Como começar com Spark Declaratives Pipelines (SDP)
Os pipelines de dados declarativos se tornaram um recurso nativo do Spark no Apache Spark 4.1. Sem frameworks adicionais. Sem dependências externas. Sem nova curva de aprendizagem. Milhões de usuários Spark agora podem criar pipelines de ETL de nível de produção, usando as ferramentas que já conhecem e adoram.
O exemplo usado aqui, um pipeline de nível de produção que rastreia todas as aeronaves no céu com milhões de eventos de IoT ao vivo a cada segundo, costumava ser um esforço sério de engenharia. Agora, isso pode ser feito em um coffee break, com algumas linhas de código e 100% de código aberto.
Figura: Visualização de dados de aeronaves OpenSky com Databricks Apps
O que é Spark Declarative Pipelines?
Spark Declarative Pipelines (SDP) é uma estrutura declarativa nativa para construir pipelines de dados em batch e streaming confiáveis em Python ou SQL.
Os jobs tradicionais do Spark são essenciais — você precisa programar cada etapa: ler este código-fonte, aplicar esta transformação, escrever nesta tabela e controlar a sequência de execução e muitos outros detalhes técnicos. O SDP inverte esse modelo. É declarativo: você descreve o resultado desejado e o Spark determina como chegar lá.
A Databricks criou originalmente o SDP como Delta Live Tables (DLT) e contribuiu para o projeto de código aberto Apache Spark no Data + AI Summit 2025.
Como funciona o SDP?
O Spark Declarative Pipelines (SDP) define como as transformações atualizam os conjuntos de dados em um pipeline. SDP automaticamente:
- Resolve dependências entre conjuntos de dados e transformações
- Determina a ordem de execução entre as etapas do pipeline
- Executa tarefas independentes em paralelo para melhorar o desempenho e a eficiência
Um pipeline de SDP é criado a partir dos principais componentes.
Você não precisará de flows ou visualizações temporárias nestes tutoriais, mas mantenha-os em mente quando seus pipelines ficarem mais complexos.
Isso é suficiente para criar seu primeiro pipeline de dados de SDP. Vamos lá.
Tutoriais sobre Spark Declaratives Pipelines (SDP)
A seguir, encontra-se um único exemplo, apresentado em dois ambientes diferentes. Um é executado localmente com PySpark de código aberto e o outro é executado na nuvem em uma conta Databricks Free Edition (para sempre gratuita). Ambos os tutoriais do SDP, o tutorial local do PySpark e o tutorial do Lakeflow Declarative Pipelines, orientam você exatamente pelo mesmo caso de uso: criar um pipeline que ingere e processa dados de aviação ao vivo de aeronaves de todo o mundo.
A fonte de dados do OpenSky
Ambos os tutoriais usam uma fonte de dados PySpark personalizada que se conecta à API REST do OpenSky Network. A OpenSky Network agrega dados de vigilância do tráfego aéreo contribuídos por entusiastas da aviação em todo o mundo, criando uma imagem em tempo real do tráfego aéreo global. A API REST do OpenSky é gratuita para uso não comercial, mas aplica limites de taxa. Verifique os documentos da API do OpenSky para conhecer os thresholds atuais.
A coleta de dados da OpenSky Network é crowdsourcing — qualquer um pode contribuir configurando um receptor ADS-B de baixo custo. Os dados que você processará nestes tutoriais existem porque milhares de voluntários ao redor do mundo fizeram exatamente isso. Alimentar seus dados com a OpenSky Network se quiser se tornar um deles.
Cada execução do pipeline de SDP ingere atualizações de posição, velocidade e altitude ao vivo das aeronaves atualmente em voo, com novos dados chegando a cada poucos segundos. A fonte de dados é uma fonte de dados PySpark de código aberto, portanto, funciona tanto em Spark simples quanto em Spark Declarative Pipelines.
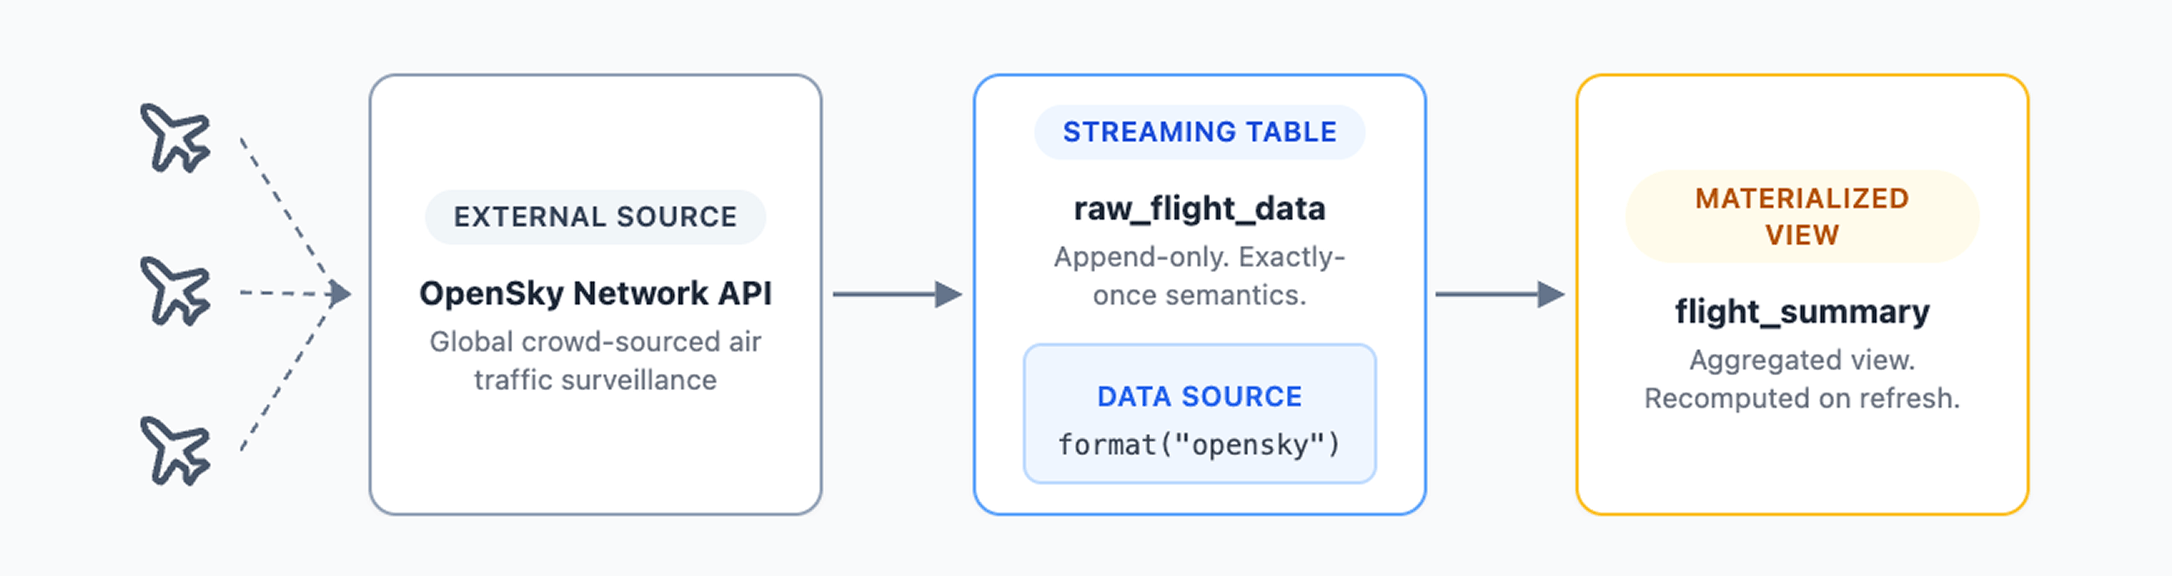
Estes são dados reais de IoT em escala de produção. O mesmo tipo que impulsiona plataformas logísticas, sistemas de rastreamento de frete e operações de monitoramento portuário. Este não é um arquivo CSV de exemplo estático. Cada execução do pipeline extrai dados ao vivo de aeronaves no ar.
A única diferença entre os dois tutoriais é onde você os executa.
Tutorial local do PySpark (código aberto)
O tutorial local do PySpark orienta você na criação de um pipeline declarativo a partir do zero em sua máquina local usando o PySpark e qualquer editor de sua preferência. Ele apresenta:
- Controle total sobre seu ambiente de desenvolvimento e escolha de IDE
- Acesso direto aos arquivos de saída do Parquet em seu sistema de arquivos local
- Stack 100% de código aberto sem dependências proprietárias
Requisitos: Python 3.12, Java 17, PySpark 4.1 e um IDE, como VS Code
Tutorial Lakeflow (Databricks Free Edition)
O tutorial Lakeflow é o caminho mais rápido para um pipeline em execução. Lakeflow é a implementação gerenciada pelo Databricks do Spark Declarative Pipelines, construída sobre o mesmo núcleo de código aberto com recursos corporativos adicionais. Ele apresenta:
- Serverless Compute com dimensionamento automático, sem necessidade de configuração de cluster
- Editor de pipeline integrado com exploração de dados com IA
- Tabelas de saída registradas no Unity Catalog com rastreamento automático de linhagem
- Sem configuração local, tudo é executado na nuvem
Requisitos: conta do Databricks Free Edition (sem cartão de crédito, nunca expira)
Perguntas frequentes
Spark Declarative Pipelines (SDP) é uma estrutura declarativa nativa integrada ao Apache Spark 4.1 ou posterior para construir pipelines confiáveis em batch e streaming de dados em Python ou SQL. Você declara quais dados devem existir, sua fonte, sua forma e como são atualizados, e o Spark lida com a resolução de dependências, a ordem de execução e o processamento paralelo. Basta executar seu pipeline declarativo e o Spark resolve o resto.
Última atualização: agosto de 2026
Autor: Frank Munz