Dimensionierung von Lakebase Search: Erkenntnisse aus einer realen Anwendung und 4 Millionen Abschnitten
- Lakebase Search führt Vektor- und BM25-Schlüsselwortsuchen als Postgres-Erweiterungen innerhalb der Anwendungsdatenbank aus, sodass Entwickler eine hybride Suche erhalten, ohne ein separates Suchsystem oder einen zweiten Transaktionspfad verwalten zu müssen.
- Benchmarks zeigen, dass bei einer Dimensionierung des Local File Cache auf etwa die Größe des Vektorindex 95–98 % der Seiten im Speicher verbleiben, wodurch die Warm-Vektor-Latenz auf einstellige Millisekunden sinkt. Eine Verringerung des Kandidatenpools von 1.000 auf 200 erhält 90,5 % der Top-10-Ergebnisse bei nur einem Drittel der Seitenlesezugriffe.
- Lakebase Postgres berechnet Compute-Ressourcen nur während der Laufzeit. Ein 14-minütiger Lasttest mit 109.000 Anfragen verbrauchte nur 0,02 $ an Lakebase Postgres-Compute. Daher wird eine dauerhafte Untergrenze von 0,5 CU für 31–40 $/Monat als empfohlene Produktions-Baseline genutzt, um Kaltstarts zu vermeiden.
Slide Hub ist eine interne Databricks-App. Field Engineers nutzen sie, um Folien aus etwa 700 internen Präsentationen zu finden und wiederzuverwenden: Event-Vorträge, Produkt-Decks und Architektur-Decks. Eine Suchleiste findet einzelne Folien nach Bedeutung und Schlüsselwort, und ein Model Context Protocol (MCP)-Server bietet AI-Agenten dieselbe Suche. Die App speichert ihre Folien, Abstimmungen, Suchtelemetrie und den Änderungsverlauf in Lakebase Postgres. Wir nutzen Slide Hub als Baseline für das Benchmarking von Lakebase Postgres. Es ist eine echte App mit einem echten Anwendungsfall und echten Nutzern, daher zeigen ihre Zahlen, wie sich die Datenbank unter einer tatsächlichen Arbeitslast verhält.
Dieser Beitrag richtet sich an Entwickler und Architekten, die Apps auf Databricks entwickeln und eine Suche innerhalb der eigenen Lakebase Postgres-Datenbank der App wünschen. Er setzt voraus, dass Sie SQL und die Grundlagen von PostgreSQL kennen. Wenn Sie eine Suchleiste oder ein Agenten-Tool auf Lakebase Postgres planen, helfen Ihnen die folgenden Zahlen bei der Auswahl der Compute-Größe, bevor Sie in die Produktion gehen.
Dieser Beitrag zeigt, wie Slide Hub die Suche innerhalb von Lakebase Postgres ausführt, was sie unter Last begrenzt, was sie kostet und wie sich Lakebase Search bei 1 Mio. bis 4 Mio. Zeilen eines öffentlichen Korpus verhält.
Eine Datenbank für die App und ihre Suche
Lakebase Search wurde im September allgemein verfügbar. Es handelt sich um eine Reihe von Postgres-Erweiterungen, sodass es direkt neben den Anwendungstabellen läuft. Die App kopiert keine Daten in ein separates Suchsystem. Entwickler müssen keinen zweiten Transaktionspfad verwalten.
Zwei CREATE EXTENSION-Anweisungen aktivieren die Komponenten. lakebase_vector speichert Embeddings, Vektoren aus Zahlen, die die Bedeutung eines Textes darstellen, und unterstützt den lakebase_ann-Index für die Approximate Nearest Neighbor (ANN)-Suche. lakebase_text unterstützt den lakebase_bm25-Index für BM25, eine Standardmethode, die Text nach den darin enthaltenen Abfragewörtern bewertet. lakebase_tokenizer ist optional. Der ANN-Index nutzt IVF-Partitionierung, die ähnliche Vektoren gruppiert, sodass eine Abfrage nur wenige Gruppen liest, und RaBitQ-Quantisierung, die jeden Vektor auf etwa 1 Bit pro Dimension komprimiert. BM25 bewertet Text mit dem <@>-Operator.
Die 23.000 Folienzeilen von Slide Hub befinden sich in derselben serverlosen Lakebase Postgres-Instanz wie die Abstimmungen, Telemetrie, der Änderungsverlauf, die Vorschauen und beide Indizes. Die App liest die Daten und die Indizes innerhalb einer Verbindung und eines Berechtigungsmodells.
Die Suchabfrage
Slide Hub führt eine hybride Suche aus. Sie kombiniert die Vektorsuche, die Folien mit einer ähnlichen Bedeutung wie die Abfrage findet, mit der BM25-Schlüsselwortsuche, die Folien findet, welche die Abfragewörter enthalten. Jede Methode liefert eine kurze Liste ihrer besten Treffer, die Kandidaten. Eine einzige SQL-Anweisung enthält die gesamte Ranking-Richtlinie. Sie bewertet jede Kandidatenliste, führt die beiden Rankings zusammen, wendet die App-Filter an und bindet die Abstimmungen ein. Such- und App-Logik teilen sich eine Verbindung, ein Set von Berechtigungen und ein Commit.
Slide Hub übernimmt 200 Kandidaten von jeder Methode. Es führt die beiden Listen mittels Reciprocal Rank Fusion (RRF) bei k=60 zusammen: Eine Folie erhält in jeder Liste den Wert 1/(60 + ihr Rang), und die beiden Werte werden addiert. Schwellenwerte für Ähnlichkeit von 0,70 lehnen Vektortreffer ab, die zu weit von der Abfrage entfernt sind, um für dieses Embedding-Modell nützlich zu sein. Titelstufen fügen Gewicht hinzu, wenn die Abfrage mit einem Folientitel übereinstimmt. Notizen erhalten das Gewicht 0,5. Scope-Filter beschränken das Ergebnis auf Assets, für die der Benutzer eine Leseberechtigung hat.
Was die App unter Last begrenzt
Eine Suchanfrage nutzt zwei separate Compute-Ressourcen, und jede davon kann das Limit festlegen.
Lakebase Postgres Compute führt die Datenbank aus. Lakebase Postgres skaliert diese in Compute Units (CU). Eine CU weist der Datenbank etwa 2 GB RAM mit dem entsprechenden Anteil an CPU und lokaler SSD zu. Ein Compute skaliert automatisch zwischen einer Mindest- und einer Höchstgröße von 0,5 CU bis 64 CU, wobei das Maximum höchstens 16 CU über dem Minimum liegen kann. Feste Compute-Größen reichen bis zu 112 CU, und Computes bis zu 32 CU können auf Null skalieren. Postgres speichert Tabellen und Indizes in 8-KB-Seiten. Lakebase Postgres hält kürzlich gelesene Seiten in einem Local File Cache (LFC) auf dem Compute bereit. Der Cache wächst mit der CU-Größe und kann bis zu 75 % des Compute-Speichers nutzen. Eine Seite, die sich nicht im Cache befindet, wird vom Speicher geladen, was länger dauert.
Databricks Apps-Compute führt den Slide Hub-Webserver aus. Seine Größe ist pro App festgelegt. Eine MEDIUM-App verfügt über bis zu 2 vCPU und 6 GB Speicher, eine LARGE-App über bis zu 4 vCPU und 12 GB. Slide Hub führt eine App-Instanz aus. Jeder darin enthaltene Python-Worker-Prozess hält einen Pool von 8 Datenbankverbindungen, sodass 2 Worker höchstens 16 Verbindungen und 4 Worker höchstens 32 Verbindungen öffnen.
Für jede Anfrage bettet die App den Abfragetext ein, sendet eine SQL-Anweisung an Lakebase Postgres und gibt das Ergebnis zurück. Um das Limit zu finden, ändert der Test jeweils eine Seite. Er fixiert Lakebase Postgres auf eine CU-Größe und ändert die App, oder er behält die App bei und ändert die CU-Größe. Ein Lastgenerator simuliert Benutzer, die Suchanfragen senden, und erhöht die Anzahl der Benutzer schrittweise. Die Liste zeigt die Anfragen pro Sekunde und die mittlere Latenz (p50) bei 500 Benutzern für jede Lakebase Postgres- und App-Größe.
- 1 CU, MEDIUM-App mit 2 Workern: 196 req/s, p50 1,8 s
- 0,5 bis 1 CU, LARGE-App mit 4 Workern: 193 req/s, p50 1,6 s
- 2 CU, MEDIUM-App mit 2 Workern: 201 req/s, p50 1,8 s
- 4 CU, MEDIUM-App mit 2 Workern: 219 req/s, p50 1,6 s
- 8 CU, MEDIUM-App mit 2 Workern: 336 req/s, p50 1,0 s
- 16 CU, MEDIUM-App mit 2 Workern: 349 req/s, p50 1,0 s
- 16 CU, LARGE-App mit 4 Workern: mindestens 662 req/s, p50 343 ms
Bis zu 4 CU ist Lakebase das Limit. Eine LARGE-App mit doppelt so vielen Workern und Verbindungen bringt bei 1 CU keinen Vorteil. Bei 1 CU dauerte die Suchanweisung durchschnittlich 146 ms und las 14,9 Mio. Seiten aus dem Speicher, bei einem Datei-Cache von 1,5 GB. Bei 8 CU dauerte sie durchschnittlich 34 ms mit einem Cache von 12 GB, und der Durchsatz stieg um etwa 50 %.
Ab 8 CU bildet die App das Limit. 16 CU mit derselben MEDIUM-App bringt nur 4 % mehr, und die Datenbankverbindungen sind meist inaktiv. Eine LARGE-App mit 4 Workern bei 16 CU erreicht mindestens 662 req/s, wobei dort der Lastgenerator das Limit war. Dimensionieren Sie zuerst die Abfrage. Skalieren Sie dann Lakebase Postgres, bis die App-Worker das Limit darstellen, und skalieren Sie erst danach die App.
Fazit: Ermitteln Sie das Limit, bevor Sie skalieren. Unter 8 CU fügen Sie Lakebase Postgres CUs hinzu. Ab 8 CU geben Sie der App mehr Worker.
Der Verbindungspool ist weiterhin erforderlich. Bei 50 Benutzern erreichte die App ohne den Pool 45 req/s und 2,4 s p95 und mit ihm 85 req/s und 0,7 s p95. Der Embedding-Cache machte unter Last keinen messbaren Unterschied.
Kandidaten-Pools und Kaltstarts
Das Kandidatenlimit legt fest, wie viele Seiten eine Abfrage berührt. Bei einem kalten Cache bestimmt diese Zahl die Latenz. Slide Hub wurde ursprünglich mit 1.000 Kandidaten pro Methode ausgeliefert. Das Dokumentationsmuster verwendet 40. Das Kandidatenlimit-Experiment änderte nur candidate_limit und maß 20 öffentliche Abfragen in drei Zuständen. Kalt ist die erste Abfrage, nachdem der Compute auf Null skaliert wurde, mit einem leeren Cache. Erstaufruf ist die erste Ausführung einer Abfrage auf einem aktiven Compute. Wiederholung ist dieselbe Abfrage erneut ausgeführt, wobei sich ihre Seiten im Cache befinden. Berührte Seiten zählt die Seiten, die eine Abfrage aus einer beliebigen Quelle liest. Die Top-10-Überschneidung ist der Anteil der Top-10-Ergebnisse, die mit dem Ergebnis bei 1.000 Kandidaten übereinstimmen.
- 40 Kandidaten: kalt 127 ms, Erstaufruf 13 ms, Wiederholung 5,0 ms. Berührt 5.655 Seiten. Top-10-Überschneidung 74,5 %.
- 100 Kandidaten: kalt 240 ms, Erstaufruf 16 ms, Wiederholung 7,9 ms. Berührt 7.355 Seiten. Top-10-Überschneidung 89 %.
- 200 Kandidaten: kalt 387 ms, Erstaufruf 24 ms, Wiederholung 11,7 ms. Berührt 10.401 Seiten. Top-10-Überschneidung 90,5 %.
- 1.000 Kandidaten: kalt 740 ms, Erstaufruf 109 ms, Wiederholung 35,3 ms. Berührt 28.972 Seiten. Top-10-Überschneidung 100 % (die Referenz).
Bei 200 Kandidaten bleiben 90,5 % der Top 10 unverändert, und die gemeldete Anzahl der Treffer entspricht 81 % der Anzahl bei 1.000 Kandidaten. Benutzer blättern selten über 200 Ergebnisse hinaus, weshalb Slide Hub jetzt 200 liefert. End-to-End gemessen von einem Job in derselben Cloud-Region wie die App, dauerte eine kalte Suche bei 200 Kandidaten 2,9 s und eine wiederholte Suche 40 ms. Die Kaltstartzeit besteht aus zwei Teilen. Die Verbindung wartet etwa 1 s, während der Endpunkt aufwacht. Anschließend liest jede Abfrage ihre Seiten aus dem Speicher, bis der Cache aufgewärmt ist. Die erste Abfrage über eine neue Verbindung erfordert zudem etwa 75 ms für die Planung.
Fazit: Halten Sie den Kandidaten-Pool klein. 200 Kandidaten behalten 90,5 % der Top-10-Ergebnisse bei, lesen etwa ein Drittel der Seiten von 1.000 Kandidaten und halbieren die Kaltstartlatenz.
Skalierung: 1 Mio. bis 4 Mio. Zeilen von MIRACL English
Die Skalierungstests nutzen MIRACL English, ein aus Wikipedia erstelltes Passagen-Korpus. Das gesamte Korpus umfasst 32.893.221 Passagen. Wir haben es mit gte-large-en-v1.5 eingebettet, einem offenen Modell mit 1024 Dimensionen, dieselbe Größe wie die Slide Hub Embeddings. Wir haben das Modell auf einer A10G GPU mit 379 Passagen pro Sekunde selbst gehostet. Das gesamte Korpus benötigte 2,95 GPU-Stunden, verglichen mit 48,87 $ für dieselbe Arbeit auf einem Modell-Serving-Endpunkt. Die GPU-Vektoren stimmten mit den Endpunkt-Vektoren überein (mittlerer Kosinus 1,0000, Minimum 0,9978).
Wir haben drei Teilmengen erstellt: 1M, 2M und 4M Passagen. Der Index lakebase_ann wuchs mit dem Korpus: 5,8 GB bei 1M, 11,5 GB bei 2M, 23,0 GB bei 4M. Ein binärer COPY lud alle 4M Zeilen in 19 Minuten bei 8 CU.
Lakebase Postgres enthält etwa 1,6 GB Dateicache pro CU. Skalierung wirft eine Frage auf: Was passiert, wenn der Index größer als der Cache ist? Jede Test-Zelle entspricht einer Korpusgröße bei einer CU-Größe, sodass der Cache einen bekannten Anteil des Index ausmacht. Diesen Anteil nennen wir das Cache-Verhältnis: Cache-Größe geteilt durch Vektorindex-Größe. Ein Verhältnis von 1,0 bedeutet, dass der Index gerade hineinpasst. Die Trefferquote ist der Anteil der Seiten, die eine Abfrage liest und die nicht aus dem Speicher geladen werden.
Wir haben drei Abfragemixe für jede Zelle ausgeführt. Der uniforme Mix sendet jedes Mal einen neuen Titel und wiederholt sich nie – der Worst Case für einen Cache. Der asymmetrische Mix zieht aus einem Pool von 20.000 Titeln mit einer Zipf-Verteilung, ein gängiges Modell für Such-Traffic. Der kalte Mix führt die ersten Abfragen direkt nach dem Aufwachen aus, wenn der Cache leer ist. Vor den Messungen des uniformen und asymmetrischen Mixes führt ein Aufwärmdurchlauf denselben Mix aus, bis sich die Trefferquote nicht mehr ändert. Die Ergebnisse nach dem Aufwärmen nennen wir warm.
Die Trefferquote folgt dem Cache-Verhältnis

Die Trefferquote hängt vom Cache-Verhältnis ab. Die Korpusgröße ändert daran nichts: Die Punkte für 2M und 4M liegen auf einer Kurve. Bei einem Verhältnis von 0,07 erreichte der asymmetrische Mix 45 % seiner Seiten im Cache. Bei 0,57 lag der Wert bei 86 %. Bei 1,14, wo der Index gerade hineinpasst, lag er bei 97 %. Der uniforme Mix liegt einige Prozentpunkte darunter, da er nichts wiederverwendet.
Daraus ergibt sich eine Regel für die Dimensionierung: Messen Sie Ihre Indexgröße, wählen Sie eine CU-Größe für das gewünschte Cache-Verhältnis und lesen Sie die Trefferquote von der Kurve ab. Das Verhältnis gilt über verschiedene Korpusgrößen hinweg, sodass ein Test bei 2M das Verhalten bei 4M vorhersagt.
Fazit: Dimensionieren Sie den Cache anhand des Vektorindex, nicht anhand der Zeilenzahl. Ein Cache, der etwa so groß ist wie der Index, bedient 95 % bis 98 % der Seiten ohne Festplattenspeicher.
Latenz folgt der Trefferquote
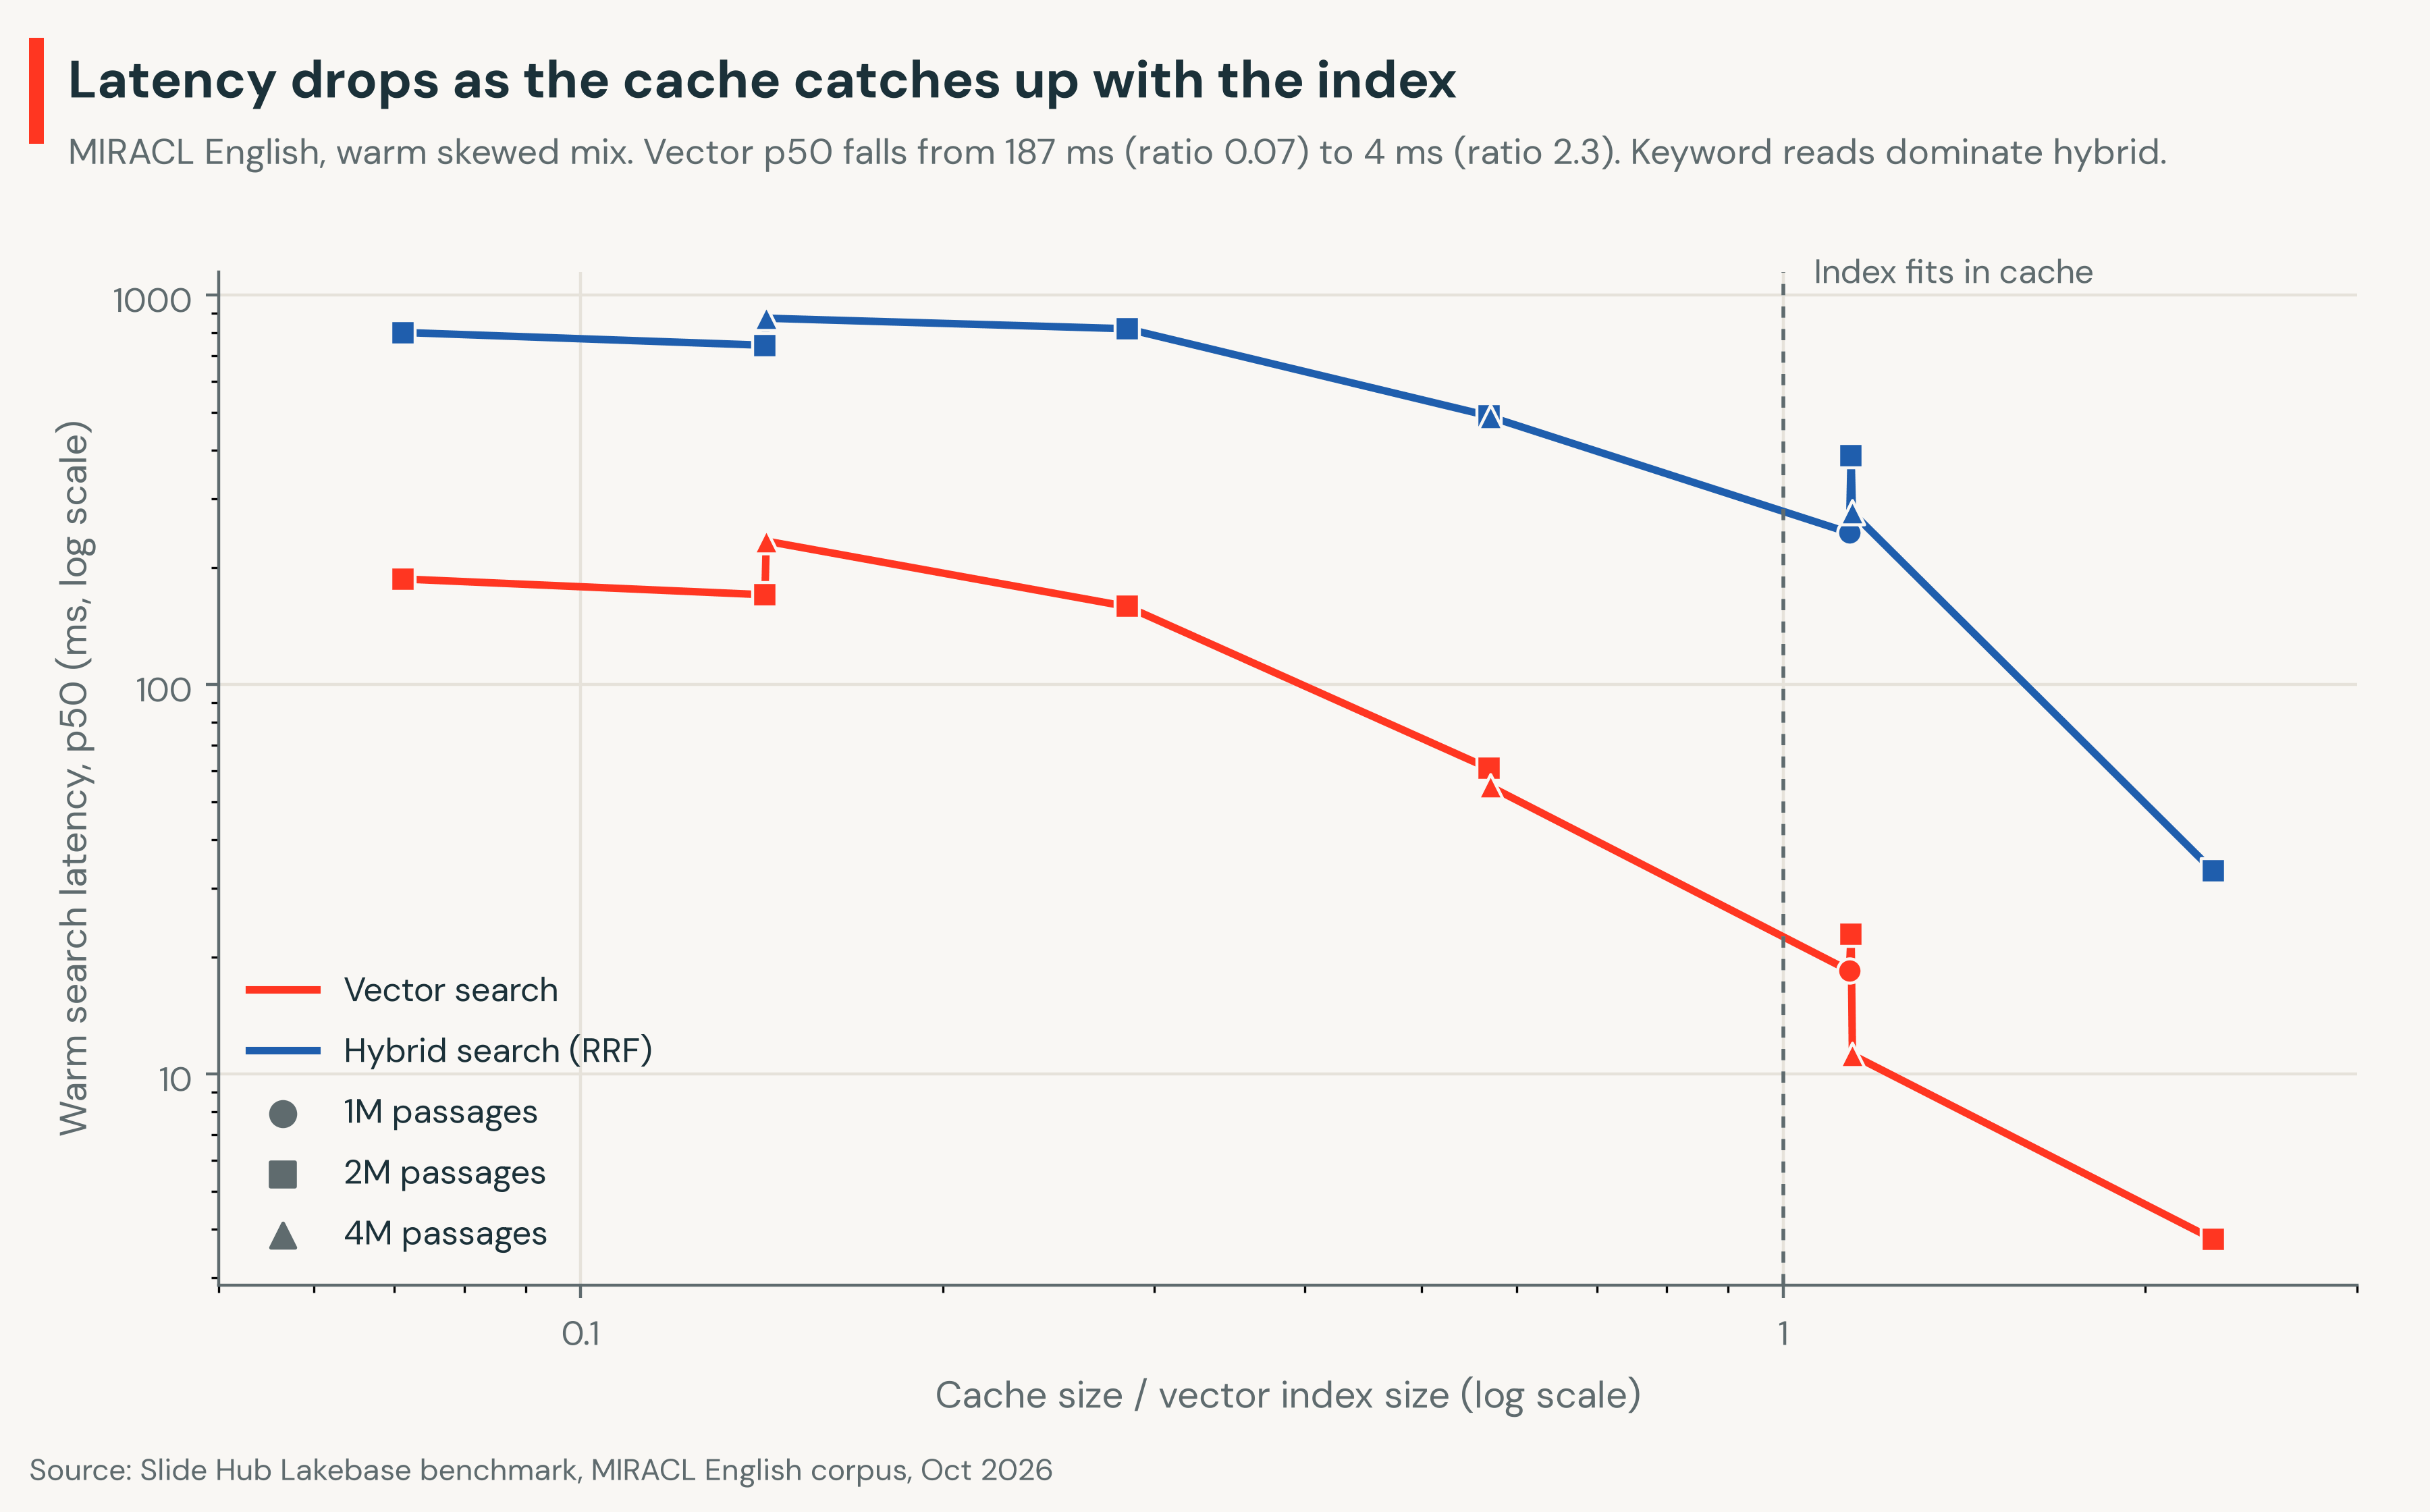
Der p50-Wert für warme Vektorabfragen sank von 187 ms bei einem Verhältnis von 0,07 auf 4 ms bei einem Verhältnis von 2,3. Die hybride Suche blieb bei nahezu 800 ms, bis sich das Verhältnis 1 näherte, und fiel dann auf 33 ms. Der Schlüsselwort-Teil der hybriden Abfrage liest die meisten Seiten, profitiert also am stärksten von einem vollen Cache.
Fazit: Die Vektorsuche dauert 160 bis 230 ms, solange der Cache weniger als ein Drittel des Index enthält, und 11 bis 23 ms, sobald der gesamte Index hineinpasst.

Ein Miss (Fehlzugriff) ist eine 8-KB-Postgres-Seite, die sich nicht im lokalen Dateicache befindet. Im Vektorindex enthält eine Seite ein oder zwei Embeddings. Jeder Seitenlesezugriff auf den Speicher kostet eine feste Zeitspanne. Über alle gemessenen Abfragen hinweg steigt die Ausführungszeit um etwa 252 Mikrosekunden pro verpasster Seite bei der Vektorsuche und um 316 Mikrosekunden bei der hybriden Suche. Eine Abfrage, die 2.000 Seiten verpasst, verliert etwa eine halbe Sekunde. Ein voller Cache eliminiert fast alle Fehlzugriffe. Aus diesem Grund bestimmt das Cache-Verhältnis die Latenz: Es bestimmt, wie viele Seiten jede Abfrage aus dem Speicher liest.
Fazit: Jede Seite aus dem Speicher fügt etwa 0,3 ms hinzu. Multiplizieren Sie die Speicher-Misses pro Abfrage mit 0,3 ms, um abzuschätzen, was Sie durch den Cache einsparen.
Aus dem Cache wächst die Latenz mit dem Korpus kaum an

Halten Sie das Cache-Verhältnis bei nahezu 1,0 und ändern Sie die Korpusgröße. Die warme Vektorlatenz blieb zwischen 11 und 23 ms von 1M bis 4M. Die warme hybride Latenz blieb bei nahezu 276 ms. Die kalten Abfragen, die aus dem Speicher lesen, wuchsen mit dem Korpus: Eine kalte Vektorabfrage stieg von 44 ms bei 1M auf 133 ms bei 4M, und eine kalte hybride Abfrage erreichte 911 ms bei 4M.
Das ist die ehrliche Form von „Sie brauchen nicht den gesamten Index im Arbeitsspeicher“: Das brauchen Sie tatsächlich nicht, weil die Architektur den Rechenspeicher flach hält. RaBitQ speichert etwa 1 Bit pro Dimension – 32-mal kleiner als float32 – und IVF liest nur wenige Partitionen pro Abfrage. Der Index ist speichergestützt, sodass die Rechenleistung klein gehalten werden oder auf null skalieren kann. Abfragen, die den Cache verfehlen, zahlen für diesen Fehlzugriff, und das Cache-Verhältnis steuert, wie oft das geschieht.
Fazit: Skalieren Sie die Rechenleistung mit dem Korpus, bleibt die warme Latenz konstant. Nur Abfragen mit Cache-Fehlzugriffen werden mit wachsendem Korpus langsamer.
Durchsatz skaliert mit der Rechenleistung
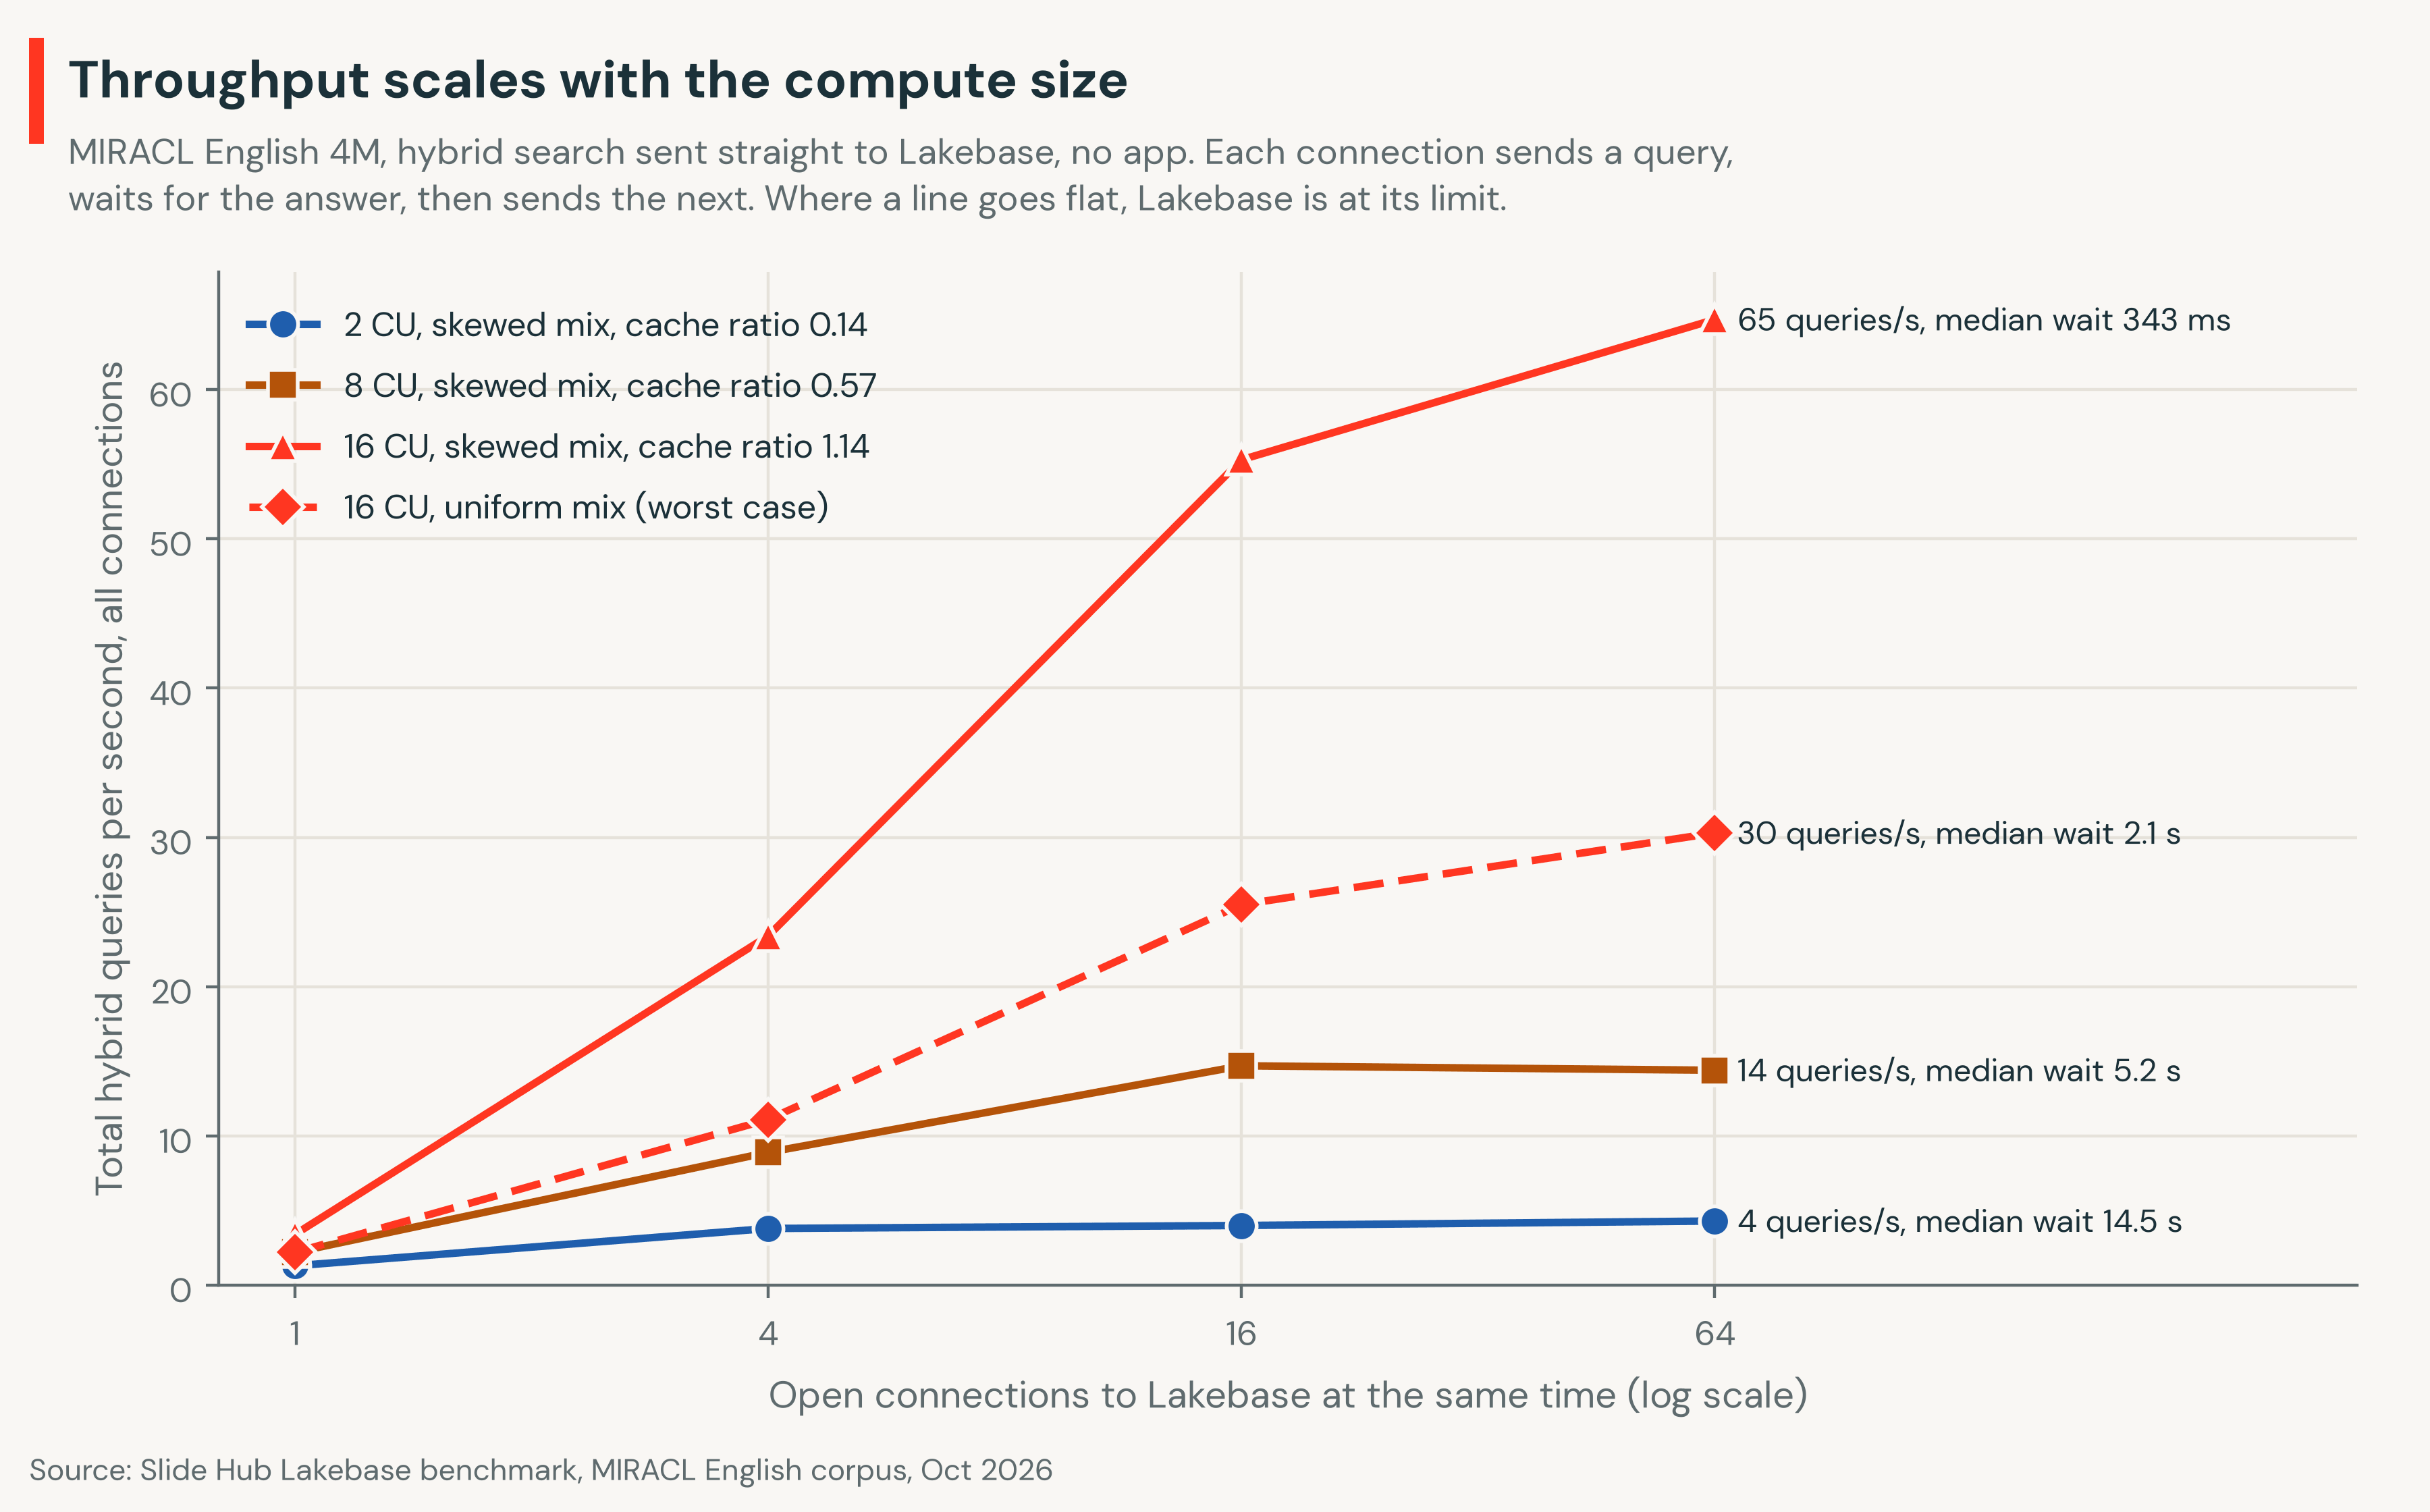
Der Durchsatztest sendete hybride Abfragen direkt an Lakebase Postgres, ohne die App, misst also die Datenbank allein. Es wurden gleichzeitig 1, 4, 16 oder 64 Verbindungen zu Lakebase Postgres geöffnet. Jede Verbindung sendete eine Abfrage, wartete auf die Antwort und sendete dann die nächste. Das Diagramm zeigt die Gesamtzahl der Abfragen pro Sekunde über alle Verbindungen hinweg. Wenn eine Linie flach verläuft, führen mehr Verbindungen nicht zu mehr abgeschlossenen Abfragen. Lakebase Postgres ist dann an seiner Grenze und jede Abfrage wartet stattdessen länger. Die eigene CPU des Lastgenerators blieb nahe null, sodass Lakebase Postgres jeden Wert bestimmte.
Beim 4M-Korpus erreichte der asymmetrische Mix etwa 4 Abfragen pro Sekunde bei 2 CU, 15 bei 8 CU und 65 bei 16 CU. Bei 64 Verbindungen betrug die mittlere Wartezeit für eine Abfrage 14,5 s bei 2 CU, 5,2 s bei 8 CU und 343 ms bei 16 CU. Der uniforme Mix bei 16 CU erreichte seinen Höchstwert bei 30 Abfragen pro Sekunde, da er nie eine Seite wiederverwendet. Der Durchsatz skaliert sowohl mit der Rechenleistungsgröße als auch mit dem Cache-Verhältnis.
Betrachten Sie dies als die Kosten von Cache-Fehlzugriffen unter Last. Die meisten Abfragen in einer realen Anwendung wiederholen sich oder bilden Cluster, sodass die warme Trefferquote – und nicht der uniforme Mix – die Kapazität im Normalbetrieb bestimmt.
Fazit: Mehr CUs steigern den Durchsatz in zweifacher Hinsicht: durch mehr CPU-Leistung und einen größeren Cache. Der Wechsel von 8 CU auf 16 CU erhöhte den asymmetrischen Durchsatz von 15 auf 65 Abfragen pro Sekunde.
Trefferquote (Recall) im Vergleich zur exakten Suche
Der Index lakebase_ann ist approximativ. Recall@10 ist der Anteil der echten 10 nächstgelegenen Passagen aus einer exakten Suche über alle Vektoren, den der Index ebenfalls zurückgibt. Der Index unterteilt die Vektoren in Partitionen (IVF), und lakebase_ann.probes legt fest, wie viele Partitionen eine Abfrage liest. Recall@10 veränderte sich bei der Standard-Probes-Anzahl kaum mit der Korpusgröße: 0,74 bei 1M, 0,75 bei 2M und 0,75 bei 4M. Mehr Probes tauschen Latenz gegen Trefferquote ein.

Mit dem Standardindex bei 4M lieferten die standardmäßigen 109 Probes einen Recall@10 von 0,74 in 3 ms, und 2.000 Probes lieferten 0,95 in 49 ms. Ein mit build_mode = 'quality' erstellter Index erhöhte den Recall bei jeder Probes-Anzahl: 0,80 bei den Standard-Probes in 3 ms und 0,97 bei 2.000 Probes in etwa der gleichen Zeit wie der Standard-Build. Sein Erstellen dauerte 52 Minuten bei 16 CU. Das Erhöhen von lakebase_ann.epsilon auf 4, den höchsten Wert, den es in unseren Tests akzeptierte, erbrachte weniger als 0,3 Punkte.[9] Der Recall hängt von den Daten und dem Embedding-Modell ab, also messen Sie ihn an Ihren eigenen Daten und wählen Sie die Probes-Anzahl, die Ihre Anwendung benötigt. Lakebase Search unterstützt einen einzelnen Index von über 1 Milliarde Vektoren.[1]
Fazit: Erstellen Sie den Vektorindex mit build_mode = 'quality'. Bei den Standard-Probes erhöhte dies den Recall@10 von 0,74 auf 0,80 in etwa 3 ms, und bei 500 Probes erreichte er 0,91 in 13 ms, wofür beim Standard-Build 1.000 Probes und 20 ms erforderlich sind. Die Kosten liegen in der Erstellungszeit: 52 Minuten für 4M Passagen bei 16 CU. Erhöhen Sie die Probes nur, wenn Ihre Anwendung einen höheren Recall benötigt.
Kosten
Die Kosten für Lakebase richten sich nach der Nutzung. Bei einer angehaltenen Rechenressource fallen keine Rechenkosten an, und der Speicherplatz wird separat abgerechnet. Lakebase machte etwa 1 % der 30-Tage-Abrechnung von Slide Hub aus. Slide Hub ist eine interne Anwendung, und eine langsamere erste Suche nach 5 inaktiven Minuten ist für deren Nutzer akzeptabel, sodass die Produktionsdatenbank auf null skaliert, wenn niemand sucht.
Die Skalierungsevaluierung war günstig. Das selbstgehostete Embedding des gesamten Korpus dauerte 2,95 GPU-Stunden, verglichen mit 48,87 $ für den Model-Serving-Endpunkt. Ein regionaler Lasttest lief 14 Minuten lang und kostete laut Listenpreis 0,13 $: 0,11 $ für die App und 0,02 $ für Lakebase Postgres, das automatisch zwischen 0,5 und 1 CU skalierte und 0,21 CU-Stunden verbrauchte. Bis zu 1.000 Benutzern bediente der Test 109.602 Anfragen ohne Fehler. Die Zellen liefen mit 0,5 bis 16 CU und wurden zwischen den Durchläufen pausiert. In den Abrechnungstabellen unseres Workspaces entspricht eine CU-Stunde 0,213 DBU: etwa 0,085 $ zum Premium-Listenpreis und 0,11 $ zum Enterprise-Listenpreis in AWS US East.
Fazit: Lakebase Postgres berechnet Compute-Ressourcen nur, während sie ausgeführt werden. Der 14-minütige Lasttest verbrauchte 0,02 $ an Compute-Kosten für Lakebase Postgres, was etwa 1 % der 30-Tage-Abrechnung von Slide Hub entsprach. Setzen Sie das Minimum für die Produktion auf 0,5 CU, anstatt auf null zu skalieren. Zum Listenpreis kostet das etwa 31 bis 40 $ pro Monat, und Suchanfragen warten nicht mehr etwa 1 Sekunde darauf, dass Compute aufwacht oder mit einem leeren Cache startet.[11] Lassen Sie Entwicklungs- und Test-Branches auf null skalieren.
Hinweis zu den Daten
MIRACL English ist frei zugänglich. Der Korpus steht unter Apache-2.0, und seine Passagen stammen aus Wikipedia unter CC BY-SA. Das Embedding-Modell gte-large-en-v1.5 steht unter Apache-2.0. Dieser Beitrag berichtet nur über aggregierte Metriken. Derselbe Test läuft mit jedem 1024-dimensionalen Modell: Tauschen Sie einfach den Embedding-Schritt aus und behalten Sie die Tabelle, die Indizes und die Suche bei.
Fazit
Stellen Sie sich Lakebase Postgres wie einen Leser an einem Schreibtisch vor einem großen Bücherregal vor.
- Das Bücherregal ist der Speicher und der Schreibtisch ist der Cache. Seiten auf dem Schreibtisch lassen sich schnell lesen. Seiten aus dem Regal erfordern einen kleinen Weg und dauern jeweils etwa 0,3 ms.
- Machen Sie den Schreibtisch so groß wie die Bücher, die Sie nutzen. Wenn der Cache etwa so groß ist wie der Vektorindex, liegt fast jede Seite auf dem Schreibtisch, und eine Vektorsuche dauert nur Millisekunden.
- Mehr CU sorgen für einen größeren Schreibtisch und mehr Hände. Das macht jede Suche schneller und ermöglicht es Lakebase Postgres, mehr Suchanfragen gleichzeitig zu beantworten.
- Fordern Sie weniger Bücher an. Eine Suche, die 200 Kandidaten statt 1.000 abfragt, überträgt etwa ein Drittel der Seiten und behält 9 der Top-10-Ergebnisse bei.
- Sortieren Sie die Regale gut und wählen Sie dann aus, wie viele Sie durchsuchen möchten. Ein im Qualitätsmodus erstellter Index liefert bei den Standard-Probes 8 der tatsächlich 10 nächsten Passagen in 3 ms und 97 von 100 mit 2.000 Probes in etwa 50 ms.
- Die App hat ihren eigenen Schreibtisch. Sobald Lakebase Postgres schnell ist, werden die Worker der App zum Engpass. Geben Sie der App dann mehr Worker. Mehr Lakebase Postgres CU helfen an diesem Punkt nicht weiter.
- Sie brauchen nicht die gesamte Bibliothek auf dem Schreibtisch. Lakebase Postgres liest den Rest aus dem Speicher. Das ist langsamer, aber es funktioniert, und die Cache-Ratio zeigt Ihnen, wie oft das vorkommt.
- Sie zahlen nur für den Schreibtisch, während jemand liest. Wenn niemand sucht, kann Lakebase Postgres pausieren und berechnet nur den Speicher; bei Slide Hub machte das etwa 1 % der 30-Tage-Abrechnung aus. Halten Sie in der Produktion einen kleinen Schreibtisch offen: 0,5 CU kosten etwa 31 bis 40 $ pro Monat und vermeiden den Kaltstart.
Databricks bietet drei Suchoptionen, und jede eignet sich für eine andere Aufgabe. Wählen Sie diejenige, die direkt neben Ihren Daten liegt.
- Lakebase Search läuft in der Postgres-Datenbank der App. Verwenden Sie es, wenn die Suche direkt neben den eigenen Tabellen der App liegen und jeden Schreibvorgang sofort erfassen muss.
- AI Search, ehemals Vector Search, ist ein verwalteter Suchdienst über Lakehouse-Tabellen in Unity Catalog. Er hält seinen Index mit einer Delta- oder Iceberg-Tabelle synchron und kann Embeddings für Sie erstellen. Verwenden Sie ihn für RAG, Agenten und Empfehlungen über Lakehouse-Daten.
- Volltextsuchindizes (Beta) beschleunigen SQL-Abfragen auf verwalteten Delta- und Iceberg-Tabellen. Die Funktionen search und isearch nutzen den Index, um Dateien zu überspringen, die keine Übereinstimmung enthalten können, sodass Log- und Schlüsselwort-Lookups weniger Daten lesen. Sie filtern Zeilen und rangieren keine Ergebnisse für eine Suchleiste.
Slide Hub führt all dies in einer einzigen Lakebase Postgres-Datenbank aus: die App-Daten, den Vektorindex und den Schlüsselwortindex. Starten Sie mit der Dokumentation zu Lakebase Search und führen Sie anschließend denselben Test mit Ihren eigenen Daten aus.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.