Erste Schritte mit Spark Declarative Pipelines (SDP)
Deklarative Datenpipelines sind in Apache Spark 4.1 eine native Funktion von Spark geworden. Keine zusätzlichen Frameworks. Keine externen Abhängigkeiten. Keine neue Lernkurve. Millionen bestehender Spark-Benutzer können jetzt produktionsfähige ETL-Pipelines mit den Tools erstellen, die sie bereits kennen und lieben.
Das hier verwendete Beispiel – eine Pipeline für die Produktion, die jedes Flugzeug am Himmel verfolgt und Millionen von Live-IoT-Ereignissen pro Sekunde gestreamt werden – war früher ein ernsthafter technischer Aufwand. Jetzt kann dies in einer Kaffeepause mit wenigen Codezeilen und 100 % Open Source erledigt werden.
Abbildung: Visualisierung von OpenSky-Flugzeugdaten mit Databricks Apps
Was sind Spark Declarative Pipelines?
Spark Declarative Pipelines (SDP) ist ein natives deklaratives Framework zum Erstellen zuverlässiger Batch- und Streaming-Datenpipelines in Python oder SQL.
Herkömmliche Spark-Jobs sind zwingend erforderlich. Sie müssen jeden Schritt programmieren: Lesen Sie diese Quelle, wenden Sie diese Transformation an, schreiben Sie in diese Tabelle und steuern Sie die Ausführungssequenz und viele andere technische Details selbst. SDP kehrt dieses Modell um. Sie beschreiben das gewünschte Ergebnis, und Spark bestimmt, wie es erreicht werden soll.
Databricks hat SDP ursprünglich als Delta Live Tables (DLT) entwickelt und auf dem Data + AI Summit 2025 zum Open-Source-Projekt Apache Spark beigetragen.
Wie funktioniert SDP?
Spark Declarative Pipelines (SDP) definieren, wie Datensätze in einer Pipeline durch Transformationen aktualisiert werden. SDP automatisch:
- Löst Abhängigkeiten zwischen Datensätzen und Transformationen
- Bestimmt die Ausführungsreihenfolge über Pipelineschritte hinweg
- Führt unabhängige Aufgaben parallel aus, um Leistung und Effizienz zu verbessern
Eine SDP-Pipeline besteht aus wichtigen Kernkomponenten.
Sie benötigen in diesen Lernprogrammen keine Flows oder temporären Ansichten, aber denken Sie daran, wenn Ihre Pipelines komplexer werden.
Das reicht aus, um Ihre erste SDP-Datenpipeline aufzubauen. Gehen wir.
Tutorials zu Spark Declarative Pipelines (SDP)
Im Folgenden wird ein einzelnes Beispiel in zwei verschiedenen Umgebungen dargestellt. Eine wird lokal mit Open Source PySpark ausgeführt, die andere wird in der Cloud mit einem (für immer kostenlosen) Databricks Free Edition Konto ausgeführt. Beide SDP-Tutorials – das lokale PySpark-Tutorial und das Lakeflow-Tutorial zu deklarativen Pipelines – führen Sie durch genau denselben Anwendungsfall: Erstellen einer Pipeline, die Live-Luftfahrtdaten von Flugzeugen auf der ganzen Welt aufnimmt und verarbeitet.
Die OpenSky-Datenquelle
Beide Tutorials verwenden eine benutzerdefinierte PySpark-Datenquelle, die eine Verbindung zur OpenSky Network REST-API herstellt. Das OpenSky Network sammelt Flugverkehrsüberwachungsdaten, die von Luftfahrtenthusiasten weltweit zur Verfügung gestellt werden, und erstellt so ein Echtzeitbild des globalen Luftverkehrs. Die OpenSky REST-API ist für nichtkommerzielle Zwecke kostenlos, es gelten jedoch Ratenbeschränkungen. Aktuelle Schwellenwerte finden Sie in der OpenSky API-Dokumentation.
Die Datenerfassung von OpenSky Network erfolgt über Crowdsourcing. Jeder kann durch die Einrichtung eines kostengünstigen ADS-B-Empfängers dazu beitragen. Die Daten, die Sie in diesen Lernprogrammen verarbeiten, existieren, weil Tausende von Freiwilligen auf der ganzen Welt genau das getan haben. Führen Sie Ihre Daten dem OpenSky Network bei, wenn Sie einer von ihnen werden möchten.
Jeder SDP-Pipeline-Betrieb erfasst aktuelle Positions-, Geschwindigkeits- und Höheninformationen von Flugzeugen, die sich gerade im Flug befinden. Alle paar Sekunden kommen neue Daten ein. Die Datenquelle ist eine Open-Source-PySpark-Datenquelle, die sowohl in normalem Spark als auch in deklarativen Spark Pipelines funktioniert.
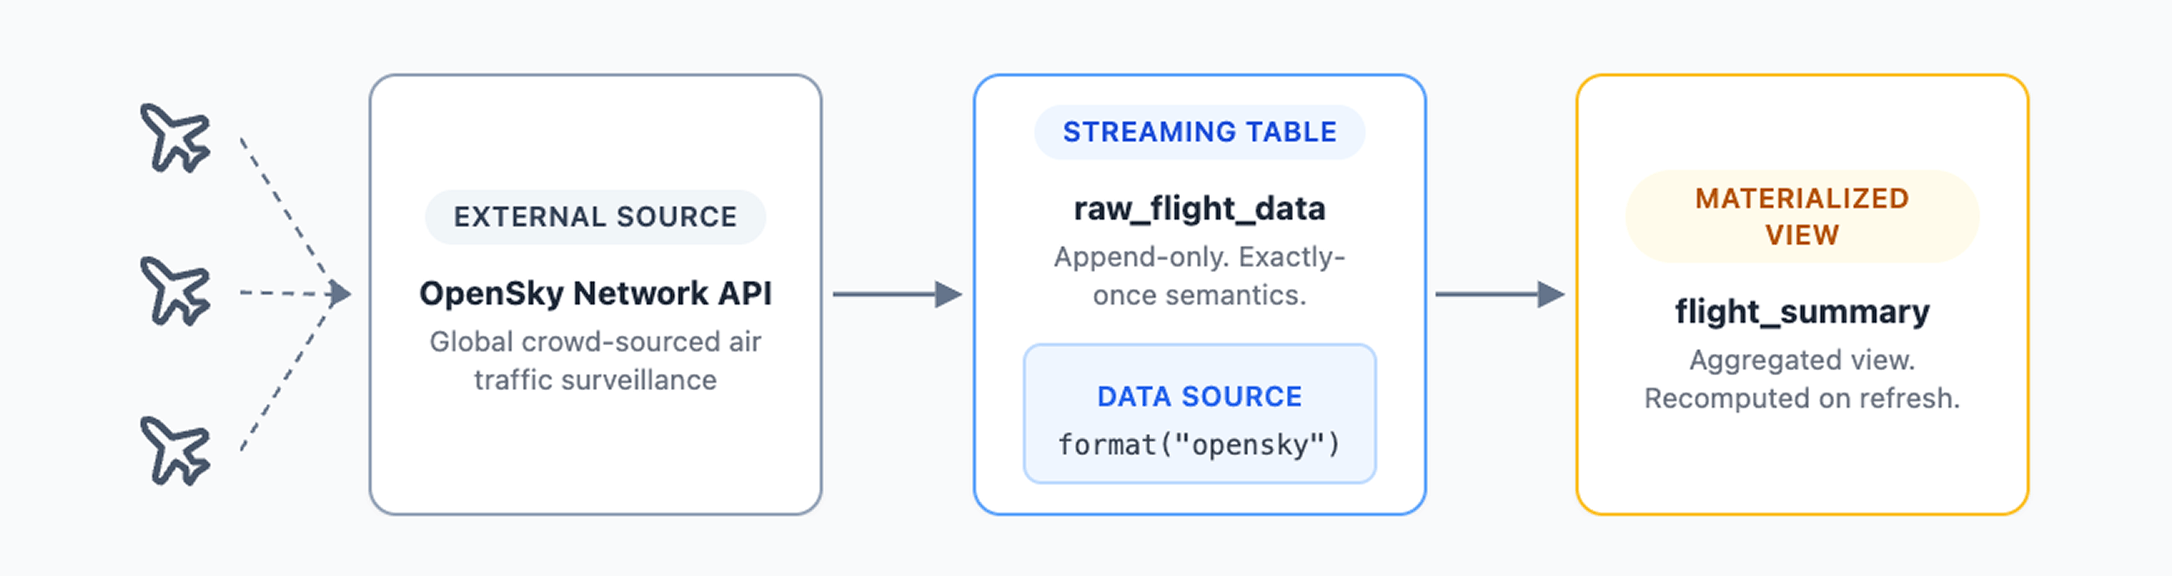
Dies sind reale IoT-Daten im Produktionsmaßstab. Dieselbe Art von Systemen, die Logistikplattformen, Frachtverfolgungssystemen und Hafenüberwachungsvorgängen betreiben. Dies ist keine statische CSV-Beispieldatei. Jeder Pipeline-Lauf bezieht Live-Daten von Flugzeugen, die sich gerade in der Luft befinden.
Der einzige Unterschied zwischen den beiden Lernprogrammen besteht darin, wo Sie sie ausführen.
PySpark-Lokales Tutorial (Open Source)
Das lokale PySpark-Tutorial führt Sie durch die Erstellung einer deklarativen Pipeline auf Ihrem lokalen Rechner mithilfe von PySpark und einem beliebigen Editor, den Sie bevorzugen. Es verfügt über:
- Volle Kontrolle über Ihre Entwicklungsumgebung und Auswahl der IDE.
- Direkter Zugriff auf Parquet-Ausgabedateien auf Ihrem lokalen Dateisystem
- 100 % Open Source-Stack ohne proprietäre Abhängigkeiten
Voraussetzungen: Python 3.12, Java 17, PySpark 4.1 und eine IDE wie VS Code
Lakeflow-Tutorial (Databricks Free Edition)
Das Lakeflow-Tutorial ist der schnellste Weg zu einer ausgeführten Pipeline. Lakeflow ist die von Databricks verwaltete Implementierung von Spark Declarative Pipelines, die auf demselben Open Source-Kern mit zusätzlichen Enterprise-Funktionen aufbaut. Es verfügt über:
- Serverlose Datenverarbeitung mit automatischer Skalierung, keine Clusterkonfiguration erforderlich
- Integrierter Pipeline-Editor mit KI-gestützter Datenexploration
- Im Unity-Katalog registrierte Ausgabetabellen mit automatischer Abstammungsverfolgung
- Keine lokale Einrichtung erforderlich, alles läuft in der Cloud
Voraussetzungen: Databricks Free Edition-Konto (keine Kreditkarte, läuft nie ab)
FAQ
Spark Declarative Pipelines (SDP) ist ein natives deklaratives Framework, das in Apache Spark 4.1 oder höher integriert ist, um zuverlässige Batch- und Streaming-Datenpipelines in Python oder SQL zu erstellen. Sie geben an, welche Daten vorhanden sein sollen, welche Quelle sie haben und wie sie aktualisiert werden. Spark übernimmt die Auflösung von Abhängigkeiten, die Ausführungsreihenfolge und die parallele Verarbeitung. Führen Sie einfach Ihre deklarative Pipeline aus und Spark erledigt den Rest.
Letzte Aktualisierung: August 2026
Autor: Frank Munz