Cómo empezar a utilizar Spark Declarative Pipelines (SDP)
Las canalizaciones de datos declarativas se han convertido en una función nativa de Spark en Apache Spark 4.1. Sin marcos adicionales. Sin dependencias externas. No hay nueva curva de aprendizaje. Millones de usuarios de Spark pueden crear canalizaciones ETL de nivel de producción con las herramientas que ya conocen y adoran.
El ejemplo utilizado aquí, una tubería de grado de producción que rastrea cada avión en el cielo con millones de eventos IoT en vivo transmitidos cada segundo, solía ser un esfuerzo de ingeniería serio. Ahora se puede hacer en una pausa para tomar café, con unas pocas líneas de código y 100% de código abierto.
Figura: Visualización de datos de aeronaves OpenSky con aplicaciones Databricks
¿Qué es Spark Declarative Pipelines?
Spark Declarative Pipelines (SDP) es un marco declarativo nativo para crear canalizaciones de datos fiables por lotes y streaming en Python o SQL.
Los trabajos tradicionales de Spark son esenciales: debe codificar cada paso: leer este código fuente, aplicar esta transformación, escribir en esta tabla, así como controlar la secuencia de ejecución y muchos otros detalles técnicos usted mismo. SDP invierte este modelo. Es declarativo: usted describe el resultado deseado y Spark determina cómo llegar allí.
Databricks creó originalmente SDP como Delta Live Tables (DLT) y lo contribuyó al proyecto de código abierto Apache Spark en Data + AI Summit 2025.
¿Cómo funciona SDP?
Spark Declarative Pipelines (SDP) define cómo las transformaciones actualizan conjuntos de datos en una canalización. SDP automáticamente:
- Resuelve las dependencias entre conjuntos de datos y transformaciones
- Determina el orden de ejecución en los pasos de la canalización
- Ejecuta tareas independientes en paralelo para mejorar el rendimiento y la eficiencia
Una canalización SDP se crea a partir de componentes principales clave.
En estos tutoriales no necesitará flujos ni vistas temporales, pero tenga en cuenta estos elementos cuando las canalizaciones se vuelvan más complejas.
Eso es suficiente para crear su primera canalización de datos SDP. Vamos.
Tutoriales de Spark Declarative Pipelines (SDP)
A continuación se muestra un solo ejemplo, presentado en dos entornos diferentes. Uno se ejecuta localmente con PySpark de código abierto y el otro se ejecuta en la nube en una cuenta (gratuita para siempre) de Databricks Free Edition. Ambos tutoriales de SDP (el tutorial local de PySpark y el tutorial de Lakeflow Declarative Pipelines) le guiarán a través del mismo caso de uso: crear una tubería que ingiere y procese datos de aviación en vivo procedentes de aeronaves de todo el mundo.
Fuente de datos OpenSky
Ambos tutoriales utilizan un origen de datos PySpark personalizado que se conecta a la API REST de OpenSky Network. La Red OpenSky agrega datos de vigilancia del tráfico aéreo aportados por entusiastas de la aviación de todo el mundo, creando una imagen en tiempo real del tráfico aéreo mundial. La API REST de OpenSky es gratuita para uso no comercial, pero se aplican límites de velocidad. Consulte los documentos de la API de OpenSky para conocer los umbrales actuales.
La recopilación de datos de OpenSky Network es de colaboración colectiva: cualquiera puede contribuir configurando un receptor ADS-B de bajo costo. Los datos que procesará en estos tutoriales existen porque miles de voluntarios de todo el mundo han hecho exactamente eso. Envíe sus datos a la Red OpenSky si desea convertirse en uno de ellos.
Cada ejecución de la tubería SDP recibe actualizaciones en vivo de posición, velocidad y altitud de las aeronaves actualmente en vuelo, con nuevos datos que llegan cada pocos segundos. El origen de datos es un origen de datos PySpark de código abierto, por lo que funciona tanto en Spark normal como en Spark Declarative Pipelines.
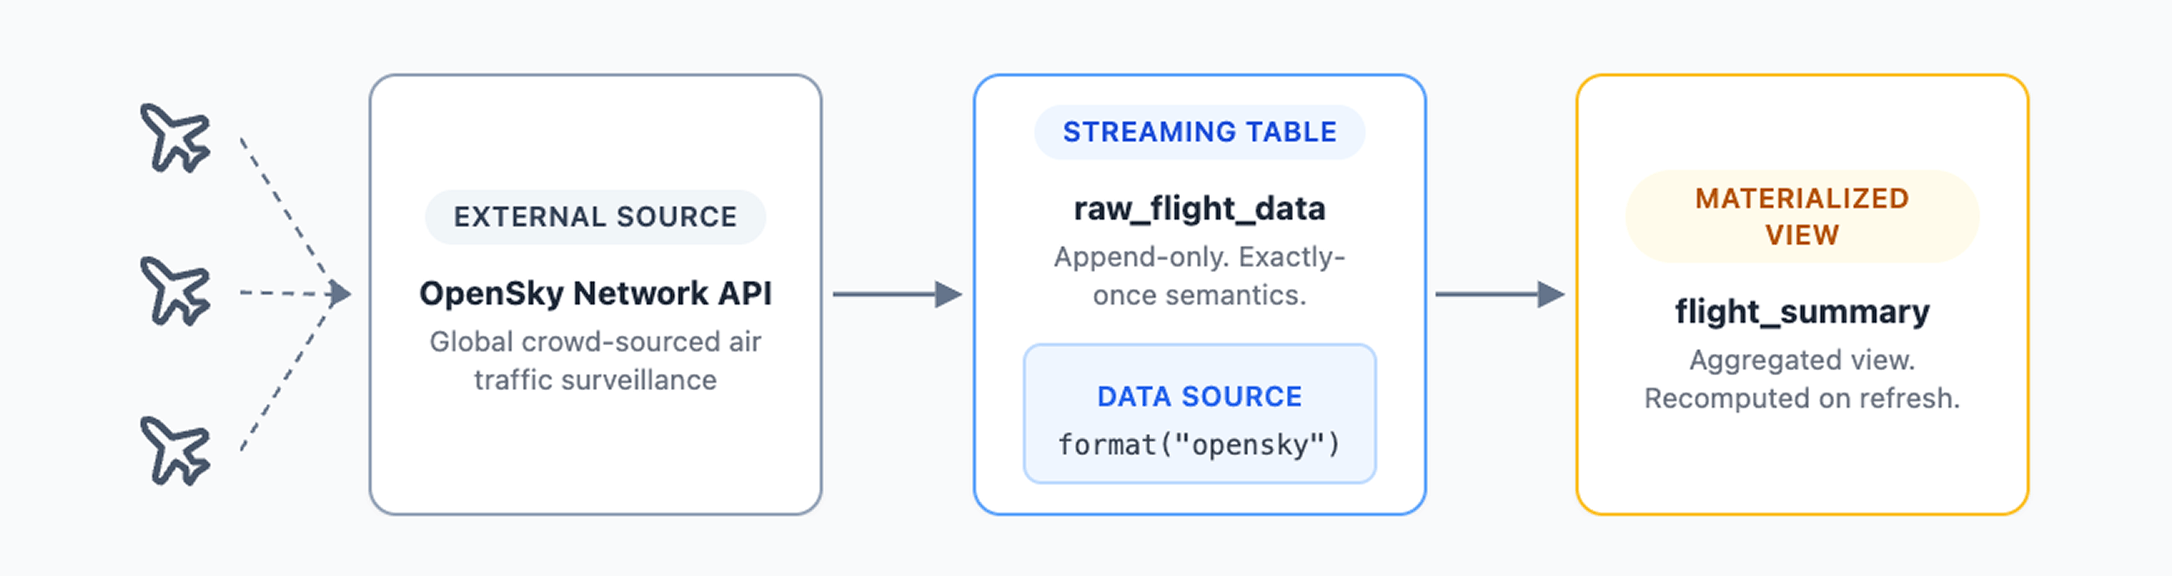
Estos son datos reales de IoT a escala de producción. El mismo tipo que impulsa plataformas logísticas, sistemas de seguimiento de carga y operaciones de supervisión portuaria. No se trata de un archivo CSV de muestra estático: cada ejecución de tuberías extrae datos en vivo de aeronaves actualmente en vuelo.
La única diferencia entre los dos tutoriales es dónde se ejecutan.
Tutorial local de PySpark (código abierto)
El tutorial local de PySpark le guía a través de la creación de una canalización declarativa desde cero en su equipo local utilizando PySpark y cualquier editor que prefiera. Incluye:
- Control total sobre el entorno de desarrollo y elección del IDE
- Acceso directo a los archivos de salida de Parquet en su sistema de archivos local
- Pila de código abierto 100 % sin dependencias propietarias
Requisitos: Python 3.12, Java 17, PySpark 4.1 y un IDE como VS Code
Tutorial de Lakeflow (edición gratuita de Databricks)
El tutorial Lakeflow es la ruta más rápida para una canalización en ejecución. Lakeflow es la implementación gestionada por Databricks de Spark Declarative Pipelines, basada en el mismo núcleo de código abierto con capacidades empresariales adicionales. Incluye:
- Informática sin servidor con escalado automático, sin necesidad de configuración de clúster
- Editor de canalizaciones integrado con exploración de datos basada en IA
- Tablas de salida registradas en el catálogo de Unity con seguimiento automático de linaje
- Sin configuración local, todo se ejecuta en la nube
Requisitos: cuenta Databricks Free Edition (sin tarjeta de crédito, nunca caduca)
Preguntas frecuentes
Spark Declarative Pipelines (SDP) es un marco declarativo nativo integrado en Apache Spark 4.1 o posterior para crear canalizaciones de datos fiables por lotes y streaming en Python o SQL. Usted declara qué datos deben existir, su origen, su forma y cómo se actualizan, y Spark se encarga de la resolución de dependencias, el orden de ejecución y el procesamiento paralelo. Simplemente ejecute su canalización declarativa y Spark se encargará del resto.
Última actualización: agosto de 2026
Autor: Frank Munz