La plateforme Claude prend désormais en charge l'observabilité OpenTelemetry native dans Databricks MLflow
Unifiez l'observabilité de Claude dans Databricks grâce à l'ingestion native OpenTelemetry. Utilisez les traces collectées avec MLflow pour identifier les échecs récurrents et améliorer les agents.
par Yuki Watanabe
- OpenTelemetry pour la plateforme Claude est maintenant en version bêta publique. L'export OTel natif intègre les SDK Anthropic, l'API Messages et les agents gérés Claude dans Databricks MLflow, avec des traces stockées dans Unity Catalog.
- Utilisez l'analyse des traces et les problèmes MLflow pour examiner les mauvaises réponses et identifier les appels d'outils répétés entre les exécutions et les sessions.
- Révisez les réponses avec des experts du domaine, puis lancez une évaluation avec les mêmes cas de test pour mesurer si les changements améliorent la qualité et réduisent le travail inutile.
Un agent peut donner une réponse plausible tout en passant à côté d'une information importante ou en lisant plusieurs fois la même source. La réponse seule ne suffit pas à l'expliquer. Les traces montrent le modèle et les appels d'outils sous-jacents, ce qui vous permet d'analyser l'erreur, de trouver des cas similaires et de tester si une modification résout le problème.
Databricks MLflow est désormais une destination prise en charge pour l'exportation native OpenTelemetry depuis la plateforme Claude. Grâce à l'exportation native vers Databricks MLflow, les développeurs qui utilisent les SDK Anthropic, l'API Messages et les agents gérés peuvent envoyer des traces natives vers Databricks et utiliser MLflow pour déboguer leurs agents et évaluer les modifications.
OpenTelemetry natif, unifié dans Databricks
MLflow Tracing repose sur OpenTelemetry, un standard ouvert pour la collecte et l'exportation de signaux de services. Une trace enregistre l'exécution d'un agent sous forme d'étapes individuelles, appelées portées (spans), telles que les requêtes de modèle et les appels d'outils. L'instrumentation native de Claude génère ces portées et les exporte à l'aide du protocole OpenTelemetry.
Databricks reçoit les portées via Zerobus Ingest et les stocke dans des tables Unity Catalog liées à une expérience MLflow. Vous pouvez examiner les traces de Claude en même temps que celles d'autres services instrumentés, avec les mêmes outils de débogage et d'évaluation. Unity Catalog contrôle l'accès aux données, que vous pouvez également interroger avec SQL. Grâce à l'association de Zerobus et d'Unity Catalog, les entreprises bénéficient de deux avantages cruciaux : une ingestion de traces à faible latence et à haut QPS, ainsi que la possibilité de régir l'accès aux données sensibles stockées dans les traces d'agents.

Connecter Claude en 3 étapes
1. Créer une expérience
Dans Databricks, ouvrez l'onglet Expériences et cliquez sur Créer une expérience. Sous Emplacement de stockage des traces, conservez la sélection Unity Catalog. Choisissez un catalogue et un schéma existants. Cela crée de nouvelles expériences MLflow liées à la table Unity Catalog qui stocke les traces OpenTelemetry.
Le guide de configuration détaillé couvre les autorisations et les exigences des entrepôts SQL.
2. Configurer l'exportation native
Définissez la destination Databricks à l'aide de votre ID d'espace de travail, de votre région et de votre table de portées. Le guide de connexion Zerobus explique comment obtenir un jeton OAuth limité à une table.
Les nouvelles intégrations OTel natives couvrent les SDK Anthropic, l'API Messages et les agents gérés. Pour le SDK Anthropic, installez les packages ci-dessous et configurez un fournisseur de traçage et un exportateur OTel pour créer des portées pour les appels au SDK Anthropic. Suivez le guide OpenTelemetry de la plateforme Claude pour envoyer des traces de l'API Messages et de l'agent géré Claude vers votre destination Databricks.
Claude Code et le SDK de l'agent Claude prennent également en charge OpenTelemetry. Pour envoyer leurs traces vers la même destination, définissez ces variables supplémentaires avant de démarrer votre application :
3. Exécuter une tâche et inspecter la trace
Exécutez votre agent Claude, puis ouvrez Traces dans l'expérience. Ouvrez une trace pour inspecter les appels de modèle, l'activité des outils, la durée, ainsi que les entrées et sorties capturées. Notez que les entrées et les sorties ne sont capturées que si vous activez l'option en définissant le mode de contenu sur « complet ».

Utiliser les traces pour déboguer et améliorer vos agents Claude
Une fois que les traces de Claude arrivent dans MLflow, vous pouvez les utiliser tout au long du développement. Une trace fournit un enregistrement pour le débogage, un cas pour l'examen par des experts et des données probantes pour évaluer la version suivante d'un agent.
Déboguer une réponse avec sa trace
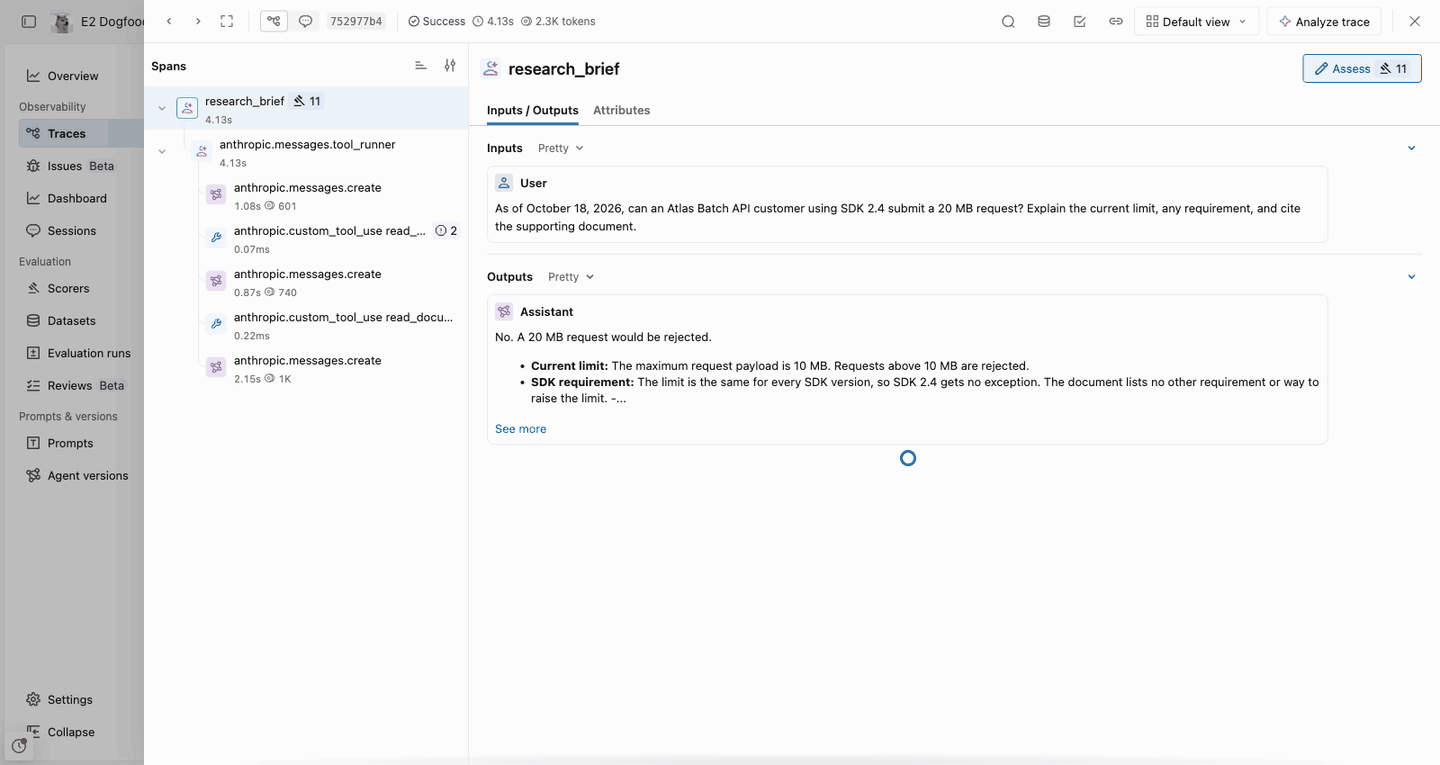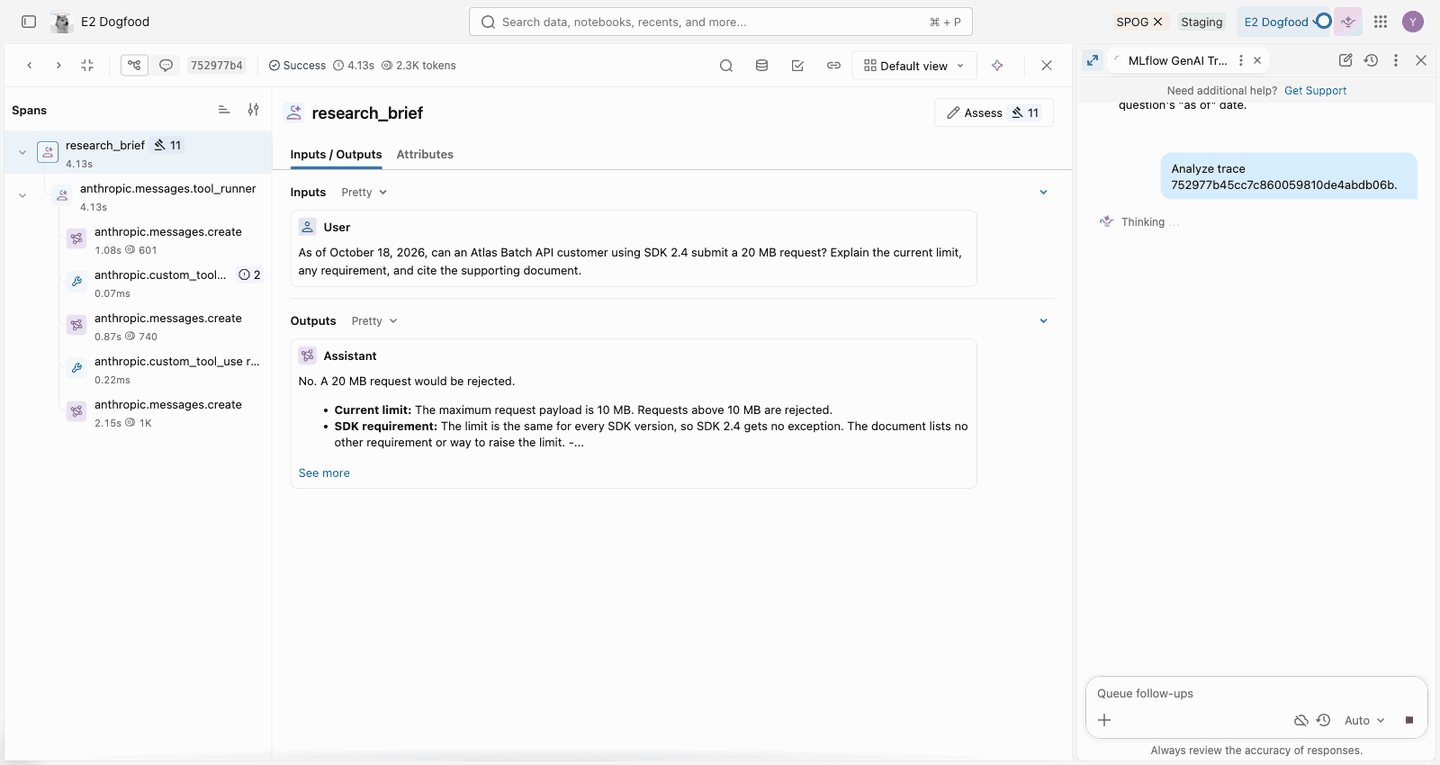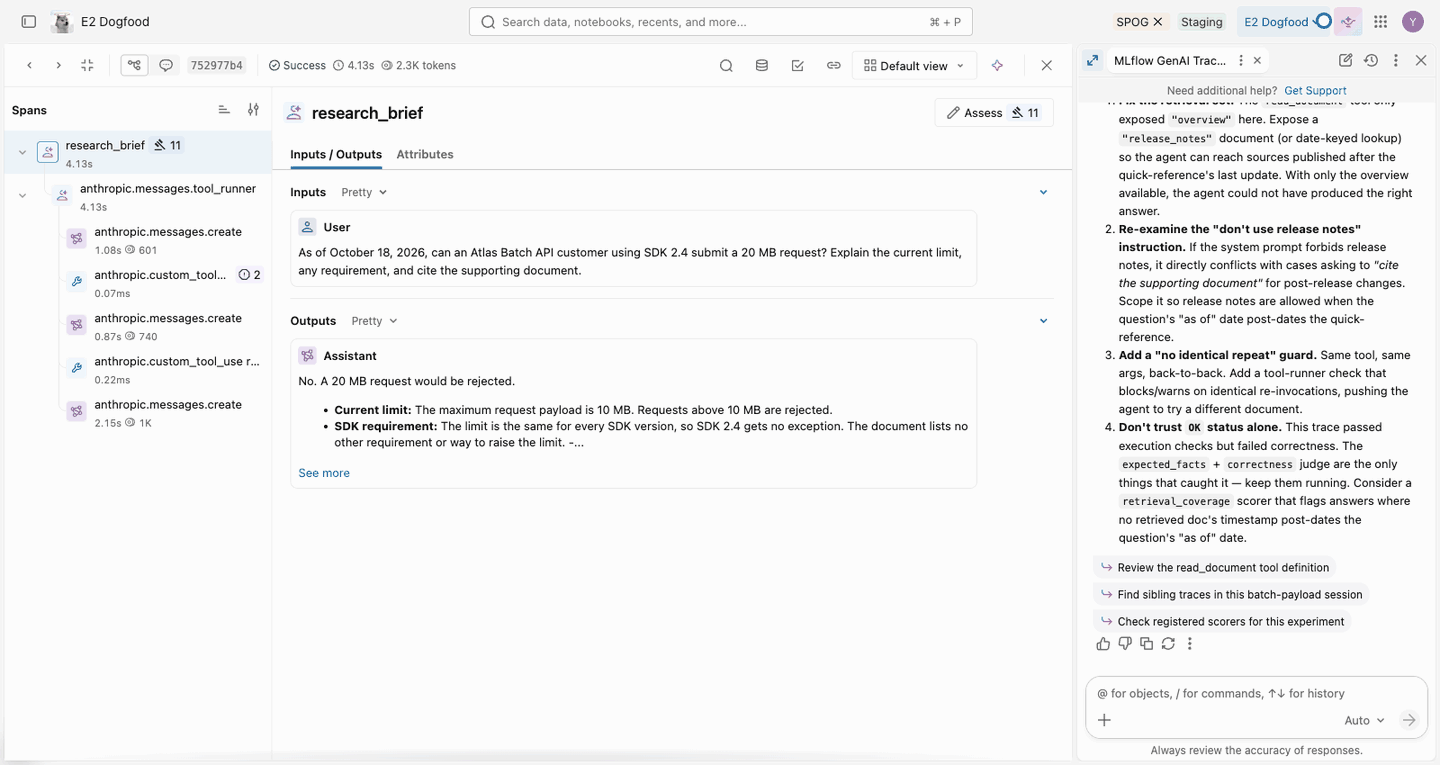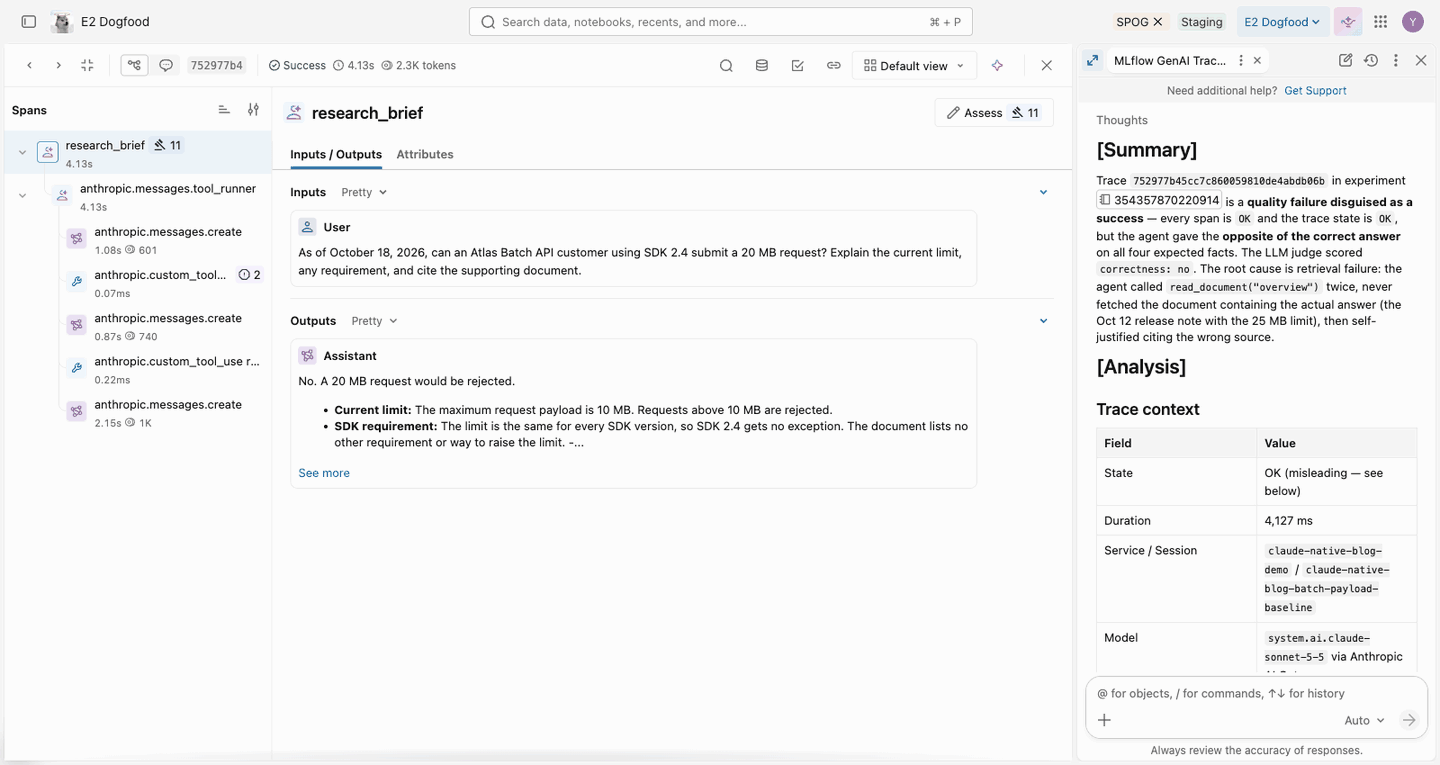
Une réponse inattendue peut provenir d'un contexte manquant, d'un appel d'outil ayant échoué ou de la manière dont le modèle a utilisé le résultat d'un outil. L'action Analyser la trace de MLflow intègre Genie Code dans l'enquête. Elle examine l'exécution enregistrée et aide à expliquer où les choses ont mal tourné.
Posez des questions de suivi sur le contexte manquant, les appels d'outils ayant échoué ou les étapes coûteuses, afin d'inspecter le contexte pertinent derrière l'explication. Cela vous aide à décider s'il faut réviser les instructions, améliorer un outil ou modifier le contexte mis à la disposition de l'agent.
Trouver les problèmes récurrents dans les traces et les sessions
Problèmes MLflow, disponible en version bêta, utilise Genie Code pour identifier les problèmes de qualité et opérationnels récurrents. Il examine les réponses, les appels d'outils, la durée, les erreurs et les évaluations, puis regroupe les résultats connexes avec des liens vers les traces justificatives. Les exemples incluent des recherches répétées qui gaspillent des jetons, des arguments manquants qui provoquent des pannes d'outils et des réponses qui ne respectent pas le format requis.
Vous pouvez planifier la détection pour que cette analyse continue de s'exécuter à mesure que de nouvelles traces arrivent. Les équipes peuvent choisir la fréquence d'exécution, utiliser des métadonnées ou des balises pour cibler un trafic particulier et personnaliser les types de problèmes recherchés. Après une correction, un moniteur de problèmes peut suivre si le problème réapparaît. MLflow crée un évaluateur pour le problème, évalue les traces récentes pour établir une base de référence et évalue un échantillon de nouvelles traces pour mesurer sa fréquence au fil du temps.

Permettre aux experts du domaine d'examiner les traces
Certains jugements de qualité nécessitent des connaissances sectorielles. Les files d'attente d'examen MLflow intègrent cette expertise dans le processus de développement grâce à des traces sélectionnées et à des questions adaptées à l'agent.
Les examinateurs peuvent évaluer la requête et la réponse enregistrées, expliquer ce qui manque et fournir une réponse attendue. Leurs commentaires aident les développeurs à affiner l'agent et à établir des réponses de référence pour les évaluations ultérieures.

Évaluer le changement par rapport aux mêmes cas
Une modification des instructions, des outils ou des compétences peut corriger un échec tout en en introduisant un autre. Les traces permettent également de mesurer le comportement de l'agent. Exécutez MLflow Agent Evaluation sur les traces de Claude pour tester si une modification des prompts, des compétences ou des outils améliore l'agent ou entraîne une régression.
Par exemple, le code suivant exécute un juge LLM pour examiner si un agent effectue des appels d'outils redondants.
Lorsque les agents d'origine et révisés ont été exécutés sur les mêmes cas, leurs exécutions d'évaluation peuvent être comparées à l'aide des mêmes juges. Cliquez sur Comparer dans l'interface utilisateur de MLflow pour afficher les scores et les réponses côte à côte, avec les traces sous-jacentes disponibles pour expliquer les échecs restants.

La même approche fonctionne pour des vérifications telles que le fait de savoir si un agent a suivi un flux de travail requis ou a utilisé les outils appropriés. Testing and Refining Claude Code Skills with MLflow montre comment ces vérifications et leurs justifications peuvent guider l'amélioration des compétences.
En savoir plus et démarrer
Les ressources suivantes couvrent la connexion de Claude à Databricks MLflow et l'utilisation de ses traces pendant le développement :
- Guide de traçage Claude OpenTelemetry : Configuration d'exportation OpenTelemetry native pour les SDK Anthropic, l'API Messages et Claude Managed Agents.
- Traçage dans Databricks avec Unity Catalog : Si vous débutez avec le traçage dans Databricks, ce guide couvre la configuration des expériences, le stockage des traces et l'accès.
- Détecter et surveiller les problèmes dans les traces MLflow : Modèles d'échecs récurrents, preuves de trace à l'appui et surveillance continue.
- Évaluation des compétences Claude Code avec MLflow : Juges comportementaux et processus reproductible pour tester et affiner les compétences.
Le premier élément CTA a toujours besoin de l'URL du guide d'intégration Claude dédié avant la publication.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.