Comment démarrer avec Spark Declarative Pipelines (SDP)
Les pipelines de données déclaratives sont devenus une fonctionnalité native de Spark dans Apache Spark 4.1. Pas de cadres supplémentaires. Aucune dépendance externe. Pas de nouvelle courbe d'apprentissage. Des millions d'utilisateurs Spark peuvent désormais créer des pipelines ETL de qualité production, à l'aide des outils qu'ils connaissent et apprécient déjà.
L'exemple utilisé ici, un pipeline de production qui suit chaque avion dans le ciel avec des millions d'événements IoT en direct diffusés chaque seconde, était autrefois un effort d'ingénierie sérieux. Maintenant, cela peut être fait pendant une pause-café, avec quelques lignes de code et 100 % open source.
Figure : Visualisation des données aéronautiques OpenSky avec les applications Databricks
Qu'est-ce que Spark Declarative Pipelines ?
Spark Declarative Pipelines (SDP) est un framework déclaratif natif permettant de créer des pipelines de données par lots et en flux fiables en Python ou SQL.
Les tâches Spark traditionnelles sont impératives : vous devez coder chaque étape : lire cette source, appliquer cette transformation, écrire dans cette table, ainsi que contrôler vous-même la séquence d'exécution et de nombreux autres détails techniques. SDP inverse ce modèle. Il est déclaratif : vous décrivez le résultat souhaité et Spark détermine comment y parvenir.
Databricks a créé SDP à l'origine sous le nom de Delta Live Tables (DLT) et l'a contribué au projet open source Apache Spark lors du sommet Data + AI 2025.
Comment fonctionne SDP ?
Les pipelines déclaratifs Spark (SDP) définissent la manière dont les transformations mettent à jour les jeux de données dans un pipeline. SDP automatiquement :
- Résolution des dépendances entre jeux de données et transformations
- Détermine l'ordre d'exécution des étapes du pipeline
- Exécute des tâches indépendantes en parallèle pour améliorer les performances et l'efficacité
Un pipeline SDP est construit à partir de composants clés de base.
Vous n'aurez pas besoin de flux ou de vues temporaires dans ces didacticiels, mais gardez-les à l'esprit lorsque vos pipelines deviennent plus complexes.
C'est suffisant pour créer votre premier pipeline de données SDP. Allons-y.
Tutoriels sur Spark Declarative Pipelines (SDP)
Voici un exemple unique, présenté dans deux environnements différents. L'un fonctionne localement avec PySpark open source, et l'autre fonctionne dans le cloud sur un compte Databricks Free Edition (gratuit à jamais). Les deux didacticiels SDP (le didacticiel PySpark local et le didacticiel Lakeflow Declarative Pipelines) vous guident à travers le même cas d'utilisation : créer un pipeline qui ingère et traite des données aéronautiques en temps réel provenant d'avions du monde entier.
Source de données OpenSky
Les deux didacticiels utilisent une source de données PySpark personnalisée qui se connecte à l'API REST OpenSky Network. Le réseau OpenSky rassemble les données de surveillance du trafic aérien fournies par les passionnés d'aviation du monde entier, créant ainsi une image en temps réel du trafic aérien mondial. L'API REST OpenSky est gratuite pour une utilisation non commerciale, mais elle est soumise à des limites de débit. Veuillez consulter la documentation API OpenSky pour connaître les seuils actuels.
La collecte de données OpenSky Network est participative : tout le monde peut contribuer en installant un récepteur ADS-B peu coûteux. Les données que vous allez traiter dans ces didacticiels existent parce que des milliers de volontaires dans le monde entier ont fait exactement cela. Envoyez vos données au réseau OpenSky si vous souhaitez en faire partie.
Chaque pipeline SDP reçoit des mises à jour en temps réel de position, de vitesse et d'altitude des avions en vol, avec de nouvelles données arrivant toutes les quelques secondes. La source de données est une source de données PySpark open source, elle fonctionne donc aussi bien dans Spark standard que dans les pipelines déclaratifs Spark.
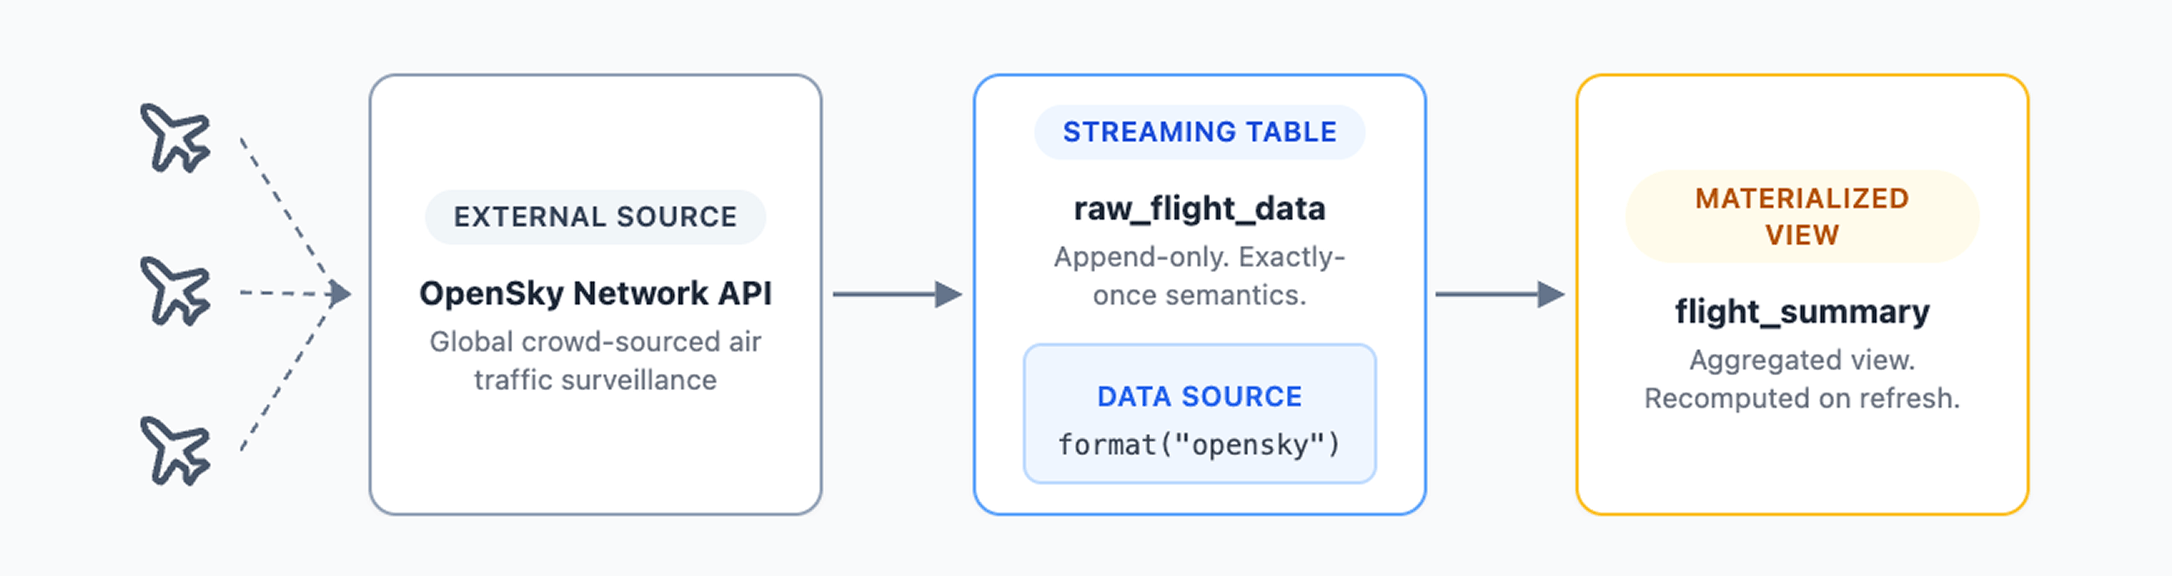
Ce sont de véritables données IoT à l'échelle de production. Le même type qui anime les plateformes logistiques, les systèmes de suivi des marchandises et les opérations de surveillance portuaire. Il ne s'agit pas d'un exemple de fichier CSV statique : chaque pipeline exploite des données en direct provenant d'avions actuellement en vol.
La seule différence entre les deux didacticiels est l'endroit où vous les exécutez.
Tutoriel local PySpark (open source)
Le didacticiel local de PySpark vous guide dans la création d'un pipeline déclaratif à partir de zéro sur votre ordinateur local à l'aide de PySpark et de l'éditeur de votre choix. Il comprend :
- Contrôle total de votre environnement de développement et choix de l'IDE
- Accès direct aux fichiers de sortie Parquet sur votre système de fichiers local
- Stack 100 % open source sans dépendances propriétaires
Configuration requise : Python 3.12, Java 17, PySpark 4.1 et un IDE tel que VS Code
Tutoriel Lakeflow (édition gratuite de Databricks)
Le didacticiel Lakeflow est le moyen le plus rapide d'accéder à un pipeline en cours d'exécution. Lakeflow est l'implémentation gérée par Databricks de Spark Declarative Pipelines, basée sur le même noyau open source et dotée de fonctionnalités d'entreprise supplémentaires. Il comprend :
- Calcul sans serveur avec mise à l'échelle automatique, aucune configuration de cluster requise
- Éditeur de pipeline intégré avec exploration des données basée sur l'IA
- Tables de sortie enregistrées dans le catalogue Unity avec suivi automatique des lignées
- Aucune configuration locale, tout fonctionne dans le cloud
Conditions requises : compte Databricks Free Edition (pas de carte de crédit, n'expire jamais)
FAQ
SDP (Spark Declarative Pipelines) est un framework déclaratif natif intégré à Apache Spark 4.1 ou version ultérieure pour créer des pipelines de données par lots et en flux fiables en Python ou SQL. Vous déclarez quelles données doivent exister, leur source, leur forme et leur mode de mise à jour, et Spark gère la résolution des dépendances, l'ordre d'exécution et le traitement parallèle. Il suffit d'exécuter votre pipeline déclaratif, et Spark se charge du reste.
Dernière mise à jour : août 2026
Auteur : Frank Munz