Umidifica la tua produttività e i dati AI con Lakeflow Connect
Riunisci documenti, ticket, e-mail e strumenti di IA in un'unica base con governance grazie a Lakeflow Connect per alimentare agenti di IA e analisi di Genie
- Gli strumenti di produttività e collaborazione contengono la conoscenza aziendale più preziosa, ma storicamente questi dati sono rimasti isolati in decine di applicazioni separate, dietro un'integrazione API personalizzata per ogni origine.
- Lakeflow Connect offre connettori nativi e completamente gestiti per Atlassian (Jira, Confluence), Microsoft (SharePoint, Outlook), Google Workspace (Drive, Gmail), GitHub e i principali provider di IA (OpenAI, Anthropic) con governance unificata e nessuna infrastruttura da gestire.
- Poiché sia i dati non strutturati che quelli strutturati arrivano direttamente in Unity Catalog, i team di dati possono alimentare facilmente basi di conoscenza aziendali, agenti di IA e dashboard di produttività per gli sviluppatori senza dover creare o mantenere pipeline di dati personalizzate.
Questo è il secondo articolo della nostra serie su come Lakeflow Connect porta l'ingestione di dati completamente gestita in ogni reparto aziendale. Dopo il nostro approfondimento sull'unificazione dei dati di marketing, questo post si concentra sullo sblocco della conoscenza aziendale intrappolata nello stack di produttività della tua organizzazione. Esploreremo come i connettori nativi per wiki, strumenti di gestione dei progetti e modelli di fondazione di IA forniscano ai tuoi agenti di IA downstream il contesto aziendale completo di cui hanno bisogno.
Una piattaforma, qualsiasi origine
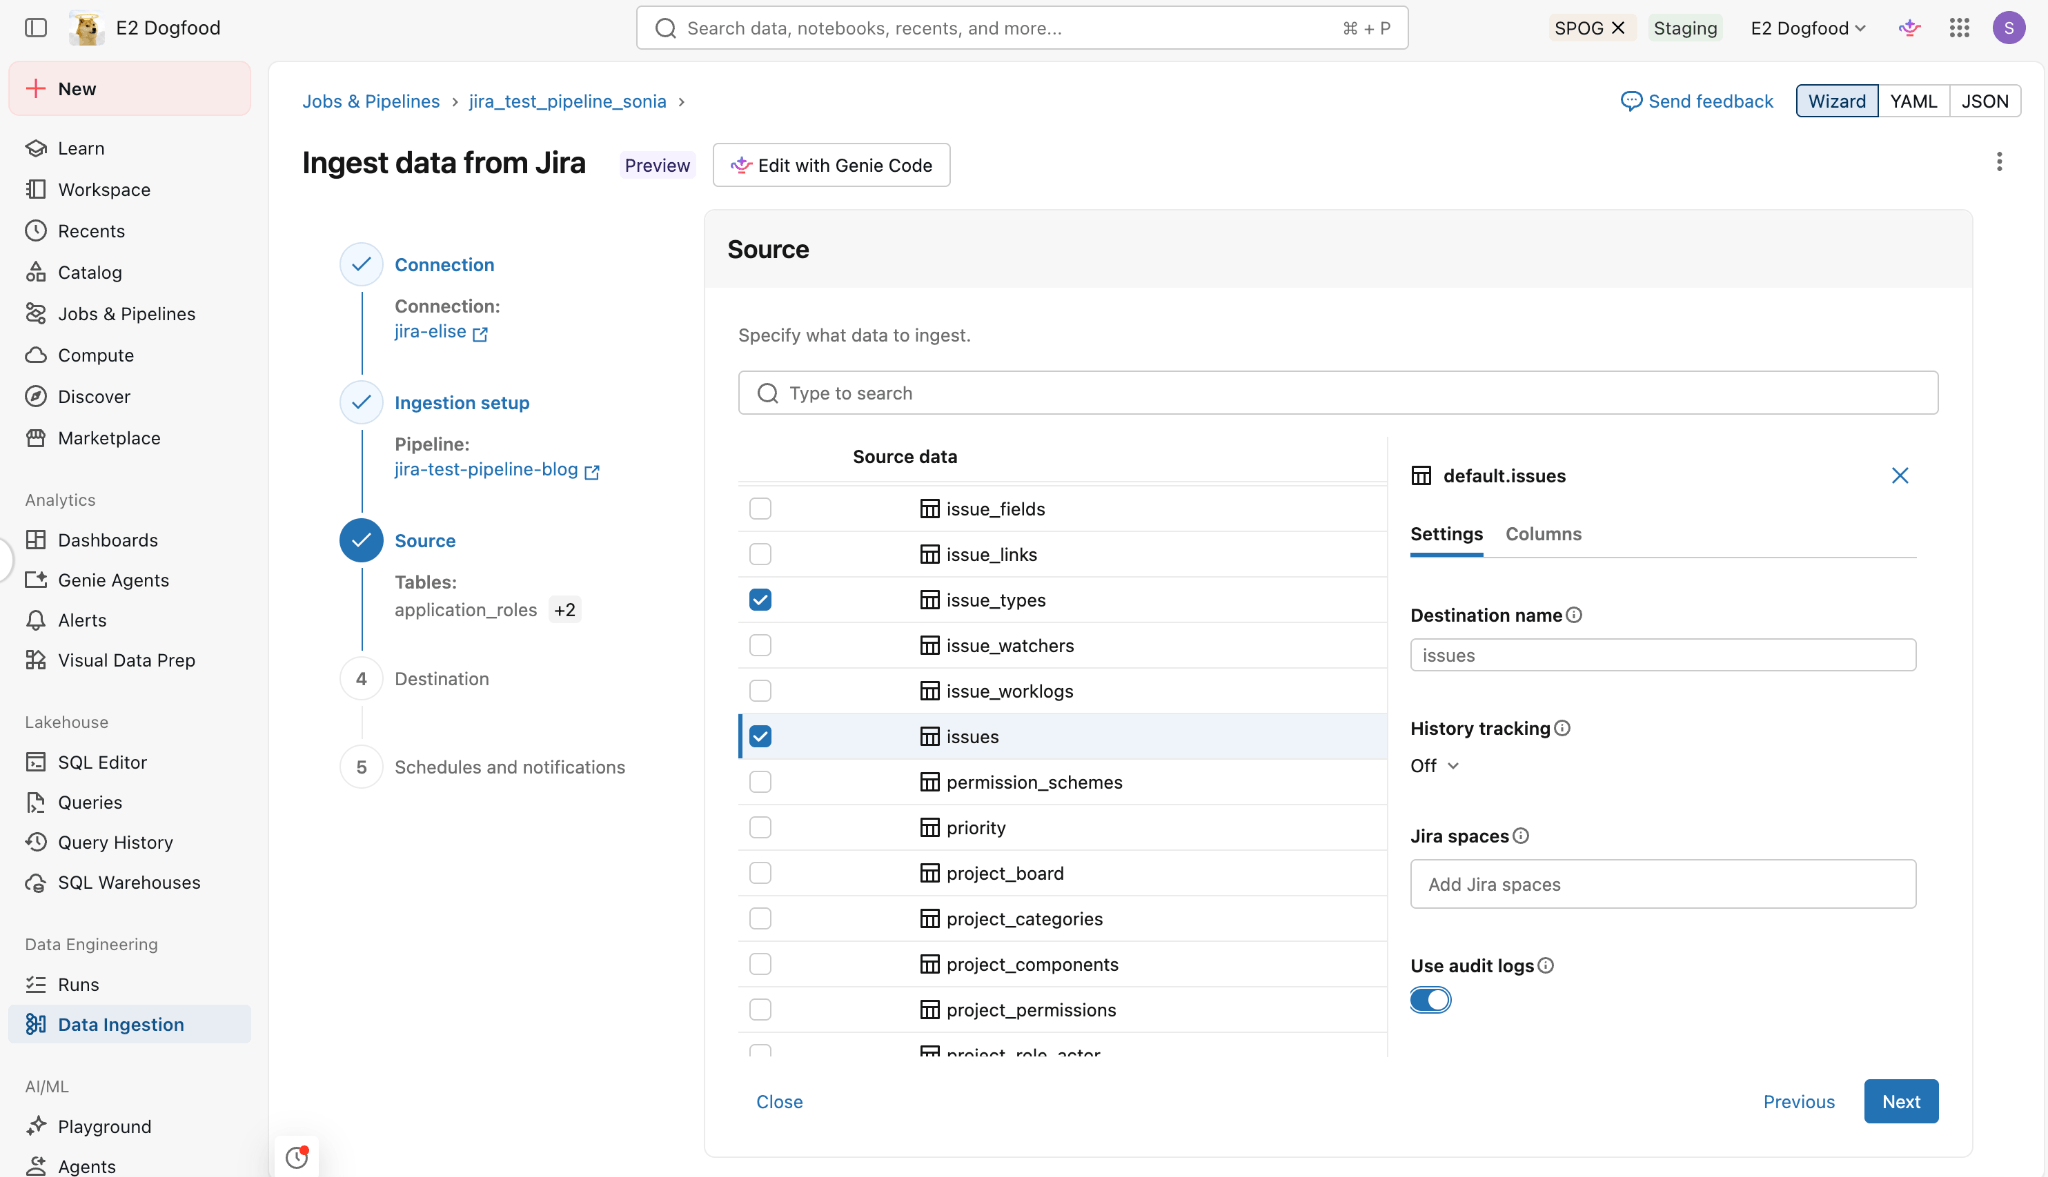
Lakeflow Connect offre una suite completa di connettori nativi completamente gestiti tra applicazioni SaaS, database e origini di file che inseriscono i tuoi dati direttamente nella Databricks Platform. Ciascun connettore può essere configurato tramite un'interfaccia utente punta e clicca o una semplice API. Da lì, i tuoi dati vengono inseriti in modo incrementale come tabelle gestite e soggette a governance in Unity Catalog, senza infrastrutture da configurare, gestire o scalare.
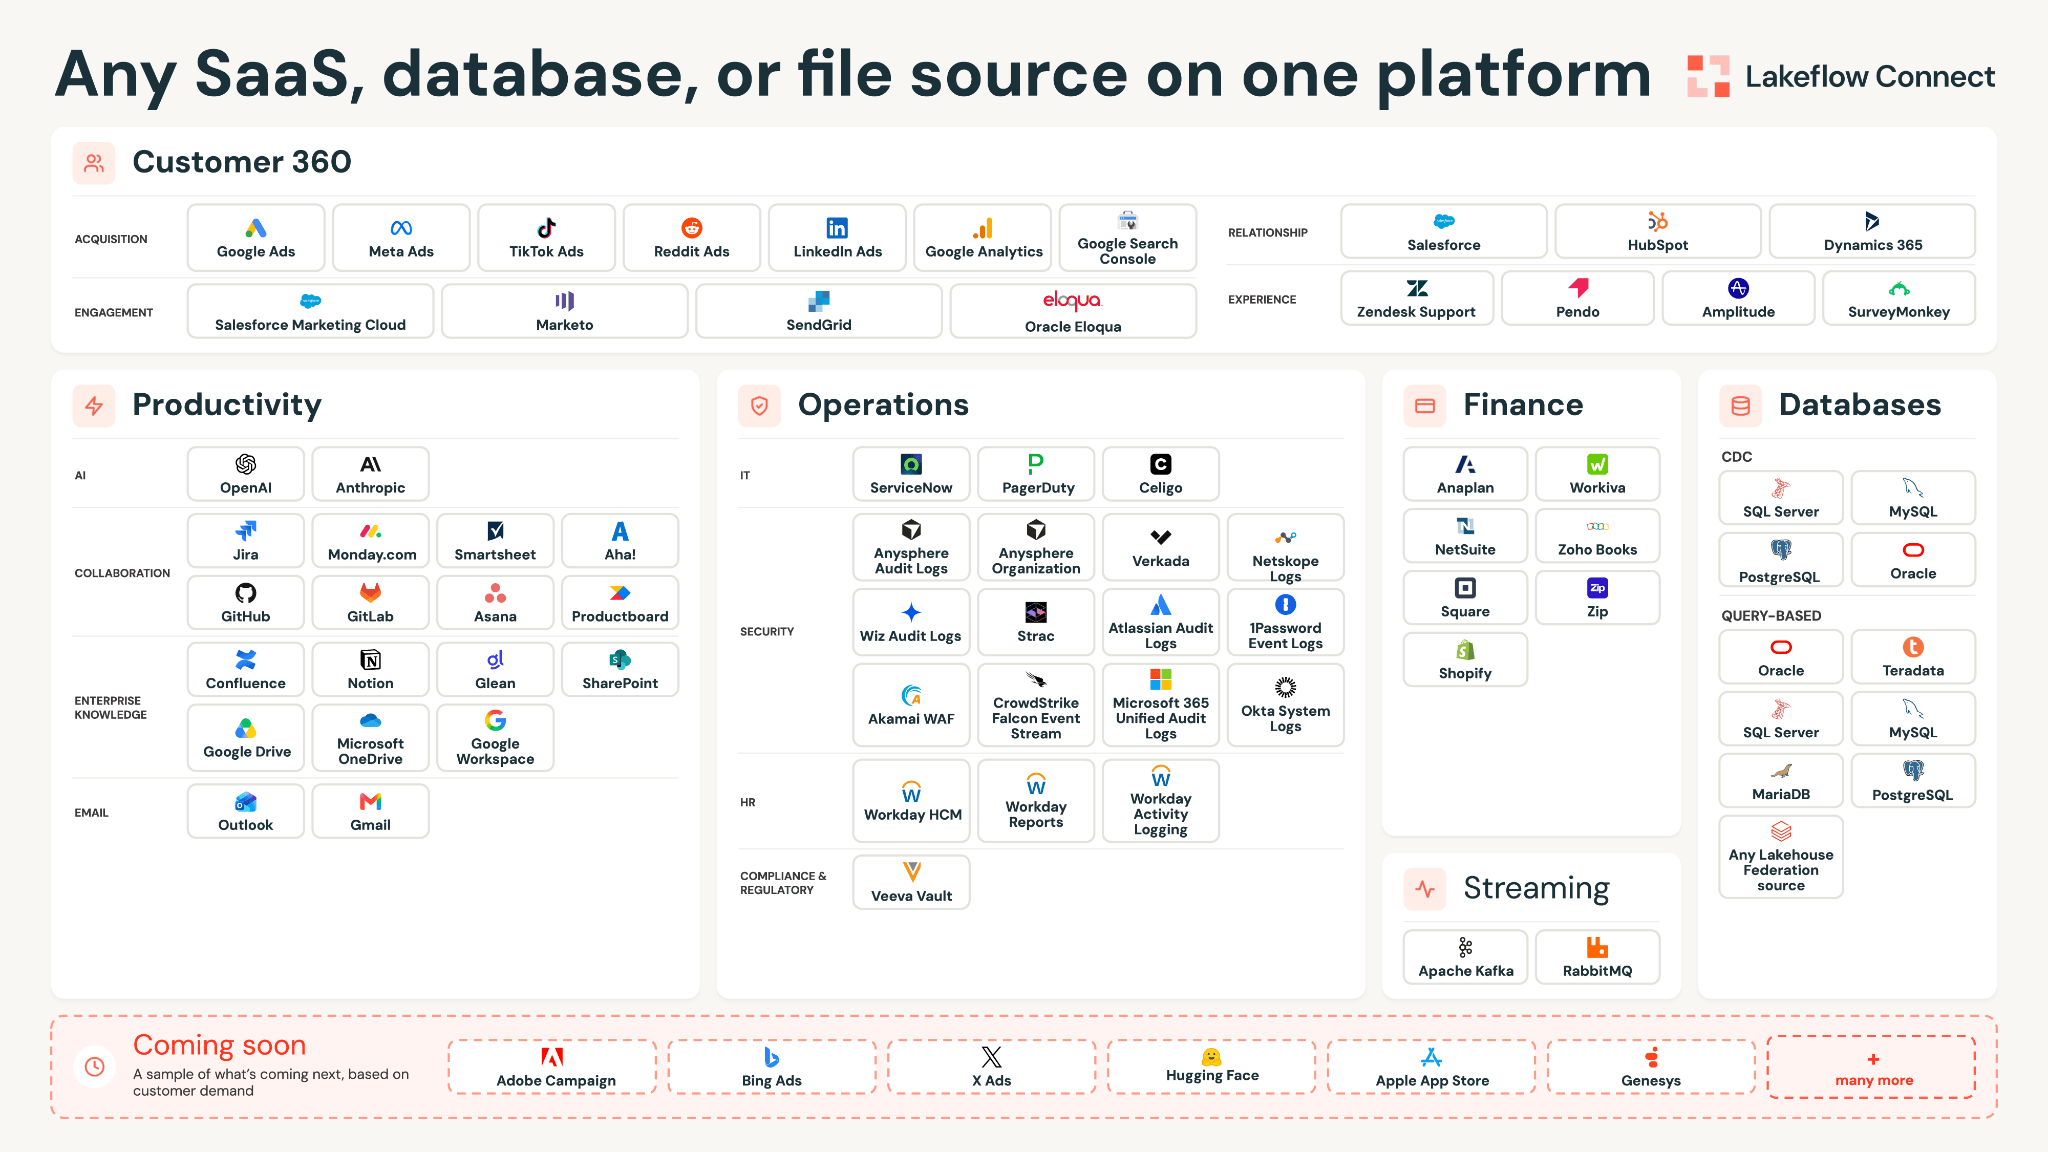
Prioritizzati in base alle richieste dei clienti, i connettori di ingestione di Lakeflow Connect coprono ogni reparto aziendale, tra cui Customer 360, Operations, Finanza e Produttività, ovvero lo stack più vicino al lavoro quotidiano.
Una piattaforma, ogni strumento di produttività
Lo stack di produttività dell'azienda media è un insieme frammentato di tracker di progetti, wiki, archivi di documenti, caselle di posta e strumenti di IA, ognuno dei quali contiene solo una parte di come viene svolto il lavoro. Estrarre questi dati ha storicamente richiesto una serie di pipeline personalizzate, lente da costruire e difficili da mantenere. L'asticella è abbastanza alta che i casi d'uso più importanti rimangono fuori portata, ad esempio: agenti di IA alimentati dalla conoscenza interna della tua azienda o visibilità sull'analisi operativa.
Lakeflow Connect risolve questo problema fornendo connettori integrati per l'ingestione trasparente da tutto lo stack di produttività:
- COLLABORATION: Come viene tracciato e rilasciato il lavoro? Jira, Monday.com, Smartsheet, Aha! e GitHub
- ENTERPRISE KNOWLEDGE: Su quale competenza collettiva si basa la tua azienda? Confluence, Notion, Glean, SharePoint e Google Drive
- EMAIL: Come comunicano i tuoi team? Outlook e Gmail
- AI: In che modo la tua organizzazione sta adottando l'IA? OpenAI e Anthropic
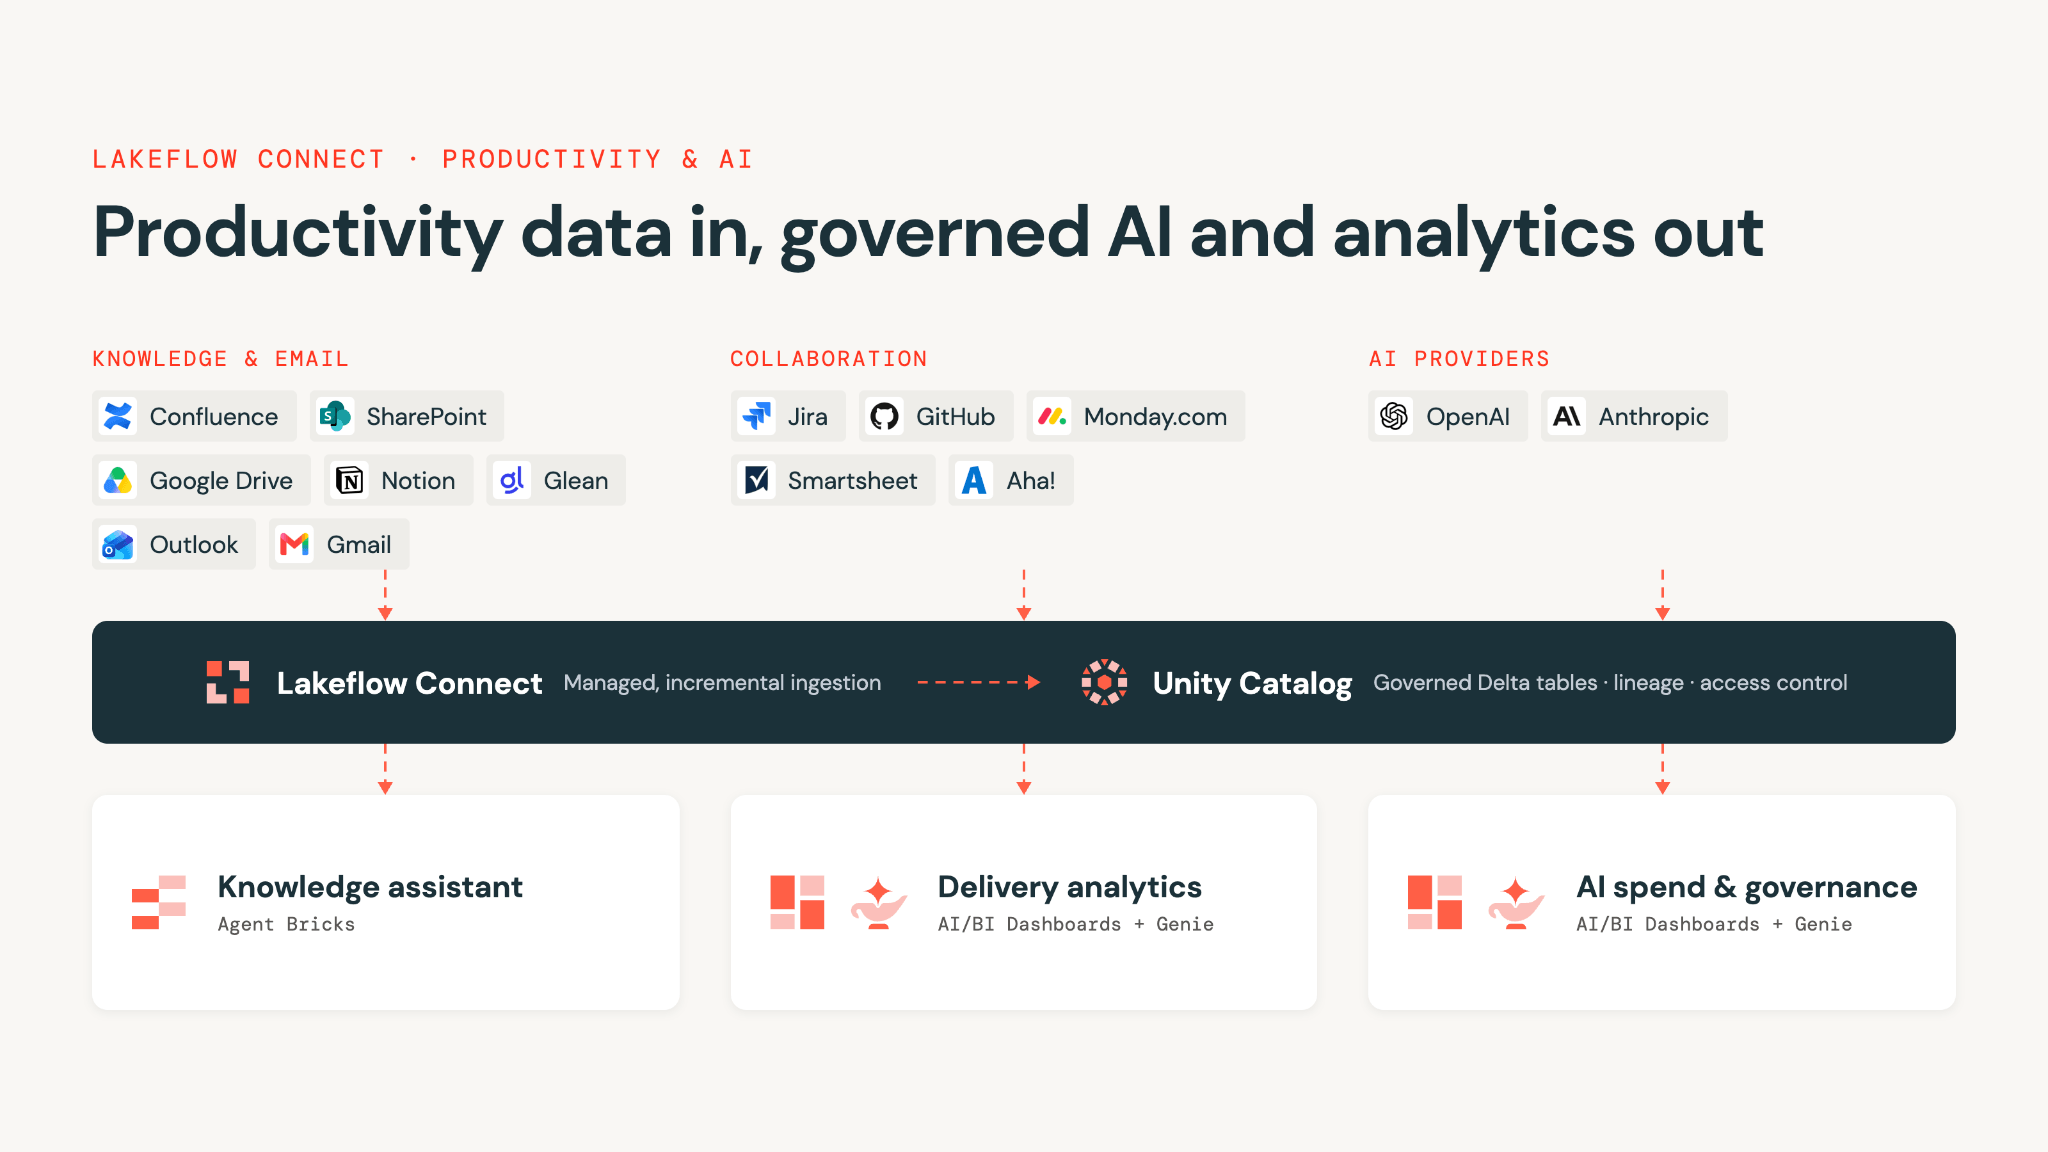
Grazie a questa vasta gamma di connettori, Lakeflow Connect diventa il motore di ingestione che unisce dati di produttività sparsi in un'unica base soggetta a governance, eliminando i colli di bottiglia dell'integrazione che tradizionalmente rallentano i team.
Ad esempio, Toyota Finance Australia, la divisione finanziaria di una delle case automobilistiche più grandi del mondo, utilizza Lakeflow Connect per importare i suoi dati Jira in Databricks come pipeline completamente gestita e a zero manutenzione.
“Lakeflow Connect per Jira ha trasformato il modo in cui integriamo e utilizziamo i dati di Jira all'interno della nostra piattaforma di gestione dei dati aziendali. Il passaggio all'esperienza completamente gestita e basata su interfaccia utente offerta da Databricks ha fornito una pipeline trasparente e a zero manutenzione che gestisce automaticamente la complessità delle API e le modifiche dello schema, offrendo al contempo tabelle Delta pronte per l'analisi e soggette a governance nel Databricks Lakehouse con il minimo sforzo e la massima affidabilità.”- Charbel Khoury, Head of Data Office, Toyota Finance Australia Limited
Allo stesso modo, Seguros SURA utilizza il connettore Monday.com per trasformare bacheche di attività isolate in insight aziendali pronti per la governance..
"Utilizzando il connettore Monday.com di Lakeflow Connect, possiamo centralizzare i dati di progetti e operazioni che in precedenza erano sparsi su diverse bacheche all'interno di Databricks. Grazie alla sincronizzazione automatica, non dobbiamo più gestire esportazioni manuali o dati obsoleti. Unendo queste informazioni con gli altri nostri dati aziendali sulla stessa piattaforma, possiamo creare facilmente analisi più complete, con governance e controllo degli accessi gestiti da Unity Catalog."- Juan David Munera, Head of Data and AI, Seguros Sura Mexico
VaxCare, un'azienda di gestione dei vaccini, gestisce la più grande rete di vaccinazioni di cure primarie negli Stati Uniti e utilizza il connettore Confluence di Lakeflow Connect per alimentare la sua base di conoscenza interna in Databricks e fondare su di essa un agente di IA.
"Il connettore Confluence di Lakeflow Connect ci offre un modo trasparente per alimentare la nostra base di conoscenza interna in Databricks, rendendo tali dati ricercabili e utilizzabili per il nostro chatbot oggi, e pronti per alimentare future soluzioni di IA man mano che le creiamo." - Yasaman Malone, VP of Optimization and AI, VaxCare
Contenuto non strutturato, pronto per l'IA
Gli agenti di IA possono fornire risposte immediate e fondate dalla conoscenza collettiva della tua azienda senza che i dipendenti debbano cercare tra wiki, unità di archiviazione e caselle di posta. Ma un agente vale tanto quanto i dati su cui si basa, e la maggior parte di questi non è strutturata. Con Lakeflow Connect questo non è un problema; i nostri connettori possono caricare contenuti non strutturati come file, pagine e messaggi come tabelle soggette a governance in Unity Catalog. I dati esatti e il formato in cui arrivano variano a seconda dell'origine:
- SharePoint: Il connettore SharePoint acquisisce i file non strutturati stessi (PDF, documenti Word, presentazioni e immagini). Ogni file non strutturato viene salvato come una riga, con i suoi byte grezzi archiviati in una colonna
content(come tipoBINARYoFILE), con metadati per file memorizzati a fianco. I file strutturati (file Excel, CSV, ecc.) possono anche essere caricati direttamente come tabelle Delta. - Google Drive: Il connettore Google Drive funziona allo stesso modo per i file non strutturati, salvando i byte grezzi di ciascun documento come una riga in una colonna
content. I file strutturati (Google Fogli, CSV, ecc.) possono anche essere caricati direttamente come tabelle Delta. - Confluence: Il connettore Confluence acquisisce il contenuto di ogni pagina e post di blog come tipo
STRUCTin un campobodydelle tabellepageseblogposts. - Outlook: Il connettore Outlook archivia il corpo dell'email in una colonna
full_body_contentcome stringa di testo (HTML o testo semplice) e archivia gli allegati in una colonnaattachmentscome tipoBINARY. Entrambi si trovano nella tabellaemail_messages. - Gmail: Il connettore Gmail importa il corpo completo del messaggio come stringa di testo, memorizzata nella tabella
messages. Inoltre, acquisisce un riferimento a ciascun allegato comeattachmentId. - GitHub: Il connettore GitHub importa i file di testo del repository (codice sorgente, Markdown e configurazioni), memorizzati nella colonna
contentdella tabellarepo_contents.
Qualunque sia l'origine, il contenuto arriva in Unity Catalog come tabella protetta da governance, dove puoi iniziare a trasformarlo per i casi d'uso di AI a valle.
- Il testo in arrivo (come pagine Confluence, corpi di email e file sorgente GitHub) è pronto per essere suddiviso in chunk ed eseguito l'embedding dopo una leggera pulizia.
- D'altra parte, i file di documenti che arrivano come byte grezzi (come i file da SharePoint e Google Drive o gli allegati da Outlook), vengono prima convertiti in testo con
ai_parse_document, la document intelligence integrata di Databricks.
In entrambi i casi, ti ritroverai con del testo che puoi indicizzare per il recupero e inserire dietro un agent. Per un'analisi più approfondita dell'elaborazione dei documenti, guarda questa sessione on-demand, Intelligent Document Processing with Lakeflow; e per maggiori informazioni su come iniziare, leggi la guida RAG a valle.
M3 Accounting, un fornitore leader di software per il settore alberghiero, utilizza i connettori GitHub e SharePoint di Lakeflow Connect per unificare la sua documentazione ingegneristica e di prodotto in Databricks.
"Abbiamo configurato e reso operativo il connettore GitHub di Lakeflow Connect in pochi minuti. Ci fa risparmiare circa un'ora a settimana unendo automaticamente i nostri dati di GitHub con gli altri dati delle nostre operazioni di ingegneria, offrendoci un quadro completo dell'attività degli sviluppatori su cui possiamo effettivamente agire. Abbiamo puntato il connettore SharePoint di Lakeflow Connect verso la nostra libreria di documentazione di prodotto e il nostro assistente di conoscenza interno ha iniziato ad attingere da contenuti live e aggiornati nel giro di una settimana. Nessun crawler personalizzato, nessun script di sincronizzazione dei file, solo un connettore e una pipeline." - Ross Serven, VP of Data & AI, M3 Accounting
Gestisci la spesa per l'AI con Lakeflow Connect
Man mano che gli AI agent e gli strumenti generativi si diffondono tra i team, aumentano anche le domande sui modelli che li alimentano: quanto stiamo spendendo, chi sta usando cosa, è conforme? Per rispondere a queste domande, Lakeflow Connect offre connettori per i principali fornitori di foundation model:
- OpenAI: Il connettore OpenAI importa utilizzo, costi, chiavi API, progetti, utenti e log di audit, in modo da poter attribuire la spesa per l'AI per team e monitorare l'adozione.
- Anthropic: Il connettore Anthropic importa i log di audit, gli utenti e i ruoli della tua organizzazione e il contenuto delle chat e dei messaggi di claude.ai, in modo da poter controllare come viene utilizzato lo strumento.
In concreto, ciò consente di avere una vista singola e unificata dell'andamento dell'utilizzo e dell'adozione dell'AI all'interno della tua organizzazione, permettendoti di misurare e riportare il ROI dei tuoi investimenti in AI agli stakeholder.
Crea un quadro completo dei tuoi dati Atlassian
La profondità di copertura dell'ecosistema di Lakeflow Connect si estende anche ad Atlassian, una delle suite più utilizzate in qualsiasi organizzazione di ingegneria o di prodotto:
- Jira: Il connettore Jira importa ticket, commenti, sprint, board e campi personalizzati, in modo da poter monitorare il delivery e creare dashboard tra i vari progetti.
- Confluence: Il connettore Confluence importa il testo completo di pagine e post di blog, insieme ai relativi spazi, etichette e allegati, in modo che la conoscenza scritta del tuo team sia pronta per essere cercata e analizzata.
Con entrambi i connettori ottieni un quadro completo dei tuoi dati Atlassian, del delivery e della documentazione che li circonda, fianco a fianco. Da lì puoi monitorare rilasci, colli di bottiglia e tempi di risoluzione tra i progetti. Puoi anche creare dashboard AI/BI e fare domande a Genie su qualsiasi aspetto utilizzando il linguaggio naturale.
Ad esempio, Digicert, leader globale nella sicurezza digitale, utilizza il connettore Confluence di Lakeflow Connect per alimentare in modo affidabile i suoi assistenti di conoscenza AI interni senza i costi di gestione di pipeline personalizzate.
"Il connettore Confluence di Lakeflow Connect è stato di grande aiuto per mantenere i nostri assistenti di conoscenza in Databricks continuamente sincronizzati con la nostra documentazione più recente. Ci offre un modo semplice e affidabile per portare i dati di Confluence in Databricks senza la complessità di costruire e mantenere pipeline personalizzate. Questo è stato particolarmente prezioso per i nostri Product Bot, aiutandoli a rimanere aggiornati e a fornire ai nostri team una conoscenza accurata e aggiornata." - Nikita Raje, Senior Director, Data Engineering, DigiCert
Un altro cliente, Orizon, un'azienda brasiliana di tecnologia sanitaria, utilizza il connettore Jira di Lakeflow Connect per alimentare le dashboard della propria leadership.
"Con il connettore Jira di Lakeflow Connect, abbiamo portato oltre un milione di ticket da 168 progetti in Databricks, tutti sincronizzati giornalmente con il 100% di successo. Da questi dati, abbiamo creato dashboard AI/BI che alimentano automaticamente il cockpit del nostro comitato direttivo. Genie è stato fondamentale: facciamo domande in linguaggio naturale e fornisce risposte all'istante." - Gustavo Lima, Data Engineering Manager, Orizon
Per una guida passo-passo alla configurazione e all'ottimizzazione del connettore Jira, consulta Unify Your Engineering Data: Jira Ingestion Best Practices.
Una base unica, ogni domanda di analisi o AI
Poiché ogni connettore memorizza i propri dati sotto forma di tabelle Delta soggette a governance in Unity Catalog, la produttività e i dati di AI che inserisci diventano parte della stessa base del resto dei dati aziendali. Da lì puoi interrogarli direttamente in Databricks Lakehouse insieme alle tue altre origini, porre domande in linguaggio naturale con Genie One e fondare gli agent che crei con Agent Bricks sulla conoscenza aziendale attuale.
E poiché la governance, il lignaggio e il controllo degli accessi provengono tutti da Unity Catalog, l'accesso rimane coerente indipendentemente dal team o dallo strumento da cui i dati originariamente provengono.
TRegs, una piattaforma di tecnologia finanziaria per la tesoreria, il rischio e il reporting normativo, sta già costruendo su questa base.
"Avevamo bisogno di vedere tutti i nostri costi e le nostre proiezioni in un unico posto. Portando i nostri dati di Monday.com e QuickBooks in Databricks con Lakeflow Connect, ora possiamo alimentare le nostre dashboard AI/BI di Genie per ottenere una visione a 360 gradi delle nostre spese attuali e previste, rendendo la nostra vita super semplice." - Smriti Raj, President and CTO, TRegs
Lakeflow Connect sta introducendo attivamente nuovi connettori in ogni linea di business, con il supporto per un numero ancora maggiore di connettori in arrivo! Prova subito Lakeflow Connect gratuitamente.
Segui il prossimo post di questa serie di blog su Lakeflow Connect per continuare a imparare come portare tutti i tuoi dati aziendali in Databricks e dare ai tuoi AI agent il contesto completo di cui hanno bisogno.
FAQ
A quali strumenti di produttività si collega Lakeflow Connect?
Lakeflow Connect dispone di connettori gestiti per Jira, Confluence, Monday.com, Smartsheet, Aha!, GitHub, Notion, Glean, SharePoint, Google Drive, Outlook e Gmail. Dispone inoltre di connettori per OpenAI e Anthropic. Ciascun connettore può essere configurato tramite un'interfaccia utente punta e clicca o tramite un'API. Scopri l'elenco completo dei connettori SaaS di Lakeflow Connect.
Lakeflow Connect può acquisire file non strutturati ed email?
Sì. I connettori SharePoint e Google Drive salvano ogni file non strutturato come una singola riga, con i suoi byte grezzi in una colonna content. Il connettore Outlook importa i corpi delle email come testo, mentre il connettore GitHub importa i file di testo del repository. Tutto viene salvato come tabella con governance in Unity Catalog.
Come posso preparare il contenuto acquisito per un AI agent?
Testi come pagine Confluence, corpi di email e file sorgente GitHub sono pronti per il chunking e l'embedding dopo una leggera pulizia. I file che arrivano come byte grezzi vengono prima convertiti in testo con ai_parse_document. Puoi quindi indicizzare il testo per il recupero e usarlo per il grounding di un agent. Per iniziare, guarda questa sessione on-demand, Intelligent Document Processing con Lakeflow, oppure leggi la guida RAG a valle.
Quali dati importano i connettori OpenAI e Anthropic?
Il connettore OpenAI importa utilizzo, costi, chiavi API, progetti, utenti e log di audit, così puoi attribuire la spesa per l'IA per team. Il connettore Anthropic importa log di audit, utenti e ruoli, oltre al contenuto di chat e messaggi di claude.ai. Insieme ti offrono una visuale unica sull'andamento dell'utilizzo e dell'adozione dell'IA.
Cosa posso costruire una volta che i dati di Jira e Confluence sono in Databricks?
Puoi monitorare lanci, colli di bottiglia e tempi di risoluzione tra i progetti, e costruire dashboard AI/BI sui risultati. Orizon, ad esempio, ha portato oltre un milione di ticket Jira da 168 progetti in Databricks per alimentare le sue dashboard di leadership. Le pagine Confluence possono anche fare da grounding per assistenti di conoscenza interni.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.