Introduzione a Spark Declarative Pipelines (SDP)
Le pipeline di dati dichiarative sono diventate una funzionalità nativa di Spark in Apache Spark 4.1. Nessun framework aggiuntivo. Nessuna dipendenza esterna. Nessuna nuova curva di apprendimento. Milioni di utenti Spark possono ora creare pipeline ETL di livello di produzione, utilizzando gli strumenti che già conoscono e amano.
L'esempio qui utilizzato, una pipeline di produzione che traccia ogni aeromobile in cielo con milioni di eventi IoT in streaming ogni secondo, era un serio sforzo ingegneristico. Ora può essere fatto in una pausa caffè, con poche righe di codice e 100% open source.
Figura: Visualizzazione dei dati degli aeromobili OpenSky con le applicazioni Databricks
Che cos'è Spark Declarative Pipelines?
Spark Declarative Pipelines (SDP) è un framework dichiarativo nativo per la creazione di pipeline di dati batch e streaming affidabili in Python o SQL.
I processi Spark tradizionali sono essenziali: è necessario codificare ogni fase: leggere questa sorgente, applicare questa trasformazione, scrivere in questa tabella, nonché controllare la sequenza di esecuzione e molti altri dettagli tecnici da soli. SDP inverte questo modello. È dichiarativo: descrivi il risultato desiderato e Spark determina come raggiungerlo.
Databricks ha originariamente creato SDP come Delta Live Tables (DLT) e l'ha contribuita al progetto open source Apache Spark al Data + AI Summit 2025.
Come funziona SDP?
Le Spark Declarative Pipelines (SDP) definiscono il modo in cui le trasformazioni aggiornano i set di dati in una pipeline. SDP automaticamente:
- Risolve le dipendenze tra set di dati e trasformazioni
- Determina l'ordine di esecuzione tra i passaggi della pipeline
- Esegue attività indipendenti in parallelo per migliorare prestazioni ed efficienza
Una pipeline SDP è costruita a partire da componenti principali chiave.
In questi tutorial non avrete bisogno di flussi o viste temporanee, ma teneteli a mente quando le pipeline diventano più complesse.
Questo è sufficiente per creare la tua prima pipeline di dati SDP. Andiamo.
Tutorial su Spark Declarative Pipelines (SDP)
Di seguito è riportato un singolo esempio, presentato in due ambienti diversi. Uno viene eseguito localmente con PySpark open source, mentre l'altro viene eseguito nel cloud su un account Databricks Free Edition (gratuito per sempre). Entrambi i tutorial SDP, il tutorial locale PySpark e il tutorial Lakeflow Declarative Pipelines, illustrano esattamente lo stesso caso d'uso: la creazione di una pipeline che acquisisce ed elabora dati aeronautici in tempo reale provenienti da aeromobili di tutto il mondo.
Fonte dati OpenSky
Entrambi i tutorial utilizzano una sorgente dati PySpark personalizzata che si connette all'API REST di OpenSky Network. OpenSky Network aggrega i dati di sorveglianza del traffico aereo forniti dagli appassionati di aviazione di tutto il mondo, creando un quadro in tempo reale del traffico aereo globale. L'API REST OpenSky è gratuita per uso non commerciale, ma applica limiti di velocità. Consultare la documentazione API OpenSky per conoscere le soglie correnti.
La raccolta dati di OpenSky Network è crowdsourcing: chiunque può contribuire impostando un ricevitore ADS-B a basso costo. I dati che elaborerai in questi tutorial esistono perché migliaia di volontari in tutto il mondo hanno fatto proprio questo. Invia i tuoi dati alla rete OpenSky se vuoi diventare uno di loro.
Ogni esecuzione della pipeline SDP acquisisce aggiornamenti in tempo reale di posizione, velocità e altitudine dagli aeromobili attualmente in volo, con nuovi dati che arrivano ogni pochi secondi. L'origine dati è un'origine dati PySpark open source, pertanto funziona in Spark normale così come nelle pipeline dichiarative Spark.
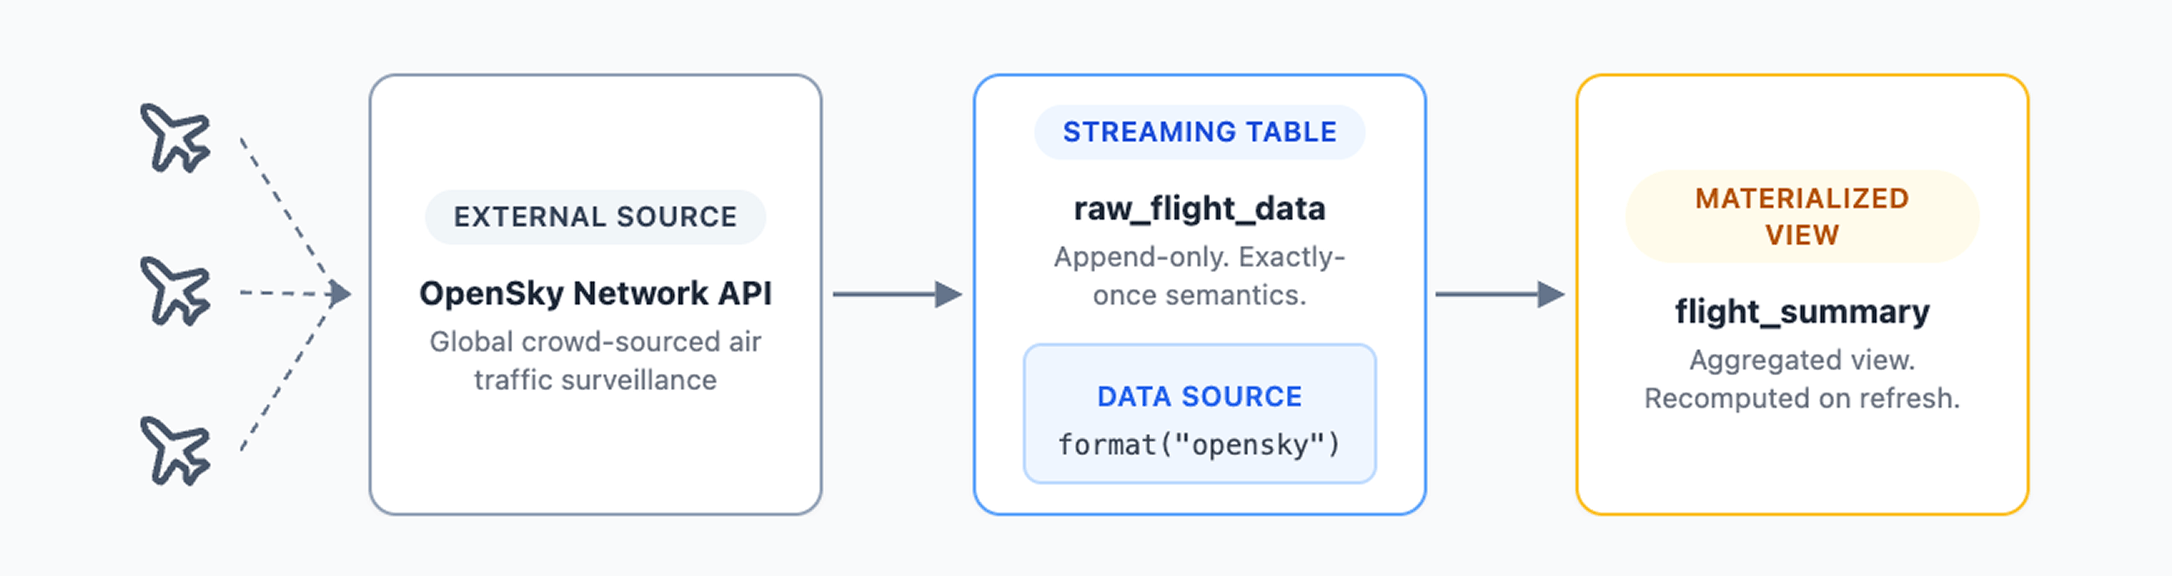
Questi sono dati IoT reali su scala di produzione. Lo stesso tipo che guida piattaforme logistiche, sistemi di tracciamento merci e operazioni di monitoraggio portuale. Non si tratta di un file CSV di esempio statico: ogni esecuzione della pipeline estrae dati in tempo reale dagli aeromobili attualmente in volo.
L'unica differenza tra i due tutorial è dove vengono eseguiti.
Tutorial locale di PySpark (open source)
Il tutorial locale di PySpark ti guida attraverso la creazione di una pipeline dichiarativa partendo da zero sul tuo computer locale utilizzando PySpark e qualsiasi editor preferito. È dotato di:
- Controllo completo dell'ambiente di sviluppo e scelta dell'IDE
- Accesso diretto ai file di output Parquet sul file system locale
- Stack open source al 100% senza dipendenze proprietarie
Requisiti: Python 3.12, Java 17, PySpark 4.1 e un IDE come VS Code
Tutorial Lakeflow (Edizione gratuita di Databricks)
L'esercitazione Lakeflow è il percorso più veloce per una pipeline in esecuzione. Lakeflow è l'implementazione gestita da Databricks di Spark Declarative Pipelines, basata sullo stesso core open source con funzionalità aziendali aggiuntive. È dotato di:
- Elaborazione serverless con scalabilità automatica, nessuna configurazione cluster richiesta
- Editor di pipeline integrato con esplorazione dei dati basata sull'IA
- Tabelle di output registrate nel catalogo Unity con tracciamento automatico del lignaggio
- Nessuna configurazione locale, tutto funziona nel cloud
Requisiti: account Databricks Free Edition (nessuna carta di credito, non scade mai)
Domande frequenti
Spark Declarative Pipelines (SDP) è un framework dichiarativo nativo integrato in Apache Spark 4.1 o versioni successive per la creazione di pipeline di dati batch e streaming affidabili in Python o SQL. Dichiari quali dati devono esistere, la loro origine, la loro forma e le modalità di aggiornamento, e Spark gestisce la risoluzione delle dipendenze, l'ordine di esecuzione e l'elaborazione parallela. Basta eseguire la pipeline dichiarativa e Spark si occuperà del resto.
Ultimo aggiornamento: agosto 2026
Autore: Frank Munz