Spark Declarative Pipelines (SDP) の使用を開始する方法
宣言型データパイプラインは、Apache Spark™ 4.1 でネイティブの Spark 機能になりました。 追加のフレームワークはありません。 外部依存関係はありません。 新しい学習曲線はありません。 何百万人もの既存の Spark ユーザーは、すでに知っているツールを使用して、実稼働グレードの ETL パイプラインを構築できるようになりました。
ここで使用した例は、空中のすべての航空機を追跡し、毎秒何百万ものライブ IoT イベントをストリーミングする実用レベルのパイプラインです。これはかつては重大なエンジニアリング作業でした。 今ではコーヒー休憩中に数行のコードと100%オープンソースで作業を行うことができます。
図: Databricks アプリを使用した OpenSky 航空機データの可視化
Spark Declarative Pipelines とは何ですか?
Spark Declarative Pipelines (SDP) は、信頼性の高いバッチおよびストリーミング データ パイプラインを Python または SQL で構築するためのネイティブな宣言フレームワークです。
従来の Spark ジョブは不可欠です。各ステップをコーディングする必要があります。つまり、このソースを読み取り、この変換を適用し、このテーブルに書き込むだけでなく、実行シーケンスやその他の多くの技術的な詳細を自分で制御する必要があります。 SDP はこのモデルを反転させます。 それは宣言的です: あなたが望む結果を記述すれば、Spark がその達成方法を決定します。
Databricks はもともと SDP を Delta Live Tables (DLT) として作成し、2025 年の Data + AI Summit で Apache Spark オープンソース プロジェクトに貢献しました。
SDP はどのように機能しますか。
Spark Declarative Pipelines (SDP) は、変換によってパイプライン全体でデータセットがどのように更新されるかを定義します。 SDP は自動的に:
- データセットと変換間の依存関係を解消
- パイプラインステップ全体にわたって実行順序を決定
- 独立したタスクを並列実行することでパフォーマンスと効率性を向上
SDP パイプラインは、主要なコア コンポーネントから構築されます。
これらのチュートリアルではフローや一時的なビューは必要ありませんが、パイプラインがより複雑になる場合はこれらのことを念頭に置いておいてください。
これは、最初の SDP データ パイプラインを構築するのに十分な量です。 行きましょう。
Spark 宣言型パイプライン (SDP) チュートリアル
以下は、2 つの異なる環境で提示された単一の例です。 1つはオープンソースのPySparkを使用してローカルで実行され、もう1つは(永久に無料の)Databricks Free Editionアカウントを使用してクラウドで実行されます。 SDP のチュートリアル(ローカルの PySpark チュートリアルと Lakeflow の宣言型パイプラインチュートリアル)はどちらも、まったく同じユースケースについて説明します。これは、世界中の航空機から生じたライブ航空データを取り込み処理するパイプラインの構築です。
OpenSky データソース
どちらのチュートリアルも、OpenSky Network REST API に接続するカスタム PySpark データソースを使用しています。 OpenSky Networkは世界中の航空愛好家から提供された航空交通監視データを集約し、世界の航空交通状況をリアルタイムで把握しています。 OpenSky REST API は非商用利用の場合無料ですが、レート制限が適用されます。 現在のしきい値については、OpenSky API ドキュメントを確認してください。
OpenSky Networkのデータ収集はクラウドソーシングされており、誰でも低コストのADS-B受信機をセットアップすることで貢献できます。 これらのチュートリアルで扱うデータが存在するのは、世界中の何千人ものボランティアがまさにその作業を行ってきたからです。 OpenSky Networkに参加したい場合は、データをOpenSky Networkにフィードしてください。
各 SDP パイプラインは、現在飛行中の航空機からリアルタイムで位置、速度、高度の更新情報を取り込み、数秒ごとに新しいデータが届きます。 データソースはオープンソースの PySpark データソースであるため、このデータソースは通常の Spark でも Spark 宣言型パイプラインでも動作します。
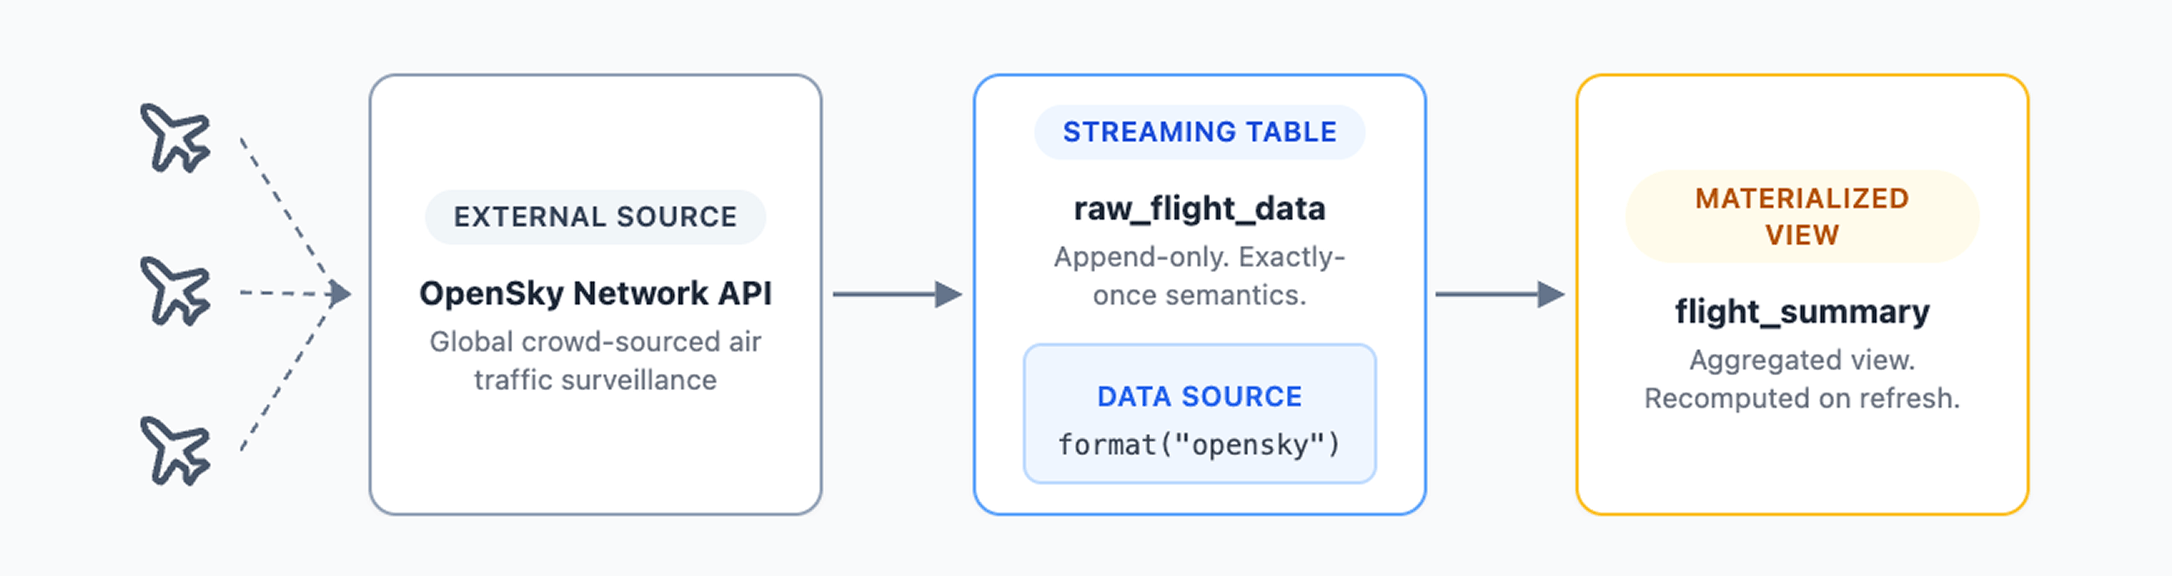
これは実際の生産規模の IoT データです。 これは物流プラットフォーム、貨物追跡システム、港湾監視業務を推進するのと同じ種類です。 これは静的な CSV サンプルファイルではありません。パイプラインの実行ごとに、現在飛行中の航空機からライブデータを取得します。
この 2 つのチュートリアルの唯一の違いは、どこで実行するかです。
PySpark ローカルチュートリアル(オープンソース)
PySpark ローカルチュートリアルでは、PySpark とお好みのエディタを使用して、ローカルマシン上で宣言型パイプラインをゼロから構築する方法について説明します。 この機能は次のとおりです。
- 開発環境とIDEの選択を完全に制御
- ローカルファイルシステム上の Parquet 出力ファイルへの直接アクセス
- プロプライエタリな依存関係のない100%オープンソーススタック
要件: Python 3.12、Java 17、PySpark 4.1、および VS Code などの IDE
Lakeflow チュートリアル(Databricks 無料版)
Lakeflow チュートリアルは、稼働中のパイプラインへの最速のルートです。 LakeflowはDatabricksが管理するSpark Declarative Pipelinesの実装であり、同じオープンソースコア上に構築されており、エンタープライズ機能を追加しています。 この機能は次のとおりです。
- 自動スケーリングを備えたサーバーレスコンピューティング。クラスタ構成は不要です
- AI を活用したデータ探索機能を備えた組み込みパイプラインエディタ
- 自動系統追跡機能を備えた Unity カタログに登録された出力テーブル
- ローカルでのセットアップは不要。すべてがクラウド上で実行されます
要件: Databricks 無料版アカウント (クレジットカードなし、有効期限なし)
よくある質問
Spark Declarative Pipelines (SDP) は、Apache Spark 4.1 以降に組み込まれたネイティブ宣言フレームワークで、信頼性の高いバッチおよびストリーミングデータパイプラインを Python または SQL で構築できます。 どのようなデータが存在すべきか、そのソース、その形状、およびその更新方法を宣言すれば、Spark は依存関係の解決、実行順序、並列処理を処理します。 宣言型パイプラインを実行するだけで、残りは Spark が処理します。
最終更新日:2026年8月著者:
フランク・ムンツ