Spark 선언적 파이프라인(SDP)을 시작하는 방법
선언적 데이터 파이프라인은 아파치 스파크™ 4.1에서 네이티브 스파크 기능이 되었습니다. 추가 프레임워크는 없습니다. 외부 종속성 없음 새로운 학습 곡선이 없습니다. 수백만 명의 기존 Spark 사용자는 이제 자신들이 이미 알고 있고 좋아하는 도구를 사용하여 프로덕션 수준의 ETL 파이프라인을 구축할 수 있습니다.
여기서 사용된 예제는 매초 수백만 건의 라이브 IoT 이벤트를 스트리밍하면서 하늘의 모든 항공기를 추적하는 생산 수준의 파이프라인으로, 이전에는 심각한 엔지니어링 노력이 필요했습니다. 이제 몇 줄의 코드와 100% 오픈 소스로 커피 휴식시간에 이 작업을 완료할 수 있습니다.
그림: Databricks 앱을 사용한 OpenSky 항공기 데이터 시각화
Spark 선언적 파이프라인이란 무엇입니까?
SDP(Spark Declarative Pipelines)는 Python 또는 SQL로 신뢰할 수 있는 배치 및 스트리밍 데이터 파이프라인을 구축하기 위한 네이티브 선언적 프레임워크입니다.
전통적인 Spark 작업은 필수적이며, 각 단계를 코딩해야 합니다: 이 소스를 읽고, 이 변환을 적용하고, 이 테이블에 기록하며, 실행 순서와 기타 많은 기술적 세부 사항을 직접 제어해야 합니다. SDP는 이 모델을 반전시킵니다. 이는 선언적입니다: 여러분은 원하는 결과를 설명하고, 스파크는 그 결과에 도달하는 방법을 결정합니다.
Databricks는 원래 SDP를 델타 라이브 테이블(DLT)으로 개발했으며 이를 2025년 데이터 + AI 서밋에서 아파치 스파크 오픈소스 프로젝트에 기여했습니다.
SDP는 어떻게 작동합니까?
SDP(Spark Declarative Pipelines)는 변환이 파이프라인 전반에서 데이터 세트를 업데이트하는 방법을 정의합니다. SDP 자동:
- 데이터 세트와 변환 간의 상관 관계 해소
- 파이프라인 단계별 실행 순서 결정
- 독립적인 작업을 병렬로 실행하여 성능과 효율성을 개선합니다.
SDP 파이프라인은 핵심 구성 요소로 구성됩니다.
이 자습서에서는 흐름이나 임시 뷰가 필요하지 않지만 파이프라인이 더 복잡해질 때 이를 염두에 두십시오.
이는 첫 번째 SDP 데이터 파이프라인을 구축하기에 충분합니다. 가자.
SDP(Spark 선언적 파이프라인) 자습서
다음은 두 가지 다른 환경에서 제공되는 단일 예입니다. 하나는 오픈소스 PySpark를 사용하여 로컬에서 실행되고, 다른 하나는 (영원히 무료) Databricks 무료 에디션 계정으로 클라우드에서 실행됩니다. 두 SDP 자습서(로컬 PySpark 자습서와 Lakeflow 선언적 파이프라인 자습서)는 모두 정확히 동일한 사용 사례를 안내합니다: 전 세계 항공기로부터 실시간 항공 데이터를 수집하고 처리하는 파이프라인 구축.
OpenSky 데이터 소스
두 자습서 모두 OpenSky Network REST API에 연결되는 사용자 지정 PySpark 데이터 소스를 사용합니다. OpenSky Network는 전 세계 항공 애호가들이 제공한 항공 교통 감시 데이터를 집계하여 전 세계 항공 교통량에 대한 실시간 그림을 생성합니다. OpenSky REST API는 비상업적 용도로 무료로 사용할 수 있지만 속도 제한이 적용됩니다. 현재 임계값에 대해서는 OpenSky API 문서를 확인하십시오.
오픈스카이 네트워크의 데이터 수집은 크라우드소싱되므로 누구나 저렴한 ADS-B 수신기를 설치함으로써 기여할 수 있습니다. 이 튜토리얼에서 여러분이 처리하게 될 데이터는 전 세계 수천 명의 자원봉사자들이 정확히 그 작업을 수행했기 때문에 존재합니다. 오픈스카이 네트워크의 일원이 되기를 원한다면 여러분의 데이터를 오픈스카이 네트워크에 제공하세요.
각 SDP 파이프라인은 현재 비행 중인 항공기의 실시간 위치, 속도 및 고도 업데이트를 수집하며, 새로운 데이터는 몇 초마다 도착합니다. 데이터 소스는 오픈 소스 PySpark 데이터 소스이므로 일반 Spark에서도 Spark 선언적 파이프라인에서도 작동합니다.
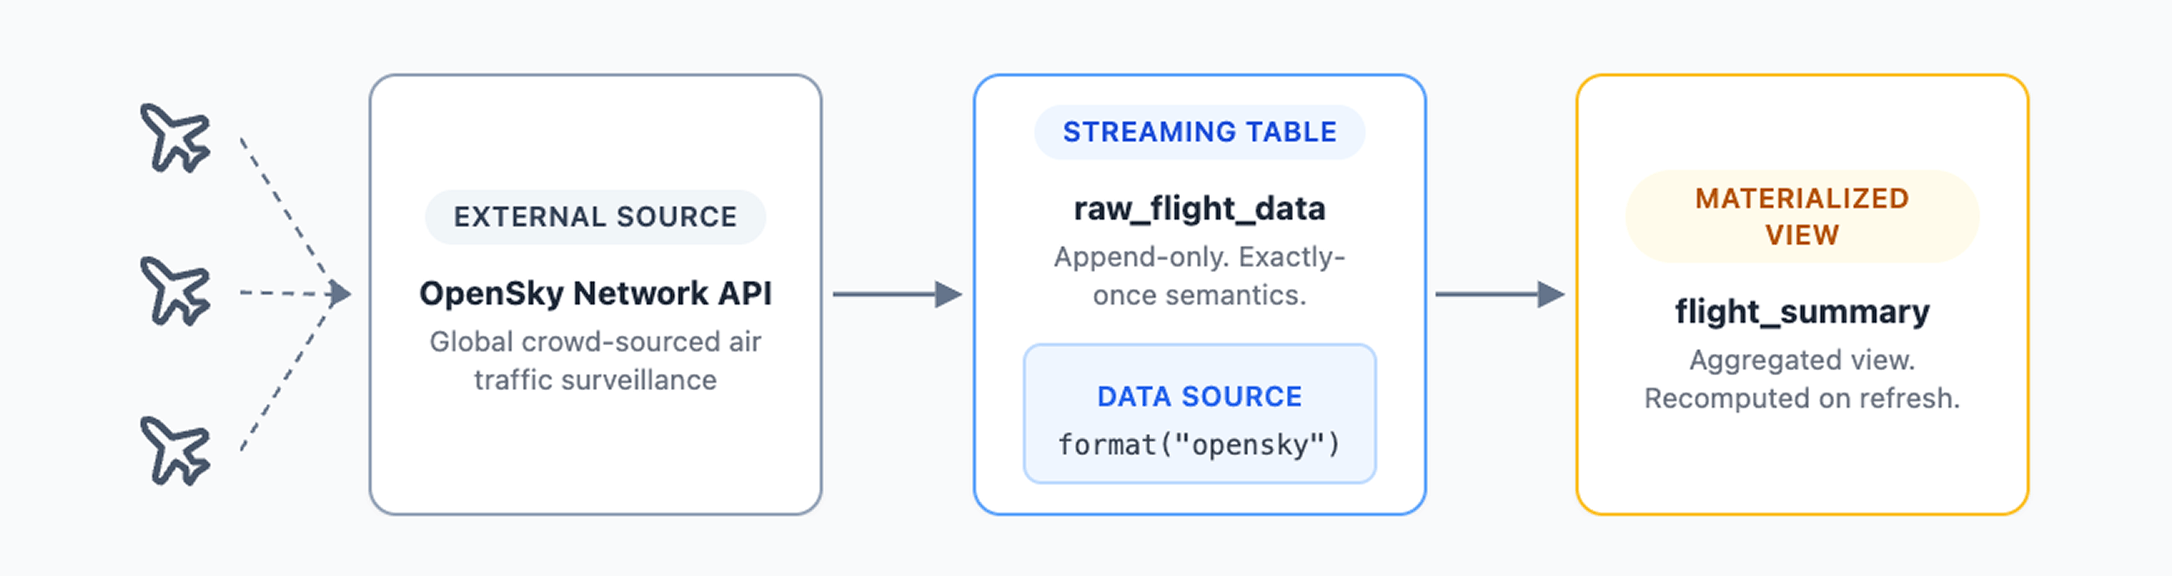
이것은 실제 생산 규모의 IoT 데이터입니다. 물류 플랫폼, 화물 추적 시스템 및 항구 모니터링 작업을 주도하는 것과 동일한 종류입니다. 이 파일은 정적 CSV 샘플 파일이 아닙니다. 모든 파이프라인은 현재 비행중인 항공기에서 라이브 데이터를 가져옵니다.
두 튜토리얼 간의 유일한 차이점은 해당 튜토리얼을 실행하는 위치입니다.
PySpark 로컬 튜토리얼(오픈소스)
PySpark 로컬 자습서는 PySpark와 원하는 편집기를 사용하여 로컬 컴퓨터에서 처음부터 선언적 파이프라인을 구축하는 방법을 안내합니다. 이 기능은 다음과 같습니다.
- 개발 환경과 IDE 선택에 대한 완전한 제어
- 로컬 파일 시스템의 Parquet 출력 파일에 직접 액세스
- 독점적 의존성이없는 100% 오픈 소스 스택
요구 사항: Python 3.12, Java 17, PySpark 4.1 및 VS Code와 같은 IDE
Lakeflow 튜토리얼(Databricks 무료 버전)
Lakeflow 자습서는 실행 중인 파이프라인으로 가는 가장 빠른 경로입니다. Lakeflow는 Databricks가 관리하는 Spark Declarative Pipelines의 구현으로, 동일한 오픈소스 코어를 기반으로 구축되었으며 추가적인 엔터프라이즈 기능을 갖추고 있습니다. 이 기능은 다음과 같습니다.
- 자동 확장을 지원하는 서버리스 컴퓨팅, 클러스터 구성이 필요 없음
- AI 기반 데이터 탐색을 지원하는 내장 파이프라인 편집기
- 자동 계통 추적을 통해 Unity 카탈로그에 등록된 출력 테이블
- 로컬 설치 작업이 필요 없으므로 모든 것이 클라우드에서 실행
요구 사항: Databricks 무료 에디션 계정(신용카드가 없으며 만료되지 않음)
FAQ
SDP(Spark Declarative Pipelines)는 Apache Spark 4.1 이상에 내장된 네이티브 선언형 프레임워크로, Python 또는 SQL로 안정적인 배치 및 스트리밍 데이터 파이프라인을 구축할 수 있습니다. 어떤 데이터가 존재해야 하는지, 그 출처, 그 모양, 그리고 그 업데이트 방법을 선언하면 스파크는 의존성 해결, 실행 순서 및 병렬 처리를 처리합니다. 단순히 선언적 파이프라인을 실행하면 스파크가 나머지를 알아냅니다.
최종 업데이트일: 2026년 8월
작성자: Frank Munz