Escalonamento automático do Lakebase Postgres
Um mergulho profundo em como escalamos o Postgres em tempo real
por Carlota Soto
- Requisito de arquitetura de escalonamento automático
- Quando aumentar e reduzir a capacidade
- Como ajustar a capacidade sem interromper o PostgreSQL
Escolher o tamanho de uma instância de banco de dados antes de conhecer a carga de trabalho é um padrão de desenvolvimento antigo. O processo geralmente é instável e parece um grande desperdício de computação, especialmente agora que a computação está se tornando um luxo.
O Lakebase Postgres elimina completamente a necessidade de dimensionamento graças ao escalonamento automático. A capacidade de resposta do escalonamento automático vem do redimensionamento de VM no local (in-place) e de um algoritmo que monitora a CPU, a memória e o conjunto de trabalho (working set) do banco de dados.
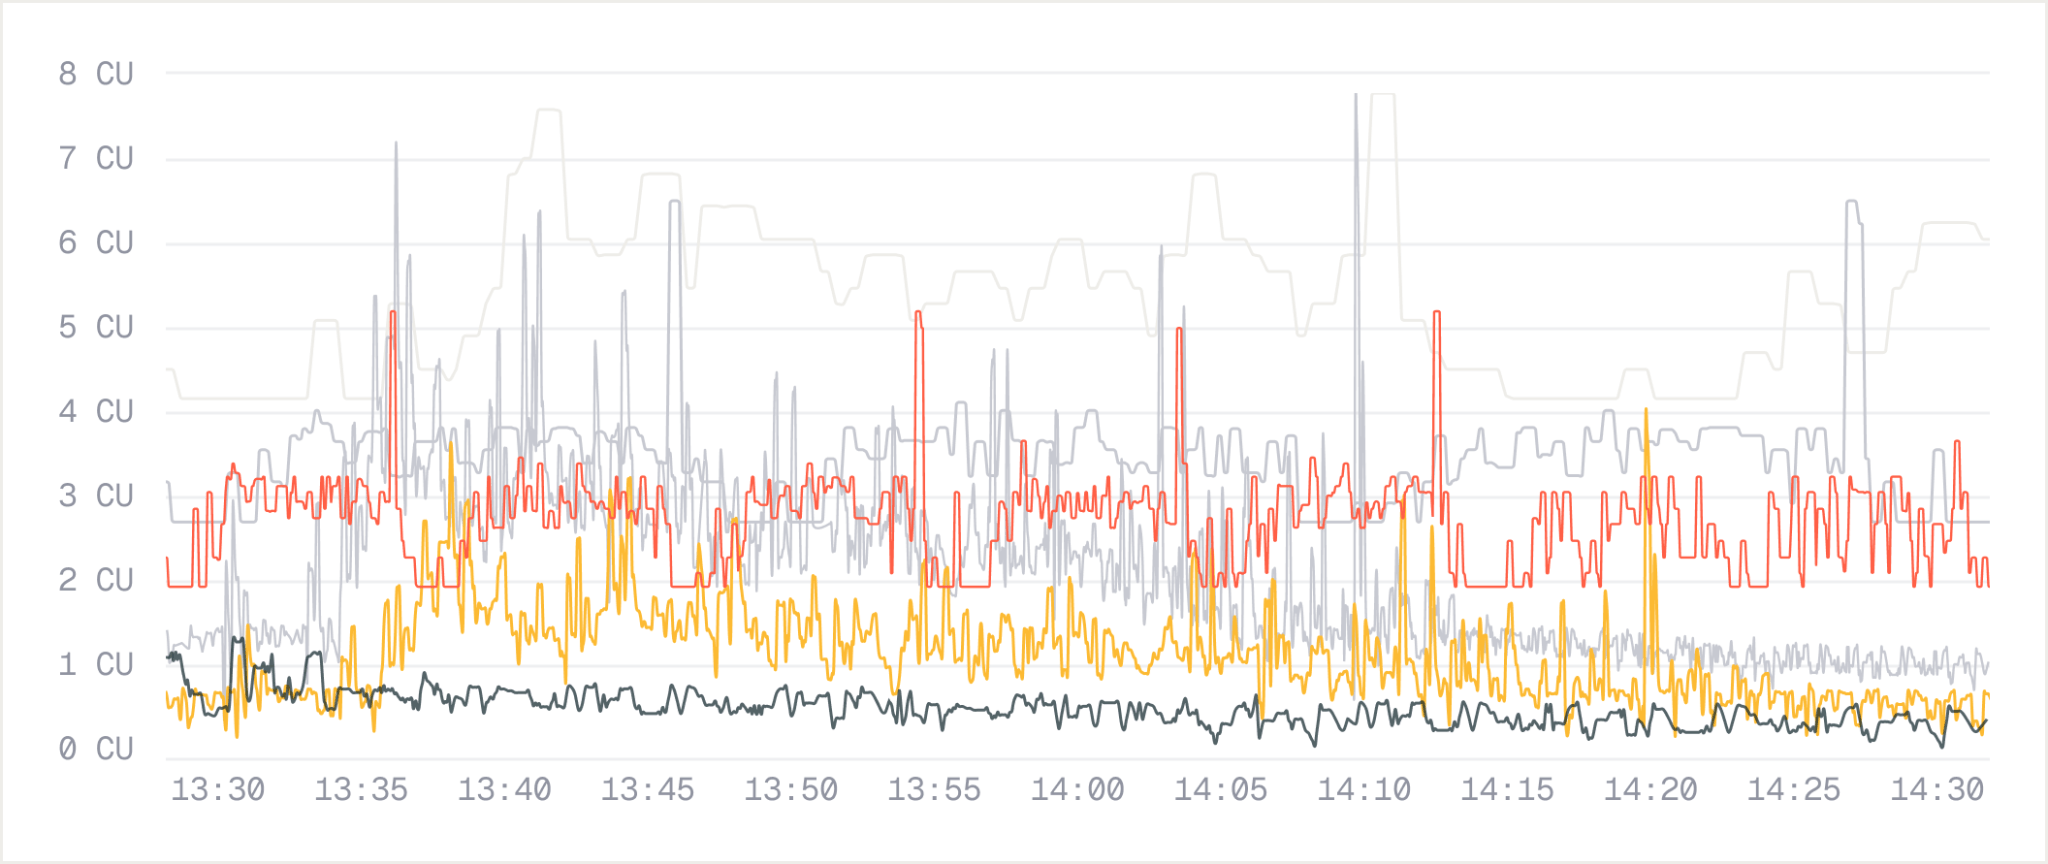
Como o escalonamento automático se comporta em uma amostra arbitrária de bancos de dados Lakebase Postgres. Note que este período é de apenas uma hora.
O requisito de arquitetura
O Postgres tradicional é executado como um processo com estado (stateful) vinculado a uma máquina e seus discos; substituir ou redimensionar essa máquina é uma operação de banco de dados porque a máquina possui tanto a execução quanto o estado durável. Mas a arquitetura do Lakebase Postgres separa essas responsabilidades:
- A camada de computação executa o Postgres e processa as consultas. Ela usa RAM e NVMe local para acesso de baixa latência, e não possui estado durável.
- A camada de armazenamento é responsável pela durabilidade e pelo histórico. O WAL é replicado por safekeepers executados em SSDs, os pageservers (também SSDs) reconstroem as versões das páginas, e o armazenamento de objetos mantém o registro imutável de longo prazo. (Este post de blog foca em computação, mas escrevemos uma análise detalhada sobre a parte de armazenamento se você tiver interesse.)
Portanto, um nó de computação pode iniciar, parar, mover ou alterar de tamanho sem mover o banco de dados subjacente. Essa é uma base essencial.
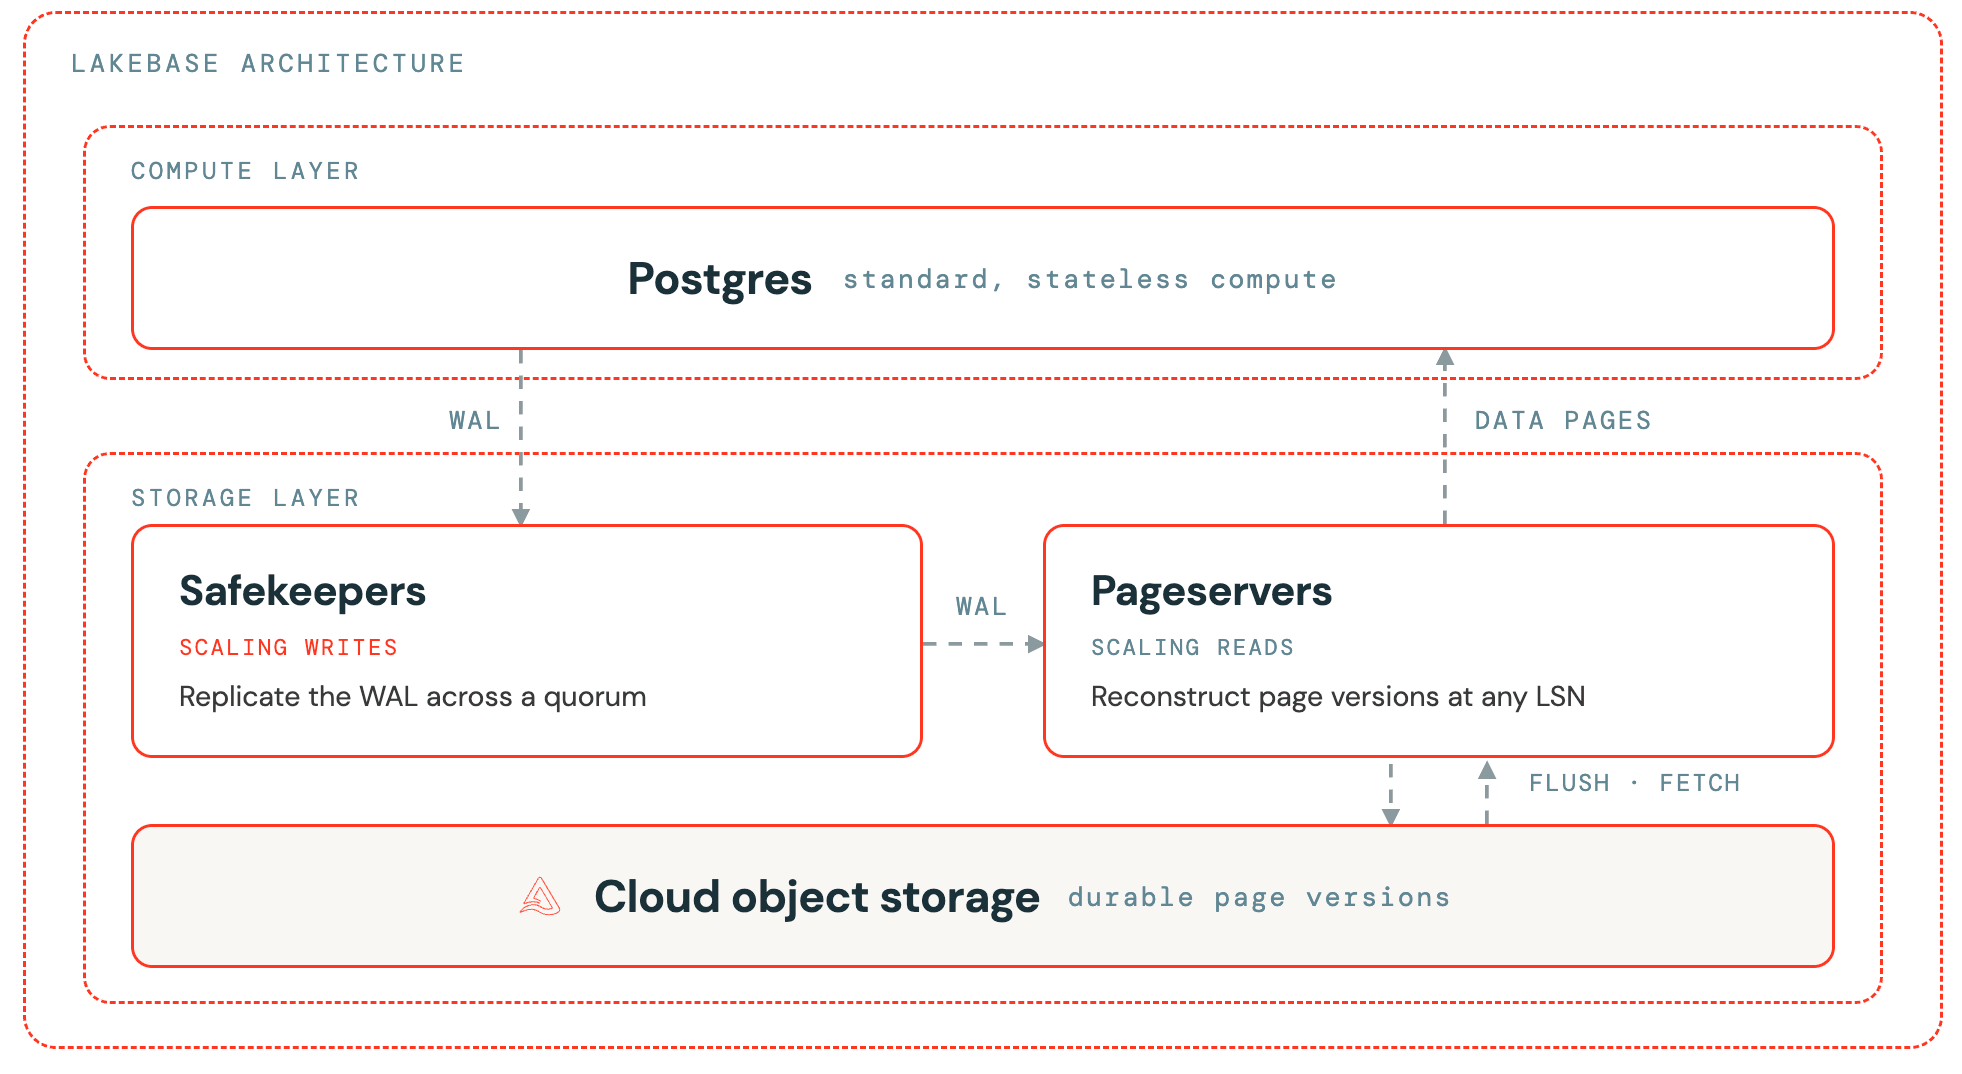
Agora, quando se trata de implementar o escalonamento automático, a história tem duas partes: primeiro, é preciso determinar quando ajustar a capacidade para mais ou para menos e, segundo, como fazer isso sem parar o Postgres.
Vamos abordar ambos em ordem.
Parte I: O algoritmo
Os três sinais de escalonamento automático
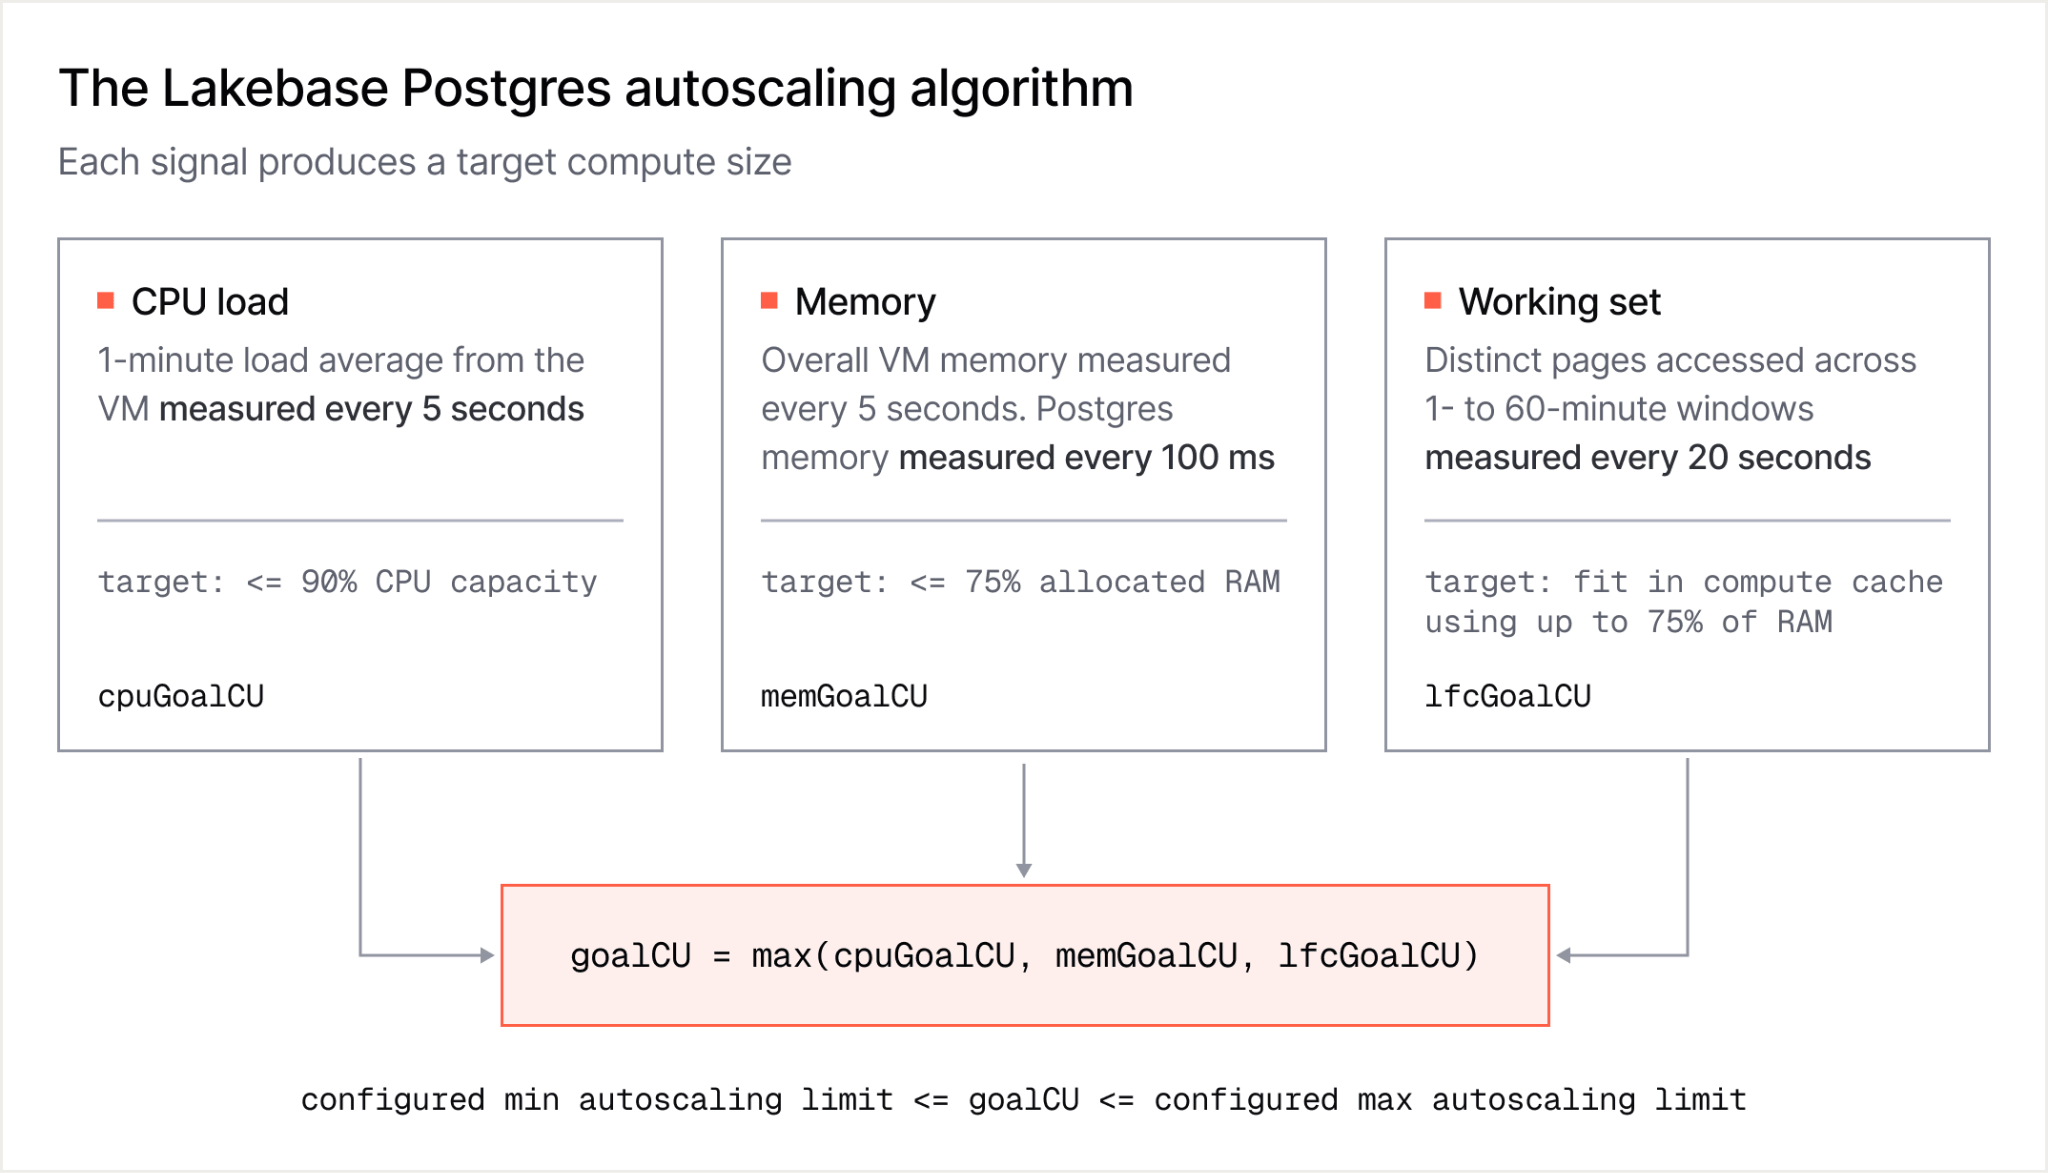
Para deduzir quando redimensionar, o algoritmo de escalonamento automático do Lakebase Postgres monitora três sinais, com cada sinal gerando seu próprio tamanho de computação de destino:
- Carga de CPU:
cpuGoalCU - Uso de memória:
memGoalCU - Tamanho do conjunto de trabalho do cache de computação:
lfcGoalCU
O destino final de escalonamento é o maior dos três, limitado aos tamanhos mínimos e máximos de computação que o usuário configurou para esse banco de dados (os limites de escalonamento automático):
CPU (cpuGoalCU)
A CPU é o mais simples dos três sinais. O algoritmo monitora de perto a intensidade de trabalho do processador:
- A cada cinco segundos, o autoscaler-agent lê a média de carga de CPU de um minuto da VM.
- A meta de CPU visa manter essa carga em 90% ou menos da capacidade de CPU disponível.
- Quando a carga ultrapassa essa meta,
cpuGoalCUaumenta. Quando a carga sustentada cai, a meta cai junto com ela.
O uso de uma média de um minuto filtra flutuações muito curtas, ao mesmo tempo em que responde a mudanças significativas na demanda. O intervalo de consulta (polling) de cinco segundos permite que o sistema atualize a meta conforme essa média se move.
No entanto, a CPU sozinha não é suficiente para dimensionar o Postgres corretamente. Uma consulta aguardando a chegada de dados pela rede pode apresentar baixo uso de CPU, mas ter um desempenho ruim. O algoritmo também precisa considerar a pressão de memória e cache.
Memória (memGoalCU)
A memória tem um modo de falha diferente da CPU. Se a demanda exceder brevemente a CPU disponível, as consultas ficam mais lentas; mas se o Postgres alocar mais memória do que a VM possui, o kernel pode encerrar processos. Portanto, o autoscaler precisa de um sinal muito mais rápido do que a CPU para o esgotamento de memória.
Por isso, o sistema monitora a memória em duas frequências:
- A cada cinco segundos, o autoscaler-agent lê as métricas gerais de memória da VM.
- A cada 100 milissegundos, o vm-monitor verifica a memória usada pelo Postgres.
A meta de memória mantém o uso abaixo de 75% da RAM alocada. Essa margem de segurança dá ao sistema espaço para responder a novas alocações e deixa memória livre para o sistema operacional convidado (guest OS) e outros processos.
O vm-monitor também verifica cada proposta de redução de escala (downscale). A memória não pode ser removida se isso deixar os processos em execução sem espaço suficiente.
Um pouco de história: Essa abordagem de consulta (polling) substituiu um design anterior baseado no evento de cgroup memory.high. Ultrapassar o memory.high fazia com que o Linux recuperasse memória e limitasse (throttle) os processos dentro do cgroup. A consulta provou ser mais previsível e estável, ao mesmo tempo em que oferece ao sistema uma visão de 100 milissegundos da memória do Postgres.
O cache de computação (lfcGoalCU)
O terceiro sinal mede se os dados ativos da carga de trabalho cabem próximos ao Postgres. A visão geral é a seguinte:
O Lakebase Postgres separa o armazenamento e a computação; quando uma página não está disponível localmente, a computação a solicita ao pageserver; a página retornada é armazenada em cache para leituras subsequentes. O cache de computação, que originalmente chamávamos de Local File Cache ou (LFC), é um cache baseado em disco dimensionado para caber no cache de página do kernel. Ele atua como uma extensão redimensionável dos buffers compartilhados (shared buffers) do Postgres. Quando a computação cresce, o vm-monitor expande o cache para usar parte da memória adicionada.
Para muitas cargas de trabalho OLTP, o desempenho muda drasticamente assim que o conjunto de trabalho cabe na memória local. Isso expõe um ponto cego no escalonamento automático baseado apenas em CPU: falhas de cache (cache misses) deixam as consultas aguardando solicitações de rede, o que reduz o uso de CPU. Portanto, o sistema pode detectar uma baixa pressão de CPU exatamente no momento em que um cache maior melhoraria o desempenho. Por isso, no Lakebase Postgres, há um terceiro sinal de escalonamento automático que estima diretamente o conjunto de trabalho do Postgres.
Esta é a parte mais interessante do algoritmo, então vamos ver como essa estimativa funciona.
Análise detalhada: como estimamos o conjunto de trabalho do Postgres
O conjunto de trabalho de uma carga de trabalho é o conjunto de páginas de banco de dados e índices que ela acessa repetidamente em um determinado período. Contar exatamente cada página para fins de escalonamento automático exigiria muita memória, de modo que a maneira clássica de resolver isso é contar com o HyperLogLog, um estimador probabilístico de cardinalidade que pode estimar o número de itens distintos em um conjunto usando uma quantidade pequena e fixa de estado.
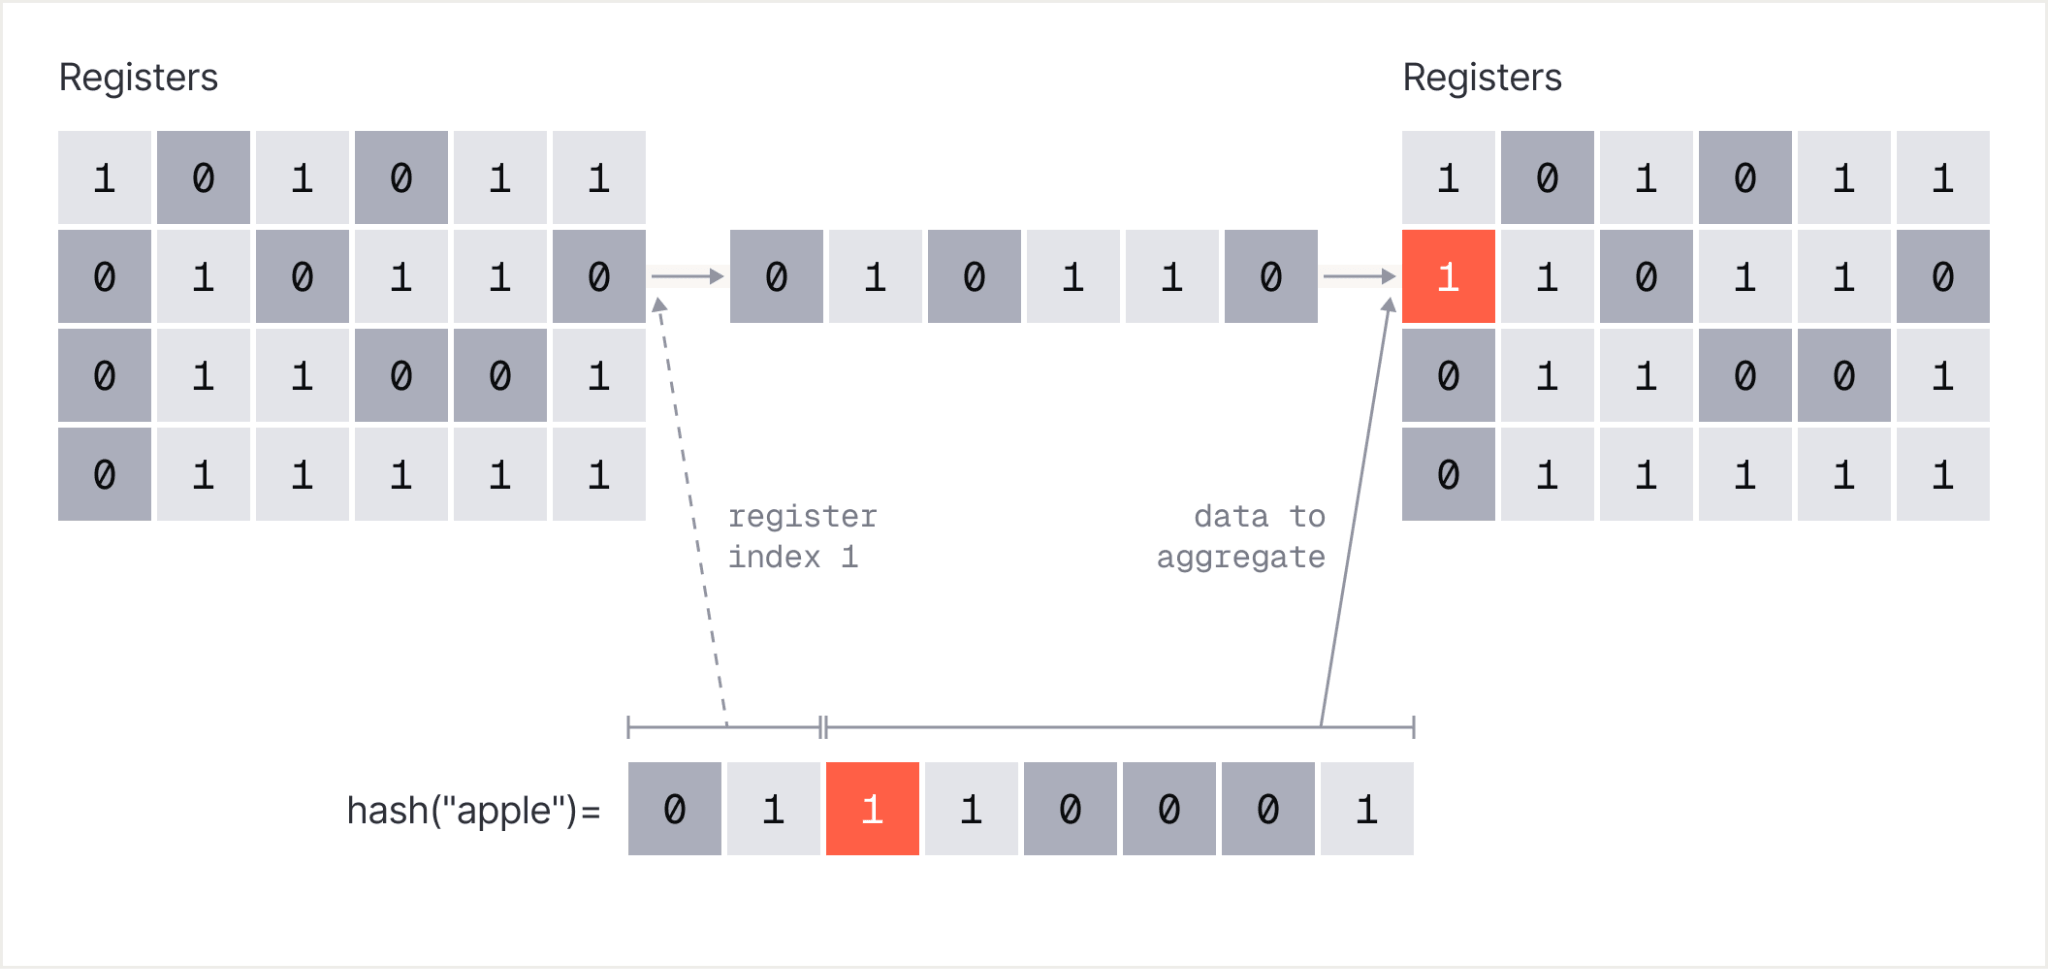
Para cada acesso de página do Postgres, uma implementação padrão do HyperLogLog:
- Aplica uma função hash ao identificador da página.
- Usa os primeiros bits do hash para selecionar um registrador.
- Conta os zeros à esquerda nos bits restantes.
- Atualiza o registrador selecionado se essa observação exceder seu valor anterior.
A distribuição desses valores de registrador forneceria uma estimativa de quantas páginas distintas foram observadas.
No entanto, há um problema em usar simplesmente o HyperLogLog para escalonamento automático: um HyperLogLog padrão apenas cresce. Uma vez que um registrador observou um valor, ele não pode dizer qual item o produziu ou quando esse item foi visto pela última vez.
Isso o torna bom para responder: “Quantas páginas distintas esta computação acessou desde que o Postgres foi iniciado?”. Mas o escalonamento automático precisa de uma resposta diferente, mais próxima de: “Quantas páginas distintas pertencem à carga de trabalho em execução agora?”.
Sem um limite de tempo, uma importação antiga ou uma consulta analítica permaneceria na estimativa e manteria a computação superdimensionada muito tempo após a conclusão desse trabalho. Por isso, mudamos o que os registradores do HyperLogLog armazenam.
Adicionando tempo ao HyperLogLog
É assim que as coisas realmente funcionam no Lakebase Postgres:
Em de definir um bit quando um hash é observado, o estimador armazena o carimbo de data/hora (timestamp) atual nessa posição. Para estimar a cardinalidade desde o momento T, ele trata as posições atualizadas após T como definidas (set) e as posições mais antigas como não definidas (unset).
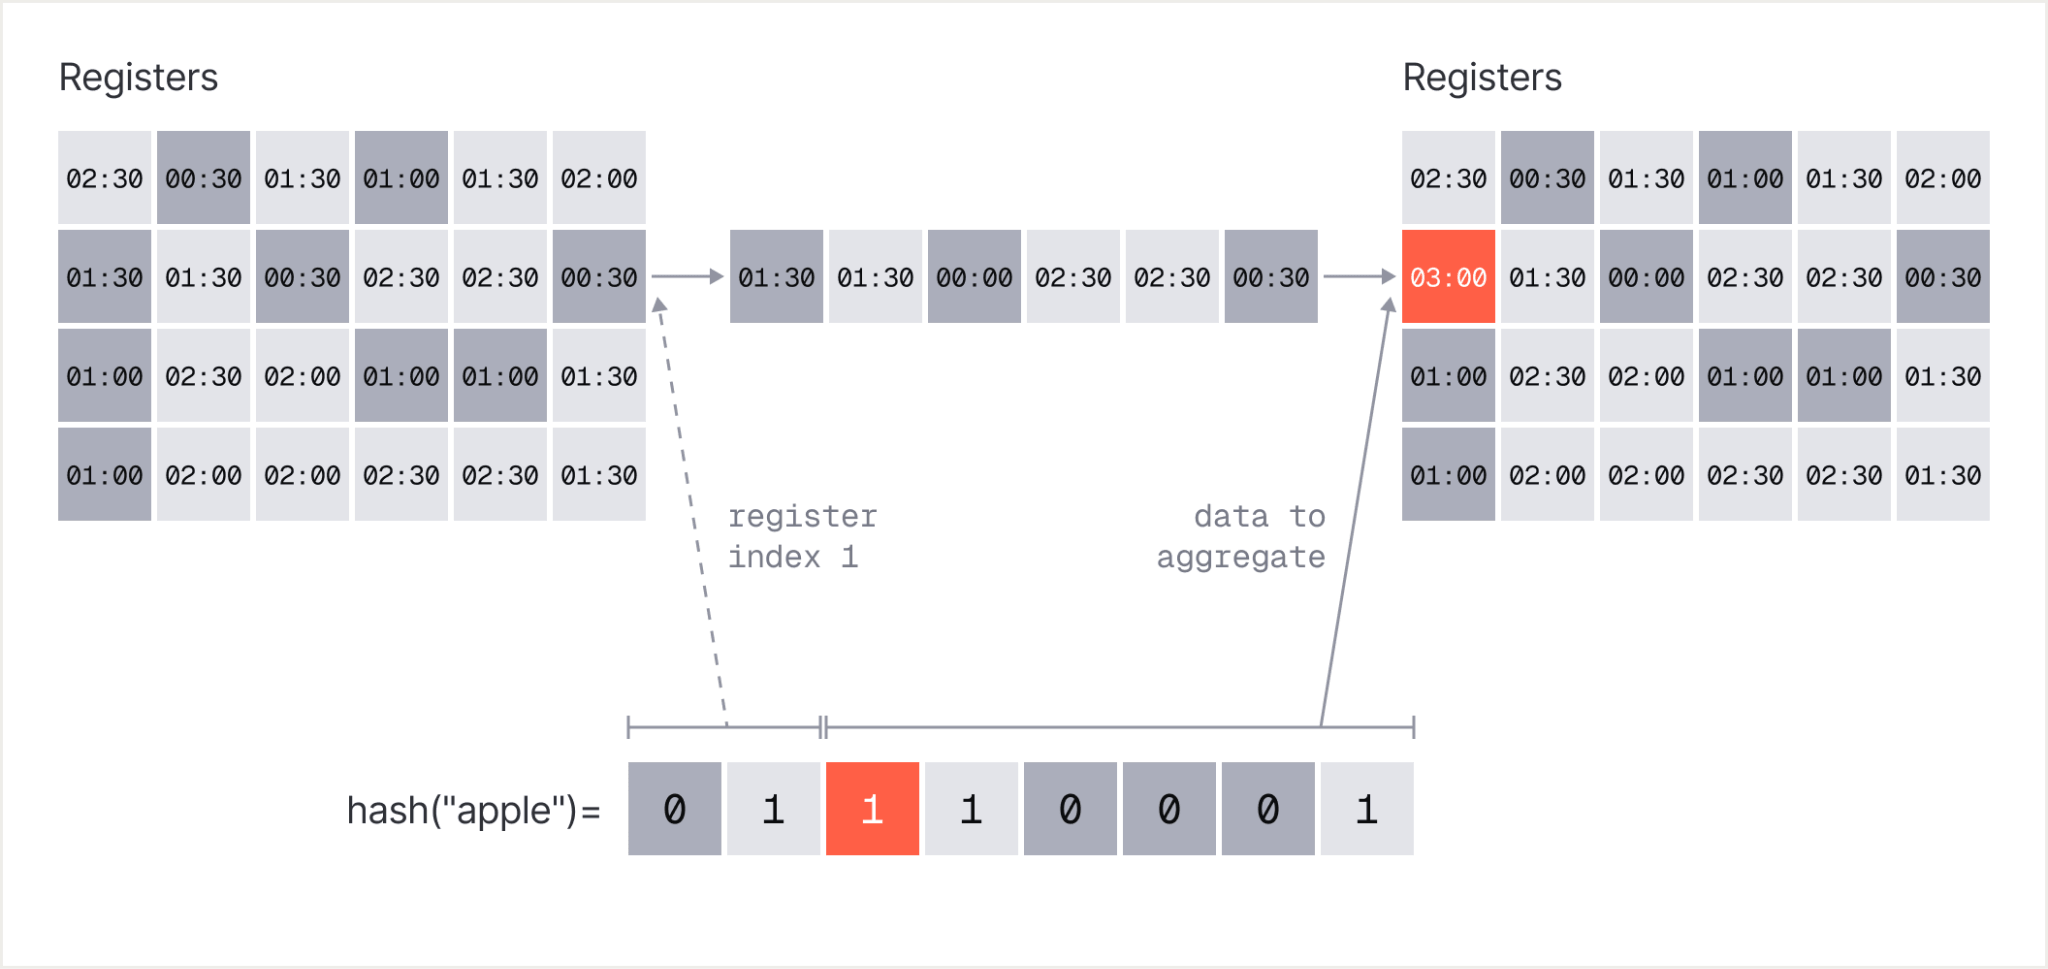
HyperLogLog modificado no autoscaling do Lakebase Postgres.
Isso gera uma estimativa para qualquer janela que termine no presente, incluindo
- Páginas distintas acessadas no último minuto
- Páginas distintas acessadas nos últimos cinco minutos
- Páginas distintas acessadas na última hora
Então, voltando ao algoritmo, é assim que a granularidade realmente funciona: a cada 20 segundos, o autoscaler-agent coleta estimativas de conjunto de trabalho para janelas de um a 60 minutos.
Mas a história não termina aqui. Como você certamente deve estar percebendo, esta é uma janela de tempo ampla. Como realmente a escolhemos?
Escolhendo a janela de tempo do conjunto de trabalho
O problema é o seguinte: não existe uma janela universal que descreva o conjunto de trabalho atual de um banco de dados. Se escolhermos uma janela curta, o mecanismo de autoscaling responderá rapidamente quando uma carga de trabalho terminar, mas descartará o cache de forma muito agressiva entre os picos de atividade. Se escolhermos uma janela longa, o algoritmo protegerá o cache, mas também manterá a memória alocada para tarefas que não estão mais em execução.
O algoritmo resolve isso analisando como o conjunto de trabalho muda ao longo do tempo. For exemplo: para uma carga de trabalho estável, o número estimado de páginas cresce inicialmente e depois se estabiliza. Estender a janela adiciona tempo, mas poucas páginas novas são adicionadas, porque o mesmo conjunto de trabalho está sendo acessado repetidamente.
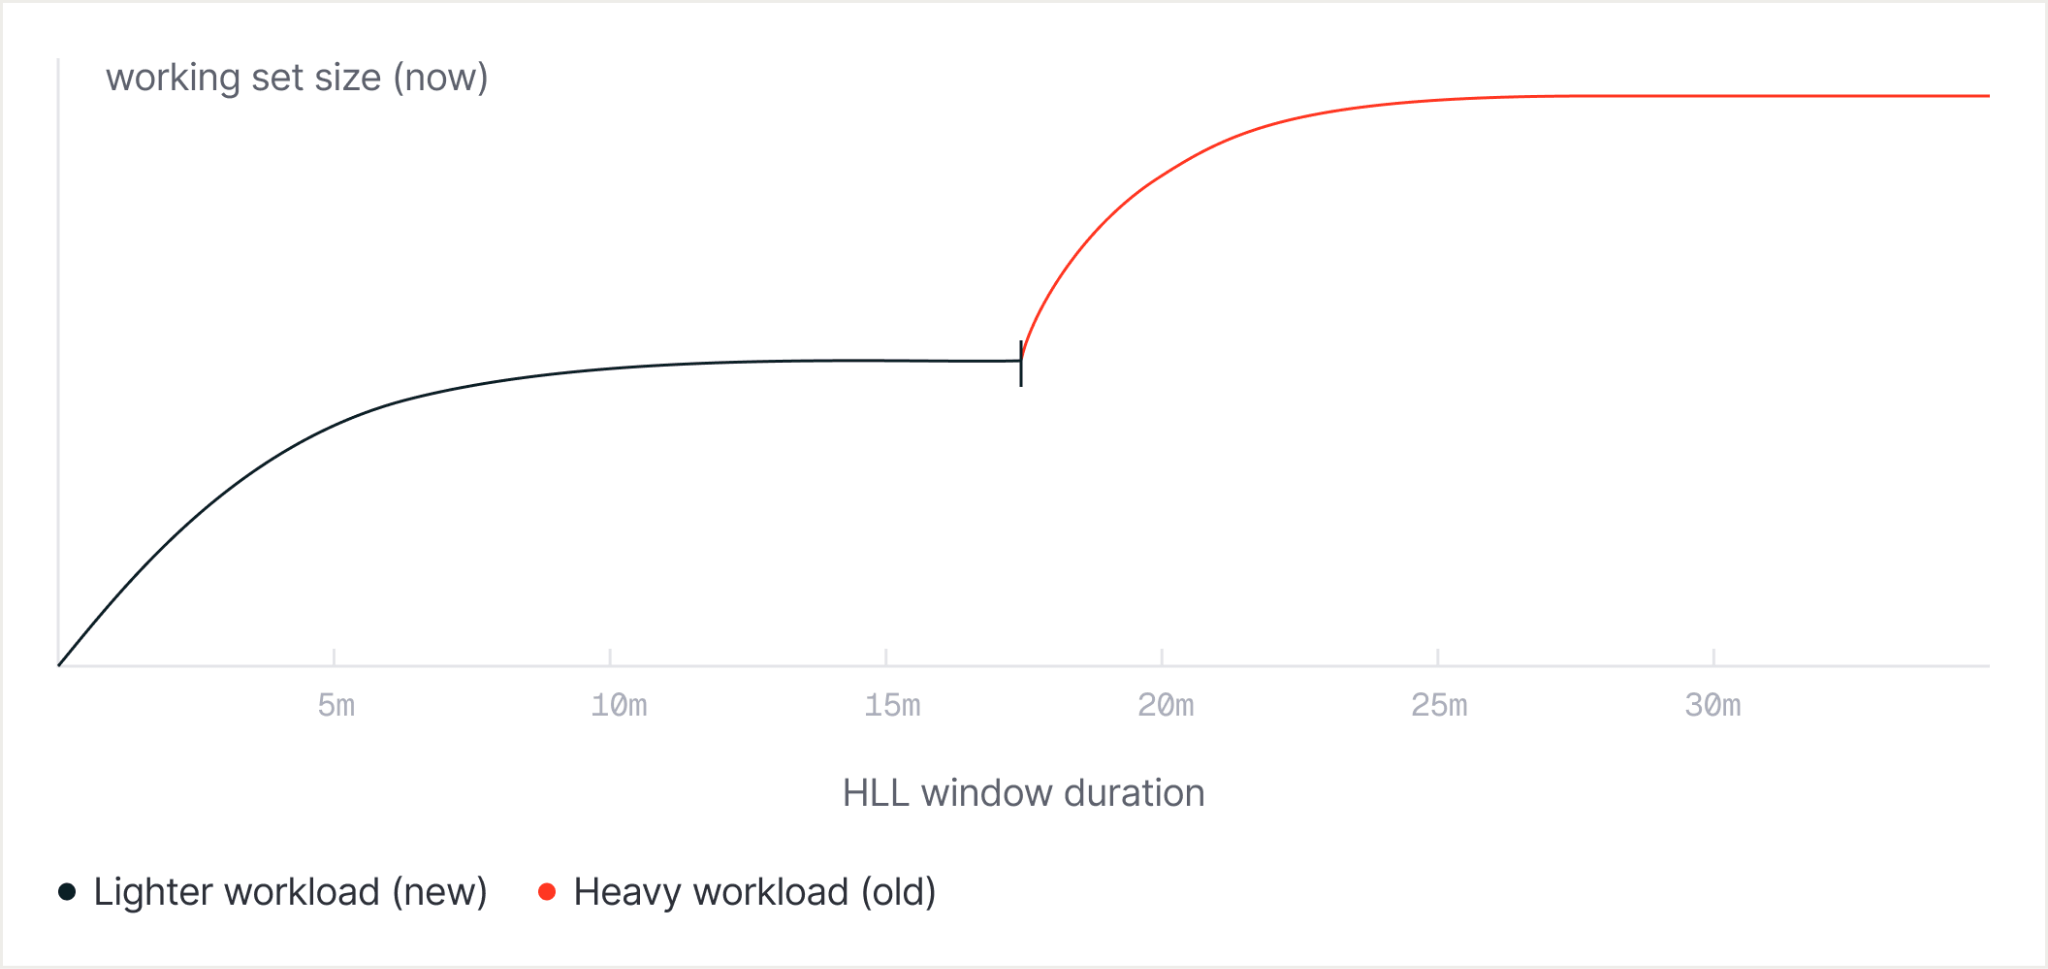
Agora, considere uma carga de trabalho pesada que terminou recentemente. Janelas curtas contêm apenas a carga de trabalho atual, mais leve; mas assim que a janela retrocede o suficiente no passado para incluir a carga de trabalho anterior, a estimativa dá um salto. O algoritmo busca por esse salto, que marca o fim do patamar atual.
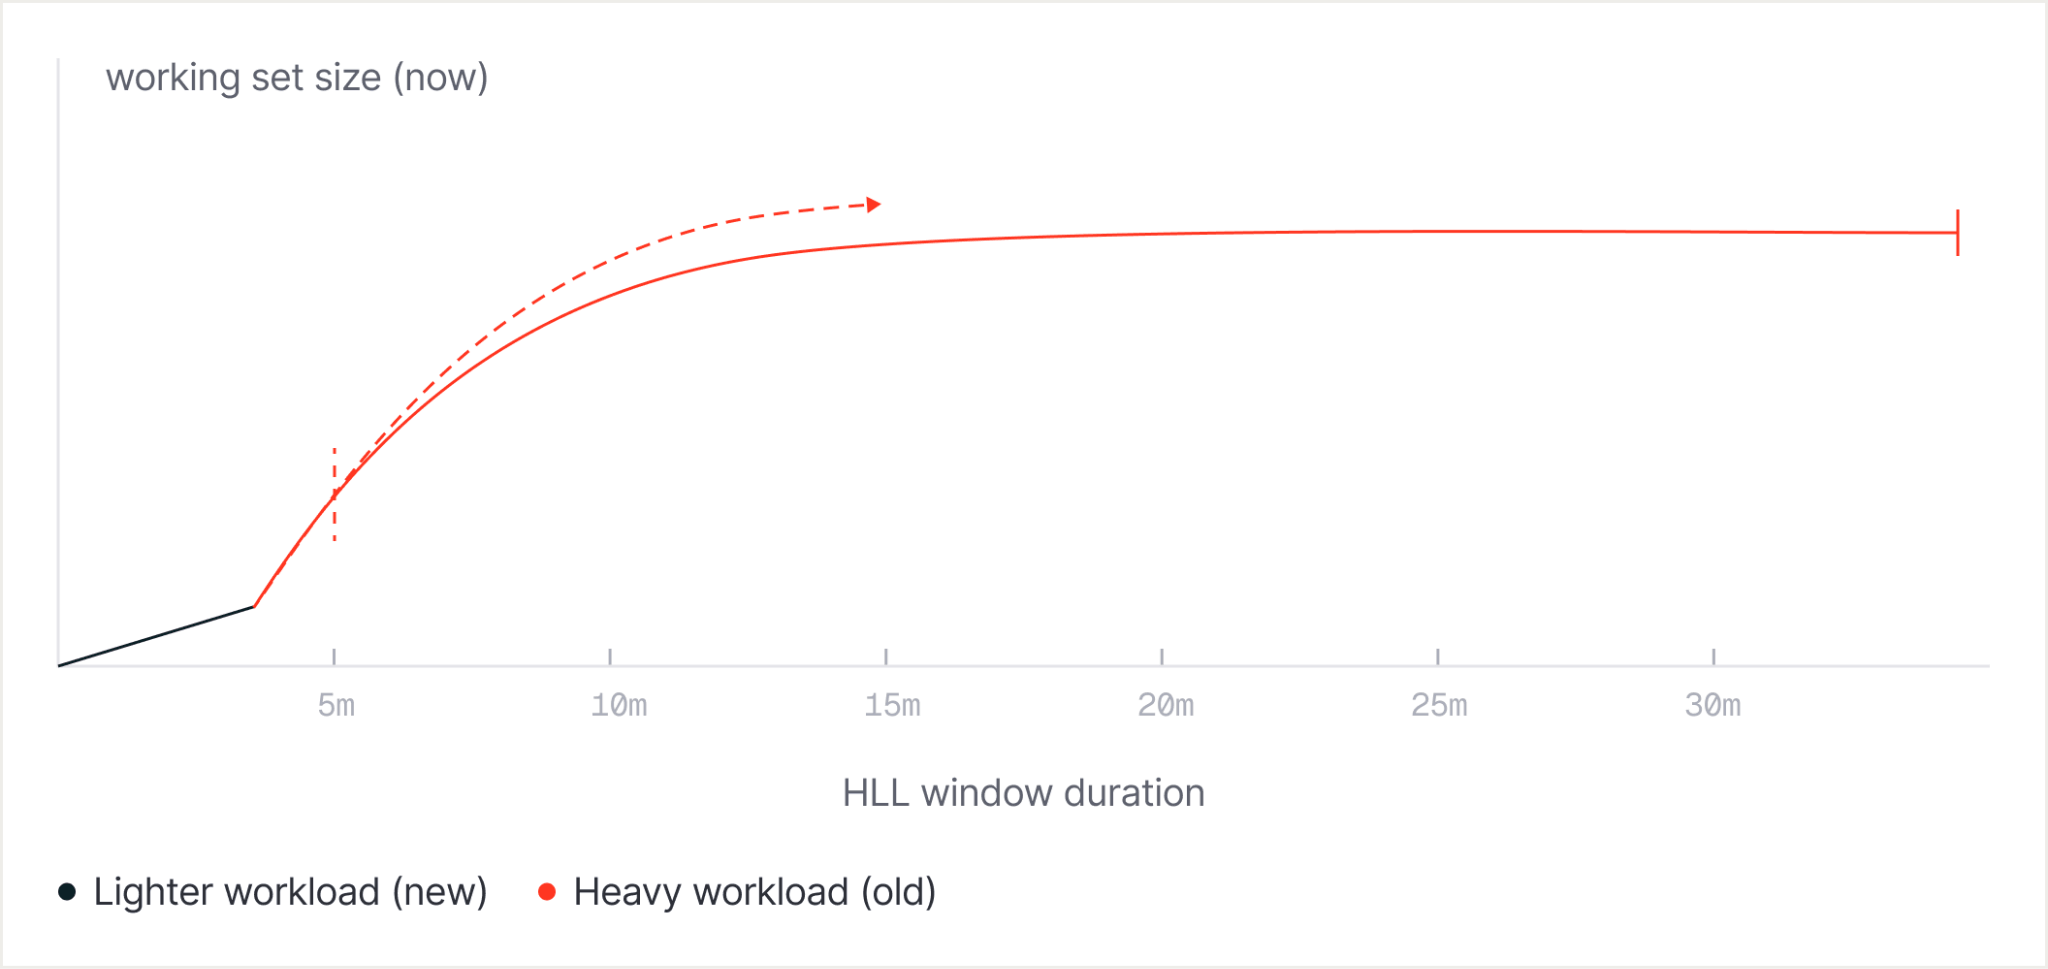
Resumindo:
A implementação inicia sua busca após cinco minutos. Isso evita que o recurso de computação diminua imediatamente durante uma pausa curta e depois cresça novamente no próximo pico. Mas se o algoritmo não encontrar nenhum aumento acentuado, ele usará a estimativa de 60 minutos — esse é o resultado esperado para uma carga de trabalho estável cujo conjunto de trabalho permanece ativo durante toda a hora.
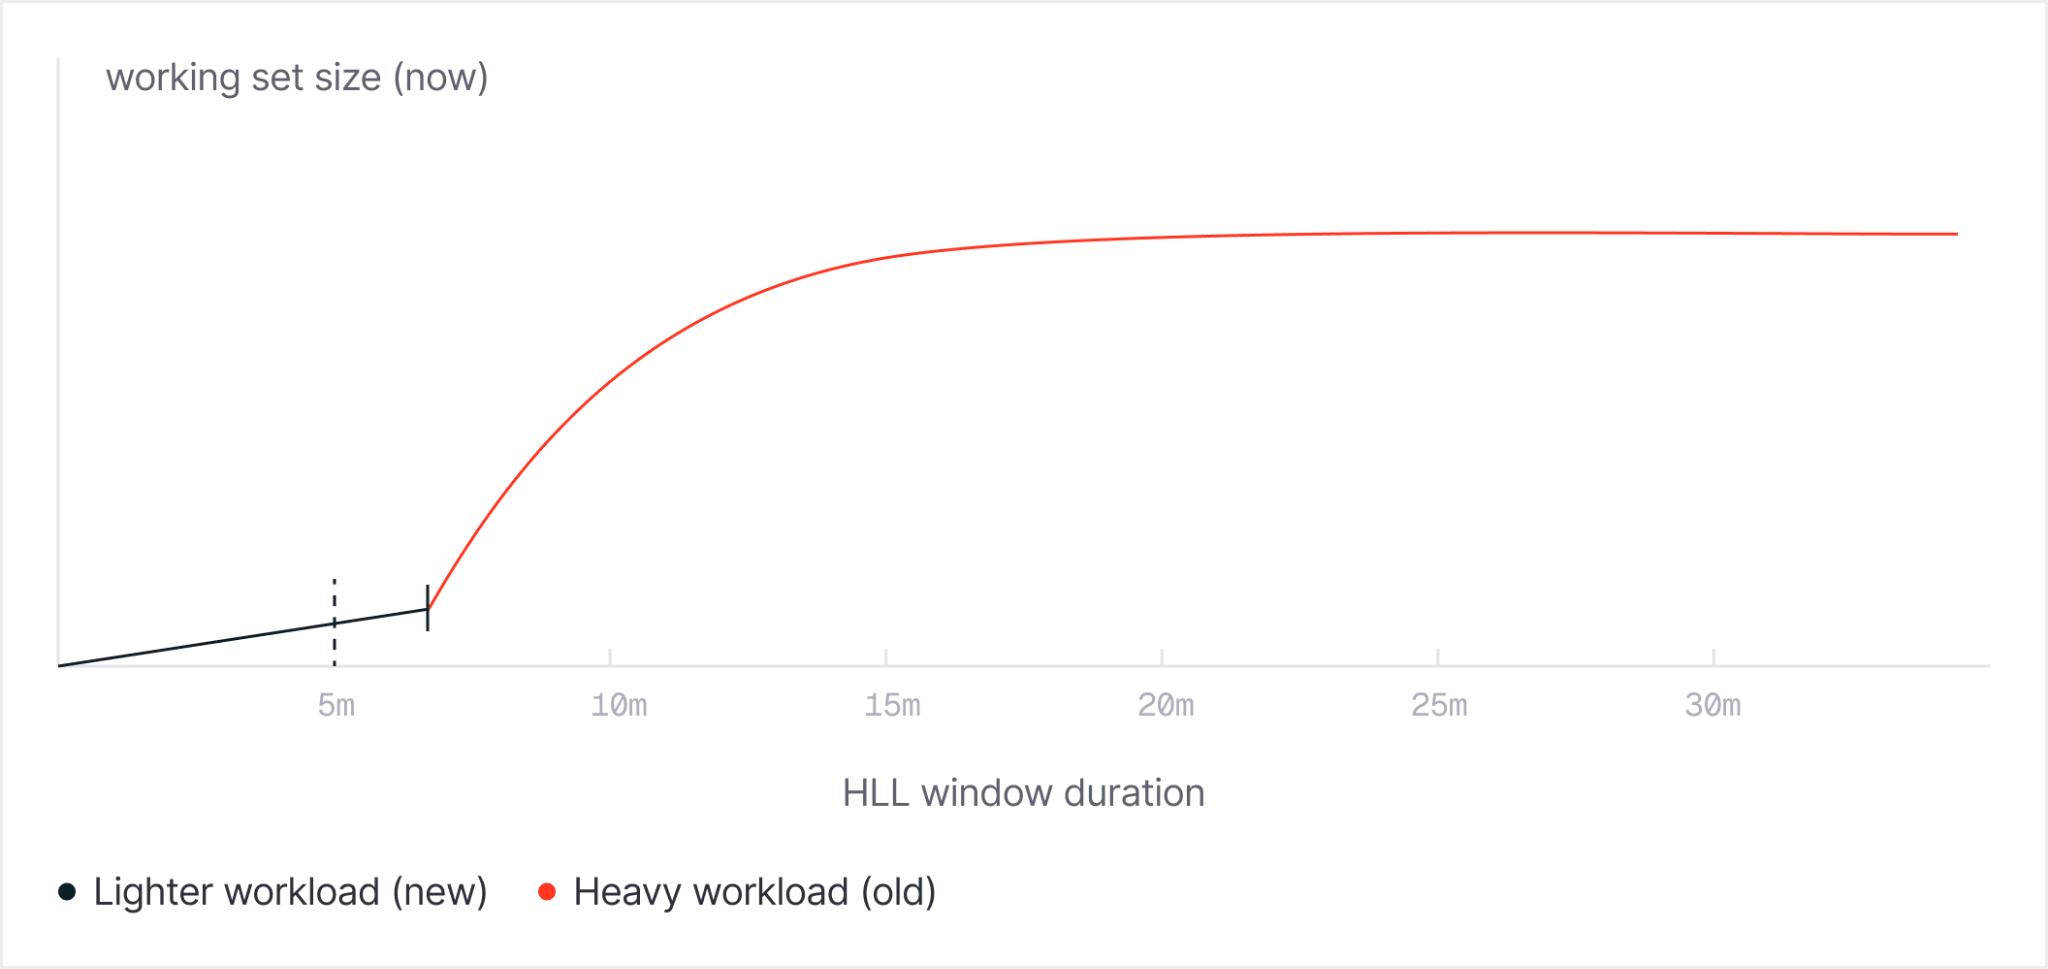
Projetando o crescimento do cache
Há uma última peça nessa engrenagem. Medir o conjunto de trabalho atual acontece um pouco tarde demais: suponha que uma carga de trabalho comece a escanear um novo conjunto de páginas. Se o cache de computação crescer apenas depois que essas páginas forem lidas, as primeiras páginas já podem ter sido descartadas para abrir espaço para as posteriores. O cache terá então que buscar alguns dos mesmos dados novamente.
Portanto, o algoritmo também projeta o crescimento do conjunto de trabalho para o futuro. Ele examina como a estimativa aumenta de uma duração para a outra e aloca cache suficiente para o conjunto de trabalho esperado no próximo intervalo de controle.
Como as métricas de cache são coletadas a cada 20 segundos, a projeção cobre apenas uma fração de minuto. Projeções mais longas reagiriam mais cedo, mas também amplificariam picos breves e fariam o recurso de computação oscilar.
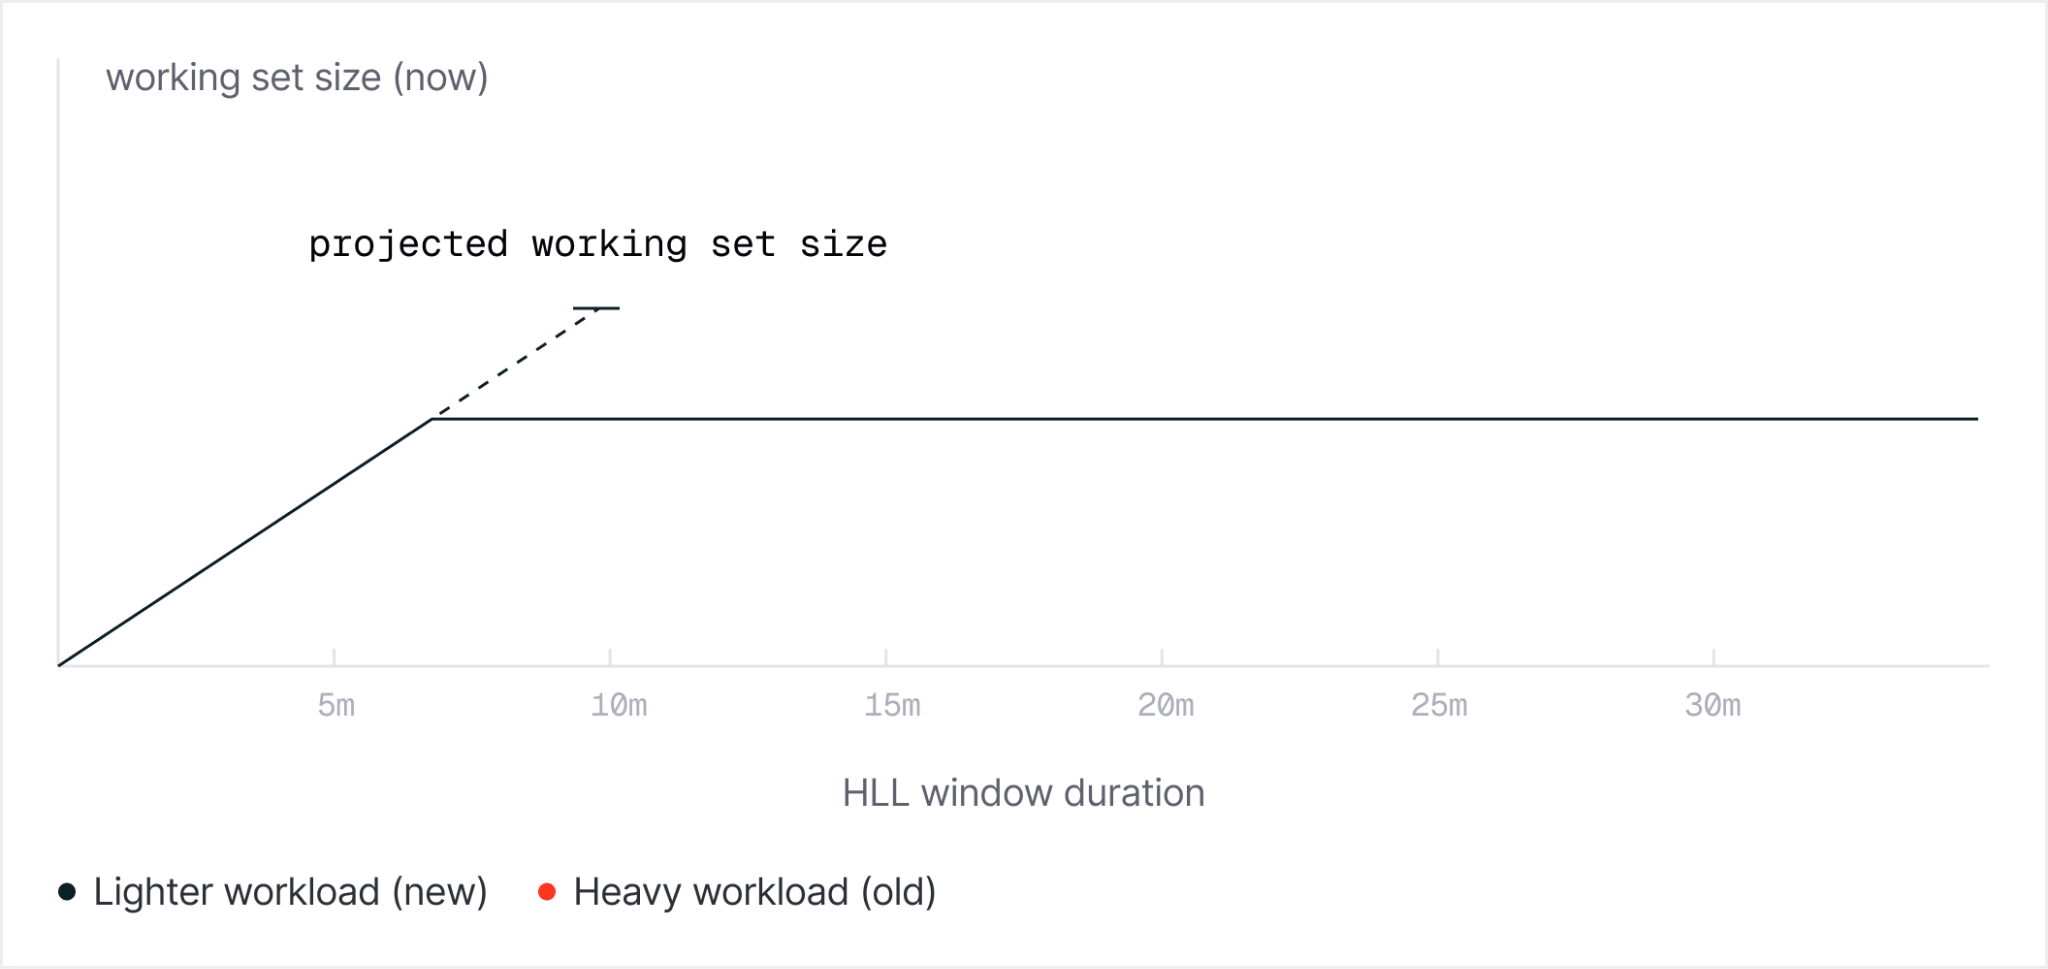
O tamanho projetado (finalmente!) torna-se lfcGoalCU. E o objetivo do algoritmo é ajustar o conjunto de trabalho dentro da parte da memória disponível para o cache de computação, até 75% da RAM do recurso de computação.
Parte II: Redimensionando a computação em execução
Recapitulando: a meta de dimensionamento era,
Esses três sinais dizem ao sistema qual tamanho buscar. Aplicar esse tamanho significa alterar a CPU e a memória em uma VM em execução sem interromper o Postgres.
Cada instância do Postgres no Lakebase Postgres é executada dentro de sua própria máquina virtual em um cluster Kubernetes. Usamos VMs porque elas fornecem um limite de isolamento forte e, ao contrário de uma alocação de contêiner convencional, permitem que CPU e memória sejam adicionadas ou removidas de um sistema convidado em execução.
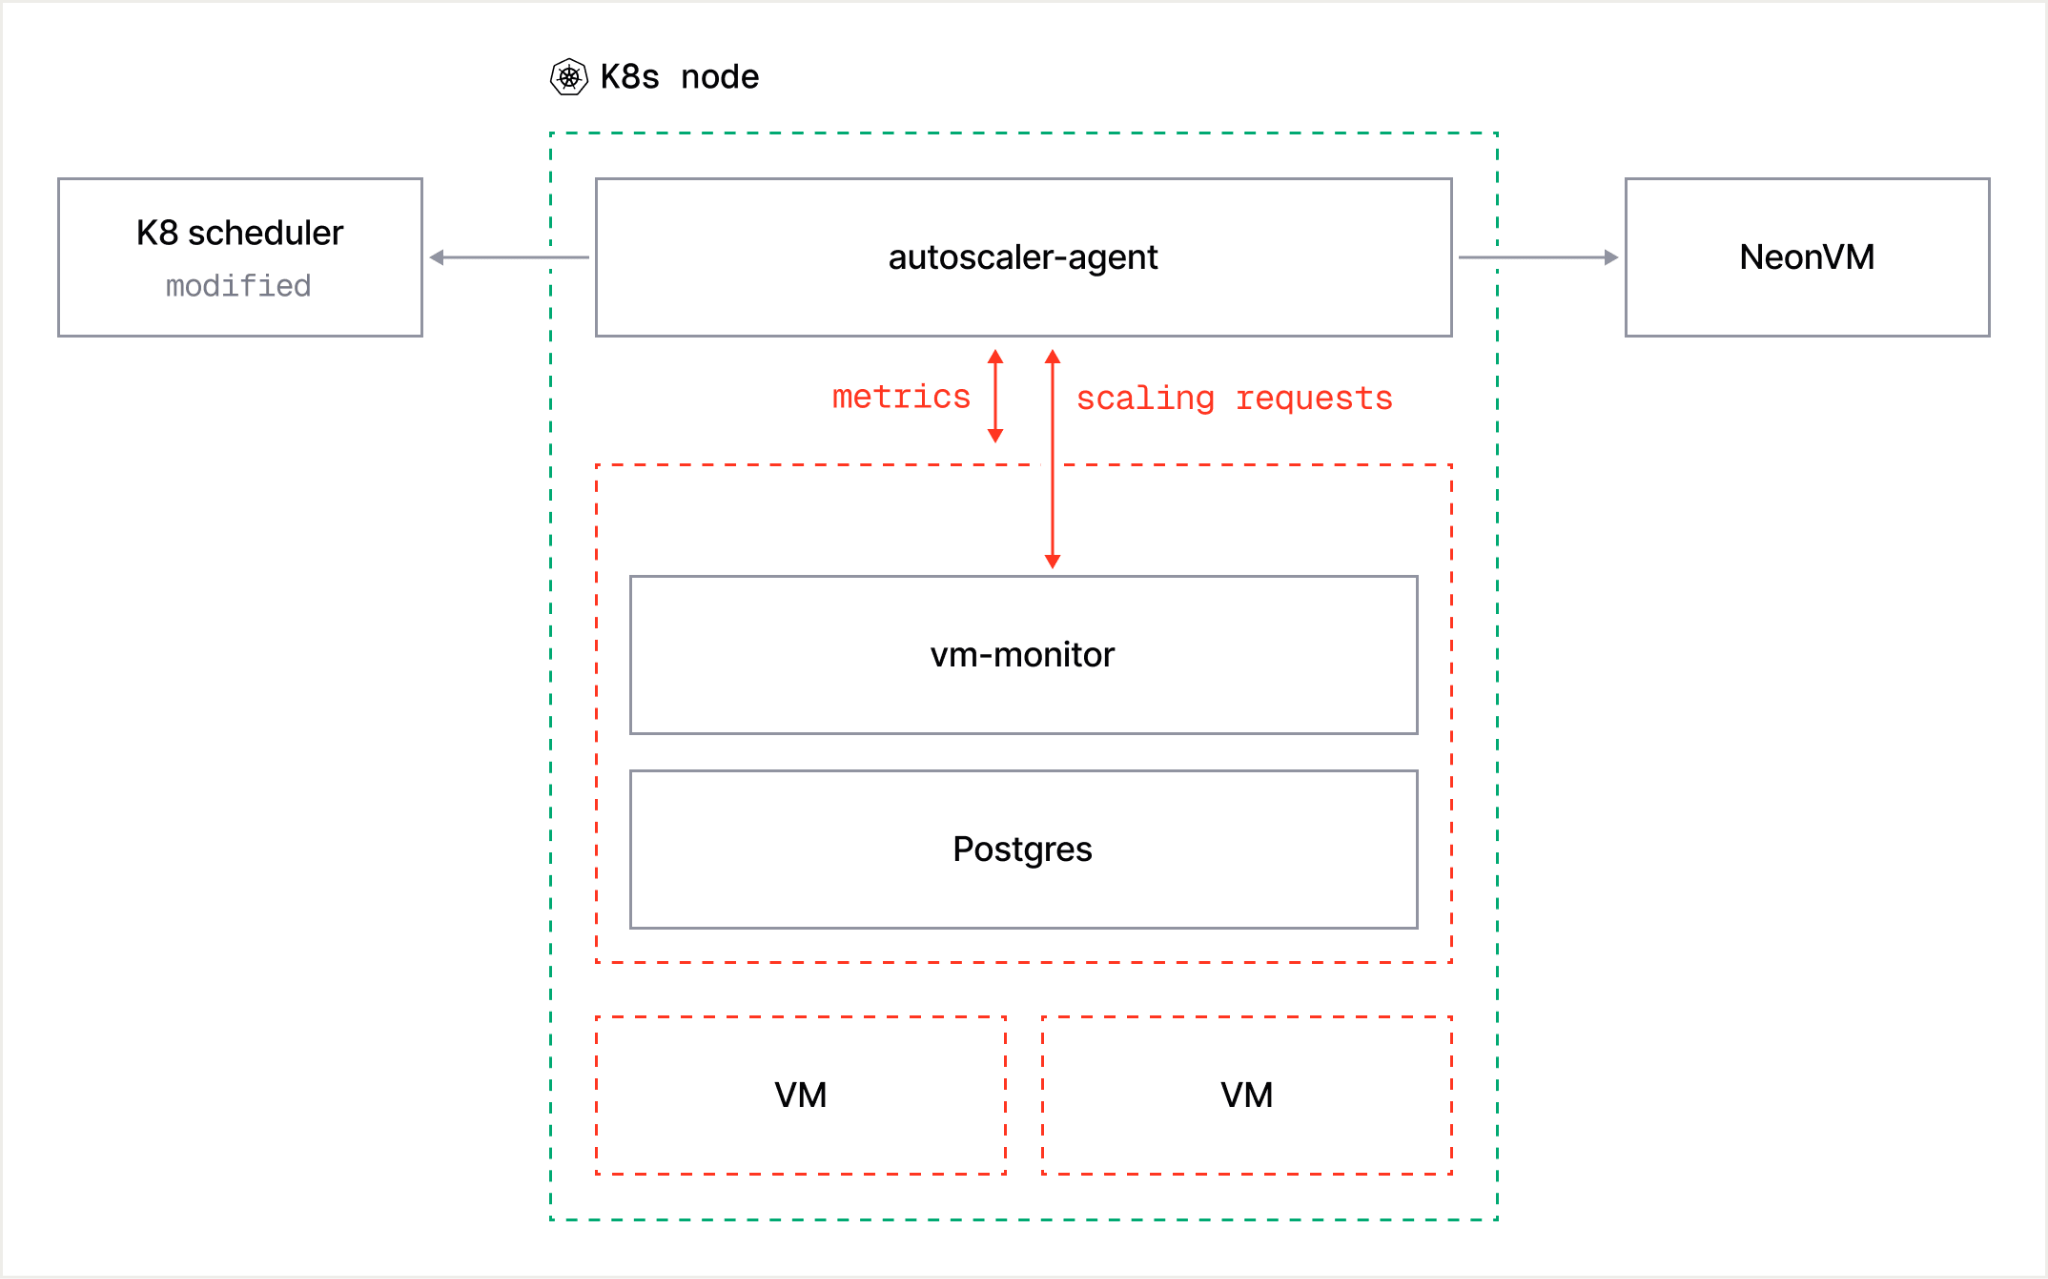
Quatro componentes coordenam cada redimensionamento de computação:
- O autoscaler-agent é executado em cada nó do Kubernetes. Ele coleta métricas das VMs do Postgres nesse nó, calcula os tamanhos de destino e inicia o dimensionamento.
- O vm-monitor é executado dentro de cada VM. Ele monitora de perto a memória do Postgres, valida solicitações de redução de escala e redimensiona o cache de computação.
- Um agendador Kubernetes modificado mantém a visão global dos recursos disponíveis. Cada aumento de escala deve ser aprovado pelo agendador antes que a memória seja confirmada.
- O NeonVM aplica a alteração. Trata-se de um recurso e controlador personalizado do Kubernetes, desenvolvido com QEMU e KVM, que pode adicionar ou remover CPU e memória de uma VM em execução. (Nota: a arquitetura do Lakebase Postgres começou no Neon e o nome do recurso/controlador permanece o mesmo).
Aumento de escala
Como acabamos de ver, o aumento de escala acontece quando um dos três objetivos exige mais computação do que a VM possui atualmente. Um aumento de escala segue esta sequência:
- O autoscaler-agent calcula o novo destino a partir dos objetivos de CPU, memória e conjunto de trabalho.
- O agendador do Kubernetes verifica se o nó pode atender à solicitação sem superalocar a memória.
- Uma vez aprovado, o autoscaler-agent atualiza o recurso NeonVM.
- O controlador NeonVM adiciona CPU e memória à VM em execução.
- O vm-monitor expande o cache de computação para usar a nova capacidade.
O agendador é a única fonte de verdade para a alocação. Ele vê tanto o agendamento comum do Kubernetes quanto as solicitações de autoscaling. Sem essa coordenação, o agendador poderia colocar uma nova carga de trabalho em um nó no mesmo momento em que o autoscaler confirmasse a memória restante para uma VM do Postgres.
Se um nó estiver muito cheio para crescer no local, o NeonVM pode migrar a VM ao vivo para outro nó. A VM mantém seu endereço IP, de modo que as conexões existentes permanecem abertas. Os recursos de computação do Lakebase Postgres têm pouco estado local durável para mover, portanto, a migração consiste principalmente na memória da VM e no estado de tempo de execução.
Redução de escala
A redução de escala usa exatamente os mesmos componentes, com uma verificação extra dentro da VM. O vm-monitor confirma se a remoção de memória ainda deixará o suficiente para o Postgres e o restante do sistema convidado. Se não deixar, a redução de escala não prossegue.
Aviso: A redução de escala é tão importante quanto o aumento de escala. Alguns sistemas de autoscaling são rápidos para adicionar capacidade, mas lentos para devolvê-la, deixando os bancos de dados superdimensionados muito tempo depois que um pico passou. O Lakebase Postgres trata as duas direções da mesma forma. O objetivo é acompanhar a carga de trabalho o mais de perto possível a cada momento, para que você pare de pagar pela capacidade assim que deixar de precisar dela.
Conclusão
O Lakebase Postgres monitora a carga de trabalho enquanto ela é executada e redimensiona o recurso de computação para corresponder em tempo real. A arquitetura lakebase torna isso possível: como o armazenamento é desacoplado e durável por si só, o recurso de computação fica livre para se mover sem se preocupar com os dados.
O sistema resultante escala em ambas as direções, em um banco de dados ativo, sem perder conexões. O mais importante é que ele vai além do sinal óbvio: rastrear apenas a CPU deixaria passar uma carga de trabalho paralisada por falhas de cache, por isso o algoritmo também rastreia a pressão de memória e uma estimativa do conjunto de trabalho que considera o tempo.
O loop final é executado em três escalas de tempo:
- 100 milissegundos: o vm-monitor verifica a memória do Postgres para detectar alocações rápidas
- 5 segundos: o autoscaler-agent lê a CPU e a memória geral
- 20 segundos: o autoscaler-agent avalia as estimativas do conjunto de trabalho em janelas de um a 60 minutos
É assim que um banco de dados de produção pode mudar de tamanho mais de 32.000 vezes por mês.
À medida que a computação se torna mais cara e mais disputada, pagar por um pico que você raramente atinge é um padrão de arquitetura que pode não ser viável por muito mais tempo. O autoscaling prepara o Postgres para cargas de trabalho onde o desperdício de computação não é uma opção.
Execute-o
Peça ao seu agente para implantar o Lakebase Postgres e coloque o escalonamento automático à prova. Comece aqui.
O Lakebase Postgres pode ser usado como um banco de dados independente, e você também pode integrá-lo ao restante da Plataforma Data + AI da Databricks: governança do Unity Catalog, análises de lakehouse, notebooks e fluxos de trabalho de IA.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.