BigQuery para Databricks: Um framework estratégico para migração moderna
Maximize o ROI e minimize os riscos adotando uma abordagem de migração em fases ao fazer a transição do BigQuery para o Databricks Lakehouse
por Takero Ibuki
- Um framework estratégico para migrar do data warehouse proprietário do Google BigQuery para a arquitetura aberta do Databricks Lakehouse.
- Ele permite que os clientes derrubem silos, unifiquem a governança e construam uma base para a inovação em AI, mantendo o TCO baixo, superando os obstáculos da inovação em AI e da governança fragmentada.
- A migração consolida BI, ETL e AI multimodelo em um único ambiente, resultando em desempenho previsível, redução de custos operacionais por meio de workspaces unificados e uma base "pronta para AI" que capacita as equipes de SQL a criar produtos de dados avançados.
A migração como uma evolução estratégica
O BigQuery costuma ser o padrão para começar rápido, mas, para muitas empresas, a escala acaba transformando essa simplicidade em um desafio de gerenciamento. Quando suas cargas de trabalho atingem um ponto em que a variação dos custos sob demanda e as reservas de slots exigem uma compensação entre o desempenho e o seu orçamento, somados à maior complexidade de gerenciar a governança de dados, é hora de repensar a arquitetura.
Ao consolidar ETL, armazenamento, BI e AI multimodelo em uma arquitetura Lakehouse única, aberta e simplificada com uma camada de governança unificada, as organizações eliminam silos proprietários e obtêm desempenho previsível em qualquer escala. Essa transição permite que as equipes migrem para um formato aberto que simplifica as operações, agiliza a conformidade desde os dados até a AI e viabiliza novos casos de uso baseados em AI.
Uma migração bem-sucedida exige mais do que apenas copiar tabelas. Ela exige uma estratégia em fases: extrair os dados de um armazenamento proprietário, transformar a lógica de maneira criteriosa e validar os resultados com ferramentas automatizadas para capturar o ROI. Este guia apresenta uma estrutura pragmática que abrange Processos, Tecnologia e Pessoas para navegar por essa transição com o mínimo de interrupção e impacto comercial mensurável.
Processo: A jornada de migração e a evolução da governança
O pilar de Processo define como você migra. O sucesso depende da escolha do ponto de partida correto e do gerenciamento eficaz do período de transição.
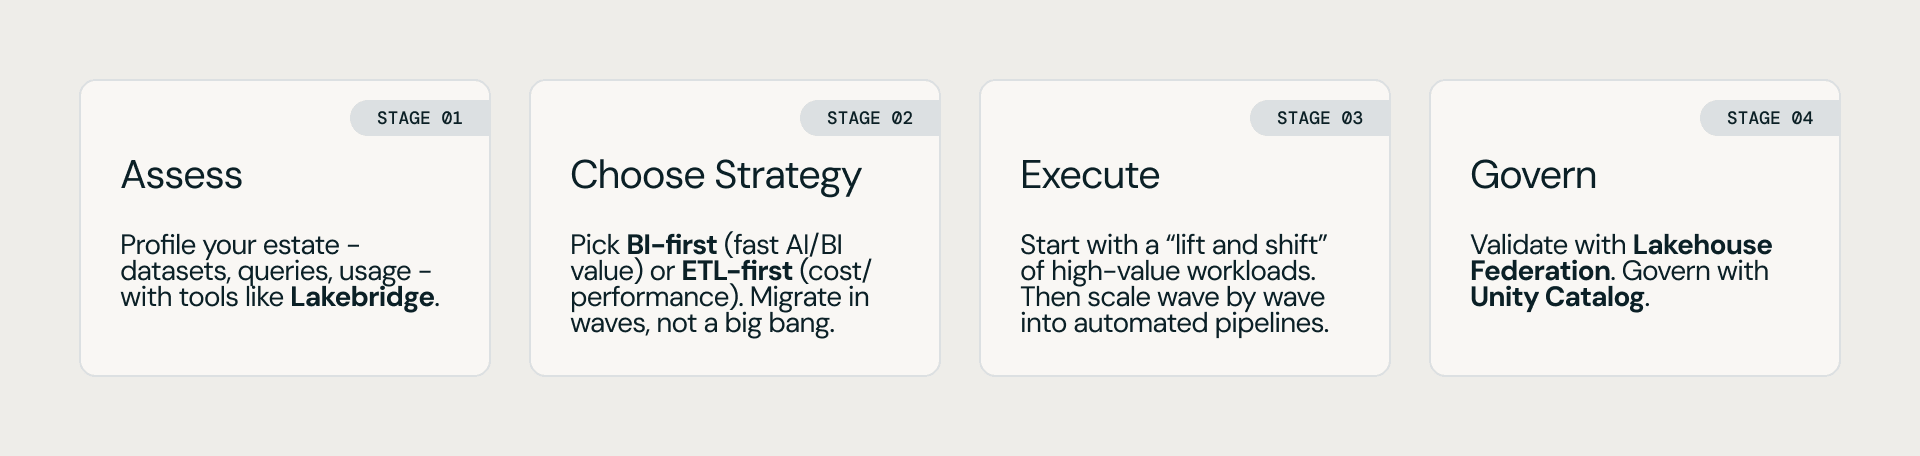
Avaliação
A jornada de migração ocorre em sequência: avaliar o ambiente, escolher um ponto de partida, migrar, validar em operação dupla e, em seguida, desativar. A avaliação vem antes de tudo: você não pode escolher o ponto de partida correto sem saber o que está executando hoje. Trace o perfil do ambiente do BigQuery primeiro — conjuntos de dados, histórico de consultas e consumo de slots — para descobrir quais cargas de trabalho geram custos, quais dashboards são realmente usados e quais tabelas nunca são consultadas. O Lakebridge, o kit de ferramentas de migração de código aberto do Databricks Labs, inclui um profiler do BigQuery que automatiza essa descoberta, para que as ondas de migração sejam planejadas com base no que é realmente usado, e não no que apenas existe.
Escolher a estratégia
- Primeiro o BI: priorize os dashboards que os tomadores de decisão veem todos os dias. Este é o caminho para um líder de analytics cujos dashboards estão lentos ou limitados por limites de simultaneidade, e cujos analistas desejam recursos de AI. Recrie os dashboards mais usados no Databricks, lendo os dados do BigQuery diretamente na origem no início, e faça a transição das equipes um caso de uso por vez, comprovando a paridade lado a lado. O retorno é visível desde o primeiro dia: dashboards mais rápidos e perguntas e respostas em linguagem natural com o Genie.
- Primeiro o ETL: priorize o back-end para resolver custos crescentes ou gargalos de desempenho. Ao descarregar o processamento pesado no mecanismo Photon/Spark, você estabiliza o "mecanismo" e cria uma base limpa para o futuro da AI. É ideal para um proprietário de plataforma de dados que vê os custos subirem e os prazos dos pipelines se perderem: mova o back-end primeiro e deixe os resultados falarem por si. A desvantagem é a visibilidade — os usuários de negócios veem pouco até que os pipelines sejam implementados —, portanto, publique os ganhos de custo e tempo de execução a cada onda. Em caso de dúvida, a avaliação decide: reclamações sobre dashboards apontam para 'Primeiro o BI'; custos de pipeline apontam para 'Primeiro o ETL'.
Qualquer que seja o ponto de partida escolhido, migre em ondas, não de uma só vez (big bang). Uma transição do tipo big bang concentra todo o risco em um único momento — e se algo der errado, a confiança em todo o programa também será abalada. As ondas mantêm o raio de impacto pequeno: classifique as cargas de trabalho em dois eixos — valor para a organização (o quão visível é para a liderança, o quão diretamente afeta a receita, o quão urgente é o prazo de conformidade por trás dela, quantas pessoas dependem dela no dia a dia) e complexidade da migração — e comece onde o valor é alto e a complexidade é baixa. Cada onda, então, entrega uma vitória de negócios visível, realiza a reconciliação antes do início da próxima e torna o manual da equipe mais ágil para a onda seguinte. Reserve o big bang para o raro ambiente pequeno e de baixo risco, onde manter duas plataformas custa mais do que protege.
Executar
- Lift and shift: migre a lógica SQL existente "como está" para o Databricks SQL. Isso garante a rápida desativação dos custos legados e ganhos imediatos de desempenho.
- Modernizar: uma vez estável, refatore os pipelines de alto valor no Lakeflow Spark Declarative Pipeline para orquestração automatizada, qualidade de dados integrada e uma estrutura unificada para lote (batch) e streaming.
A maioria das organizações passa por uma fase de Operação Dupla usando o Lakehouse Federation para espelhar ("shadow") cargas de trabalho para validação. A chave para o ROI é definir "critérios de sucesso" claros (por exemplo, 99,9% de paridade) para acionar a desativação imediata dos pipelines legados, eliminando o custo de manter duas plataformas em execução.
A operação dupla funciona em ambas as direções, e a ponte certa depende do seu ponto de partida. As equipes que priorizam o BI usam o Lakehouse Federation para que o Databricks possa ler o BigQuery enquanto os dashboards são movidos primeiro. As equipes que priorizam o ETL invertem o processo: movem a ingestão e a transformação para o Databricks, gravam as tabelas tratadas em formatos abertos e deixam o BigQuery continuar atendendo aos dashboards e aplicativos existentes a partir dessa mesma cópia única — sem pipelines de gravação dupla, sem trabalhos de exportação, sem uma segunda cópia para reconciliar. A migração em ondas mantém essa janela de operação dupla curta e estreita: apenas as cargas de trabalho na onda atual arcam com o custo de execução em duas plataformas simultaneamente, de modo que a conta da operação dupla permanece proporcional ao que está realmente em andamento, não a todo o ambiente. Trate o "BigQuery como camada de visualização" (BigQuery-as-serving-layer) como um estado de transição, e não como um destino: as tabelas externas são somente leitura no lado do BigQuery e apresentam limitações, como a atualização manual do esquema após alterações de esquema, portanto, planeje a transição da camada de visualização para o Databricks SQL como a etapa final da jornada.
Governança como motor
O Unity Catalog transforma a governança de um obstáculo em um motor estratégico. Ele oferece um mapeamento contínuo de 3 níveis (Project -> Catalog, Dataset -> Schema, Table -> Table) que replica as permissões do BigQuery, ao mesmo tempo em que adiciona linhagem automática de ponta a ponta e trata os modelos de AI como cidadãos de primeira classe.
O mapeamento vai além da hierarquia de objetos. O Unity Catalog oferece a mesma proteção granular de forma nativa: filtros de linha restringem o acesso linha por linha, e máscaras de coluna e tags gerenciam a segurança em nível de coluna — assim, a proteção acompanha os dados em vez de ser recriada do zero. E uma regra de sequenciamento prática: migre as permissões antes dos dados, para que a transição de cada onda altere onde uma tabela reside, mas nunca quem pode visualizá-la.
Tecnologia: construindo a base aberta
O pilar técnico se concentra na transição de um modelo de armazenamento proprietário e fechado para uma arquitetura aberta e de alto desempenho.
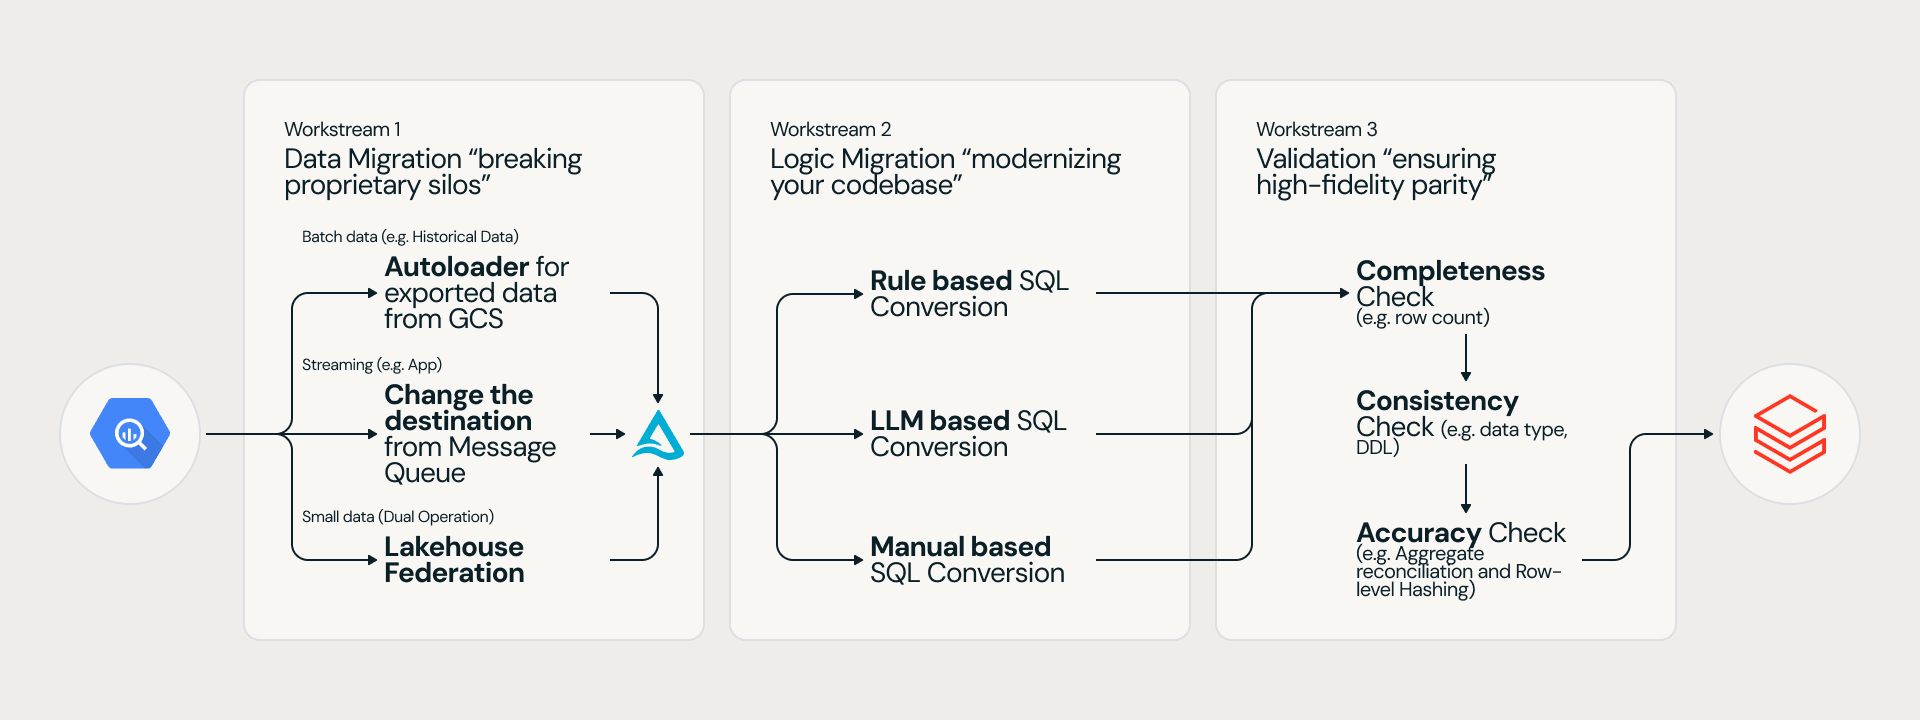
A modernização do BigQuery para o Databricks envolve três frentes de trabalho: Migração de dados, Migração de lógica e Validação.
Migração de dados
Escolha o caminho por volume e atualização dos dados. O histórico em lote é movido mais rapidamente por meio da exportação do BigQuery para Parquet no Google Cloud Storage, geralmente a rota mais econômica em escala, e a exportação também funciona como uma cópia estática de um ponto no tempo que simplifica a validação. As tabelas atualizadas continuamente são lidas por meio do conector da Storage API ou redirecionadas na origem, e conjuntos de dados pequenos e que mudam com frequência podem continuar disponíveis para consulta por meio de federação até que sua onda chegue. Tudo é gravado em formatos abertos, pronto para as camadas medalhão (medallion layers).
Migração de lógica
Nunca converta um ambiente manualmente. Três níveis cobrem isso: transpilação baseada em regras (por exemplo, Lakebridge) para a maior parte do SQL rotineiro, conversão assistida por LLM para particularidades do dialeto e engenheiros reservados para a parte genuinamente complexa. A orquestração segue o mesmo padrão: consultas agendadas e DAGs do Composer são mapeados para Lakeflow Jobs.
Validação
Planeje o orçamento para a validação com a mesma seriedade que para a migração em si — na prática, ela costuma consumir um esforço comparável. Execute-a em três níveis: integridade (contagem de linhas), consistência (esquemas e tipos) e precisão (reconciliação agregada mais hash em nível de linha), automatizada com a reconciliação do Lakebridge, que oferece suporte ao BigQuery como origem nativa. Uma lição prática: pequenas diferenças de funções integradas entre os dois dialetos SQL podem corromper as comparações de hash — investigue as divergências antes de presumir perda de dados. A paridade aqui é o que aciona a desativação na jornada de Processo.
Formatos de tabela abertos
A fundação aberta traz retornos antes mesmo de a migração terminar. Como o Delta Lake e o Apache Iceberg são formatos abertos, as tabelas que você armazena no Google Cloud Storage podem ser lidas por outras plataformas além do Databricks: o BigQuery lê Delta por meio de tabelas externas do BigLake e Iceberg por meio de tabelas externas do Iceberg, e a federação de catálogos entre o Unity Catalog e o BigQuery (atualmente em preview) permite que ambas as plataformas governem e consultem as mesmas tabelas sem copiá-las. O armazenamento é desacoplado do mecanismo — uma cópia dos dados, muitos mecanismos. Essa interoperabilidade não é um benefício secundário; é a capacidade por trás dos padrões de transição de baixo risco descritos na seção Processo.
Pessoas: Organizando a equipe moderna de Dados + AI
O terceiro pilar oferece o ROI definitivo de uma migração: uma força de trabalho mais capacitada e unificada.
Acabando com a cultura de passagem de bastão. Em pilhas legadas, a lacuna entre analistas de SQL e cientistas de dados cria silos. No Databricks, Notebooks compartilhados permitem que todo o "squad" trabalhe no mesmo espaço de trabalho, reduzindo o excesso de comunicação.
Desenvolvendo o novo conjunto de habilidades. O Genie funciona como uma ponte para equipes focadas em SQL. Os analistas podem usar linguagem natural para gerar código Python ou Spark, transformando analistas tradicionais em profissionais de dados versáteis, sem uma curva de aprendizado íngreme. Combine essa assistência de AI do dia a dia com treinamentos estruturados, cursos da Databricks Academy e certificações baseadas em funções, para que o novo conjunto de habilidades se consolide em toda a organização, em vez de depender de alguns poucos adotantes iniciais autodidatas.
Rigor de engenharia. As equipes passam de "escrever consultas" para "construir produtos de dados" ao adotar as melhores práticas de engenharia de software, como Unity Catalog, integração com Git e CI/CD.
Lições de campo
Seis padrões se repetem em migrações bem-sucedidas do BigQuery, com base em nossa experiência em projetos de migração:
- Trace o perfil antes de planejar. Na maioria dos ambientes, uma parcela significativa das tabelas do BigQuery é raramente ou nunca consultada. Analisar o histórico de consultas e o uso de slots primeiro significa que você migrará as cargas de trabalho que importam e desativará o restante.
- Defina os critérios de paridade antes do início da execução dupla. Entre em acordo sobre o limite de sucesso (por exemplo, 99,9% de reconciliação entre contagens de linhas, agregações e hashes) logo no início — sem isso, o período de transição em paralelo não terá uma condição de saída.
- Não converta o SQL manualmente. A transpilação baseada em regras combinada com a conversão assistida por AI lida com a maior parte do ambiente; reserve os engenheiros para a parte restante que for genuinamente complexa.
- Mapeie a governança de um para um primeiro, modernize depois. O mapeamento de projeto → catálogo, conjunto de dados → esquema, tabela → tabela no Unity Catalog preserva as permissões existentes — incluindo políticas de nível de linha e coluna — desde o primeiro dia; marcações mais ricas, controles baseados em atributos e governança orientada por linhagem podem evoluir após a transição definitiva.
- Trate iniciativas focadas em BI como um projeto de gestão de mudanças. A tecnologia costuma ser a parte mais fácil; os analistas cujos painéis serão movidos precisam de capacitação, defensores e um ciclo de feedback.
- Desative os sistemas antigos sem hesitar. A cada semana que ambas as plataformas funcionam em paralelo, o ROI diminui. Comemore os desligamentos, não apenas os lançamentos.
Conclusão
Migrar para o Databricks não é um salto único — é uma sequência de decisões que você pode planejar de verdade: qual ponto de entrada se adapta à sua equipe, como sequenciar as ondas para que cada uma garanta uma vitória antes do início da próxima e qual ponte mantém o BigQuery e o Databricks funcionando lado a lado até que o último painel seja migrado. Acerte esse sequenciamento e Processo, Tecnologia e Pessoas se reforçarão mutuamente: a migração de dados, a transformação lógica e a validação desativam o ambiente antigo de um lado, enquanto analistas que fazem consultas em linguagem natural com o Genie e engenheiros que entregam produtos de dados governados constroem sobre ele do outro.
O resultado não é apenas um lakehouse aberto substituindo um warehouse proprietário — é uma migração em que sua organização pode confiar onda após onda, e uma equipe que está pronta para construir sobre a nova base.
Pronto para planejar sua migração? Explore o hub de migração do Databricks, avalie seu ambiente com o toolkit de código aberto Lakebridge ou entre em contato com a equipe de contas do Databricks para uma avaliação de migração.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.