Apresentando a memória de agente no Databricks
por Sirui Sun e Nihit Desai
Hoje estamos apresentando a memória de agente no Agent Bricks, a plataforma de desenvolvimento de agentes da Databricks. A memória de agente melhora a qualidade do agente enquanto reduz custos e latência ao armazenar fatos críticos, preferências e fluxos de trabalho que um agente deve lembrar. Ela está disponível em Beta hoje, roda no Lakebase para alta confiabilidade e baixa latência, e foi desenvolvida com base nas pesquisas de memória mais recentes da Databricks.
Sem memória, os agentes correm o risco de redescobrir fatos importantes, esquecer as preferências do usuário e repetir erros que já foram corrigidos. Como resposta, muitos desenvolvedores estão criando suas próprias soluções de memória, mas enfrentam várias questões de design — por exemplo, onde as memórias devem ser armazenadas? Como as memórias devem ser sintetizadas? E, uma vez geradas, como devem ser recuperadas?
Para resolver isso, a Databricks Agent Memory foi construída com base na arquitetura MemCurrent, pioneira pela Databricks Research. O MemCurrent combina três padrões de acesso: plugins para registrar e carregar o contexto automaticamente, ferramentas que o agente chama sob demanda e um pipeline de "sonho" offline que consolida a memória em segundo plano. Tudo isso é fornecido com latência extremamente baixa usando o Lakebase. Em nossos benchmarks internos, a implementação dessa arquitetura de memória triplicou a taxa de aprovação do agente em tarefas empresariais reais, usando 31% a menos de tokens.
A Agent Memory se junta ao restante do Agent Bricks, incluindo hospedagem de agentes, Databricks Sandbox, Unity Gateway, servidores MCP pré-construídos e rastreamento e avaliação, fornecendo aos desenvolvedores todas as funcionalidades de infraestrutura necessárias para criar agentes de produção.
Problema: agentes sem estado pagam pelo mesmo contexto duas vezes
Dois problemas aparecem assim que um agente passa de uma demonstração para o uso diário.
- Os custos aumentam a cada redescoberta. Um agente sem estado deduz novamente o que descobriu ontem: qual tabela contém dados de uso, o que significa uma sigla interna, qual junção realmente funciona. Em uma sessão real da nossa pesquisa, um agente levou 11 chamadas de ferramentas, 8 subagentes e quase seis minutos para responder a uma pergunta sobre os principais clientes de um produto. No dia seguinte, ele teria feito tudo isso de novo.
- Os agentes nunca se tornam pessoais. O usuário declara uma preferência, corrige um erro ou explica como sua equipe define uma métrica, e o agente se esquece disso quando a sessão termina. Ou o usuário se repete, ou o agente repete o erro.
Os desenvolvedores de agentes e as equipes de plataforma que operam seus agentes têm duas soluções alternativas comuns. Cada uma troca um problema por outro:
- Reproduzir todo o histórico no contexto funciona até que os históricos fiquem longos. Em benchmarks de memória open source, o contexto completo usou cerca de 12 vezes mais tokens de entrada por pergunta do que uma memória bem projetada com a mesma precisão e, nos históricos mais longos, obteve um desempenho pior, porque interações irrelevantes confundiam o agente.
- Criar a memória você mesmo em um armazenamento de objetos ou em um banco de dados vetorial significa ser responsável pela extração, eliminação de duplicatas, recuperação e controle de acesso. As memórias ficam desatualizadas, fatos contraditórios se acumulam e ninguém consegue identificar qual memória causou uma resposta ruim.
O que as equipes precisam é de uma memória que torne os agentes mais baratos e mais personalizados ao mesmo tempo, sem a necessidade de criar outro sistema para isso.
Como funciona a Agent Memory na Databricks
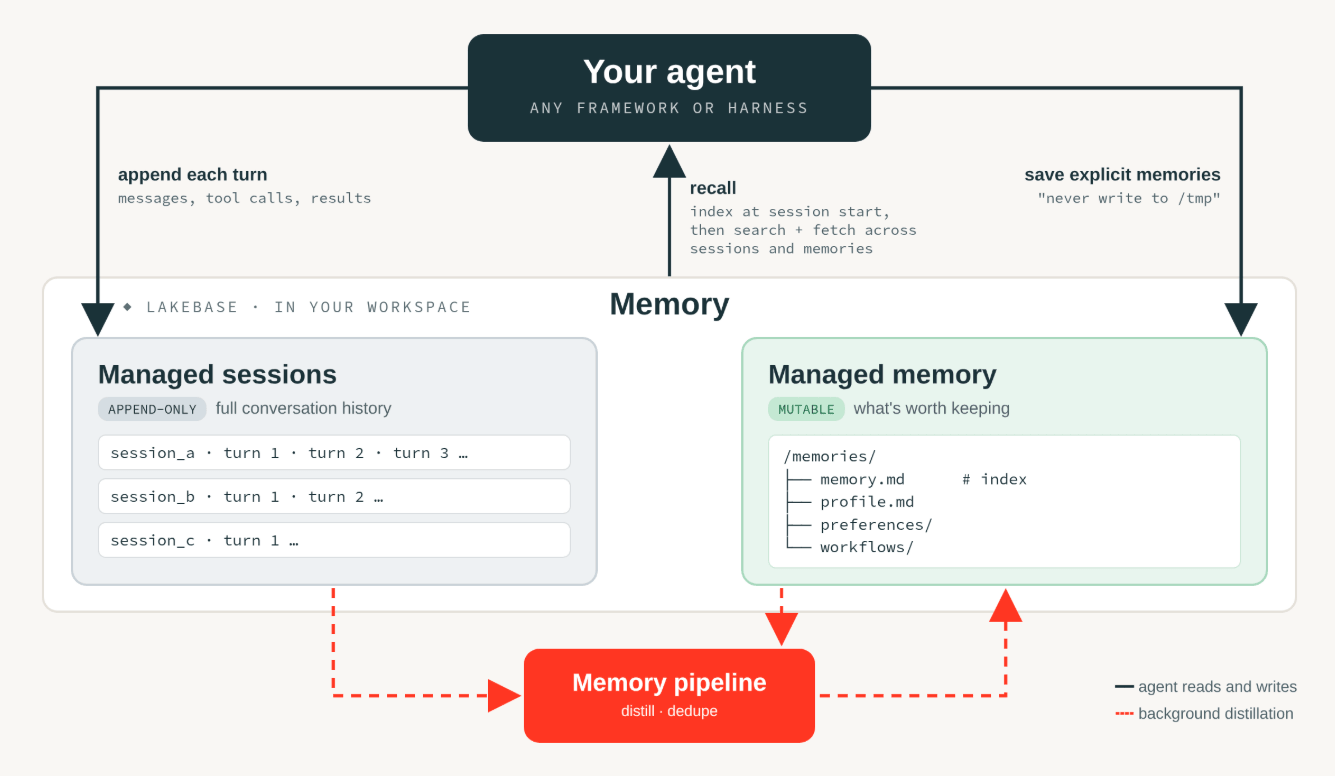
Figura 1. Agent Memory no Agent Bricks. O agente anexa cada interação a sessões gerenciadas, recupera e salva memórias diretamente, e um pipeline de memória destila as sessões em memória de longo prazo em segundo plano.
A Agent Memory tem três partes:
- Sessões gerenciadas registram cada conversa como um histórico ordenado de mensagens, chamadas de ferramentas e resultados, no formato nativo do seu framework.
- Memória gerenciada guarda o que vale a pena lembrar: perfil, preferências, conhecimento de domínio e fluxos de trabalho. No início de uma sessão, o agente carrega um índice do que é conhecido na memória. Durante a sessão, ele encontra detalhes com busca híbrida por palavra-chave e busca semântica.
- Pipelines de memória destilam sessões em memória sob demanda ou de forma regular em segundo plano. Eles extraem fatos duradouros e preferências, removem duplicatas e substituem fatos que conversas mais recentes contradizem.
Tudo roda no Lakebase, o Postgres serverless da Databricks, provisionado no seu workspace e operado pela Databricks. Isso garante que o armazenamento e a recuperação de memórias sejam extremamente rápidos, e que seus armazenamentos possam escalar junto com o tráfego do seu agente.
Construído com base em nossas pesquisas de memória
A Agent Memory é uma implementação de produção do MemCurrent, o sistema de memória descrito em MemCurrent: Projetando memória para agentes empresariais. A principal descoberta dos nossos pesquisadores é que a memória funciona melhor em duas camadas: um registro bruto do que aconteceu e um registro destilado do que vale a pena lembrar, mantido atualizado por um processo em segundo plano, em vez de ser escrito de forma ad hoc pelo agente no meio da tarefa.
Construída dessa forma, a memória melhorou a qualidade e a eficiência ao mesmo tempo. Os agentes aprovaram cerca de três vezes mais tarefas do que os agentes sem memória, terminaram mais rápido e usaram menos tokens. A mesma infraestrutura já alimenta a memória no Genie, a experiência de linguagem natural da Databricks para usuários de negócios.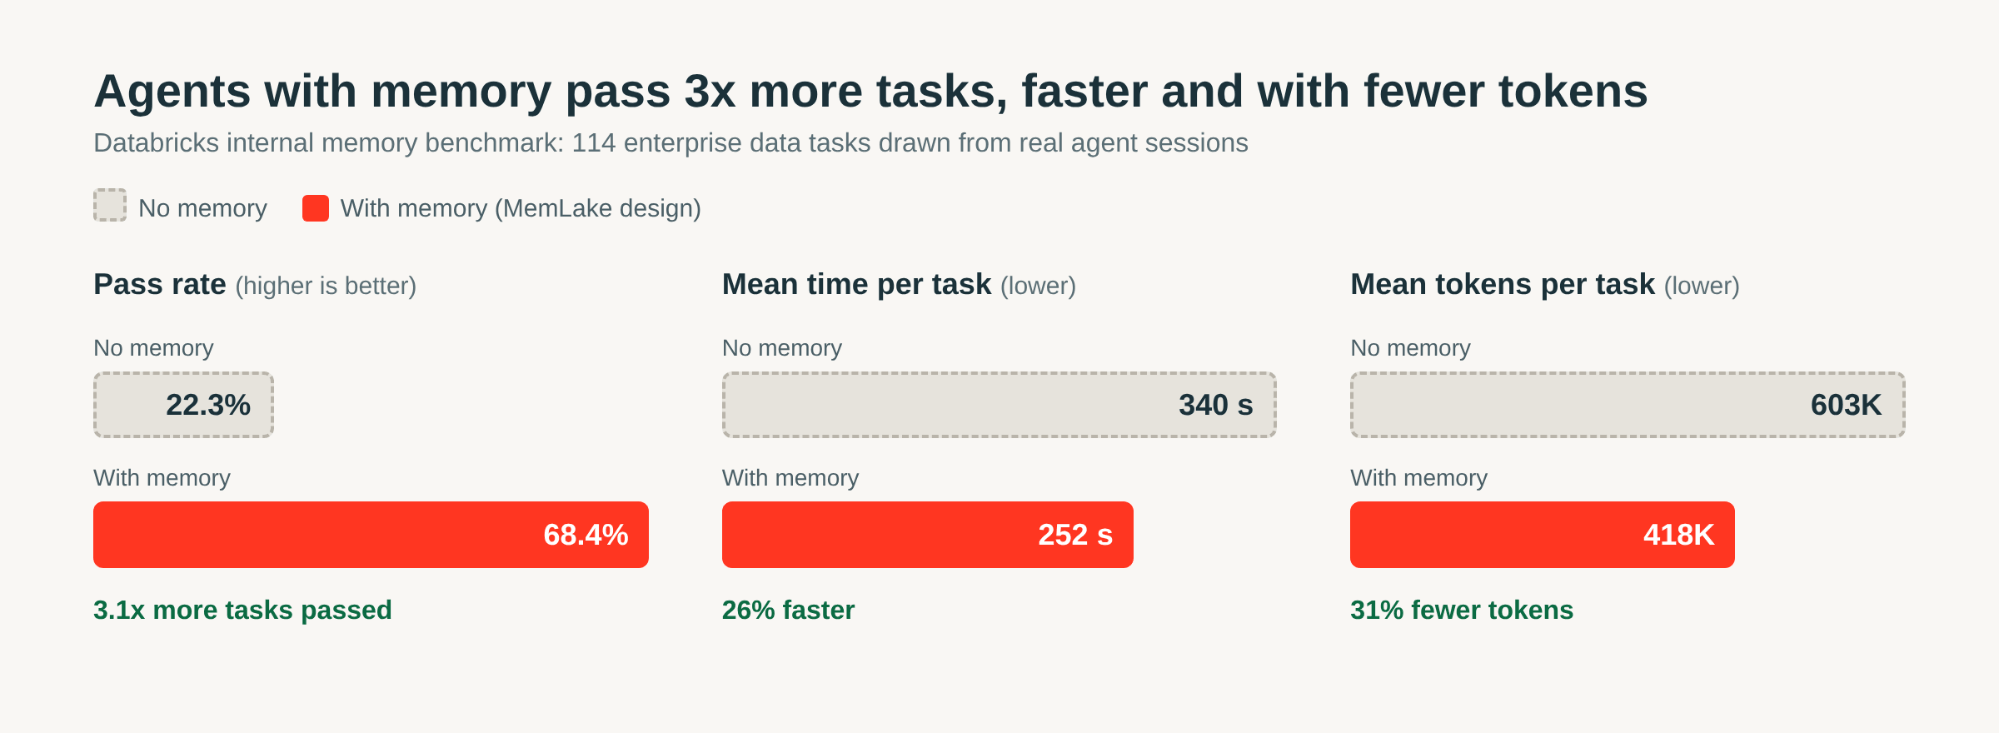
Figura 2. Agentes com e sem memória no benchmark interno de memória da Databricks para tarefas de dados empresariais. Fonte: Pesquisa MemCurrent.
O que muda para os seus agentes
- Custo menor por tarefa. Os agentes pulam trabalhos que já fizeram. No exemplo acima, uma vez que o fluxo de trabalho foi salvo na memória, o agente respondeu a uma pergunta de acompanhamento relacionada em 2 chamadas de ferramentas e 41 segundos, em comparação com 11 chamadas de ferramentas e quase seis minutos.
- Personalização contínua. Preferências, correções e definições específicas da equipe são mantidas entre as sessões, com escopo definido para cada usuário, para que as pessoas parem de se repetir.
- Erros que permanecem corrigidos. Os agentes se lembram de seus erros e podem evitar cometer o mesmo erro duas vezes — economizando tempo valioso e tokens.
- Memória que você possui e controla. Sessões e memórias residem no seu projeto Lakebase, independentemente de qualquer framework de agente individual. Desenvolvedores podem ler, exportar e excluir as entradas que um agente mantém sobre cada usuário, além de dar instruções a um pipeline de memória para orientar o que ele retém, como "mantenha preferências duradouras do cliente; ignore notas pontuais de depuração".
- Uma única plataforma para todo o ciclo. O mesmo agente usa modelos por meio do Unity Gateway, faz o deploy com a CLI do Agent Bricks e é rastreado e avaliado com o rastreamento do Agent Bricks, com memória incluída.
Comece agora
Nada disso exige nova infraestrutura do seu lado. A CLI do Agent Bricks pode ajudar você a implantar um agente com memória e sessões em minutos.
A partir de então, a próxima conversa do seu agente com cada usuário começará com o que ele aprendeu nas anteriores. Para obter mais informações, confira o guia de início rápido para criar um novo agente com memória, ou nosso tutorial para adicionar memória a um agente existente.
O Agent Memory é uma parte do Agent Bricks, a plataforma de desenvolvimento de agentes da Databricks para criar, executar e aprimorar agentes personalizados em escala, com qualquer modelo, framework ou harness. Explore o Agent Bricks para ver o restante da plataforma.
Mais recursos
- Crie um agente stateful em menos de 10 minutos com a documentação da CLI do Agent Bricks.
- Adicione memória e sessões a um agente existente com a documentação de memória e sessões do agente.
- Leia a pesquisa por trás disso em MemCurrent: Projetando memória para agentes corporativos.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.