Restaurações baseadas em branches do Lakebase Postgres para recuperação rápida em escala
Como o Lakebase Postgres substitui as lentas restaurações de banco de dados por restaurações baseadas em ramificações quase instantâneas para recuperar 100 TB em segundos.
por Cassie Murray e Carlota Soto
- A recuperação tradicional de bancos de dados é extremamente lenta e escala mal com o tamanho, geralmente causando horas de inatividade durante o provisionamento de nova computação, download de grandes snapshots e reprodução de arquivos de log.
- O Lakebase Postgres introduz restaurações baseadas em ramificações, uma operação de metadados que recupera instantaneamente um banco de dados ao apontar para um histórico imutável em armazenamento desacoplado, em vez de copiar dados.
- Restaurar um banco de dados de 100 TB leva segundos, tornando a recuperação praticamente instantânea e permitindo que agentes de AI gerenciem perfeitamente fluxos de trabalho de ramificação e reversão.
No OLTP gerenciado, as restaurações sempre foram dolorosamente lentas e ficam ainda mais lentas em escala. Isso geralmente significa que os grandes bancos de dados de produção, onde o tempo de inatividade custa mais caro, são os que mais demoram para se recuperar.
As soluções alternativas comuns são difíceis, caras e arriscadas. Elas envolvem réplicas extras, ambientes adicionais e até mesmo um DBA acompanhando a restauração, o que não garante totalmente a sua proteção. O failover para uma réplica íntegra ajuda quando uma máquina falha, mas não resolve quando a gravação incorreta já foi replicada para o standby. Isso ainda exige uma restauração, e uma restauração pode significar horas de inatividade.
Esse problema é causado pela arquitetura dos sistemas OLTP gerenciados tradicionais. Computação e armazenamento são fornecidos como uma única máquina, e a restauração começa com o provisionamento de uma nova instância (e você já começa esperando); os snapshots ficam no armazenamento de objetos enquanto o Postgres roda nesse volume, de modo que o snapshot ainda precisa ser copiado para o disco (mais espera); a reprodução do WAL precisa então preencher a lacuna entre o momento do snapshot e o timestamp exato de recuperação (ainda mais espera). À medida que o banco de dados cresce, esse processo se torna mais lento e caro.
A arquitetura do Lakebase Postgres quebra o monólito e muda a mecânica de restauração. No Lakebase, a computação e o armazenamento são desacoplados, e o histórico do banco de dados já é mantido no armazenamento de objetos de uma forma que pode ser referenciada instantaneamente. Nessa arquitetura, a restauração não copia dados para um novo disco. Em vez disso, ela simplesmente cria um branch em um timestamp específico, o que é uma operação simples de metadados, e não um trabalho de cópia e reprodução que leva várias horas.
Em termos práticos, o tempo de restauração cai para segundos, mesmo que o banco de dados seja de 100 TB. E é tão simples que um agente pode fazer isso.
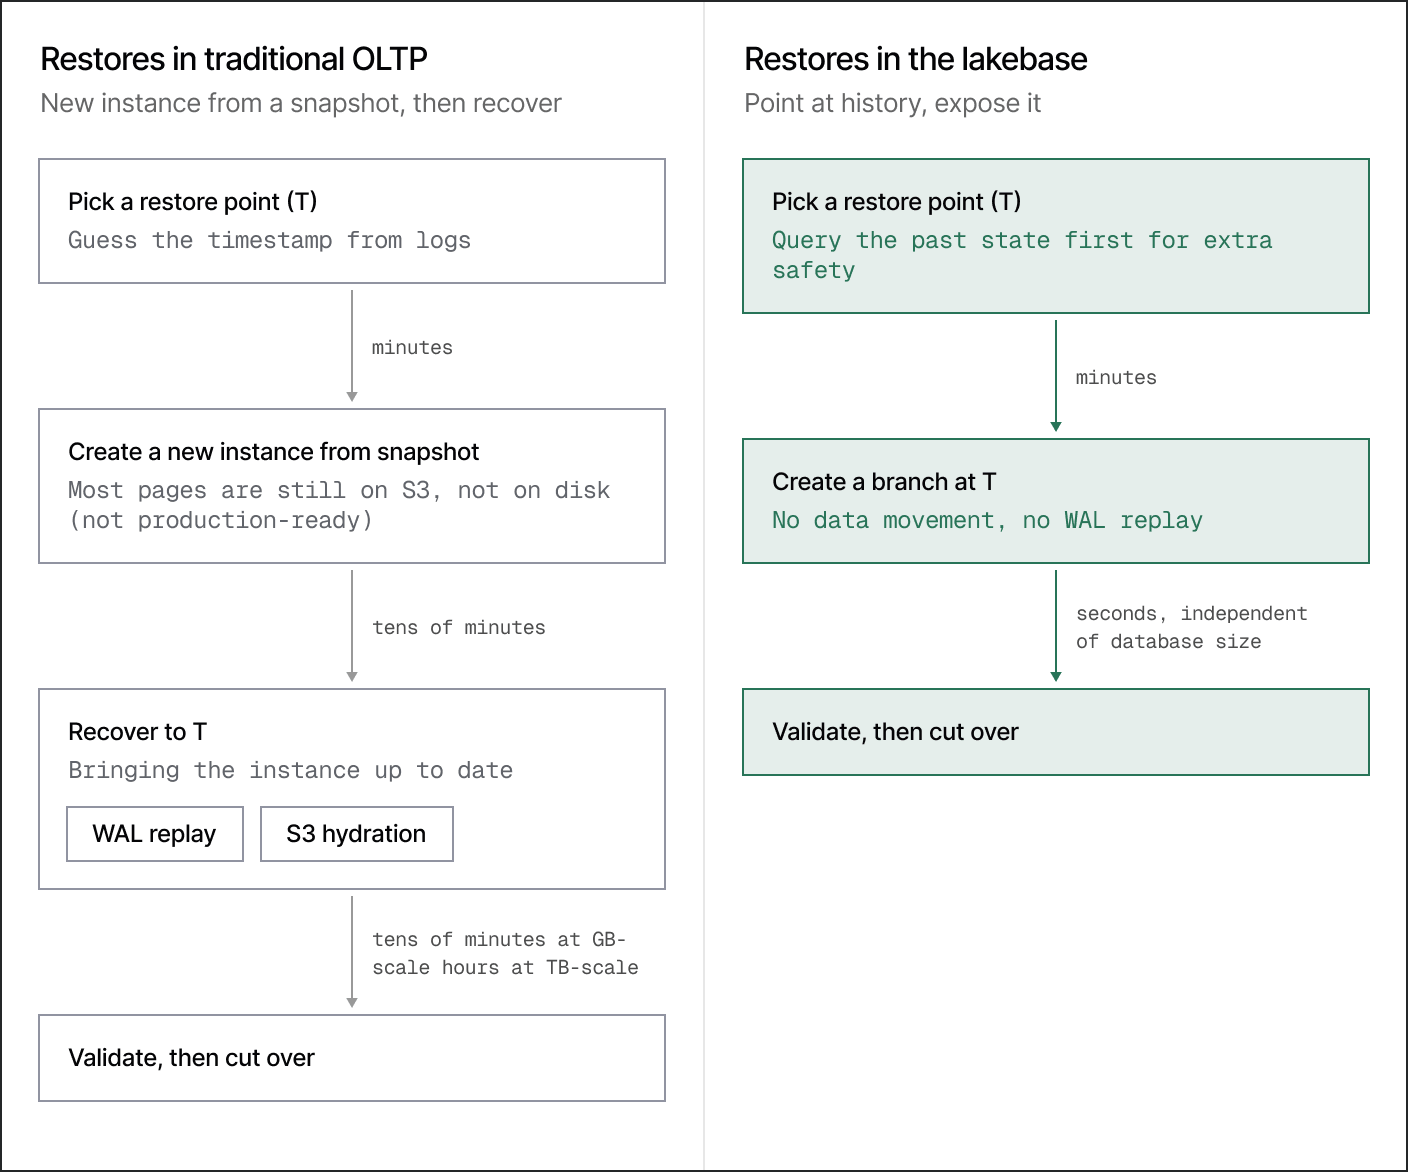
O caminho tradicional de restauração OLTP (e onde ele falha)
A recuperação point-in-time (PITR) tradicional do Postgres é composta por dois ingredientes: um backup base dos arquivos e o WAL arquivado para tudo o que aconteceu após esse backup. Em um ambiente Postgres gerenciado, como o Amazon RDS, esse backup geralmente é um snapshot armazenado no armazenamento de objetos.
A "restauração a partir do backup" para um momento específico no tempo T é, na verdade, um processo que envolve três etapas:
- Implantar uma nova instância
- Restaurar o snapshot utilizável mais recente antes de T
- Reproduzir o WAL a partir desse snapshot até T
1. Implantar uma nova instância
Isso envolve provisionar volumes de computação e armazenamento (acoplados) de tamanho pelo menos igual ao do primário. Uma instância pequena pode ser ativada em minutos, mas uma instância grande com volumes EBS grandes geralmente demora mais, fazendo com que você espere antes mesmo de iniciar o processo de restauração.
2. Restaurar a partir do snapshot
Os snapshots do RDS ficam no S3, portanto, "restaurar" significa extrair esse snapshot do armazenamento de objetos e colocá-lo no disco do Postgres.
Esse processo é lento para tamanhos grandes, por isso o RDS não espera que ele seja concluído para disponibilizar a instância restaurada available. Para volumes grandes, isso acontece enquanto a maioria das páginas de tabela e índice ainda está no S3. Mas estar disponível não significa que o conjunto de trabalho (working set) esteja no volume do Postgres. Se uma consulta acessar um bloco que ainda não é local, o volume o busca no S3 na hora, enquanto o restante continua sendo carregado em segundo plano.
Esses tipos de consulta apresentam uma latência aceitável para uma verificação interna, mas não para produção. A restauração só é concluída de fato quando os dados que você realmente precisa estão no volume, e isso não é rápido para um banco de dados grande. Quanto maior o banco de dados, mais tempo (em horas) isso levará.
3. Reproduzir o WAL até T
O snapshot é consistente apenas em relação ao momento em que foi tirado. Para chegar a T, o Postgres ainda precisa reproduzir os logs de transação arquivados após esse snapshot. O tempo que essa reprodução leva depende de quanto aconteceu entre o snapshot e T. Um snapshot de uma hora atrás será muito mais rápido do que um snapshot da noite anterior. Além disso, se você teve um dia com muitas gravações, haverá muito WAL para reproduzir. Mais uma vez, isso significa uma longa espera (além de a instância ainda estar carregando dados do S3).
Janelas significativas de inatividade
A menos que o banco de dados seja pequeno, o PITR é quase sempre uma operação de várias horas. Você precisa provisionar o monólito, extrair um snapshot do S3, reproduzir o WAL e esperar até que uma parte suficiente do volume esteja local para receber tráfego.
Durante todo esse período, você pode sofrer com a inatividade. Uma réplica íntegra e de alta disponibilidade (HA) pode salvar você se o primário falhar e a réplica ainda tiver dados íntegros. No entanto, ela pode não salvar você do PITR, pois tabelas excluídas e gravações incorretas já podem estar no standby.
Restaurações lentas de banco de dados são um grande problema
Em uma pesquisa, 50 desenvolvedores que executam Postgres de mais de 1 TB em produção foram questionados sobre suas experiências com restaurações:
- 59% tiveram uma falha crítica de produção nos últimos 12 meses
- 30% ficaram fora do ar por mais de 3 horas, e alguns passaram de meio dia
- apenas 21% se recuperaram em menos de 60 minutos
Isso gerou um potencial impacto adverso nos negócios:
- 40% relataram interrupção significativa dos negócios
- 52% receberam feedback negativo dos clientes devido ao incidente
- 72% sentiam-se apenas "um pouco confiantes" de que poderiam se recuperar rapidamente caso ocorresse outra falha
Restaurações baseadas em branch introduzem um novo caminho
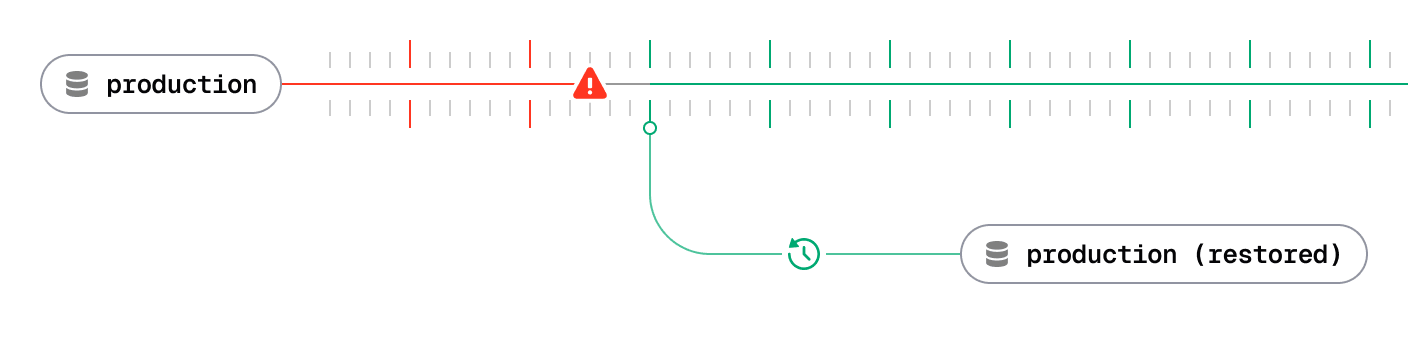
No Lakebase Postgres, uma arquitetura moderna possibilita um caminho diferente para as restaurações.
Computação e armazenamento são separados
A computação e o armazenamento durável são separados e conectados pelo WAL. A computação executa o Postgres, o que significa que ela roda SQL, planeja consultas, aplica MVCC, gerencia bloqueios e gera WAL (todas as tarefas normais do Postgres). O que ela não faz é possuir a cópia durável dos seus dados.
O armazenamento é o responsável pela durabilidade e pelo histórico, e o trabalho é dividido em três partes executadas por três componentes distintos:
- Os safekeepers recebem o WAL da computação. Uma transação torna-se durável assim que um quórum de safekeepers confirma seu registro de WAL
- O pageserver transforma o WAL nas páginas que o Postgres lê. Ele pode reconstruir qualquer página para uma determinada chave em um determinado LSN.
- O armazenamento de objetos mantém o histórico imutável de longo prazo. A computação nunca o lê diretamente; o pageserver fica no meio do caminho.
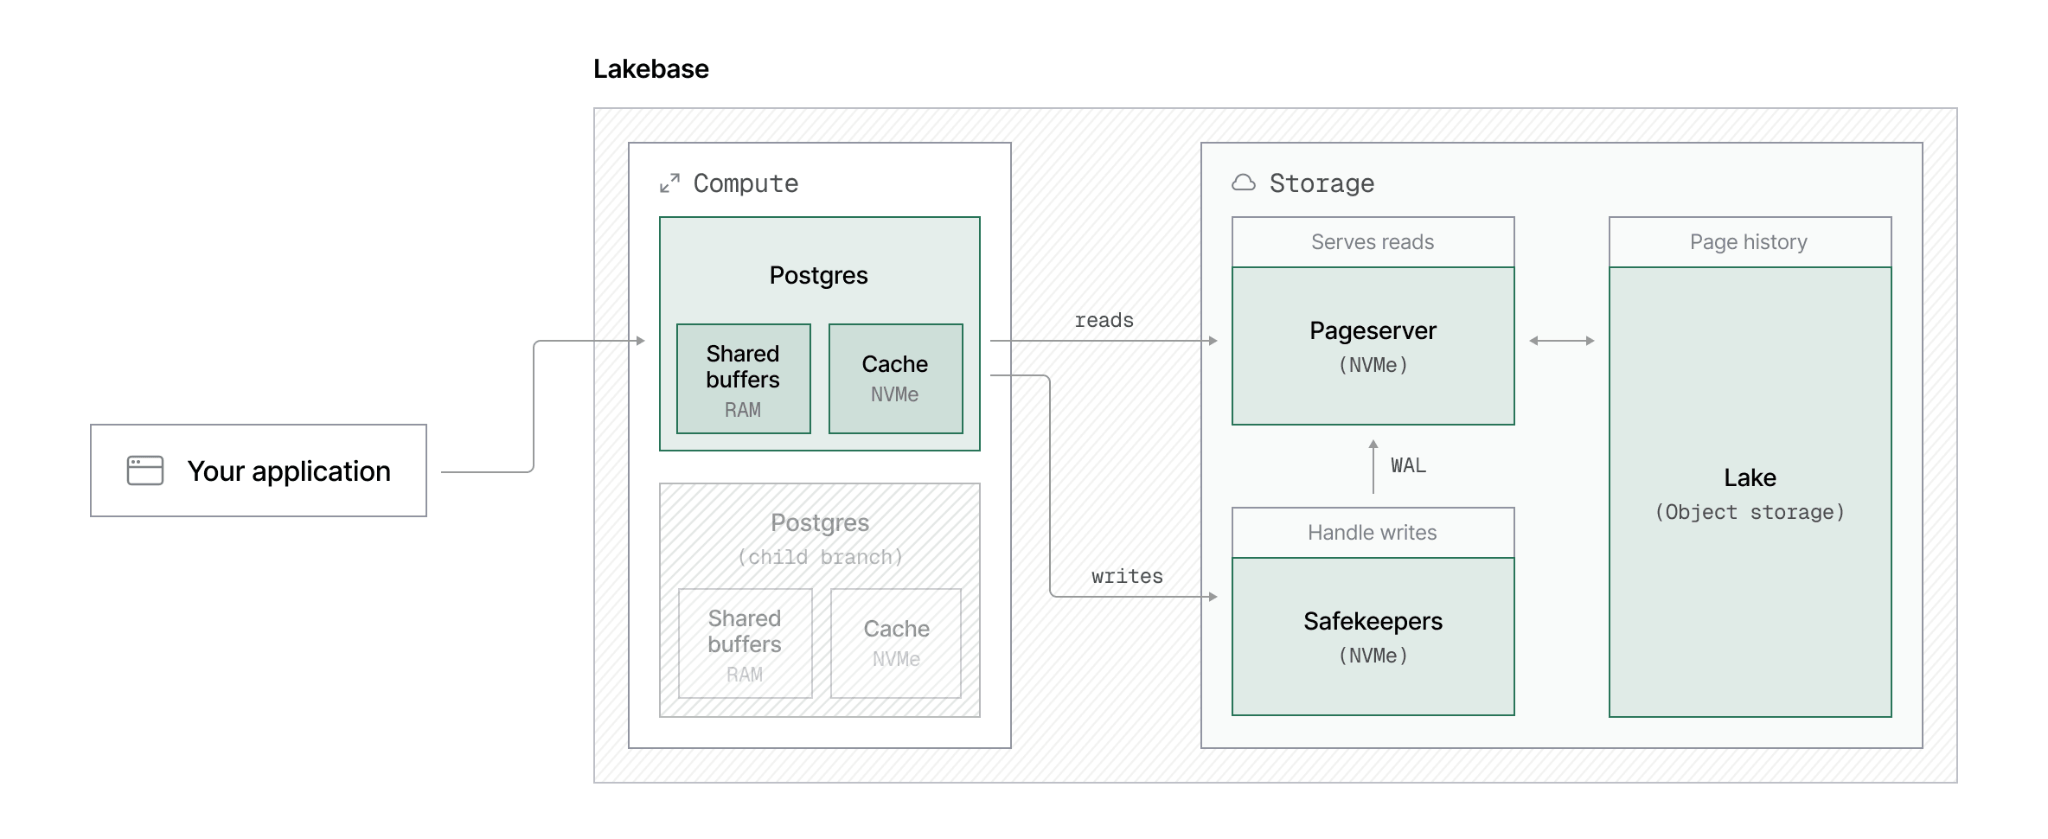
Quando uma gravação é recebida:
- O Postgres altera as linhas na memória e gera o WAL
- A computação transmite esse WAL para os safekeepers
- Um quórum confirma o recebimento, e a transação agora é durável
- O pageserver posteriormente transforma esse WAL em versões de página
- Essas versões vão para o armazenamento de objetos como histórico imutável
O histórico é armazenado como uma linha do tempo endereçável
Nesse design, o caminho de gravação assume uma forma interessante. A arquitetura acima separa a confirmação de uma transação da materialização das páginas, o que, em termos mais simples, significa: as versões antigas das páginas nunca são substituídas. O histórico do seu banco de dados se acumula como uma linha do tempo para a qual você pode apontar, e não como uma única cópia que você altera.
Uma restauração no Lakebase é um branch em um ponto no tempo
No caminho tradicional, uma restauração significa principalmente reconstruir esse estado passado em uma instância separada. Mas com o Lakebase, há um histórico de armazenamento imutável para referenciar, portanto, essa etapa é desnecessária e é substituída por uma primitiva diferente: um branch.
Enquanto as restaurações tradicionais provisionam uma nova instância e copiam os dados para ela, uma restauração no Lakebase é um branch em um ponto da história. Esse novo branch tem sua própria computação independente, sua própria string de conexão e pode ser consultado de forma totalmente independente da produção. Não é uma réplica da instância original, mas funciona exatamente como uma.
Veja como usar essa primitiva para uma restauração:
- Quando algo falha no branch principal, você escolhe um timestamp no passado (na verdade, você pode inspecionar esse timestamp antes de se comprometer com uma restauração, por exemplo, executando consultas)
- Depois de validá-lo, o plano de controle mapeia esse timestamp para o ponto exato no histórico do armazenamento (o LSN correto), cria esse branch e anexa a computação
- O "banco de dados restaurado" é esse novo branch, que fica disponível praticamente assim que você clica em "deploy", independentemente de quantos dados estejam armazenados no banco de dados subjacente
Como este é o conceito mais importante, vamos reiterar:
O branch não copia o banco de dados
Este método de restauração elimina completamente as cópias de dados. O branch restaurado não precisa copiar dados; ele simplesmente aponta para as camadas de imagem e delta que já existem até aquele momento.
- Em um sistema de cópia e reprodução (copy-and-replay), a restauração é uma tarefa de movimentação de dados. O banco de dados não está "lá" até que a cópia e a reprodução do WAL sejam concluídas
- No Lakebase, o "banco de dados" já está lá. Uma restauração é um metadado: um ponteiro para um ponto no histórico. Tudo o que resta é expor esse ponto como um branch, com sua própria computação
O resultado: restaurar 100 TB é tão rápido quanto restaurar 10 GB
O benefício é que o dimensionamento não é mais assustador do ponto de vista operacional. Se uma restauração é um trabalho de metadados, o tempo necessário não aumenta com o tamanho dos seus dados, e o mecanismo permanece o mesmo.
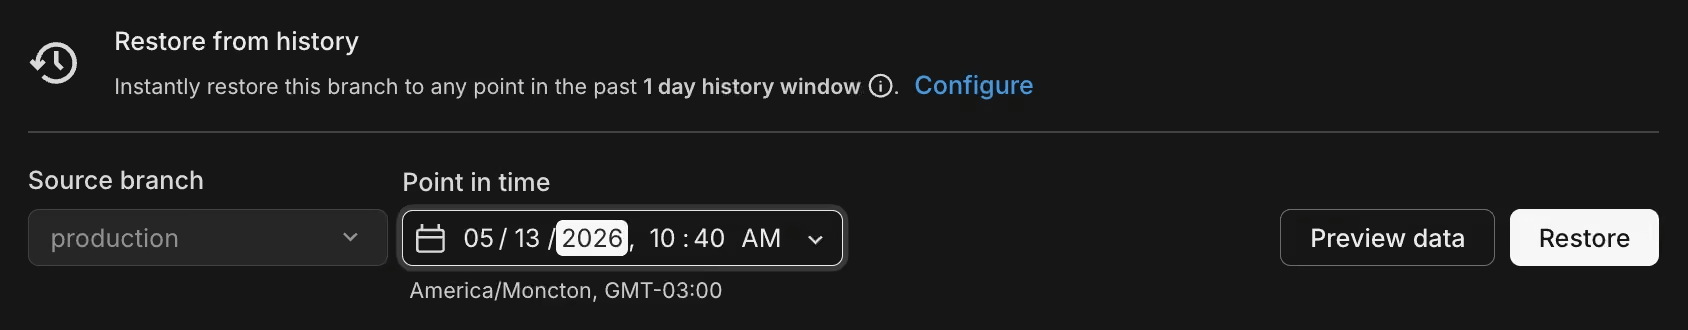
Independentemente do tamanho do seu banco de dados:
- Alcançar um estado anterior endereçável é quase instantâneo
- Validar esse estado leva apenas o tempo necessário para as verificações e os dados que você escolher ler
Um ser humano ou um agente sempre pode acessar um estado anterior consultável imediatamente após um incidente, mesmo em um banco de dados Postgres gigante.
Os agentes podem criar com base em restaurações
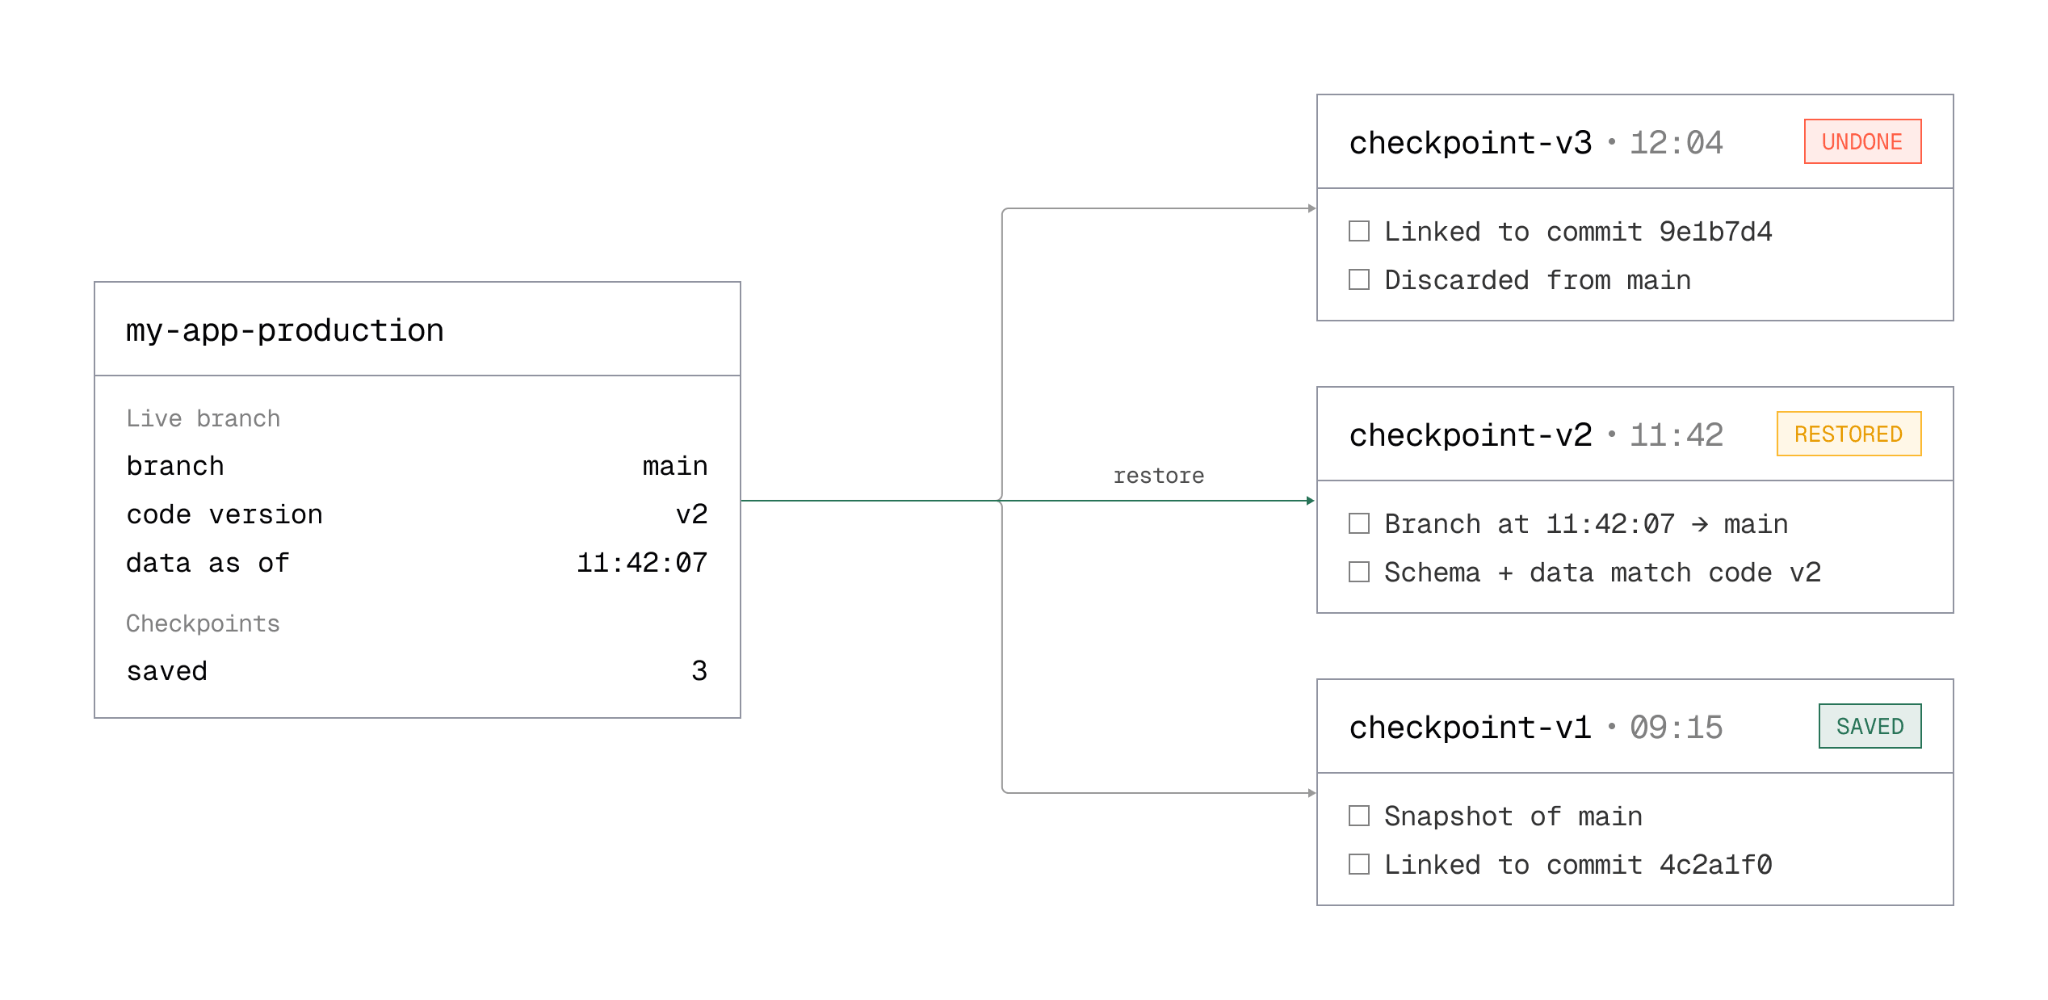
As restaurações no Lakebase são uma operação simples: criar um branch em um timestamp. O ciclo é curto o suficiente para que os agentes possam tratá-lo como uma chamada de ferramenta comum, não apenas para resolver incidentes.
Essa é a parte que as plataformas de agentes como Replit ou v0 realmente transformam em produto para criar recursos de controle de versão ou desfazer. Um ciclo típico se parece com isto:
- O agente altera o aplicativo, o que altera o banco de dados
- A plataforma salva um checkpoint como um snapshot da main. Ela armazena o ID do checkpoint ao lado da versão do código
- O usuário clica em desfazer ou escolhe uma versão mais antiga na UI
- A plataforma busca esse checkpoint e o restaura no branch ativo
- O esquema e os dados voltam instantaneamente para a versão do banco de dados que corresponde ao "código antigo"
O PITR tradicional é muito lento e pesado para dar suporte a fluxos de trabalho em tempo real, mas um branch em um timestamp é rápido e barato o suficiente para fazer parte do produto.
A arquitetura do Lakebase muda a forma como a recuperação é feita
As restaurações tradicionais ficam mais lentas e pesadas à medida que o banco de dados cresce. As restaurações baseadas em branch não. O histórico já reside fora da computação, portanto, um ponto anterior é algo que você pode abrir como um branch, não algo que precisa reconstruir. Independentemente de você ter 10 GB ou 100 TB, as restaurações são iguais. Escolha um timestamp, crie o branch e conecte a computação. Falhas em escala não são mais tão assustadoras.
Experimente você mesmo: crie um banco de dados Postgres no Lakebase, carregue uma boa quantidade de dados, execute uma restauração e pergunte-se como conseguiu viver sem isso por tanto tempo.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.