Lakebase Search: Busca de texto completo e vetorial de última geração para Postgres
Busca rápida, escalável e serverless no Postgres, agora em Disponibilidade Geral (GA)
por Zhou Sun, Jinjing Zhou, Keming Yang, Usamoi Cui, Pranav Aurora e Junyu Chen
- O Lakebase Postgres agora inclui um mecanismo de busca integrado (GA no AWS/Azure). Duas extensões, lakebase_vector (busca ANN) e lakebase_text (BM25), permitem que você execute buscas semânticas, por palavra-chave e híbridas diretamente no Postgres junto com dados operacionais, eliminando a necessidade de um sistema de busca separado + pipeline de ETL.
- Ele supera o pgvector e mecanismos de busca dedicados em escala. Em um benchmark de 100M de vetores, o Lakebase oferece o dobro do throughput do segundo melhor sistema, custo 4 vezes menor que o Postgres na nuvem com pgvector e 97% de recall com latência P99 de 71ms. Ele alcança isso desacoplando o armazenamento da computação e usando clustering IVF hierárquico + quantização binária (RaBitQ) para que as consultas acessem apenas os dados de que precisam.
- A arquitetura é serverless e escala até zero. Você paga pelo uso de consultas, não pelo volume de dados. A criação de índices é descarregada do banco de dados primário, os cold starts levam cerca de 1 segundo e 100M de vetores podem ser servidos em uma única unidade de computação, tornando-o desenvolvido sob medida para os padrões de recuperação intermitentes de agentes de AI.
Os sistemas OLTP tradicionais não foram criados para as demandas de busca dos agentes de IA. Eles exigem recuperação de baixa latência e alta precisão em todos os seus dados e, muitas vezes, executam buscas paralelas massivas. Até agora, resolver isso significava conectar de forma improvisada um mecanismo de busca independente ao seu banco de dados principal com um pipeline de ETL.
Mas e se o seu banco de dados OLTP pudesse simplesmente executar a carga de trabalho de busca de forma eficiente?
Hoje, estamos trazendo um mecanismo de busca rápido e escalável para o Lakebase Postgres por meio de duas extensões: lakebase_vector (busca escalável de vizinhos aproximados) e lakebase_text (busca em texto completo bm25). Ambas as extensões estão geralmente disponíveis na AWS e no Azure.
Com o lakebase_vector, o Postgres está agora na fronteira da busca vetorial. Ele supera a eficiência e a escalabilidade de um mecanismo de busca dedicado. No benchmark VectorDBBench 100M, ele oferece o dobro da vazão (throughput) do segundo melhor sistema e é 4 vezes mais barato do que um provedor de Postgres na nuvem usando pgvector, e isso antes de contabilizar a economia adicional devido ao escalonamento automático (autoscaling).
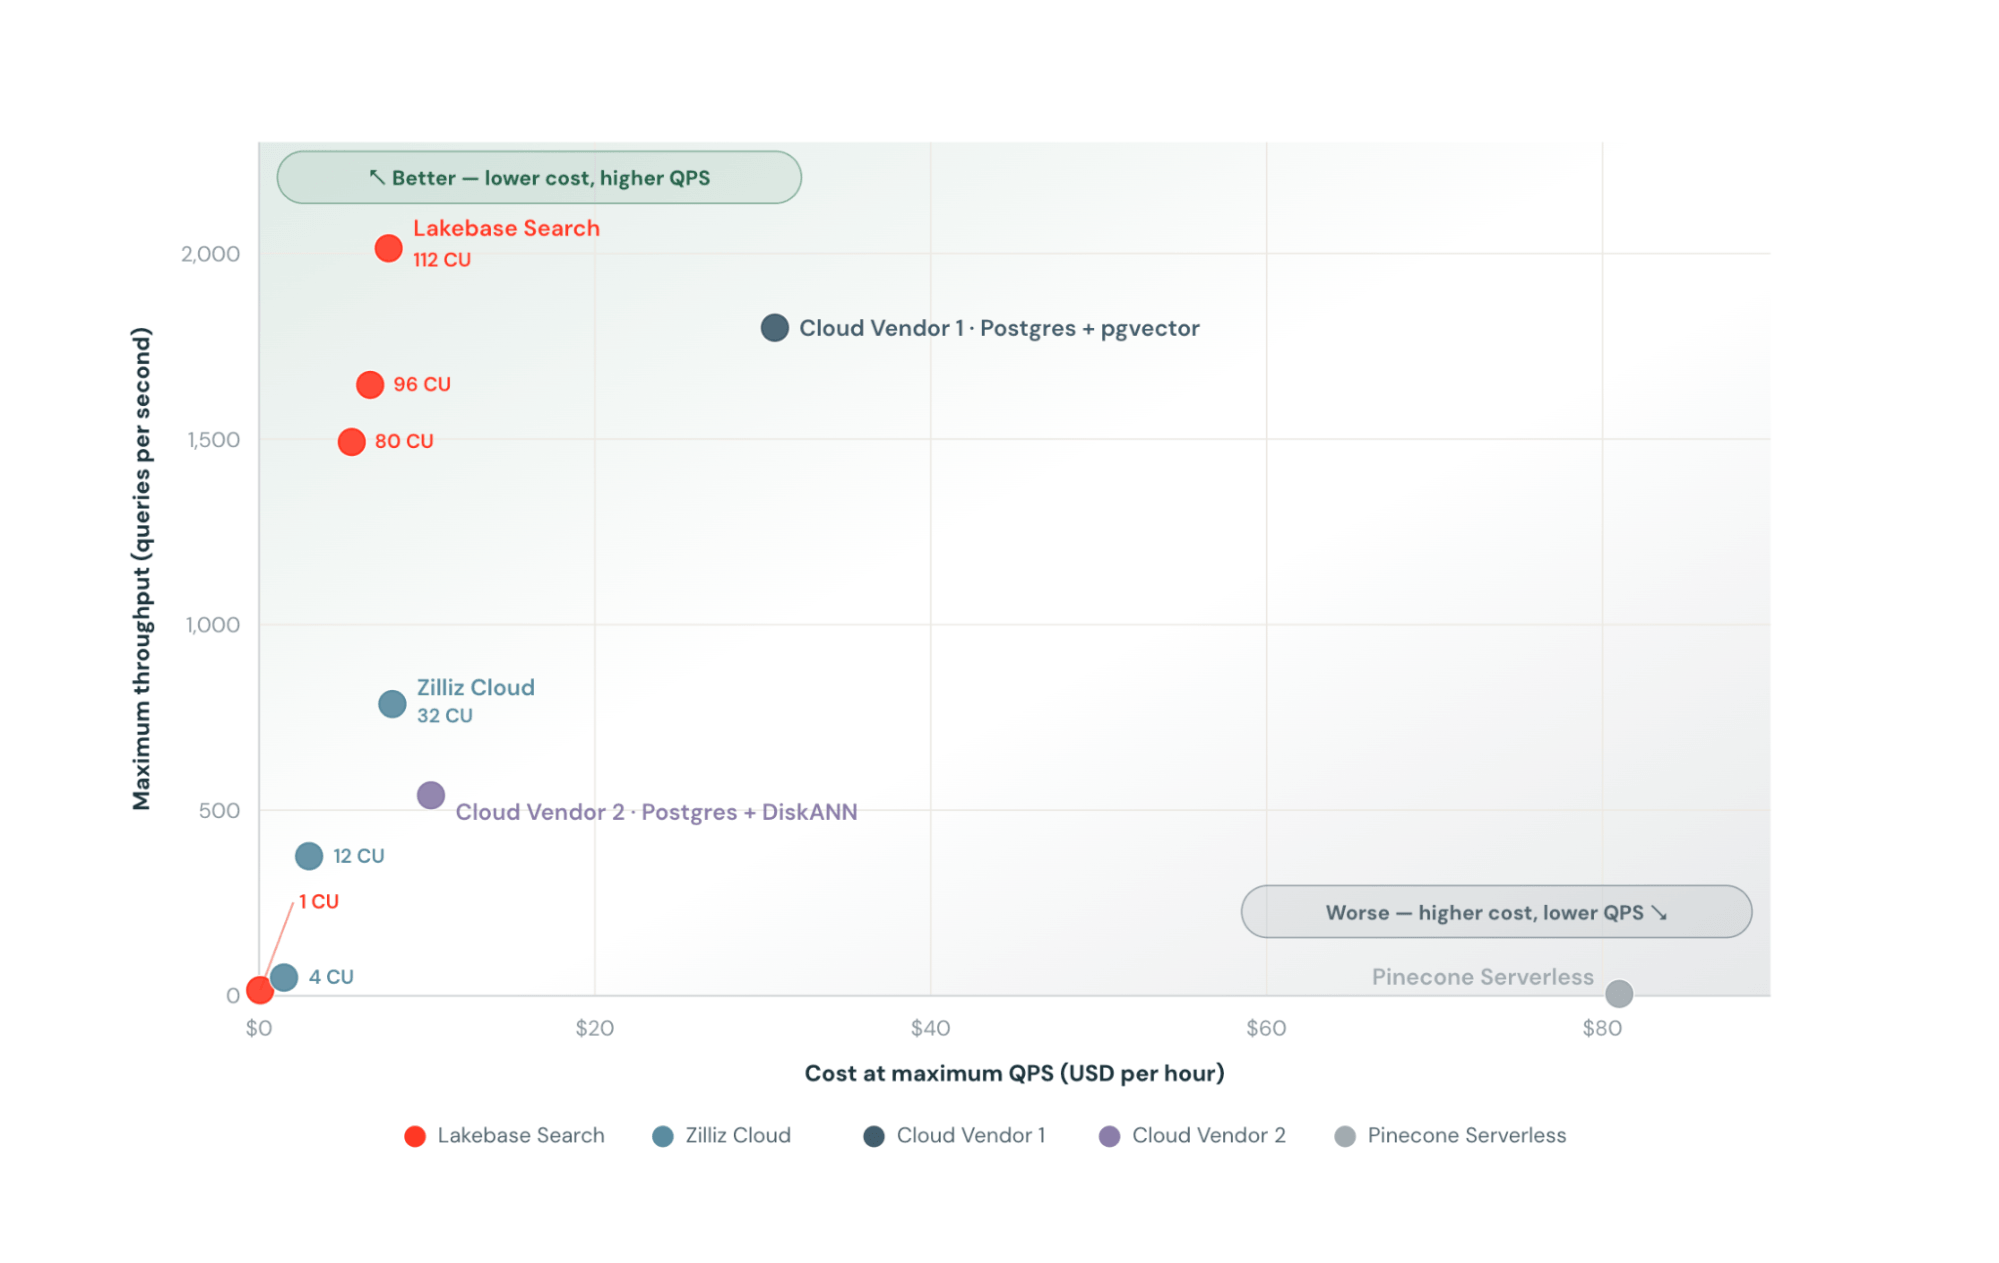
Ele mantém esse desempenho sem sacrificar a precisão. Em nossos testes, o lakebase_vector apresentou uma latência P99 de 71 milissegundos com 97% de recall (recuperando com sucesso os vizinhos mais próximos reais em 97% das vezes).

O Lakebase Postgres agora conta com recursos de busca de última geração, e vimos clientes como a Conexiom executarem busca híbrida com BM25 em mais de 100 milhões de linhas com metade da pegada de computação de sua configuração anterior do pgvector. Eles agora têm um banco de dados para todas as cargas de trabalho de OLTP e busca que é totalmente serverless e se dimensiona conforme suas necessidades.
O Lakebase Search nos oferece um nível totalmente novo de escalabilidade em relação ao pgvector e desbloqueia o BM25 no mesmo banco de dados serverless. Usamos o Lakebase para conectar dados aos nossos agentes em escala. - Jordan Voves, Arquiteto de IA/ML na Conexiom
Por que o pgvector encontra limitações em escala
Para a maioria dos usuários do Postgres, a busca começa com o pgvector. Ele permite a busca por similaridade vetorial por meio de algoritmos de índice como HNSW e IVFFlat sobre dados nativos no Postgres, evitando a complexidade de um armazenamento de vetores separado. Na verdade, o pgvector é a extensão mais instalada no Lakebase Postgres. Observamos 3 pontos de dor comuns de clientes que executam o pgvector em escala.
Primeiro, os custos aumentam com o volume de dados, não com o uso.
O pgvector mantém seu índice na memória do banco de dados para ser rápido. Como a busca HNSW depende da travessia de grafos de acesso aleatório, as consultas são executadas em milissegundos apenas se tudo couber perfeitamente na RAM. No momento em que o índice transborda para o disco, as consultas se transformam em cadeias de leituras aleatórias, e o desempenho despenca de 10 a 50 vezes.
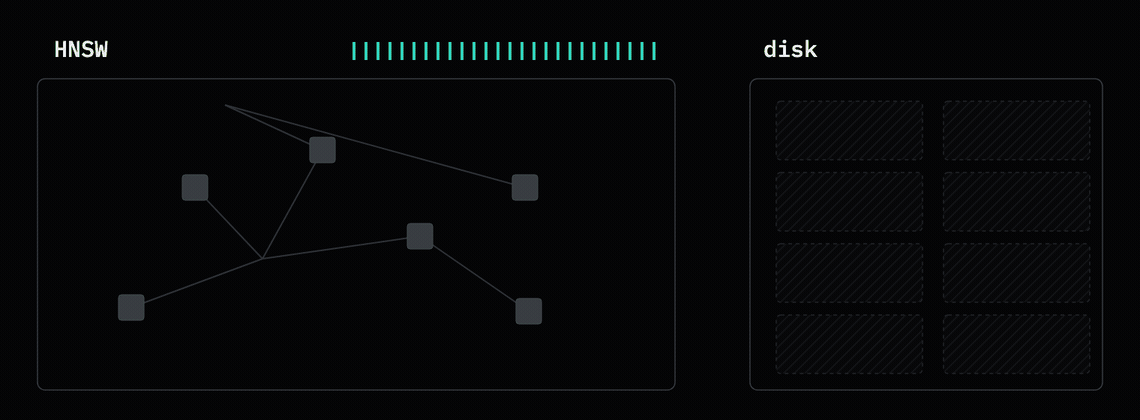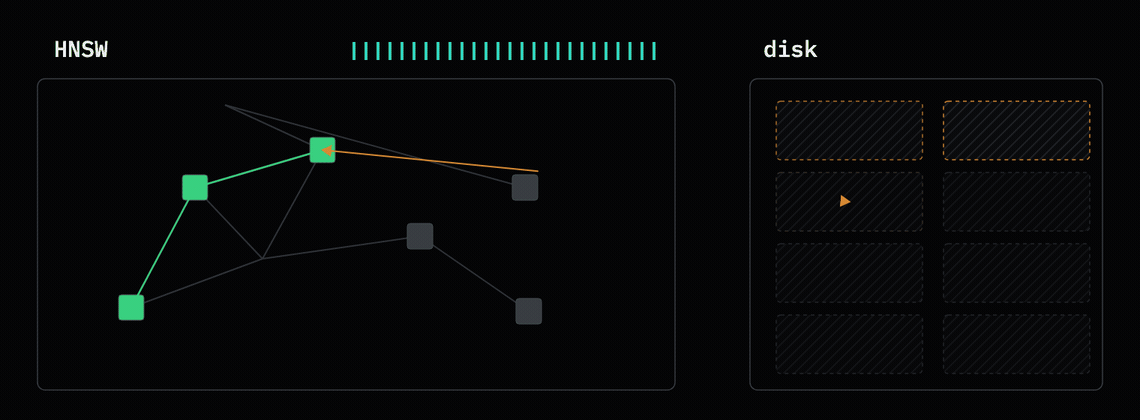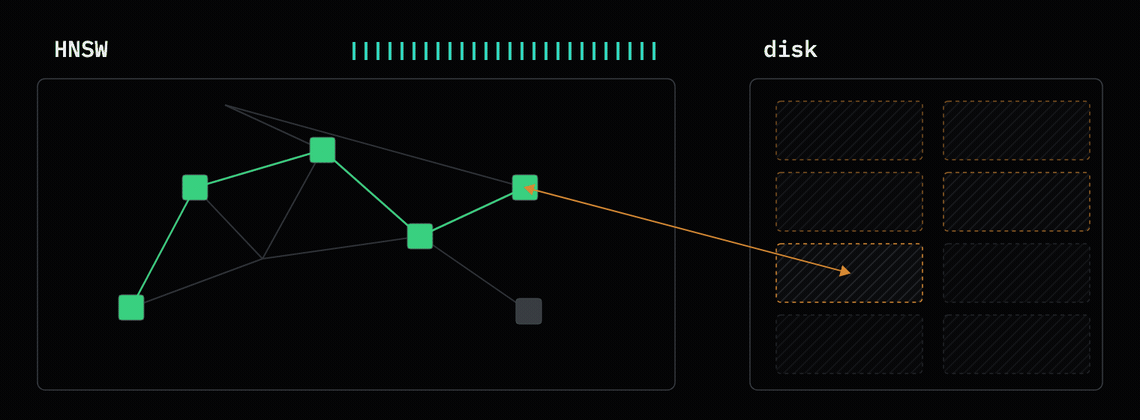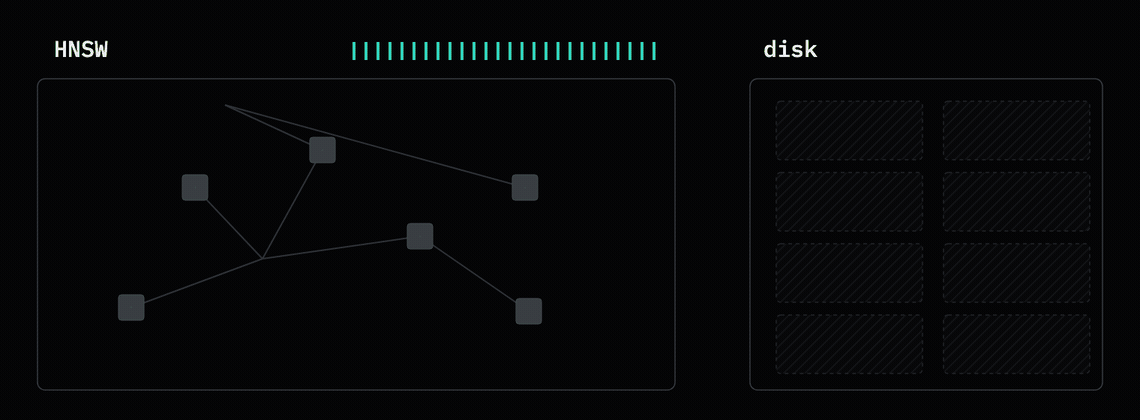
Um vetor float32 de 768 dimensões requer cerca de 3,3 KB de memória após contabilizar os links de grafos e a sobrecarga do Postgres. Com 100 milhões de linhas, você precisa de aproximadamente 330 GB de RAM para manter o índice residente para consultas de milissegundos. Não há noção de um "working set" (conjunto de trabalho). Você faz o provisionamento para todo o índice, quer consulte tudo ou nada dele.
Segundo, a manutenção do índice é cara e bloqueia seu banco de dados.
Os índices do pgvector são limitados pela memória porque o grafo HNSW depende de acesso aleatório contínuo. Quando uma compilação transborda para o disco, milhões de operações de I/O aleatórias prejudicam o desempenho — levando quase 50 horas para criar um índice pgvector em uma instância de nuvem padrão.
A ingestão sofre com o mesmo gargalo. A inserção de novos vetores é lenta e cara porque cada gravação força o pgvector a navegar e modificar várias camadas do grafo usando buscas de acesso aleatório.
Segundo, a ingestão torna-se lenta e cara, pois o HNSW depende de navegação contínua em grafos de acesso aleatório. Também precisa modificar cada camada do grafo. Portanto, o índice hnsw
A manutenção contínua agrava o problema. Como o HNSW carece de rebalanceamento global, restaurar a qualidade da busca exige um REINDEX completo, o que bloqueia a tabela e impede as gravações em produção.
Terceiro, você sacrifica a qualidade da busca em troca de desempenho
Cada consulta do pgvector é executada em um único processo de back-end do Postgres, o que significa que a varredura do índice HNSW nunca é paralelizada.
Para obter um recall mais alto, o mecanismo precisa visitar mais nós do grafo, acionando mais leituras de memória aleatórias e comparações de distância. Isso infla a latência e reduz suas QPS. Como uma única busca não pode ser paralelizada entre núcleos, sua única opção para obter maior vazão (throughput) é adicionar mais conexões ou réplicas de leitura.
O lakebase_vector traz busca vetorial escalável para o Postgres
O principal gargalo do pgvector é que todo o índice precisa caber na RAM de uma única máquina para ser rápido. E se não precisasse?
O Lakebase Postgres nos dá um excelente ponto de partida, pois separa o armazenamento da computação. Os dados duráveis residem em um armazenamento de objetos em nuvem de baixo custo, enquanto a RAM e o NVMe local agem como caches efêmeros à frente dele para leituras rápidas do conjunto de dados de trabalho. Com essa arquitetura, um cache HNSW significa uma série de leituras aleatórias no armazenamento de objetos.
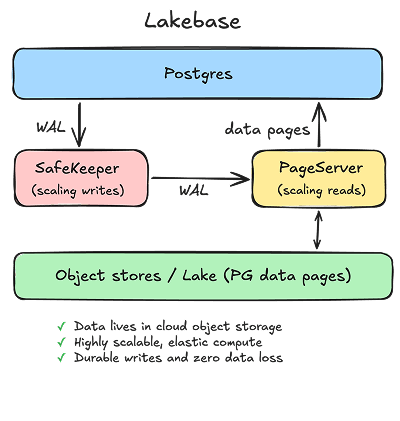
Precisamos de um índice que seja rápido tanto quando armazenado em cache na RAM quanto quando estiver frio no armazenamento de objetos. Aproveitamos duas ideias:
- Agrupamento (clustering) IVF hierárquico. Os vetores são agrupados em clusters armazenados como blocos contíguos. Uma consulta pontua os centroides dos clusters na memória e, em seguida, lê apenas os poucos blocos promissores — transformando centenas de saltos aleatórios em um punhado de grandes leituras sequenciais.
- Quantização binária (RaBitQ). Cada vetor é compactado para aproximadamente 1 bit por dimensão, cerca de 32× menor que float32. As consultas varrem os códigos compactos para selecionar candidatos e, em seguida, reclassificam essa lista restrita em relação aos vetores de precisão total.
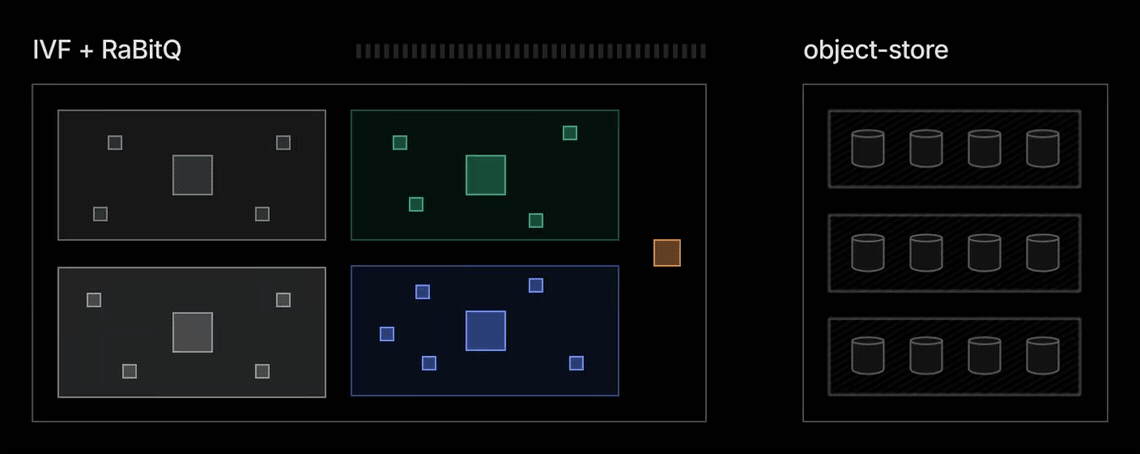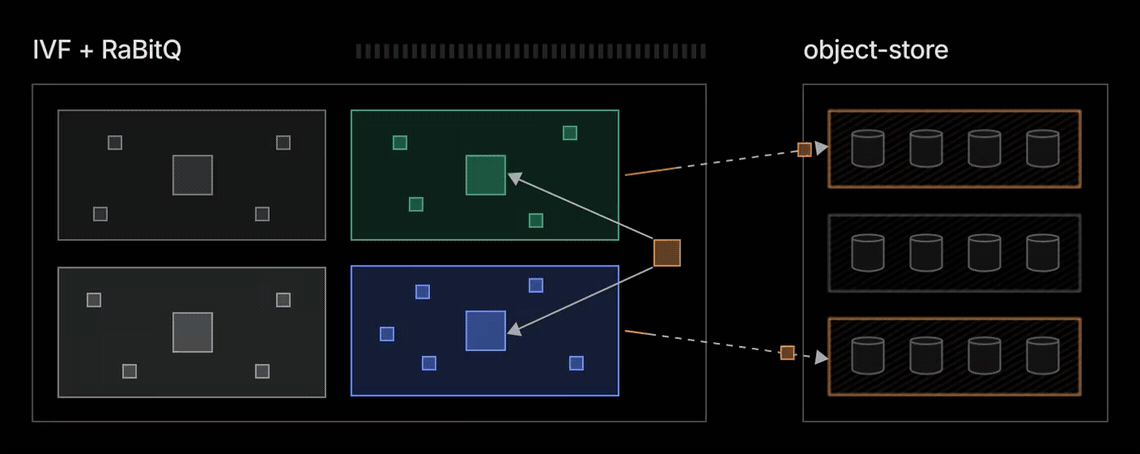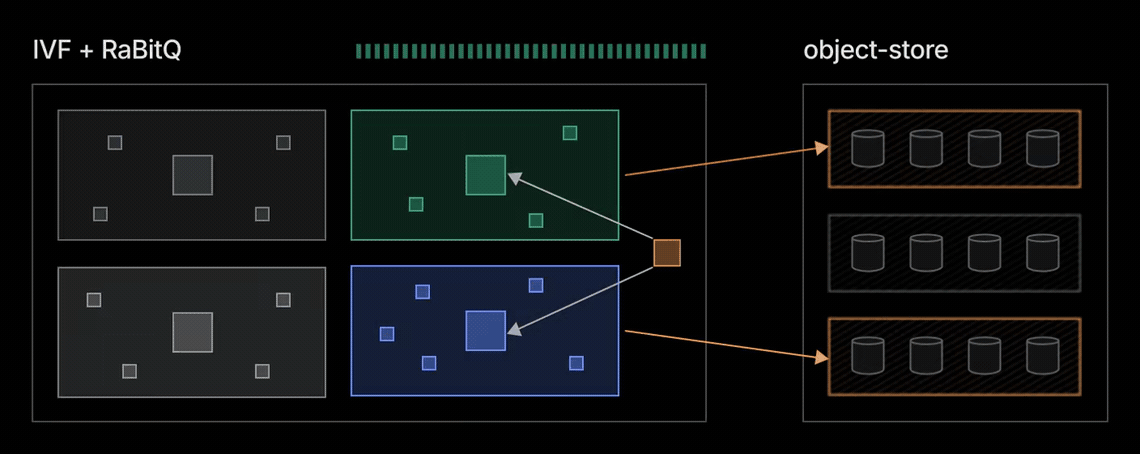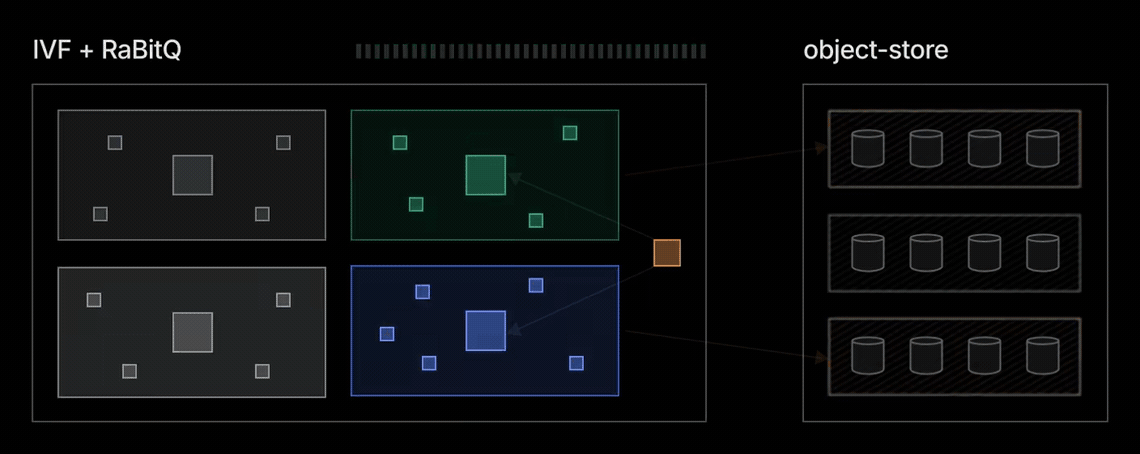
Quando armazenada em cache, a busca opera com uma pegada mínima usando vetores quantizados. Quando fria, as consultas buscam apenas os blocos de que precisam e não requerem varrer todo o índice. O lakebase_vector oferece:
Pague apenas pelo que usar e dimensione até zero
A separação entre armazenamento e computação torna o lakebase_vector totalmente stateless: um nó armazena dados ativos em cache sob demanda, suspende as atividades para zero quando ocioso e retoma na próxima consulta.
- Em repouso, você paga apenas pelo armazenamento, proporcionando um custo básico baixo para manter os vetores indexados no Lakebase.
- As inicializações a frio (cold starts) são baratas porque apenas os códigos quantizados e os blocos específicos que uma consulta toca são carregados. Nosso P90 medido para a primeira consulta após o dimensionamento até zero é de apenas 1,13 segundo (100M × 768 dimensões).
- É possível até mesmo servir 100M de vetores em apenas 1 Lakebase Compute Unit (CU). Apenas o conjunto de dados de trabalho ativo precisa ser armazenado em cache nos nós de computação, oferecendo um modelo de preços que realmente reflete o uso real e a atividade de consulta.

Criação rápida de índices com offload
O lakebase_vector constrói índices de forma mais paralela. Treinamos os centroides uma única vez em uma pequena amostra aleatória. Essa é a única etapa que analisa todo o conjunto de dados. Depois disso, cada vetor é atribuído de forma independente ao seu centroide mais próximo, quantizado e gravado no bloco do seu cluster. Esse processo pode ser distribuído por quantos núcleos você tiver, escalando com a capacidade de computação.

Damos um passo além ao descarregar totalmente a criação de índices do seu banco de dados principal. O armazenamento de dados em formatos abertos permite que nossa arquitetura LTAP delegue a indexação e a manutenção a mecanismos distribuídos como o Spark, reduzindo o tempo de criação para minutos com computação paralela. Fique atento.
Busca rápida e precisa
O lakebase_vector amplia a busca de candidatos de forma econômica usando códigos compactos de 1 bit, reclassificando apenas uma lista restrita com precisão total. Como os blocos de índice são independentes, uma única consulta é paralelizada entre os núcleos de CPU, oferecendo alto recall e baixa latência simultaneamente.
A filtragem ocorre diretamente à medida que o lakebase_vector varre os blocos do cluster. A aplicação de predicados inline evita a busca excessiva de candidatos e mantém o recall alto em consultas filtradas.
lakebase_text: busca nativa BM25 no Postgres
A busca de texto padrão do Postgres (tsvector) carece de contexto de relevância em todo o corpus. O lakebase_text traz o BM25 nativo para o Postgres, pontuando termos com a frequência inversa de documentos (IDF) global: dando grande peso a termos raros e de alta intenção, enquanto penaliza palavras de preenchimento comuns.
Ele também é mais rápido do que os índices tradicionais tsvector + GIN. Ao avaliar os limites superiores de pontuação durante a varredura, o mecanismo ignora blocos inteiros de postagens que não conseguem alcançar os resultados top-K.
A combinação do lakebase_text com o lakebase_vector libera a busca híbrida nativa dentro do Postgres. Em uma única consulta, você pode fundir a busca vetorial semântica com a relevância de palavras-chave do BM25, aplicar predicados de filtro SQL padrão e fazer junções diretamente com tabelas operacionais ativas.
O Lakebase Postgres foi desenvolvido para a era dos agentes
Os agentes levaram os mecanismos de busca tradicionais além de seus limites. Eles tornaram a busca vetorial um requisito essencial da pilha de dados e introduziram picos extremos de demanda, onde um único fluxo de trabalho pode acionar milhares de solicitações de recuperação simultâneas em segundos.
Projetamos o Lakebase Search especificamente para essa nova realidade. O Lakebase Postgres agora pode lidar com todas as suas cargas de trabalho operacionais e de busca, apoiado por uma arquitetura serverless que escala perfeitamente de 1 linha a 1 bilhão de vetores e de 1 QPS a milhares, sem provisionamento manual ou gerenciamento de infraestrutura.
Desenvolvemos o Lakebase Search com base no feedback de centenas de clientes beta, e os resultados falam por si mesmos:
- Gastos com banco de dados 3 vezes menores: A Conexiom reduziu os custos de infraestrutura em 3 vezes, alcançando uma vazão 5 vezes maior em comparação com o pgvector.
- Uma única chamada de ferramenta SQL para agentes: Os desenvolvedores substituem pipelines complexos de recuperação de vários sistemas por uma única chamada SQL para busca híbrida nativa, regida pelas regras padrão do banco de dados.
- OLTP e busca unificados: As equipes consolidam tabelas operacionais ativas e clusters de busca dedicados em um único back-end no modelo pague pelo que usar.
O Lakebase Search está disponível para o público geral hoje na AWS e no Azure. Se você já está criando um aplicativo ou um agente no Lakebase, basta ativar as extensões. Se você ainda não experimentou o Lakebase, comece hoje mesmo.
▎ 📝 Observação: O Databricks AI Search é um mecanismo de busca gerenciado para recuperação de alta qualidade pronta para uso — ele pode ser a melhor opção quando você deseja ótimos resultados sem ajuste manual. O Lakebase Search é a melhor escolha quando você deseja todos os seus dados operacionais e de busca em um único banco de dados.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.