Dados de manufatura e IA: Conectando a cadeia de valor do produto
Dê a cada etapa da cadeia de valor de manufatura acesso a dados confiáveis e IA
- Os dados de manufatura abrangem uma cadeia de valor de produtos conectada, mas os sistemas que os capturam permanecem separados por função e fábrica
- O Databricks reúne dados de sistemas distintos – ou realiza consultas diretamente na origem – para que as equipes possam responder a perguntas entre diferentes etapas de toda a cadeia de valor
- Semântica governada, análises em linguagem natural e aplicações agentivas ajudam mais pessoas a passar da busca de dados para a tomada de ações, sem a necessidade de se tornarem engenheiros de dados
Um defeito de fabricação raramente pertence a um único sistema. Um pico de refugo pode estar relacionado a uma configuração de máquina, a um lote de fornecedor, a um evento de logística ou a um problema recorrente registrado em um sistema de qualidade. No entanto, os dados necessários para investigá-lo geralmente estão divididos entre limites de fábrica, funcionais e de sistema.
Há mais de 50 anos, a visão do Dr. Joseph Harrington de Computer Integrated Manufacturing (CIM) reconheceu que a fabricação depende de um fluxo conectado de informações entre as funções. Hoje, essa visão está se tornando prática à medida que os dados e a AI conectam as etapas da cadeia de valor do produto.
As perguntas mais difíceis de fabricação são perguntas que cruzam etapas:
- Qual lote de fornecedor chegou aos produtos afetados?
- Esse defeito já apareceu antes? A ação corretiva funcionou?
- Quais clientes ou casos de serviço podem ser afetados?
Responder a qualquer uma dessas perguntas exige a união de dados de sistemas que nunca foram projetados para se comunicar entre si. Os fabricantes não precisam de mais relatórios isolados. Eles precisam de um fluxo conectado de informações em toda a cadeia de valor do produto, com a governança e o contexto de negócios para tornar essas informações utilizáveis. Esse é o papel que uma plataforma moderna de dados e AI pode desempenhar.
O que é a cadeia de valor do produto de fabricação?
A cadeia de valor do produto é a sequência de ponta a ponta de funções que transforma matérias-primas e ideias em produtos entregues aos clientes e suportados em campo. Ela conecta pesquisa e desenvolvimento (R&D) e engenharia, compras, produção e qualidade, vendas e marketing, e pós-venda e serviço de campo. Cada etapa tem seus próprios objetivos, equipes e sistemas operacionais:
- Pesquisa e desenvolvimento (R&D) e engenharia trabalham com Product Lifecycle Management (PLM), Computer-Aided Design (CAD), Computer-Aided Engineering (CAE) e simulação, dados de teste, requisitos e Bills of Materials (BOMs) de engenharia.
- Compras trabalha com compras de Enterprise Resource Planning (ERP), source-to-pay, contratos, risco de fornecedores e portais de fornecedores.
- Produção e qualidade trabalham com Manufacturing Execution Systems (MES), dados de Supervisory Control and Data Acquisition (SCADA)/Programmable Logic Controller (PLC), historiadores de processo, Quality Management Systems (QMS)/Laboratory Information Management Systems (LIMS) e sistemas de manutenção.
- Logística e cadeia de suprimentos trabalham com Enterprise Resource Planning (ERP), Warehouse Management Systems (WMS), Transportation Management Systems (TMS), sistemas de planejamento, Electronic Data Interchange (EDI) e telemática.
- Vendas e marketing trabalham com Customer Relationship Management (CRM), Configure-Price-Quote (CPQ), precificação, gestão de concessionárias, automação de marketing e e-commerce.
- Pós-venda e serviço de campo trabalham com gestão de serviços, garantia, planejamento de peças de reposição, dados de produtos conectados, diagnósticos e chamados.
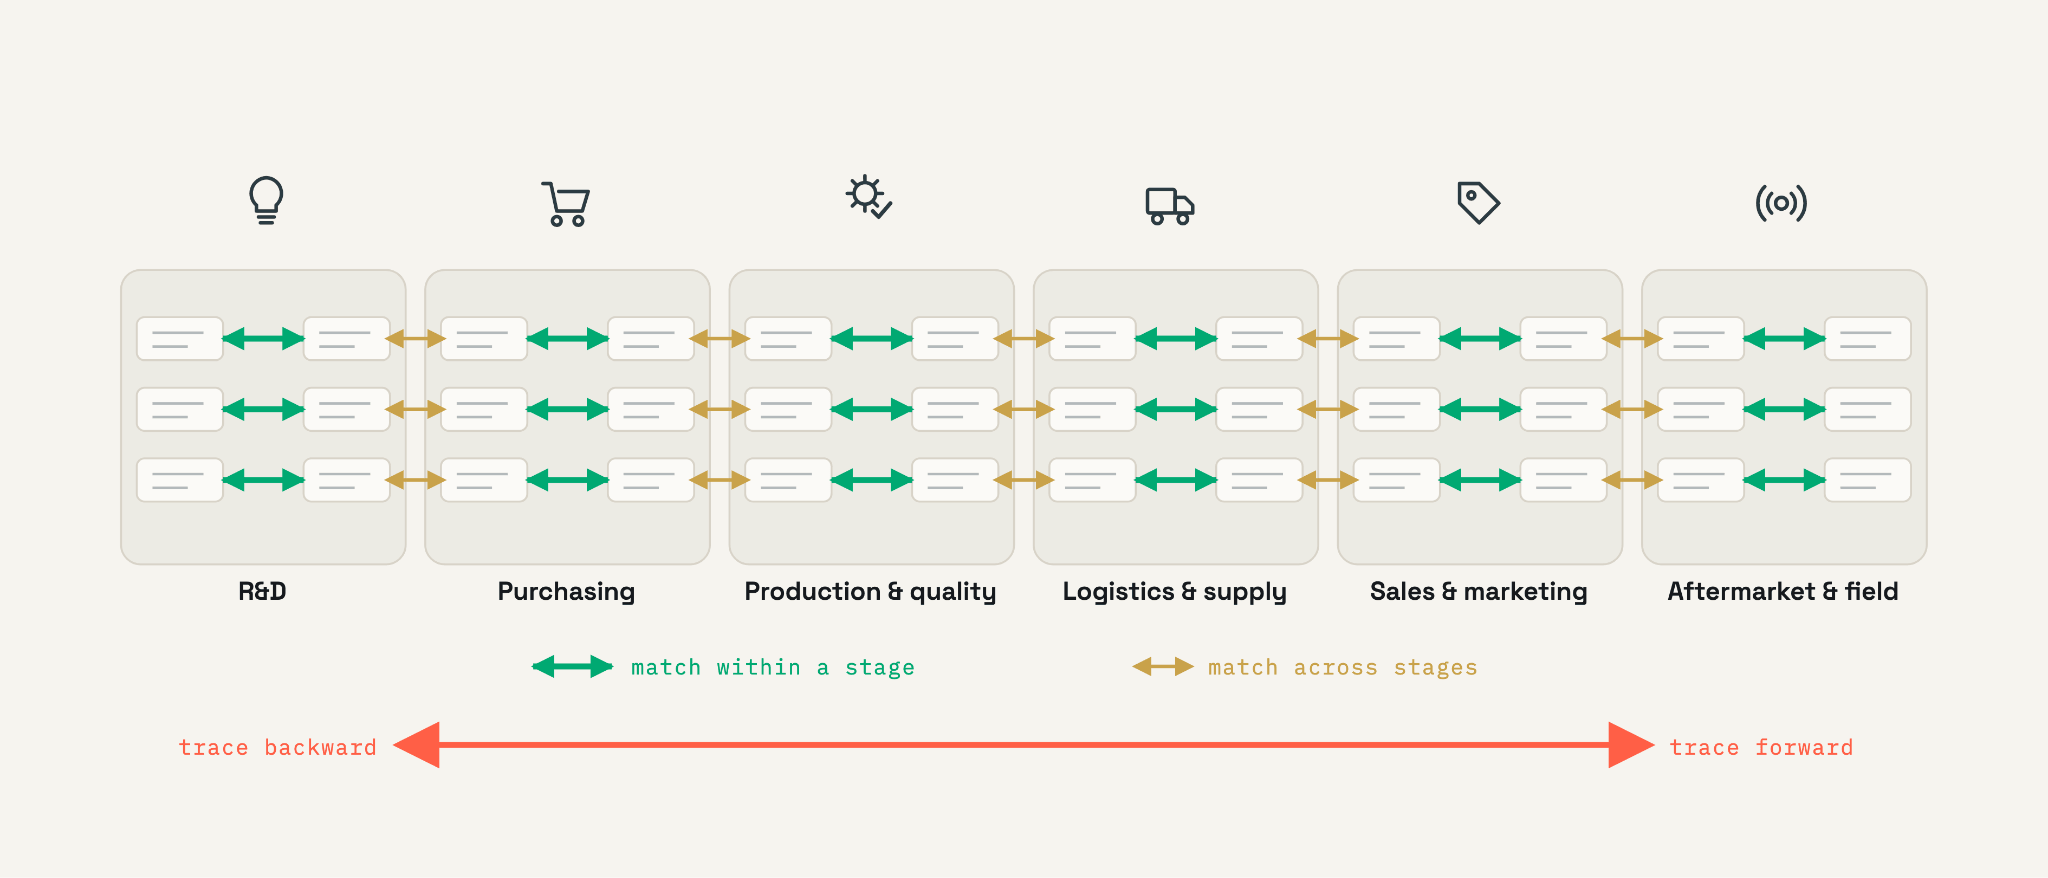
Cada etapa produz dados operacionais valiosos. A maior oportunidade vem de conectar uma descoberta em uma parte da cadeia a uma ação em outra: um problema de qualidade encontrado na produção investigado por meio de registros de logística e de fornecedores, ou um alerta de fornecedor rastreado até cada produto que recebeu o material afetado.
Por que os limites do sistema são o verdadeiro problema
Quando cada etapa da cadeia de valor é isolada, uma pergunta que cruza etapas se torna um projeto manual de chamados, exportações e reconciliação. Quando os dados estão acessíveis como um único sistema governado, a mesma pergunta se torna uma consulta.
Exemplo 1: Um engenheiro de qualidade de fábrica precisa responder a três perguntas:
- Um pico de refugo é causado pelo lote, pela máquina ou pela configuração, e isso ainda está acontecendo agora?
- Já vimos esse defeito antes e a correção funcionou?
- Por que uma fábrica descarta muito mais da mesma peça do que outra?
Cada pergunta abrange vários sistemas: registros de Manufacturing Execution System (MES), dados de historiadores de processo, dados de fornecedores e de Supplier Quality Management (SQM), histórico de Quality Management System (QMS), registros de Eight Disciplines (8D) e, frequentemente, várias instâncias de fábrica. Hoje, responder a cada uma delas significa abrir chamados, extrair exportações manuais e depender de alguns especialistas.
Exemplo 2: Um analista de compras precisa responder a três perguntas:
- Quais peças críticas dependem de um único fornecedor que agora está sinalizado com risco de entrega?
- O desempenho de pontualidade e qualidade de um fornecedor tem caído nos pedidos recentes?
- Se um fornecedor falhar, quais produtos, fábricas e pedidos em aberto ficarão expostos?
Cada pergunta abrange vários sistemas: registros de compras e source-to-pay de Enterprise Resource Planning (ERP), contratos, feeds de risco de fornecedores e portais de fornecedores. Hoje, responder a cada uma delas pode se tornar um pequeno projeto de chamados, conhecimento especializado e exportações manuais.
Agrupar essas fontes de dados operacionais elimina esse atrito. Reúna a cadeia de valor uma vez, governe-a uma vez e use um identificador compartilhado — um número de série, lote ou peça — como chave de junção, e a rastreabilidade se tornará uma consulta. Seis perguntas, uma necessidade subjacente: unir dados entre sistemas que nunca foram projetados para se conectar e confiar no resultado. Quatro recursos de plataforma tornam isso possível.
Como a Databricks conecta dados de fabricação
Nenhuma migração disruptiva é necessária
Uma cadeia de valor conectada não exige uma migração disruptiva de cada sistema de origem. Os dados podem ser copiados quando essa for a escolha certa, ou podem permanecer no local e ainda assim serem consultados.
Com o Open Sharing sem cópia e a Lakehouse Federation, as organizações podem acessar dados em seus sistemas de origem sem criar outro pipeline de extração, transformação e carregamento (ETL) ou cópia para cada caso de uso. Quando o espelhamento é apropriado, os conectores e o armazenamento de objetos em nuvem fornecem um caminho escalável para trazer dados para o lakehouse.
A Databricks Data and AI Platform reúne essa flexibilidade com os recursos de que as equipes de fabricação precisam: análise histórica de dados de produção, qualidade e suprimentos; processamento de baixa latência para telemetria de máquinas e veículos; e aplicativos que podem ler e gravar registros individuais rapidamente.
Os quatro recursos em que os exemplos se baseiam
Agrupar ou federar os dados de origem, sem uma migração disruptiva: A pergunta do engenheiro de qualidade abrange registros de MES, historiador de processo, fornecedor e SQM, QMS e 8D em todas as instâncias de fábrica; a do analista de compras abrange compras de ERP, contratos e feeds de risco de fornecedores. Com o Open Sharing sem cópia e a Lakehouse Federation, esses dados podem ser consultados no local e espelhados por meio de conectores quando a cópia for a melhor escolha. De qualquer forma, nenhuma nova cópia de ETL é necessária por pergunta.
Orquestração e refinamento: Ambos os exemplos fazem junções com tabelas gold governadas, não com extrações brutas. O Lakeflow ajuda as equipes a criar, agendar e monitorar os pipelines que transformam entradas brutas em dados confiáveis e prontos para análise, geralmente por meio das camadas Bronze, Silver e Gold.
Governança para dados e AI: Unity Catalog é o plano de controle único para dados espelhados e federados: um modelo de permissão, linhagem completa e descoberta que abrange dados, modelos e agentes de AI, para que a mesma superfície governada responda a ambos os exemplos. O Unity Gateway permite que você controle o acesso, os gastos e a observabilidade de AI em agentes, ferramentas, modelos e MCPs.
Recursos de agentes: Desenvolvido sobre essa base governada, o Genie One é um colega de trabalho de AI que se conecta aos seus dados, o Agent Bricks ajuda a criar agentes de AI baseados em dados corporativos e o Genie App Builder permite que qualquer pessoa crie agentes e aplicativos em linguagem natural. O engenheiro e o analista podem fazer suas perguntas em linguagem simples e obter respostas baseadas em definições que a empresa reconhece, o assunto das próximas duas seções.
O princípio de design prático é simples: agrupar os dados onde eles agregam valor, federá-los onde a cópia não faz sentido e governar ambos por meio do mesmo plano de controle. O resultado é uma maneira de trabalhar com tipos e etapas de dados de fabricação sem criar um novo silo para cada caso de uso analítico ou de AI.
Aumentando a alfabetização de dados – tornando os dados úteis para além dos especialistas
Uma plataforma só é valiosa se as pessoas conseguirem usá-la. Em muitas organizações de manufatura, um pequeno grupo de especialistas entende os sistemas específicos da fábrica, enquanto os usuários de negócios esperam por relatórios ou exportações.
A alfabetização de dados cresce quando as pessoas conseguem passar por uma progressão prática: encontrar dados relevantes, entender definições confiáveis, analisá-los, fazer perguntas em linguagem natural, criar agentes ou aplicativos governados e compartilhar esses ativos com outras pessoas. Nem todo mundo precisa se tornar um engenheiro de dados para participar. Esse crescimento segue seis etapas, mostradas abaixo.

A tecnologia é apenas parte da mudança. Treinamentos, comunidades de prática e uma rede de defensores ajudam cada função a desenvolver confiança e compartilhar padrões reutilizáveis. Uma superfície de dados comum e governada oferece a essas comunidades algo concreto para trabalhar: definições compartilhadas, vocabulário comum e respostas que podem ser reutilizadas entre as equipes.
Como o "Fale com os Dados" funciona na manufatura (e por que ele exige semântica governada)
A maneira mais rápida de aumentar a alfabetização de dados é permitir que as pessoas falem com seus dados: sem linguagem de consulta para aprender, sem chamados para abrir e sem relatórios para esperar. A análise em linguagem natural pode reduzir a barreira de acesso aos dados, mas uma interface de conversação não é suficiente. A resposta deve ser baseada em definições que a empresa reconheça.
Exemplo: Compras
Uma pergunta como “Quais peças críticas dependem de um único fornecedor que agora está marcado com risco de entrega?” pode exigir conhecimento de cabeçalhos de tabela específicos do SAP, joins e regras de negócios. Um analista de compras não deve precisar se tornar um especialista em dados para investigar isso.
A Demonstração do Purchasing Genie torna esse padrão concreto. O projeto executável segue três etapas: preparar dados governados, criar agentes especialistas e, em seguida, compô-los sob um supervisor e compartilhá-los como um único aplicativo governado.

Esse padrão separa o trabalho que exige conhecimento técnico – preparar e governar os dados – do trabalho que os usuários de negócios devem ser capazes de fazer sozinhos: fazer perguntas, revisar respostas e tomar atitudes.
Exemplo: Relatórios de KPI
O mesmo padrão se aplica aos relatórios diários. Quando as definições de KPI residem em uma camada semântica governada, tanto as ferramentas de BI quanto a IA trabalham a partir da mesma lógica de negócios. Os Genie Agents respondem a perguntas dentro de uma função usando essas definições confiáveis, e o Agent Bricks os compõe em agentes baseados em personas que funcionam em todas as funções. O resultado: a mesma pergunta obtém a mesma resposta sempre, baseada em definições que a empresa reconhece, em vez de ser inferida de esquemas complexos ou relatórios desconectados.
A Mercedes-Benz Korea aplica esse padrão na prática, saiba mais aqui.
Um caminho prático a seguir
Há mais de 50 anos, a visão do Dr. Joseph Harrington de Manufatura Integrada por Computador descreveu a manufatura como um sistema coeso, unificado pelo fluxo de informações. Essa visão agora é alcançável em escala.
A receita de implementação tem três etapas:
- Agrupe os dados uma vez e governe-os uma vez com o Unity Catalog como o plano de controle único, cobrindo fontes de dados espelhadas e federadas.
- Torne um identificador compartilhado a chave de junção, como um número de série, lote ou peça, para que as descobertas em uma parte da cadeia de valor possam impulsionar ações em outra, permitindo a rastreabilidade de ponta a ponta como uma consulta. Qual identificador se ajusta depende do domínio: unidades serializadas e VINs em alguns, números de lote em manufatura de processo.
- Permita que as pessoas falem com seus dados fundamentando o acesso em linguagem natural na semântica de negócios governada.
Quando os usuários de negócios podem fazer perguntas em linguagem simples e receber respostas confiáveis, a alfabetização de dados deixa de ser o privilégio de alguns especialistas e se torna uma capacidade organizacional. O resultado não é mais um dashboard. São milhares de pessoas em toda a cadeia de valor que podem encontrar, entender e agir com base em dados confiáveis.
Perguntas frequentes (FAQ)
Qual é o maior benefício de conectar dados de manufatura em toda a cadeia de valor?
O maior benefício de conectar dados de manufatura em toda a cadeia de valor é a capacidade de responder a perguntas que começam em uma etapa e exigem ação em outra. Um defeito de produção pode ser rastreado pela logística até o lote do fornecedor que o causou, ou um lote de fornecedor suspeito pode ser rastreado até cada produto que ele alcançou. Sem dados conectados, cada uma dessas investigações exige dias de trabalho manual. Com um lakehouse conectado, a mesma pergunta se torna uma consulta.
Os fabricantes precisam migrar todos os dados de origem para o Databricks?
Os fabricantes não precisam migrar todos os dados de origem para o Databricks. Os dados podem ser copiados quando isso for útil, mas o Open Sharing com cópia zero e a Lakehouse Federation permitem que os dados permaneçam nos sistemas de origem e sejam consultados no local. O Unity Catalog pode governar tanto dados federados quanto espelhados.
O que é rastreabilidade?
A rastreabilidade vincula as etapas do processo de manufatura, produtos, materiais e registros operacionais para que as equipes possam rastrear retrospectivamente a partir de um produto afetado ou prospectivamente a partir de um material suspeito. Ela oferece suporte a uma resolução de problemas mais rápida e a uma análise de recall mais precisa. Um exemplo é rastrear os números de série ou de lote dos produtos produzidos.
O que é LTAP e por que os fabricantes precisam dele?
LTAP significa Lake Transactional/Analytical Processing. Ele descreve a execução de cargas de trabalho analíticas e transacionais em uma única plataforma governada. A manufatura precisa tanto de análise em grande escala de dados históricos quanto de aplicativos responsivos que leem e gravam registros operacionais. Historicamente, eles residiam em duas pilhas separadas com dados copiados entre elas; o LTAP executa ambos em uma única cópia de dados governados.
O que faz com que a alfabetização de dados cresça além dos recursos da plataforma?
Os recursos por si só não são suficientes. Treinamentos, comunidades de prática e defensores em cada função ajudam as pessoas a desenvolver confiança, compartilhar padrões e usar uma superfície de dados comum e governada. A plataforma fornece a base; uma comunidade ativa a transforma em uma ampla capacidade.
Como o “Fale com os Dados” se torna confiável?
O acesso em linguagem natural deve ser baseado na semântica de negócios governada: medidas, dimensões, joins e definições documentadas. O Genie pode então responder a perguntas usando o mesmo contexto confiável, em vez de inferir o significado de esquemas complexos ou relatórios desconectados.
O que é Lakehouse Federation?
A Lakehouse Federation é um recurso do Databricks que permite que os dados permaneçam em seu sistema de origem enquanto ainda são consultados por meio do Databricks. Ela evita a criação de pipelines de ETL adicionais ou cópias de dados. Os dados de origem são governados por meio do Unity Catalog junto com quaisquer dados espelhados, oferecendo uma camada de governança unificada, independentemente de onde os dados residam fisicamente.
O que é o Unity Catalog no contexto de dados de manufatura?
O Unity Catalog é a camada de governança unificada do Databricks para dados, modelos e agentes de IA. Ele fornece um modelo de permissão único, linhagem de dados completa e descoberta em todo o cenário de dados. Para a manufatura, isso significa um único plano de controle que governa dados de produção, registros de qualidade, dados de fornecedores e agentes de IA, quer esses dados residam no lakehouse ou sejam federados de sistemas de origem.
A plataforma lida com telemetria de máquinas e veículos de alto volume?
Sim. A plataforma combina lote e streaming. A telemetria de máquinas e veículos de alto volume pode ser ingerida como um fluxo contínuo de baixíssima latência e processada de forma confiável, para que nenhum evento seja perdido pelo caminho.
Como os dados entram no Databricks?
A ingestão foi projetada para ser fácil. O Zerobus Ingest oferece suporte a streaming baseado em push diretamente em tabelas governadas, o Lakeflow Connect fornece conectores gerenciados e captura de dados alterados para sistemas de negócios, e o Auto Loader e o Structured Streaming lidam com arquivos e eventos.
A plataforma é aberta e multi-cloud?
Sim. As tabelas Delta são armazenadas em armazenamento de objetos em nuvem, com armazenamento e computação escalando de forma independente. O Databricks é executado na AWS, Azure e Google Cloud, e os dados chegam em formatos abertos, como Delta Lake e Iceberg.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.