NEAREST BY Join: Escalando a busca vetorial no Databricks Runtime
Como integramos a busca vetorial ao Databricks como um join SQL de primeira classe, com otimizações profundas de kernel no Photon e um índice vetorial em um formato de armazenamento aberto.
por Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu e Sergei Tsarev
- O NEAREST BY é um novo join SQL para busca vetorial em lote: para cada linha de consulta, encontre as k linhas mais próximas por similaridade ou distância vetorial — exata ou aproximada.
- Um operador Photon fundido com um kernel GEMM em blocos personalizado direciona a pontuação de distância para o pico de taxa de transferência aritmética que o hardware oferece.
- Seu Lakehouse também é seu armazenamento de vetores, sem nenhum sistema separado para sincronizar ou operar: o índice vetorial IVF é uma tabela Delta comum com clustering líquido que elimina a maioria das partições na leitura.
A busca vetorial surgiu como um problema de serving. O caso de uso clássico é um chatbot ou uma barra de pesquisa: um embedding de consulta chega, e o sistema é otimizado para retornar os top-k documentos mais próximos em dezenas de milissegundos.
No entanto, uma boa parte das cargas de trabalho de busca vetorial em nossa plataforma é inerentemente orientada a lote — pré-computando vizinhos mais próximos exatos ou aproximados offline, em vez de buscá-los no momento da requisição. Uma empresa de pagamentos compara mais de 100 milhões de transações diárias com 140 milhões de embeddings de comerciantes para resolução de entidades; uma empresa de dados enriquece dezenas de milhões de registros históricos todas as noites; um fundo quantitativo executa lotes de milhões de consultas em um corpus de 50 milhões de vetores para marcação de taxonomia.
Resolução de entidades, deduplicação, marcação semântica, classificação, enriquecimento de registros, recomendações em lote — essas são fundamentalmente cargas de trabalho em lote: milhões de consultas contra milhões a bilhões de vetores de forma programada, medidas pelo fato de o job ser concluído dentro de seu SLA a um custo razoável, e não pela latência de uma única busca. Essas cargas de trabalho merecem uma arquitetura muito diferente para melhor desempenho, confiabilidade e eficiência de custos — por isso, voltamos aos primeiros princípios.
Requirements
- Vazão agregada em vez de latência por requisição. A unidade de sucesso é a conclusão de todo o job em lote dentro de seu SLA a um custo razoável, de modo que o design deve priorizar a vazão em detrimento da latência por requisição em todas as oportunidades.
- Escalar em ambos os lados do join. Até centenas de milhões de vetores de consulta contra bilhões de vetores de base. O sistema deve lidar com todos os formatos de cardinalidade de consulta e de base.
- Paralelismo elástico. A vazão em lote vem do escalonamento horizontal. O trabalho deve ser particionado de forma limpa entre centenas a milhares de cores, e a computação deve se dimensionar de acordo com o job: escalar horizontalmente (scale out) para a execução e reduzir a zero (scale down) após o término.
- Pico aritmético por núcleo. O cálculo de pontuação de distância é computacionalmente caro. O escalonamento horizontal apenas multiplica o que um único núcleo alcança, portanto, os loops internos devem ser executados próximos ao máximo teórico definido pela largura de banda aritmética do hardware subjacente (FLOPs/s) e pela largura de banda de memória (bytes/s).
- Tolerância a falhas. Um job que roda por horas deve sobreviver à perda de workers, falhas temporárias de tarefas e pressão de memória por meio de gravação em disco (spilling to disk). Essas são propriedades de um mecanismo de execução, não recursos que podemos encapsular em torno de um endpoint de serving em tempo real.
O Databricks Runtime atende a esses requisitos perfeitamente — um mecanismo de execução distribuído, tolerante a falhas e elástico construído sobre o Spark e o Photon, um mecanismo de consulta nativo em C++ vetorizado. É exatamente por isso que decidimos criar a busca vetorial diretamente como um recurso nativo do mecanismo, em vez de depender de uma infraestrutura separada.
Architecture
Nossa primeira versão da função SQL VECTOR_SEARCH foi projetada para federar requisições para um endpoint externo de busca vetorial em tempo real. Ela foi implementada como um nó Generate transmitindo (streaming) uma linha de consulta por vez: cada linha gerava uma requisição de rede, uma resposta para desserializar e, possivelmente, tentativas de reenvio. Funcionou, mas expôs um teto de desempenho — a vazão era limitada pelo dimensionamento do endpoint em tempo real, e não pelo tamanho do cluster de runtime, com o mecanismo de runtime reduzido a um despachante (dispatcher). Ela também não capturava o formato real da consulta. Uma busca vetorial em lote não é um milhão de pequenas buscas. É uma única grande consulta: para cada linha à esquerda, encontre as k linhas mais próximas à direita — um join de classificação top-k. Executar joins enormes é exatamente aquilo em que o mecanismo de runtime se destaca.
Implementar a busca vetorial nativamente no mecanismo de runtime traz vantagens sob dois aspectos.
- Cópia única dos dados. os embeddings permanecem em tabelas Delta no Lakehouse — sem armazenamento de vetores separado, sem pipeline de sincronização para manter a consistência, sem um segundo sistema para operar e pagar.
- Mecanismo único para execução. a busca é executada em um único mecanismo que escala de forma elástica com a carga de trabalho, com kernels desenvolvidos especificamente para formatos de consulta em lote — levando cada núcleo ao pico de FLOPs e deixando o escalonamento horizontal multiplicar o restante. O mecanismo já gerencia a tolerância a falhas: as tarefas são repetidas automaticamente e a pressão de memória grava no disco (spills to disk). Sem controle de concorrência no lado do cliente, limitação de taxa (rate limiting) ou loops de repetição.
Isso resultou em uma pilha deliberadamente pequena, mas profunda: uma nova sintaxe de join, NEAREST BY, que torna o join de classificação top-k uma operação relacional de primeira classe; uma reescrita que a reduz a três primitivas — funções de distância aceleradas por SIMD e uma agregação top-k limitada; um operador Photon fundido que substitui todo o meio do plano por um kernel GEMM personalizado; e um índice IVF opcional construído como uma tabela Delta comum com agrupamento líquido (liquid-clustered), o que permite que consultas APPROX pontuem uma fração dos vetores de base com os mesmos kernels.
The syntax: a top-k ranking join
Os mecanismos existentes convergiram para dois formatos de interface. O Postgres com pgvector e o Snowflake compõem operadores de distância com ORDER BY … LIMIT — o lote, então, precisa de uma subconsulta LATERAL por linha de condução, e o otimizador carece de um padrão para reconhecer e diferenciar consultas KNN e ANN. Esse reconhecimento também é frágil: qualquer desvio do formato de consulta esperado faz com que o caminho rápido desapareça silenciosamente. O BigQuery expõe uma função com valor de tabela — o lote é de primeira classe, mas as referências de coluna são strings que o analisador (parser) não pode validar.
Estruturalmente, a busca vetorial em lote é uma operação relacional binária: duas entradas de tabela, uma saída combinando ambas e um top-k por linha esquerda conectando-as. A sintaxe codifica essa estrutura como um join de classificação top-k nativo:
O join é assimétrico, semelhante ao LATERAL: o lado esquerdo conduz, o lado direito é pesquisado. A direção de classificação é explícita: BY SIMILARITY decrescente, BY DISTANCE crescente. LEFT OUTER mantém as linhas de consulta sem candidatos, e a expressão BY é plugável: qualquer escalar ordenável em ambos os lados funciona, de modo que outras expressões de pontuação podem reutilizar a mesma cláusula mais tarde.
APPROX e EXACT codificam um contrato semântico. EXACT garante o top-k real por meio de avaliação exaustiva; APPROX permite que o otimizador substitua por uma estratégia aproximada, como um índice ANN, onde aplicável. Portanto, criar ou excluir um índice nunca pode alterar silenciosamente os resultados da consulta: apenas as consultas que especificam APPROX consentem com a aproximação.
The query rewrite
O NEAREST BY é analisado em um nó de join lógico, que o otimizador reduz a operadores relacionais padrão: a reescrita marca cada linha de consulta com um ID gerado, pontua cada par (consulta, base), mantém os k melhores por ID com um top-k agrupado e insere as linhas mantidas de volta na saída:
Semanticamente, isso encapsula todo o recurso: um cross join, uma expressão de pontuação escalar e um agregado top-k agrupado. Como cada operador é um operador relacional comum, o plano é distribuído, grava em disco (spills) e tenta novamente (retries) como qualquer outro — a correção e a tolerância a falhas vêm de graça. O que a reescrita realmente isola são as duas primitivas pelas quais todo o tempo de execução flui: a função de distância que pontua um par e o agregado que mantém os k melhores de cada grupo.
Implementamos todos os operadores desse plano nativamente no Photon, além de um operador fundido adicional, desenvolvido especificamente para busca vetorial, que colapsa totalmente a seção intermediária do plano com um kernel mais eficiente e amigável para lotes.
The photon kernels
The vector functions
Os blocos de construção principais são uma família de funções SQL vetoriais sobre colunas ARRAY<FLOAT>. Três delas são responsáveis pelo cálculo de similaridade e distância:
| Função SQL | Calcula | Mais Próximo Significa |
|---|---|---|
| vector_inner_product(a, b) | 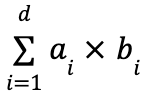 | Maior (BY SIMILARITY) |
| vector_cosine_similarity(a, b) | 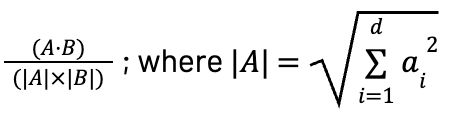 | Maior (POR SIMILARIDADE) |
| vector_l2_distance(a, b) | 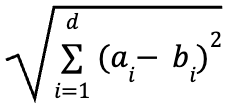 | Menor (POR DISTÂNCIA) |
Além das funções de similaridade e distância, lançamos dois auxiliares de norma — vector_norm e vector_normalize, e dois agregadores, vector_sum e vector_avg. Juntos, eles cobrem tanto a construção de consultas quanto a de índices: as funções de distância pontuam as consultas e atribuem linhas ao seu centroide mais próximo, enquanto os agregadores e normalizadores recalculam esses centroides durante o k-means.
O Photon executa toda a família como kernels SIMD nativos. Cada métrica é baseada em multiplicações e adições (multiply-adds) em sua essência, e uma única instrução FMA (fused multiply-add) calcula 𝑎 · 𝑏 + 𝑐 em todo um registrador vetorial por emissão. Os kernels são implementados com base em quatro escolhas de design deliberadas.
- Portável por construção. Os mesmos kernels devem ser executados em todas as nuvens (AWS, Azure, GCP) e em todas as arquiteturas de CPU (x86, ARM) que oferecemos suporte. Como a largura do SIMD e o conjunto de instruções diferem entre elas, cada kernel é compilado em vários clones específicos de ISA, e o melhor que a CPU suporta é selecionado em tempo de execução (AVX-512 em um núcleo Intel moderno, SVE2 no Graviton).
- Entrada zero-copy. Um ARRAY<FLOAT> é contíguo dentro de uma linha, de modo que cada vetor é lido como um ponteiro bruto para o buffer de suporte da coluna, sem cópia e sem indexação por elemento dentro do loop crítico.
- Semântica de ponto flutuante relaxada. Abandonar a ordenação estrita do IEEE permite que o compilador funda multiplicações e adições em instruções FMA e divida a redução em cadeias de acumuladores paralelos, para que o loop não seja serializado em uma única soma contínua.
- Nada escalar no loop. Os loops críticos são reduções puras de multiplicação e adição vetorizadas; o trabalho escalar, como sqrt e a divisão, é feito apenas uma vez, fora do loop.
O agregador top-k
No SQL padrão, o top-k agrupado é uma função de janela (window function): ROW_NUMBER() OVER (PARTITION BY query ORDER BY score). Isso ordena cada partição por completo e, em seguida, descarta tudo, exceto as primeiras k classificações. Em vez disso, estendemos os agregadores max_by / min_by existentes com uma sobrecarga de um terceiro parâmetro K. A implementação foi desenvolvida com base em quatro propriedades principais.
- Seleção de comparação única. O estado de agregação por grupo é um heap limitado cuja raiz é o candidato à remoção e o limite de admissão. Uma vez cheio, cada candidato é aceito ou rejeitado com uma única comparação. Nenhuma ordenação é executada no fluxo de candidatos.
- Estado O(k). A memória por grupo é independente do tamanho da entrada. Uma consulta pontuada em relação a um bilhão de linhas carrega apenas k linhas de estado, e k pode chegar a 100.000.
- Materialização tardia. O heap armazena índices, não cópias totalmente materializadas. O candidato permanece como um ponteiro para o lote colunar ativo e é copiado para o estado de agregação apenas se ainda sobreviver quando o lote for reciclado.
- Distribuível. Os agregadores têm um contrato de divisão parcial/mesclagem (partial/merge). Cada partição emite seu top-k local, o shuffle move esses arrays de k elementos em vez de pares brutos, e a mesclagem os reinsere. O resultado é exato porque o top-k global é sempre um subconjunto da união dos parciais.
O modelo roofline
Com todos os kernels nativos acima, o plano de consulta é totalmente otimizado para o Photon (Photonized), mas ainda está longe do ideal em escala de lote. O motivo é teórico, não de implementação, e o modelo roofline é uma maneira simples e eficaz de visualizá-lo.
𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 = 𝑚𝑖𝑛(𝑃𝑝𝑒𝑎𝑘, 𝐴𝐼 × 𝐵𝑊)
𝑃𝑝𝑒𝑎𝑘 é a capacidade máxima de processamento computacional do hardware (FLOPs/s), BW é a largura de banda de memória (bytes/s), e 𝐴𝐼 é a intensidade aritmética do kernel (FLOPs executados por byte movido). Ao plotar 𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 em relação a 𝐴𝐼, obtemos o roofline: um limite de memória diagonal que encontra um limite de computação horizontal no ponto de inflexão (ridge point) — o 𝐴𝐼 mínimo no qual um kernel pode ser limitado por computação (compute-bound). À esquerda do ponto de inflexão, apenas mover menos bytes por FLOP ajuda; à direita dele, o kernel é limitado por computação e as próprias unidades aritméticas são o limite. Concretamente, em uma máquina de referência m6i.2xlarge (ilustrativo, as constantes mudam com o hardware):
| Por núcleo | |
|---|---|
| Limite de capacidade de processamento computacional | 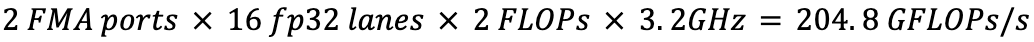 |
| Limite de largura de banda de DRAM | 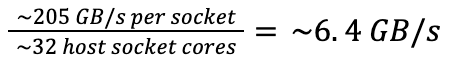 |
| Ponto de inflexão (ridge point) | 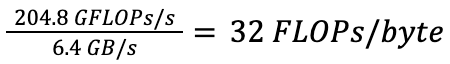 |
*Os limites de cache L1/L2 ficam de 30 a 60 vezes acima da parcela justa de DRAM, mas a tabela base é muito maior do que qualquer cache, de modo que cada byte base cruza o limite da DRAM pelo menos uma vez.
*O limite de capacidade de processamento computacional escala linearmente com os núcleos. Um cluster de 64 executores m6i.2xlarge (4 núcleos físicos cada) atinge o pico de 64 x 4 x 204,8 GFLOP/s ≈ 52,5 TFLOP/s de FMA fp32.
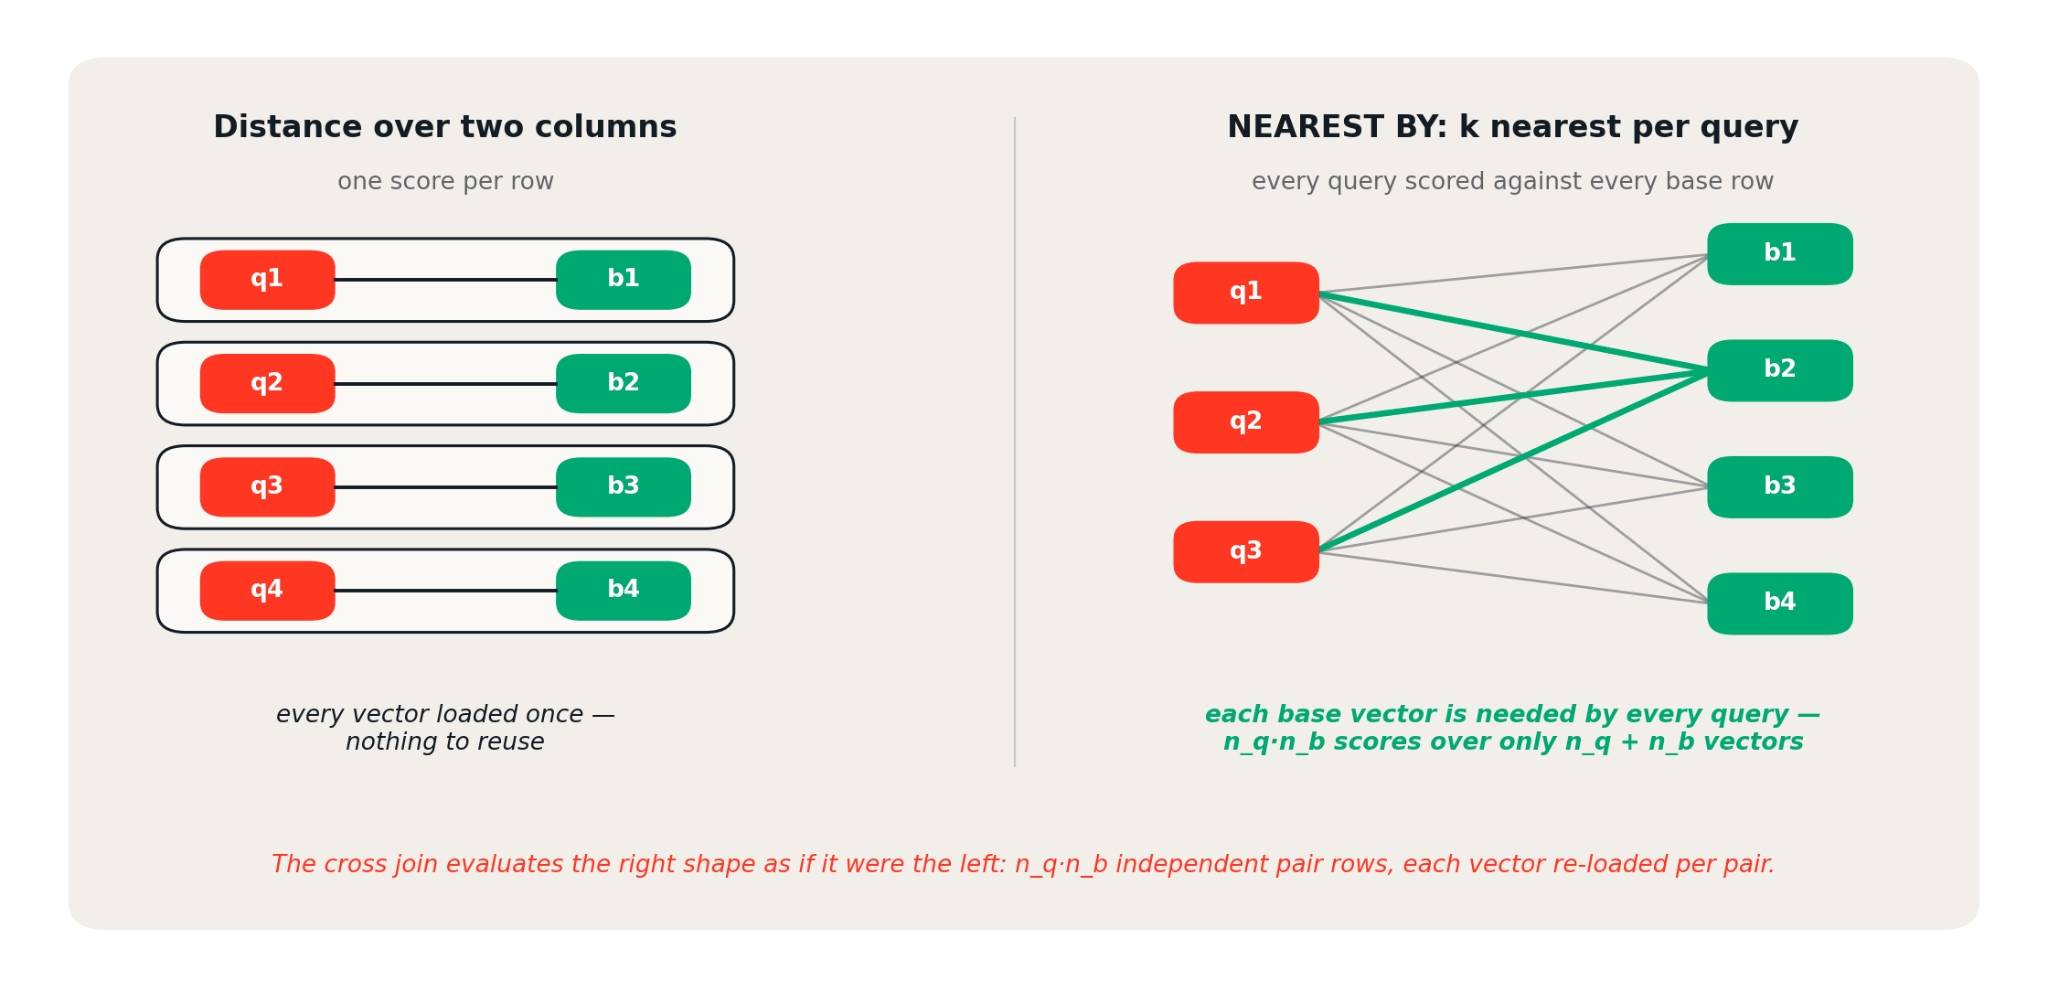
A pontuação de duas colunas alinhadas gera uma pontuação por linha — cada vetor é usado uma vez e não há reutilização. O formato NEAREST BY gera 𝑛𝑞 × 𝑛𝑏 pontuações a partir de apenas 𝑛𝑞 + 𝑛𝑏 vetores distintos, já que cada vetor base é necessário para cada consulta.
Agora compare o que a busca vetorial move sob o plano simples (naive) versus um plano que reconhece a reutilização. Os FLOPs são idênticos em ambos: 2 × 𝑑 × 𝑛𝑞 × 𝑛𝑏, onde 𝑛𝑞 e 𝑛𝑏 são a cardinalidade do lado da consulta e da base, e 𝑑 é a dimensão do embedding.
| Plano | Bytes movidos | Intensidade aritmética (AI) | Escalonamento |
|---|---|---|---|
| Cross join em pares — cada operando carregado do zero, usado apenas uma vez | 2 × 4 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 | 1/4 | 0(1) |
| GEMM fundido — buffer, transmitido uma vez | 4 × 𝑑 × 𝑛b | 𝑛𝑞/2 | 0(𝑛𝑞) |
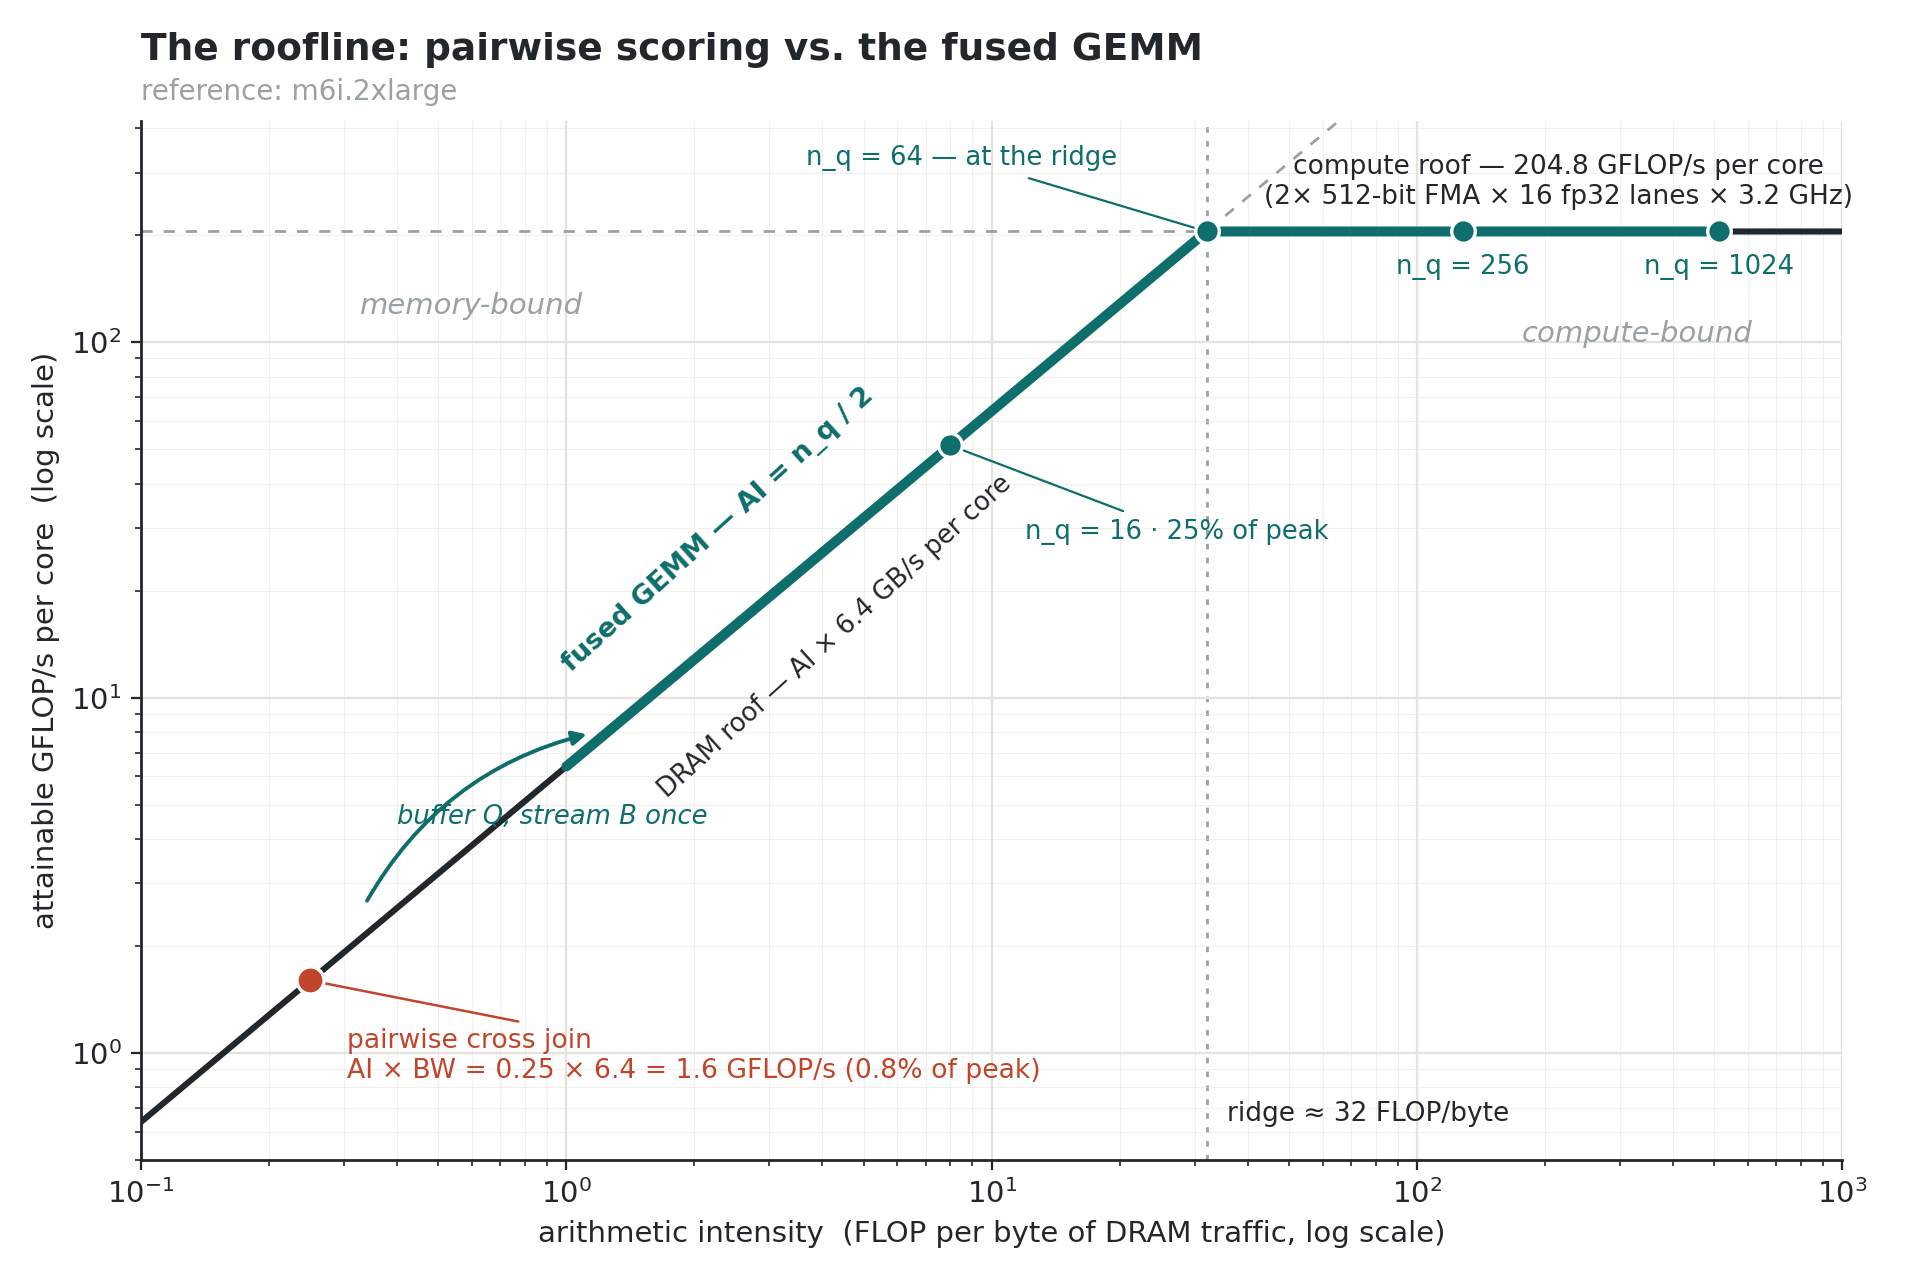
A pontuação em pares fica presa à inclinação da DRAM em 0,8% do pico, enquanto a intensidade aritmética do kernel GEMM fundido cresce com o tamanho do lote: 𝐴𝐼 = 𝑛𝑞/2 — permitindo que ele cruze o ponto de inflexão em 𝑛𝑞 = 64 e acompanhe o limite de computação em lotes maiores. Os kernels de distância vetorial e similaridade são quase ideais para seu formato de entrada, mas o formato do plano simples não tem reutilização de dados para explorar, e o processamento em lote não pode ajudar: a explosão de pares multiplica FLOPs e bytes igualmente. A solução é um plano de operador fundido, permitindo que o kernel explore a reutilização de dados, e a intensidade aritmética o acompanhará.
O operador fundido e o kernel GEMM
O operador fundido é um único nó de execução do Photon que substitui o cross join, a projeção de distância/similaridade e, opcionalmente, o top-k parcial. Ele armazena em buffer a entrada menor, transmite a outra em lotes, pontua blocos de consulta por base com um kernel GEMM personalizado e mantém o estado top-k por consulta entre os blocos quando k é pequeno o suficiente. Com o top-k fundido, sua saída é de no máximo 𝑛𝑞 × 𝑘 linhas candidatas, em vez de 𝑛𝑞 × 𝑛𝑏 pares, consumidos pelo kernel de mesclagem max_by / min_by downstream. O pico de memória por tarefa é o lado armazenado em buffer + um lote em andamento + estado de seleção 0(𝑛𝑞 × 𝑘). A distribuição segue as estratégias de junção padrão — faz o broadcast do lado menor quando ele couber; caso contrário, particiona ambos os lados e executa o produto cartesiano em blocos.
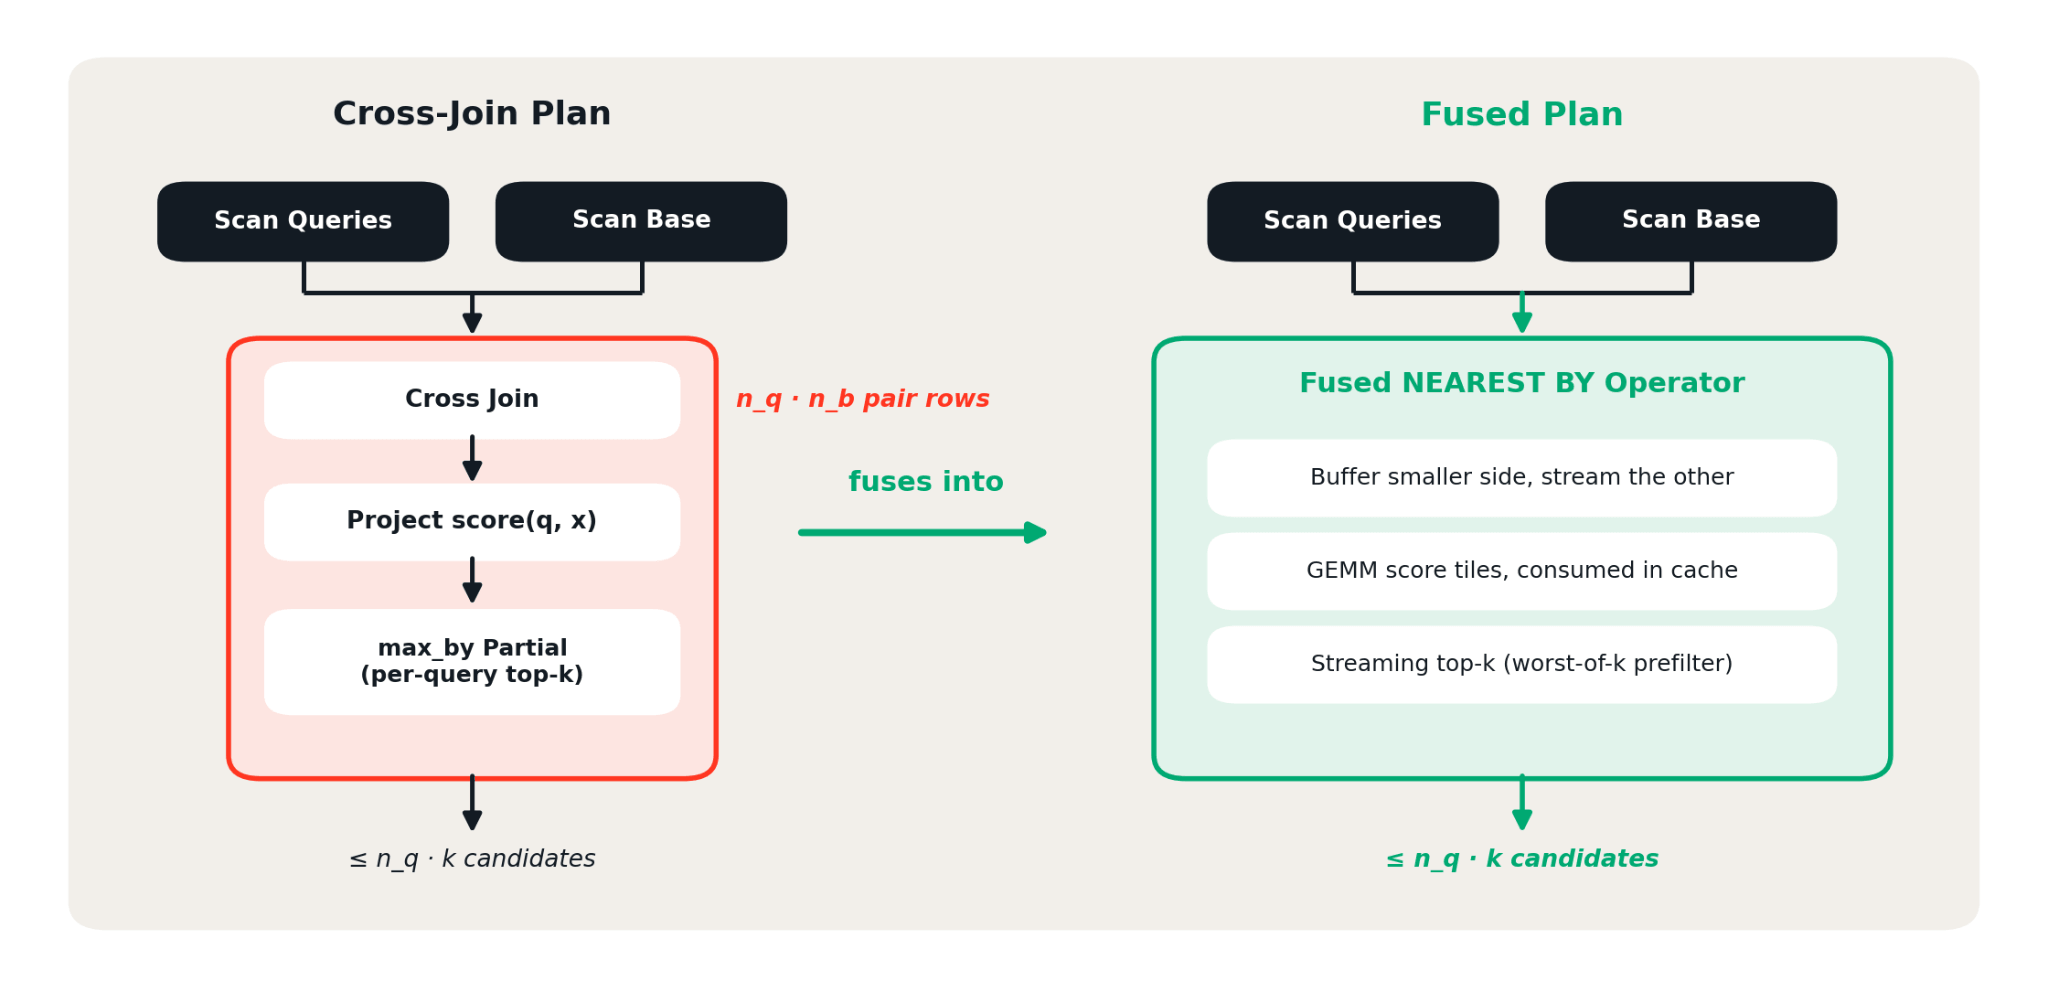
Como mostrado no modelo roofline, a fusão altera os bytes que movemos na memória, não os FLOPs que realizamos. Cada vetor de base é pontuado em relação a todas as consultas armazenadas em buffer uma vez carregado, de modo que a intensidade aritmética cresce linearmente com o lote e cruza o ponto de crista de referência em 𝑛𝑞 = 64 — bem abaixo dos tamanhos de lote de cargas de trabalho de produção típicas. O mesmo se aplica quando o lado da base é menor: a intensidade aritmética escala com o lado que permanecer residente.
Cruzar a crista é necessário, mas não suficiente. A contagem de bytes 𝑛𝑞/2 é o resultado direto do kernel GEMM em blocos abaixo. Ultrapassar o teto da DRAM apenas move o gargalo para baixo, para a largura de banda do cache e, em seguida, para a latência de FMA.
Concretely, o kernel é um GEMM em blocos clássico sobre a matriz de pontuação 𝐷 = 𝑄 · 𝐵𝑇. O loop externo avança sobre a base um painel de vetores por vez e compacta cada painel no formato dimension-major para reutilização entre os blocos de consulta. Como a própria dimensão do embedding é dividida em blocos de painéis, o loop intermediário varre cada bloco de consulta armazenado em buffer contra o painel compactado antes que o próximo seja buscado. O loop mais interno acumula um pequeno bloco de saída em registradores ao longo de um painel de dimensão; para embeddings mais largos do que um único painel, as parciais em execução são armazenadas temporariamente no buffer de pontuação e lidas de volta para continuar o próximo painel. Cada bloco finalizado é gravado em um buffer de pontuação limitado e reciclado que o top-k em streaming consome in-place, de modo que a matriz de pontuação completa de 𝑛𝑞 × 𝑛𝑏 nunca é gravada na DRAM.
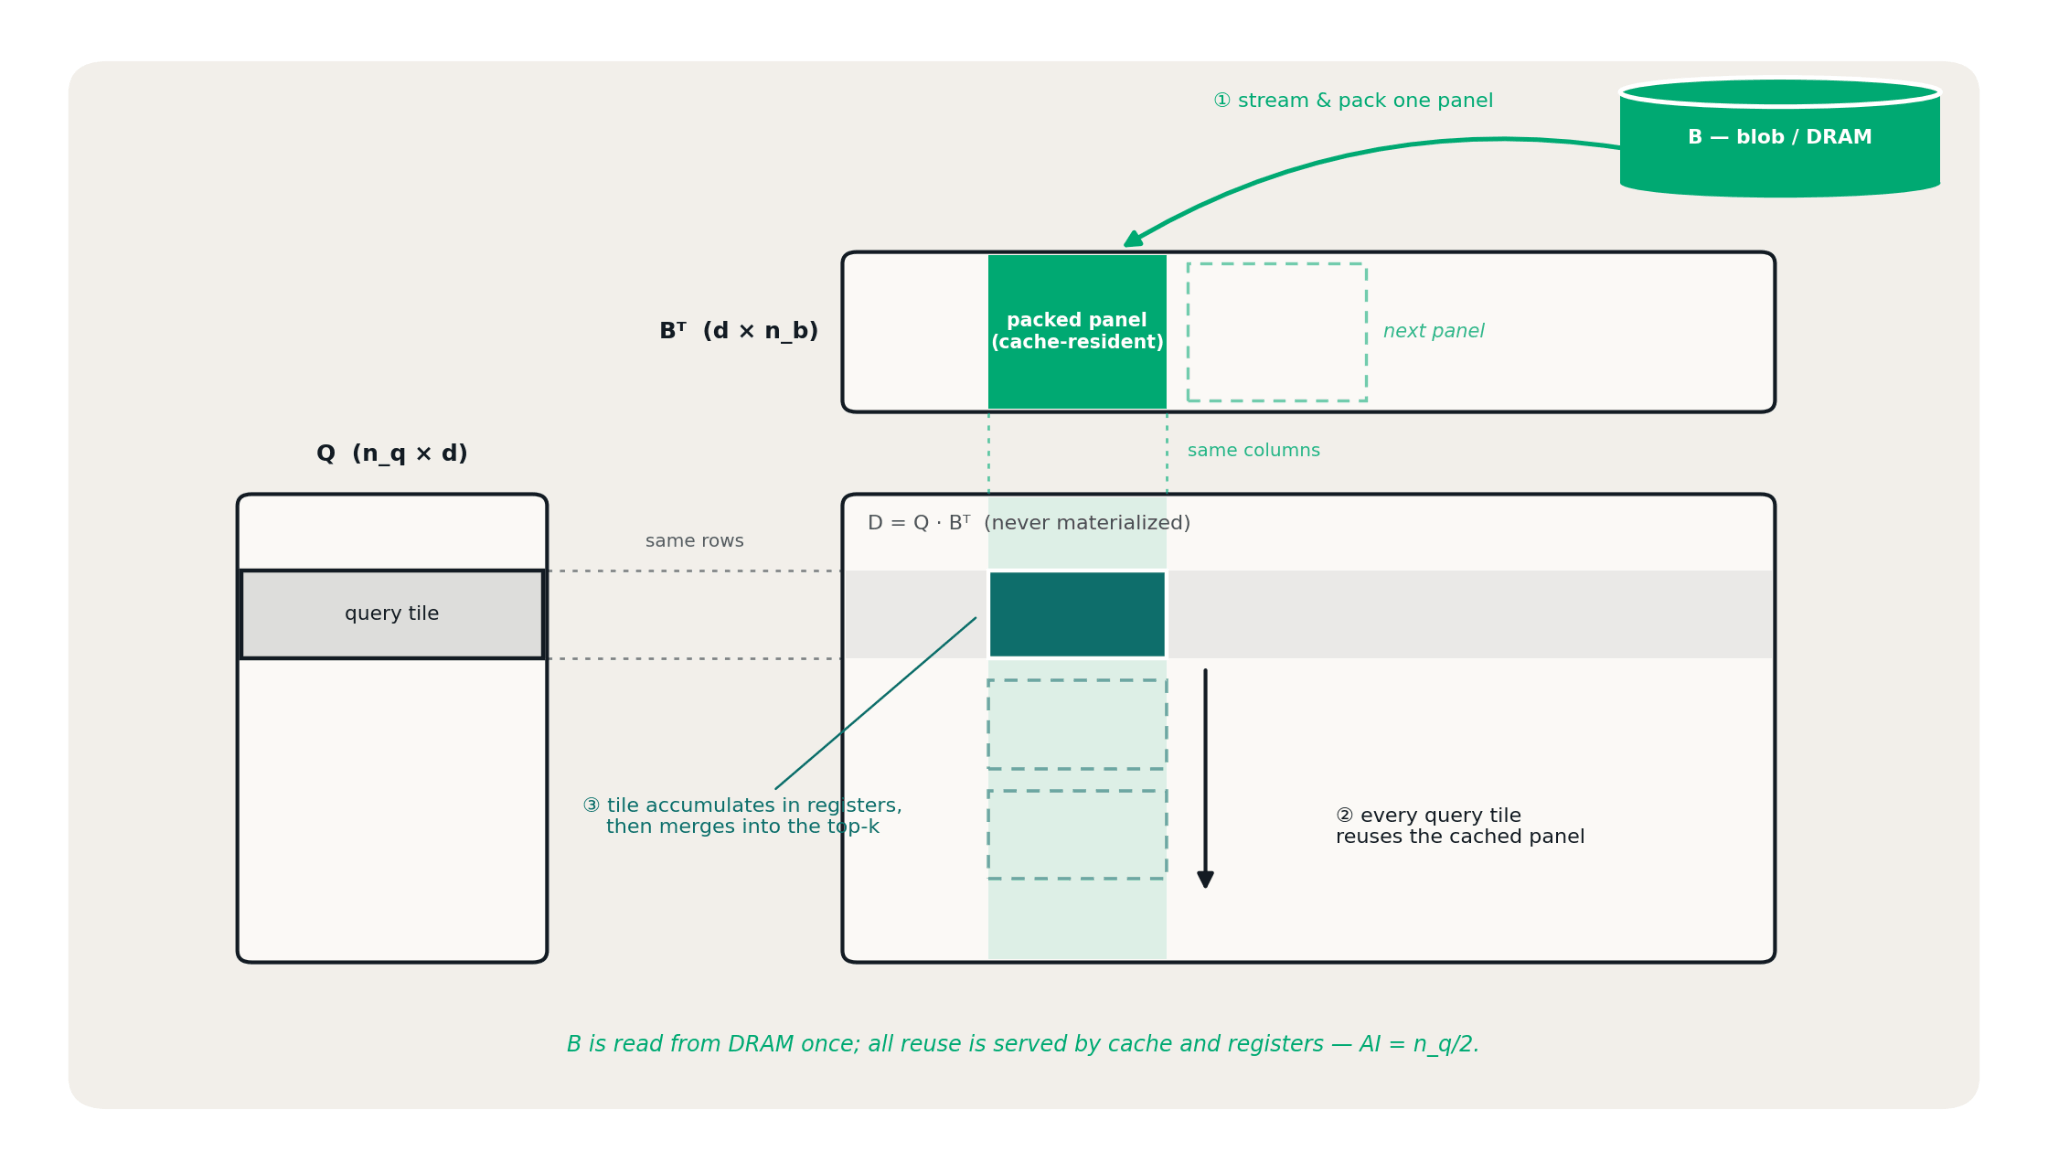
Existem dois níveis de divisão em blocos para melhorar a reutilização de dados. Painéis de base compactados são reutilizados em blocos de consulta para incentivar acertos de cache (cache hits) da CPU, enquanto a divisão em blocos de registradores permite que cada valor carregado contribua para múltiplos FMAs. Cada tamanho de bloco equilibra duas considerações concorrentes:
- Tamanho do painel compactado: o painel deve ser pequeno o suficiente para caber confortavelmente no cache, mas grande o suficiente para limitar a sobrecarga (overhead) de salvar e recarregar resultados parciais. Cada limite ao longo da dimensão do embedding exige uma viagem de ida e volta (round-trip) pelo buffer de pontuação. Painéis maiores reduzem esse tráfego, mas podem aumentar os cache misses.
- Tamanho do bloco de registradores: os acumuladores e operandos devem caber nos registradores vetoriais disponíveis, fornecendo acumulações independentes suficientes para sobrepor a latência de FMA. Blocos maiores aumentam a reutilização de dados e expõem mais trabalho independente, mas também aumentam a pressão sobre os registradores e o risco de spill para a memória.
A maioria das cargas de trabalho de produção é executada com um k relativamente pequeno, por isso otimizamos o top-k em streaming para esse caso. O estado de seleção por consulta permanece dentro do operador fundido, cada bloco de pontuação é mesclado nas seleções enquanto ainda está no cache, e a matriz completa de 𝑛𝑞 × 𝑛𝑏 nunca chega à DRAM. Assim que uma consulta contém k entradas, sua pior pontuação se torna o limite de admissão, permitindo que a mesclagem rejeite múltiplas pontuações por comparação vetorizada. Apenas as linhas sobreviventes são reunidas para a saída. Quando k é grande o suficiente para que esse estado gere pressão de memória, o operador executa o GEMM em blocos sozinho e entrega os blocos pontuados para a parcial max_by / min_by existente. Sob esse fallback, emitir uma pontuação 𝑓𝑝32 por par custa 4 𝑏𝑦𝑡𝑒𝑠 contra 2𝑑 𝐹𝐿𝑂𝑃𝑠, portanto 𝐴𝐼 = 𝑑/2 — ainda muito além da crista para qualquer dimensão realista.
O índice de vetores
Tudo até agora acelera a busca exaustiva de KNN (k-nearest-neighbor); nada disso muda o fato de que a busca exaustiva é de 0(𝑛𝑞 × 𝑛𝑏) — um milhão de consultas contra um bilhão de linhas resulta em 1015 produtos escalares, e nenhum bloco de registradores amortece um expoente. É para isso que servem o APPROX e o índice de vetores.
O índice é um design clássico de IVF (inverted file). A indexação treina o k-means sobre uma amostra do corpus para produzir um conjunto de centroides. Cada linha de base é atribuída ao seu centroide mais próximo e, no momento da consulta, cada consulta pontua apenas os vetores em seus clusters mais próximos. A poda (pruning) se acumula com 𝑛𝑏: na escala de bilhões, uma consulta examina ≤ 0,1% do corpus, ordens de magnitude a menos de trabalho de distância do que a força bruta. Escolhemos o IVF em vez de índices de grafos porque as varreduras independentes de clusters são paralelizadas entre os executores e o layout fica naturalmente no armazenamento colunar, enquanto a travessia de grafos é uma cadeia de buscas seriais.
Fisicamente, o índice é uma tabela Delta comum. As linhas de atribuição carregam o vetor ao lado de seu ID de centroide, e a tabela é configurada com clustering líquido pelo ID de centroide. Os candidatos de cada cluster ficam contíguos no armazenamento de blobs, e os arquivos cujos clusters não foram examinados por nenhuma consulta são podados antes de serem lidos. A atualização é transacional e incremental.
Uma consulta APPROX é reescrita nas mesmas primitivas: examinar os centroides com a mesma junção NEAREST BY top-k, fazer uma equi-junção no ID do centroide para restringir cada consulta aos seus clusters examinados, pontuar e aplicar o top-k, e depois mesclar. Os arquivos adicionados desde a última atualização passam por força bruta em uma ramificação de compensação e são unificados na mesma mesclagem, de modo que um índice desatualizado realiza menos podas, mas nunca degrada a qualidade da busca.
A execução da consulta é moldada pelas cardinalidades da consulta e da base.
| Cenário | Estratégia de junção | Principais características |
|---|---|---|
| Tabela de índice pequena, tabela de consulta pequena | BNLJ, broadcast do índice | Tudo na memória |
| Tabela de índice pequena, tabela de consulta grande | BNLJ, broadcast do índice | As consultas permanecem particionadas e em streaming, broadcast do índice para todas |
| Tabela de índice grande, tabela de consulta pequena | BNLJ, broadcast das consultas | As partições do índice são transmitidas por streaming, broadcast das consultas examinadas |
| Tabela de índice grande, tabela de consulta grande | Equi-junção por ID de centroide, com shuffle in-place para o índice | Faz o shuffle das consultas examinadas por ID de centroide; aproveita o clustering líquido do índice para evitar um shuffle completo do índice |
O caso grande-grande é onde o clustering líquido traz o maior retorno: apenas o lado da consulta se move; cada consulta examinada passa por um shuffle para as partições de seus clusters, enquanto o lado do índice varre diretamente os arquivos em busca dos IDs de centroide correspondentes. Cada partição examina exatamente os candidatos de seus próprios clusters.
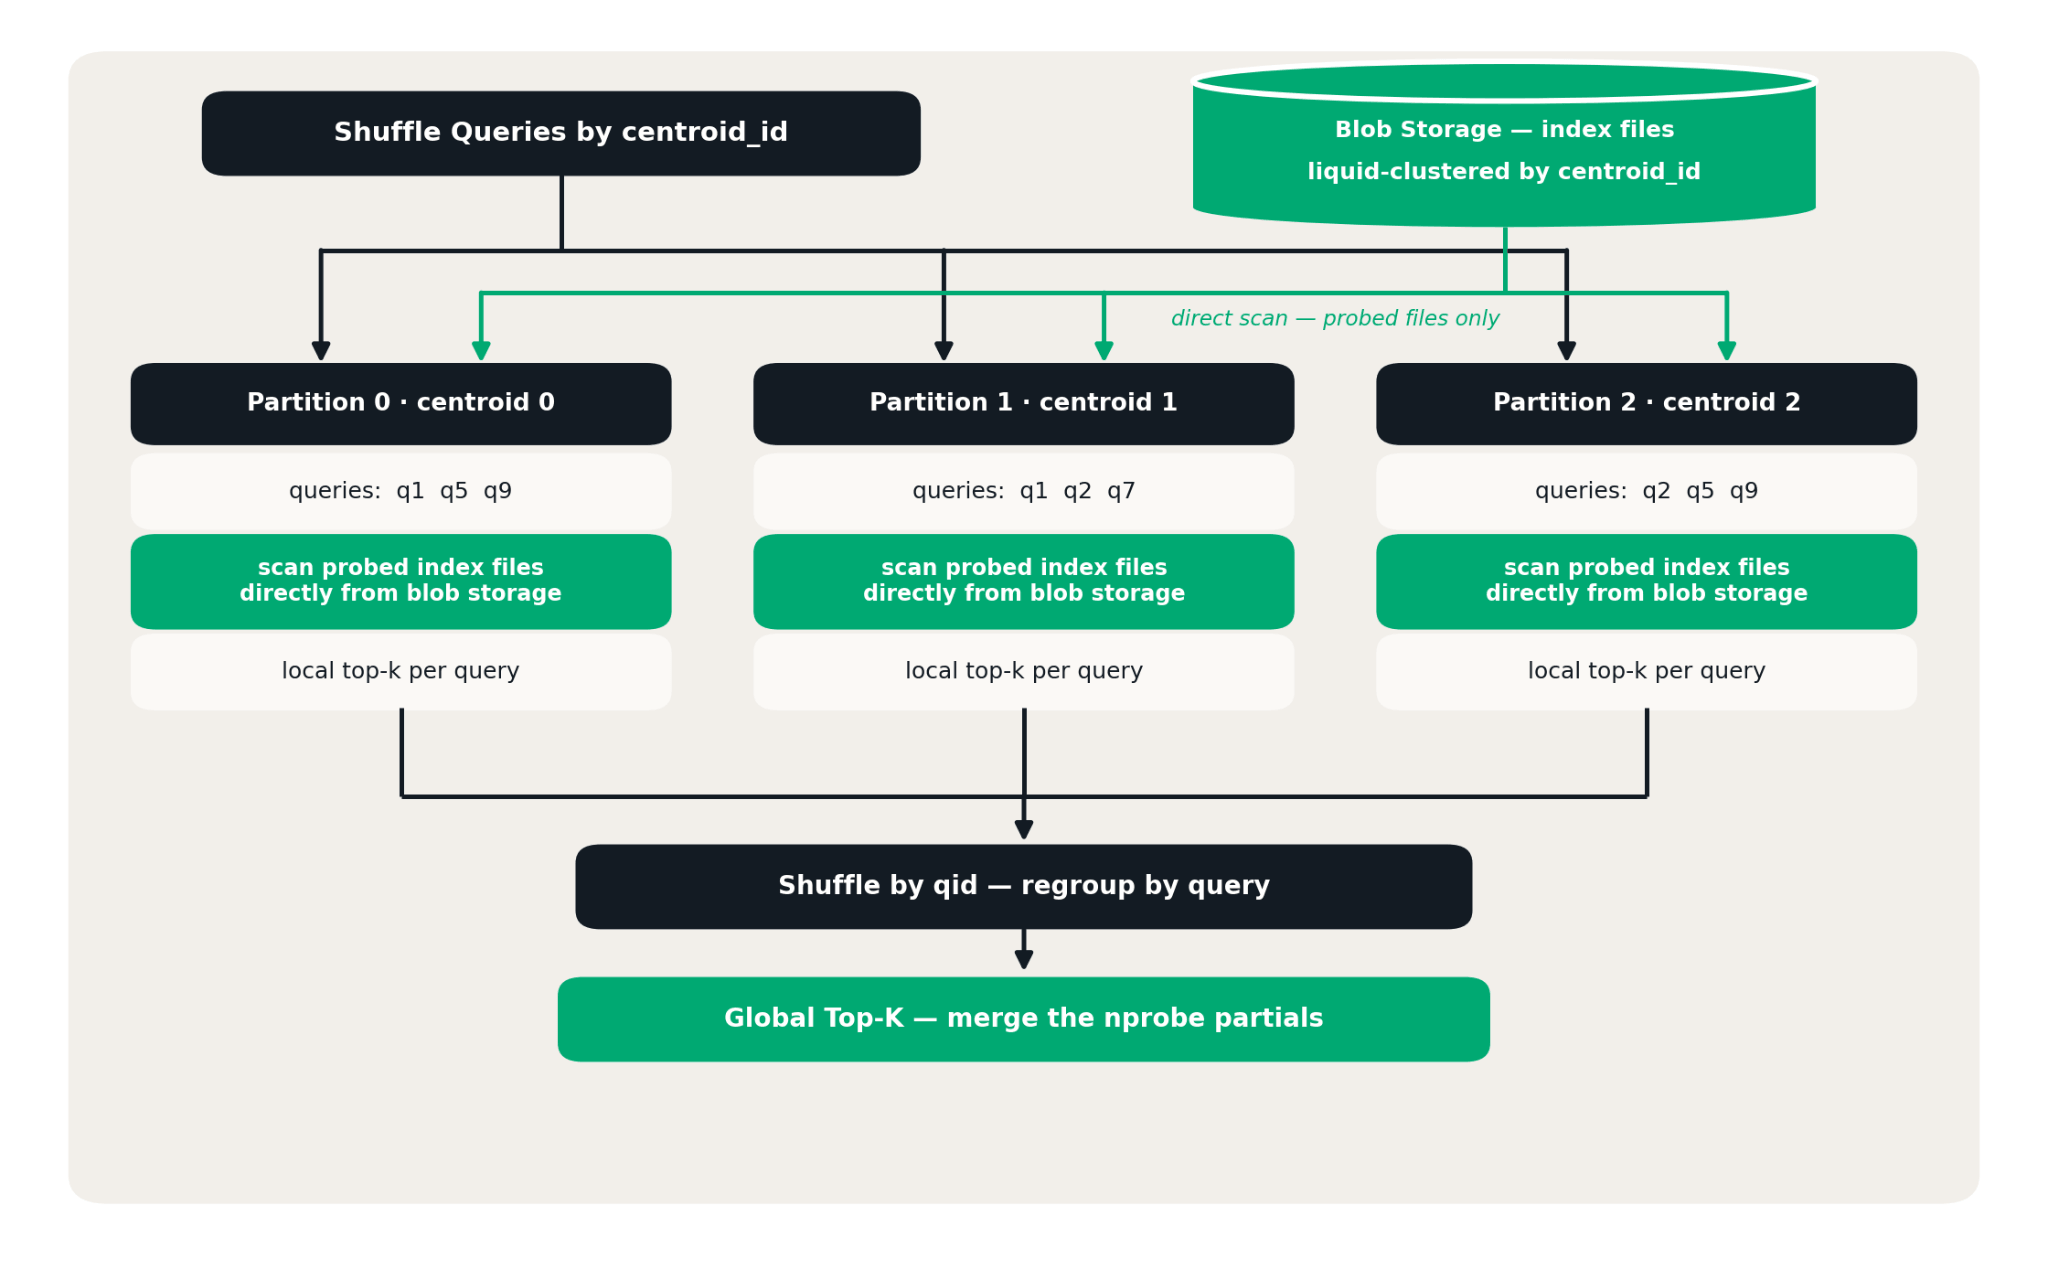
Dentro de uma partição, os candidatos de cada cluster chegam como um bloco contíguo denso, de modo que o mesmo kernel GEMM se aplica. O caminho exato o executa uma vez globalmente; o caminho aproximado o executa uma vez por cluster. Top-k local por consulta, reagrupamento, mesclagem das parciais: o contrato de parcial/mesclagem do agregado fazendo exatamente aquilo para o qual foi projetado.
O resultado
Avaliamos o NEAREST BY em cargas de trabalho canônicas observadas em clientes, com tabelas de base variando de 100.000 a 5 bilhões de vetores e lotes de consulta de até 10 milhões de vetores, visando pelo menos 96% de recall@K. Usando ANN indexado:
- Deduplicação semântica: Uma autojunção de uma tabela de 10 milhões de registros foi concluída em minutos, recuperando correspondências candidatas para detecção de duplicatas.
- Classificação e marcação: A busca de 10 milhões de consultas contra 100.000 vetores de referência levou menos de um minuto, apoiando a classificação por meio de exemplos rotulados semelhantes.
- Atualizações de recomendação: Um lote de 1 milhão de consultas contra 10 milhões de vetores de catálogo gerou candidatos a recomendação em minutos.
- Resolução e enriquecimento de entidades: A busca de 1 milhão de consultas contra 1 bilhão de vetores de referência foi concluída em minutos, fornecendo correspondências candidatas para vincular registros e recuperar contexto adicional.
Conclusão
A busca vetorial em lote não precisava de um novo sistema — ela precisava se tornar um cidadão de primeira classe daquele que já contém os dados. O NEAREST BY expressa a carga de trabalho como o que ela estruturalmente é: uma junção de classificação top-k. O modelo roofline explica por que o plano ingênuo é limitado pela memória e o que qualquer kernel mais rápido deve fazer a respeito. O operador fundido e seu GEMM em blocos transformam essa análise em intensidade aritmética, e o índice vetorial a dimensiona ainda mais, mantendo-se como uma tabela Delta comum com clusterização líquida. Os novos mecanismos são deliberadamente projetados para serem simples, estreitos, mas profundos e eficazes: uma cláusula de junção, sete funções vetoriais, uma sobrecarga de agregação, um operador fundido e uma decisão de layout de armazenamento. Todo o resto, de shuffles e spills a governança e escalonamento automático, veio com o mecanismo de runtime, desenvolvido e aprimorado ao longo de mais de uma década.
Se criar sistemas de computação complexos para cargas de trabalho de AI/ML em grande escala na Databricks parece interessante para você, venha construir conosco!
Baixe agora Experimente o NEAREST BY — leia a documentação
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
AI Engineering, Data Engineering, AI Search e Real-Time & Streaming Data
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.