O PostgreSQL 19 está disponível no Lakebase
Experimente os novos recursos: REPACK, orientação de planos de consulta, WAIT FOR LSN e muito mais
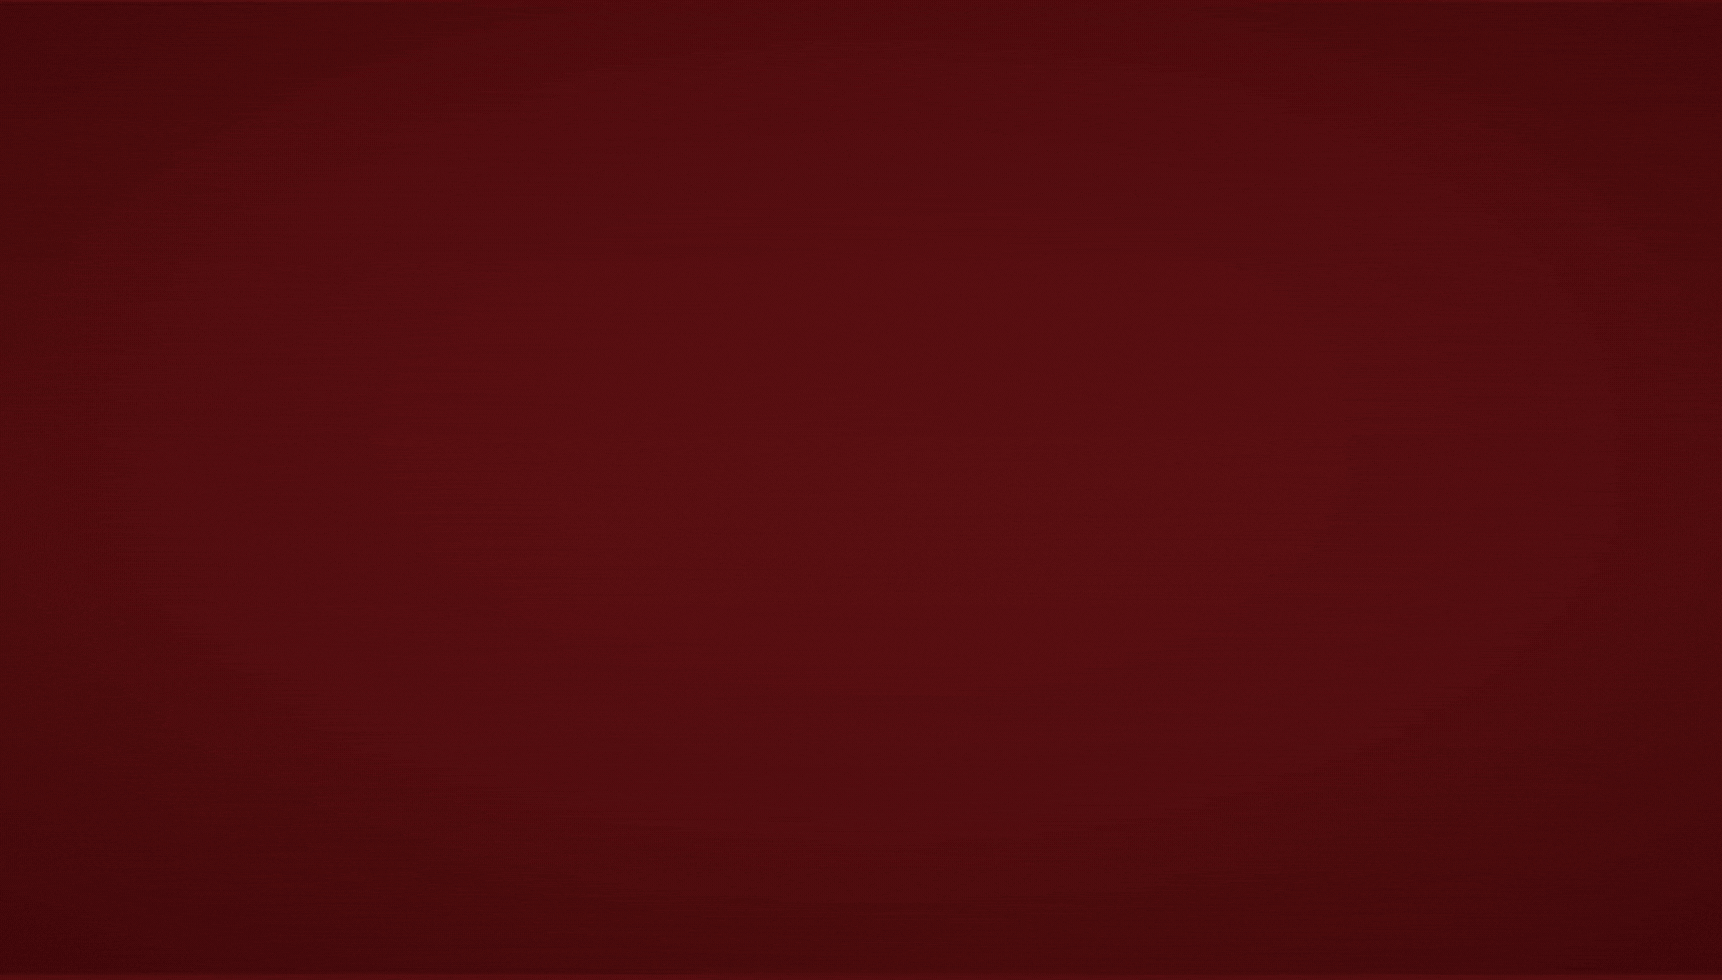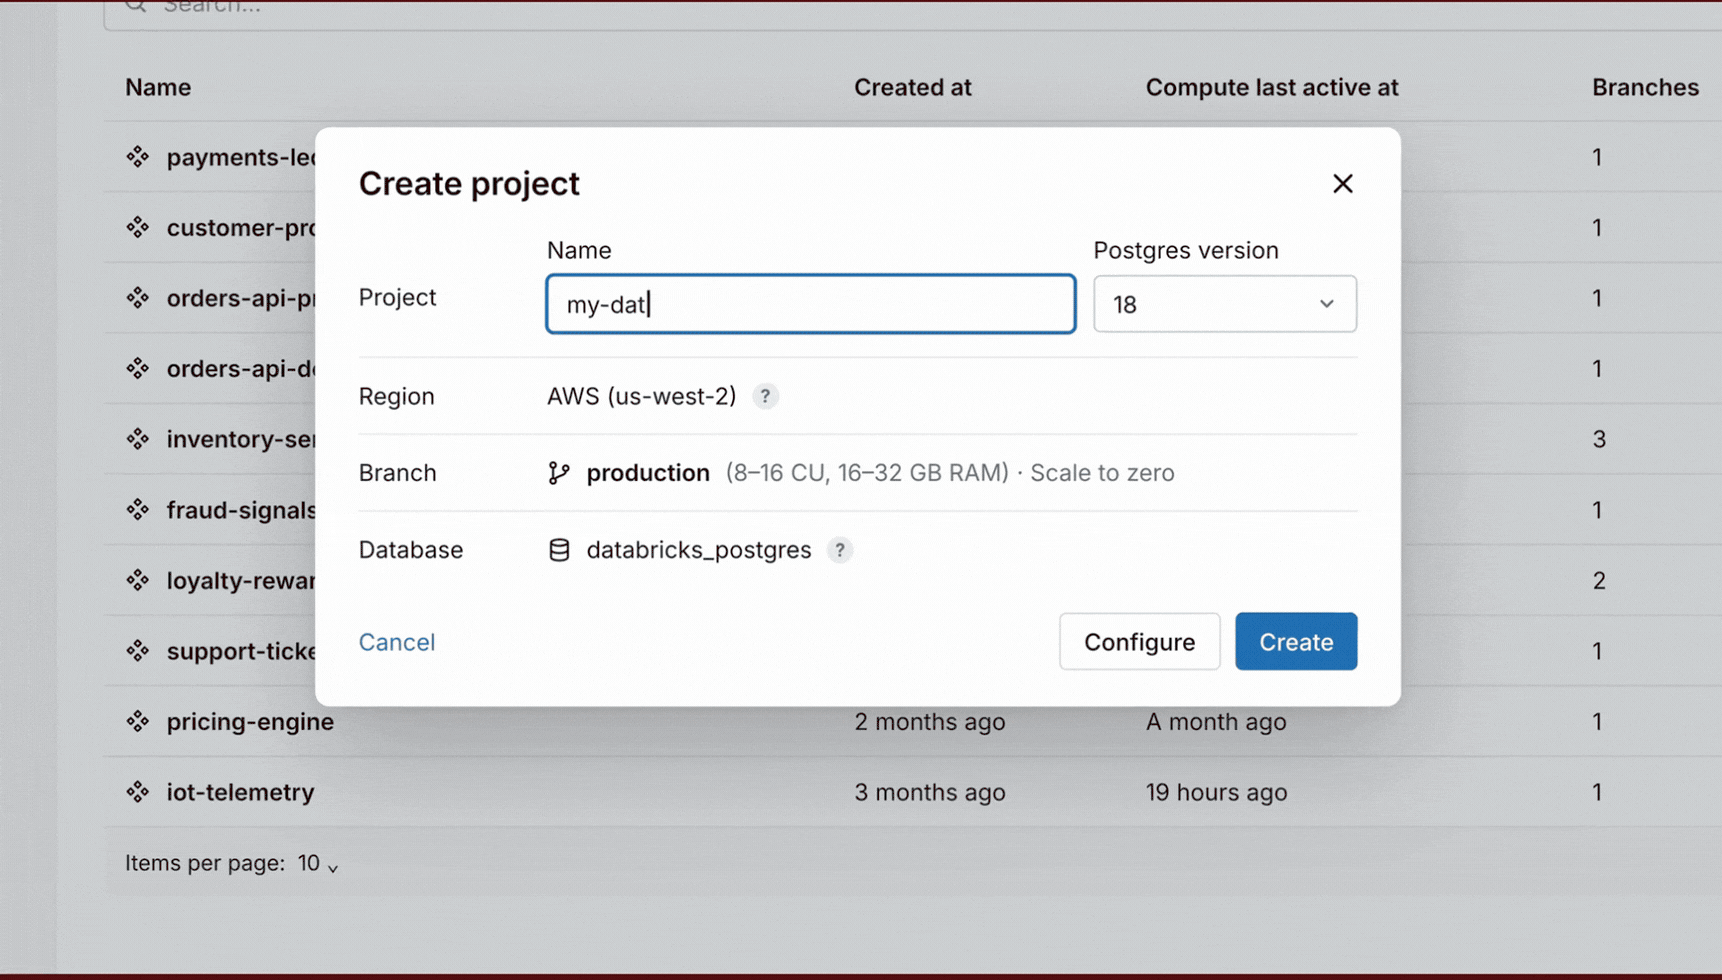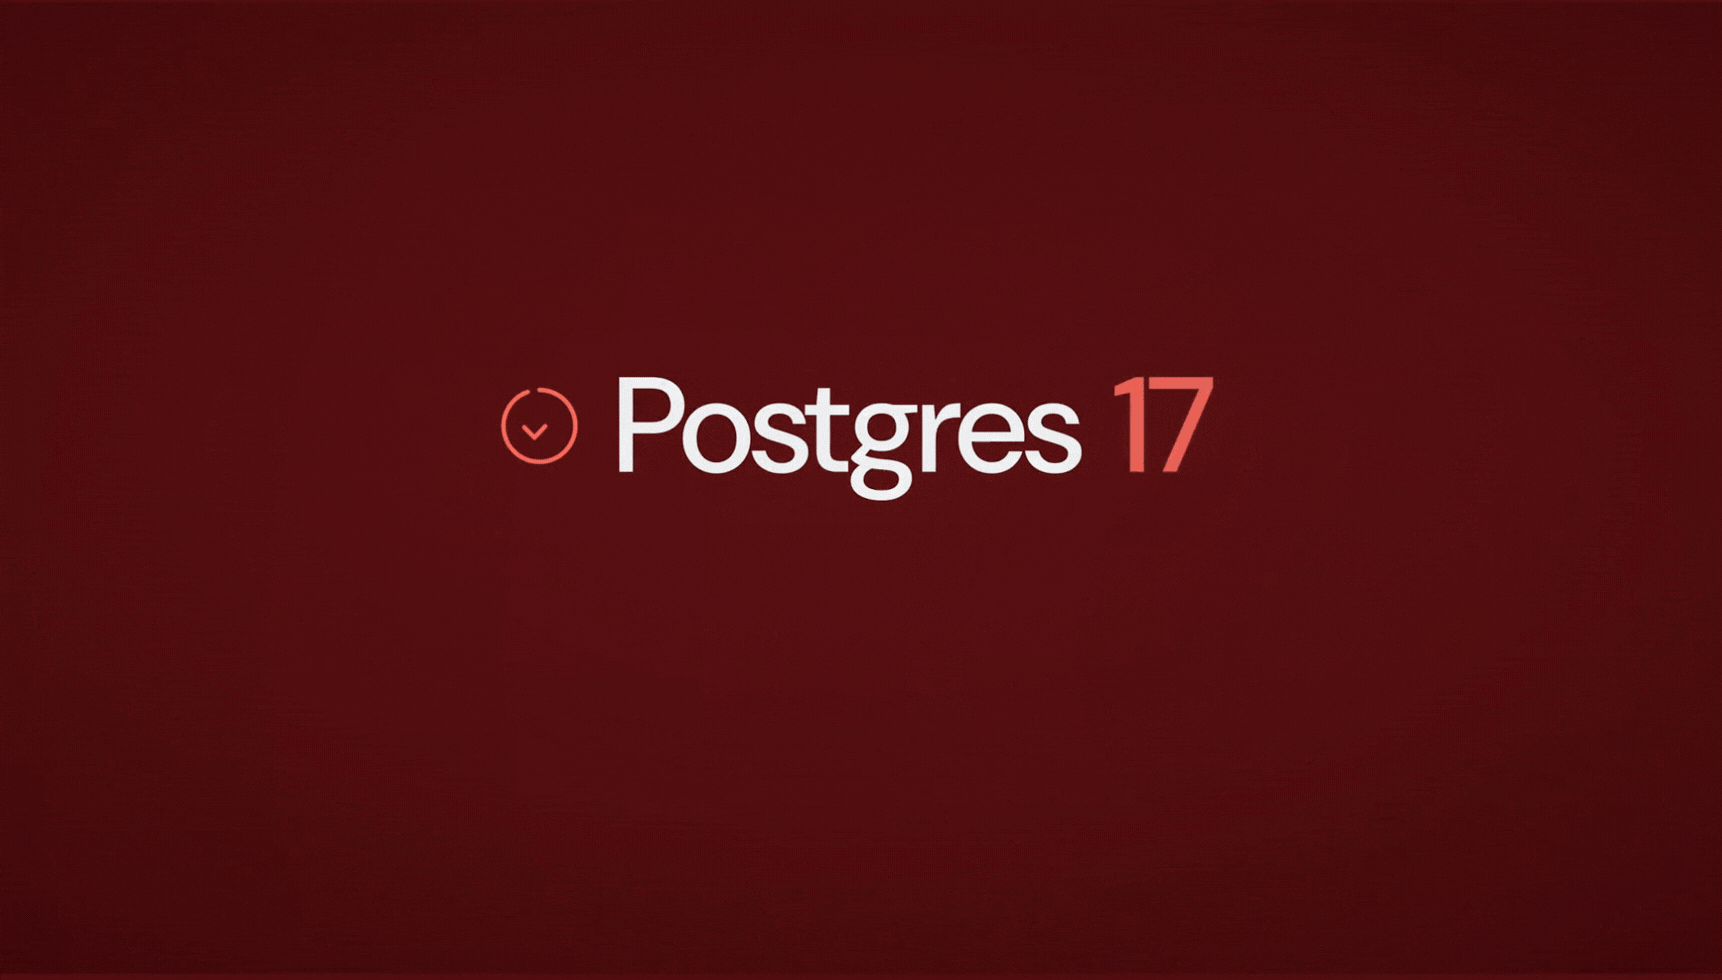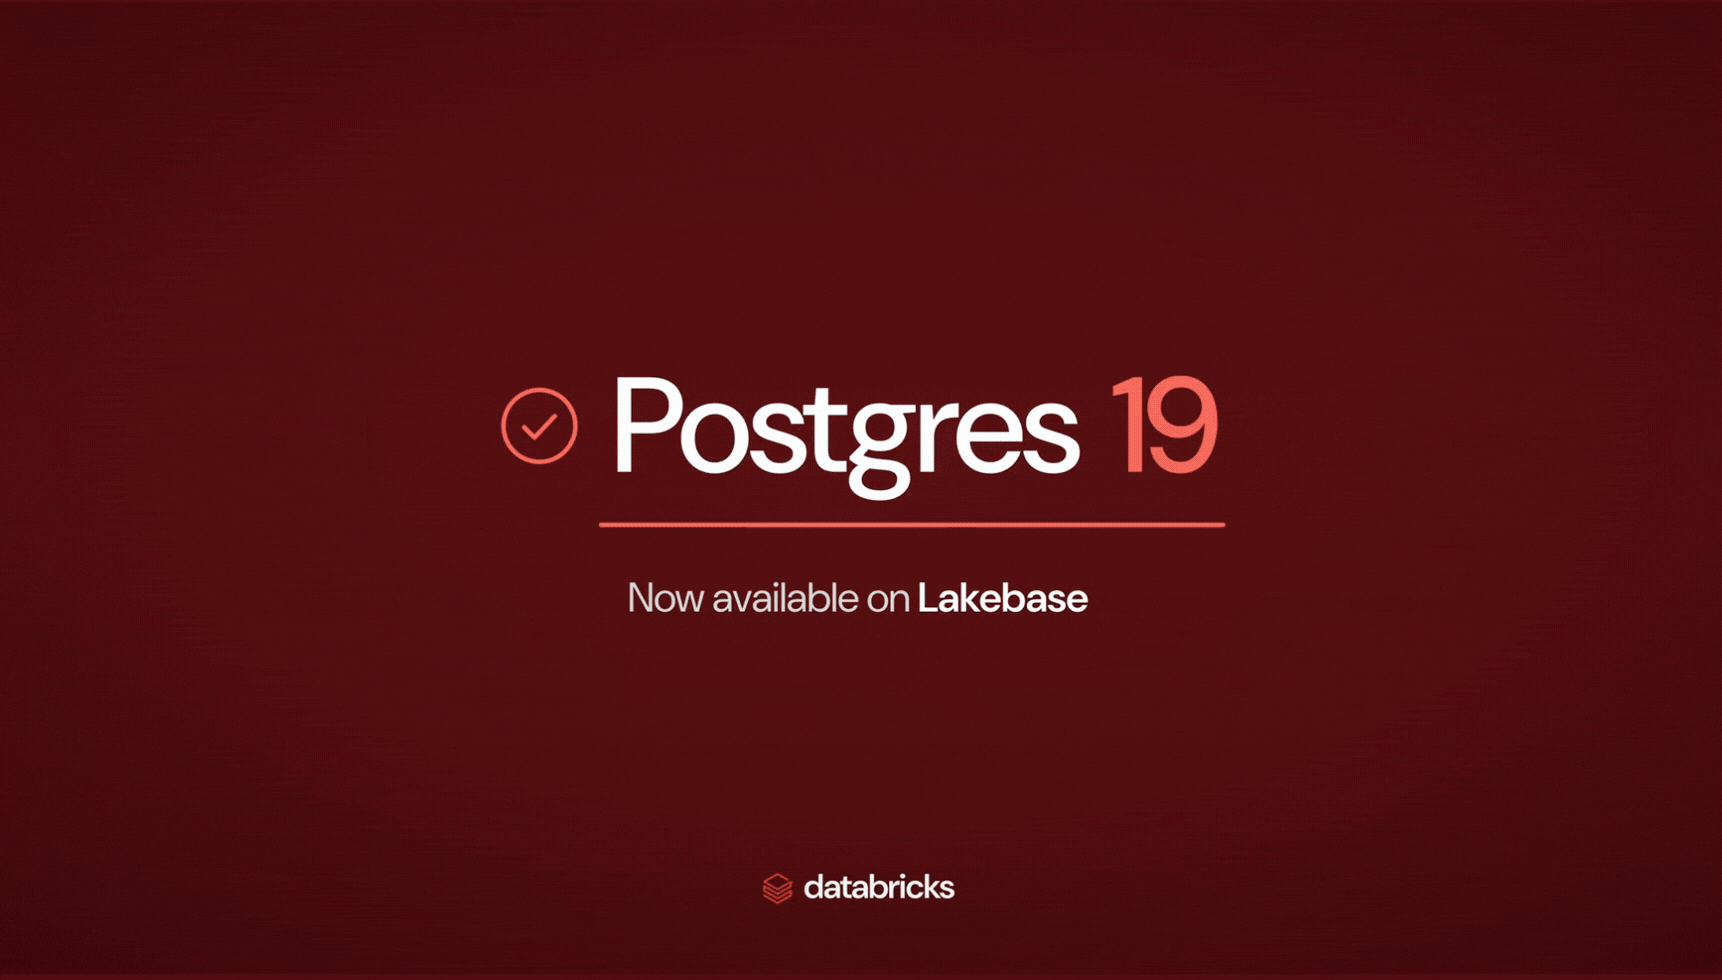
- O PostgreSQL 19 está disponível no Lakebase no mesmo dia em que a comunidade o lançou. Para testá-lo, crie um novo projeto no Lakebase e selecione o PostgreSQL 19.
- Esta versão do PostgreSQL foca no controle operacional. O REPACK recupera espaço enquanto as leituras e gravações continuam, a orientação de planos de consulta permite estabilizar planos que dão errado, e o WAIT FOR LSN oferece leitura das próprias gravações em réplicas. A replicação lógica também recebe várias melhorias.
- Vários engenheiros do Lakebase são committers e colaboradores do PostgreSQL que trabalharam nesta versão, desde a orientação de planos de consulta até memória compartilhada e gerenciamento de lançamentos.
O PostgreSQL 19 foi lançado hoje com disponibilidade geral (GA) e já está disponível no Lakebase. Novas versões principais costumam levar semanas para chegar a outros serviços gerenciados de PostgreSQL. Em vez disso, quisemos dar acesso a ela aos nossos clientes no mesmo dia.
Vários engenheiros da equipe do Lakebase são committeres e contribuidores do PostgreSQL, e eles trabalharam diretamente nesta versão, desde recomendações de planos de consulta até memória compartilhada, gerenciamento de localidade e gerenciamento de lançamentos. Para testá-lo, crie um novo projeto no Lakebase e selecione o PostgreSQL 19 como versão.
O que há de novo no PostgreSQL 19
O PostgreSQL 19 é uma versão prática. Não há um único recurso principal que mude o que o PostgreSQL é. Em vez disso, a versão 19 aborda problemas operacionais que as equipes de banco de dados conhecem bem: tabelas inchadas, planos de consulta instáveis, atraso de réplica, estatísticas incompletas e trabalhos de manutenção difíceis de executar com segurança em produção.
O ponto em comum é o controle. O PostgreSQL 19 oferece mais maneiras de intervir quando os padrões não são suficientes, sem abrir mão da propensão do projeto à confiabilidade e ao comportamento previsível.
A lista completa de alterações está nas notas de lançamento do PostgreSQL 19.
REPACK
O PostgreSQL usa controle de concorrência multiversão, portanto, uma UPDATE cria uma nova versão de linha e uma DELETE deixa uma tupla morta para trás. A limpeza de rotina torna esse espaço reutilizável, mas não necessariamente devolve espaço ao sistema operacional nem restaura uma ordem física de linhas útil. Com o tempo, tabelas com muitas atualizações podem ficar inchadas e mal clusterizadas.
As soluções habituais têm sido VACUUM FULL, CLUSTER ou ferramentas externas como pg_repack. Os comandos integrados funcionam, mas exigem um bloqueio ACCESS EXCLUSIVE para toda a operação, bloqueando o acesso normal à tabela.
O PostgreSQL 19 adiciona REPACK, que recupera espaço enquanto as leituras e gravações normais continuam durante a maior parte da operação. Por exemplo, um aplicativo de chat pode reconstruir sua tabela messages enquanto clusteriza linhas por conversa e horário de envio usando um índice existente:
REPACK recupera espaço como VACUUM FULL; com USING INDEX, ele também ordena fisicamente as linhas como CLUSTER. Com CONCURRENTLY, o PostgreSQL reconstrói a tabela enquanto as leituras e gravações normais continuam, capturando alterações contínuas por meio de decodificação lógica. Em seguida, ele adquire um bloqueio ACCESS EXCLUSIVE para aplicar quaisquer alterações capturadas restantes e trocar os arquivos da nova tabela e do índice de lugar. Esta fase costuma ser breve, mas pode demorar mais em uma tabela movimentada.
Existem restrições operacionais. O reempacotamento concorrente cria um slot de replicação adicional durante a operação, portanto, ele precisa de capacidade livre sob max_repack_replication_slots e uma tabela com uma chave primária não adiável ou uma identidade de réplica baseada em índice adequada. Ele também precisa de espaço em disco temporário para uma cópia da tabela e de todos os seus índices, possivelmente mais um arquivo de ordenação de tamanho equivalente ao da tabela. Tabelas com tráfego intenso de atualizações e exclusões enfrentam um limite adicional: a implementação upstream atual do PostgreSQL 19 falha se mais de cerca de 104 milhões de tuplas na tabela de destino forem atualizadas ou excluídas enquanto o REPACK (CONCURRENTLY) estiver em execução. Isso conta as alterações feitas durante o reempacotamento, não as linhas já presentes na tabela.
Nem todo tipo de relação é elegível. Transações de longa duração podem atrasar o bloqueio final. O reempacotamento concorrente também não é seguro para MVCC: após a confirmação, transações que usam instantâneos tirados antes do início do reempacotamento podem ver a tabela como vazia. A clusterização física também se degrada à medida que gravações posteriores chegam.
REPACK CONCURRENTLY ainda precisa de planejamento, mas traz para o núcleo uma tarefa que antes exigia mais tempo de inatividade ou uma extensão.
Recomendações de plano de consulta
O otimizador baseado em custos do PostgreSQL usa estatísticas de tabela e estimativas de custo para escolher um plano de execução. Na maior parte do tempo, isso funciona bem.
As estatísticas descrevem bem tabelas individuais, mas conjuntos de dados reais costumam conter relações que são mais difíceis de capturar. Imagine que clientes corporativos representem 0,1% dos clientes, mas gerem 30% dos pedidos. Estatísticas por tabela não conseguem capturar essa correlação entre tabelas.
Com um índice em orders.customer_id, o planejador pode estimar que cada cliente corporativo tem apenas alguns pedidos e escolher um loop aninhado que sonda o índice repetidamente. Se esses clientes realmente representarem 30% dos pedidos, cada busca retornará muito mais linhas do que o esperado, e uma junção hash pode ser mais apropriada.
O PostgreSQL 19 adiciona pg_plan_advice e pg_stash_advice para essas situações:
pg_plan_advicedescreve as decisões do planejador como recomendações, aplica as recomendações fornecidas e relata se elas foram seguidas.pg_stash_advicearmazena recomendações por ID de consulta e as aplica automaticamente quando uma consulta correspondente é planejada
Esses componentes não adicionam estatísticas entre tabelas nem substituem o planejador. Em vez disso, eles permitem que você intervir quando uma estimativa imprecisa produz um plano ruim.
Considere uma consulta que conta os pedidos de clientes corporativos:
Aqui, c é o alias para a tabela de clientes filtrados. A seguinte recomendação pede ao PostgreSQL para colocar esses clientes no lado interno de uma junção hash:
Quando o PostgreSQL consegue aplicar a recomendação, EXPLAIN relata um feedback semelhante a:
matched significa que o plano resultante está em conformidade com a recomendação. Isso não significa que o novo plano seja necessariamente melhor; você ainda precisa avaliá-lo em relação à carga de trabalho real.
Ao contrário das dicas de otimizador embutidas, as recomendações de plano ficam fora do texto da consulta do aplicativo. Você pode inspecionar o plano atual, testar recomendações focadas e, em seguida, armazená-las por ID de consulta.
pg_stash_advice é o componente que aplica as recomendações armazenadas automaticamente. Crie a extensão em cada banco de dados antes de usar suas funções de gerenciamento de armazenamento:
Crie um armazenamento e associe a recomendação testada ao ID de consulta relatado por EXPLAIN (VERBOSE). Substitua <query_id> pelo identificador do seu plano:
Configure o banco de dados para usar o armazenamento para novas conexões:
Substitua appdb pelo nome do seu banco de dados.
Trate as recomendações de plano como um estabilizador assim que diagnosticar o problema. As distribuições de dados mudam, instruções preparadas em cache podem continuar usando um plano mais antigo por um tempo, e o otimizador ainda acerta mais frequentemente do que erra.
Quando o planejador altera inesperadamente uma consulta crítica para um plano pior, o PostgreSQL 19 oferece uma forma compatível para estabilizá-la.
Autovacuum paralelo e novas visualizações de estatísticas
O Autovacuum agora pode usar workers paralelos ao executar o vacuum em índices, controlado por autovacuum_max_parallel_workers. Um novo sistema de pontuação prioriza as tabelas elegíveis com base na urgência com que precisam de vacuum ou análise.
Novas visualizações de estatísticas revelam mais sobre o que o servidor está fazendo:
pg_stat_lockrelata estatísticas por tipo de bloqueio.pg_stat_recoverymostra o status de recuperação.pg_stat_autovacuum_scoresmostra como o autovacuum prioriza as tabelas.
O diagnóstico ao nível de consulta também melhora. EXPLAIN (ANALYZE, IO) relata a atividade de I/O assíncrono e auto_explain.log_io pode incluir a mesma informação nos planos registrados em log.
O PostgreSQL 19 também relata os bytes gravados para imagens de página inteira em pg_stat_wal, EXPLAIN (ANALYZE, WAL), além dos logs de vacuum e analyze.
Juntas, essas melhorias tornam a investigação de desempenho menos dependente de inferências. Você pode ver o motivo da priorização do trabalho de manutenção, onde o I/O assíncrono ocorreu e quantos bytes de WAL vieram de imagens de página inteira.
Replicação lógica
A replicação lógica tornou-se uma infraestrutura essencial para captura de dados de alteração (CDC), migrações, atendimento em tempo real e pipelines ETL. O PostgreSQL 19 fecha várias lacunas antigas:
- A decodificação lógica pode ser ativada sem necessidade de reinicialização quando
wal_levelestiverreplica. A criação do primeiro slot de replicação lógica válido elevaeffective_wal_levelparalogical, mostrando o nível de WAL atualmente em vigor. - Os valores de sequência podem ser sincronizados de publicadores para assinantes.
- As publicações podem incluir todas as sequências com
FOR ALL SEQUENCES. CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...)publica todas as tabelas, exceto um conjunto especificado.- As assinaturas podem reutilizar detalhes de conexão de um servidor
postgres_fdwcomCREATE SUBSCRIPTION ... SERVER. - A opção de assinatura
retain_dead_tuplespreserva informações suficientes paradetect update_deletedconflitos, nos quais uma atualização replicada tem como alvo uma linha excluída por outra origem. A detecção também requertrack_commit_timestampno assinante, epg_stat_subscription_statsconta esses conflitos.
A sincronização de sequências elimina um caso limite incômodo de migração, especialmente durante atualizações de versão principal que usam replicação lógica. Copiar linhas de tabela sem avançar suas sequências pode fazer com que um assinante promovido gere valores que já existem, causando erros de chave duplicada.
O PostgreSQL copia os valores iniciais da sequência quando a assinatura é criada com copy_data = true, que é o padrão. Alterações posteriores na sequência não são transmitidas continuamente, portanto, atualize-as imediatamente antes da transição:
Isso atualiza as sequências já conhecidas pela assinatura para os valores atuais delas no publicador. Se a publicação ganhou novas sequências, use ALTER SUBSCRIPTION ... REFRESH PUBLICATION para adicioná-las e sincronizar seus valores antes da transição.
WAIT FOR LSN
As réplicas de leitura assíncronas aumentam a capacidade de leitura sem fazer com que os commits principais precisem esperar por elas. A desvantagem é o atraso de replicação. Um aplicativo pode confirmar uma gravação na primária, ler imediatamente de uma réplica e não encontrar a linha porque a réplica ainda não reproduziu o WAL relevante.
O PostgreSQL 19 adiciona uma maneira direta de coordenar essa entrega. Um LSN identifica uma posição no WAL do PostgreSQL e WAIT FOR LSN bloqueia a instância de espera (standby) até que a reprodução alcance pelo menos a posição solicitada:
Por padrão, WAIT FOR LSN aguarda indefinidamente a instância de espera reproduzir o LSN solicitado. Outros modos podem aguardar a gravação ou o despejo (flush) do WAL, e você pode definir um tempo limite (timeout).
O cliente ou o connection pooler ainda precisa carregar o LSN da primária para a réplica. O banco de dados agora fornece a etapa de sincronização ausente, de modo que o comportamento de leitura de suas próprias gravações (read-your-writes) não precisa mais de polling ou pausas arbitrárias.
ON CONFLICT DO SELECT
INSERT ... ON CONFLICT DO SELECT oferece um padrão limpo de obtenção ou criação (get-or-create) que retorna tanto linhas existentes quanto recém-inseridas:
Ele substitui a solução alternativa DO UPDATE SET col = EXCLUDED.col, que realiza uma atualização mesmo que nenhum valor seja alterado. Isso cria uma nova versão de linha e deixa uma tupla morta em cada conflito.
Saída JSON para COPY TO
COPY TO agora pode emitir JSON diretamente. Por padrão, ele grava um objeto por linha, enquanto FORCE_ARRAY envolve a saída em um único array JSON:
O novo formato JSON é apenas para exportação, portanto COPY FROM não o aceita.
SQL menor e alterações de desempenho
Por fim, algumas alterações compactas que trazem melhorias na qualidade de vida:
- As expressões de caminho JSON ganham métodos de string conhecidos, como
btrim(),lower(),replace()esplit_part(). - A família
random(min, max)agora oferece suporte adate,timestampetimestamptz, o que ajuda em testes e conjuntos de dados sintéticos. - Cinco funções de janela aceitam
IGNORE NULLSeRESPECT NULLS. - Quando
io_method = worker, os workers de I/O são dimensionados automaticamente entreio_min_workerseio_max_workers. As verificações de chave estrangeira estão mais rápidas, e o planejador e o executor recebem outra rodada de otimizações direcionadas.
Também removemos alguns recursos
Vários recursos importantes chegaram durante o desenvolvimento do PostgreSQL 19, mas foram removidos antes do lançamento. Os revisores encontraram problemas de correção ou de design que eram arriscados demais para serem resolvidos tarde no ciclo, então a comunidade reteve os recursos para um lançamento futuro.
Alguns dos recursos que acabaram não sendo lançados na versão 19:
SQL/PGQconsultas de grafo de propriedades.CREATE PROPERTY GRAPHeGRAPH_TABLEtrouxeram correspondência de padrões de grafos sobre tabelas regulares para o SQL. Revertido em 7 de setembro de 2026.UPDATE and DELETE ... FOR PORTION OF.Atualizações e exclusões temporais que dividem linhas para preservar o histórico fora do intervalo de tempo direcionado. Revertido em 15 de setembro de 2026.ALTER TABLE ... MERGE PARTITIONSeSPLIT PARTITION. Comandos integrados para combinar ou dividir partições. Revertido em 27 de agosto de 2026.GROUP BY ALL. Atalho para agrupamento por cada expressão não agregada na lista de seleção.. Revertido em 17 de julho de 2026.- Formatos de saída não textuais para
pg_dumpall. Revertido em 18 de junho de 2026. - Funções de extração de DDL.
pg_get_role_ddl(),pg_get_tablespace_ddl()epg_get_database_ddl()foram Revertidas em 13 de setembro de 2026.
Obrigado aos contribuidores do PostgreSQL
O PostgreSQL é feito por seus contribuidores: obrigado às centenas de contribuidores da comunidade creditados nas notas de lançamento. Agradecimentos especiais aos engenheiros da equipe do Lakebase que trabalharam nesta versão do PostgreSQL:
- Robert Haas escreveu pg_plan_advice e pg_stash_advice (este último com Lukas Fittl)
- Heikki Linnakangas trabalhou em um novo mecanismo para registrar memória compartilhada, uma reformulação de como os subsistemas a alocam, correções do multixact e o novo padrão de 128 para max_locks_per_transaction
- Jeff Davis escreveu a alteração que permite ao CREATE SUBSCRIPTION reutilizar os detalhes de conexão de um servidor postgres_fdw e realizou um longo trabalho de localidade e manipulação de caracteres
- Jonathan Katz trabalhou no comunicado de imprensa do PostgreSQL 19 e gerenciou a coordenação do lançamento
- Matthias van de Meent trabalhou em vários commits, incluindo a alteração para rotinas de métodos de acesso a índices estáticos
- Alexander Lakhin encontrou e relatou vários bugs
Atualizando para o PostgreSQL 19
Como em qualquer nova versão principal do PostgreSQL, recomendamos uma abordagem moderada para sua adoção. Antes de mover cargas de trabalho de produção para 19.0, sugerimos que você:
- Teste suas próprias cargas de trabalho, consultas e extensões no PostgreSQL 19 primeiro em um ambiente de desenvolvimento ou homologação
- Compare o desempenho e o comportamento com a sua versão atual, já que as principais versões podem alterar planos de consulta e padrões
- Verifique se as extensões das quais você depende estão disponíveis no PostgreSQL 19 (veja abaixo).
- Mantenha a produção na sua versão atual até que esteja confortável com os resultados
O PostgreSQL 19 também altera vários padrões e comportamentos de compatibilidade. Verifique estes itens antes de atualizar:
- A compilação JIT está desativada por padrão
- A compactação TOAST usa LZ4 por padrão em vez de pglz
- A autenticação por senha MD5 emite avisos de descontinuação mais fortes
- O suporte à autenticação RADIUS foi removido
- standard_conforming_strings está sempre ativado
- O pg_upgrade rejeita clusters com índices btree_gist afetados em inet ou cidr
- Nomes de banco de dados, função e tablespace não podem mais conter retornos de carro ou quebras de linha
Uma nota sobre extensões
Abordamos a maioria das extensões suportadas em nossa versão do PostgreSQL 18, mas nem todas estão disponíveis no PostgreSQL 19 ainda. Estamos adicionando mais conforme elas ficam disponíveis pelos provedores de extensões. Se a sua carga de trabalho depende de uma extensão específica, confirme se ela está disponível no PostgreSQL 19 antes de planejar uma migração.
A comunidade normalmente lança sua primeira versão secundária alguns meses após uma versão principal, à medida que o uso no mundo real traz correções e melhorias. O PostgreSQL 19.1 é esperado para fevereiro, e muitas equipes planejam atualizações de produção em torno desse lançamento. Esse é um padrão comum e sensato para qualquer versão .0, e o mesmo se aplica aqui.
Independentemente do seu cronograma, estamos aqui para ajudar. Se quiser conversar sobre o planejamento de atualizações ou testes, entre em contato com a sua equipe de atendimento ou com o suporte da Databricks.
Experimente
O PostgreSQL 19 já está disponível no Lakebase. Crie um projeto do PostgreSQL 19 no seu workspace para testá-lo ou comece a usar o Lakebase se você for novo nisso.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.