RADAR: Detecte falhas cinzas com detecção de anomalias
Como a detecção de anomalias em tempo real captura interrupções parciais e silenciosas em minutos — e como criar o mesmo sistema na Databricks.
- Falhas cinzas passam despercebidas por painéis verdes, custando clientes e receita silenciosamente antes que alguém perceba.
- O RADAR é um padrão de quatro estágios agnóstico de métricas — métricas de confiabilidade, detecção de anomalias, alertas e análise de causa raiz — que a Databricks executa em si mesma para capturar essas falhas em minutos, com mais de 90% de precisão e descoberta 95% mais rápida.
- Você pode criar o mesmo sistema na Databricks para qualquer métrica — faturamento, conversão ou desempenho do modelo — usando componentes nativos e uma estrutura de agente de AI.
Algumas das interrupções mais prejudiciais são aquelas que o seu monitoramento nunca sinaliza: uma parcela dos seus clientes falha silenciosamente enquanto todas as verificações de integridade (health checks) ainda indicam normalidade. Essas "falhas cinzas" (gray failures) causam perda de usuários e receita por horas antes que alguém ligue os pontos. Este post é sobre como detectá-las precocemente com detecção de anomalias — como fazemos isso na Databricks com um sistema chamado RADAR, e como você pode criar a mesma solução para qualquer métrica que seja mais importante para o seu negócio. Ele foi escrito para os responsáveis pela confiabilidade do serviço: SREs, engenheiros de plataforma e de dados, equipes de plantão (on-call) e os líderes de engenharia a quem eles respondem.
Quando tudo está verde, mas nada está bem
Imagine uma quarta-feira normal. Manter a confiabilidade de um serviço voltado para o cliente é o seu trabalho, e todos os dashboards na sua tela estão verdes — CPU saudável, latência normal, servidores ativos, banco de dados conectado. De acordo com todos os sinais que sua equipe monitora, o sistema parece perfeito.
Mas não está.
- 9:30 — Um deploy de rotina introduz um bug sutil no seu fluxo de checkout.
- 9:35 — Um em cada vinte clientes que pagam com cartão de crédito falha silenciosamente. Após algumas tentativas, eles desistem e vão embora.
- 12:40 — O primeiro ticket de suporte chega. Parece apenas mais um número de cartão digitado incorretamente, então ninguém desconfia.
- 14:20 — Mais dois tickets chegam sobre o mesmo problema.
- 14:25 — O líder de suporte percebe o padrão e escala o problema.
- 16:00 — Os engenheiros localizam o bug e lançam uma correção.
Por quase sete horas, seu monitoramento insistiu que tudo estava bem enquanto os clientes iam embora e a receita caía.
O que é uma falha cinza?
Essa quarta-feira é um exemplo clássico de falha cinza. Na superfície, tudo parece saudável; por baixo, uma parte específica parou de funcionar silenciosamente — e isso prejudica os clientes sem nunca disparar um alerta.
Duas coisas tornam as falhas cinzas tão traiçoeiras:
- Elas são parciais. Não afetam a todos — apenas uma parcela, como um único tipo de cartão de crédito. Não há uma queda de servidor que você detectaria instantaneamente, apenas um meio-termo confuso onde a maioria dos usuários está bem e um grupo falha o tempo todo.
- Elas crescem. O que começa com um pequeno grupo de clientes afetados se espalha. Se não for resolvido, cada vez mais pessoas encontram o mesmo obstáculo.
Pense nisso como fumaça atrás da parede. Por fora, a casa parece bem, mas por dentro o estrago está se espalhando — e quanto mais você espera, maior é o raio de impacto. Os pesquisadores também têm um nome para o problema subjacente: o artigo da Microsoft Gray Failure: The Achilles’ Heel of Cloud-Scale Systems chama isso de observabilidade diferencial — seus detectores de falhas não percebem um problema, mesmo quando seus usuários claramente percebem.
Por que esperar por relatórios de clientes não funciona
A maioria das equipes lida com falhas cinzas exatamente como aconteceu naquela quarta-feira: elas esperam que os clientes as informem. Os relatórios dos clientes são importantes — representam uma frustração real —, mas seus clientes não deveriam ser o seu sistema de monitoramento. Depender apenas de relatórios traz três problemas:
- É manual. Alguém precisa notar a mesma reclamação em uma pilha de tickets. Isso é fácil de passar despercebido.
- É demorado. No momento em que pessoas suficientes reclamam para que alguém ligue os pontos, horas ou dias já se passaram.
- É silencioso. A maioria dos clientes afetados nunca abre um ticket. Eles simplesmente vão embora.
A solução não é parar de ler os tickets — continue fazendo isso. É adicionar uma detecção automática que funcione o tempo todo e capture o que as pessoas deixam passar. Concretamente, você quer algo que seja acionado no momento em que muito mais clientes do que o normal comecem a enfrentar o mesmo problema ao mesmo tempo.
| Apenas relatórios de clientes | Adicionar detecção automática |
|---|---|
| Manual — fácil de passar despercebido | Captura o que as pessoas deixam passar |
| Atrasado — percebido em dias | Rápido — percebido em tempo real |
| Clientes sofrem em silêncio | Sinaliza o pico — muitos usuários ao mesmo tempo |
Conheça o RADAR
Essa é da ideia por trás do RADAR — Reliability Anomaly Detection, Alerting, and Root-cause analysis. Nós o desenvolvemos na Databricks para detectar falhas cinzas em minutos, em vez de horas. O nome faz sentido: quando a visibilidade é baixa, você não espera até que algo o atinja — você busca por sinais fracos com antecedência.
Veja como o direcionamos para um sinal especialmente útil: erros do usuário.
Uma falha cinza geralmente aparece como um pico repentino de erros que parecem ser culpa do usuário. Imagine um grupo de usuários em uma região que de repente não consegue iniciar um determinado tipo de cluster. Cada solicitação falha com INVALID_ARGUMENT — um erro que diz educadamente: "a culpa é sua".
But quando muitos usuários encontram o mesmo erro de "culpa do usuário" no mesmo instante, deixa de ser culpa deles. É nossa. Esse pico é exatamente o padrão que o RADAR foi criado para capturar.
As quatro etapas do RADAR
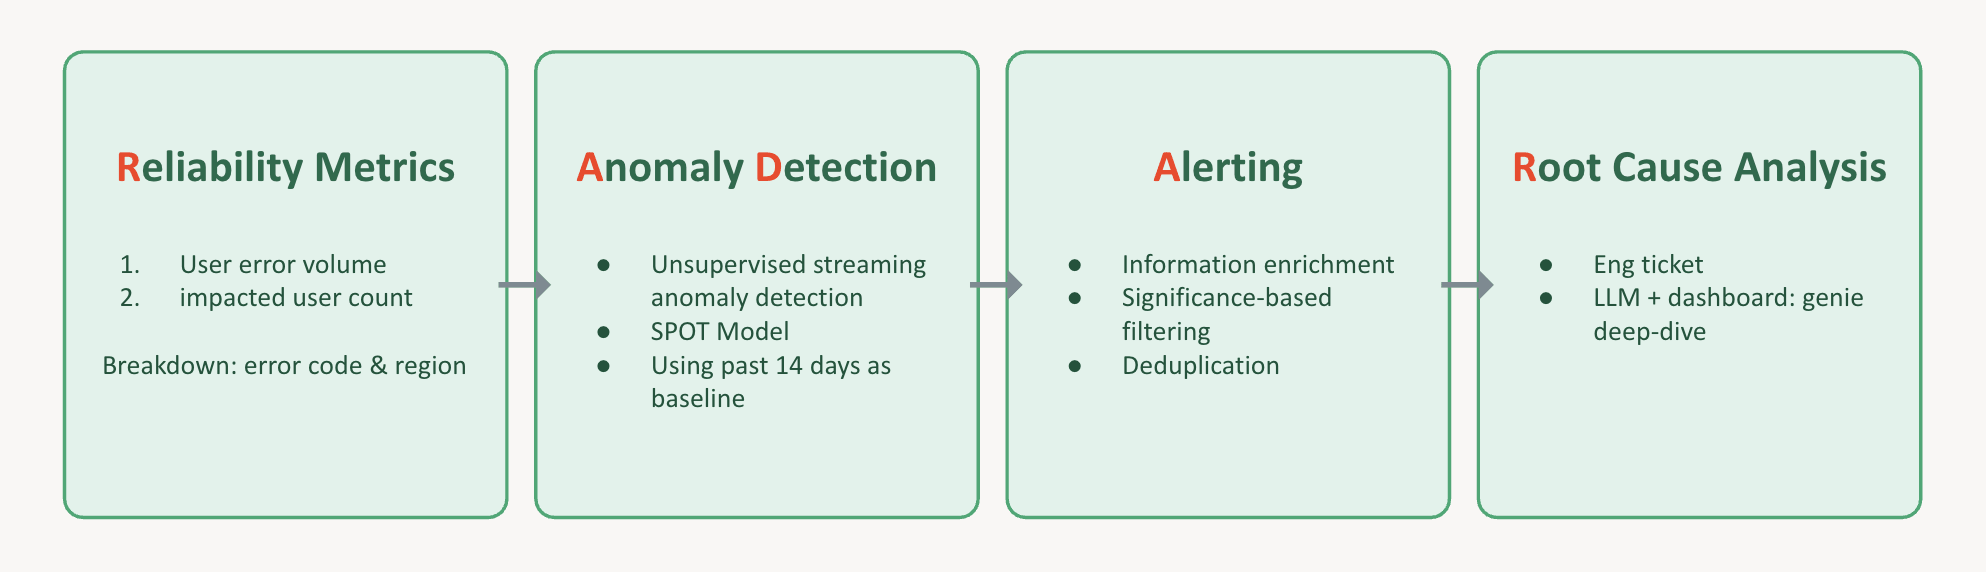
O RADAR transforma esse instinto em um pipeline com quatro etapas:
- Métricas de confiabilidade. Em cada momento, registre duas coisas: quantos erros estão ocorrendo e quantos usuários distintos foram afetados por cada um deles. Divida isso por código de erro e região. Agora você tem um conjunto rico de séries temporais que descrevem a integridade do seu serviço.
- Detecção de anomalias. Execute a detecção de anomalias em cada uma dessas séries para que o sistema sinalize qualquer coisa fora do comum — sem que você precise ajustar manualmente uma pilha de limites. Usamos um modelo de streaming não supervisionado chamado SPOT, que aprende o que é "normal" com base nos últimos 14 dias e precisa de apenas um único parâmetro de risco em vez de limites manuais. (O SPOT vem do artigo de Siffer et al., Anomaly Detection in Streams with Extreme Value Theory, KDD 2017.)
- Alertas. Quando algo é acionado, a camada de alertas assume o controle. Ela enriquece o alerta com contexto, filtra o que não é significativo e elimina duplicatas para que a equipe de plantão não seja soterrada por cópias do mesmo problema. Em seguida, ela abre um ticket direcionado para a equipe de engenharia correta para aquele erro.
- Análise de causa raiz. Cada ticket chega com detalhes aprofundados da anomalia e um link para um dashboard apoiado por um assistente de IA, o AI/BI Genie. Quem estiver de plantão pode ir direto para a identificação do que realmente quebrou, no menor tempo possível.
O que alcançamos
Executar o RADAR internamente mudou a forma desses incidentes. Antes, dependíamos dos tickets dos clientes para descobrir tais incidentes, o que gerava dias de atraso. Com o RADAR, alcançamos uma redução de 95% no tempo de descoberta de incidentes, com mais de 90% de precisão, sem a necessidade de intervenção humana para identificar o padrão. Como resultado, conseguimos manter o raio de impacto das falhas cinzas sob controle.
Direcione o RADAR para qualquer métrica
Aqui está a parte mais importante para você: o RADAR não se importa com qual é a métrica. Nós o direcionamos para erros de usuários, mas o mesmo padrão funciona em qualquer lugar onde um número possa dar errado silenciosamente:
- Serviços financeiros — falhas de pagamento e transação, anomalias de faturamento, sinais de fraude
- Varejo e e-commerce — conversão de checkout, erros no carrinho, tempos de entrega
- Saúde e ciências da vida — fluxo de pacientes, processamento de sinistros
- Qualquer produto de IA — desempenho do modelo e desvio de distribuição de dados (data drift) que aparecem antes que um modelo quebre visivelmente
É o mesmo padrão sob diferentes configurações. Onde quer que você tenha algo que possa dar errado silenciosamente, o RADAR se aplica.
Crie você mesmo na Databricks
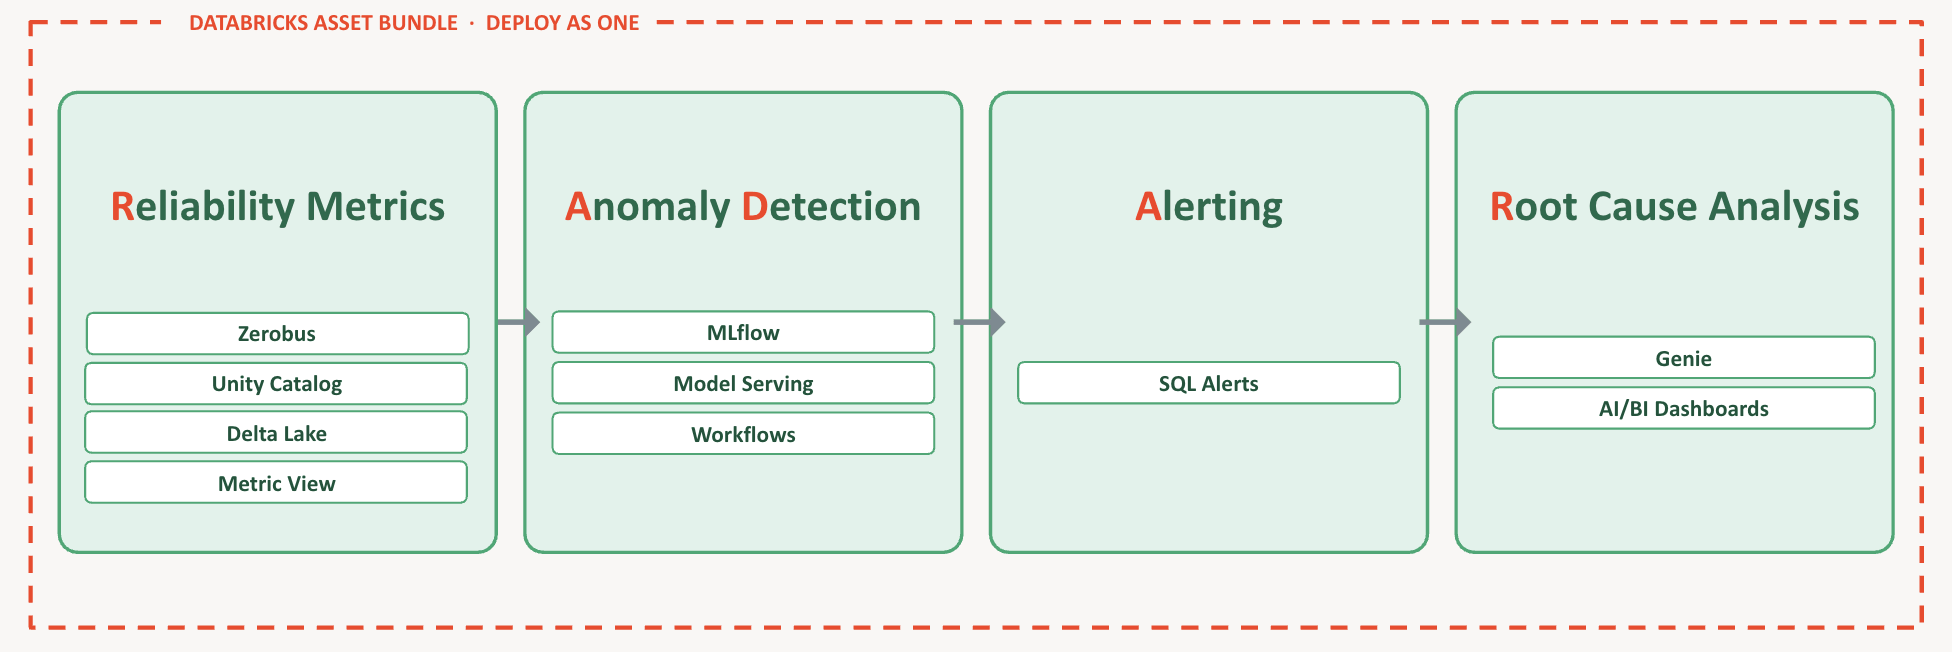
A melhor notícia: cada peça que você precisa já está na Databricks. Mapeie as quatro etapas para a plataforma e o resultado será este:
- Métricas de confiabilidade — Zerobus para ingestão de baixa latência, Unity Catalog e Metric View para governança, Delta Lake para armazenamento
- Detecção de anomalias — MLflow para treinamento de modelo, Model Serving para fornecer o endpoint do modelo e Workflows para orquestrar os jobs recorrentes
- Alertas — Databricks SQL Alerts para disparar alertas
- Análise de causa raiz — AI/BI Genie e AI/BI Dashboards
E tudo isso é implantado como uma única unidade por meio de um Declarative Asset Bundle (DAB).
Conectar todas essas partes manualmente é a parte chata — por isso, nós a eliminamos. Destilamos todo o sistema RADAR interno em um único scaffold: um arquivo markdown que funciona como uma receita, mapeando cada parte do RADAR para um componente específico do Databricks (coletar e armazenar → uma tabela Delta; detectar a anomalia → um job; alertar e eliminar duplicatas → um ticket; visualizar → um dashboard).
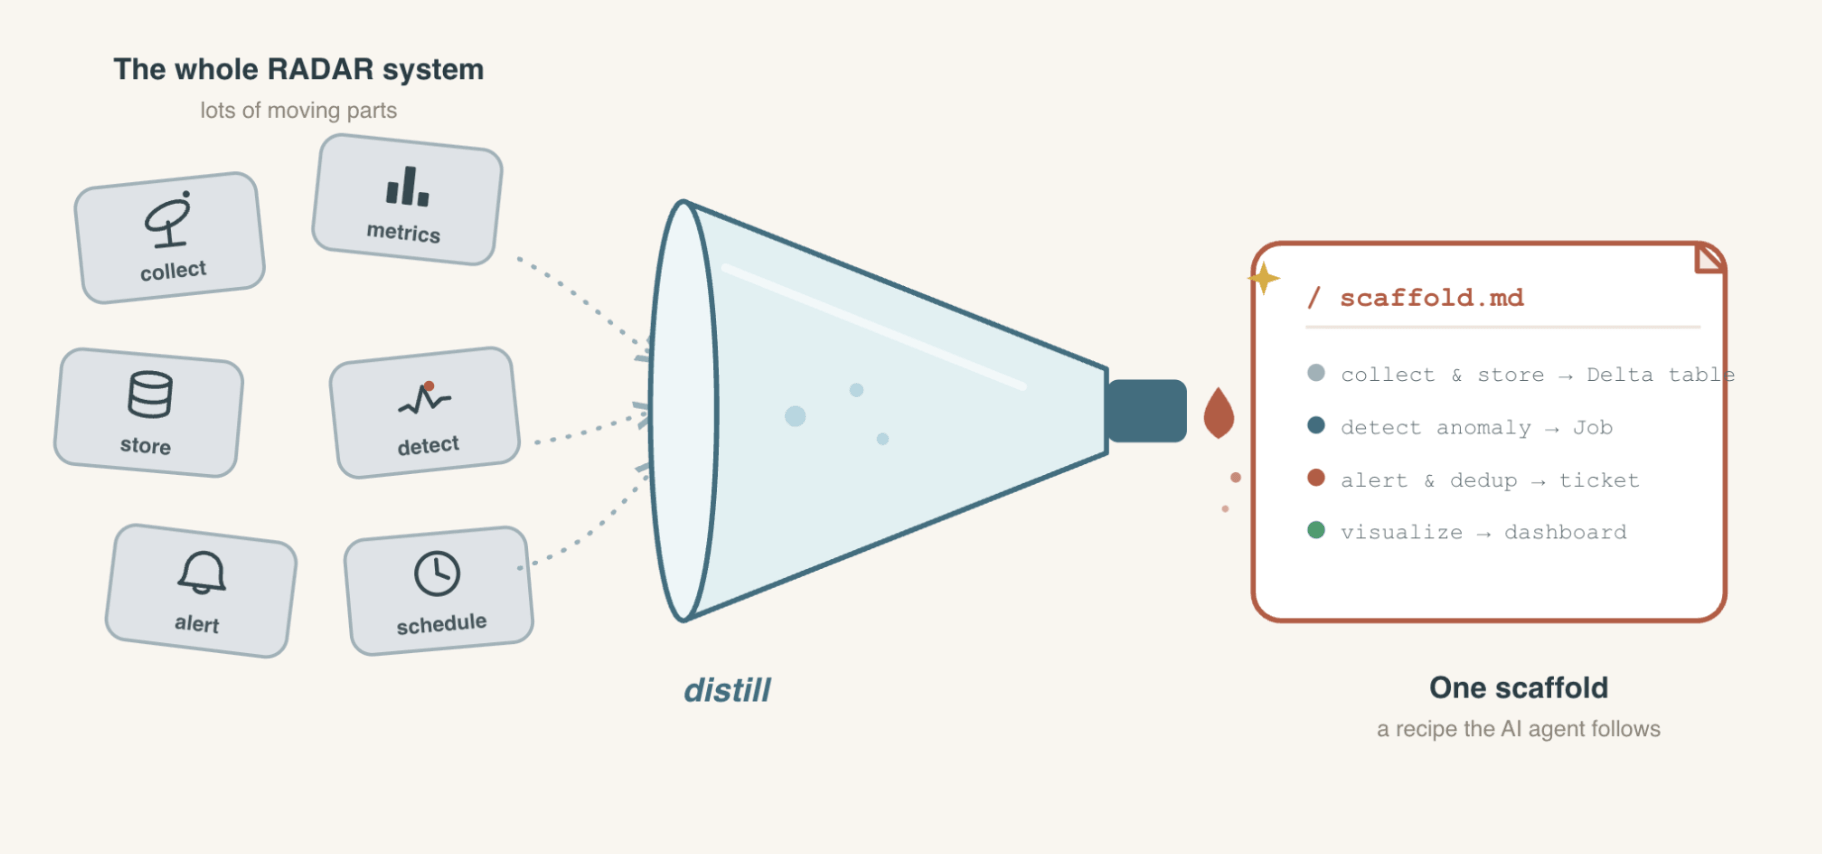
Depois vem a recompensa. Você traz sua própria métrica — onde quer que seu sinal esteja — e entrega a métrica, o scaffold e um breve prompt para um agente de IA. Ele cria todo o sistema RADAR para você, diretamente no Databricks. Você pode seguir as instruções do GitHub sobre como criar um a partir de um único prompt.
Principais conclusões
Duas coisas para levar com você:
- Detecte falhas cinzas antes que elas se agravem. Dashboards verdes não são prova de que os clientes estão bem. Adicione detecção de anomalias em tempo real para que uma falha parcial e silenciosa apareça em minutos, não em dias.
- Crie o RADAR no Databricks para qualquer métrica que seja importante para você. O scaffold, a demonstração e o prompt são todos públicos — comece por eles.
Obtenha o scaffold do RADAR no GitHub
Porque o melhor resultado não é uma resposta mais rápida a clientes insatisfeitos — é que seus clientes nunca precisem descobrir os incidentes por você.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.