"Regex para Linhas": Simplificando a detecção de padrões em SQL com MATCH_RECOGNIZE
Use o MATCH_RECOGNIZE sempre que uma sequência for importante, desde tendências do mercado de ações até falhas de sensores e muito mais.
por Kent Marten e Sergei Fedorov
- O MATCH_RECOGNIZE é um novo operador SQL, disponível em Public Preview, que permite detectar padrões e sequências a partir de dados de eventos.
- O MATCH_RECOGNIZE usa correspondência de padrões semelhante a regex.
- O MATCH_RECOGNIZE é altamente útil em vários setores, incluindo: serviços financeiros, segurança cibernética, e-commerce e manufatura/IoT
Imagine que você trabalha com segurança cibernética e tem uma tabela que rastreia tentativas de login. Essa tabela inclui cada tentativa de login como sucesso ou falha e o momento em que a tentativa ocorreu. Você quer encontrar padrões de login estranhos, então pode fazer a pergunta: “quais usuários tiveram falhas de login consecutivas, seguidas de sucesso?”. Encontrar esse tipo de atividade suspeita com SQL padrão é um desafio. O SQL trata as linhas como conjuntos não ordenados de fatos sem uma linha do tempo, e não há um conceito inerente de sequência de eventos.
Você poderia contar os logins com falha por usuário, mas as contagens não ajudarão a entender se essas tentativas de login ocorreram em um intervalo de tempo curto ou se foram distribuídas ao longo de um mês; e não podem dizer se um login bem-sucedido ocorreu logo após as falhas. Para fazer isso em SQL, você acabará com uma consulta complexa que encadeia várias expressões de tabela comuns, ancorando a janela de tempo na primeira falha e, em seguida, verificando cada linha subsequente.
MATCH_RECOGNIZE simplifica isso. Agora disponível na computação do Databricks (incluindo Lakehouse Real-Time), o MATCH_RECOGNIZE permite descrever diretamente a sequência de seu interesse, como uma expressão regular para linhas. Uma única cláusula SQL agora lida com a correspondência de padrões, eliminando códigos SQL excessivamente complicados que dependem da lógica de "lacunas e ilhas" (gaps and islands).
Vejamos exemplos específicos do setor de como o MATCH_RECOGNIZE simplifica a detecção de sequências em diferentes indústrias.
Segurança cibernética: identificando anomalias suspeitas de login

Se você estiver procurando por preenchimento de credenciais (credential stuffing) em logs de autorização, a simples contagem de tentativas de login pode levar a falsos positivos. Você precisa especificamente detectar picos de alta frequência, como 5 ou mais tentativas de login com falha dentro de uma janela de tempo curta e específica, seguidas imediatamente por um login bem-sucedido.
Funções de janela padrão como COUNT() OVER (PARTITION BY user_id ORDER BY event_time) podem informar quantas falhas ocorreram em um intervalo de tempo, mas não conseguem ancorar facilmente uma janela de tempo deslizante à primeira falha em uma sequência específica, nem isolar de forma limpa a sequência assim que ocorre um sucesso.
Com o MATCH_RECOGNIZE, você pode usar FIRST(FAIL.event_time) diretamente dentro do bloco DEFINE para ancorar o carimbo de data/hora (timestamp) da tentativa inicial com falha. Cada evento FAIL subsequente é verificado dinamicamente para garantir que ocorra dentro de 1 hora dessa primeira tentativa antes de fazer a transição para o estado SUCCESS.
Análise financeira: detectando tendências de ações em forma de V
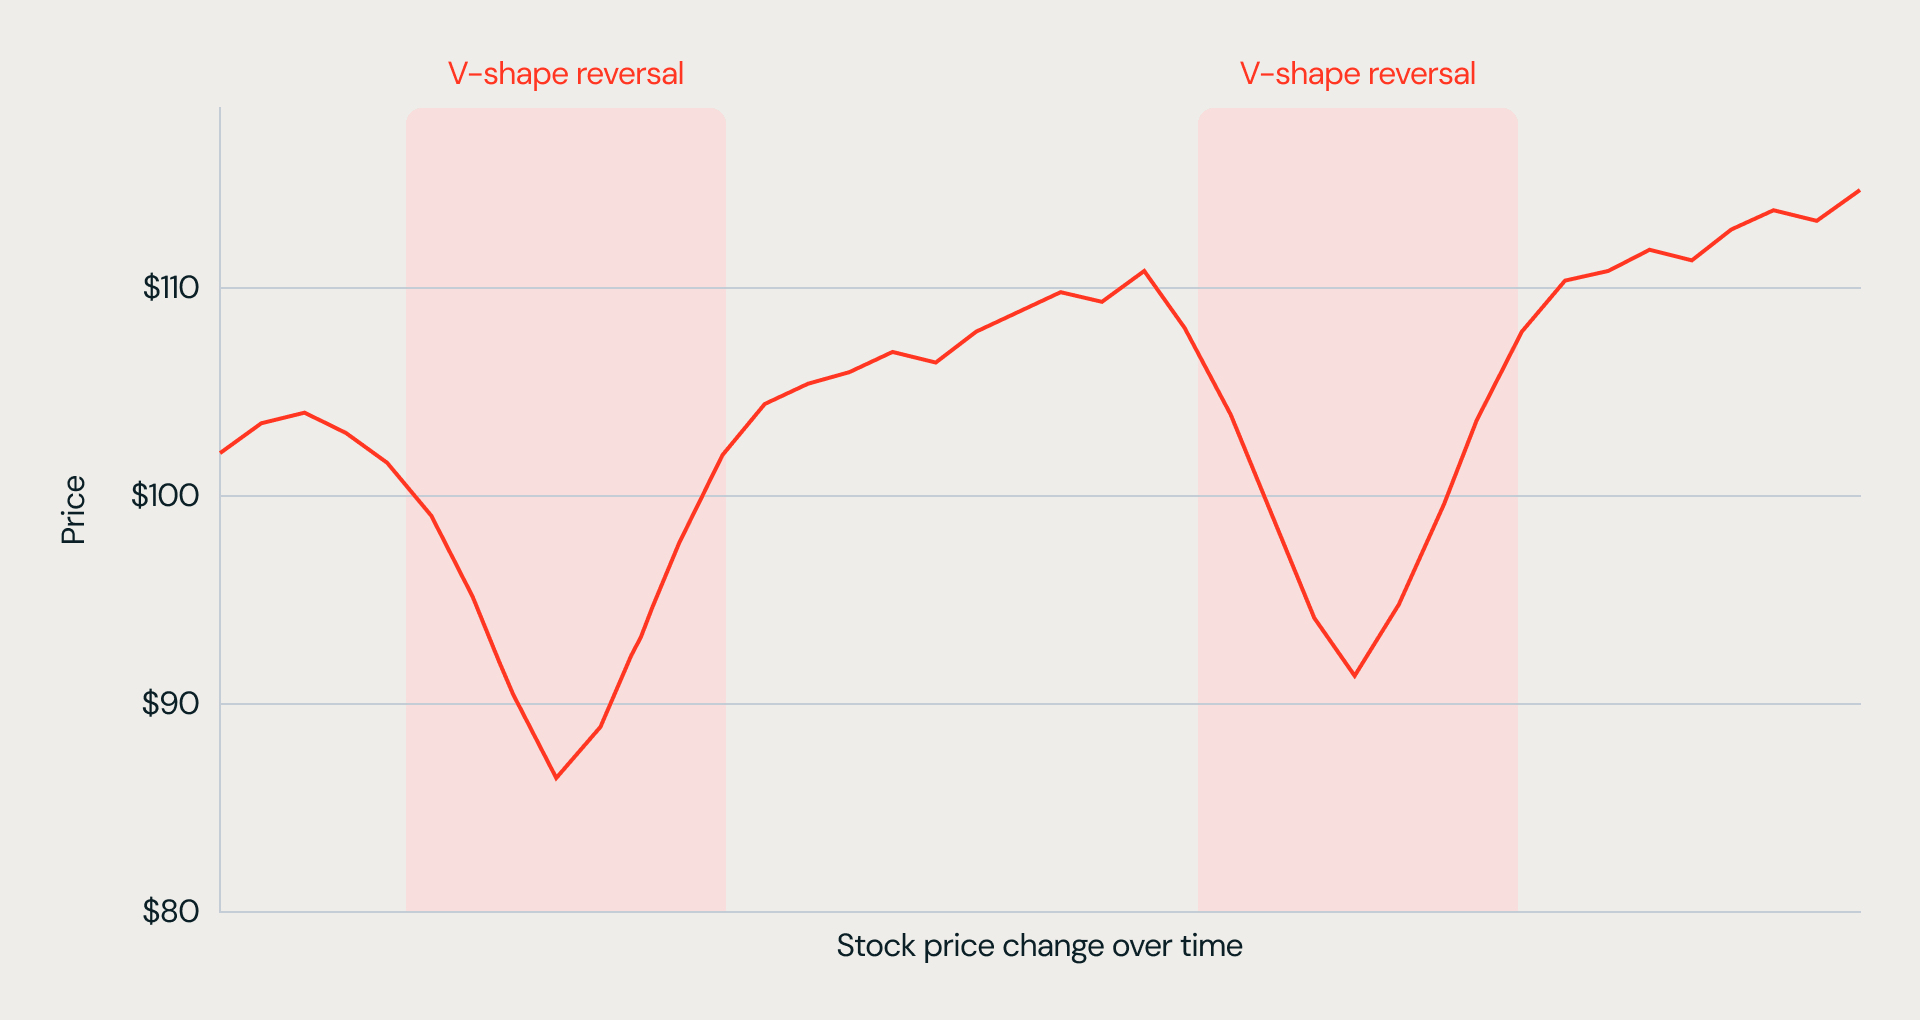
Todo analista de dados de mercado se preocupa com reversões de preços, momentos em que uma ação perde valor e, de repente, começa a se recuperar. Esse formato é conhecido como "forma de V" (V-shape), e encontrá-lo no SQL padrão significa recorrer a uma técnica chamada "lacunas e ilhas" (gaps and islands): como o SQL não tem uma noção nativa de tendência, primeiro você precisa dividir manualmente suas linhas em "ilhas" (trechos consecutivos onde o preço está se movendo na mesma direção) antes mesmo de poder perguntar onde uma forma de V começa e termina.
Na prática, isso significa usar LAG e LEAD para comparar cada linha com suas vizinhas, criando um contador cumulativo que aumenta toda vez que a direção muda (para que você tenha um ID de grupo para cada ilha) e, em seguida, escrever filtros HAVING para confirmar a forma e os limites de cada ilha. É muita estrutura apenas para responder a uma pergunta simples: "onde o preço caiu e se recuperou?"
A cláusula MATCH_RECOGNIZE elimina a necessidade dessa estrutura. Você simplesmente particiona os dados por símbolo, ordena por tempo e define a forma da tendência em V como uma sequência de estados do tipo regex.
E-commerce: detectando abandono de carrinho

Os gerentes de produto querem encontrar usuários com alta intenção de compra, mas que nunca a concluem. Usuários que demonstram intenção real de compra, mas depois ficam inativos, são um sinal valioso. Identificar esse grupo de usuários pode ajudar a: determinar para quais usuários enviar um lembrete, medir facilmente a oportunidade e qual porcentagem é recuperável com ações de acompanhamento e, como ponto de comparação com outros usuários dessa coorte, descobrir novos insights (como um determinado produto estar com o preço muito alto). Um funil de conversão com falha de alto valor rastreia usuários que:
- Visualizaram a página de um produto duas ou mais vezes (VIEW 2 ou mais vezes, indicando alto interesse)
- Adicionaram o item ao carrinho (ADD_TO_CART)
- Por fim, abandonaram a sessão (usando um filtro de tempo)
A última etapa não é baseada em um valor, mas em um intervalo de tempo baseado na atividade do usuário. Não há uma linha de “abandono” para corresponder ou um “erro de checkout”, o usuário simplesmente para. No SQL tradicional, você prova uma negativa com subconsultas NOT EXISTS, autojunções (self-joins) e funções de janela para mostrar que nada aconteceu depois que os itens foram adicionados ao carrinho e que tempo ocioso suficiente se passou para considerar o carrinho abandonado.
O MATCH_RECOGNIZE expressa "nada aconteceu depois disso" diretamente com a âncora de fim de partição $, que força a adição ao carrinho a ser o último evento registrado na sessão. Adicione um filtro de tempo para a janela de inatividade e você terá uma regra de abandono baseada em tempo limite (timeout) sem autojunções.
Manufatura / IoT: Prevendo falhas de equipamentos a partir de dados de sensores

A manutenção preditiva depende da identificação de tendências e padrões. Com qualquer máquina em uso, sua temperatura interna tende a aumentar, mas uma sequência de aumento constante de temperatura, seguida por um pico de vibração, pode sinalizar uma falha iminente.
O SQL tradicional exige comparações contínuas linha por linha para tentar detectar uma tendência perigosa. MATCH_RECOGNIZE trata a lógica linha por linha nativamente. Dentro da cláusula DEFINE, você pode usar as funções PREV e NEXT (que agem de forma semelhante a LAG e LEAD). Isso significa que configurar uma regra de aumento de temperatura é tão simples quanto escrever temperature > PREV(temperature).
Experimente o Match Recognize no Lakehouse hoje mesmo
Agora está mais fácil do que nunca descobrir padrões de dados e simplificar a análise de sequência de eventos. MATCH_RECOGNIZE permite que você escreva menos código para correspondência de padrões de forma lógica. Essa cláusula é mais fácil de validar, mais fácil de manter e simples de atualizar.
- Explore a documentação: Mergulhe na documentação oficial de referência de SQL para saber mais sobre sintaxe de padrões avançados, quantificadores e agregados de medidas.
- Experimente em seu workspace: Teste os exemplos acima em seus próprios fluxos de logs, sessões de clickstream ou telemetria de séries temporais no Databricks SQL ou Lakehouse//RT.
- Migre pipelines legados: Identifique suas CTEs de função de janela e self-join mais complexas e deixe o Genie Code ajudar a reescrevê-las com consultas MATCH_RECOGNIZE mais simples.
O melhor data warehouse é um Lakehouse. Nossos recursos nativos continuam se expandindo e permitem que você faça análises mais avançadas em uma única plataforma unificada.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.