Escalando e operando um grande projeto dbt no Databricks: a equipe de dados da IFCO fala sobre performance, visibilidade e depuração
- Otimize os modelos incrementais do dbt para que cada execução grave apenas as linhas que foram alteradas, usando liquid clustering, uma estratégia de merge deliberada e dynamic file pruning. Isso reduziu o tempo de execução do job principal da IFCO em mais de 60% e eliminou o full refresh noturno.
- Diagnostique modelos lentos a partir do plano de consulta real executado, e não do SQL compilado, pois é aí que aparecem as causas reais. A IFCO empacotou esse diagnóstico em uma habilidade repetível que é executada em cada modelo.
- Execute o projeto dbt como uma tarefa por modelo no Databricks Jobs com o databricks-dbt-factory de código aberto, e não como um único job opaco. Isso proporciona visibilidade por modelo, reexecuções direcionadas e testes obrigatórios.
Resumo
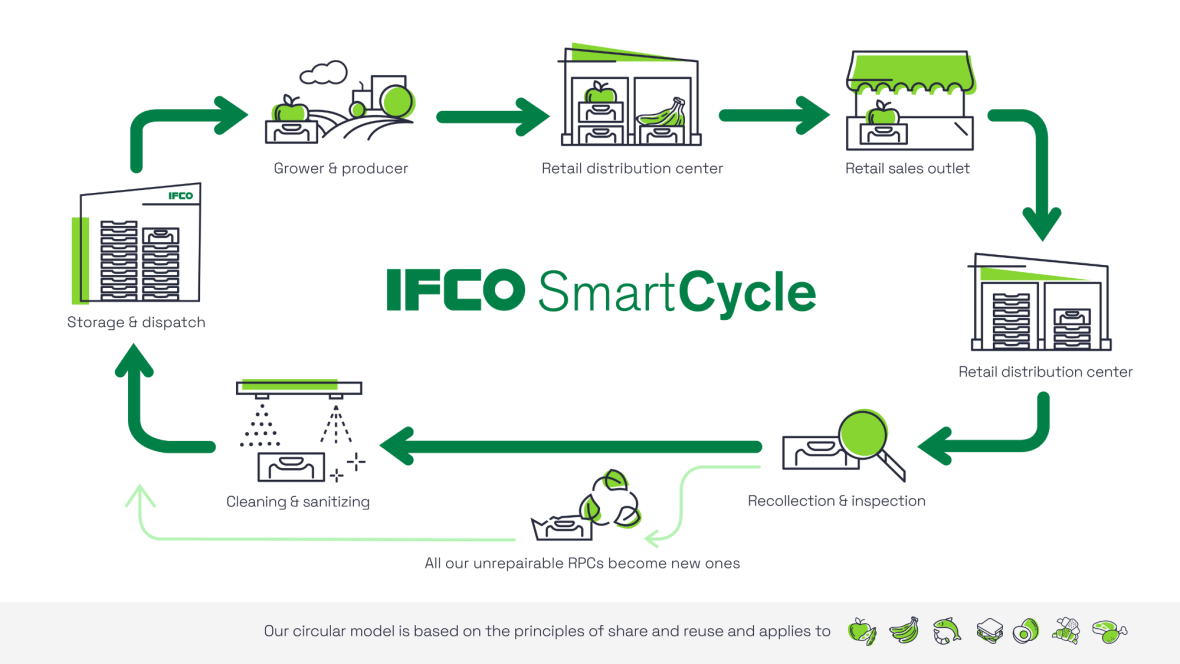
A IFCO opera um dos maiores pools de embalagens reutilizáveis do mundo, com centenas de milhões de caixas e paletes. Com mais de 2.000 funcionários em todo o mundo, a IFCO emprega mais de 350 pessoas na Alemanha, a maioria das quais trabalha em sua sede global em Pullach, perto de Munique. O negócio é um serviço de pooling circular: contentores plásticos reutilizáveis (RPCs) transportam produtos frescos de produtores e embaladores para centros de distribuição e varejistas, retornando depois aos Centros de Serviço da IFCO para serem lavados, triados e enviados novamente, em mais de 50 países.
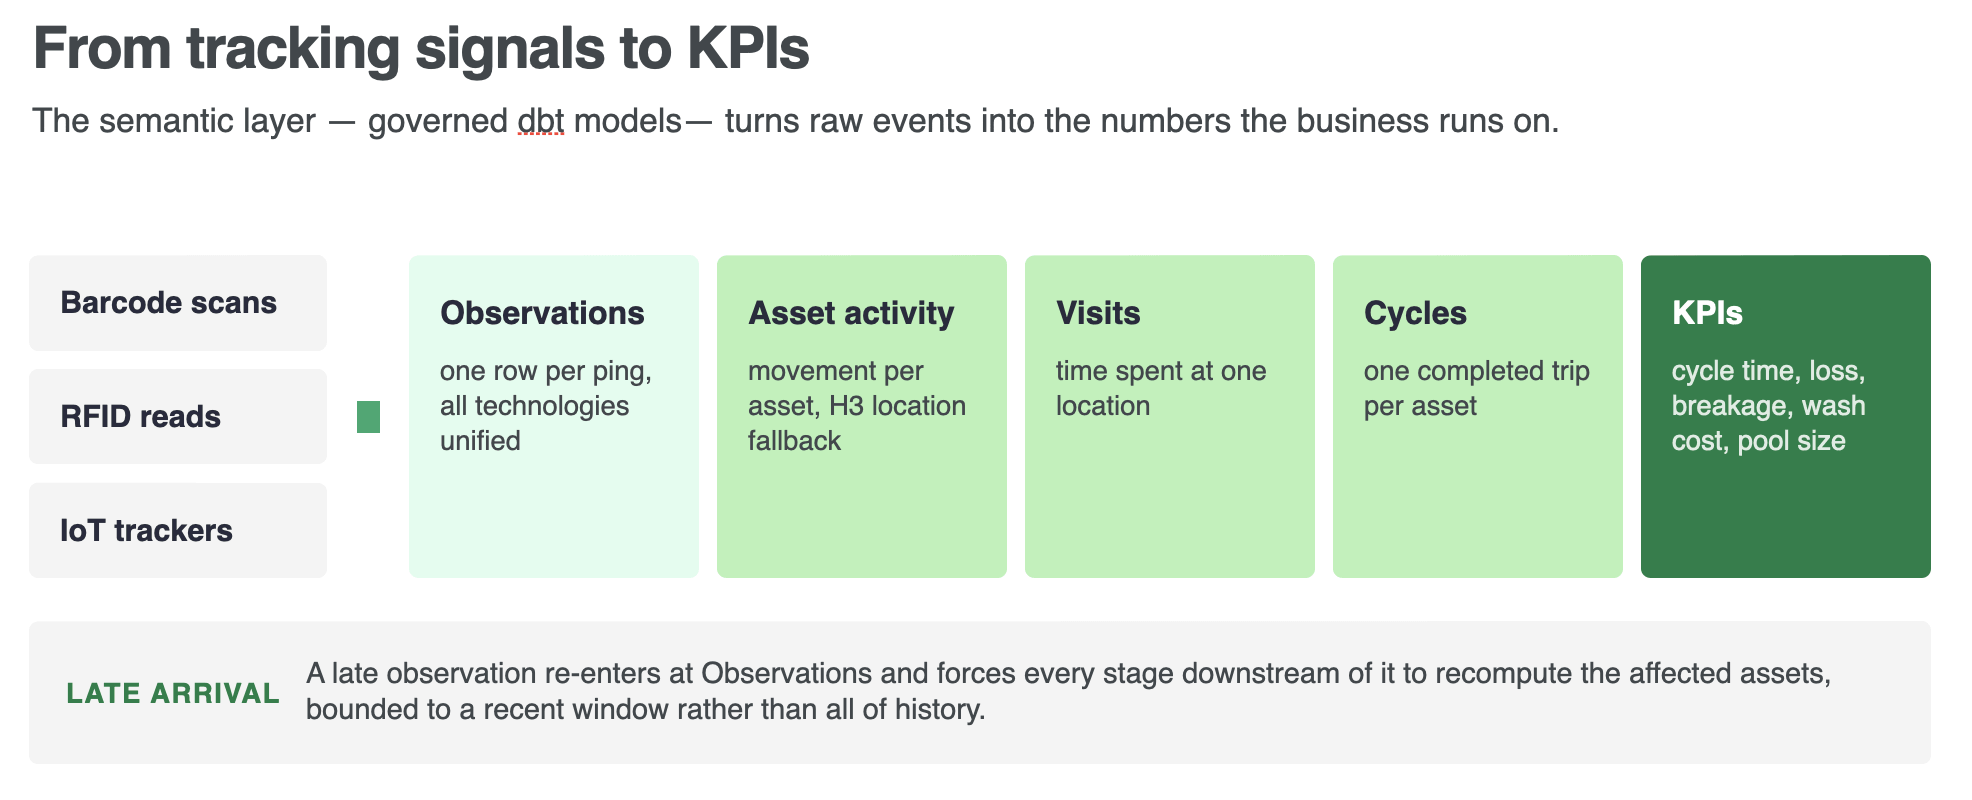
Cada caixa e palete é rastreado ao longo de seu ciclo de vida, alimentando os KPIs que direcionam o negócio: tempo de ciclo, perda, quebra, custo de lavagem e tamanho do pool. Transformar bilhões de eventos brutos de rastreamento em KPIs confiáveis é difícil por três motivos: há uma grande quantidade de dados, parte deles chega com atraso de maneiras difíceis de prever e, quando isso acontece, força o pipeline a corrigir o histórico que já havia sido relatado.
Este post mostra como a equipe da plataforma de dados da IFCO, trabalhando em colaboração com o Databricks Forward Deployed Engineering, tornou esse pipeline mais rápido e econômico. A lógica de transformação permanece no dbt. Ela é executada no Databricks, onde cada configuração incremental é mapeada para um comportamento de gravação concreto do Delta Lake: quais colunas clusterizam os dados, quanto da tabela de destino uma gravação precisa afetar e se as linhas são mescladas ou substituídas. Ajustar corretamente essas configurações, na granularidade de dados adequada, reduziu o tempo de execução diário do job principal da camada semântica em mais de 60% e permitiu que a IFCO eliminasse uma atualização completa (full refresh) noturna de alto custo.
A IFCO e o formato do problema de dados
Uma caixa é coletada, abastecida, enviada, devolvida, lavada e reutilizada muitas vezes ao ano, por isso a IFCO precisa saber onde cada ativo está e o que aconteceu com ele. A IFCO introduziu uma camada semântica, que reúne muitos sinais de rastreamento diferentes em uma única visão governada da atividade dos ativos: leituras de código de barras conforme as caixas passam pela linha de lavagem, leituras de RFID nas portas das docas e rastreadores alimentados por bateria que informam a posição de GPS, beacons Bluetooth próximos e temperatura. (Ao longo deste post, "camada semântica" refere-se a esses modelos dbt governados que transformam eventos brutos de rastreamento em KPIs de negócios). Três propriedades tornam isso difícil.
- Escala. Bilhões de eventos de rastreamento chegam por dia. A consolidação reduz os pings repetidos de cada ativo em muito menos linhas de atividade, mas as tabelas que os KPIs leem ainda são grandes o suficiente para que reconstruí-las do zero seja caro.
- Chegadas tardias imprevisíveis. A maioria das observações chega dentro de uma janela esperada, mas alguns fluxos de dados atrasam semanas e alguns meses, sem um cronograma fixo. Um pipeline que assume que os dados que possui hoje são a imagem completa do que aconteceu ontem relatará silenciosamente um histórico incorreto.
- Reconciliação histórica. A atividade do ativo é uma sequência, portanto, uma observação tardia não serve apenas para preencher uma lacuna. Adicione uma leitura no meio da linha do tempo de um ativo e isso alterará o que o pipeline já havia concluído sobre tudo o que veio depois: para onde o ativo foi em seguida, quando seu ciclo começou, em qual categoria de KPI ele se enquadrou. Portanto, uma chegada tardia força o pipeline a recalcular o estado que já foi publicado, e não apenas anexar uma nova linha. O objetivo é emitir uma boa estimativa rapidamente e fazê-la convergir para a realidade à medida que os dados tardios chegam, sem reprocessar tudo todas as noites.
Processamento incremental em escala
Por baixo dos panos, um modelo incremental do dbt é um conjunto de comportamentos de leitura e gravação do Delta, e a maior parte do ganho veio de um princípio: fazer com que cada execução afete o menor número possível de linhas e as filtre o quanto antes. A primeira e maior alavanca é a própria leitura, rastreando apenas os arquivos e os ativos alterados de que uma execução realmente precisa, pois cada linha que você evita ler é uma linha que nunca chega às caras operações downstream de ordenação por ativo, shuffles e gravações. Cada técnica abaixo é uma configuração comum do dbt que se transforma em um comportamento específico do Delta.
Clusterize pelas colunas que você filtra e junta (join). O Liquid clustering, indexado pela granularidade pela qual cada modelo é consultado (para a atividade do ativo, o ativo e a data do evento), permite que o mecanismo ignore arquivos em vez de escaneá-los. É isso que faz as duas técnicas a seguir funcionarem.
Escolha a estratégia incremental deliberadamente. A estratégia decide como cada execução grava, e a escolha decorre de duas perguntas: cada linha tem uma chave estável e você está atualizando as linhas no local ou substituindo um grupo delas de uma só vez? Para upserts baseados em chave e com muita eliminação de duplicatas (dedup), o merge é o padrão. Indexado na granularidade real (para a atividade do ativo, asset_id e event_date_time), ele faz duas coisas que uma exclusão e reinserção em massa (bulk delete-and-reinsert) não consegue:
O predicado equi-join ativa o dynamic file pruning (poda dinâmica de arquivos): os valores de chave no lote de entrada ignoram os arquivos de destino que não podem conter uma correspondência, de modo que a gravação afeta apenas a fatia que ela altera. (DBT_INTERNAL_DEST and DBT_INTERNAL_SOURCE são os aliases do dbt para a tabela de destino e o lote de entrada na instrução que ele gera). A clusterização nas mesmas chaves com as quais o merge faz a correspondência mantém essa poda precisa. Uma proteção de hash de linha, um matched_condition que compara um hash substituto (surrogate hash) de cada linha, evita a regravação de linhas que não foram realmente alteradas, o que economiza gravações e mantém o feed de alterações downstream limpo.
delete+insert é a alternativa: ele exclui um grupo inteiro de linhas por chave e as reinserte. Isso é mais simples quando uma execução recalcula um grupo como uma unidade e as linhas não possuem uma identidade estável para correspondência, ao custo de regravar o grupo mesmo onde nada mudou. Em volumes muito grandes, vale a pena realizar um benchmark de ambos em vez de apenas presumir.
Limite a gravação a uma janela recente. O mesmo mecanismo de predicado tem um segundo uso. Em vez de um equi-join para poda de arquivos, um limite de tempo restringe a gravação a dados recentes, de modo que, nos modelos upstream de maior volume, o MERGE faz a correspondência com uma fatia recente do destino, em vez de toda a tabela:
Como o predicado se baseia em quando uma linha foi ingerida, e não em quando o evento ocorreu, um evento com meses de idade ainda é capturado, desde que tenha chegado recentemente. A janela só precisa ser ampla o suficiente para cobrir o intervalo entre a chegada dos dados e o processamento deles por este job. Se você a definir de forma muito estreita, os dados tardios serão ignorados silenciosamente: não haverá erro, eles simplesmente nunca serão processados.
Recompute apenas o que mudou. Os modelos limitam seu escopo de trabalho aos ativos afetados por dados novos ou tardios, identificados a partir de um watermark de ingestão, e leem uma janela mais ampla do que gravam, de modo que os eventos tardios sejam capturados sem a necessidade de um full refresh.
Mantenha o Delta organizado. Tabelas incrementais pesadas ativam gravações otimizadas (optimized writes) e compactação automática (auto-compaction), ou transferem a manutenção de tabelas para o Predictive Optimization, de modo que merges frequentes não deixem para trás um custo de leitura de arquivos pequenos.
A disciplina consiste em aplicar essas técnicas na granularidade correta e, em seguida, confirmar, a partir do plano de consulta real, se o mecanismo realmente realiza a poda em vez de fazer uma varredura silenciosa.
Um exemplo prático: consolidando observações na atividade do ativo
O modelo mais movimentado na camada semântica é aquele que consolida as observações de cada tecnologia de rastreamento em um único fluxo com reconhecimento de localização por ativo. Ele calcula quando um ativo realmente se moveu usando funções de janela (window functions) particionadas por ativo e ordenadas pelo tempo do evento. Quando uma observação não traz uma localização explícita, ele recorre às funções H3 integradas do Databricks SQL, que mapeiam cada latitude/longitude para uma célula de grade hexagonal, de modo que "mesmo lugar" se torne uma comparação simples de IDs de células e sua distância na grade, em vez de cálculos repetidos de distância geográfica. Esse foi, por uma ampla margem, o maior consumidor individual de tempo de execução.
O primeiro passo não foi otimizar, mas sim ver o que estava realmente sendo executado, e essa distinção é importante. O dbt compile renderiza o SELECT de um modelo com suas referências resolvidas, mas para um modelo incremental essa não é a instrução que o Databricks executa. Por trás desse SELECT compilado, o dbt gera e executa uma operação maior: exibições temporárias (temporary views), varreduras da tabela de destino e a gravação final de volta na tabela. A única maneira de descobrir para onde vão o tempo e a memória é ler o plano de consulta realmente executado, etapa por etapa, a partir do histórico de consultas, e não o SQL compilado.
Lido dessa forma, o plano era revelador. O modelo estava varrendo bilhões de linhas, gravando temporariamente (spilling) centenas de gigabytes em disco e gastando cerca de 85% do seu tempo em uma única ordenação de janela por ativo e shuffle. Ele estava, na prática, reconstruindo a tabela inteira a cada execução. Três fatores causaram isso:
- O conjunto de ativos "alterados" nunca diminuía. Um timestamp upstream era regenerado a cada execução em vez de ser herdado da origem, fazendo com que quase todos os ativos parecessem novos. Quando tudo parece modificado, uma execução incremental silenciosamente se torna uma atualização completa.
- O recálculo por ativo não tinha limites. As funções de janela buscavam todo o histórico de cada ativo, de modo que mesmo um conjunto alterado genuinamente pequeno arrastava anos de histórico pela ordenação.
- A etapa de janela computava colunas que a consulta final nunca usava, incluindo uma segunda janela prospectiva cujo resultado inteiro era descartado.
Cada correção decorre diretamente de sua causa: transportar o timestamp real de ingestão pelos modelos upstream para que o conjunto alterado reflita dados genuinamente novos, limitar o recálculo a uma janela recente, descartar as colunas não utilizadas e a janela prospectiva, fazer o cluster com base na granularidade pela qual o modelo é consultado e, finalmente, executar todo o grafo como tarefas paralelas por modelo em computação serverless (próxima seção). Juntas, essas medidas reduziram o tempo de execução do job principal em mais de 60% (quase dois terços) e eliminaram a atualização completa noturna que era necessária para manter os KPIs corretos.
De uma sessão de depuração a uma habilidade repetível
O diagnóstico acima — ler o plano de execução real em vez do SQL compilado, verificar o lado de leitura e o lado de gravação, rastrear cada sintoma até uma causa raiz — não é específico do modelo de consolidação. É uma sequência que qualquer engenheiro executaria em qualquer modelo incremental lento no Databricks. Essa sequência é o que é empacotado como uma habilidade: um playbook que um agente de IA executa sob demanda, para que o diagnóstico escale com o número de modelos, em vez do número de engenheiros que se lembram de como fazer isso.
A habilidade reflete o exemplo prático passo a passo. Ela extrai a família de instruções real do histórico de consultas, e não da saída do dbt compile, porque, para um modelo incremental, essas são instruções diferentes. Ela lê ambos os lados da execução: métricas do lado de varredura (arquivos podados, linhas lidas, spill) e métricas do lado de gravação (linhas gravadas vs. linhas excluídas), já que a amplificação só aparece no lado de gravação. Em seguida, ela verifica as mesmas três classes de falha encontradas no modelo de consolidação: um conjunto alterado que nunca diminui (um timestamp upstream regenerado em vez de herdado), um recálculo por ativo sem limites (uma janela sem limite de busca retroativa) e trabalho desperdiçado (colunas ou passagens de janela computadas, mas nunca lidas downstream). Cada verificação é baseada em uma métrica ou sinal de plano, não em um palpite.
O resultado é um relatório, não uma correção silenciosa: cada descoberta é apresentada com suas evidências (linhas varridas, bytes de spill, nó do plano), acompanhada de uma proposta de alteração, e nada é aplicado a um modelo até que seja aprovado. Uma vez aprovadas, as mesmas métricas de antes/depois usadas para justificar a correção são medidas novamente na próxima execução, de modo que a habilidade fecha o ciclo em vez de apenas presumir que a correção funcionou.
O ganho é consistência, não novidade. As três causas por trás do tempo de execução do modelo de consolidação eram comuns e fáceis de passar despercebidas sob carga (um timestamp regenerado, uma janela sem limites, colunas mortas). A execução de uma habilidade para detectá-los não custa nada para ser repetida e encontra a mesma classe de problema no próximo modelo antes que se torne um problema de tempo de execução de 60% que alguém precise escalar.
Executando um grande projeto dbt no Databricks Jobs
O Databricks Workflows (Lakeflow Jobs) trata o dbt como um tipo de tarefa de primeira classe: um projeto dbt pode ser agendado, executado e monitorado junto com as etapas de ingestão e downstream em um único fluxo de trabalho governado, com repetições e alertas compartilhados. A versão mais simples executa todo o projeto como uma única tarefa dbt. Funciona, mas é uma caixa-preta: se um modelo falha, todo o job falha, sem nenhuma maneira de visualizar, executar novamente ou monitorar modelos individuais. Nessa escala, isso representa um risco operacional.
A solução é executar o grafo dbt como tarefas individuais do Databricks, uma por modelo, teste, seed e snapshot. O IFCO gera esse grafo com o databricks-dbt-factory, uma biblioteca de código aberto independente (com licença MIT, no GitHub e no PyPI). Ela lê o manifesto do dbt e um modelo de job e produz um job do Databricks Asset Bundle com uma tarefa por nó. A granularidade por tarefa só vale a pena se cada tarefa for barata para iniciar, o que se resume a três mecanismos:
- Tipo de tarefa Notebook. Um pequeno notebook executor compartilhado aciona o dbt por meio de sua API Python. O dbt processa o SQL e o envia para o SQL warehouse, de modo que a computação do notebook não processa dados.
- Ambientes base. Um ambiente base é um snapshot de ambiente Python serverless pré-construído. Este já contém o
dbt-databricks, de modo que cada tarefa começa a partir dele e ignora a instalação via pip que uma nova tarefa de outra forma teria que realizar. - Injeção de manifesto. Um manifesto pré-construído é entregue diretamente ao dbt para que a análise seja ignorada, e cada tarefa grava artefatos em um diretório local privado. Em um grande projeto executado por muitas tarefas ao mesmo tempo, essa é a diferença entre minutos relendo o projeto e trabalho útil.
Com o overhead mantido baixo, a distribuição (fan-out) oferece à operação o que ela precisa: visibilidade no nível da tarefa, reexecuções direcionadas apenas do modelo com falha e seus dependentes, registro de logs por modelo, alertas e testes, além de um executor que você pode estender (carregar segredos, marcar uma execução com um SHA do git ou postar no Slack em poucas linhas). Tudo é implantado como Databricks Asset Bundles por meio de uma matriz do GitHub Actions com reconhecimento de caminho, e o tempo de execução e o custo por modelo são rastreados a partir de tags de consulta e tabelas do sistema em um painel com alertas, de modo que uma regressão aparece em um dia, não em uma fatura mensal.
Testes e qualidade em escala
A eficiência não vale nada se quebrar silenciosamente os números, por isso a qualidade é imposta, não apenas esperada. Cada modelo possui um proprietário e um teste de exclusividade. As chaves primárias são testadas como exclusivas e não nulas no nível de gravidade de erro. Modelos com lógica real (funções de janela, junções múltiplas, macros complexas) exigem testes unitários. O dbt-bouncer bloqueia commits que violam essas regras, junto com o sqlfluff no dialeto do Databricks, e os contratos são aplicados nas camadas que os consumidores externos leem.
A mesma disciplina se aplica ao custo dos próprios testes. As verificações em views são materializadas ou consolidadas em menos passagens, porque uma verificação baseada em view recalcula a view a cada execução — verificações básicas tornam-se restrições de coluna e os testes são limitados a dados incrementais. Localmente, os desenvolvedores recorrem a um manifesto de produção, de modo que apenas os modelos alterados são compilados, enquanto os upstreams leem de prod. No CI, testes unitários e de amostragem de dados são executados nos modelos alterados antes do merge.
Benchmarking
| Métrica | Antes | Depois |
|---|---|---|
| Tempo de execução diário, job principal | ≈ 7 horas | 2h 20min, redução de ~66% |
| Atualização completa noturna | necessária para manter os KPIs corretos | descontinuada |
| Linhas varridas por execução, modelo de consolidação | ≈ 25 bilhões (e crescendo diariamente) | -75% de linhas varridas |
| Custo de computação diário | Reduzido em 58% | |
| Ativos recalculados por execução | quase todo o conjunto | ≈ 3 - 5% do conjunto |
Próximos passos
O pipeline hoje é em lote (batch): a ingestão ocorre uma vez por dia, e a camada semântica é executada sobre ela, emitindo uma estimativa inicial e convergindo-a à medida que os dados atrasados chegam. Três frentes de trabalho recomendadas durante o projeto levariam isso adiante e abririam as portas para KPIs em tempo quase real.
- Consumir apenas o que mudou, com o Change Data Feed. O Change Data Feed do Delta permite que um modelo downstream leia apenas as linhas que foram alteradas upstream, em vez de varrer novamente suas entradas. Aplicado ao modelo de consolidação e seus dependentes, ele reduz o trabalho de reconciliação de "varrer uma janela recente" para "processar as linhas exatas que foram movidas", o próximo passo natural após limitar o recálculo.
- Ingestão de menor latência. A carga diária pode migrar para um caminho de ingestão por streaming, usando o Auto Loader ou um conector Lakeflow Connect de baixa latência, sem a necessidade de reestruturar nada downstream. Isso por si só reduz o tempo de atualização de um dia para minutos.
- Transformações de streaming declarativas. A mesma lógica de transformação pode ser executada continuamente como um Lakeflow Declarative Pipeline lendo um stream, em vez de um lote noturno, com o processamento stateful lidando com a reconciliação por ativo à medida que os eventos chegam.
A questão decisiva é a necessidade de negócios, não a tecnologia. Onde uma métrica realmente precisa ser atualizada em minutos, em vez de na manhã seguinte, esse caminho a entrega nas mesmas tabelas governadas, com a mesma lógica definida pelo dbt. Onde uma atualização diária é suficiente, o pipeline em lote já é a resposta mais barata.
Conclusão
A estrutura da solução consiste em uma divisão clara de trabalho. A lógica de transformação permanece no dbt, de forma modular e testada, enquanto os dados ficam no formato aberto Delta Lake sob um único modelo de governança do Unity Catalog, garantindo que a linhagem e os controles de acesso sobrevivam a cada reconstrução de tabela e que nada fique preso a um único mecanismo de consulta. Essa lógica do dbt é compilada para os recursos do Databricks criados para escala: clustering líquido, gravações incrementais do Delta, poda dinâmica de arquivos e funções geoespaciais H3. Faça o diagnóstico a partir do plano de consulta real, e não do SQL compilado, reduza o número de linhas que chegam às ordenações e shuffles caros e execute o projeto como um gráfico de tarefas por modelo para que a equipe de operações ganhe visibilidade e reexecuções seguras com baixo overhead. Os maiores ganhos não vieram de clusters maiores, mas sim de realizar menos trabalho: processar menos linhas, recomputar menos ativos e reconstruir a tabela com muito menos frequência.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.