Unificando a governança entre mecanismos e catálogos no Lakehouse aberto
Como duas novas especificações do Apache Iceberg™ tornam a governança tão portátil quanto seus dados
- Restrições de leitura e rótulos de catálogo são duas novas especificações do Apache Iceberg™ que ajudam a padronizar como as políticas são aplicadas em diferentes mecanismos e catálogos.
- Ambas as adições eliminam a aplicação fragmentada. As restrições de leitura delegam decisões a mecanismos confiáveis; os rótulos de catálogo tornam os metadados de governança portáteis entre catálogos federados.
- Agora existe um modelo claro para cada padrão de acesso: aplicação centralizada para mecanismos não confiáveis, restrições de leitura para os confiáveis e rótulos de catálogo para federação de catálogo para catálogo.
Em nossos posts anteriores, mostramos como formatos de tabela abertos, APIs abertas e governança unificada estão se unindo para completar a visão de Lakehouse aberto. Também apresentamos o controle de acesso baseado em atributos entre mecanismos, que permite que as políticas definidas no Unity Catalog sejam aplicadas de forma consistente quando mecanismos externos acessam dados governados.
Agora, essa visão está começando a se materializar abertamente. A comunidade Apache Iceberg™ apresentou recentemente duas adições importantes ao Iceberg REST Catalog: restrições de leitura e rótulos de catálogo. Juntas, elas abordam dois desafios distintos: delegar a aplicação a um mecanismo externo e tornar o contexto de governança portátil entre catálogos.
Neste post, examinaremos de perto ambas as novas adições à especificação: como funcionam, os principais desafios que abordam, as oportunidades futuras de inovação e quando usá-las.
Restrições de leitura: padronizando a aplicação delegada
As restrições de leitura abordam um cenário comum de mecanismo para catálogo: uma organização governa os dados em um catálogo e deseja consultá-los a partir de vários mecanismos ou ferramentas.
Para qualquer consulta governada, três coisas devem acontecer:
- O catálogo recebe a identidade solicitante e o contexto relevante, como sujeitos, grupos, funções ou até mesmo atributos de identidade, como 'região'
- Ele avalia a política para decidir se o usuário pode ler a tabela e quais filtros de linha ou máscaras de coluna se aplicam.
- Uma camada de computação confiável aplica essa decisão quando os dados são lidos.
Quando os dados são acessados a partir de um mecanismo, essas responsabilidades podem ser divididas de duas maneiras.
Com a aplicação centralizada, todas as três etapas permanecem no ambiente do catálogo. Por exemplo, o Databricks implementa controle de acesso refinado em computação dedicada, roteando consultas de forma transparente por meio de uma frota de filtragem segura. E o recurso Cross-engine ABAC do Unity Catalog estende essa governança a outros mecanismos, colocando a frota de filtragem por trás das APIs de varredura/planejamento (scan/plan) do Iceberg REST Catalog para higienizar os dados antes que um mecanismo externo, como o Spark1 ou o DuckDB, processe o resultado.
Com aplicação delegada, o catálogo recebe a identidade solicitante e avalia a política, depois retorna as restrições de linha e coluna resultantes para um mecanismo em que confia para aplicá-las. Aqui, confiança significa que o catálogo pode contar com o mecanismo para aplicar as restrições e impedir que os usuários as ignorem. Mecanismos como o Spark e o DuckDB não são confiáveis quando os usuários controlam o ambiente de execução (runtime), pois esses usuários podem executar código arbitrário ou acessar os dados subjacentes diretamente. Uma implantação do Trino configurada de forma segura é um exemplo de mecanismo confiável, pois fornece aplicação nativa para filtros de linha e máscaras de coluna.
A aplicação delegada exige um contrato comum entre o catálogo e o mecanismo. A comunidade do Iceberg adotou as restrições de leitura para fornecer esse contrato.
Como funcionam as restrições de leitura
Quando um leitor carrega uma tabela por meio do Iceberg REST Catalog, o catálogo avalia as políticas aplicáveis para o principal solicitante e o contexto da solicitação. Ele pode retornar as ações de projeção de coluna e expressões de filtro de linha necessárias, e o mecanismo confiável deve aplicar essas restrições ao ler a tabela.
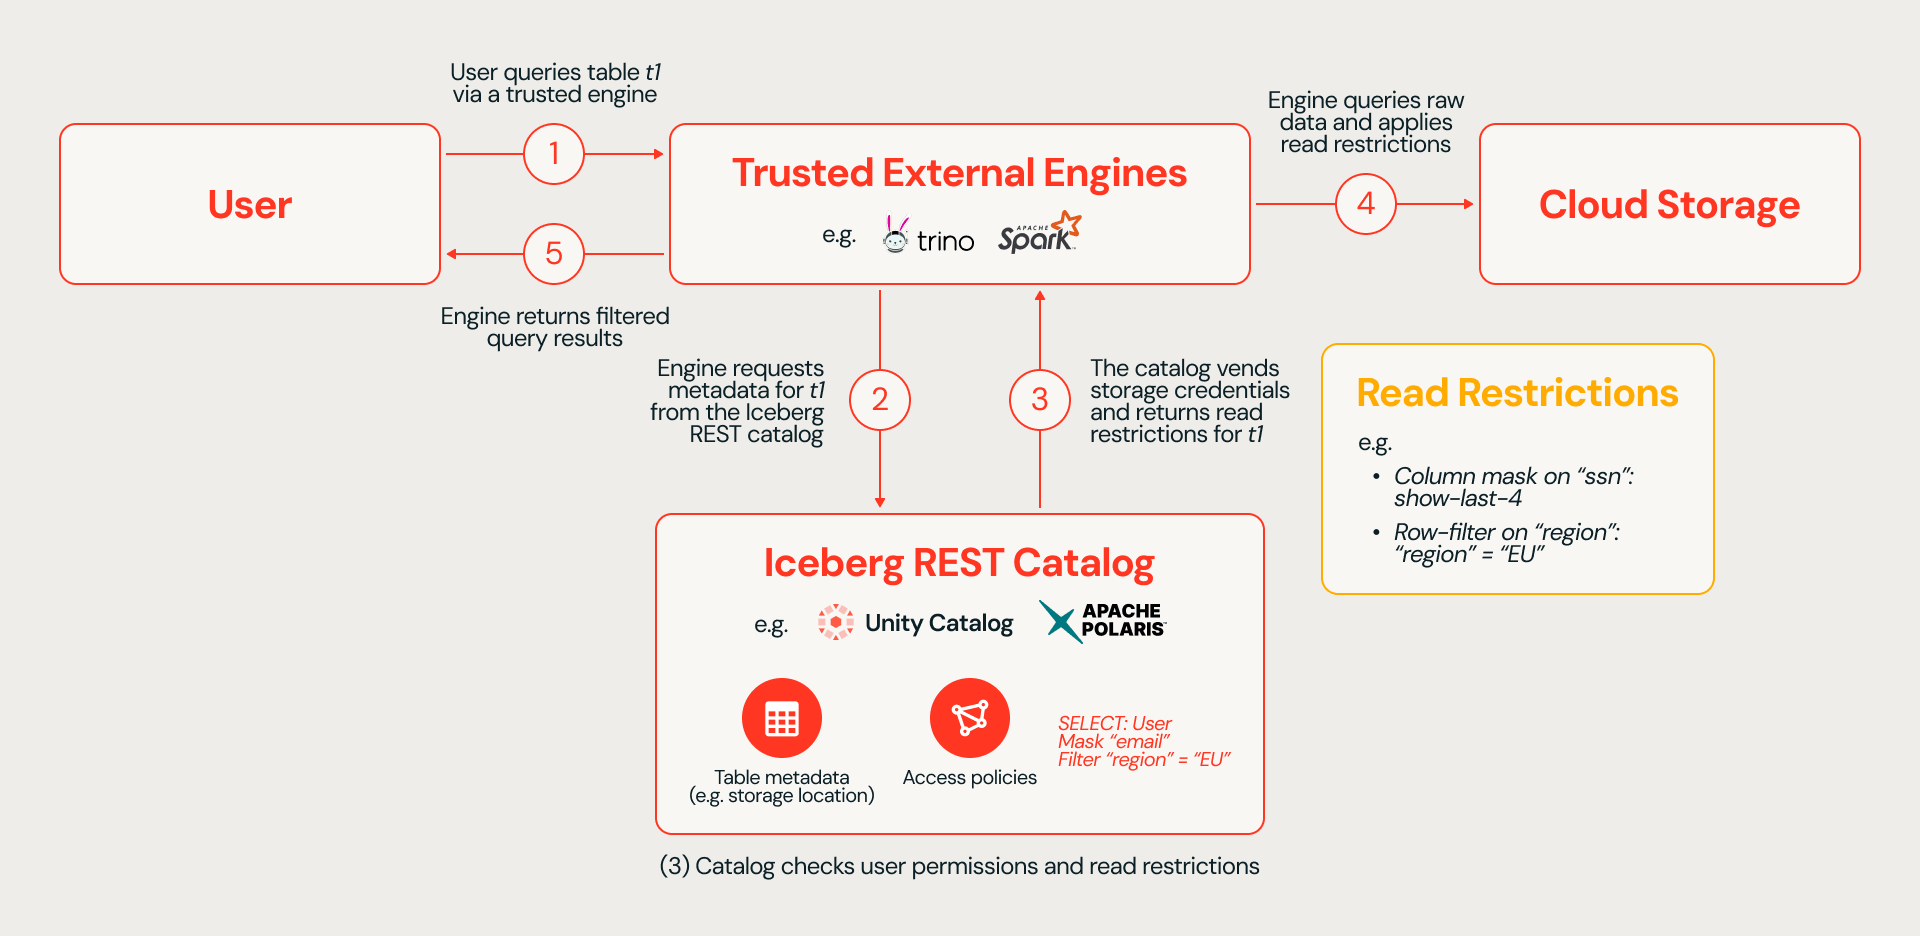
Duas decisões de design são importantes para entender o escopo atual da proposta.
Primeiro, o mecanismo não recebe a política conforme definida pelo administrador. Em vez disso, ele recebe o resultado para um principal específico, expresso como instruções de filtragem ou mascaramento que deve aplicar. Isso cria um contrato de aplicação comum entre o mecanismo e o catálogo. A especificação inicial define um vocabulário limitado: nove ações de projeção de coluna predefinidas e expressões de filtro de linha padronizadas, como comparações ou associação de conjunto. Muitas políticas corporativas do mundo real dependem de subconsultas, tabelas de pesquisa ou UDFs personalizadas, que não podem ser expressas no vocabulário de restrições de leitura. Isso tem uma implicação importante: as políticas só podem ser representadas quando o catálogo consegue reduzir seu resultado ao vocabulário definido pelo padrão; caso contrário, perde-se a semântica da política.
Segundo, a especificação define o que um mecanismo confiável deve aplicar, mas não como o catálogo estabelece essa relação de confiança. Uma declaração do cliente não é suficiente, portanto, os administradores de sistema e as implementações devem usar mecanismos de segurança apropriados para seu ambiente. As discussões da comunidade do Iceberg consideraram mecanismos como mTLS e OAuth, mas a confiança, em última análise, permanece fora do protocolo (discussão da comunidade do Iceberg).
As restrições de leitura são mais adequadas para cenários de acesso direto de mecanismo para catálogo, onde as políticas do catálogo de origem são simples e um mecanismo confiável pode aplicar a decisão resultante. Restam muitas dúvidas de implementação, como a forma pela qual um mecanismo propaga com segurança a identidade e os atributos do usuário final, como um catálogo distingue o usuário do mecanismo que age em seu nome e como as credenciais são vinculadas ao destinatário pretendido. À medida que as implementações surgem, estamos entusiasmados em colaborar com a comunidade do Iceberg para superar esses desafios e evoluir o padrão.
Rótulos de catálogo: tornando o contexto de governança portátil
Os rótulos de catálogo abordam um cenário diferente: governança em catálogos federados.
Muitas empresas agora conectam vários catálogos, como Unity Catalog, Snowflake, AWS Lake Formation e Google Cloud Knowledge Catalog, por meio de federação e APIs abertas. Isso é mais complexo do que uma integração de mecanismo para catálogo porque cada catálogo atende a seus próprios usuários, aplicativos e mecanismos por meio de modelos de identidade, linguagens de política e semânticas distintas.
Qualquer solução de governança unificada que funcione em escala corporativa deve:
- Preservar a expressividade das políticas. Os clientes devem ser capazes de definir regras sofisticadas, incluindo políticas baseadas em atributos e subconsultas complexas, e aplicá-las de forma consistente em sistemas heterogêneos.
- Fornecer auditabilidade e responsabilidade claras. Cada catálogo deve ser capaz de demonstrar conformidade de forma independente, sem exigir que os administradores reconciliem trilhas de auditoria em vários sistemas.
- Escalar sem colocar outro serviço de catálogo no caminho crítico. A descoberta com reconhecimento de permissões no Catálogo A não deve exigir uma chamada ao Catálogo B para cada usuário e ativo. For exemplo, a maioria das experiências de usuário no Unity Catalog reconhece permissões, e carregar o gerenciador de catálogos ou fornecer pesquisa preditiva poderia, de outra forma, exigir milhares de decisões por usuário que são difíceis de armazenar em cache, o que torna a experiência do usuário lenta e vincula o desempenho e a disponibilidade a outro serviço.
Os rótulos de catálogo, adotados recentemente pela comunidade Iceberg, são o primeiro passo em direção a essa visão. Os rótulos permitem que os catálogos troquem metadados leves de chave-valor no nível de tabela e coluna por meio de APIs abertas. Os rótulos podem indicar que um campo contém PII, associar um conjunto de dados a um domínio de negócios ou fornecer dicas semânticas para modelos de AI. Como a proposta é geral, os rótulos podem dar suporte a muitos casos de uso além do controle de acesso, incluindo descoberta, propriedade, atribuição de custos, contexto de AI e qualidade de dados.
Como funcionam os rótulos de catálogo
Quando um catálogo consumidor carrega uma tabela de um catálogo produtor por meio de federação de catálogos, o catálogo produtor retorna rótulos no nível de tabela e coluna.
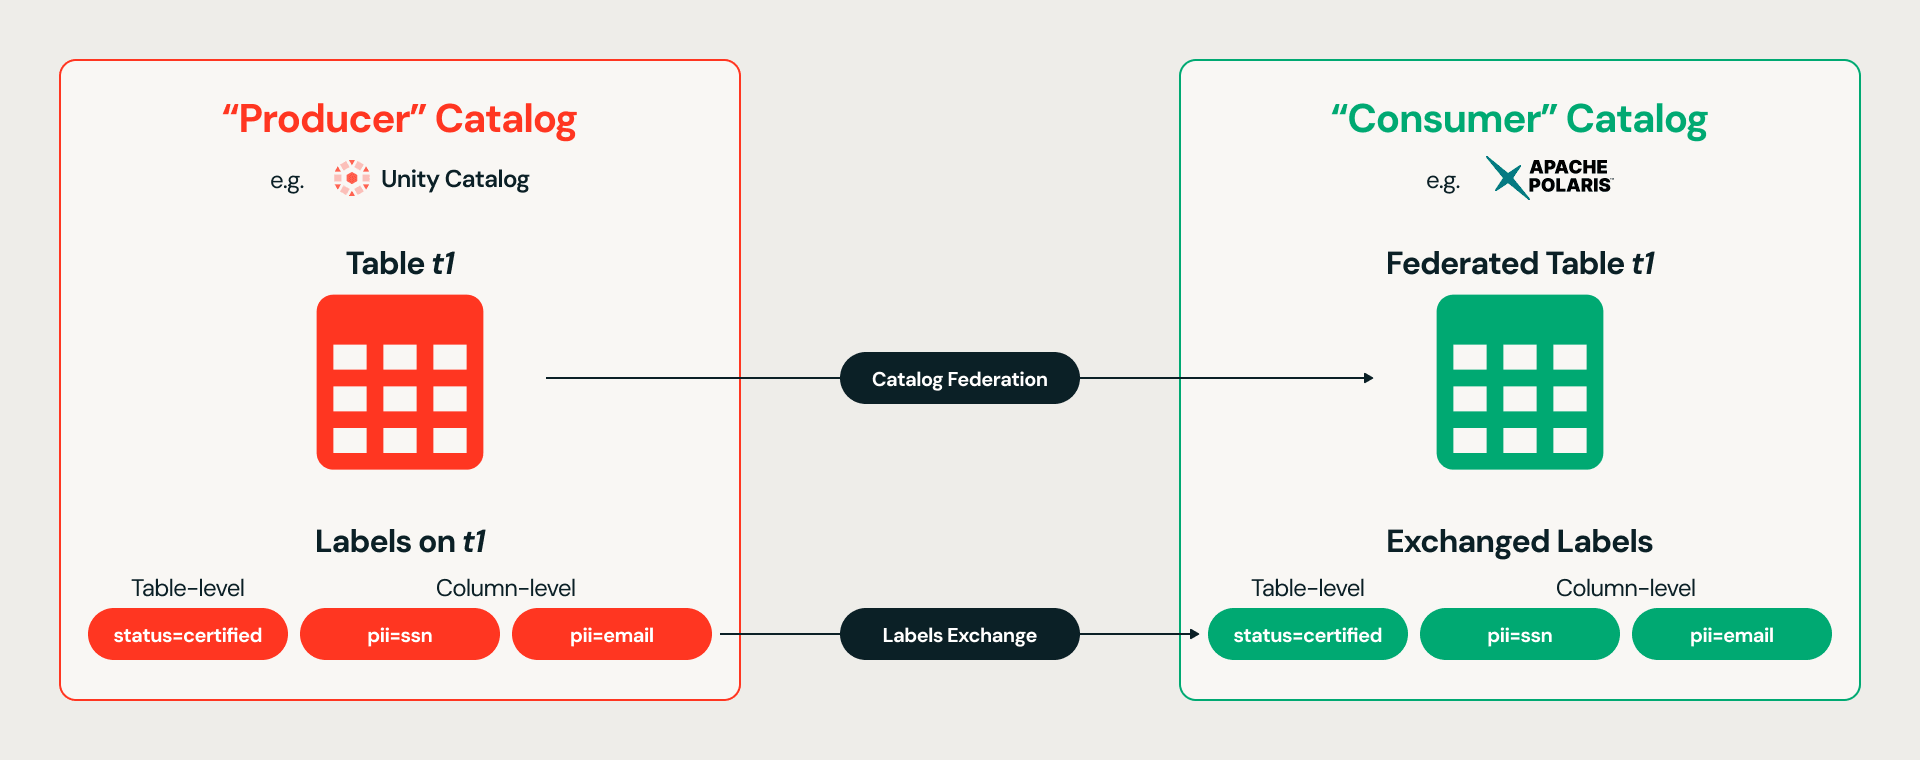
O catálogo consumidor então mapeia os rótulos em suas próprias classificações, atributos ou modelo de tag nativo. Em seguida, ele avalia o acesso usando suas identidades e políticas nativas e aplica controles em seu próprio ambiente de execução. Por exemplo, se um catálogo produtor rotular uma coluna ssn como pii=ssn, o catálogo consumidor poderá aplicar uma política baseada em tags que mascara as colunas que contêm esse rótulo.
Como a aplicação da política permanece local, o catálogo consumidor preserva a expressividade de suas políticas nativas e evita chamar o catálogo produtor para cada decisão de acesso. Cada catálogo também mantém de forma independente seus registros de aplicação e trilha de auditoria.
Vale a pena ter em mente que os rótulos são pares de chave-valor opacos. O padrão não define semânticas compartilhadas ou identificadores estáveis, e a linhagem dos rótulos não se estende além do catálogo de origem. O catálogo consumidor recebe apenas a chave e o valor resolvidos, não se o rótulo era destinado à descoberta, controle de acesso, atribuição de custos ou outra finalidade. Portanto, os rótulos tornam os metadados portáteis, mas não o seu significado; as empresas ainda precisam de convenções compartilhadas ou mapeamentos explícitos para interpretar os rótulos de forma consistente.
Os rótulos de catálogo são mais adequados para cenários de catálogo para catálogo com federação entre sistemas heterogêneos, onde o catálogo consumidor tem seu próprio sistema de governança e precisa de contexto reutilizável, em vez de uma decisão de acesso separada para cada usuário e solicitação. A ideia central é que a governança e o contexto de negócios, assim como os metadados de tabela, devem ser abertos e portáteis por meio das APIs REST Catalog do Iceberg.
Escolhendo o modelo certo
O modelo certo depende do destino: aplicação centralizada para um mecanismo não confiável, restrições de leitura para um mecanismo confiável e rótulos de catálogo para troca aberta de metadados quando o destino for outro catálogo com seu próprio sistema de governança.
Aplicação centralizada por meio de planejamento de varredura | Restrições de leitura | Rótulos de catálogo | |
Como funciona | O catálogo de origem avalia e aplica a política por meio de um serviço de filtragem seguro, retornando apenas dados autorizados | No momento da consulta, o catálogo informa ao mecanismo quais restrições aplicar para esse usuário e ativo específicos - por exemplo, “aplicar mask_alphanum na coluna 12” | Os catálogos compartilham informações adicionais de governança ou de negócios sobre uma determinada tabela - por exemplo, “a coluna 12 tem a classificação pii=ssn” |
Mais adequado para | Acesso direto a partir de um mecanismo não confiável, como um ambiente de execução do Spark ou DuckDB controlado pelo usuário | Acesso direto do mecanismo ao catálogo, onde a origem avalia a política e um mecanismo confiável aplica o resultado | Federação entre sistemas heterogêneos com sua própria identidade, política e ambiente de execução de aplicação |
Identidade e segurança | O cliente deve traduzir e passar conceitos de identidade (funções, grupos, etc.) para o catálogo. A aplicação permanece dentro do limite de confiança do catálogo, de modo que dados não autorizados nunca chegam ao mecanismo. | O cliente deve traduzir conceitos de identidade (principais, funções, grupos, atributos de usuário) para algo que o catálogo entenda e passar esses atributos como parte do contexto da solicitação | O destino usa as identidades e atributos que já entende, reduzindo o contexto confidencial trocado entre os sistemas |
Escala, desempenho e disponibilidade | O planejamento de varredura no lado do servidor pode otimizar o acesso aos dados, mas o roteamento de consultas governadas por meio de uma frota de filtros adiciona latência e uma dependência operacional em comparação com a aplicação no mecanismo consumidor. | O catálogo de destino não pode mais reutilizar uma tabela armazenada em cache entre seus usuários porque as respostas da tabela tornam-se específicas do usuário. Isso faz com que experiências como navegação, pesquisa e preenchimento automático exijam um cache por usuário ou exijam uma chamada separada ao catálogo de origem para cada ação do usuário. | O contexto de governança pode ser armazenado em cache e atualizado para que a pesquisa, a navegação e outras experiências do usuário sejam executadas nativamente |
Governança e auditabilidade | O catálogo de origem retém sua expressividade total de política nativa e registra a avaliação e aplicação da política dentro do mesmo ambiente confiável | As decisões são limitadas ao vocabulário compartilhado do padrão. Os registros de auditoria são divididos entre os sistemas de origem e de destino. | O destino usa seu mecanismo de política nativo e mantém um registro de ponta a ponta da avaliação e aplicação |
Conclusão | Use quando o catálogo de origem deve garantir que dados não autorizados nunca cheguem a um mecanismo não confiável | Use quando o destino for um mecanismo confiável e as políticas de origem puderem ser totalmente expressas com restrições de leitura | Use quando o destino for outro catálogo que precisa de governança escalável em velocidade nativa entre seus usuários e mecanismos |
O que vem a seguir
As restrições de leitura e os rótulos de catálogo resolvem dois problemas distintos e importantes para a governança multiplataforma. As restrições de leitura oferecem aos catálogos uma maneira padrão de delegar a aplicação a mecanismos confiáveis. Os rótulos de catálogo tornam a governança e o contexto de negócios portáteis entre catálogos, assim como seus dados. Juntamente com a aplicação centralizada por meio de Cross-Engine ABAC, eles oferecem às empresas um conjunto prático de opções para governar dados de forma consistente em diferentes mecanismos e catálogos.
Parabéns à comunidade Apache Iceberg por adotar ambas as propostas. Embora haja mais trabalho pela frente, este é um grande marco. Estamos entusiasmados em ver mais partes do ecossistema adotando esses blocos de construção fundamentais e em continuar trabalhando com a comunidade para tornar a governança unificada no lakehouse aberto uma realidade.
1As diretrizes de segurança do próprio Apache Spark afirmam que o código enviado pelo usuário é executado sem restrições em seu comportamento e dão aos usuários controle sobre os recursos atribuídos à sua aplicação. Uma extensão do Spark pode implementar restrições de leitura, mas a implantação se qualifica como confiável apenas quando os administradores controlam o runtime e eliminam todos os caminhos para contornar a aplicação, pois ela carece de uma API de controle de acesso em nível de tabela, muito menos de uma para controle de acesso refinado (discussão da comunidade Iceberg).
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.