Árvores de decisão escaláveis no MLlib
por Manish Amde e Joseph Bradley
Árvores de decisão e seus conjuntos são os principais pontos de referência do setor para as tarefas de machine learning de classificação e regressão. As árvores de decisão são fáceis de interpretar, lidam com recursos categóricos e contínuos, se estendem à classificação multiclasse, não exigem escalonamento de recursos e são capazes de capturar não-linearidades e interações de recursos.
Devido à sua popularidade, quase todas as bibliotecas de machine learning fornecem uma implementação do algoritmo da árvore de decisão. No entanto, a maioria é projetada para computação em uma única máquina e raramente é dimensionada com elegância para um ambiente distribuído. O Apache Spark é uma plataforma ideal para uma implementação de árvore de decisão distribuída escalável, já que a computação em memória do Spark nos permite realizar eficientemente várias passagens sobre o conjunto de dados de treinamento.
Há cerca de um ano, desenvolvedores de código aberto uniram forças para criar uma implementação rápida de árvore de decisão distribuída que faz parte da biblioteca Spark MLlib desde a versão 1.0. A comunidade Spark tem melhorado ativamente o código da árvore de decisão desde então. Esta postagem do blog descreve a implementação, destacando algumas das otimizações importantes e apresentando os resultados dos testes que demonstram a escalabilidade.
Novo no Spark 1.1: as árvores de decisão do MLlib agora oferecem suporte à classificação multiclasse e incluem várias otimizações de desempenho. Agora, há APIs para Python, além de Scala e Java.
Histórico do algoritmo
Em linhas gerais, um modelo de árvore de decisão pode ser considerado como declarações hierárquicas se-senão que testam valores de recurso para prever um rótulo. Um modelo de exemplo para uma tarefa de classificação binária é mostrado abaixo. Ele se baseia em dados de quilometragem do carro da década de 1970! Ele prevê a quilometragem do veículo (alta/baixa) com base no peso (pesado/leve) e na potência.
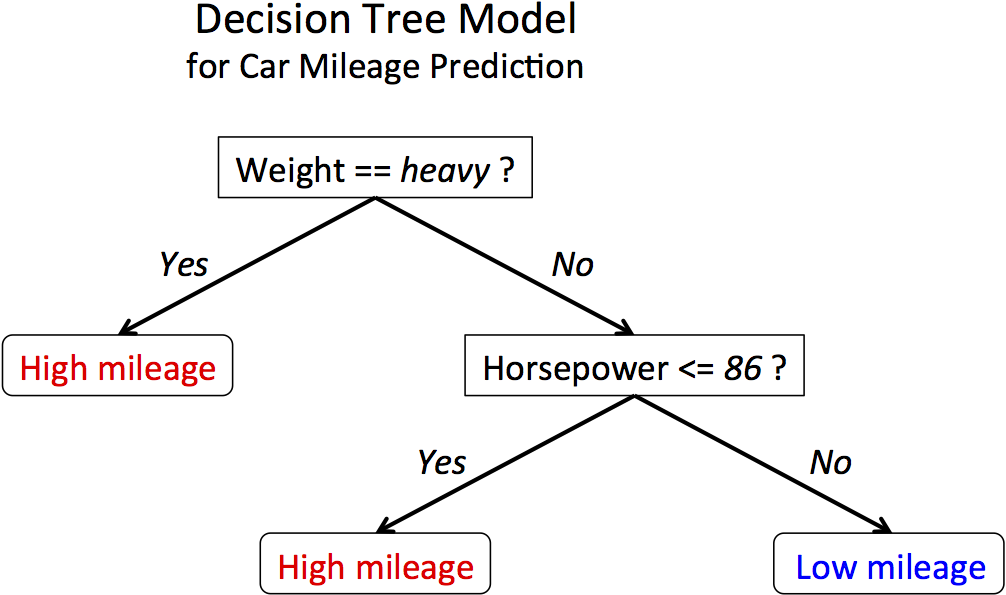
Um modelo é aprendido a partir de um conjunto de dados de treinamento criando uma árvore de cima para baixo. As instruções if-else, também conhecidas como critérios de divisão, são escolhidas para maximizar a noção de ganho de informações: elas reduzem a variabilidade dos rótulos nos (dois) nós filhos subjacentes em comparação com o nó pai. O modelo de árvore de decisão aprendido pode ser usado posteriormente para prever os rótulos de novas instâncias.
Esses modelos são interpretáveis e, muitas vezes, funcionam bem na prática. As árvores também podem ser combinadas para construir modelos ainda mais poderosos, usando algoritmos de árvore de ensemble. Conjuntos de árvores, como florestas aleatórias e árvores boosted, geralmente têm o melhor desempenho do setor para tarefas de classificação e regressão.
API simples
O exemplo abaixo mostra como uma árvore de decisão no MLlib pode ser facilmente treinada usando algumas linhas de código usando a nova API Python no Spark 1.1. Ele lê um conjunto de dados, treina um modelo de árvore de decisão e, em seguida, mede o erro de treinamento do modelo. Exemplos de Java e Scala podem ser encontrados na documentação do Spark no DecisionTree.
Implementação otimizada
O Spark é uma plataforma de compute ideal para uma implementação de árvore de decisão distribuída escalável devido ao seu sofisticado mecanismo de execução DAG e cache em memória para cálculo iterativo. Mencionamos algumas otimizações importantes.
Treinamento por nível: selecionamos as divisões para todos os nós no mesmo nível da árvore simultaneamente. Essa otimização em níveis reduz exponencialmente o número de passagens pelo conjunto de dados: fazemos uma passagem para cada nível, em vez de uma para cada nó da árvore. Isso gera economias significativas em E/S, compute e comunicação.
Quantis aproximados: implementações de máquina única normalmente usam valores de recurso únicos classificados para recursos contínuos como candidatos a divisão para o melhor cálculo de divisão. No entanto, encontrar valores exclusivos classificados é uma operação cara em um conjunto de dados distribuído. A árvore de decisão da MLlib usa quantis para cada recurso como candidatos divididos. É uma alternativa padrão para melhorar o desempenho da árvore de decisão sem perda significativa de precisão.
Evitar a operação de mapeamento: as primeiras implementações de protótipos da árvore de decisão usavam operações de mapeamento e redução ao selecionar as melhores divisões para os nós da árvore. O código atual utiliza significativamente menos cálculo e comunicação, explorando a estrutura conhecida dos candidatos a divisões pré-computados para evitar a etapa de mapeamento.
Cálculo por bin: o melhor cálculo por divisão discretiza os recursos em bits, e esses bits são usados para calcular estatísticas suficientes para dividir. Pré-computamos as representações binadas de cada instância, economizando cálculo em cada iteração.
Escalabilidade
Demonstramos a escalabilidade das árvores de decisão do MLlib com resultados empíricos em vários conjuntos de dados e tamanhos de cluster.
Dimensionamento com o tamanho do dataset
As duas figuras abaixo mostram os tempos de treinamento das árvores de decisão à medida que dimensionamos o número de instâncias e recursos no conjunto de dados. Os tempos de treinamento aumentaram linearmente, destacando a escalabilidade da implementação.
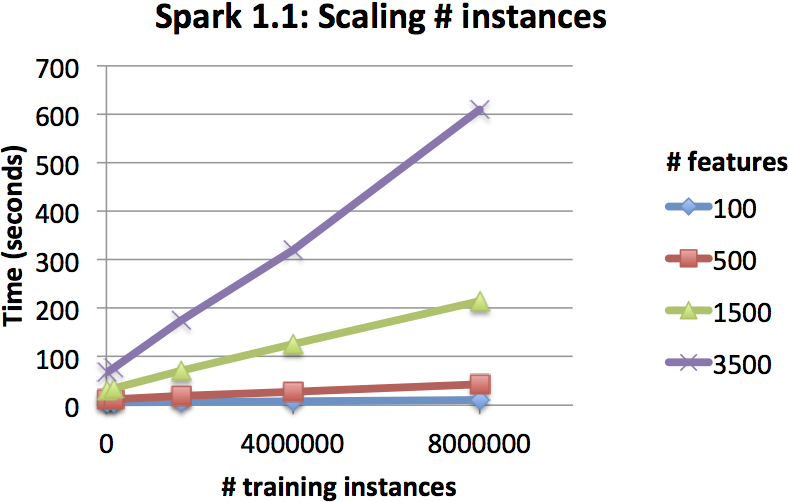
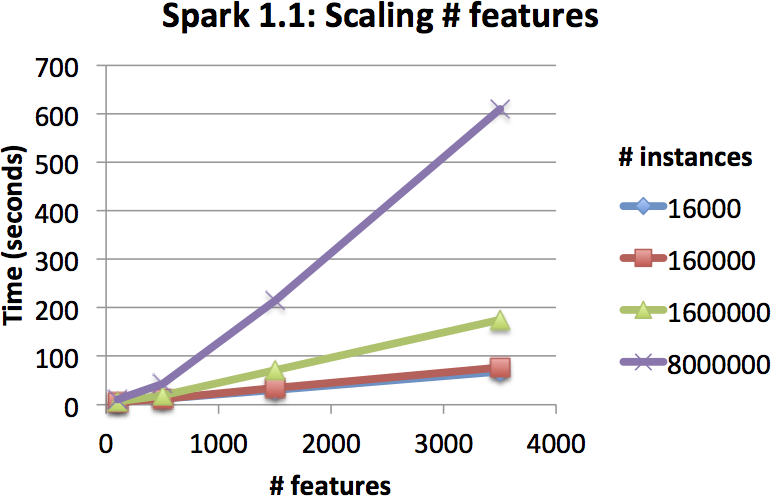
Estes testes foram executados em um cluster EC2 com um nó master e 15 nós worker, usando instâncias r3.2xlarge (8 CPUs virtuais, 61 GB de memória). As árvores foram construídas em 6 níveis, e os conjuntos de dados foram gerados pela biblioteca spark-perf.
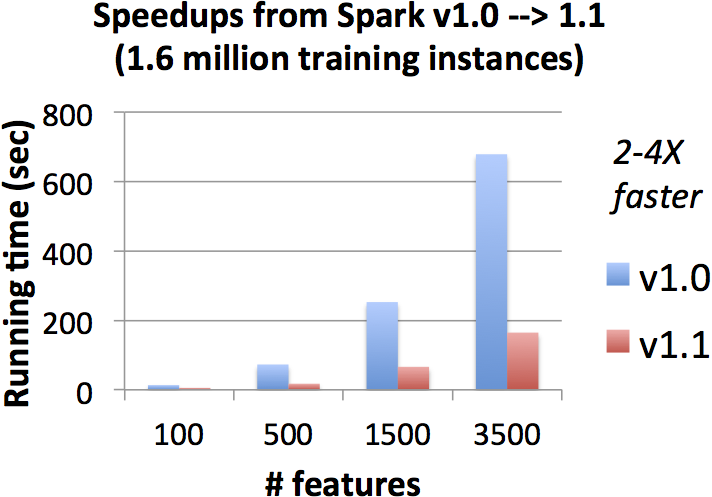
Acelerações do Spark 1.1
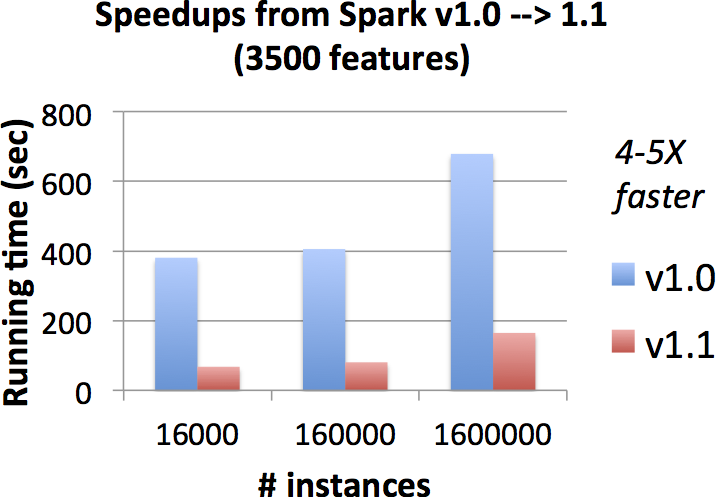
As duas figuras a seguir mostram melhorias no Apache Spark 1.1, em relação à implementação original do Apache Spark 1.0. Nos mesmos conjuntos de dados e cluster, a nova implementação é 4 a 5 vezes mais rápida em muitos conjuntos de dados.
Qual é o próximo passo?
O desenvolvimento de algoritmos baseados em árvore após a versão 1.1 se concentrará principalmente em algoritmos de conjunto, como florestas aleatórias e boosting. Também continuaremos otimizando o código da árvore de decisão para desempenho e planejamos adicionar suporte a mais opções nas próximas versões.
Para começar a usar árvores de decisão, baixe o Spark 1.1 hoje mesmo!
Leitura adicional
- Consulte os exemplos e a API na documentação da árvore de decisão do MLlib.
- Assista à apresentação da árvore de decisão do Spark Summit 2014.
- Confira o vídeo e os slides de outra palestra sobre árvores de decisão em um encontro de SF Scala/Bay Area Machine Learning em setembro de 2014.
Agradecimentos
O trabalho de árvore de decisão do Spark MLlib foi inicialmente realizado em conjunto com Hirakendu Das (Yahoo Labs), Evan Sparks (UC Berkeley AMPLab) e Ameet Talwalkar e Xiangrui Meng (Databricks). Desde então, mais colaboradores se juntaram, e sua opinião também é bem-vinda!
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.