Traga o Databricks para o Kiro IDE com o Databricks Power
Duas formas de conectar o Kiro IDE à plataforma Databricks: os quatro servidores MCP gerenciados pelo Databricks para começar em 10 minutos, ou o Databricks Power e as habilidades de agente oficiais para ter todos os recursos.
- Duas formas de conectar o Kiro IDE ao Databricks: os quatro servidores MCP gerenciados pelo Databricks (Genie, SQL, Unity Catalog Functions, AI Search) para uma configuração em 10 minutos baseada em PAT, ou o Databricks Power, que instala as habilidades de agente oficiais do Databricks com a Databricks CLI.
- Desenvolvimento assistido por IA baseado em metadados reais do workspace: os dois caminhos herdam suas permissões do Unity Catalog, seus filtros de linha e suas máscaras de coluna, para que o assistente escreva SQL com suas colunas reais e veja apenas o que você pode ver.
- Escolha pelo escopo: o caminho A é a configuração mais leve para analistas e desenvolvedores focados em SQL; o caminho B abre toda a plataforma Databricks (pipelines, jobs, Agent Bricks, Lakebase, Declarative Automation Bundles) dentro do IDE.
Por que isso é importante
O desenvolvimento assistido por IA desmorona no momento em que o assistente precisa adivinhar nomes de colunas, a estrutura das tabelas ou quais catálogos você pode ler. A solução é o grounding: conecte o assistente aos metadados em tempo real do workspace por meio do Model Context Protocol (MCP). Assim, o SQL que ele escreve usa suas colunas reais, os modelos dbt fazem join de tabelas reais e cada consulta herda as permissões do Unity Catalog que você já configurou. O acesso é aplicado no Databricks, então a IA vê apenas o que você pode ver.
Dois marcos recentes tornam isso prático no Kiro IDE, criado pela AWS:
Primeiro, o Kiro agora é um agente compatível com a Databricks CLI. Desde a CLI v1.20.0, databricks aitools install --agents kiro instala as habilidades de agente oficiais do Databricks em ~/.kiro/skills/. As habilidades que antes vinham no Databricks AI Dev Kit agora são essas habilidades oficiais, e a CLI as instala.
Segundo, o Databricks Power no catálogo Kiro Powers agora instala essas mesmas habilidades oficiais: ele configura as habilidades com a Databricks CLI e não inclui nenhum servidor MCP. Instale-o pelo painel Powers; a habilidade de configuração dele guia você pela verificação da CLI, pelo login e pela instalação das habilidades.
Junto com os quatro servidores MCP remotos gerenciados pelo Databricks que já fazem parte da plataforma, você tem duas formas de conectar o Kiro ao Databricks. As duas levam ao mesmo resultado: os desenvolvedores entregam análises, pipelines e workflows de agentes mais rápido quando o assistente herda as permissões reais do workspace em vez de adivinhar esquemas, colunas e permissões.
Por que o Databricks para desenvolvimento assistido por IA
Os dois marcos acima tornam o Kiro × Databricks prático. O que realmente importa é o que está por baixo. Quatro aspectos fazem do Databricks a base preferida para o desenvolvimento assistido por IA, seja qual for o caminho escolhido.
O Unity Catalog ancora a IA no nível dos dados. Cada chamada é executada com suas próprias permissões, seja uma ferramenta MCP no caminho A ou um comando da Databricks CLI executado por uma habilidade no caminho B: as permissões de tabela, os filtros de linha e as máscaras de coluna se aplicam ao SQL e aos agentes do Genie, e os índices do AI Search são compartilhados individualmente. O assistente não tem uma visão privilegiada dos seus dados; ele vê o que você vê. Não existe uma camada separada de controle de acesso para gerenciar para o assistente.
Uma única cópia dos dados, um único conjunto de definições. Como o Databricks é um lakehouse, a tabela que o assistente consulta pelo databricks-sql é a mesma em que seu modelo dbt grava, a mesma que seu agente do Genie expõe e a mesma que seu dashboard de AI/BI lê. Não existe sincronização entre warehouse e lake que possa quebrar, nem uma camada semântica separada para manter em sincronia. Quando o assistente se baseia em samples.tpch.lineitem, ele usa a mesma definição que todas as outras ferramentas.
Toda a pilha de IA é integrada, não adicionada depois. O Unity Gateway roteia as chamadas aos modelos. O Agent Bricks orquestra workflows multiagente. O MLflow acompanha experimentos e avaliações. O AI Search potencializa a recuperação semântica. O Lakebase gerencia o estado transacional. As habilidades cobrem tudo isso (databricks-unity-gateway, databricks-agent-bricks, databricks-mlflow-evaluation, databricks-vector-search e databricks-lakebase), tudo no mesmo Unity Catalog. Você não está juntando cinco produtos; está usando uma única plataforma.
As habilidades são criadas pelo Databricks. Os protocolos são abertos, mas as orientações dentro das habilidades são escritas pelo Databricks especificamente para a forma como nossos clientes desenvolvem.
Os dois caminhos em resumo
Aspecto | Caminho A: servidores MCP gerenciados | Caminho B: Databricks Power |
|---|---|---|
Escopo | 4 servidores: Genie, SQL, Unity Catalog Functions, AI Search | Habilidades de agente oficiais do Databricks, mais as habilidades do MLflow |
O que você recebe | SQL em linguagem natural, pesquisa semântica, execução de funções governada | O escopo do caminho A, mais pipelines, jobs, dashboards, Lakebase, Agent Bricks, Declarative Automation Bundles, MLflow, Model Serving e Apps |
Hospedagem | Gerenciado pelo Databricks (HTTPS remoto) | Habilidades instaladas na sua máquina pela Databricks CLI (databricks aitools); sem servidor MCP |
Autenticação | PAT no ambiente do shell | Perfil da Databricks CLI, OAuth U2M recomendado |
Configuração | Editar ~/.kiro/settings/mcp.json e exportar as variáveis de ambiente | Instalar o Power e seguir a configuração guiada da CLI |
Ideal para | Analistas e desenvolvedores focados em SQL que querem fazer uma pergunta ao warehouse em 10 minutos | Engenheiros de dados e desenvolvedores de plataforma que precisam de todos os recursos do Databricks em um único IDE |
A arquitetura de integração em resumo
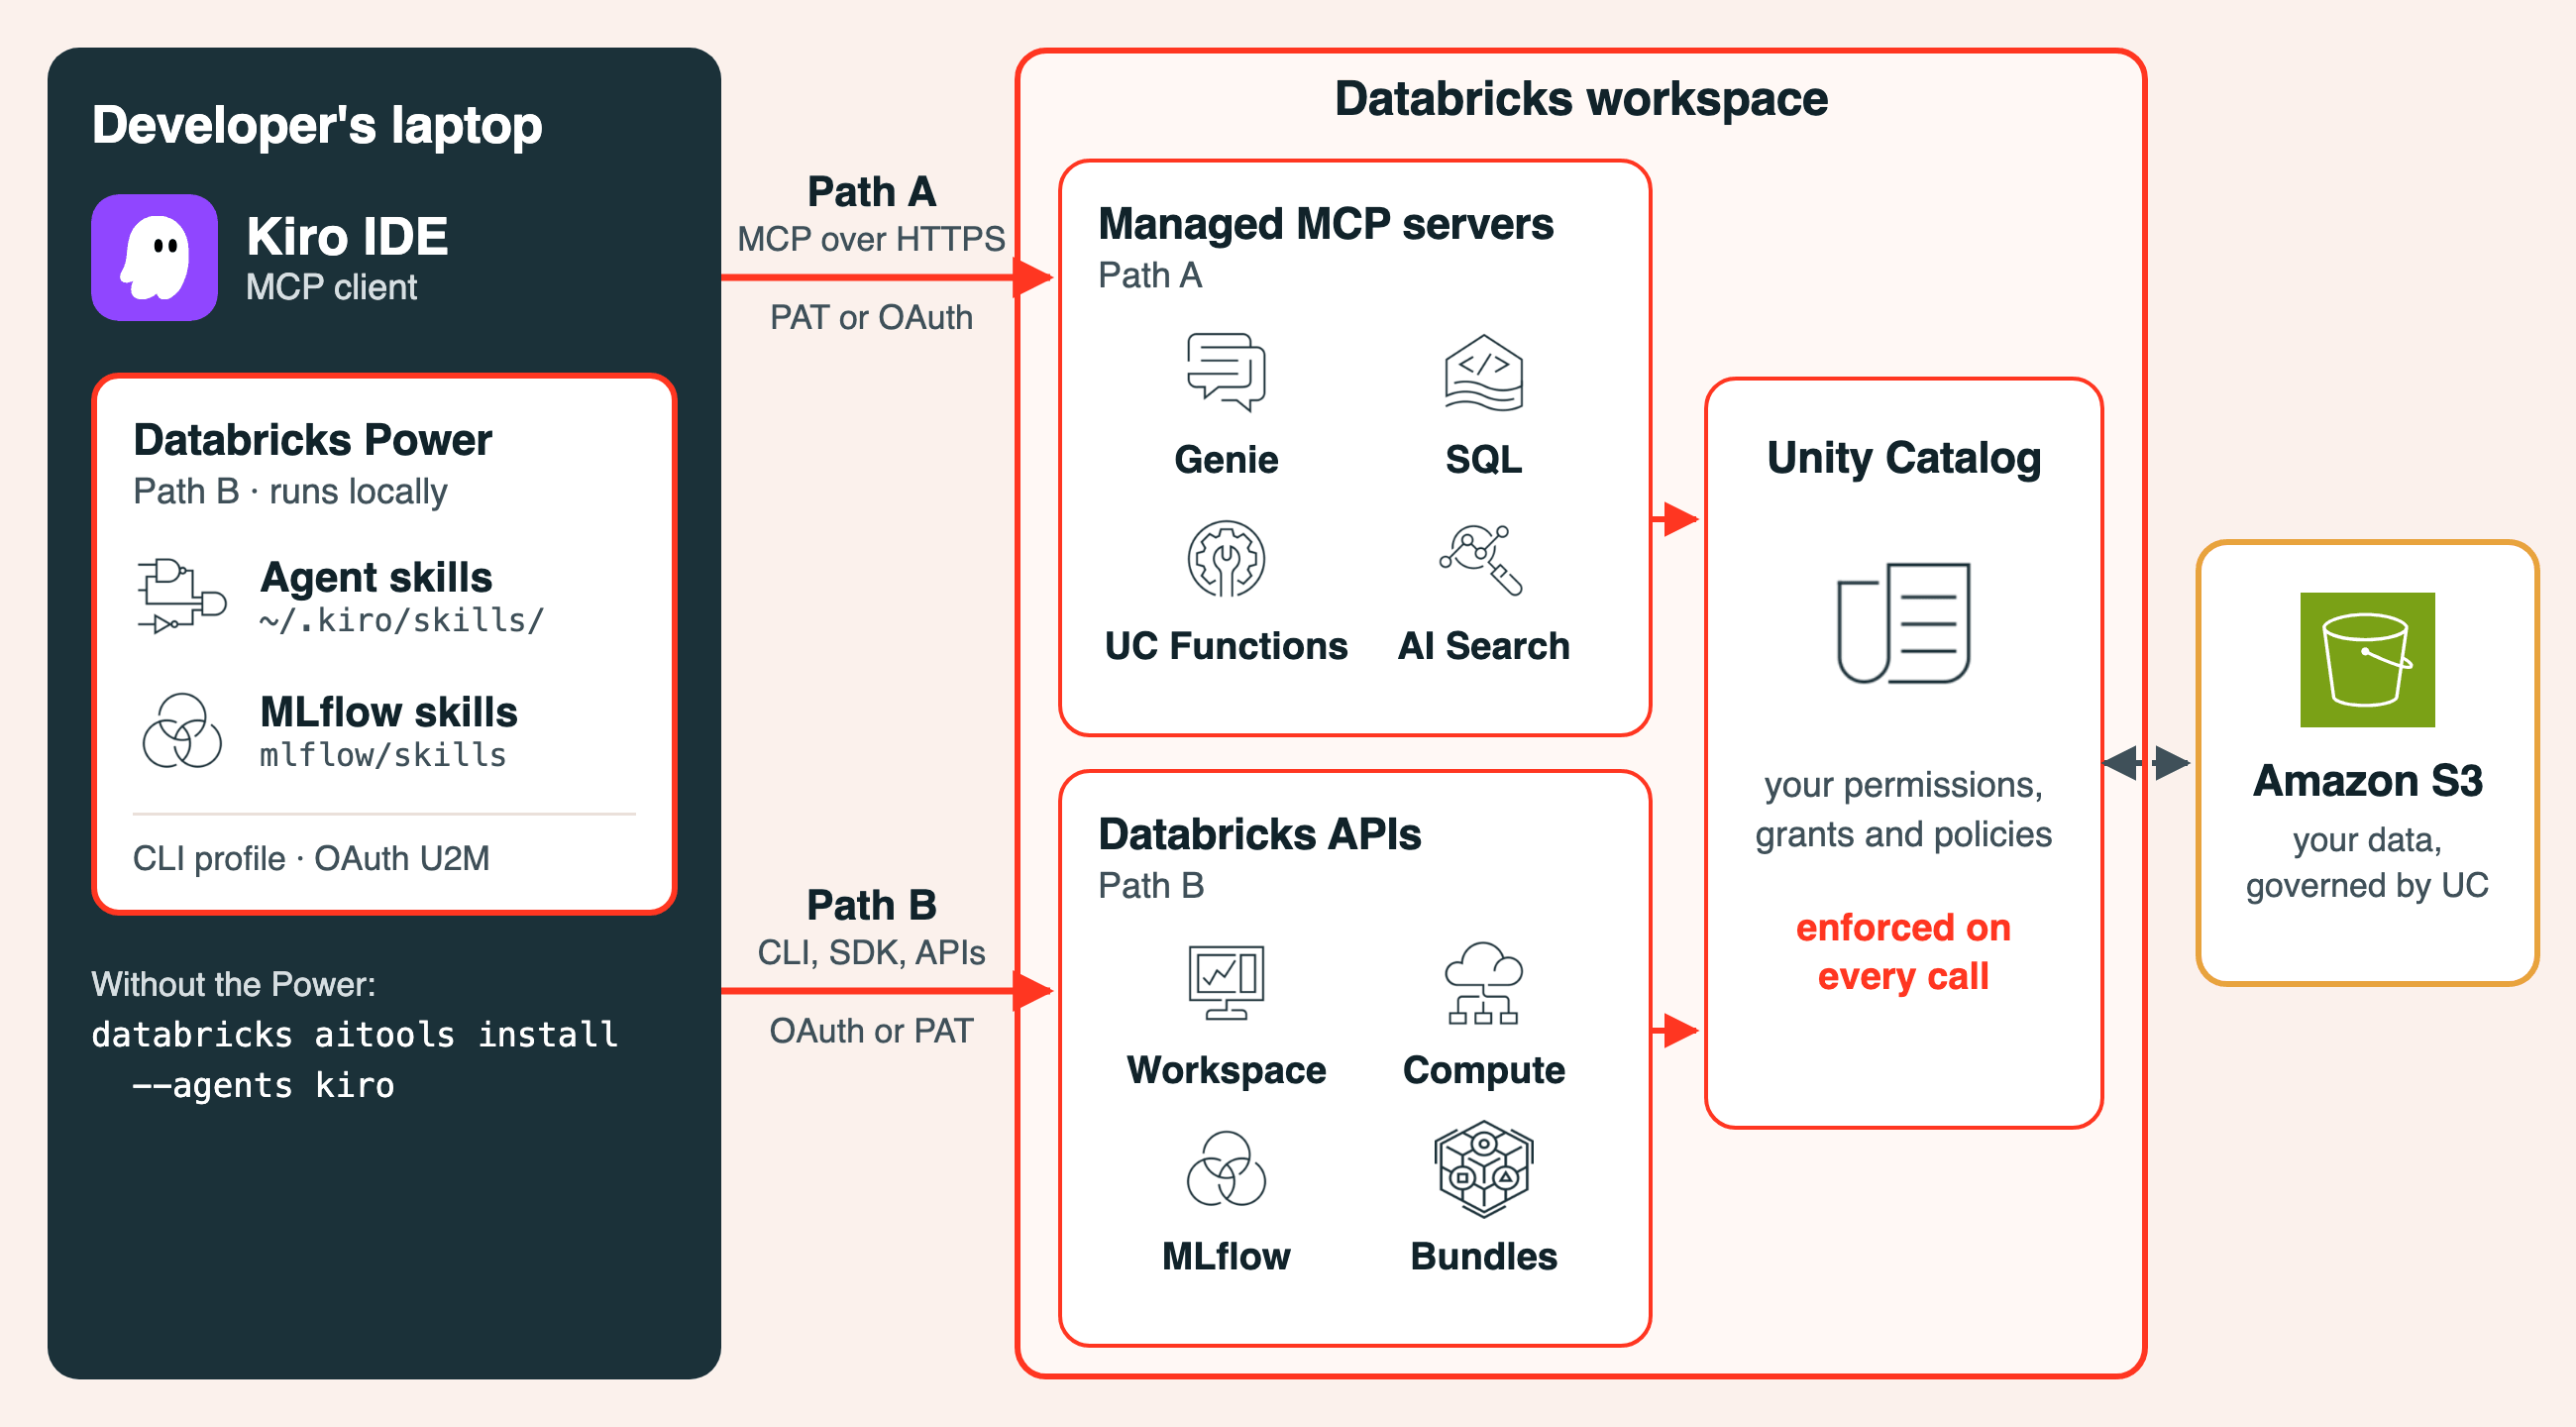
Os dois caminhos compartilham o mesmo back-end: a aplicação das regras pelo Unity Catalog e a identidade do workspace do Databricks. Eles diferem no escopo e no modelo de autenticação.
Caminho A: conecte-se aos quatro servidores MCP gerenciados
Esta é a configuração mais leve: um arquivo mcp.json, um Personal Access Token do Databricks e uma alteração no perfil do shell. Em menos de 10 minutos, o Kiro está se comunicando com Genie, SQL, Unity Catalog Functions e AI Search.
Para novas integrações, o Databricks agora recomenda os MCPs system.ai por meio do Unity Gateway. Os quatro endpoints /api/2.0/mcp deste caminho estão em Public Preview e não são governados pelo Unity Gateway. O acesso continua seguindo suas permissões nos recursos subjacentes (agentes do Genie, tabelas, funções, índices e SQL warehouses); você abre mão apenas do rastreamento do Unity Gateway e das permissões, políticas e proteções dele no nível do MCP. O MCP do Genie One (system.ai.genie_one_mcp) está disponível para todos, e a habilidade de configuração do Databricks Power mostra como adicioná-lo ao mcp.json. Consulte Databricks-provided MCPs para ver as duas opções.
Pré-requisitos
- Um workspace do Databricks na AWS com o Unity Catalog habilitado.
- Um administrador do workspace habilitou Managed MCP Servers na página Previews do workspace. Sem isso, as URLs abaixo não funcionam.
- Um Personal Access Token (PAT) do Databricks ou um token OAuth com escopo para os servidores MCP que você vai usar (
sql,unity-catalog,genie,ai-search). PATs não utilizados são revogados automaticamente após 90 dias. - O Kiro instalado e aberto pelo menos uma vez, para que
~/.kiro/exista. - O nome de host do seu workspace no formato
<workspace>.cloud.databricks.com.
Gere um PAT do Databricks
No workspace do Databricks, acesse Settings, Developer, Access tokens, Manage, Generate new token. Defina uma data de expiração alinhada à política de rotação da sua equipe. Selecione apenas os escopos de API de que você precisa; o privilégio mínimo é melhor do que a conveniência de "tudo". Copie o token imediatamente. O Databricks não o exibe novamente.
Onde o Kiro armazena a configuração do MCP
O Kiro lê a configuração do MCP em JSON a partir de dois escopos; o escopo do workspace tem prioridade sobre o do usuário.
- Escopo do usuário:
~/.kiro/settings/mcp.jsonse aplica a todos os workspaces. - Escopo do workspace:
$PWD/.kiro/settings/mcp.jsonse aplica apenas ao workspace atual e substitui a entrada com a mesma chave do escopo do usuário.
Instalação com um clique pelo diretório de servidores do Kiro
Abra kiro.dev/docs/mcp/servers/, encontre a linha do Databricks e clique em Add to Kiro. O navegador abre o Kiro e exibe uma caixa de diálogo de confirmação com uma configuração pré-preenchida. Confirme para gravar a entrada databricks-sql em ~/.kiro/settings/mcp.json. Ela chega desativada, com uma URL de exemplo e uma referência à variável DATABRICKS_ACCESS_TOKEN. Em seguida, defina a URL como ${DATABRICKS_SQL_MCP_URL}, altere "disabled" para false e crie as duas variáveis.
Verifique (ou adicione) a entrada databricks-sql
Defina as variáveis de ambiente
No perfil do shell que abre o Kiro (normalmente ~/.zshrc no macOS):
Recarregue o perfil (source ~/.zshrc) antes de abrir o Kiro. Feche o Kiro completamente (Cmd+Q no macOS) e abra-o de novo. O Reload Window não lê novamente as variáveis de ambiente; só a reinicialização do processo faz isso.
O Kiro só expande referências ${...} em mcp.json para variáveis de ambiente que você aprovou. Quando o Kiro mostrar o aviso de segurança com a lista de variáveis DATABRICKS_*, aprove-as, ou adicione-as você mesmo em Settings, Mcp Approved Env Vars.
Adicione Genie, Unity Catalog Functions e AI Search
Os quatro servidores gerenciados pelo Databricks se conectam como MCP HTTP remotos. O handshake initialize funciona até com uma URL de exemplo; o servidor só valida o recurso quando uma ferramenta é invocada. Um estado conectado, mas com falha, em que tools/call retorna RESOURCE_DOES_NOT_EXIST ou PERMISSION_DENIED, é o problema mais comum. Faça primeiro estas verificações prévias:
- Genie: confirme que existe um agente do Genie e que você consegue abri-lo. Copie o ID do espaço na guia Settings do agente (a interface o chama de Agent ID); ele é o
<genie_space_id>na tabela de URLs abaixo. - Unity Catalog Functions: confirme que a função existe e que você tem
EXECUTE. Liste as funções comSELECT * FROM system.information_schema.routines WHERE routine_type = 'FUNCTION'. - AI Search: confirme que existe um endpoint com pelo menos um índice acessível.
- Escopo do PAT: um PAT com escopo de workspace ainda pode gerar
PERMISSION_DENIEDse o usuário não tiver acesso ao recurso específico: Can View no agente do Genie, ouSELECTno índice do AI Search (maisUSE CATALOGeUSE SCHEMA). Os agentes do Genie são compartilhados individualmente.
Adicione as variáveis de ambiente extras (DATABRICKS_GENIE_MCP_URL, DATABRICKS_UC_FUNCTIONS_MCP_URL, DATABRICKS_AI_SEARCH_MCP_URL) e atualize mcp.json com a configuração completa:
Formatos de URL por servidor:
Servidor | Padrão de URL |
|---|---|
databricks-genie | https://<workspace-hostname>/api/2.0/mcp/genie/<genie_space_id> |
databricks-sql | https://<workspace-hostname>/api/2.0/mcp/sql |
databricks-uc-functions | https://<workspace-hostname>/api/2.0/mcp/functions/<catalog>/<schema>/<function_name> |
databricks-ai-search | https://<workspace-hostname>/api/2.0/mcp/ai-search/<catalog>/<schema>/<index_name> |
Feche e abra o Kiro novamente. Abra a seção MCP SERVERS do painel do Kiro; as quatro entradas databricks-* aparecem com indicadores de status verdes. Clique em reconnect em qualquer uma que esteja vermelha e refaça as verificações prévias. Experimente uma primeira consulta de baixo risco no painel de chat: "List the catalogs I have access to."
Caminho B: instale o Databricks Power
Os quatro servidores gerenciados cobrem SQL, pesquisa semântica e análise em linguagem natural, o que basta para muitos desenvolvedores. Se o seu workflow envolve pipelines, jobs, Model Serving, Lakebase, Declarative Automation Bundles, Agent Bricks, dashboards de AI/BI, MLflow ou Databricks Apps, a configuração com quatro servidores faz você passar o dia copiando e colando na interface do workspace.
O Databricks Power resolve isso. Uma única instalação configura as habilidades de agente oficiais do Databricks, que são carregadas sob demanda de acordo com a tarefa em andamento.
O que você recebe
Área | Cobertura |
|---|---|
SQL & Compute | Executar SQL em warehouses; executar Python ou Scala em clusters; gerenciar o ciclo de vida da computação |
Pipelines & Jobs | Spark Declarative Pipelines (tabelas de streaming, CDC, SCD Type 2, Auto Loader); DAGs de jobs com várias tarefas |
Unity Catalog | Tabelas, volumes, permissões, tags, credenciais de armazenamento, tabelas de sistema, metric views, External Iceberg Reads |
Dashboards de AI/BI | Visualizações, KPIs, dashboards analíticos |
Agentes do Genie | Exploração de dados em linguagem natural sobre conjuntos de dados governados |
Agent Bricks | Knowledge Assistants (RAG) e Multi-Agent Supervisors |
AI Search | Pesquisa semântica e RAG com índices gerenciados |
Model Serving | Modelos de ML, agentes de IA e Foundation Model APIs (FMAPI) com pagamento por token, roteáveis pelo Unity Gateway |
MLflow | Experimentos, avaliações, instrumentação de traces, consultas de métricas |
Lakebase | PostgreSQL gerenciado, provisionado ou com escalonamento automático, para cargas de trabalho OLTP |
Databricks Apps | Aplicativos web full-stack no Lakehouse |
Declarative Automation Bundles (antes Databricks Asset Bundles) | Infraestrutura como código para recursos do Databricks |
Instale o Power
No Kiro (IDE 1.0.288 ou posterior), abra o painel Powers, pesquise databricks e instale o Databricks Power. A habilidade de configuração dele então guia você em quatro etapas:
- Verificar se a Databricks CLI é a v1.20.0 ou posterior, a primeira versão com suporte ao Kiro em
databricks aitools, e instalá-la ou atualizá-la se necessário. - Fazer login na CLI com
databricks auth loginou reutilizar um perfil que você já tenha. - Instalar as habilidades com
databricks aitools install --agents kiro --scope global, que as coloca em~/.kiro/skills/. Use--scope projectpara instalá-las em um único workspace. - Adicionar oito habilidades do MLflow de mlflow/skills (rastreamento, avaliação, análise de traces, métricas), que a CLI não inclui.
Além da habilidade de configuração, o Power não inclui nenhum conteúdo nem servidor MCP. A CLI baixa as habilidades de databricks/databricks-agent-skills, e você mesmo as atualiza com databricks aitools update.
Autenticação
As habilidades executam comandos da Databricks CLI, então usam um perfil da Databricks CLI. Para uso interativo, faça login com OAuth user-to-machine: databricks auth login --host https://<your-workspace-url> --profile <profile-name> abre um navegador, e o token é renovado automaticamente. O OAuth com service principal é indicado para automação, e os Personal Access Tokens continuam sendo uma opção; consulte Databricks CLI authentication. A habilidade de configuração lista seus perfis existentes sem exibir nenhum segredo e nunca reutiliza um perfil sem perguntar.
Verifique a instalação
O Kiro carrega as habilidades quando uma sessão de chat começa, então abra uma nova sessão e pergunte: "Using the databricks-core skill, which workspace am I connected to?" Uma resposta correta confirma a CLI, seu perfil e as habilidades. databricks aitools list mostra a versão instalada de cada habilidade.
Atualização a partir do AI Dev Kit Power
Se você instalou o antigo Databricks AI Dev Kit Power, atualize o Power no Kiro e depois siga as etapas das habilidades e do MLflow acima. Alguns itens ficam fora do Power e precisam de limpeza manual: uma entrada databricks de nível superior em mcp.json que executa databricks-mcp-server/run_server.py, e qualquer exportação de credenciais DATABRICKS_* que a configuração antiga adicionou ao seu perfil do shell. Opcionalmente, remova o clone do ai-dev-kit (~/.ai-dev-kit, ou o diretório indicado em AIDEVKIT_HOME), mas só se você não usar o ai-dev-kit para outros agentes ou projetos. Exclua o diretório em vez de executar o install.sh --uninstall do ai-dev-kit, que remove pastas de habilidades pelo nome de ~/.kiro/skills/, inclusive as instaladas pela Databricks CLI. A seção "Migrating from the AI Dev Kit Power" da habilidade databricks-kiro-setup do Power cobre os três itens.
Como escolher entre os dois caminhos
Uma árvore de decisão simples:
- Você só executa SQL, faz perguntas em linguagem natural sobre conjuntos de dados governados pelo Genie e pesquisa em índices do AI Search? Use o caminho A. Os quatro servidores gerenciados fazem exatamente isso, e a configuração leva 10 minutos.
- Você cria pipelines, gerencia jobs, implanta Declarative Automation Bundles, trabalha com o Lakebase, desenvolve Databricks Apps ou chama o Agent Bricks? Use o caminho B. O kit de ferramentas completo é amplo demais para ser adicionado como servidores MCP remotos avulsos.
- Um pouco de cada? Use os dois. Os caminhos A e B não entram em conflito: o caminho B adiciona habilidades, não servidores MCP, então os quatro servidores do caminho A (
databricks-genie,databricks-sql,databricks-uc-functions,databricks-ai-search) ficam lado a lado com ele no painel MCP do Kiro. A habilidade de configuração do Power também pode guiar você para adicionar ao seumcp.jsonum MCP fornecido pelo Databricks, como o Genie One, por meio do Unity Gateway.
Para desenvolvedores que pretendem trabalhar no Kiro todos os dias com cargas de trabalho do Databricks, o caminho B é a melhor opção a longo prazo. O caminho A é a escolha certa se você tem 10 minutos e um SQL warehouse com o qual quer conversar.
Do ponto de vista de quem desenvolve
Os dois caminhos funcionam de forma diferente dependendo de quem está usando o IDE. Quatro perfis, quatro dificuldades, quatro respostas.
O analytics engineer. Você passa metade do dia consultando tabelas que nunca viu e a outra metade copiando e colando entre o editor e a interface do workspace. O caminho A resolve isso em 10 minutos. Os servidores do Genie e do SQL baseiam cada consulta em metadados reais do esquema; o assistente escreve com suas colunas reais, sem chutes; e cada resultado herda suas permissões do Unity Catalog. Chega de ficar trocando de aba.
O engenheiro de dados. Seu dia a dia são pipelines, jobs, Declarative Automation Bundles e as promoções entre ambientes que vêm com eles. Escrever o databricks.yml à mão e executar databricks bundle deploy em um terminal lateral é o caminho lento. O caminho B é o rápido. As habilidades do Power para pipelines, jobs e Declarative Automation Bundles geram, validam e implantam IaC em uma única conversa. Spark Declarative Pipelines, CDC, SCD Type 2, Auto Loader: tudo gerado a partir das suas tabelas reais do Unity Catalog e pronto para o commit.
O desenvolvedor de IA e agentes. Você conecta chamadas a modelos, avaliação, governança e orquestração de agentes em três ou quatro ferramentas que não concordam totalmente sobre o esquema. O caminho B cobre toda a oferta de IA do Databricks: Unity Gateway para roteamento e fallbacks, Agent Bricks para supervisores multiagente e assistentes de conhecimento, MLflow para avaliação e AI Search para recuperação, tudo governado de ponta a ponta pelo Unity Catalog. Seu agente herda as mesmas permissões de quem o chama, e seus traces de avaliação chegam ao mesmo workspace das suas execuções de treinamento.
O desenvolvedor de plataforma. Você gerencia os recursos do Databricks como código, faz promoções entre dev/stage/prod e responde toda semana à pergunta "houve desvio?". A habilidade de Declarative Automation Bundles do caminho B (databricks-dabs), junto com as habilidades de gerenciamento do Unity Catalog, gera o bundle completo, valida e mostra o plano de implantação (databricks bundle plan) antes de qualquer alteração. Você para de manter um conjunto de YAML à mão e outro em um documento.
Um workflow que você pode testar hoje
Seja qual for o caminho escolhido, este exercício baseia o assistente em metadados reais do workspace usando o conjunto de dados samples.tpch do catálogo samples integrado.
Você pergunta: "What columns and types does samples.tpch.lineitem have, and what is the data distribution by l_shipdate year?"
O Kiro retorna o esquema real e um histograma a partir de uma única consulta. Nomes de colunas reais e uma distribuição real, baseados no seu workspace.
Você pergunta: "Draft a dbt model that joins lineitem to orders and aggregates revenue by nation per quarter."
O Kiro gera SQL com os nomes de coluna reais (l_extendedprice, l_discount, o_orderdate) em vez de suposições. Como consultou o esquema primeiro, ele conhece os tipos exatos e a granularidade.
Você pergunta: "Run my new aggregation against samples.tpch and compare the row count to last week's snapshot in poc.gold.revenue_by_nation_qtr."
O Kiro executa as duas consultas e mostra as diferenças. Se um número parecer estranho, "Show me the lineage for gold.revenue_by_nation_qtr" busca as tabelas de origem em system.access.table_lineage. Depois de verificado, o Kiro gera o JSON do job do Databricks para o modelo e lista quais catálogos e esquemas ele usa.
No caminho B, o mesmo workflow se estende a "Generate a Declarative Automation Bundle for this job and deploy it to staging", "Create an AI/BI dashboard backed by this aggregation" ou "Wire this into a Unity Gateway endpoint with a fallback model", tudo sem sair do IDE.
Práticas recomendadas, seja qual for o caminho
- Autenticação com privilégio mínimo. Gere um PAT separado por estação de trabalho e por conjunto de escopos. No caminho B, para uso interativo, prefira OAuth U2M a PATs.
- Nunca faça commit de credenciais. Guarde
DATABRICKS_ACCESS_TOKENno seu perfil do shell ou em um gerenciador de segredos. Nunca o coloque em ummcp.jsonversionado no controle de código. - Escopo por projeto. Mantenha os IDs dos agentes do Genie e os caminhos dos índices do AI Search em
$PWD/.kiro/settings/mcp.json, para que cada projeto leve as próprias vinculações de recursos. - Confie nas permissões do Unity Catalog. Nos dois caminhos, a IA trabalha com suas permissões efetivas: permissões de tabela, filtros de linha e máscaras de coluna no SQL e nos agentes do Genie, e compartilhamento por recurso nos índices do AI Search. Não existe uma camada separada de controle de acesso para gerenciar.
- Reinicie, não recarregue. O Kiro lê as variáveis de ambiente uma única vez, quando o processo é iniciado. Depois de editar seu perfil do shell ou adicionar a autenticação, feche o Kiro completamente (Cmd+Q no macOS) e abra-o de novo.
Solução de problemas
"Server not found" ou status vermelho em uma entrada MCP.
Caminho A: verifique echo $DATABRICKS_SQL_MCP_URL no shell que abriu o Kiro. Um valor vazio significa que o Kiro não consegue resolver a URL. Confirme que o mcp.json do escopo do workspace não está sobrepondo sua configuração do escopo do usuário. Verifique se o PAT ainda é válido em Settings, Developer, Access tokens.
Conectado ao MCP, mas as chamadas de ferramentas retornam RESOURCE_DOES_NOT_EXIST ou PERMISSION_DENIED.
É a falha mais comum do caminho A. O handshake initialize funciona com uma URL de exemplo porque o servidor adia a validação do recurso até a invocação. Refaça as verificações prévias do servidor específico (o agente do Genie existe e está compartilhado com você, a função existe e você tem EXECUTE, o índice do AI Search existe e você tem SELECT nele).
O Kiro não usa as habilidades do Databricks (caminho B).
Abra uma nova sessão de chat, já que as habilidades são carregadas quando uma sessão começa, e verifique se databricks-core/SKILL.md existe em ~/.kiro/skills/. Error: unknown agent "kiro" significa que a Databricks CLI é anterior à v1.20.0; atualize-a e execute a instalação de novo. Se o comando da CLI de uma habilidade não conseguir se autenticar, execute databricks auth profiles e faça login novamente com databricks auth login.
Experimente hoje. O Databricks Power é a forma mais rápida de ter toda a plataforma (pipelines, jobs, Lakebase, Agent Bricks e tudo o que foi descrito acima) dentro do Kiro. Instale-o pelo catálogo Kiro Powers em kirodotdev/powers, ou instale as mesmas habilidades sem o Power executando databricks aitools install --agents kiro com a Databricks CLI v1.20.0 ou posterior. Para outros agentes de programação, databricks aitools install detecta os que estão na sua máquina (Claude Code, Cursor, Codex, GitHub Copilot, Gemini CLI e outros); execute databricks aitools --help para ver a lista atual, ou consulte databricks/databricks-agent-skills. Para os quatro servidores MCP gerenciados pelo Databricks, a instalação com um clique está em kiro.dev/docs/mcp/servers/.
Tem feedback ou encontrou algum problema? Abra uma issue: para a configuração ou o empacotamento do Power, kirodotdev/powers; para as habilidades de agente, databricks/databricks-agent-skills; para a Databricks CLI e databricks aitools, databricks/cli. Lemos todas.
Parceiros, Lakebase, Genie, Unity Gateway, Agent Bricks, Unity Catalog, MCP, Developer Tools, AI Search, MLOps & LLMOps e Business Intelligence
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.