Avaliando agentes de AI ao vivo na Grounded Reasoning Cup
Como as principais equipes acadêmicas construíram agentes de AI que se generalizaram para um novo corpus de documentos corporativos sob condições de competição ao vivo.
- A Grounded Reasoning Cup desafiou 11 equipes acadêmicas a aplicar agentes desenvolvidos no OfficeQA Pro ao OfficeQA Pro V2, um benchmark recém-lançado criado a partir de aproximadamente 120.000 páginas de documentos do Tesouro dos U.S.
- Os resultados mostraram que a generalização não pode ser presumida. Abordagens desenvolvidas em um benchmark familiar nem sempre foram transferidas de forma confiável para um novo corpus, e agentes de fronteira prontos para uso tiveram uma média de precisão inferior a 30%.
- A equipe vencedora de Stanford alcançou 63,3% de precisão por meio de uma estratégia de otimização de agentes de ponta a ponta que combinou uma biblioteca de habilidades reutilizáveis, fallbacks direcionados de representação de documentos e verificação adaptativa.
Este ano, a Databricks sediou a edição inaugural da Grounded Reasoning Cup, uma competição de AI ao vivo inédita para avaliar a capacidade dos agentes de AI de raciocinar sobre coleções complexas de documentos de estilo empresarial. Ao testar agentes em um corpus recém-lançado sob condições de competição ao vivo, a Grounded Reasoning Cup foi projetada para ajudar a responder a uma das perguntas mais difíceis na avaliação de AI: até que ponto as melhorias de desempenho em um benchmark se generalizam para tarefas semelhantes do mundo real?
A competição reuniu 11 das principais equipes acadêmicas de todos os U.S. e Canadá, combinadas com recursos e mentoria de laboratórios de fronteira, incluindo OpenAI, Anthropic e Google DeepMind. Ao longo de dois meses, as equipes desenvolveram e otimizaram seus agentes no OfficeQA, nosso principal benchmark de raciocínio fundamentado projetado para refletir fluxos de trabalho empresariais economicamente valiosos. No dia da competição, eles foram desafiados a aplicar esses sistemas em tempo real a um benchmark de raciocínio fundamentado recém-lançado, o OfficeQA Pro V2, projetado para testar se suas melhorias se generalizavam.
Stanford venceu com um sistema que alcançou 63,3% de precisão, superando a média das equipes em aproximadamente +22 pontos e a linha de base offline média de agentes de fronteira em aproximadamente +35 pontos. As melhores equipes demonstraram ganhos substanciais por meio de pré-processamento de documentos, recuperação direcionada, agentes paralelos, uso de ferramentas estruturadas e verificação. Ao mesmo tempo, 18,8% das perguntas não foram resolvidas por nenhuma equipe, destacando quanto espaço para melhorias ainda resta no raciocínio fundamentado empresarial.
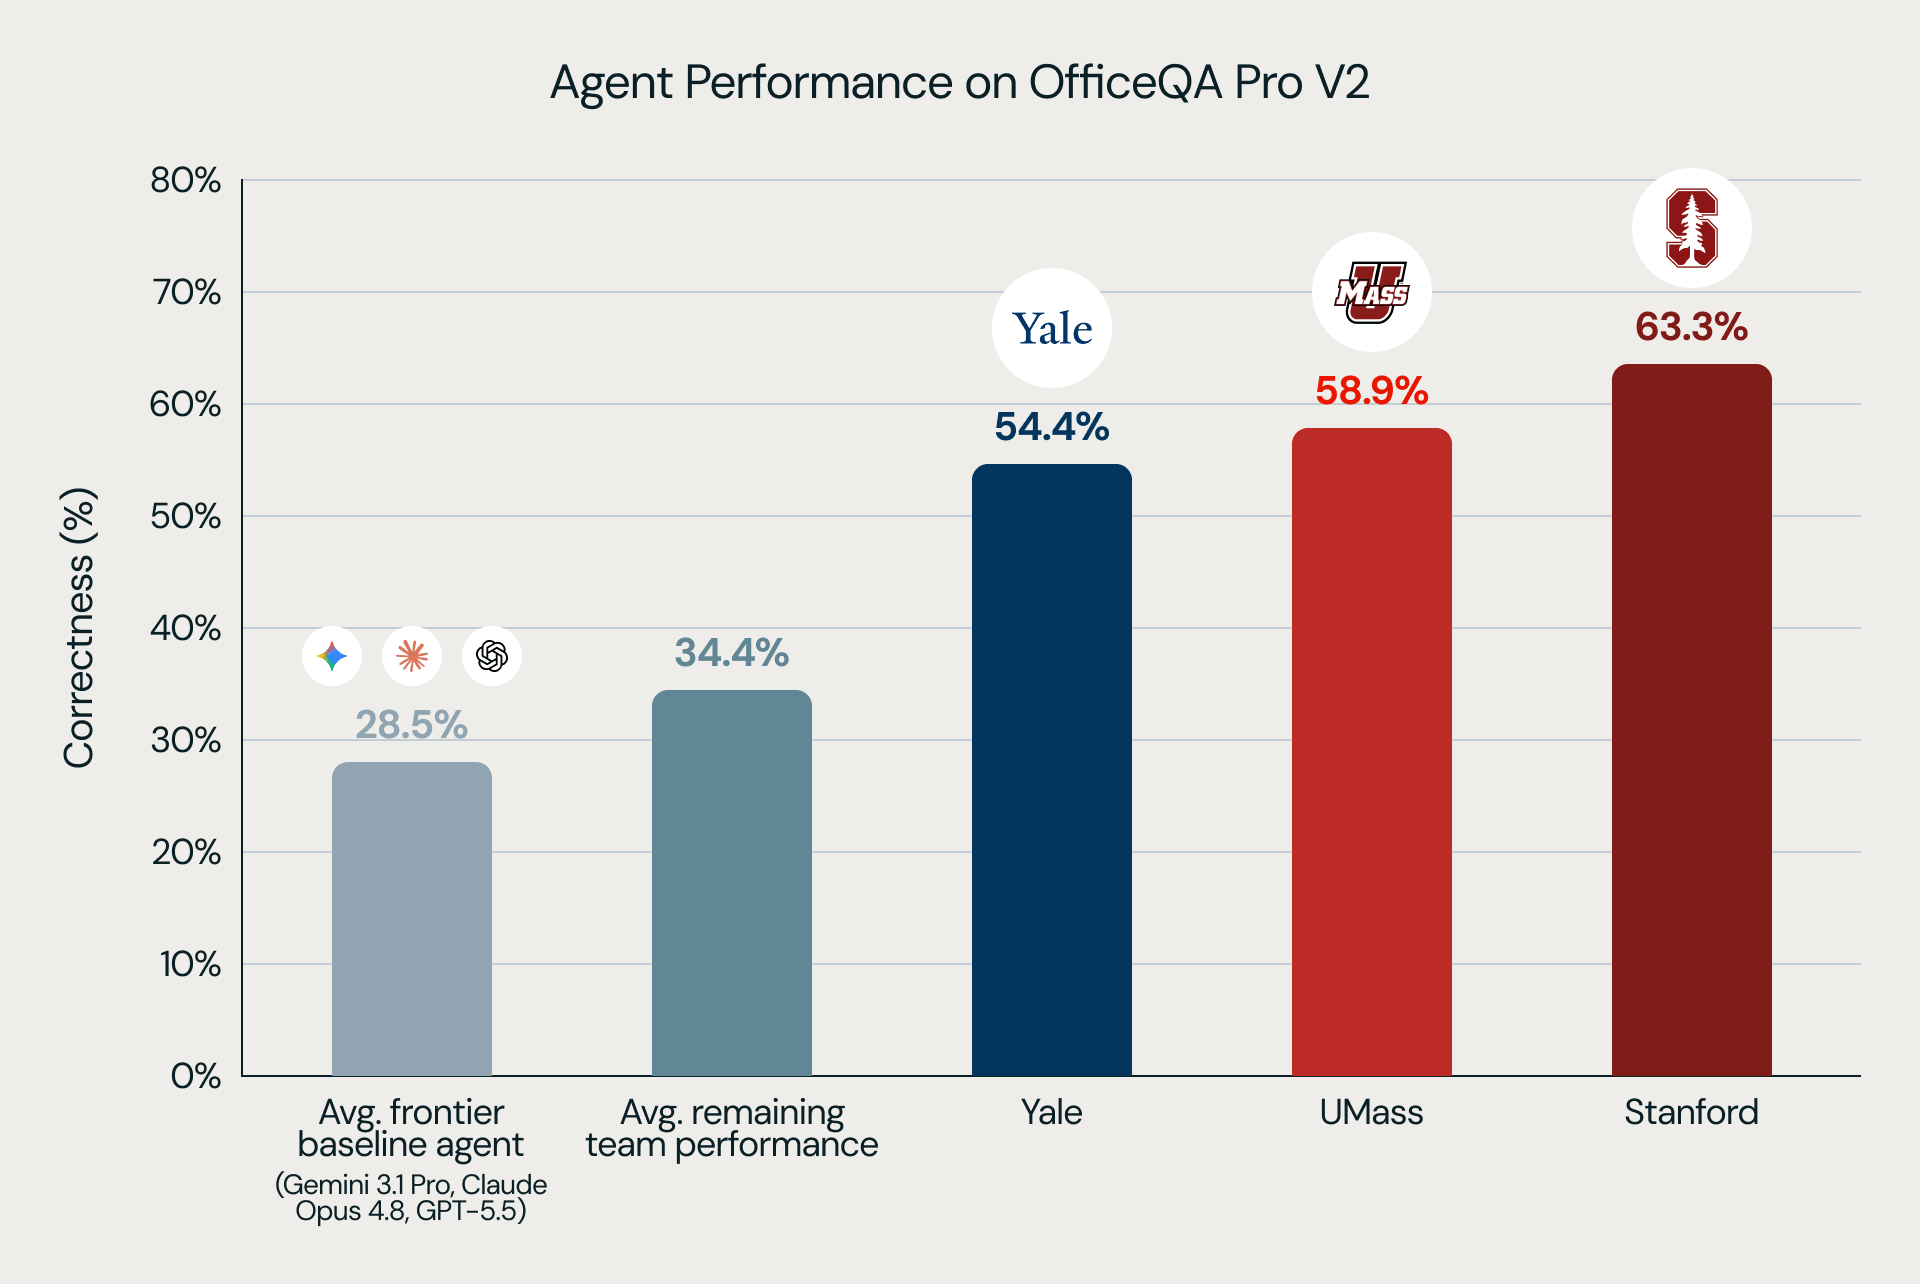
Neste post do blog, recapitulamos a competição e discutimos as estratégias de otimização de agentes e os insights das equipes vencedoras da Grounded Reasoning Cup: Stanford, University of Massachusetts Amherst e Yale.
Em geral, constatamos o seguinte:
- A generalização exige avaliações representativas e reservadas (held-out). As técnicas desenvolvidas no OfficeQA nem sempre foram transferidas de forma confiável para nosso novo benchmark. Isso reforça a importância de utilizar conjuntos de testes reservados (held-out), como o OfficeQA Pro V2, para garantir que as soluções se generalizem para novos exemplos.
- O desempenho do agente depende de todo o sistema, não apenas do modelo. A diferença média entre as equipes com maior e menor pontuação usando o mesmo modelo foi de 30,4 pontos. Parsing, recuperação, uso de ferramentas, verificação, paralelismo e infraestrutura operacional fizeram toda a diferença para que os agentes pudessem concluir com sucesso tarefas de raciocínio fundamentado de ponta a ponta.
- O raciocínio fundamentado empresarial ainda está longe de ser resolvido. Mesmo as equipes vencedoras enfrentaram dificuldades com muitas das demandas de recuperação, parsing e análise do benchmark, deixando um espaço substancial para pesquisa e melhoria contínuas. Incentivamos os profissionais a usarem a suíte de benchmark OfficeQA disponível publicamente para continuar avançando neste trabalho.
A estrutura da competição
O objetivo da Grounded Reasoning Cup era reunir as principais equipes acadêmicas para desenvolver abordagens generalizáveis para o raciocínio fundamentado – uma tarefa comum em ambientes empresariais que envolve responder a perguntas complexas usando evidências de grandes coleções de documentos, muitas vezes proprietários.
Equipes de 2 a 4 pessoas representando suas instituições acadêmicas foram pareadas com um parceiro do setor da OpenAI, Anthropic ou Google DeepMind, que forneceu acesso a seus modelos e mentoria durante todo o período de desenvolvimento. As equipes tiveram aproximadamente dois meses para criar um agente usando as abordagens que considerassem adequadas, com a única restrição de que deveriam usar exclusivamente a família de modelos do laboratório parceiro para alimentar seu agente. Durante esse período, eles usaram o benchmark OfficeQA para avaliar novas técnicas que acreditavam que se generalizariam para tarefas semelhantes de raciocínio fundamentado.
No dia da competição, as equipes foram encarregadas de aplicar seus agentes em tempo real em um benchmark novo, recém-lançado. A competição foi regida pelas seguintes regras:
- Lançamento do benchmark: O novo corpus (as Contas de Receitas e Despesas do Tesouro dos U.S.) foi lançado apenas 36 horas antes da competição. Isso deu às equipes tempo para processar e indexar os dados, limitando a oportunidade de os métodos sofrerem overfitting no novo benchmark.
- Restrições de design: As equipes podiam usar qualquer framework de agente, versão(ões) de corpus, estratégia de recuperação, configuração de uso de ferramentas ou fluxo de trabalho human-in-the-loop, desde que usassem modelos de seu parceiro de laboratório do setor designado.
- Formato: A competição consistiu em seis rodadas de 15 minutos com 15 perguntas por rodada. As rodadas tornaram-se progressivamente mais difíceis ao longo do evento.
- Pontuação: As equipes receberam 1 ponto por cada resposta correta. Para incentivar a baixa latência, elas também receberam um bônus de velocidade de 0,25 ponto se fossem as primeiras a responder corretamente a uma determinada pergunta. Os pontos valiam o dobro (2x) na rodada final, que consistia nas perguntas mais desafiadoras. Cada equipe também teve direito a 3 novos envios ao longo da competição, que podiam optar por aplicar para corrigir uma resposta anterior.
Desempenho e aprendizados das equipes
A competição deixou uma coisa clara: o raciocínio fundamentado sobre corpora de documentos de estilo empresarial melhorou desde que lançamos o benchmark OfficeQA há 7 meses, mas ainda está longe de ser resolvido. A pontuação média das equipes foi de cerca de 41%, enquanto as três melhores equipes superaram 50% de precisão, com a equipe de Stanford vencendo a competição com 63,3% de precisão. Esses resultados apontam para um trabalho impressionante das melhores equipes, bem como para muito espaço restante para explorar.
Estratégias das equipes vencedoras
Embora cada uma tenha adotado uma abordagem única, vários padrões surgiram nos agentes criados pelas três melhores equipes. Sistemas robustos tendiam a combinar um pré-processamento cuidadoso de documentos, recuperação direcionada, uso de ferramentas estruturadas e etapas de verificação de respostas. Em muitos casos, o desempenho dependia menos de uma única chamada de modelo e mais do sistema ao redor: como os documentos eram analisados (parsed), como as evidências eram recuperadas, como os cálculos intermediários eram realizados e como as respostas eram verificadas antes do envio. Embora essas fossem qualidades que os sistemas de maior desempenho geralmente tinham em comum, cada um deles também empregou estratégias distintas e criativas, conforme descrito abaixo.
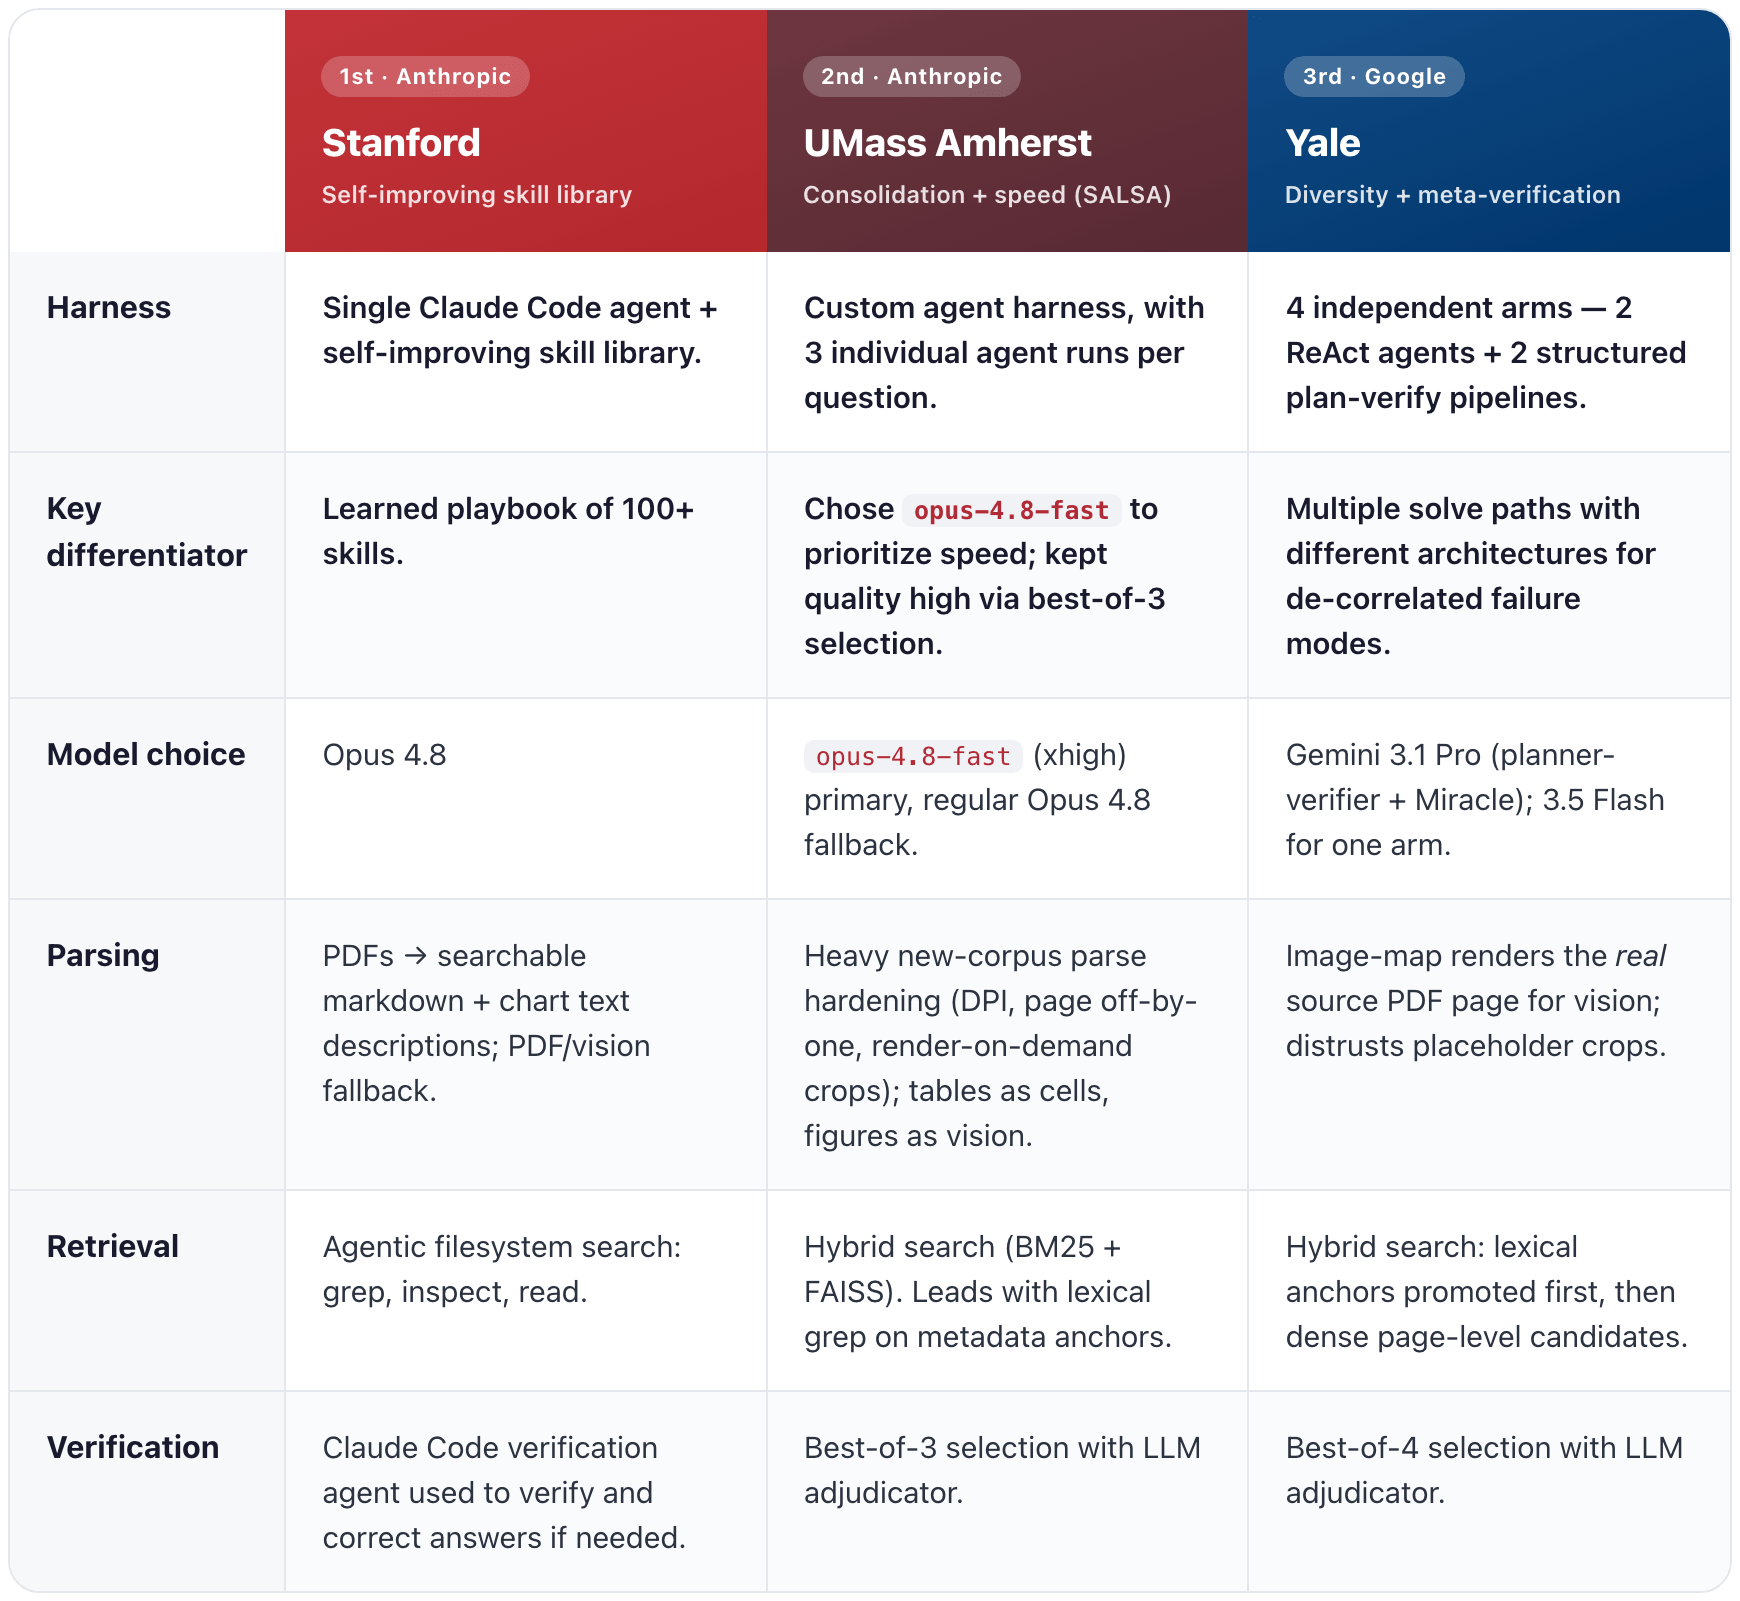
1º lugar: Stanford University
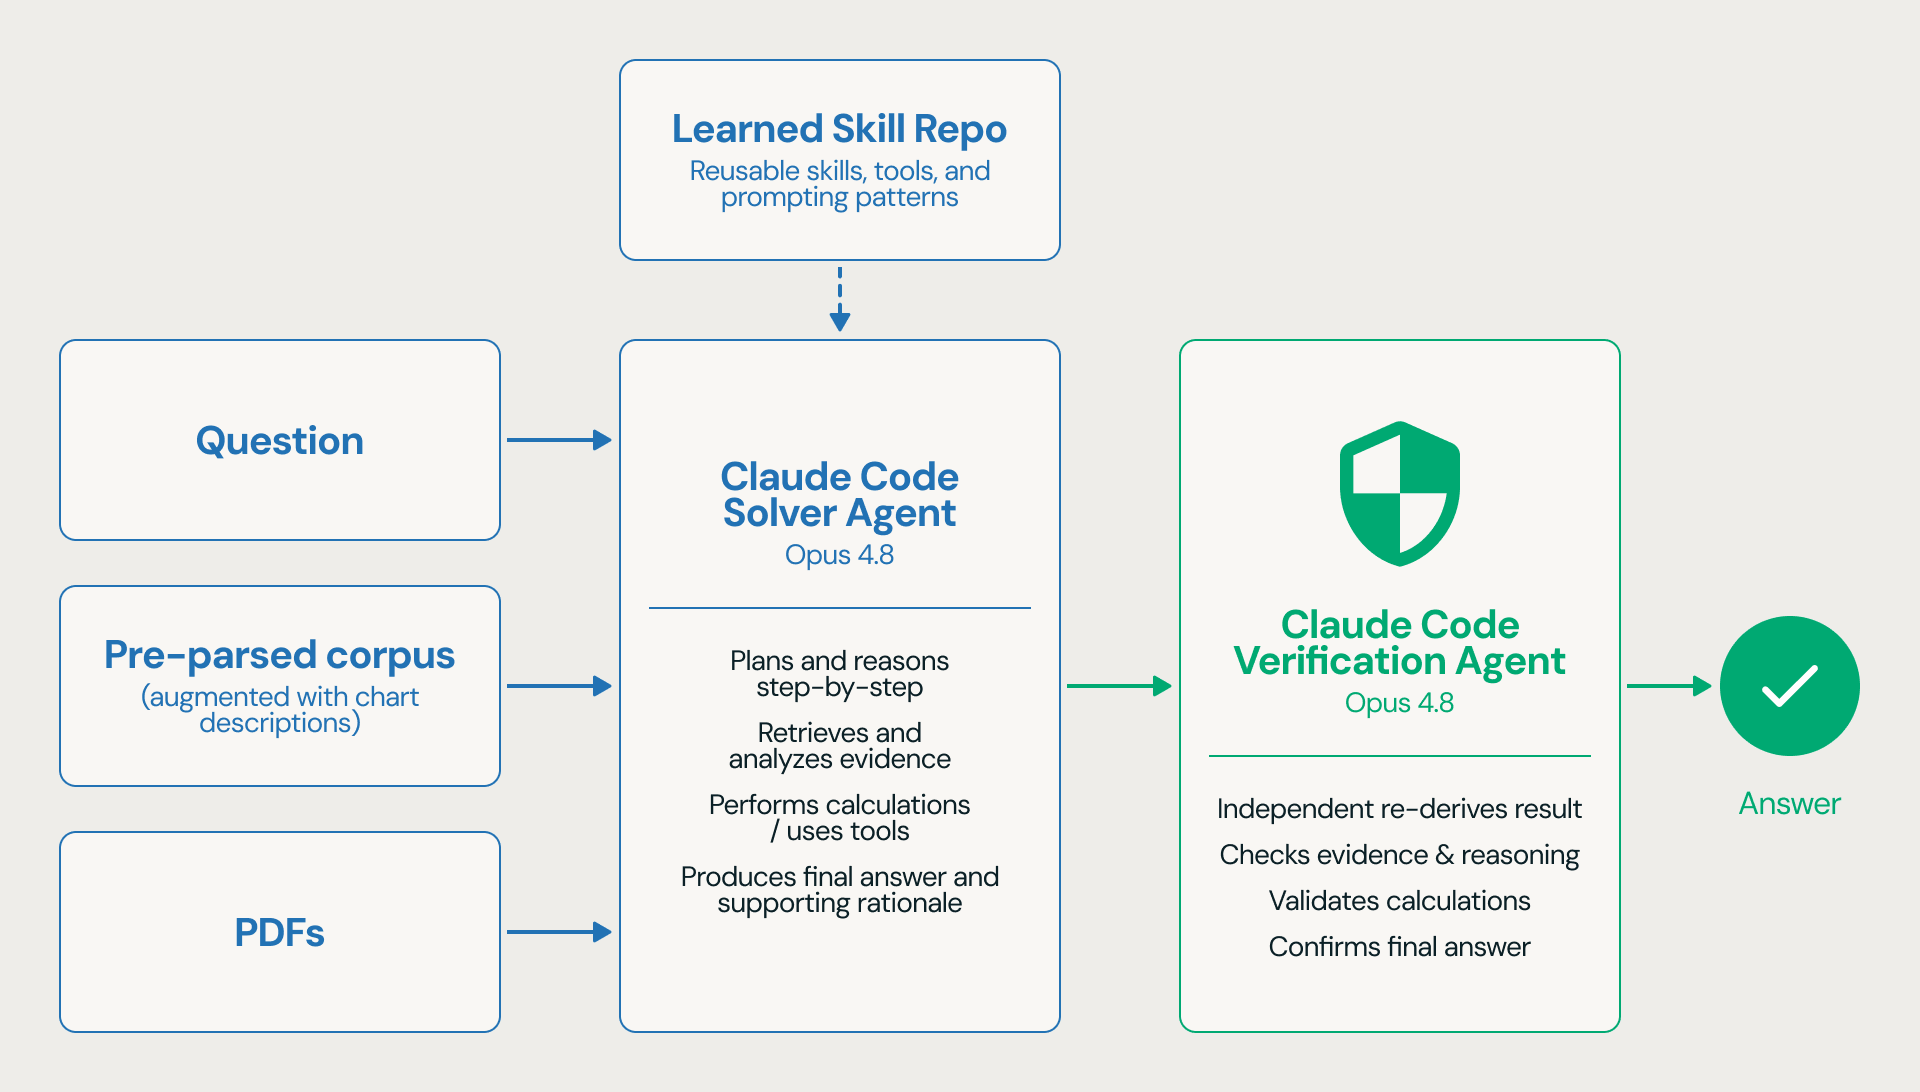
A abordagem vencedora da equipe de Stanford veio da transformação de modos comuns de falha de raciocínio fundamentado em procedimentos operacionais reutilizáveis para que seu agente Claude Code com Claude Opus 4.8 aprendesse e aplicasse nas perguntas da competição. Durante o desenvolvimento no benchmark público OfficeQA, incluindo experimentos de ablação com o Opus 4.8 e até mesmo com o Fable 5 (enquanto disponível), a equipe rastreou repetidamente as respostas erradas até o passo em falso exato do agente e, em seguida, transformou esses padrões em habilidades para localização de tabelas, formatação de respostas, esclarecimentos sobre termos financeiros comuns, etc. A equipe também integrou habilidades que decidiriam quando pesquisar no texto do corpus analisado (parsed) e nas representações de documentos no estilo markdown e quando recorrer aos PDFs de origem se o texto analisado carecesse de contexto completo. No dia da competição, Stanford havia preparado seu agente com um playbook de mais de 100 habilidades. Eles lideraram todas as equipes em precisão, com 57 respostas corretas das 88 que tentaram.
Apesar dessa preparação detalhada, Stanford ainda teve que adaptar sua estratégia durante a competição. Nas três primeiras rodadas, a equipe usou outro agente Claude Code como verificador para extrair novamente valores intermediários, verificar modos de falha comuns — como rastrear valores revisados por meio de linhagem de dados (data lineage) e lidar com dimensionamento de unidades — e corrigir cálculos ao identificar discrepâncias. Mas, depois de ganhar apenas dois bônus de velocidade nessas rodadas, Stanford removeu a etapa extra de verificação nas três rodadas finais. A mudança reduziu significativamente a latência, ajudando a equipe a ganhar bônus de velocidade em 14 perguntas e impulsionar sua recuperação. O verificador, no entanto, provou ser decisivo na rodada final, quando Stanford o ativou novamente para corrigir uma resposta por meio de um envio final, garantindo a vitória.
2º lugar: UMass Amherst
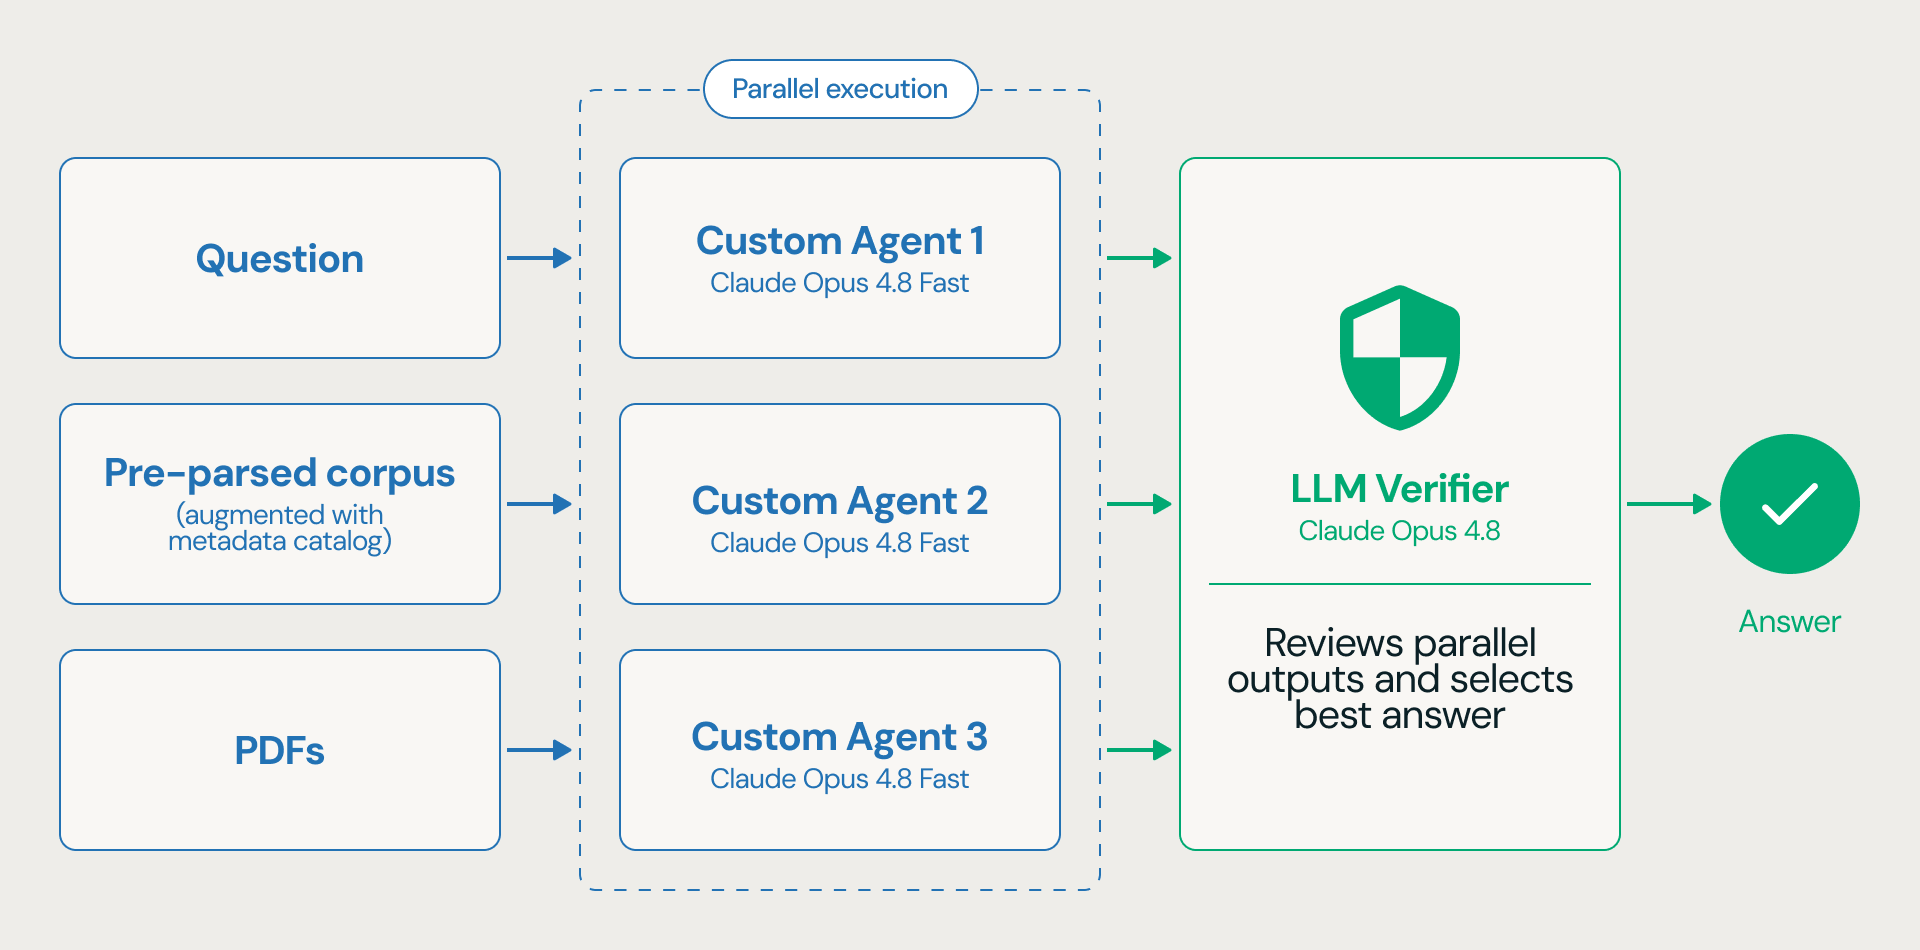
A equipe da UMass apostou na velocidade. Eles usaram o Claude Opus 4.8 Fast como modelo principal e pré-processaram o corpus para criar um catálogo de metadados que permitia busca e filtragem rápidas nos documentos analisados. Para melhorar a qualidade das respostas mantendo a baixa latência, eles executaram três agentes em paralelo para cada pergunta, seguidos por uma chamada final de verificação do Opus para selecionar a melhor resposta.
Essa estratégia deu à UMass o tempo médio de envio mais rápido para respostas corretas: quatro minutos, menos da metade da média geral das equipes, que foi de oito minutos e 30 segundos. Como resultado, eles ganharam 36 bônus de velocidade, valendo 0,25 ponto cada, por ser a primeira equipe a responder corretamente — mais do que o dobro do total de 16 da Stanford, segunda colocada. Esses bônus ajudaram a construir uma vantagem de 10,25 pontos sobre Stanford até o intervalo e a manter uma vantagem de 3,75 pontos ao entrar na rodada final. A UMass manteve essa liderança até os 56 segundos finais da competição, quando o agente mais lento e preciso de Stanford se provou decisivo nas perguntas mais desafiadoras e assumiu a liderança para vencer por 1,75 ponto.
A abordagem da UMass demonstra como modelos mais rápidos, pré-processamento de documentos e escala em tempo de teste (test-time scaling) podem funcionar juntos para alcançar uma latência muito baixa sem sacrificar muita precisão.
3º lugar: Yale University
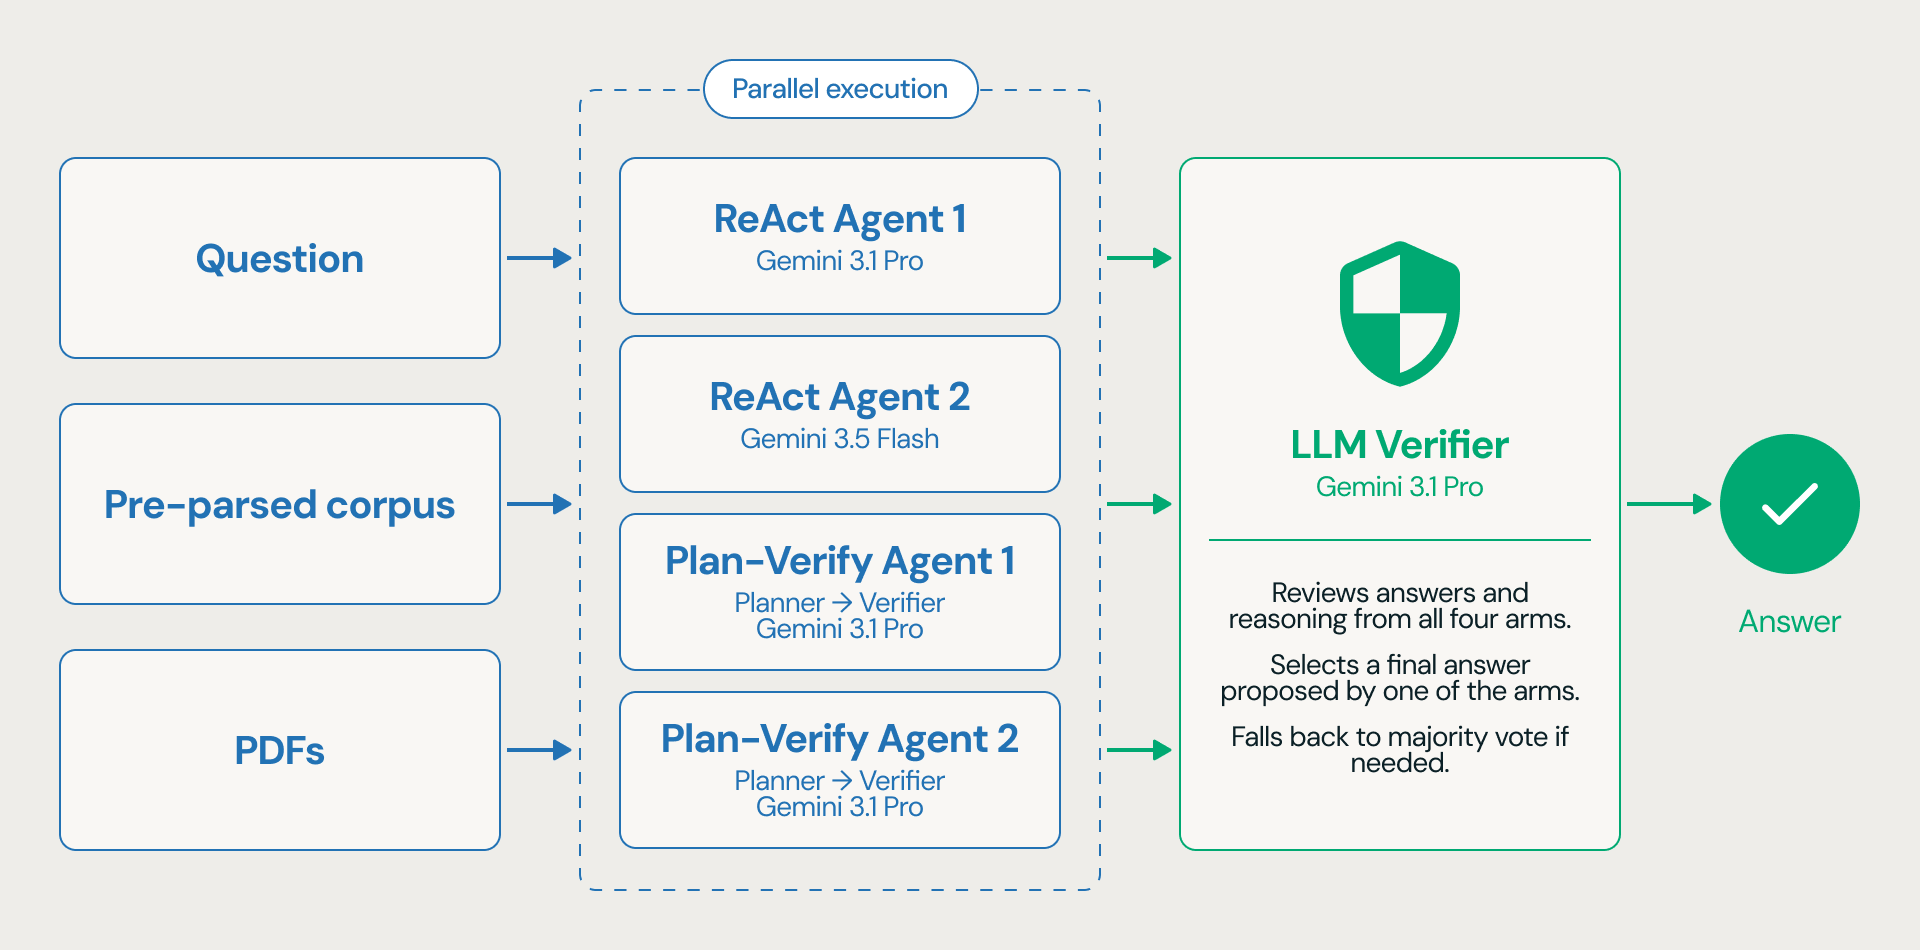
A equipe de Yale construiu uma estrutura de verificação multi-braço (multi-arm) projetada para manter a robustez caso algum agente individual falhasse. O sistema executou quatro braços independentes em paralelo, abrangendo duas estratégias de agentes. Dois braços usaram agentes ReAct autônomos: um alimentado pelo Gemini 3.1 Pro e o outro pelo Gemini 3.5 Flash. Os braços restantes usaram um pipeline estruturado de planejador-verificador (planner-verifier), com o Gemini 3.1 Pro alimentando todas as chamadas de LLM. Nesse pipeline, o planejador inspecionava e contextualizava os documentos de origem, reunindo um bloco de rascunho (scratchpad) contendo as evidências necessárias para responder à pergunta. O verificador então checava as fontes citadas e realizava os cálculos finais.
Um metaverificador Gemini 3.1 Pro revisou as respostas e o raciocínio produzidos por todos os quatro braços e selecionou a resposta final. Para reduzir o risco de introduzir uma nova resposta sem suporte, o metaverificador só podia selecionar uma resposta proposta por um dos braços existentes. Quando não conseguia fazer isso, o sistema recorria a uma votação por maioria. Ao combinar arquiteturas de agentes distintas com modos de falha independentes e parcialmente descorrelacionados, Yale enfatizou uma verificação consistente e fundamentada (grounded). A abordagem rendeu à equipe o terceiro lugar, com 49 de 90 perguntas respondidas corretamente e uma classificação de precisão entre as três melhores em quatro das seis rodadas da competição.
Resumo das estratégias das equipes vencedoras
Uma das principais conclusões dessas abordagens vencedoras é que aplicar um agente com sucesso a tarefas de raciocínio fundamentado (grounded reasoning) de ponta a ponta exige um pensamento sistêmico holístico, e não apenas a escolha do modelo. Entre as abordagens vencedoras, alguns fatores de design importantes se destacaram:
- Qualidade do parsing: As melhores equipes usaram documentos pré-analisados e frequentemente aumentaram essas representações analisadas para incluir metadados adicionais (por exemplo, descrições de gráficos ou metadados no nível da página) e preservaram os caminhos de volta aos PDFs de origem para recorrer a eles quando o texto analisado estava incompleto. Em nossos próprios estudos sobre o OfficeQA Pro V2, descobrimos que a pré-análise de documentos com
ai_parsecontribui significativamente para a melhoria de desempenho do Genie de 24,0 pontos em relação aos agentes de fronteira de referência. - Qualidade de recuperação (retrieval): Sistemas robustos não dependiam de busca genérica de blocos (chunks) top-k. Em vez disso, usavam alguma forma de recuperação lexical (por exemplo, grep), frequentemente combinada com recuperação densa para uma abordagem híbrida.
- Uso de ferramentas: Agentes bem-sucedidos geralmente delegavam busca, inspeção de documentos, cálculos, comparação e envio a ferramentas especializadas.
- Estratégias de verificação: Várias equipes integraram alguma forma de verificação explícita por meio de um agente de verificação ou chamada de LLM para melhorar a qualidade das respostas.
- Estrutura robusta: Sob a pressão de prazos em tempo real, detalhes operacionais como pré-processamento, lógica de repetição (retry), paralelismo e estrutura de suporte (scaffolding) foram necessários para garantir que as respostas corretas realmente chegassem a tempo.
Esses fatores determinaram se o modelo conseguiria encontrar com segurança as evidências corretas, realizar o cálculo certo e enviar a resposta correta sob a pressão do prazo final.
Impacto e próximos passos
Em resumo, os resultados da Grounded Reasoning Cup demonstram uma série de lições mais amplas:
- A generalização deve ser testada, não presumida. As melhorias no OfficeQA nem sempre foram transferidas para o OfficeQA Pro V2, e os agentes de fronteira ainda responderam corretamente a menos da metade de suas perguntas, em média. O progresso em um benchmark familiar não se traduz necessariamente para um novo corpus ou distribuição de tarefas.
- Avaliações representativas e com dados retidos (held-out) são críticas. Elas devem avaliar as formas de generalização que importam, idealmente mantendo fixas as qualidades essenciais da tarefa (ou seja, raciocínio fundamentado em documentos), enquanto variam elementos da tarefa que podem mudar, como o corpus. Em nossa publicação que descreve o OfficeQA Pro V2, discutimos como aproveitamos dados sintéticos, combinados com nosso conhecimento dos fluxos de trabalho dos clientes, para dimensionar rapidamente essas avaliações representativas.
- O desempenho do agente depende de todo o sistema. O desempenho depende não apenas do modelo, mas também do parsing, da recuperação (retrieval), do uso de ferramentas, da verificação e da qualidade dos dados e da infraestrutura subjacentes. As equipes vencedoras otimizaram esses componentes de forma holística. Da mesma forma, o Genie supera significativamente os agentes de fronteira de referência ao usar ferramentas como o
ai_parsepara pré-analisar documentos, além de estratégias adicionais de otimização de estrutura.
Agradecemos a todas as equipes e patrocinadores do setor, incluindo OpenAI, Google DeepMind e Anthropic, que participaram da Grounded Reasoning Cup inaugural da Databricks e ajudaram a impulsionar o setor. Também agradecemos à USAFacts pela parceria contínua, desde nos ajudar a identificar um novo corpus e criar perguntas relevantes para o OfficeQA Pro V2 até a parceria na própria competição. Por fim, agradecemos ao Tesouro dos EUA por ajudar a identificar as Contas de Receitas e Despesas dos EUA (U.S. Accounts of Receipts and Expenditures) como a base para o benchmark da competição e por disponibilizar o conjunto de dados como uma coleção coesa pela primeira vez.
Autores: Krista Opsahl-Ong, Arnav Singhvi, Josh Joseph, Jasmine Collins, Ivan Zhou, Brooke Wenig, Denny Lee, Michael Bendersky, Erich Elsen, Xing Chen, Matei Zaharia
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.