Gerenciando custos de codificação com IA em escala
por Patrick Wendell, Akshat Bhatia, Vinay Gaba, Erich Elsen e Ivan Zhou
As ferramentas de codificação de AI entregam um valor imenso: na Databricks, a codificação agêntica melhorou de forma mensurável cada métrica de velocidade que acompanhamos e, em algumas equipes, gerou ganhos de uma ordem de magnitude nos resultados. Mas quase todas as empresas que implantam ferramentas de AI em escala se depararam com o mesmo obstáculo: custos que crescem exponencialmente. Essa curva é insustentável — se não for controlada, acabará superando a receita. A explosão de gastos deixou as empresas em uma situação paradoxal: por um lado, desejando impulsionar ao máximo a transformação de AI e colocar ferramentas poderosas nas mãos dos funcionários e, por outro lado, tendo que lidar com um perfil de custo agregado que ameaça minar ou até mesmo reverter os próprios ganhos de eficiência que a AI proporciona.
Felizmente, vários dos primeiros adotantes em larga escala convergiram para um conjunto de abordagens que resolvem esse quebra-cabeça, alcançando um “duplo mandato”: (a) fornecer amplo acesso a ferramentas de AI, com o mínimo de atrito, e (b) manter os custos agregados dentro de um limite aproximadamente fixo por usuário. Este post descreve técnicas comprovadas de gestão de custos, com base em nossa experiência na Databricks e em conversas com várias outras empresas nativas digitais, incluindo Stripe, Coinbase, Uber e Ramp. A tabela abaixo resume as técnicas atuais e as economias associadas; os números são direcionais, baseados em uma pesquisa informal com equipes de desenvolvimento:
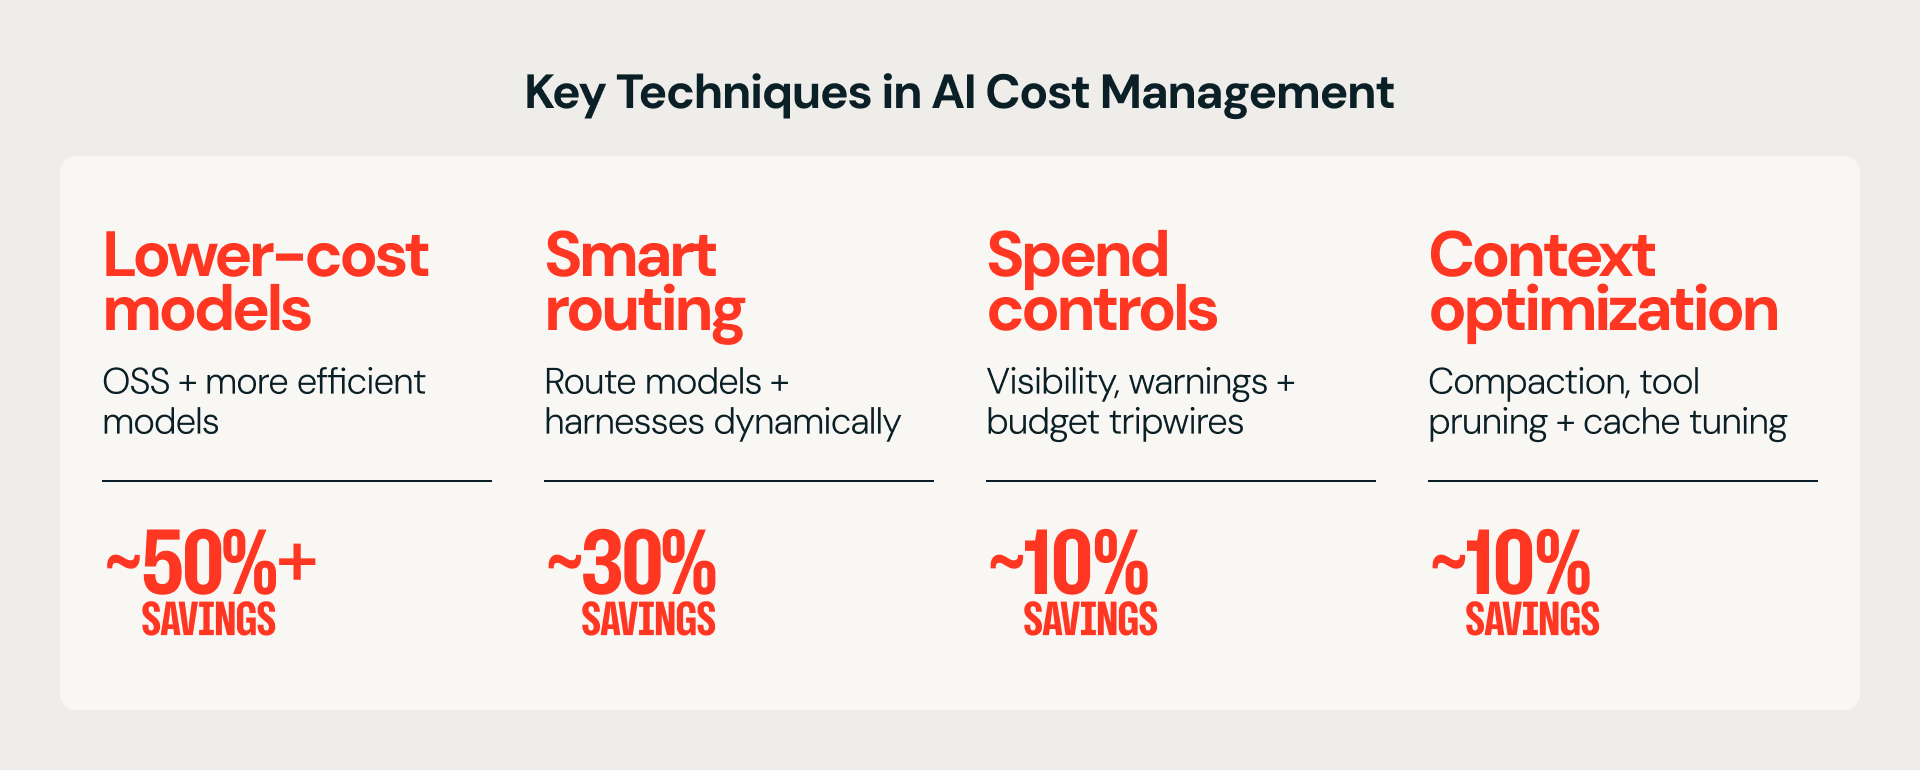
Algumas dessas técnicas podem ser facilmente implementadas com softwares que muitas empresas já utilizam. Outras exigem uma nova infraestrutura, especialmente técnicas que modificam os clientes finais ou direcionam o tráfego entre modelos. Na Databricks, disponibilizamos em código aberto ou gratuitamente nossos principais componentes de infraestrutura: um meta-harness de usuário final (Omnigent) e nosso AI Gateway (Unity AI Gateway). Para fins de completude, este post também aborda softwares usados por outras empresas com as quais conversamos.
A “Fronteira de Eficiência” para Modelos de Codificação
A maior alavanca de custo individual está em direcionar os gastos de codificação para modelos mais eficientes à medida que são lançados. Este ponto merece alguma discussão, pois a explicação simples de "modelos mais baratos" na verdade esconde uma relação sutil entre o custo e a qualidade do modelo.
Coloquialmente, o termo modelo de fronteira significa “o modelo de maior inteligência”, e os laboratórios de fronteira focam principalmente em avançar o pico de inteligência. Os modelos de fronteira agora podem resolver problemas inéditos em matemática ou segurança cibernética. Mas quando a AI é implantada em escala, um tipo diferente de fronteira importa mais: a fronteira de eficiência. A fronteira de eficiência é definida pelo conjunto de modelos que apresentam a melhor relação de preço para um determinado nível de inteligência. A maior parte da codificação do dia a dia não exige demonstrações matemáticas ou insights inéditos de segurança, de modo que o que importa no agregado é o custo dos modelos que atingem o patamar de qualidade para o trabalho típico de engenharia de software. Essa "fronteira de eficiência" está avançando muito mais rápido do que a fronteira de inteligência, com novos modelos sendo lançados quase semanalmente que apresentam uma melhor relação de inteligência por unidade de preço do que os modelos anteriores.
Alavanca de Custo nº 1: Migração para código aberto e modelos de menor custo
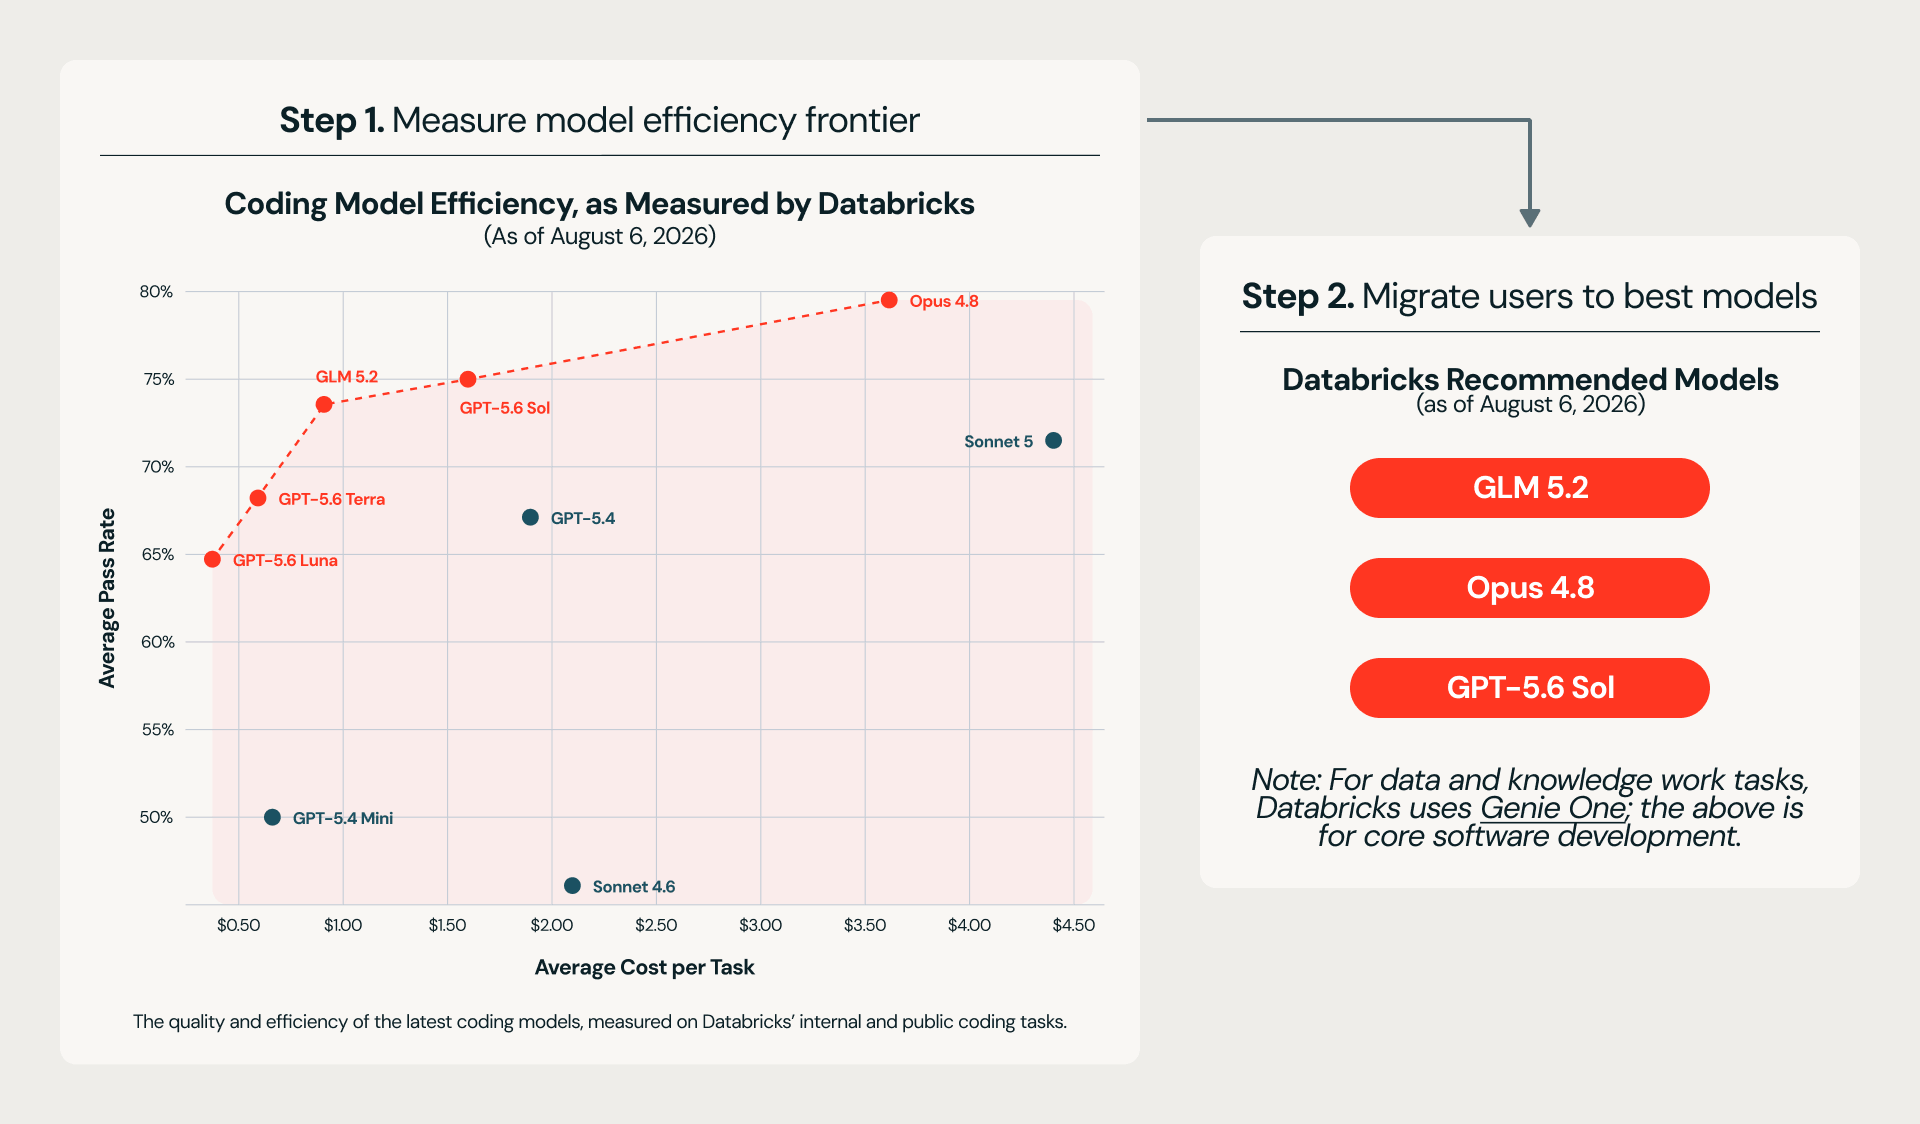
A adoção rápida de modelos mais novos e eficientes proporciona as maiores reduções de custo de qualquer técnica. Mas para capturar esses ganhos, uma empresa primeiro precisa saber quais modelos realmente superam os seus atuais. Isso pode ser difícil porque os benchmarks públicos não são bons para indicar o desempenho no mundo real em tarefas de codificação. Para avaliar novos modelos, muitas empresas criaram avaliações automatizadas que acreditam ser mais representativas de seu mix de desenvolvimento interno. A Databricks publicou recentemente um exemplo de um benchmark desse tipo, no qual observamos uma relação de preço/desempenho altamente competitiva para modelos GLM. Esse benchmark nos levou a disponibilizar o GLM internamente para os desenvolvedores. Frequentemente, novos modelos não avançam a fronteira de eficiência, e as avaliações costumam produzir resultados negativos: a Stripe descobriu que o Opus 4.7 não melhorou significativamente a qualidade em relação ao Opus 4.6, ao mesmo tempo em que aumentou o custo. Portanto, eles decidiram não disponibilizar o Opus 4.7 internamente. A Databricks observou regressões de custo semelhantes ao comparar o Opus 5.0 com o 4.8.
Flexibilidade de Harness e de Modelos
Como os maiores ganhos vêm da mudança para novos modelos, a adoção de ferramentas de usuário final que permitam a flexibilidade de modelos está se tornando um componente crítico para manter os custos baixos. A ferramenta mais comumente usada em conjunto com um modelo específico é chamada de harness. Os modelos de fronteira proprietários são cada vez mais codesenhados para funcionar bem com harnesses específicos, o que significa que certos harnesses “funcionam melhor” com determinados modelos. Se uma empresa deseja preservar a independência de modelos, existem basicamente duas abordagens:
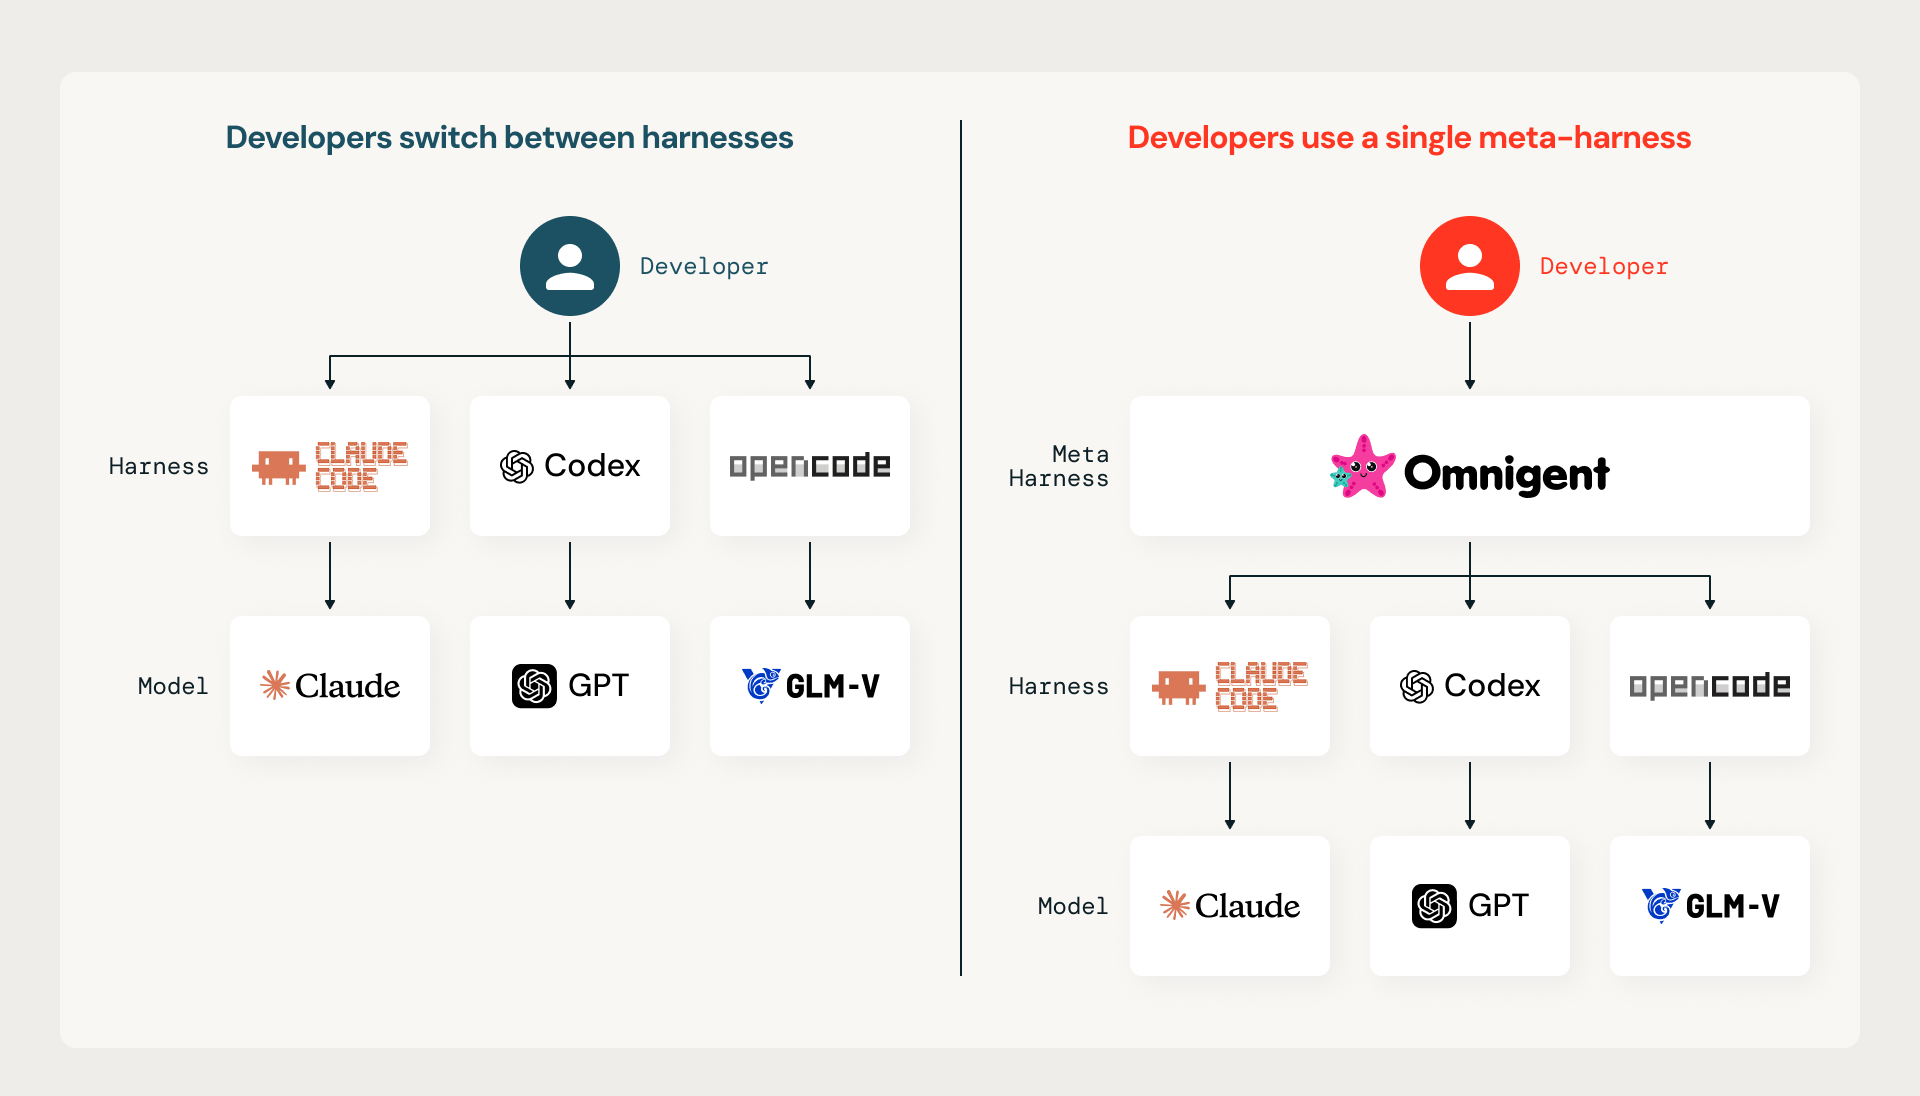
Pedir aos usuários que mudem de harness. Uma abordagem é fornecer aos desenvolvedores um conjunto de harnesses (Claude Code, Codex ou Cursor) e, em seguida, pedir que eles alternem entre os harnesses quando a empresa quiser migrar os gastos para modelos de menor custo. Isso permite que os usuários trabalhem em seu harness preferido sempre que possível, mas a desvantagem dessa abordagem é que os custos de mudança para um desenvolvedor individual podem ser altos. Se os custos de mudança se tornarem muito altos, o próprio harness se torna um bloqueio de fato (lock-in) a uma família de modelos, limitando a capacidade de direcionar os gastos para modelos mais competitivos.
Usar um meta-harness. Uma abordagem nova e cada vez mais popular é usar um meta-harness que apresenta uma experiência de usuário comum aos desenvolvedores enquanto encaminha as solicitações para os harnesses subjacentes (tanto proprietários quanto de código aberto). Essa abordagem permite a independência de modelo/harness e, ao mesmo tempo, reduz os custos de mudança para o desenvolvedor. Na Databricks, este é o modo padrão para desenvolvedores que utilizam o Omnigent. Algumas empresas com quem conversamos criaram meta-harnesses internos personalizados que se integram à sua cadeia de ferramentas de desenvolvimento.
Alavanca de Custo nº 2: Roteamento Dinâmico de Solicitações e Tarefas
Em vez de pedir aos próprios usuários que escolham modelos apropriados para a tarefa, um corpo crescente de pesquisas sugere que a seleção automática de modelos e ferramentas pode extrair ainda mais eficiência dos fluxos de trabalho de codificação agêntica. As abordagens de roteamento dividem-se basicamente em três categorias:
- Roteamento em Nível de Solicitação: Um proxy stateful fica posicionado entre um cliente (como um harness de codificação) e os modelos de fundação subjacentes. O proxy tenta rotear as solicitações para o modelo de menor custo capaz de responder a cada solicitação de inferência. O roteamento para casos de uso agênticos também precisa considerar o cache do lado do servidor, já que um acesso a cache frio (cold cache hit) tem um custo muito alto para cargas de trabalho de contexto grande. Uma nova onda de produtos está apresentando resultados iniciais promissores para o roteamento. Exemplos são: o Cursor Router, o AutoRouter da OpenRouter, o recurso Router da Ramp e o próprio recurso Smart Routing da Databricks no Unity AI Gateway.
- Roteamento em Nível de Tarefa (Meta-Harness): Um processo do lado do cliente despacha as tarefas do usuário para diferentes harnesses com base na complexidade da tarefa. Uma tarefa do usuário pode ser “renomear este componente de X para Y” (uma tarefa simples) ou uma tarefa aberta como “Explorar considerações de design que reduziriam a latência” (uma tarefa complexa). O despachante, frequentemente chamado de Meta-Harness, examina qual nível de modelo subjacente é necessário para uma tarefa e, em seguida, delega toda essa tarefa de ponta a ponta para o modelo. Omnigent é um exemplo de Meta-Harness que suporta esse padrão.
- Padrões de Escalação/Delegação: Um único harness emparelha dois modelos (um modelo caro e de alta inteligência e um modelo de execução barato). Em algumas abordagens, como a Claude’s Advisor Tool, o modelo mais barato lidera o processo e escala a tarefa quando considera que ela exige mais capacidade de processamento. O padrão inverso também existe: no Devin Fusion da Cognition, o modelo de custo mais alto é o loop principal e ele terceiriza o trabalho seletivamente para um modelo mais barato.
Resultados internos na Databricks sugerem que o Smart Router do nosso AI Gateway é capaz de reduzir consistentemente o custo médio das tarefas em mais de 30%, mantendo uma qualidade muito próxima à do modelo mais caro do conjunto de trabalho. Outras empresas com quem conversamos obtiveram resultados semelhantes.

Alavanca de custo nº 3: dar visibilidade, alertas e orçamentos aos desenvolvedores
Pode ser surpreendente que este artigo inteiro não tenha começado e terminado com "Dê aos usuários um orçamento mensal e pronto." Orçamentos rígidos, em que o uso é totalmente interrompido em um limite específico de gastos, geralmente são usados apenas como último recurso em todas as empresas com quem conversamos. Há dois motivos pelos quais os orçamentos rígidos de tokens não são particularmente eficazes para a gestão de gastos com AI: Primeiro, se um desenvolvedor atingir o teto do orçamento, cortar o acesso a ferramentas de AI prejudicaria gravemente a produtividade. Nem a empresa nem o funcionário querem esse resultado. Segundo, pelo menos alguns dos usuários de "alto gasto" são, na verdade, aqueles que alcançaram ganhos monumentais de eficiência com AI e estão gerando entregas imensas. Desestimular esses usuários é contraproducente.
Em vez de um limite rígido de gastos por usuário, a maioria das empresas está adotando uma abordagem mais sutil e progressiva, focada na visibilidade para os usuários finais e em níveis crescentes de fricção à medida que os gastos aumentam.
Visibilidade: todas as empresas com quem conversamos tinham um mecanismo para fornecer feedback quase instantâneo aos usuários sobre seus gastos contínuos, e muitas também ofereciam dicas ou insights específicos sobre como reduzir custos usando modelos mais baratos. É importante que os usuários consigam ver seus gastos em todas as ferramentas, pois eles podem querer influenciar a escolha da ferramenta onde obtêm o maior ROI.
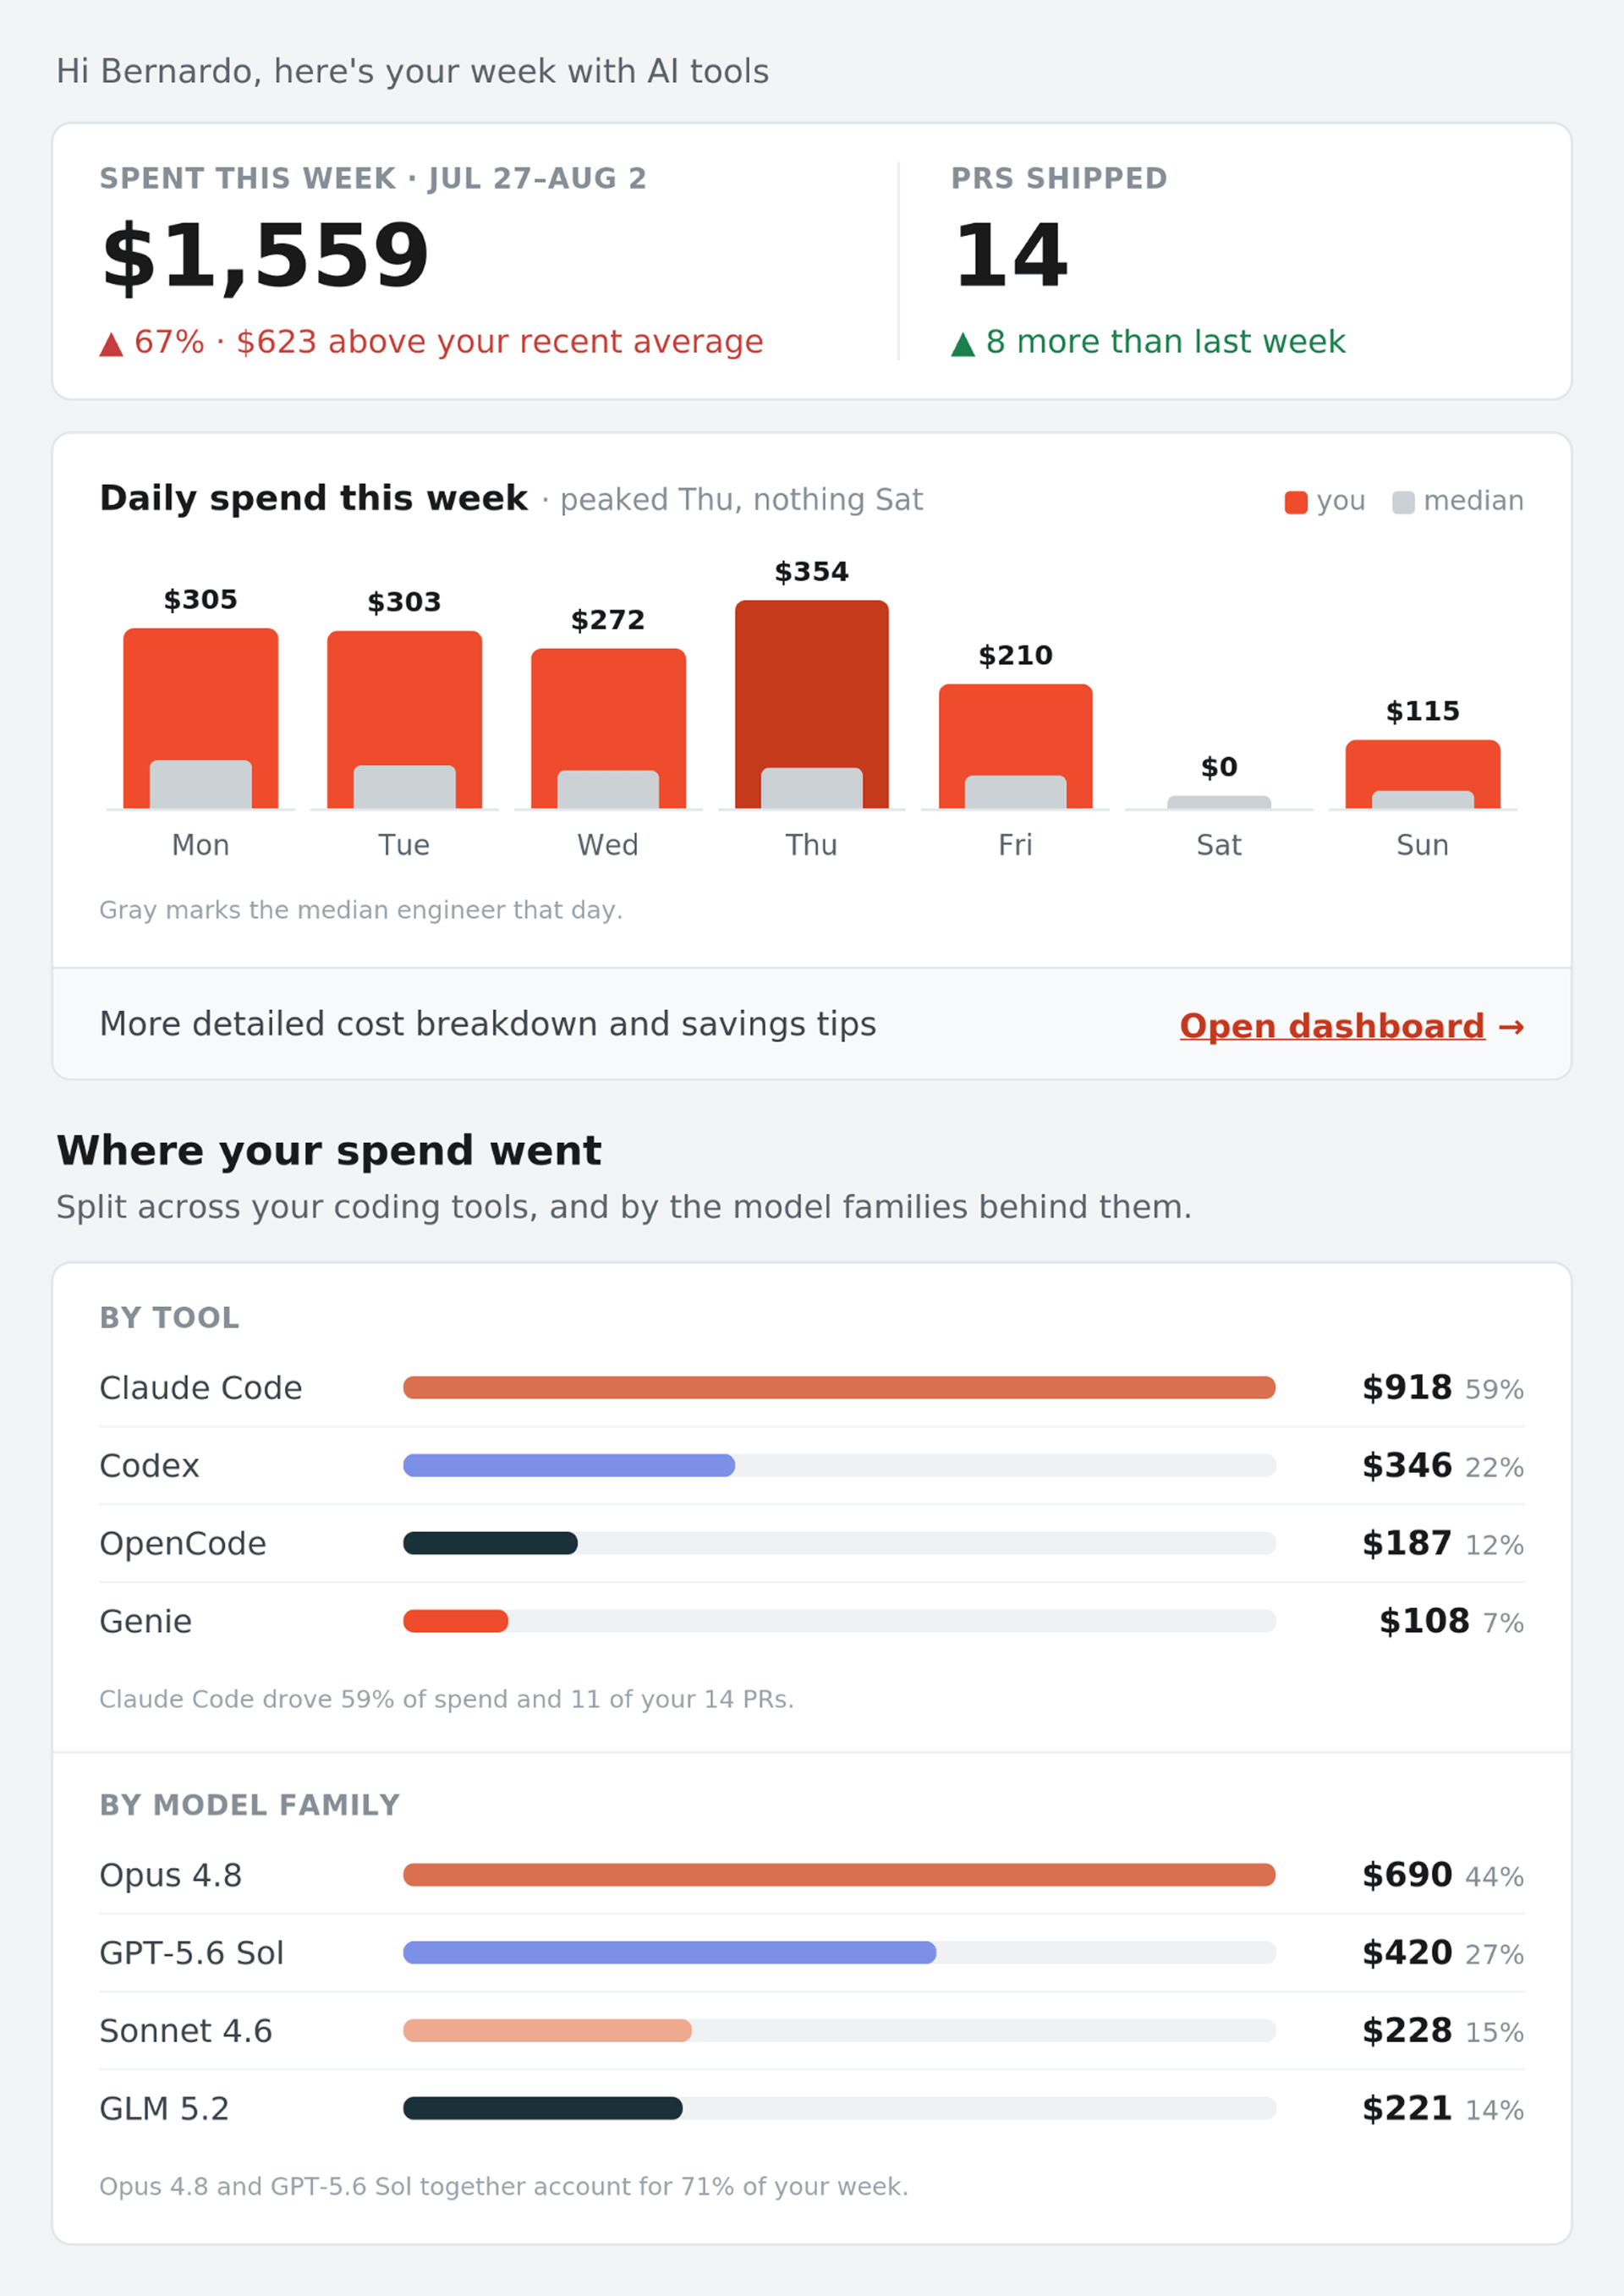
Um painel de desenvolvedor no Databricks mostrando os gastos ativos
- Barreiras de gastos: pode ser solicitado aos desenvolvedores que tomem medidas ou busquem aprovações em níveis crescentes de gastos. A forma mais simples de barreira de gastos é aquela que pode ser liberada pelo próprio usuário e serve como um aviso de que a taxa de gastos está subindo acima de um determinado limite. No Databricks, descobrimos que as barreiras autoliberáveis são um mecanismo útil para evitar gastos acidentais ou não intencionais. Barreiras adicionais podem ser introduzidas para exigir aprovação explícita de orçamento (geralmente por meio de uma cadeia de gerenciamento).
- Redução de escala (downshifting): se um desenvolvedor atingir uma barreira de gastos, ele poderá ser migrado para um modelo de menor custo, em vez de ter seu acesso a tokens totalmente suspenso. Como os modelos de menor custo são drasticamente mais baratos do que os modelos de inteligência de ponta, essa técnica permite que os desenvolvedores continuem trabalhando sem gerar gastos contínuos massivos.
- Suspensão: em casos extremos, a maioria dos sistemas mantém a capacidade de suspender totalmente o acesso dos usuários a todos os tokens. Como mencionado acima, essa costuma ser apenas uma medida temporária e o ponto de partida para uma conversa sobre como aproveitar a AI de maneira eficiente.
Alavanca de custo nº 4: reduzir o overhead de tokens
Quando um usuário digita uma solicitação relativamente simples em um agente de codificação de AI (como "Por favor, investigue e corrija este bug."), esse agente subsequentemente reúne grandes volumes de contexto relevante, aciona um grande número de ferramentas, pesquisa na base de código e integra habilidades ou informações do sistema fornecidas pela empresa. No momento em que ocorre a dispendiosa inferência do LLM, a instrução inicial do usuário representa apenas uma fração insignificante dos dados inseridos no sistema de AI, o que significa que os custos são dominados pelo contexto que o usuário não incluiu explicitamente. As técnicas para reduzir o inchaço do contexto ainda são novas, mas várias abordagens promissoras estão sendo exploradas, tais como:
- Forçar uma compactação (compressão) mais frequente do contexto ativo.
- Usar harnesses que sejam "menos prolixos" (mais eficientes em termos de tokens) ou ajustar os harnesses existentes para gerar menos overhead de tokens.
- Auditar ferramentas populares e diminuir sua verbosidade.
- Incentivar os desenvolvedores a dividir tarefas em unidades de trabalho individuais menores, diminuindo o escopo do contexto.
Quando os contextos ficam grandes, o caching de prompts também desempenha um papel significativo no desempenho geral. Tanto os LLMs proprietários quanto os de código aberto têm configurações que permitem ativar o caching de prompts e ajustar por quanto tempo o cache é armazenado. As gravações no cache custam dinheiro, mas as leituras em cache podem reduzir drasticamente o custo por inferência. Essa compensação (trade-off) depende da carga de trabalho específica de uma empresa, portanto, o ajuste manual das configurações padrão de cache para aumentar a taxa geral de acertos do cache (cache hit rate) pode trazer melhorias drásticas no custo total.
No Databricks, um ajuste relativamente simples de nossas configurações de harness e cache levou a uma redução de quase 50% no número de tokens gerados e nos custos associados, sem degradação observada na qualidade para os desenvolvedores. Continuamos a explorar técnicas nessa área e acreditamos que ainda é possível obter otimizações adicionais significativas.
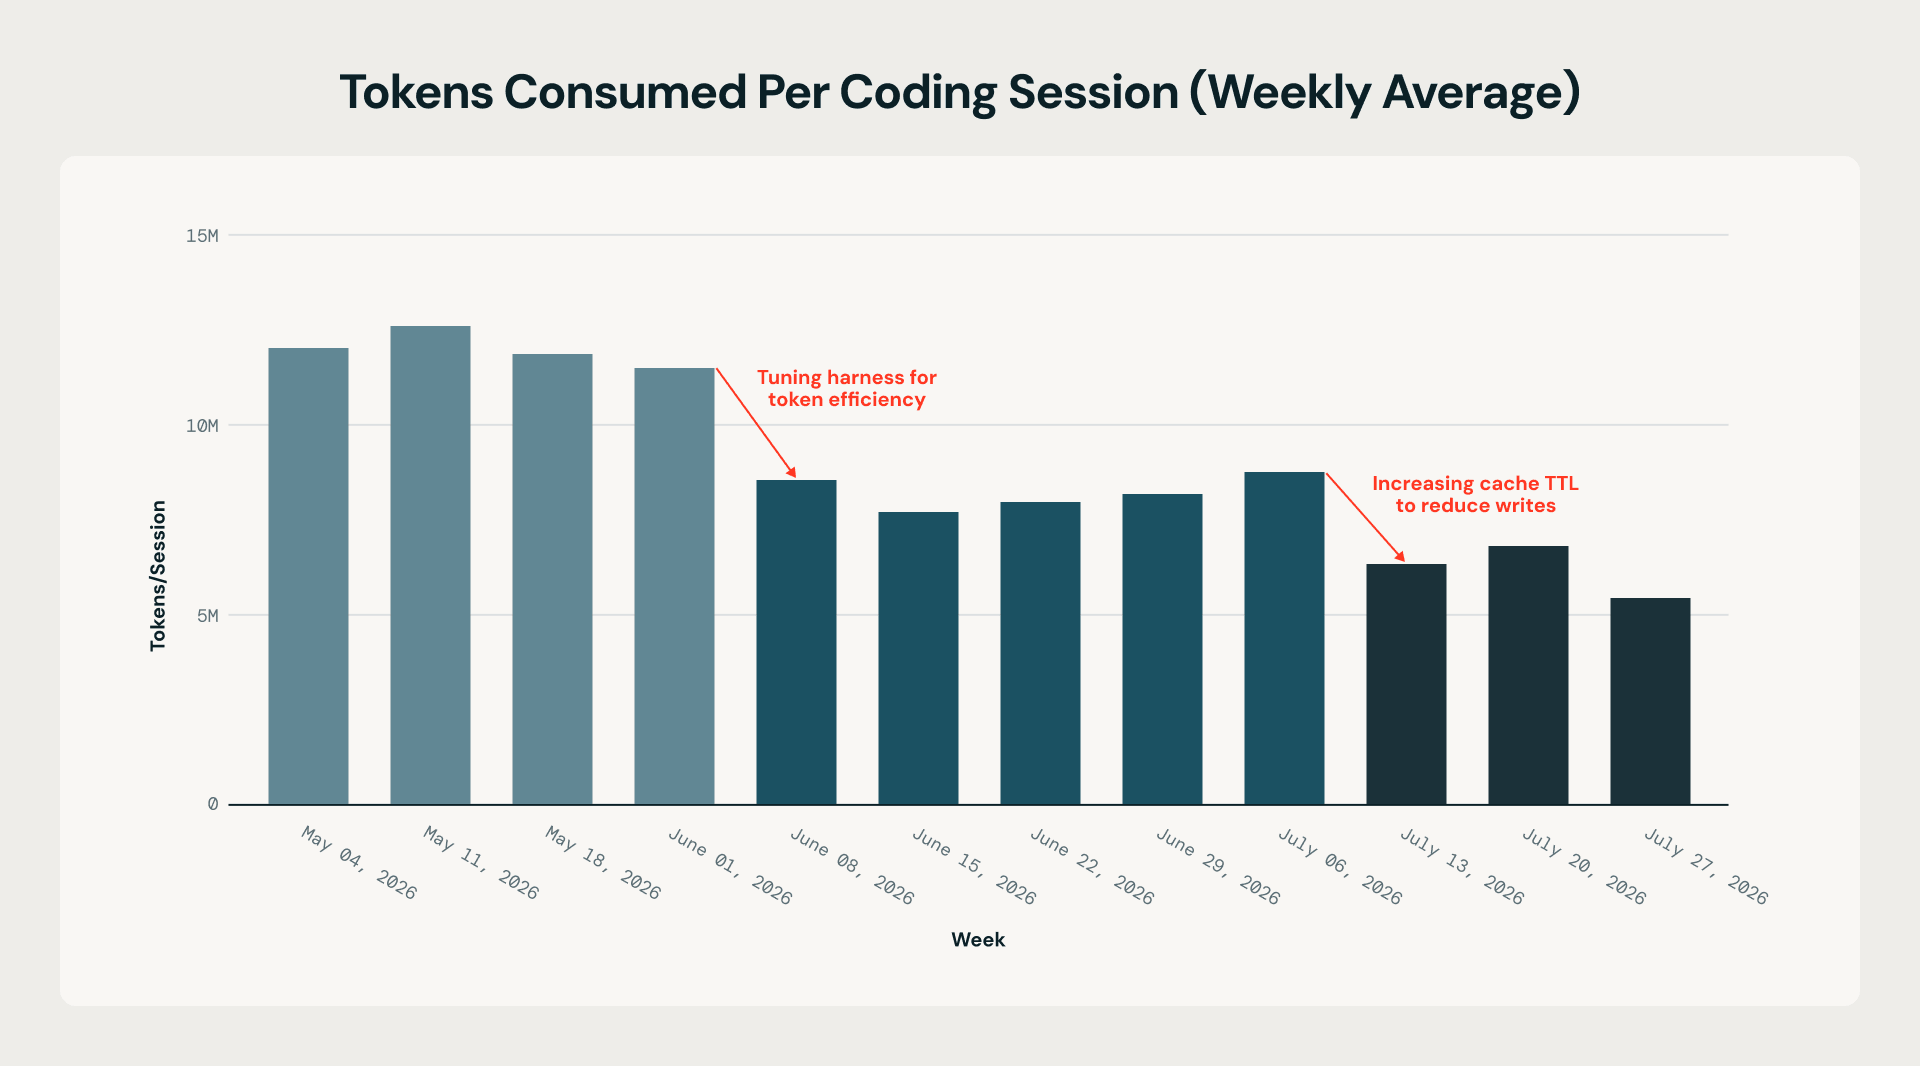
Uma redução drástica nos tokens por sessão ao eliminar chamadas de inferência supérfluas e reduzir as gravações em cache.
O padrão de design do AI Gateway
As técnicas acima tinham muitos requisitos técnicos implícitos: para aproveitar rapidamente os novos modelos, as empresas precisam ter um local central onde o "menu de modelos" seja gerenciado, e os usuários finais precisam ter uma cadeia de ferramentas (toolchain) que suporte a combinação de modelos. Para fornecer visibilidade de orçamento em várias ferramentas de AI, deve existir uma capacidade unificada de observabilidade de custos. Para gerenciar o inchaço do contexto, as empresas precisam de uma maneira de observar as saídas típicas de chamadas de ferramentas (toolcalls) e aplicar compressão ou compactação. Essas necessidades estão sendo resolvidas coletivamente por uma nova classe de software de infraestrutura, mais bem descrita como um AI Gateway. Um AI gateway é um local central onde ocorre tudo o que se segue:
- Gerenciamento de capacidade e proxying de acesso aos modelos subjacentes (tanto modelos proprietários quanto OSS).
- Acompanhamento e aplicação de orçamento, incluindo políticas de orçamento complexas, como níveis progressivos de fricção e redução de escala de modelos.
- Gerenciamento de configuração para ferramentas de usuário final, para aplicar listas de permissões (allow-lists) de modelos, configurações de compactação e outros aspectos mediados localmente.
- Registro (logging) de rastreamentos (traces) de sessões de codificação para análise de eficiência e benchmark downstream.
No Databricks, dependemos fortemente do Unity AI Gateway para todos esses recursos.
Consolidando tudo
O crescimento exponencial dos custos de codificação com AI não é uma inevitabilidade; é um problema de engenharia e governança solucionável. As empresas que conseguiram controlá-lo compartilham um manual comum: buscar incansavelmente a fronteira da eficiência em vez da fronteira da inteligência, adotar ferramentas que preservem a flexibilidade do modelo, direcionar o trabalho de forma inteligente para o modelo capaz mais barato, substituir orçamentos rígidos por visibilidade e fricção progressiva, e cortar o overhead de tokens que domina os gastos no mundo real. Nenhuma dessas técnicas exige sacrificar os ganhos de produtividade que tornaram a adoção da AI vantajosa em primeiro lugar; juntas, elas permitem que as organizações atendam ao duplo mandato de acesso amplo e de baixa fricção dentro de um limite de custo previsível.
Um conjunto de novas abstrações de infraestrutura está surgindo para dar às empresas as ferramentas para gerenciar seus custos. No Databricks, lançamos os principais componentes de nossa pilha de gerenciamento de custos como produtos de código aberto ou software livre: nosso Unity AI Gateway para gerenciamento central e o Omnigent para ferramentas de desenvolvedor. Milhares de empresas usam esses componentes todos os dias. Convidamos mais empresas a compartilhar descobertas e comparar técnicas à medida que esse cenário tecnológico evolui rapidamente.
Agradecimentos: obrigado aos líderes de infraestrutura da Uber, Stripe, Coinbase e Ramp que forneceram comentários e revisões para este artigo. Obrigado à Thrive Capital pelo feedback em um rascunho inicial deste artigo.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.