Processando dados simultaneamente de várias plataformas de streaming usando Spark Declarative Pipelines
Gerencie e consuma facilmente de diversas plataformas de streaming em múltiplas nuvens por meio de um único pipeline de ETL.
Um dos grandes imperativos das organizações hoje é permitir a tomada de decisões na velocidade dos negócios. Equipes de negócios e sistemas de decisão autônomos geralmente exigem todas as informações necessárias para tomar decisões e responder rapidamente assim que os eventos de origem acontecem – em tempo real ou quase real. Essas informações, conhecidas como eventos na terminologia de processamento de stream, são retransmitidas de forma assíncrona de uma origem para um destino e geralmente são feitas por meio de um message broker ou message bus.
À medida que as organizações crescem e as equipes se ramificam em outras equipes, os padrões de uso, o número e a variedade de message brokers aumentam. Em cenários de fusões e aquisições, as empresas costumam herdar novos message brokers, que precisam ser integrados aos seus processos de engenharia de dados existentes. Gerenciar uma infinidade de message brokers, seus produtores, consumidores e pipelines de engenharia de dados de forma coerente pode ser desafiador devido ao número de tecnologias, plataformas de nuvem e linguagens de programação em que precisam de especialização.
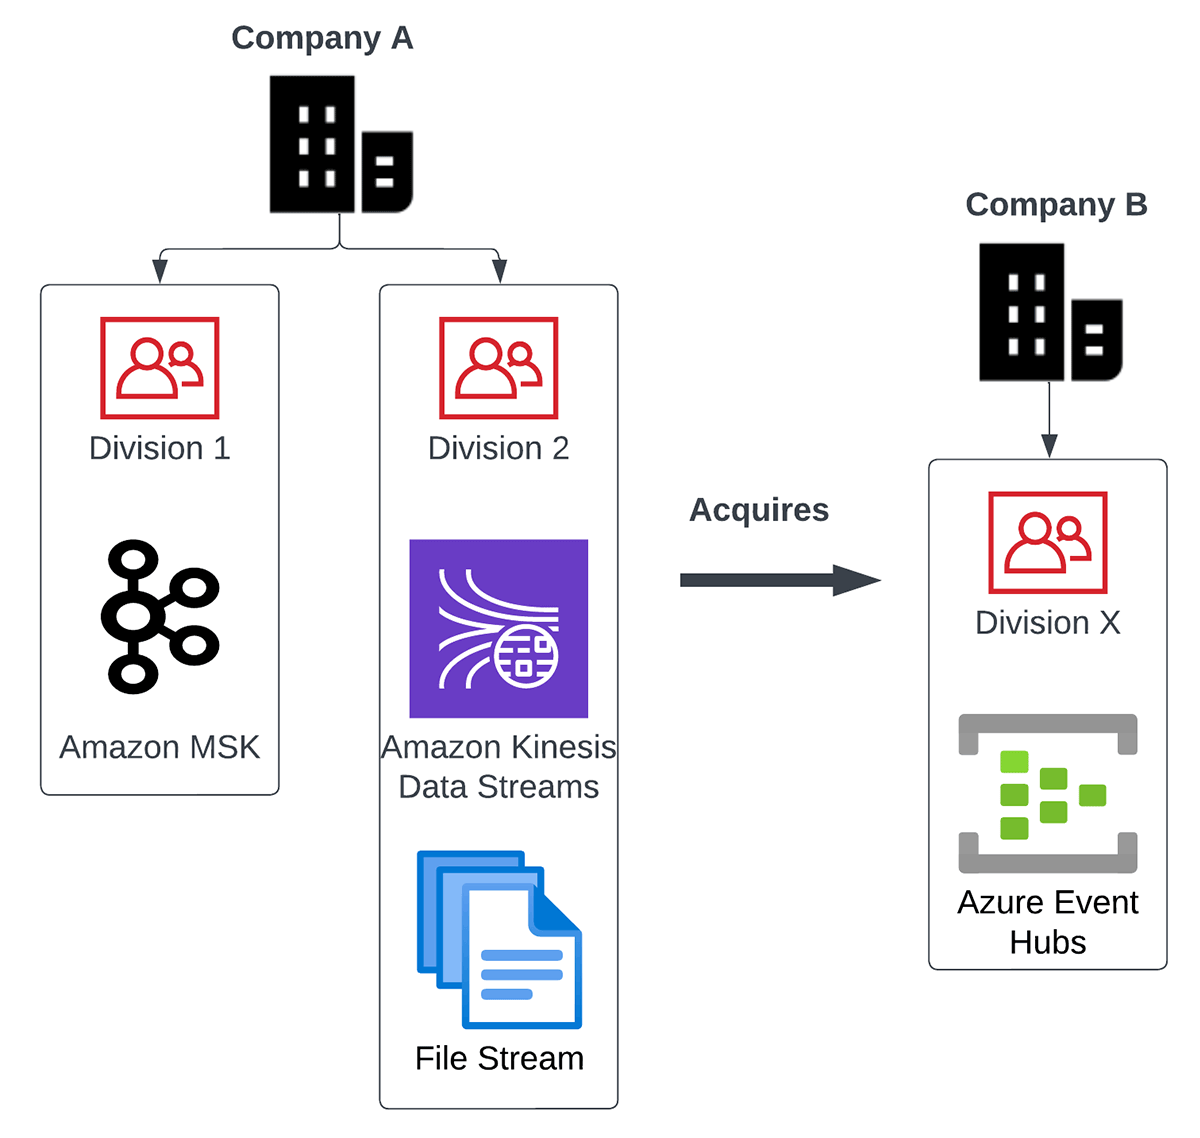
Por exemplo, vamos analisar um caso de uso de multi-stream. Imagine a seguinte situação em um conglomerado global, onde
- Eles têm duas divisões principais que usam dois message brokers separados – Amazon Kinesis Data Streams e Amazon Managed Service for Kafka (MSK).
- Eles adquiriram outra empresa de produtos menor que usa o Azure Event Hubs internamente.
- Eles também têm uma importante fonte de dados que chega na forma de um stream contínuo de arquivos csv ou json.
O diagrama abaixo ilustra o caso de uso de multi-stream descrito acima:
Aqui estão alguns dos principais desafios no processamento de todos esses dados em tal cenário:
- Como eles integram todas essas fontes de dados variadas e suas tecnologias?
- Como eles constroem sistemas de engenharia de dados de forma que sejam fáceis de escalar e manter? Eles contratam talentos especializados para cada tecnologia diferente?
- Como eles garantem que, no processo de solução desse enigma tecnológico, não se esqueçam do objetivo final – dar sentido aos dados e acelerar as decisões?
- Como eles garantem que as necessidades de lote e streaming possam ser atendidas pelo mesmo sistema de processamento de dados?
Neste blog, demonstraremos como esses problemas podem ser resolvidos de maneira fácil e limpa por meio de Spark Declarative Pipelines (SDP). Spark Declarative Pipelines na Databricks Lakehouse Platform simplifica a criação e o gerenciamento de pipelines de dados em lote e streaming de alta qualidade.
Caso de uso de multi-stream
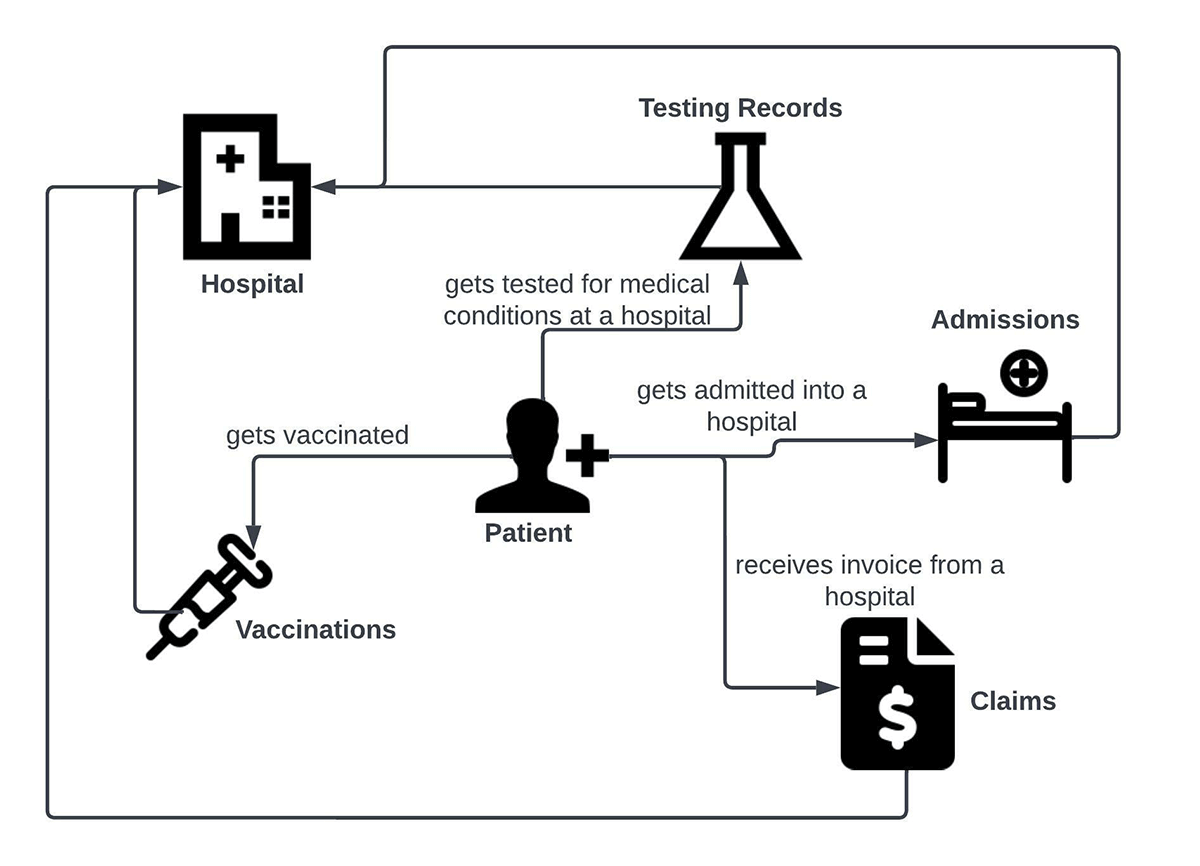
Para demonstrar um cenário de processamento de multi-stream por meio do SDP, vamos imaginar um caso de uso no setor de saúde. No centro do caso de uso está um paciente. O paciente conclui as seguintes interações com outra entidade, um hospital:
- Recebe uma vacina contra condições médicas em um hospital
- Faz um teste para condições médicas em um hospital
- É internado em um hospital para determinadas condições médicas
- Recebe uma fatura pelo tratamento, por meio de um processo de reivindicação
Essas interações podem ser representadas no diagrama de caso de uso de negócios abaixo.
As entidades envolvidas nessas interações podem ser representadas na forma do diagrama de entidade-relacionamento (ER) abaixo. De agora em diante, faremos uso amplo dos termos Fatos e Dimensões do léxico de modelagem dimensional de Data Warehousing. No diagrama ER, você pode ver que Paciente e Hospital são tabelas de dimensão, enquanto os dados de internações, vacinações, registros de testes e reivindicações são representados na forma de tabelas de fatos.
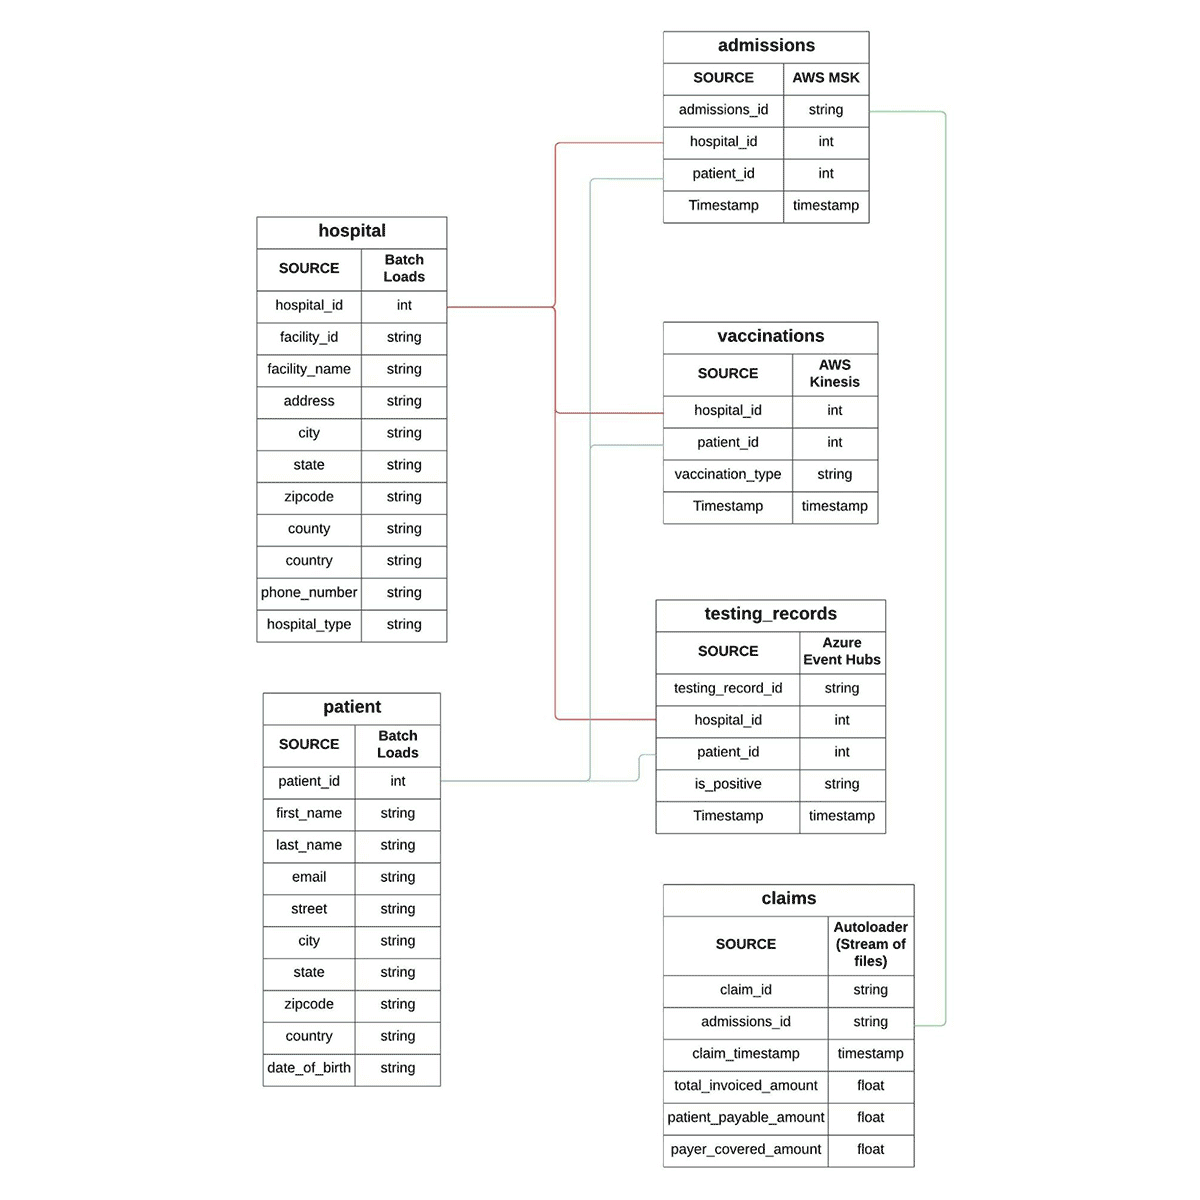
Digamos que os dados de fatos para internações, vacinações, registros de testes e reivindicações cheguem por meio de diferentes message brokers. Para este blog, selecionamos os mais populares do setor, ou seja, Apache Kafka (Amazon MSK), AWS Kinesis Data Streams e Azure Event Hubs. Nossa quarta maneira de exibir um cenário de processamento de stream é ingerindo uma sequência de arquivos incrementalmente em tabelas (Delta Lake neste caso). Selecionamos o Databricks Autoloader para essa finalidade. Com essas informações, o diagrama de interações do paciente agora pode ser atualizado com as fontes de dados relevantes:
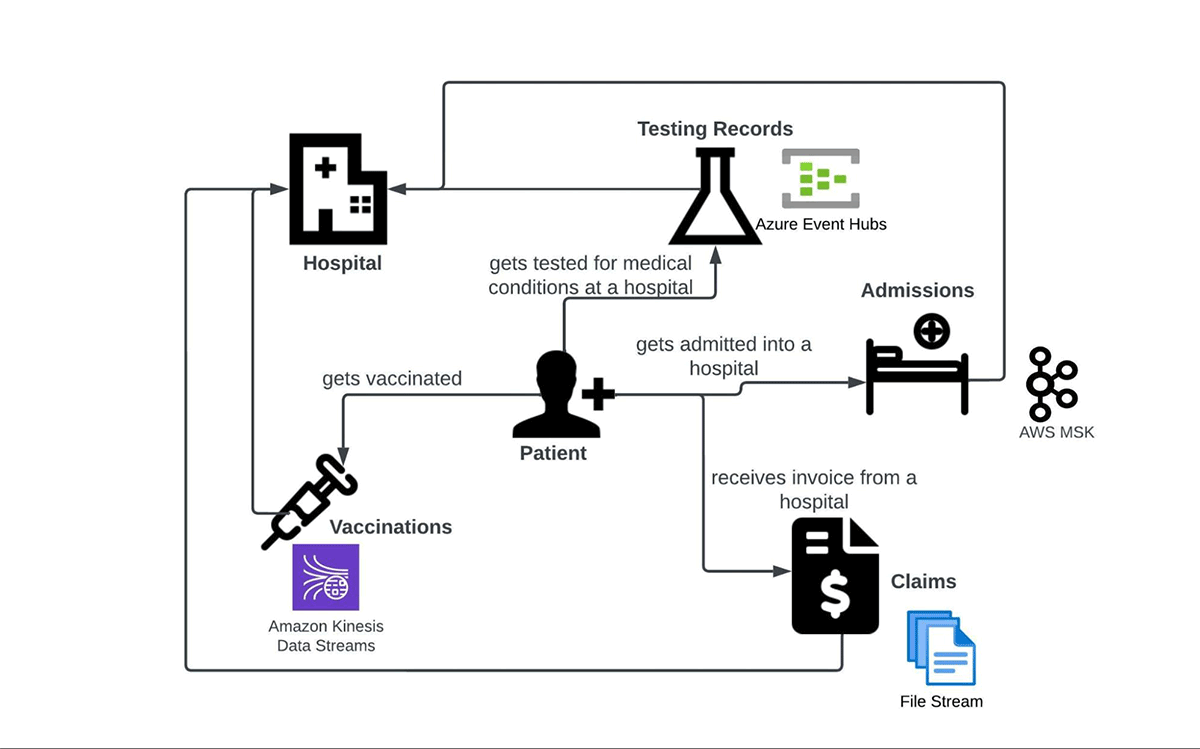
Abaixo estão as fontes de dados resumidas em formato de tabela:
| Fato | Fonte de dados |
| Internações | Amazon MSK (Apache Kafka) |
| Registros de Teste | Azure Event Hubs |
| Vacinações | AWS Kinesis Data Streams |
| Reivindicações | Stream incremental de arquivos |
Na próxima seção, demonstraremos como um único pipeline SDP pode ingerir dados das fontes de streaming acima simultaneamente e também executar ETL neles. Usamos a infraestrutura da AWS para configurar os recursos e o pipeline para este blog, mas os cenários devem ser configuráveis de maneira semelhante em outras nuvens públicas, como Azure e GCP.
Processamento de multi-stream por meio de SDP
O diagrama abaixo ilustra a aparência de um pipeline SDP comum. Embora a ingestão e a transformação de dados em streaming provenientes de diversas fontes resumam o escopo deste blog, há recursos adicionais do SDP que também merecem atenção. Por exemplo, o gerenciamento de qualidade de dados é um recurso fundamental que pode ajudar as equipes a processar apenas os dados que passam por certas 'expectativas'. As equipes podem tomar medidas corretivas e preventivas sobre os dados incorretos. Outros benefícios do SDP são o ponto de verificação gerenciado e o autoscaling aprimorado. Você pode ler sobre esses e mais recursos neste artigo: Conceitos do Spark Declarative Pipelines.
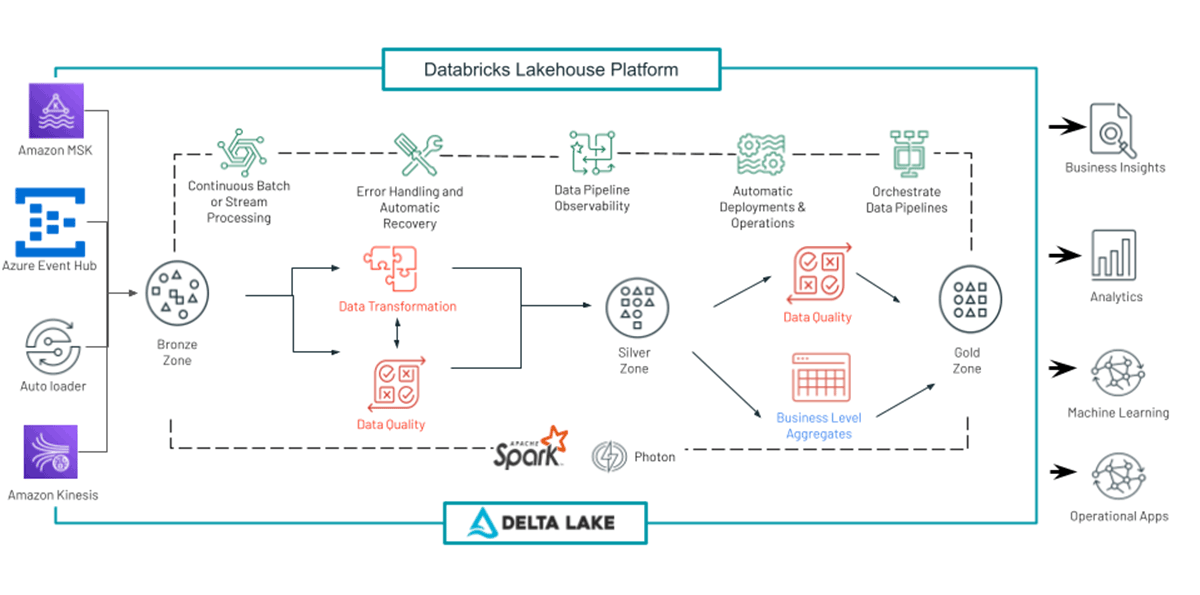
Nosso pipeline SDP de processamento de multi-stream (vamos chamá-lo de sdp_multistream_consumer para simplificar) envolve as seguintes operações:
- Carregar dados de streaming dos message brokers em uma camada bruta de tabelas do Delta Lake.
- Analisar e aplicar o esquema sobre os dados brutos para gerar fatos significativos (tabelas de fatos) a partir de cargas úteis de mensagens.
- Gerar conjuntos de dados agregados para consumo pelas equipes de BI e Analytics. Isso é feito unindo várias tabelas de fatos e dimensões e fatiando/dividindo os registros gerados.
Um pipeline SDP pode ser configurado para operar nos seguintes modos:
- Contínuo: Um cluster ativo processa os dados assim que eles chegam de forma contínua. Isso é recomendado para cenários de streaming em que a latência é primordial.
- Acionado: Um cluster é ativado em uma programação desejada e processa os dados disponíveis naquele momento. Quando não houver mais dados pendentes para processamento (por um determinado limite de duração de tempo), o cluster será desativado. Esse modo é recomendado quando a economia de custos e a taxa de transferência têm precedência sobre a latência.
Para este blog, estamos usando o modo contínuo por dois motivos. O primeiro é demonstrar um cenário de processamento de fluxo 'verdadeiro', onde os dados são capturados e processados em tempo real. Em segundo lugar, o conector do Amazon Kinesis Data Streams para Apache Spark, no momento da publicação deste blog, não oferece suporte a um modo de ingestão em lote (ou seja, disparar uma vez ou disponível agora), o que ocorre com o modo disparado. No entanto, isso estará disponível em breve.
Outro ponto a destacar é que, geralmente, em uma configuração de produção, assim que os dados brutos são ingeridos, eles passam por vários estágios de processamento e enriquecimento. Esses estágios limpam, transformam e agregam os dados para casos de uso de negócios envolvendo análise de dados, análise histórica e preditiva de dados. Chamamos de Medallion Lakehouse Architecture a melhoria progressiva na estrutura e qualidade dos dados à medida que eles passam por cada camada da arquitetura. Embora a arquitetura Medallion seja uma boa prática para casos de uso tradicionais, para simplificar este blog, vamos pular a parte de transformação de dados e passar para a análise de dados para atender aos casos de uso de negócios.
Agora, vamos ver como podemos realizar a ingestão de dados em streaming – tudo de uma vez a partir de uma infinidade de sistemas de streaming usando SDP no Delta Lake e analisar esses dados para gerar insights úteis.
Ingerindo dados de streams
Nesta seção, mostramos como vamos ingerir dados de várias plataformas de streaming.
Ingerindo dados do Amazon MSK
O Amazon Managed Streaming for Apache Kafka (Amazon MSK) é um serviço totalmente gerenciado que permite criar e executar aplicativos que usam o Apache Kafka para processar dados de streaming. O Amazon MSK fornece operações de plano de controle, como aquelas para criar, atualizar e excluir clusters.
Usamos um cluster MSK com as seguintes configurações para os fins deste blog:
- Tipo de cluster - Provisioned
- Número total de brokers - 2
- Versão do Apache Kafka - 2.5.1
- Tipo de broker - kafka.m5.large
- Número de zonas de disponibilidade - 2
- Volume de armazenamento EBS por broker - 300 GiB
- Criptografia entre clientes e brokers:
- Criptografia TLS - Habilitada
- Texto sem formatação - Habilitado
Para autenticação no ambiente AWS, anexamos um perfil de instância ao cluster SDP. Ele faz referência a uma função IAM com permissões de leitura/gravação apropriadas, conforme configurado na definição da função.
O pipeline sdp_multistream_consumer ingere o conjunto de dados Hospital Admission do tópico MSK admission na tabela do Delta Lake chamada msk_admissions_tbl_raw. O payload do Kafka (binário representado como uma string) para um fato de Admissões se parece com isto:
Usamos o seguinte código em um notebook Python para ingestão e o anexamos ao nosso pipeline SDP sdp_multistream_consumer.
O pipeline sdp_multistream_consumer, quando iniciado, cria a tabela msk_admissions_tbl_raw dentro do banco de dados/esquema desejado e preenche a tabela com os dados lidos do tópico admission. Em seguida, continua ingerindo dados adicionais conforme novos dados são gravados nesse tópico.
Além dos quatro campos ingeridos do tópico do Kafka, adicionamos uma coluna msk_event_timestamp (derivada do timestamp do evento gerado pelo Kafka) à tabela msk_admissions_tbl_raw. As mensagens são recebidas no campo value do payload do Kafka em formato binário. Elas precisam ser convertidas em string para que os processos a jusante possam analisá-las.
Ingerindo do Amazon Kinesis
Amazon Kinesis Data Streams facilita a coleta, o processamento e a análise de dados de streaming em tempo real. Os dados podem ser vídeo, áudio, logs de aplicativos, fluxos de cliques de sites e dados de telemetria de IoT para machine learning, análises e outros aplicativos. Para o nosso blog, usamos um Kinesis data stream com as seguintes configurações:
- Nome do Data Stream: test_vaccination_data
- Modo de capacidade: Sob demanda
- Capacidade de gravação: 200 MiB/segundo ou 200.000 registros/segundo (Máximo padrão)
- Capacidade de leitura: 400 MiB/segundo (Padrão)
Para melhor throughput, o recurso Amazon Kinesis enhanced fan-out (EFO) do conector Databricks Runtime Kinesis pode ser usado em cenários de produção.
O stream test_vaccination_data, em nosso caso de uso, carrega os fatos de vacinação (eventos) de um paciente. Abaixo está um exemplo de payload:
O código SDP para consumir os dados do Kinesis data stream para a Landing Zone no Lakehouse é o seguinte:
O pipeline sdp_multistream_consumer preenche a tabela de destino kinesis_vaccination_tbl_raw com os dados disponíveis no Kinesis data stream e executa um ponto de verificação (checkpoint) para evitar a releitura dos dados. As mensagens são recebidas no campo data do payload do Kinesis em formato binário. Elas precisam ser convertidas em string para que os processos a jusante possam analisá-las.
Ingerindo do Azure Event Hubs
Azure Event Hubs é uma plataforma de streaming popular oferecida pela Microsoft. O Event Hubs oferece suporte a vários protocolos para leitura e gravação, como AMQP, HTTPS e Apache Kafka. Para este blog, nosso pipeline SDP sdp_multistream_consumer usa a interface Kafka do Event Hubs para consumir as mensagens, uma vez que o conector Kafka para Spark vem integrado no Databricks Runtime sem a necessidade de bibliotecas extras. Estamos usando o nível de preço padrão para o nosso namespace do Event Hubs com 2 unidades de throughput.
A documentação do Azure descreve os namespaces como contêineres de gerenciamento para hubs de eventos (ou tópicos, na terminologia do Kafka). O Event Hub (também conhecido como tópico) de nosso interesse é testing_records_stream, que transporta eventos referentes aos resultados de exames laboratoriais de um paciente. Cada mensagem se parece com a abaixo:
O código SDP para consumir mensagens do event hub testing_records_stream é muito parecido com o padrão de ingestão com o Amazon MSK (afinal, ambos usam o protocolo Kafka).
O pipeline SDP lê de forma incremental as mensagens de registros de teste dos Event Hubs e as adiciona como novas linhas na tabela Delta Lake eventhubs_testing_records_tbl_raw. As mensagens são recebidas no campo value do payload da interface do Kafka em formato binário. Elas precisam ser convertidas em string para que os processos a jusante possam analisá-las.
Ingerindo arquivos por meio do Auto Loader
Auto Loader é uma das ferramentas de ingestão de arquivos de dados mais potentes e robustas do mercado. Ele processa novos arquivos de dados de maneira incremental e eficiente conforme eles chegam ao armazenamento em nuvem, sem precisar de nenhuma configuração adicional. Atualmente, ele consegue ingerir os formatos de arquivo JSON, CSV, PARQUET, AVRO, ORC, TEXT e BINARYFILE.
O Auto Loader permite que os consumidores configurem uma fonte Structured Streaming chamada cloudFiles. As opções de configuração incluem caminhos de arquivos de armazenamento em nuvem, padrões de filtragem de arquivos e opções de eventos de chegada de arquivos para filas como Azure Queue Storage, AWS SQS, AWS SNS, entre outras. O pipeline SDP usa essas opções para ingerir novos arquivos automaticamente à medida que chegam, com a opção de também processar arquivos já existentes nesse diretório. O Auto Loader tem suporte para Python e SQL em pipelines SDP. Os clientes usam o Auto Loader para processar bilhões de arquivos para migrar dados ou preencher uma tabela retroativamente. Ele escala para dar suporte à ingestão em quase tempo real de milhões de arquivos por hora.
Neste blog, ingerimos dados de sinistros de pacientes usando o Auto Loader com o seguinte exemplo:
No pipeline sdp_multistream_consumer, os arquivos JSON de sinistros de pacientes são ingeridos pelo Auto Loader assim que chegam ao local de origem, como mostrado no código abaixo:
Analisando dados ingeridos para gerar insights de negócios
Como mencionado anteriormente, para este blog, já ingerimos os conjuntos de dados de pacientes de quatro origens diferentes: Amazon MSK, Amazon Kinesis Data Streams, Azure Event Hubs e Databricks Auto Loader. Por questão de brevidade, limitamos a parte de transformação de dados apenas à aplicação de esquema e estamos avançando para realizar a análise de dados nesses conjuntos de dados para dar suporte a casos de uso de negócios.
Criamos dois casos de uso de análise de negócios para este blog. A ideia é mostrar como os usuários podem usar as tabelas Delta Lake criadas pelo SDP para realizar análises de dados e responder a perguntas de negócios.
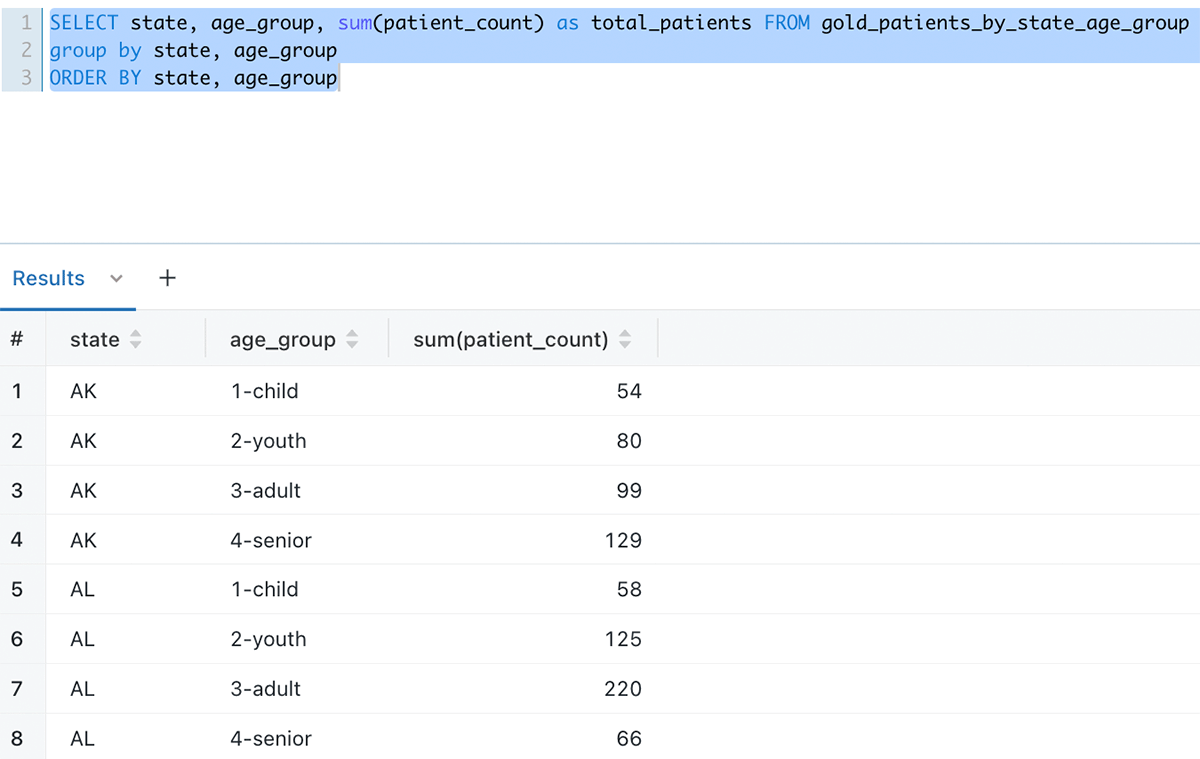
Número de pacientes por estado e faixa etária que testaram positivo para Covid após serem vacinados contra a Covid
A tabela gold_patients_by_state_age_group é criada no SDP fazendo um join das tabelas que foram populadas por meio da ingestão de dados pelo SDP. Conforme novos dados chegam à camada de ingestão, o pipeline SDP contínuo ingere esses dados na camada de ingestão e atualiza esta tabela gold_patients_by_state_age_group para análise de dados. --
Abaixo está a aparência dos dados quando consultados por meio do editor de consultas do Databricks SQL:
Número de internações por mês por cidade e estado
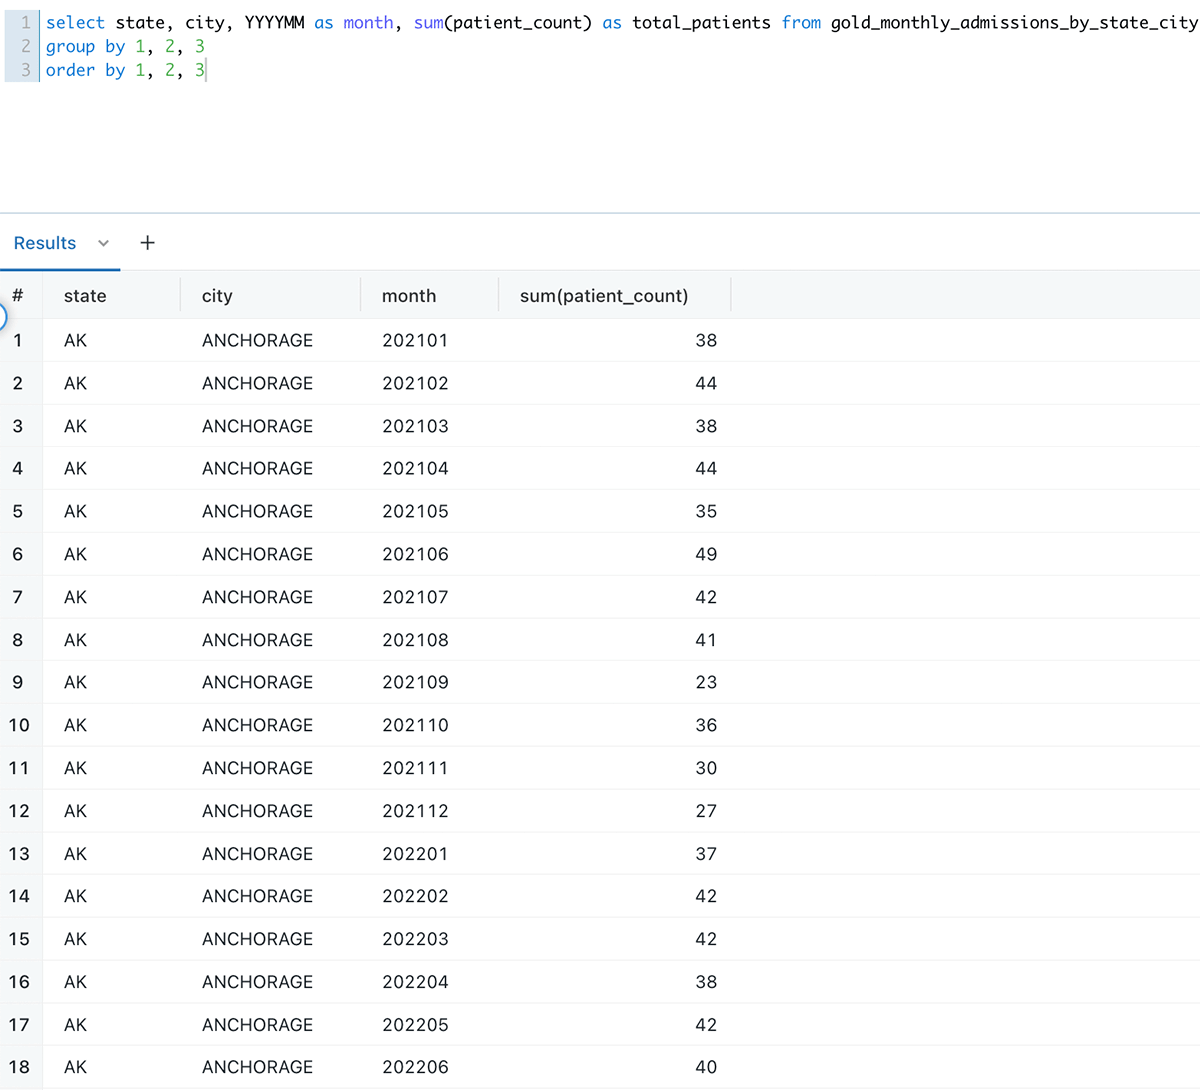
O número de internações por cidade e estado por mês é outro caso de uso que conta com suporte ao consultar a tabela gold_monthly_admissions_by_state_city.
Abaixo está a aparência dos dados quando consultados por meio do editor de consultas do Databricks SQL:
Visão de ponta a ponta do SDP Pipeline
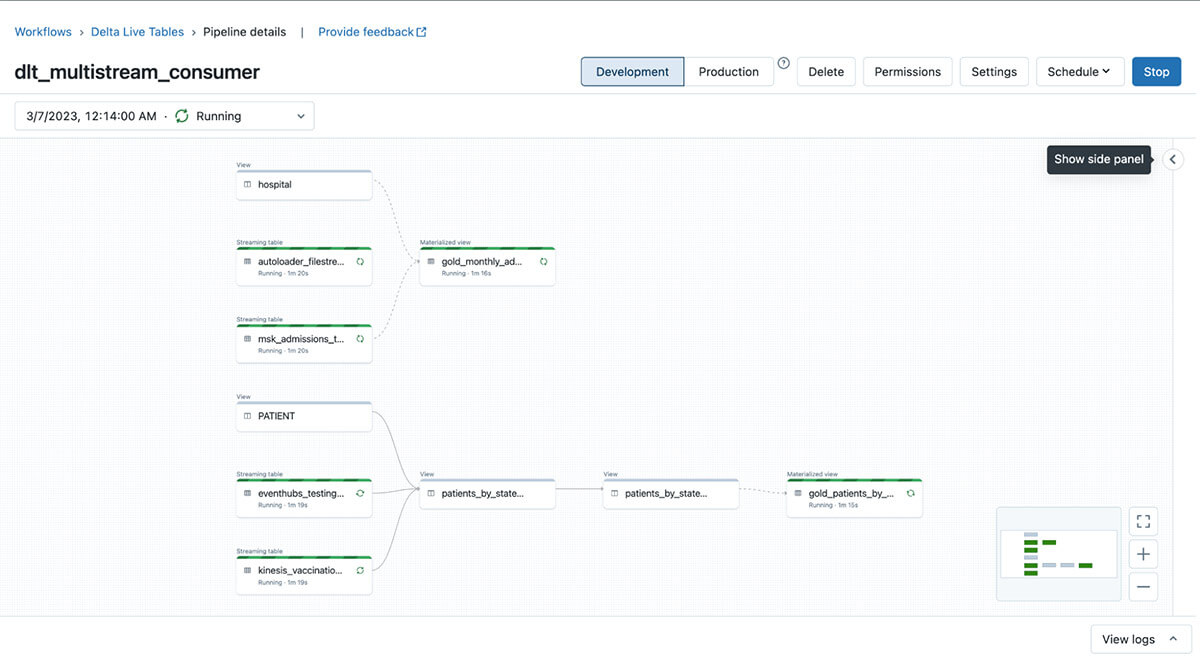
Um dos principais recursos do SDP é sua capacidade de rastrear todas as dependências em nível de tabela entre os artefatos de código incluídos como parte do pipeline e, em seguida, exibi-las na forma de um gráfico de linhagem. Esse gráfico é "ao vivo". Conforme as operações de ETL avançam, ele exibe as operações bem-sucedidas em verde e as com erro em vermelho. Uma captura de tela do nosso pipeline de dados do SDP em execução contínua é mostrada abaixo:
Conclusão
Neste blog, mostramos como você pode ingerir e consumir dados de diversas plataformas de streaming em várias clouds usando o Databricks Spark Declarative Pipelines com um único pipeline de dados. O processo de ETL acontece continuamente, assim que os dados chegam. Os dados gerados por meio de transformações ficam continuamente disponíveis para realizar análises de dados e obter respostas para as suas perguntas de negócios. Essa solução simplifica bastante a arquitetura técnica geral e facilita a manutenção e a escala. Com a Databricks introduzindo novos recursos no SDP regularmente, ele vem ganhando ampla adoção entre clientes para cargas de trabalho de ETL. Experimente o Spark Declarative Pipelines hoje mesmo.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.