El verdadero cuello de botella de la imagen biomédica son los datos, no el modelo
De los silos de PACS a la multiómica: por qué la AI de imagen se estanca en los datos y cómo construir la base para desbloquearla.
por Parastou Eslami y Douglas Moore
- Qué es: Una perspectiva sobre el terreno de por qué la IA de imágenes médicas no ofrece los resultados esperados en hospitales, el ámbito académico, medtech y la industria farmacéutica; y cómo se ve una base de datos más sólida en toda la I+D.
- El desafío: Las imágenes son los datos más ricos de la medicina, pero los menos utilizables: aislados en silos entre PACS, CRO y laboratorios centrales, difíciles de desidentificar y rara vez vinculados a otras modalidades de datos que impulsan los biomarcadores y la estratificación de pacientes. La parte difícil son los datos, no el modelo.
- La conclusión: La frontera no es un modelo mejor, sino la base de datos que lo sustenta. Gobierne las imágenes en un solo lugar, haga que se puedan consultar, desidentifíquelas a escala y vincúlelas a EHR, datos ómicos y de ensayos clínicos (a través de patrones gobernados de lakehouse). Prepare bien los datos y el modelo se convertirá en la parte fácil.
Parte I — El problema
Cuatro sectores, un mismo cuello de botella
Los hospitales y sistemas de salud generan la materia prima. La radiología es la parcela de la IA médica más regulada en todo el mundo: de los aproximadamente 950 dispositivos basados en IA/ML que la FDA había autorizado a mediados de 2024, unos 723 (alrededor del 76 %) eran herramientas de radiología. Casi todas son específicas y supervisadas por humanos, y realizan triaje, mediciones, reconstrucción o priorización de listas de trabajo. La verdadera dificultad en un hospital rara vez es el modelo. Es que los datos están bloqueados dentro de sistemas PACS y archivos independientes del proveedor creados para mostrar imágenes en un visor, no para responder preguntas de investigación. Extraer una cohorte significa obtener imágenes de sistemas clínicos, desidentificarlas (la PHI se oculta en los encabezados DICOM y se incrusta en los píxeles) y encontrar la capacidad de cómputo para usarlas. El modelo representa el 10 % fácil.
Los centros médicos académicos son el lugar donde se desarrolla la mayor parte de la ciencia abierta. El campo debe gran parte de su progreso a conjuntos de datos compartidos como MIMIC-CXR (377 110 radiografías de tórax), The Cancer Imaging Archive, fastMRI y la rama de imágenes de UK Biobank, junto con herramientas abiertas como MONAI, nnU-Net y 3D Slicer. El ámbito académico también pone al descubierto el problema de credibilidad del sector. Una conocida revisión de BMJ (Nagendran et al., 2020) sobre estudios de imagenología que comparaban deep learning con clínicos reveló que, de 81 estudios, solo un puñado eran prospectivos o se habían probado en un entorno clínico real, y que el código y los datos no estaban disponibles en el 93 % y el 95 % de ellos, respectivamente. Esa deuda de reproducibilidad se debe directamente a lo difícil que resulta compartir y volver a ejecutar datos de imagenología.
Las empresas de tecnología médica y dispositivos (GE HealthCare, Siemens Healthineers, Philips, Canon) integran la IA directamente en el escáner: reconstrucción mediante deep learning que acorta las exploraciones, reducción de dosis y triaje en el propio dispositivo. Su problema más difícil es la generalización. Un algoritmo entrenado en el escáner, la intensidad de campo y el protocolo de un proveedor puede degradarse silenciosamente en el de otro. Curar datos de entrenamiento de múltiples centros que representen el mundo real y luego demostrárselo a los organismos reguladores mediante las vías 510(k) y PMA es tanto la ventaja competitiva como el coste.
Las empresas farmacéuticas y biotecnológicas tratan la imagenología como un instrumento de medición. Los ensayos oncológicos dependen de criterios de respuesta estandarizados como RECIST, iRECIST y RANO, leídos de forma centralizada y a ciegas para eliminar el sesgo del centro, y los marcadores cuantitativos de imagenología pueden detectar la respuesta a los fármacos antes que las medidas basadas en el tamaño. Nada de esto funciona a menos que una medición signifique lo mismo en todos los centros, escáneres y momentos, motivo por el cual la QIBA de la RSNA elabora perfiles que fijan la adquisición y el análisis con una precisión concreta. La variabilidad es el enemigo del criterio de valoración de un ensayo.
Cuatro trabajos diferentes, un mismo cuello de botella compartido. Los píxeles están en todas partes y no se pueden consultar en ninguna.

Por qué la colaboración lo es todo y por qué es tan difícil
Ninguna institución por sí sola posee suficientes datos diversos para crear un modelo que generalice. El estudio colaborativo más sólido hasta la fecha lo demuestra. En el estudio EXAM (Nature Medicine, 2021), 20 instituciones entrenaron un modelo compartido para predecir las necesidades de oxígeno por COVID-19 a partir de radiografías de tórax y datos de EMR sin mover ningún dato de pacientes entre ellas. Solo viajaron los pesos del modelo, y el modelo federado ganó, de media, un 16 % en AUC y un 38 % en generalización con respecto a los modelos de un solo centro. La mecánica es menos exótica de lo que parece: cada centro entrena localmente, un coordinador promedia los pesos del modelo en lugar de los datos (la fórmula clásica de federated-averaging), y la agregación segura y la privacidad diferencial evitan que los registros de cualquier centro puedan reconstruirse a partir de esos pesos.
Esa es la promesa. La realidad es que la colaboración es realmente difícil, por razones estructurales más que técnicas:
- Heterogeneidad de los datos. Los diferentes escáneres, protocolos y convenciones de etiquetado hacen que "el mismo" examen a menudo no lo sea. Los modelos federados se degradan con estos datos no IID y sesgados por la adquisición, a menos que se diseñen deliberadamente soluciones con técnicas como el promediado de normalización por lotes o la armonización adaptada al centro.
- Privacidad y gobernanza. Cada estudio entre distintas instituciones requiere aprobaciones de IRB por centro, acuerdos de uso de datos y una desidentificación que debe ser justificable.
- Falta de un sustrato común. Los consorcios como MIDRC (copresididos por la ACR, la RSNA y la AAPM) existen precisamente porque la ingesta, curación, desidentificación, etiquetado y uso compartido son tan difíciles que requieren un esfuerzo nacional dedicado.
La colaboración en imagenología no es algo meramente deseable. Es el único camino hacia modelos que funcionen fuera del edificio en el que fueron entrenados, y depende casi por completo de la infraestructura de datos y su gobernanza.
La complejidad que la mayoría de la gente ajena al sector nunca ve
Cuando la gente dice "imágenes médicas", suele imaginarse una radiografía de tórax. La realidad es una gran diversidad de formatos y escalas que hace fallar a las herramientas de datos de propósito general.
| Tipo de imagenología | Formatos | Dimensiones y escala | Por qué fallan las herramientas de propósito general |
|---|---|---|---|
| Radiología: radiografía, CT, MRI | DICOM, codificable en aproximadamente una docena de sintaxis de transferencia (sin comprimir → JPEG 2000 → HTJ2K) | Radiografía 2D → volúmenes CT/MRI 3D → cardíaco dinámico 4D | Creado para mover estudios entre máquinas, no para analizarlos en masa; los decodificadores (pydicom, GDCM, pylibjpeg) se ejecutan en un solo hilo: unos pocos estudios es trivial, unos pocos millones es un problema de sistemas distribuidos |
| Patología digital: imágenes de portaobjetos completos | Formatos de proveedores: Aperio .svs, Hamamatsu .ndpi, Philips iSyntax (a través de OpenSlide); casi ningún DICOM | Gigapíxel: varios GB, decenas de miles de teselas, leídas como una pirámide a varios aumentos | Demasiado grandes para abrirlas en memoria; el color de la tinción y del escáner varía de un laboratorio a otro, convirtiéndose en su propia fuente de errores en el modelo |
| Oftalmología, dermatología y otros | Volúmenes OCT, fotografía clínica, cada uno con sus propias convenciones | 2D y 3D, específicos de la modalidad | Un conjunto más de formatos que una herramienta pensada para una carpeta de JPEG nunca estuvo preparada para gestionar |
Las "imágenes médicas" no son una sola cosa: son una gran diversidad de formatos y escalas. Los archivos de investigación alcanzan petabytes, lo suficiente como para que desidentificarlos a escala constituya su propia línea de investigación publicada.
Existe un segundo tipo de complejidad que arruina sigilosamente los estudios: los números en sí mismos no son comparables entre distintos centros. Un valor de captación estandarizado o un volumen tumoral medido en dos escáneres con dos protocolos distintos no son la misma medición. Es por esto que la imagenología cuantitativa se apoya en estándares como los perfiles de QIBA y las definiciones de la IBSI para características radiómicas, y por lo que la reproducibilidad, y no la precisión bruta, suele ser lo que falla.
Una herramienta que gestiona una carpeta de JPEG no puede gestionar nada de esto, lo cual explica en gran medida por qué la imagenología se ha quedado atrás respecto a la genómica y los datos de EHR en lo que respecta a estar lista para la analítica.
La imagenología es el aspecto más crítico de un problema mayor
Lo que resulta fácil de pasar por alto cuando el enfoque se mantiene únicamente en las imágenes es que todo lo expuesto aquí también se aplica al resto de I+D. La imagenología es solo el ámbito donde el problema se manifiesta primero, porque sus datos son los más voluminosos y complejos.
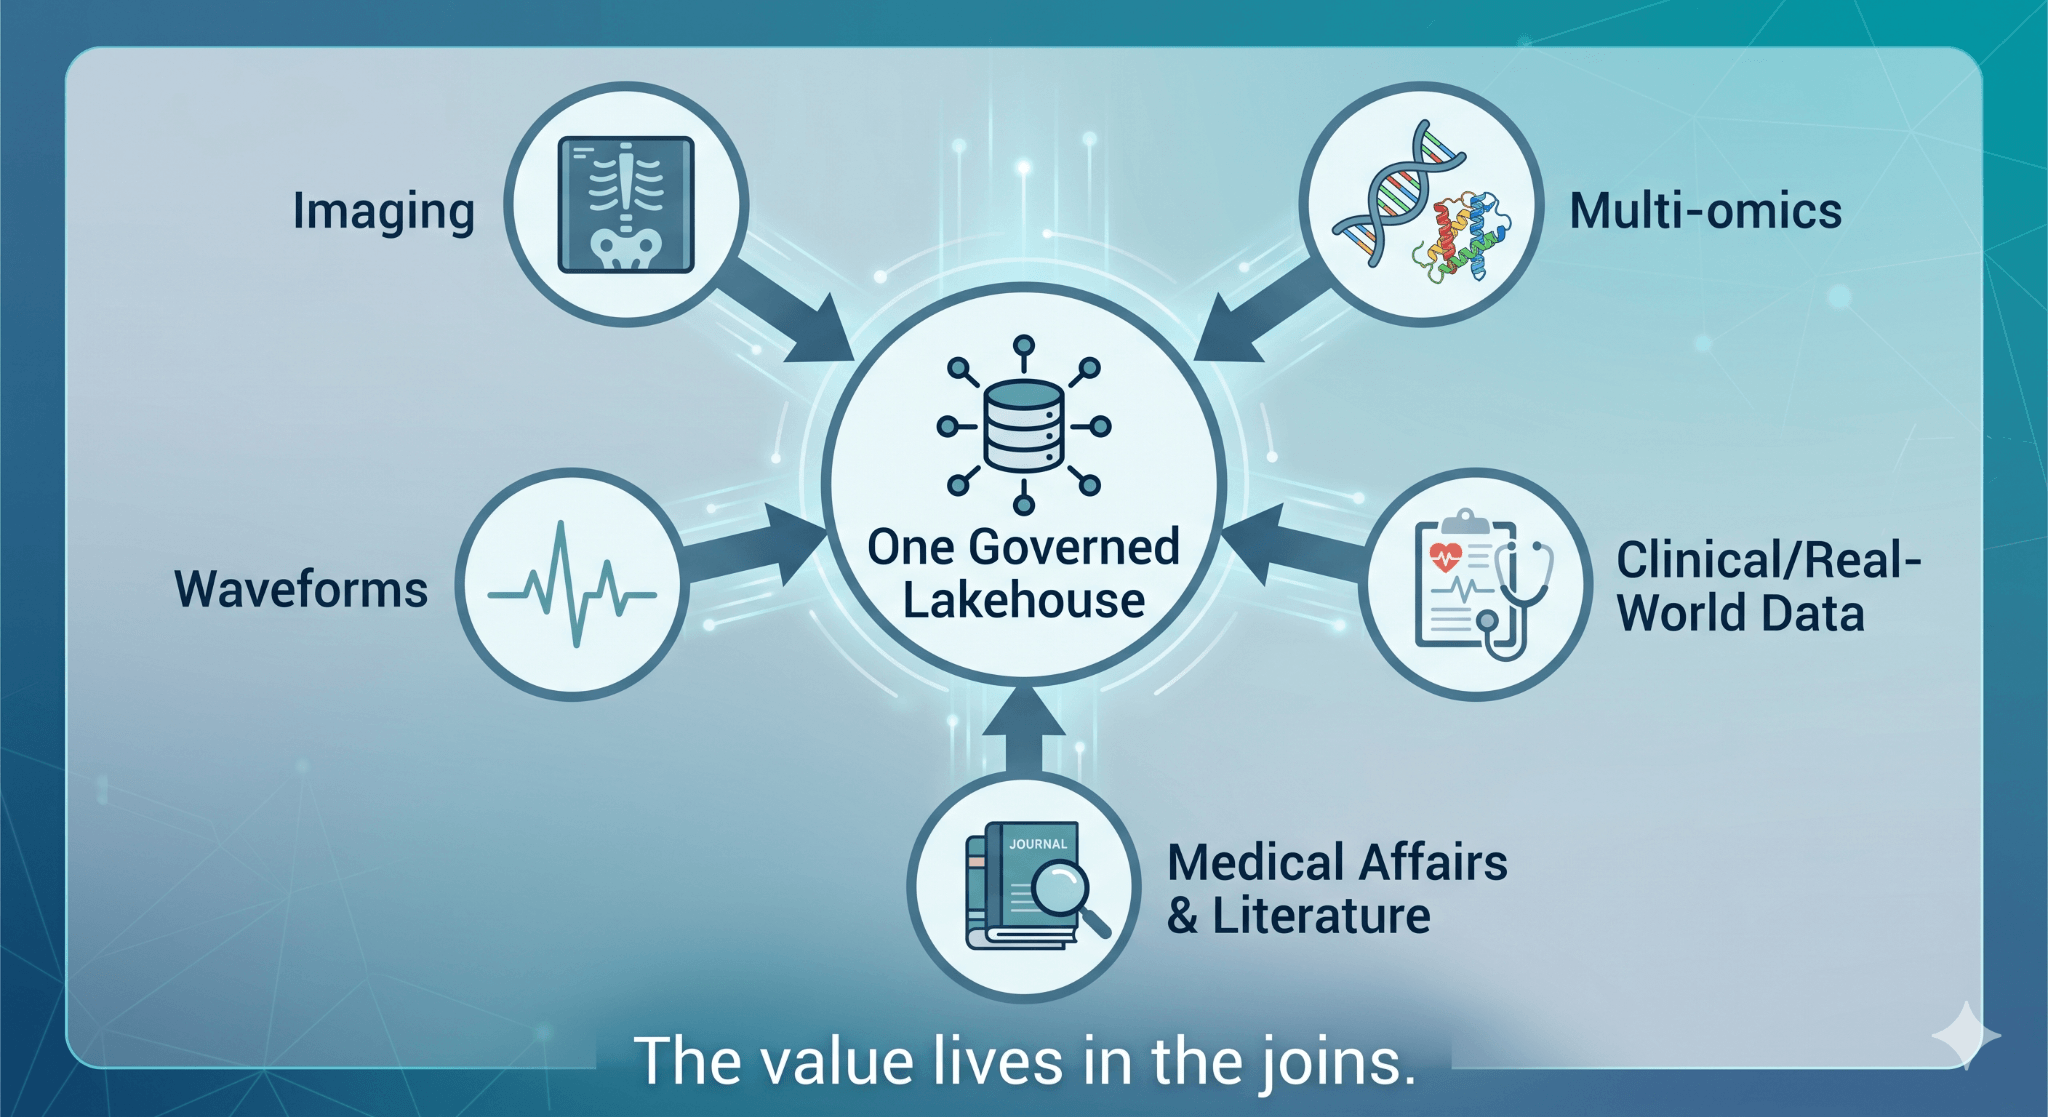
Si entra hoy en una organización de I+D de ciencias de la vida, la verdadera frontera no es ningún tipo de dato individual. Es la multiómica: la genómica, transcriptómica, proteómica y metabolómica, cada una con sus propios formatos y silos. Son los datos del mundo real y de ensayos clínicos, los EHR, los registros y las formas de onda. Son los asuntos médicos y la literatura especializada. Las preguntas que realmente impulsan un programa —qué pacientes responden y por qué, qué revelan conjuntamente la imagen, la firma molecular y el resultado— residen en las interconexiones entre estos dominios, no dentro de uno solo.
Cada uno de esos tipos de datos padece el mismo problema que la imagenología. Es información rica, de alta dimensión, mayoritariamente no estructurada, atrapada en sistemas específicos de cada dominio, difícil de gobernar y aún más difícil de vincular. Una imagen de portaobjetos completo, una llamada de variante genómica y un criterio de valoración de un ensayo ya son bastante difíciles por separado. El valor surge al ponerlos en la misma ecuación. Se trata de un problema de base de datos antes de ser un problema de IA, y es el que los equipos más suelen subestimar.
Esto no ocurre solo en el sector de la salud. Un análisis reciente de Bain sobre por qué los presupuestos de IA siguen aumentando mientras que los retornos no lo hacen reveló que el acceso y la integración de datos es la principal barrera para la IA, citada por el 41 % de las empresas y mencionada con mayor frecuencia por los líderes que por los rezagados. Su conclusión directa: la mayoría de las organizaciones todavía no pueden acceder de forma fiable a sus propios datos. La medicina simplemente hace que resulte más difícil ignorarlo.
Parte II — La base
Aquí es donde el tema se vuelve más concreto y técnico. Para los lectores que no están creando la plataforma, la versión resumida es sencilla: gobernar todo en un solo lugar, hacer que los píxeles se puedan consultar, desidentificar a escala y vincular la imagenología con el resto de la información del paciente. El resto de esta sección explica cómo hacerlo.
Lo que realmente debe hacer la base de datos
Si eliminamos las particularidades de cada sector, los requisitos son los mismos. La plataforma debe:
- Gobernar archivos de imagenología no estructurados y sus metadatos extraídos en un solo lugar, con control de acceso, linaje y auditabilidad que respondan a las exigencias de un organismo regulador.
- Procese datos multidimensionales, de escala de petabytes y gigapíxeles (rayos X 2D, volúmenes de TC/RM 3D, estudios dinámicos 4D, laminillas de patología de gigapíxeles) sin interrupciones.
- Desidentifique a escala, tanto en los encabezados como en los píxeles.
- Vincule las imágenes con EHR, genómica, formas de onda y texto, de modo que una sola pregunta de investigación pueda abarcar todos ellos.
- Haga que el intercambio entre instituciones sea un simple paso de configuración y no una negociación de seis meses.
Esa es la esencia de un lakehouse. A continuación, se muestra cómo se aplica en la práctica utilizando patrones que funcionan en Databricks.
Una arquitectura de medallón para Pixels
El modelo mental que hace que el procesamiento de imágenes sea manejable es el mismo patrón de medallón que los equipos ya usan para datos tabulares, adaptado para archivos binarios.
- Bronze: los estudios sin procesar llegan primero a un almacenamiento de objetos en la nube de acceso restringido o a un Volume, donde un trabajo de desidentificación se ejecuta en los encabezados y píxeles antes que cualquier otra cosa; los archivos desidentificados forman luego la capa bronze gobernada en los Volumes de Unity Catalog, con una fila de catálogo por archivo, y con Auto Loader gestionando la llegada incremental para que los nuevos estudios fluyan continuamente en lugar de procesarse en frágiles lotes nocturnos.
- Silver: las etiquetas DICOM con valores de texto se extraen en tablas Delta (los objetos binarios como los datos de píxeles permanecen en el archivo), de modo que los metadatos que estaban atrapados dentro de los archivos se vuelven consultables con SQL simple. Este es el paso que transforma "un visor puede abrirlo" en "un analista puede consultarlo". El acelerador de código abierto Pixels hace exactamente esto, catalogando archivos en paralelo y extrayendo etiquetas a escala.
- Gold: cohortes depuradas y listas para el análisis, unidas a tablas clínicas y ómicas, preparadas para entrenamiento, BI o un estudio con fines regulatorios.
La razón por la que esto no es sencillo es el rendimiento. Las bibliotecas de análisis sintáctico de DICOM son de un solo núcleo; el truco consiste en distribuirlas. En la práctica, esto significa usar pandas UDFs y mapInPandas para repartir el análisis en un clúster, o un origen de datos personalizado de Spark. En un trabajo publicado por el equipo de Pixels, un origen de datos zipdcm lee los metadatos de DICOM directamente desde archivos zip en memoria, dejando los archivos originales comprimidos en su lugar: catalogó más de 107 000 DICOM en aproximadamente 3.5 minutos en dos workers de 8 núcleos, aproximadamente 7 veces más rápido que los enfoques anteriores. El cuello de botella pasa de la E/S de disco y red al análisis puro de la CPU, que es exactamente para lo que destaca un clúster.

Gobernanza que supera una auditoría
El análisis de imágenes es el problema definitivo de gobernanza de datos no estructurados, y es el requisito en el que la mayoría de las plataformas fallan sin hacer ruido. Unity Catalog Volumes gobierna los archivos sin procesar en S3, ADLS o GCS bajo un espacio de nombres de tres niveles, mientras que los metadatos extraídos se guardan en Delta. Ambos se encuentran bajo un único modelo de linaje y control de acceso que llega hasta los modelos entrenados con los datos, lo que permite responder meses después a la pregunta "quién accedió a esta cohorte y qué se creó a partir de ella". La seguridad a nivel de filas y columnas, junto con las reglas basadas en atributos, permiten que una organización exponga metadatos desidentificados de forma amplia mientras mantiene protegidos los píxeles subyacentes.
Aquí es donde la desidentificación cobra verdadera importancia. La PHI del encabezado se gestiona con un cifrado que conserva el formato, de modo que el mismo identificador de paciente siempre se asocie al mismo seudónimo. Este detalle es más relevante de lo que parece: significa que la TC de un paciente aún se puede vincular con su patología y sus análisis de laboratorio en distintos conjuntos de datos sin exponer nunca el identificador real. Los perfiles de confidencialidad del estándar DICOM definen qué eliminar y qué conservar. El problema más complejo es la PHI incrustada en los píxeles, como el nombre del paciente integrado en una ecografía o en un formulario escaneado. Las herramientas tradicionales como Presidio manejan bien el texto libre, pero no las imágenes. Eliminar esa PHI incrustada es un campo de investigación activo: trabajos recientes demuestran que los modelos de visión y lenguaje (VLM) superan ahora a las canalizaciones basadas únicamente en OCR para detectarla y ocultarla (Lee et al., Radiology 2025), y los métodos de desidentificación en producción que combinan la desinfección de metadatos DICOM con OCR dirigido en texto incrustado se han validado en cientos de miles de imágenes en diez modalidades (Macdonald et al., 2024). Para los píxeles, el equipo de Pixels publicó un pipeline de modelos de visión y lenguaje que combina OCR con un VLM y se ejecuta de forma distribuida con pandas UDFs. En una muestra equilibrada del benchmark MIDI-B, GPT-4o y Claude 3.7 Sonnet alcanzaron casi el 100% de exhaustividad y precisión, el modelo abierto Llama 4 Maverick logró el 100% de exhaustividad a una fracción del costo, y Spark redujo la desidentificación de 1000 fotogramas de 105 minutos a 6. El equipo también está explorando un enfoque más optimizado basado exclusivamente en VLM para llevar esto aún más lejos.
Entrenamiento y servicio sobre los mismos datos gobernados
Una vez que los píxeles se pueden consultar y están gobernados, la capa de ML deja de ser la parte difícil. Los modelos de segmentación y clasificación se registran en el mismo catálogo como modelos de MLflow, con su linaje vinculado a la cohorte exacta con la que se entrenaron. Específicamente para imágenes, NVIDIA MONAI y VISTA-3D (un modelo fundacional de segmentación que cubre 127 clases anatómicas) se integran para la autosegmentación y el ajuste fino, con un visor OHIF integrado en una Databricks App para que un radiólogo o patólogo pueda revisar, corregir y volver a etiquetar bajo el modelo de seguridad de la plataforma.
El bucle de aprendizaje activo de MONAI Label significa que cada corrección mejora el siguiente lote, lo que permite a los equipos salir de la trampa de necesitar un conjunto de datos completamente anotado antes de comenzar. La inferencia se ejecuta como servicio de modelos en tiempo real en GPU (con escalado a cero para que un modelo poco usado no consuma recursos de GPU de forma innecesaria) o como inferencia por lotes distribuida en millones de estudios. Y dado que el trabajo más reciente de Pixels incluye un servicio DICOMweb (QIDO-RS, WADO-RS, STOW-RS), el lakehouse puede integrarse directamente en un flujo de trabajo clínico o PACS/VNA en lugar de quedar al margen.
Demostrar que es seguro: validación, desviación y la vía regulatoria
Entrenar un modelo es solo el comienzo, no el final. Un modelo que funciona de forma excelente en el escáner de una sede puede degradarse silenciosamente en otra, por lo que el verdadero trabajo radica en la validación externa en diferentes centros, proveedores y protocolos, para luego supervisar la desviación (drift) a medida que se actualizan los escáneres y cambian los protocolos en producción. MLflow se encarga de la evaluación y el seguimiento; la disciplina más compleja es tratar cada modelo como un activo con versiones al que se adjuntan su cohorte, sus métricas y sus aprobaciones. Para cualquier solución orientada al ámbito clínico, los organismos reguladores han comenzado a adaptarse a la IA adaptativa. El Predetermined Change Control Plan (PCCP) de la FDA permite a los equipos preespecificar cómo se puede volver a entrenar y actualizar un modelo sin necesidad de una nueva presentación cada vez, y las Good Machine Learning Practice (GMLP) establecen las expectativas relativas a los datos, la validación y el seguimiento. Incorporar estas salvaguardas directamente en la base de datos, en lugar de añadirlas a posteriori, es lo que diferencia una demostración de una solución que un hospital realmente llegará a implementar.
Colaboración sin mover los datos
Existen dos formas complementarias de lograr la diversidad entre instituciones que el estudio EXAM demostró que es necesaria, y resuelven problemas diferentes.
El aprendizaje federado mantiene los datos en su ubicación física y solo mueve los pesos del modelo, utilizando el promediado federado para combinarlos, junto con agregación segura y privacidad diferencial para evitar que los datos de cualquier centro se filtren. Es la herramienta adecuada cuando, por motivos legales, los datos no se pueden mover en absoluto.
El lakehouse añade una segunda opción que suele ser más sencilla en la práctica: Delta Sharing y Clean Rooms permiten a las instituciones compartir tablas y archivos gobernados (o realizar análisis conjuntos en cohortes desidentificadas) sin copiar nada, utilizando la emisión de credenciales (credential vending) en lugar de la exportación de datos. Para gran parte de la investigación multicéntrica, "compartir una vista gobernada de la cohorte" representa un esfuerzo mucho menor que configurar un entorno de entrenamiento federado, y ambas opciones se pueden combinar.
Hacer que el procesamiento de imágenes sea multimodal
Este es el requisito que convierte las imágenes de una modalidad independiente en una parte del paciente. Como los metadatos son simplemente Delta, las imágenes se pueden vincular a transmisiones FHIR y HL7 del EHR, a tablas de variantes genómicas, a formas de onda y a texto clínico, resolviendo la identidad del paciente mediante la capa de seudonomización. Los modelos de datos comunes como OMOP brindan a los datos observacionales un esquema compartido en el que alojarse. Además, Vector Search indexa embeddings para la búsqueda semántica (Pixels incluso incluye una función que vincula un término en lenguaje sencillo con la etiqueta DICOM correcta), y herramientas de lenguaje natural como Genie permiten a los científicos crear una cohorte con solo pedirla en lugar de escribir código SQL.
Las formas de onda fisiológicas son un tipo de datos particular. Un ECG, un trazado de presión arterial o un pullback de IVUS u OCT es una serie temporal de alta frecuencia muestreada cientos o miles de veces por segundo, que normalmente se almacena en formatos como WFDB en lugar de DICOM. El desafío técnico es la alineación: un fotograma de pullback o un latido de ECG solo tiene sentido cuando está sincronizado en el tiempo con la imagen y el evento clínico al que pertenece. Hacerlo bien, re-muestrear, reconciliar marcas de tiempo y almacenar la serie junto al estudio es exactamente el tipo de join que da sus frutos cuando la pregunta es por qué un paciente respondió, y no solo si lo hizo.
Los embeddings también habilitan algo más potente que la búsqueda. Los modelos de imagen y texto entrenados con pares de escaneos e informes (la línea de trabajo de BiomedCLIP y CheXzero) ubican las imágenes y el lenguaje en un espacio vectorial compartido, lo que permite a los sistemas recuperar casos similares, señalar hallazgos sin una etiqueta explícita o fundamentar un modelo generativo en las imágenes y los informes previos reales de un paciente, en lugar de basarse únicamente en sus datos de entrenamiento. Este último patrón, la generación aumentada por recuperación (retrieval-augmented generation) sobre imágenes e informes, es lo que hace que la redacción de informes y el resumen de casos sean lo suficientemente fiables como para mostrárselos a un médico: el modelo puede señalar lo que vio. Solo funciona cuando las imágenes, los informes y sus embeddings residen juntos bajo un mismo entorno gobernado, que es de lo que trata todo este artículo en miniatura.
Esto es también lo que necesita la nueva ola de modelos fundacionales. Prov-GigaPath (Nature, 2024), preentrenado con autosupervisión en 1 300 millones de teselas de 171 189 imágenes de portaobjetos completos (whole-slide images), solo funciona con datos grandes, diversos, gobernados y multimodales. Los silos no pueden alimentarlo. Un lakehouse sí.
El beneficio: un coinvestigador para el científico, un compañero para el clínico
La versión tangible de todo esto no es un sistema autónomo que reemplace a nadie. Es un compañero, un coinvestigador de IA para el científico y un copiloto para el clínico, fundamentado en los propios datos gobernados de la institución en lugar de en la internet abierta.
Para un investigador, un agente coinvestigador convierte una pregunta en trabajo. Pídale que "encuentre pacientes con NSCLC no tratados previamente que tengan una CT basal, anatomía patológica coincidente y estado de EGFR, y luego resuma cómo cambiaron las lesiones en el seguimiento", y este planificará los pasos, consultará las tablas clínicas y de imágenes a través de un espacio de Genie, recuperará casos similares con Vector Search, llamará a un endpoint de segmentación para medir las lesiones y fundamentará su resumen en la literatura relevante, con cada afirmación rastreable hasta los datos que utilizó.
La clase emergente de sistemas de "coinvestigadores de IA" apunta exactamente a esto: ayudar a generar y priorizar hipótesis, no solo a responder búsquedas de información. Lo que separa a un juguete de un colaborador de confianza es si se basa en datos multimodales y gobernados.
Para un clínico, la misma maquinaria se convierte en un compañero que realiza el trabajo preliminar que un radiólogo u oncólogo haría a mano de otro modo: extraer las pruebas anteriores del paciente, medir y comparar lesiones, mostrar los criterios de las guías que aplican y redactar el borrador del informe para su revisión. Nunca da el visto bueno final; lo hace el ser humano. Eso no es una limitación, es el diseño. Casi toda la IA médica de imagen aprobada en la actualidad está supervisada por humanos, y un compañero que muestra su trabajo y cita sus fuentes es lo que hace que esa supervisión sea real en lugar de un mero trámite.
Lo que hace que cualquiera de los dos sea seguro es la base subyacente. Cada herramienta a la que llama el agente es un objeto gobernado (una función de Unity Catalog, un endpoint de model-serving, un índice de Vector Search, un espacio de Genie), por lo que los mismos controles de acceso, el linaje y la identidad en nombre de terceros que protegen los píxeles también delimitan lo que el agente puede ver y hacer. Combine especialistas (un agente de radiología, un agente de genómica, un agente de asuntos médicos) bajo un supervisor, y el equipo de agentes reflejará las combinaciones multimodales que la base de datos ya hace posibles. El compañero es la parte fácil, una vez que la base es la correcta.
Más allá de la imagen médica: la misma base impulsa el resto de R&D
La razón por la que esto es importante más allá de la radiología es que exactamente la misma arquitectura absorbe el resto del conjunto de datos de R&D. Las multiómicas (genómica, transcriptómica, proteómica, metabolómica) se alojan en el mismo Unity Catalog junto con los datos clínicos y de imagen médica. Aporta sus propios formatos y estándares pesados, VCF para variantes, BAM y CRAM para lecturas de secuenciación alineadas, las especificaciones de GA4GH que mantienen la interoperabilidad y motores como Glow y Hail para análisis a escala poblacional, pero el patrón lakehouse es idéntico: gobernar los archivos, extraer la capa consultable y vincularla a todo lo demás.
Aquí es también donde la tecnología de NVIDIA como BioNeMo y los NIM se conectan para modelos de secuencia y estructura. Los datos del mundo real y de ensayos clínicos, los registros y las formas de onda se unifican con las cohortes de imágenes sin necesidad de exportación. Asuntos médicos y la literatura científica se convierten en texto consultable bajo la misma gobernanza y la misma interfaz de AI/BI y Genie. Los programas que avanzan, aquellos que responden qué pacientes responden y por qué, residen en los joins entre estos dominios, y un lakehouse es la arquitectura excepcional capaz de albergar una diapositiva gigapíxel, un variant call y un endpoint de un ensayo bajo un único modelo de gobernanza para consultarlos de forma conjunta.
En conclusión

Los equipos que desarrollan IA y GenAI sobre este tipo de datos se enfrentan constantemente a la misma lección. Un modelo puede dar una gran demostración en una semana. Lo que lleva meses después es conseguir que los datos estén limpios, vinculados, desidentificados y lo suficientemente gobernados como para confiar en ellos ante un científico o un organismo regulador. El problema de los datos no es la parte poco atractiva del proyecto. Es el proyecto en sí.
Analizando los datos de imagen, ómica, clínicos y de asuntos médicos dentro de las mismas organizaciones, la conclusión es sencilla. La frontera en la imagen médica no es una arquitectura mejor. Es una base mejor. Los algoritmos existen. Los datos existen, en algún lugar. Lo que faltaba era una forma de hacer que las imágenes estén gobernadas, sean consultables, vinculables y compartibles, y estén integradas con todo lo demás con lo que interactúa una pregunta de investigación, sin renunciar a la privacidad y al rigor que exige la medicina.
Los equipos que triunfen en R&D no serán los que busquen primero el modelo. Serán los que preparen correctamente los datos primero y dejen que la IA los siga. Resuelva eso y el modelo se convertirá en la parte fácil, como siempre lo fue.
Por dónde empezar
La forma más rápida de probar esto es con sus propios datos.
- Comience con el acelerador de código abierto Pixels (databricks-industry-solutions/pixels) para convertir una carpeta de DICOM en tablas Delta gobernadas y consultables, y vea el patrón medallón en acción.
- Escríbalo en Databricks. Inicie un espacio de trabajo, apunte los volúmenes de Unity Catalog a un conjunto de datos público como TCIA o MIMIC-CXR, y configure la ingesta, la desidentificación y un visor OHIF de principio a fin antes de incorporar datos protegidos.
- Profundice en la ingeniería detrás de estas cifras: los artículos sobre la ingesta 7x, la desidentificación mediante VLM y MONAI/VISTA-3D enlazados anteriormente.
- Escale de una cohorte a todo el patrimonio de datos. Una vez que un único tipo de estudio se ha ingerido, desidentificado y vinculado a una tabla clínica, el mismo patrón se extiende a multiómicas, datos del mundo real y la capa de agentes superior.
Si su equipo está trabajando en imágenes médicas o R&D multimodal en Databricks, a los autores les gustaría saber cómo lo están abordando. Póngase en contacto con nosotros o deje un comentario, y cuando esté listo para pasar de un piloto a producción, el equipo de Databricks Healthcare and Life Sciences puede ayudarle a conseguirlo.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.