Cómo crear aplicaciones empresariales gobernadas en Databricks con Replit y Lakebase
Por qué es importante para los clientes y una guía paso a paso para empezar con Lakebase
por Harish Gaur y Susan Pierce
La combinación de Replit y Databricks ofrece a las empresas una plataforma completa de desarrollo a implementación. Con esta integración, los equipos empresariales pueden crear aplicaciones gobernadas utilizando Replit Agent que opera con datos de Databricks en tiempo real y desplegarlas en Databricks Apps con soporte nativo de Lakebase. Ya sea que el usuario sea un líder empresarial, un analista de datos o un desarrollador, puede utilizar la codificación agéntica para crear una aplicación de producción a partir de una instrucción en lenguaje sencillo.
El mes pasado, anunciamos que la integración de Replit y Databricks ya está disponible de forma general con soporte nativo de Lakebase. En este blog, iremos más allá de lo que anunciamos para explicar el porqué: por qué les interesa a los equipos empresariales, qué aplicaciones está creando la gente y cómo pasar de cero a una aplicación de producción completa y gobernada. Respondamos a estas preguntas de forma secuencial.
¿Por qué los equipos empresariales deberían usar Replit con Databricks?
Muchas empresas se enfrentan a un dilema. Tienen plataformas de datos gobernadas, pero los usuarios finales, como los gerentes de operaciones, los analistas de datos y los gerentes comerciales, todavía tienen dificultades para crear rápidamente aplicaciones personalizadas para visualizar estos datos e interactuar con ellos.
Necesitan una forma rápida y sin fricciones de crear una aplicación con una interfaz de usuario intuitiva, aprovisionar una base de datos, crear una capa de autenticación, aplicar la gobernanza y, finalmente, implementarla en producción. Cada paso requiere diferentes equipos y múltiples cadenas de aprobación.
Así es como la integración entre Replit y Databricks acorta este proceso:
1. Desarrolladores ciudadanos: Replit permite que un usuario de negocio describa una aplicación en lenguaje sencillo. Este agente creará la interfaz para visualizar los datos de la empresa e interactuar con ellos, y aprovisionará automáticamente la base de datos transaccional subyacente. Al realizar la implementación en Databricks, Replit aplicará la gobernanza de Databricks para que el creador solo vea los datos a los que tiene acceso.
2. Gobernanza integrada: La aplicación se implementa como una Databricks App. Cada aplicación hereda la autenticación automática de usuarios, controles de acceso seguros y una integración estrecha con Unity Catalog. Esto ahorra muchas rondas de cambios con el equipo de seguridad e infraestructura.
3. Soporte nativo de Lakebase: Cuando las aplicaciones están listas para implementarse, en segundo plano, Replit Agent aprovisionará automáticamente una base de datos Postgres administrada de Lakebase para los datos operativos de su aplicación. Esto permite que su aplicación lea datos analíticos en tiempo real de Databricks y escriba sus propios datos de vuelta en Lakebase. Lakebase actúa como almacenamiento de datos persistente para las aplicaciones.
Es importante analizar cómo se compara Lakebase con una base de datos externa. En el pasado, los equipos que creaban aplicaciones con datos de Databricks tenían que depender de instancias externas de Postgres o MySQL para los datos que la aplicación necesitaba mantener. Estos datos, por ejemplo, las entradas de los usuarios o los estados de ejecución de la aplicación, se encontraban fuera de Databricks, lo que obligaba a las empresas a gestionar infraestructuras de gobernanza y modelos de permisos paralelos. Con Lakebase, ya no es necesario hacer eso.
Aquí tiene una comparación:
| Lakebase | Base de datos externa | |
|---|---|---|
| Ubicación de los datos transaccionales | Dentro del perímetro de Databricks | Datos fuera de Databricks |
| Permisos | Unity Catalog en tiempo de ejecución | Modelo independiente que mantener |
| Configuración | Aprovisionamiento automático por Replit Agent | Aprovisionamiento, conexión y seguridad manuales |
| Gobernanza | Hereda el linaje, la auditoría y los controles de acceso | Requiere un trabajo de cumplimiento independiente |
| Modelo de costos | Serverless y se escala a cero cuando está inactivo | Siempre activo o escalado manualmente |
Las empresas pueden crear una gran variedad de aplicaciones modernas con Replit en Databricks. Veamos tres aplicaciones empresariales que muestran lo que es posible lograr.
Escenario 1: Aplicación de gestión del rendimiento para líderes de operaciones
A un líder de operaciones le gustaría evaluar el rendimiento de varias franquicias y compartir el análisis de rendimiento con propietarios de franquicias específicos. Históricamente, las empresas han dependido de sus desarrolladores de BI para crear tableros para este análisis. Los problemas con esto siempre han sido que el desarrollo lleva tiempo, los tableros no permiten una personalización o toma de acciones sencilla, y profundizar para llegar al siguiente nivel de detalle siempre era difícil o completamente imposible.
Sin embargo, con Databricks y Replit, los usuarios empresariales obtienen lo mejor de ambos mundos: velocidad de desarrollo y gobernanza/seguridad empresarial. Mediante el uso de un prompt sencillo, el líder de operaciones puede crear una aplicación de operaciones de varias páginas, y el agente de Replit generará toda la aplicación según las especificaciones del líder de operaciones. Lee datos gobernados en tiempo real directamente desde un almacén de Lakehouse bajo Unity Catalog. En producción, se transmite el token respectivo de cada usuario, lo que permite que los datos solo se compartan con los propietarios de franquicias específicos que tienen permitido ver sus propios conjuntos de datos confidenciales.
Una aplicación de rendimiento de este tipo sería aplicable a tableros de operaciones minoristas, rastreadores de rendimiento de franquicias, vistas de ventas regionales y estado de la cadena de suministro.
Escenario 2: Un pipeline de procesamiento de documentos para un analista de negocios
Los analistas de finanzas y operaciones tienen que analizar grandes volúmenes de documentos no estructurados, como facturas, formularios y contratos, y utilizar esos datos para tomar decisiones críticas al instante.
Estos analistas pueden crear aplicaciones de pipeline de procesamiento de documentos que ingieran estos documentos y utilicen las funciones de AI de Databricks para convertirlos de archivos no estructurados (PDF, documentos, imágenes) en campos estructurados. La aplicación les permitirá consultar estos documentos, que ahora se han almacenado en la base de datos de Lakebase como datos estructurados, y tomar decisiones informadas.
Esta aplicación tiene una amplia aplicabilidad en el procesamiento de facturas, la extracción de contratos, la recepción de reclamaciones y el análisis de documentos regulatorios.
Escenario 3: Una aplicación full-stack para automatizar flujos de trabajo manuales
Cada organización tiene varios flujos de trabajo manuales que requieren lidiar con hojas de cálculo, hilos de correo electrónico y datos ubicados en varios lugares para gestionar aprobaciones o informar actualizaciones. Esto podría resolverse fácilmente con aplicaciones que automaticen los flujos de trabajo al reunir todos los datos y crear un motor de flujo de trabajo de aprobación. Lee datos analíticos en tiempo real de Databricks y captura nuevos datos operativos en Lakebase a medida que la gente los usa.
Hemos visto a clientes crear aplicaciones similares para flujos de trabajo de aprobación, sistemas de recepción de proyectos, herramientas de gestión de proveedores, seguimiento de cumplimiento y portales de solicitudes internas.
¿Cómo se configura Replit con Databricks Lakebase?
A través de un proceso de cuatro pasos, cualquier usuario puede crear una aplicación con Replit e implementarla como una aplicación de Databricks en el entorno de Databricks. Comienza conectando el entorno de Databricks a Replit, lo que permite a los usuarios crear una aplicación personalizada a partir de un prompt, implementarla de forma nativa en Databricks Apps con la gobernanza de Unity Catalog y aprovisionar automáticamente una base de datos de Lakebase para los datos de la aplicación.
Aquí está el flujo de cuatro pasos

Comenzar requiere tres roles y aproximadamente 15 minutos. Su espacio de trabajo de Databricks debe ser un espacio de trabajo estándar sin un perfil de seguridad de cumplimiento, y su organización debe estar en el plan Replit Enterprise.
La siguiente guía utiliza un conector de principal de servicio (M2M) para el acceso compartido. Replit también admite un conector de usuario a máquina (U2M), que permite a cada creador conectarse utilizando su propia identidad de Databricks. Consulte esta guía para elegir la opción correcta
Paso 1: Crear un principal de servicio (administrador de Databricks)
En la consola de la cuenta de Databricks:
- Cree un principal de servicio para la conexión entre Databricks y Replit
- Genere un ID de cliente y un secreto
- Asigne el principal de servicio al espacio de trabajo de destino
- Otórguele los permisos adecuados (normalmente acceso al almacén de SQL y a los catálogos/esquemas que utilizará la aplicación)
Ejemplo de concesión de permisos:
Paso 2: Agregar el conector de Databricks (administrador de la organización de Replit)
En Replit:
- Vaya a la configuración de conectores de su organización
- Agregue un nuevo conector de Databricks (principal de servicio)
- Ingrese el ID de cliente y el secreto del Paso 1
- Opcionalmente, configure RBAC para controlar qué usuarios de Replit pueden usar el conector
Paso 3: Activar y conectar (usuario de Replit Enterprise)
- Activa el conector de Databricks en tu proyecto de Replit
- Proporciona la ruta HTTP y el nombre de host del servidor de tu SQL warehouse para completar la conexión
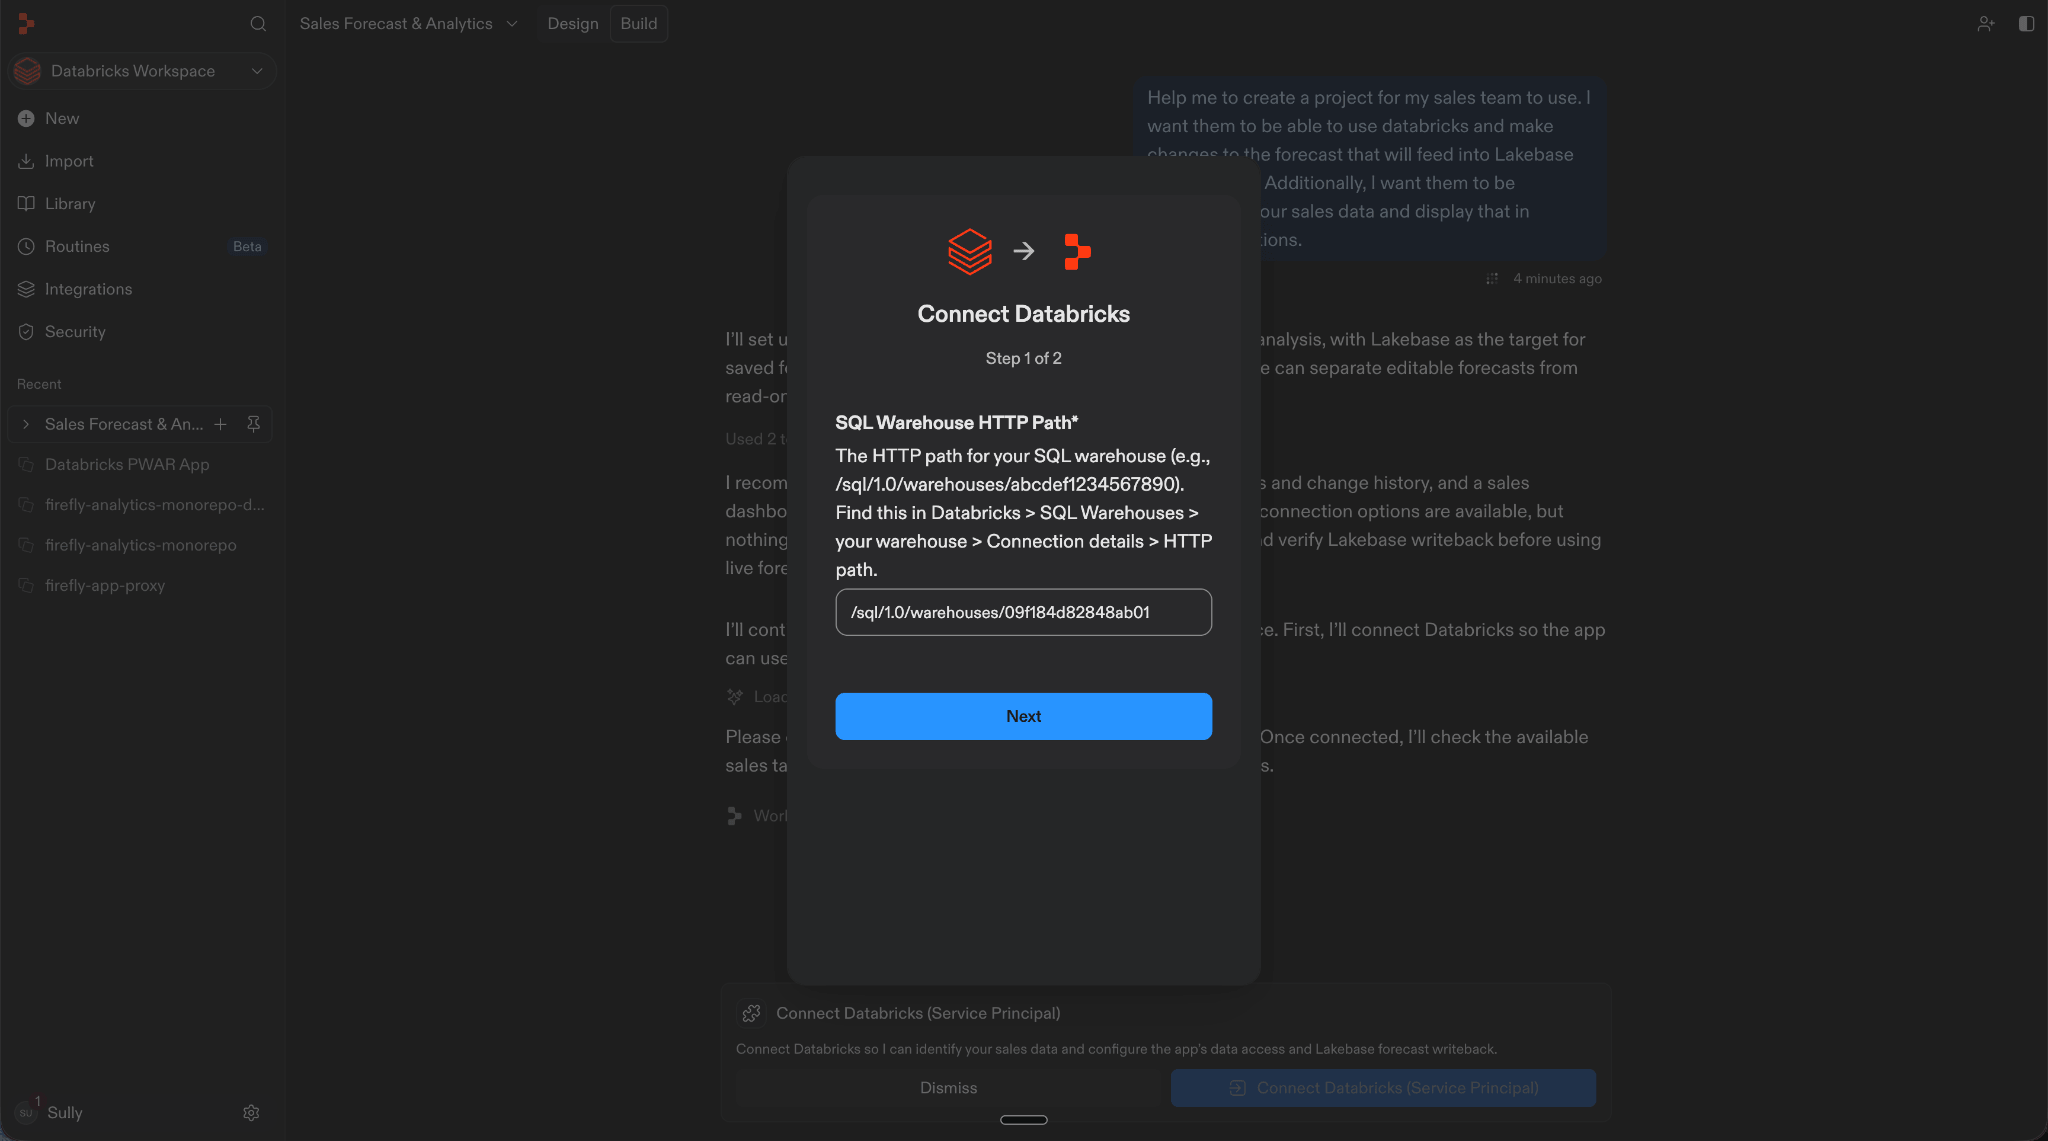
Paso 4: Indicar, compilar y desplegar
- Describe la aplicación que quieres compilar en lenguaje natural, indicando el warehouse y los datos que te gustaría usar
- Sigue al agente mientras explora tu esquema, genera consultas y compila el front-end
- Prueba en el entorno de vista previa
- Despliega en Databricks Apps con una sola acción
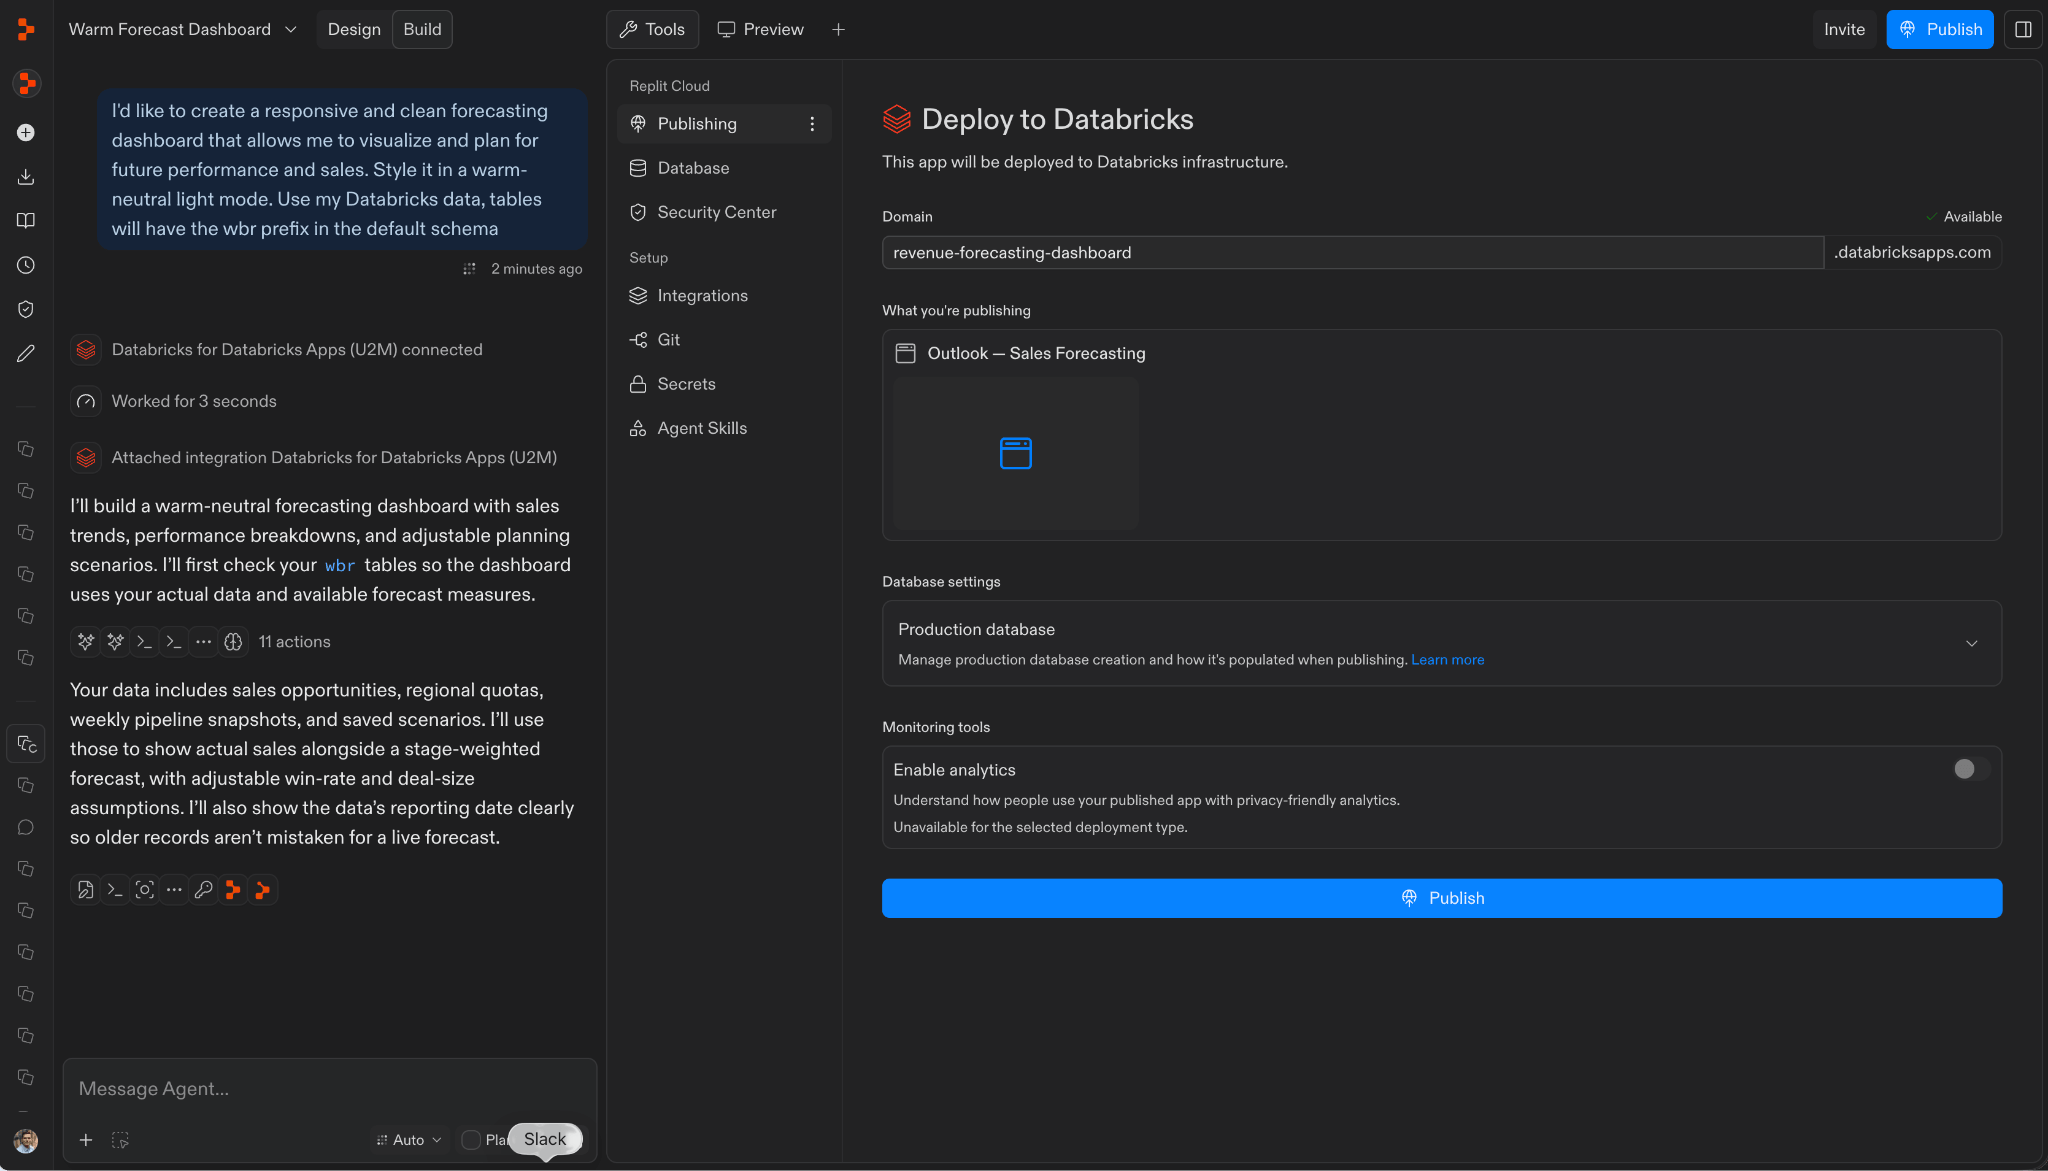
Mira la integración en acción:
Preguntas frecuentes
¿Qué es la integración de Replit y Databricks? La combinación de Replit y Databricks ofrece a las empresas una plataforma completa desde el desarrollo hasta el despliegue. Con esta integración, los equipos empresariales pueden compilar aplicaciones gobernadas utilizando Replit Agent, que opera con datos de Databricks en tiempo real, y desplegarlas en Databricks Apps con soporte nativo de Lakebase. Ya sea que el usuario sea un líder empresarial, un analista de datos o un desarrollador, puede programar de forma intuitiva (vibe coding) una aplicación de producción a partir de una instrucción en lenguaje natural.
¿Cómo se conecta Replit a Databricks? Replit admite tanto OAuth de usuario a máquina (U2M), que utiliza la identidad y los permisos de Databricks de cada creador, como OAuth de principal de servicio (M2M), que utiliza una identidad de servicio compartida. Esta guía detalla la configuración del principal de servicio.
¿Qué es Lakebase y por qué es importante para las aplicaciones de Replit? Databricks Lakebase Postgres es un servicio de Postgres serverless y totalmente gestionado que se ejecuta dentro del entorno de Databricks. Para las aplicaciones de Replit, proporciona una base de datos transaccional para almacenar datos específicos de la aplicación, como las entradas del usuario y el estado de ejecución de la aplicación, sin necesidad de una base de datos independiente que se encuentre fuera del entorno de Databricks. Replit Agent aprovisiona automáticamente la base de datos de Lakebase al realizar el despliegue.
¿Pueden los no desarrolladores compilar aplicaciones con Replit en Databricks? Sí. Replit Agent permite que un usuario de negocio describa una aplicación en lenguaje natural. Este agente no solo compilará el front-end para visualizar e interactuar con los datos de la empresa y aprovisionará la base de datos transaccional subyacente, sino que también aplicará la gobernanza para que solo puedan ver los datos para los que tienen autorización en Databricks y, luego, la desplegará como una aplicación lista para producción.
¿Cómo se aplica la gobernanza en las aplicaciones de Databricks compiladas con Replit? La aplicación se despliega como una Databricks App. Por lo tanto, cada aplicación hereda la autenticación automática de usuarios, controles de acceso seguros y una estrecha integración con Unity Catalog. Esto ahorra muchas rondas de revisión con el equipo de seguridad e infraestructura.
¿Puede una aplicación de Replit escribir datos de vuelta en Databricks? Sí. Puede escribir cualquier dato operativo en Lakebase. La aplicación puede leer datos analíticos de Databricks a través de un SQL warehouse y escribir datos operativos (envíos, aprobaciones, estado) en una base de datos Postgres de Lakebase.
¿Qué es la migración de IA supervisada (Supervised AI Migration)? Supervised AI Migration garantiza que cualquier cambio en el esquema de la base de datos propuesto por Replit Agent requiera la aprobación del equipo antes de pasar a producción.
¿Qué son los despliegues de vista previa automatizados (Automated Preview Deploys)? Los Automated Preview Deploys te permiten probar tus aplicaciones antes de que se publiquen. Replit crea un entorno de prueba independiente para que los equipos puedan compilar, revisar cambios y realizar ajustes en el entorno de prueba sin afectar a producción.
¿Cuánto cuesta la integración de Replit y Databricks? La integración requiere un plan de Replit Enterprise y consumo de Databricks (cómputo de SQL warehouse y Lakebase). El cómputo de Databricks es serverless. Por lo tanto, escala verticalmente bajo carga y se reduce a cero cuando termina, por lo que solo pagas por lo que usas.
¿Dónde puedo ver la integración de Replit y Databricks en acción? Regístrate en el próximo seminario web del martes 10 de noviembre "Compilar aplicaciones full-stack en Databricks Lakebase". Mira la demostración completa de compilación a despliegue: Cómo compilar aplicaciones listas para producción en Replit con Lakebase Postgres.
Próximos pasos
- Únete a nuestro próximo seminario web el 10 de noviembre: un recorrido en vivo sobre cómo compilar y desplegar una aplicación gobernada en Databricks con Replit. Regístrate en el próximo seminario web del martes 10 de noviembre "Compilar aplicaciones full-stack en Databricks Lakebase".
- Mira la demostración — observa el flujo completo de compilación a despliegue en acción: Cómo compilar aplicaciones listas para producción en Replit con Lakebase Postgres
- Explora la integración — visita replit.com/partners/databricks
- Lee la guía de configuración — Conectar Replit a Databricks en la documentación de Databricks
Encuéntranos en el Data and AI World Tour — Replit se une a Databricks en las paradas del World Tour en todo el mundo, incluyendo São Paulo, Mumbai, Chicago, Nueva York, Londres y Tokio. Regístrate aquí
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.