Presentamos la memoria de agentes en Databricks
por Sirui Sun y Nihit Desai
Hoy presentamos la memoria de agentes en Agent Bricks, la plataforma de desarrollo de agentes de Databricks. La memoria de agentes mejora la calidad de los agentes mientras reduce los costes y la latencia al almacenar hechos críticos, preferencias y flujos de trabajo que un agente debe recordar. Está disponible en versión Beta hoy mismo, se ejecuta en Lakebase para ofrecer una alta confiabilidad y baja latencia, y está construida sobre la investigación de memoria más reciente de Databricks.
Sin memoria, los agentes corren el riesgo de volver a descubrir hechos clave, olvidar las preferencias del usuario y repetir errores en los que ya habían sido corregidos. En respuesta, muchos desarrolladores están implementando sus propias soluciones de memoria, pero se encuentran con numerosas preguntas de diseño: por ejemplo, ¿dónde deberían almacenarse las memorias? ¿Cómo deberían sintetizarse las memorias? Y una vez generadas, ¿cómo deberían recuperarse?
Para solucionar esto, Databricks Agent Memory está construido sobre la arquitectura MemCurrent, creada de forma pionera por Databricks Research. MemCurrent combina tres patrones de acceso: plugins para registrar y cargar contexto automáticamente, herramientas a las que el agente llama a petición y un pipeline de consolidación fuera de línea (offline dreaming pipeline) que sintetiza la memoria en segundo plano. Todo esto se sirve con una latencia extremadamente baja usando Lakebase. En nuestras pruebas de rendimiento internas, implementar esta arquitectura de memoria triplicó la tasa de éxito de los agentes en tareas empresariales reales mientras utilizaba un 31 % menos de tokens.
Agent Memory se une al resto de Agent Bricks, incluyendo el alojamiento de agentes, Databricks Sandbox, Unity Gateway, servidores MCP preconstruidos, y rastreo y evaluación, proporcionando a los desarrolladores todas las capacidades de infraestructura necesarias para crear agentes en producción.
Problema: los agentes sin estado pagan dos veces por el mismo contexto
Aparecen dos problemas tan pronto como un agente pasa de una demostración al uso diario.
- Los costes aumentan con cada redescubrimiento. Un agente sin estado vuelve a deducir lo que descubrió ayer: qué tabla contiene los datos de uso, qué significa una sigla interna, qué join funciona realmente. En una sesión real de nuestra investigación, un agente necesitó 11 llamadas a herramientas, 8 subagentes y casi seis minutos para responder a una pregunta sobre los principales clientes de un producto. Al día siguiente, habría hecho todo eso de nuevo.
- Los agentes nunca se personalizan. Un usuario indica una preferencia, corrige un error o explica cómo define su equipo una métrica, y el agente lo olvida cuando termina la sesión. O bien el usuario se repite, o bien el agente repite el error.
Los desarrolladores de agentes, y los equipos de plataforma que ejecutan sus agentes, tienen dos soluciones alternativas comunes. Cada una cambia un problema por otro:
- Reproducir todo el historial en el contexto funciona hasta que los historiales se vuelven largos. En las pruebas de rendimiento de memoria de código abierto, el contexto completo utilizó aproximadamente 12 veces más tokens de entrada por pregunta que una memoria bien diseñada con la misma precisión, y en los historiales más largos obtuvo peores resultados, porque los turnos irrelevantes confundieron al agente.
- Construir la memoria usted mismo en almacenamiento de objetos o en una base de datos vectorial significa hacerse cargo de la extracción, la desduplicación, la recuperación y el control de acceso. Las memorias se vuelven obsoletas, los hechos contradictorios se acumulan y nadie puede saber qué memoria provocó una respuesta incorrecta.
Lo que los equipos necesitan es una memoria que haga a los agentes más económicos y más personalizados al mismo tiempo, sin necesidad de poner en marcha otro sistema para lograrlo.
Cómo funciona Agent Memory en Databricks
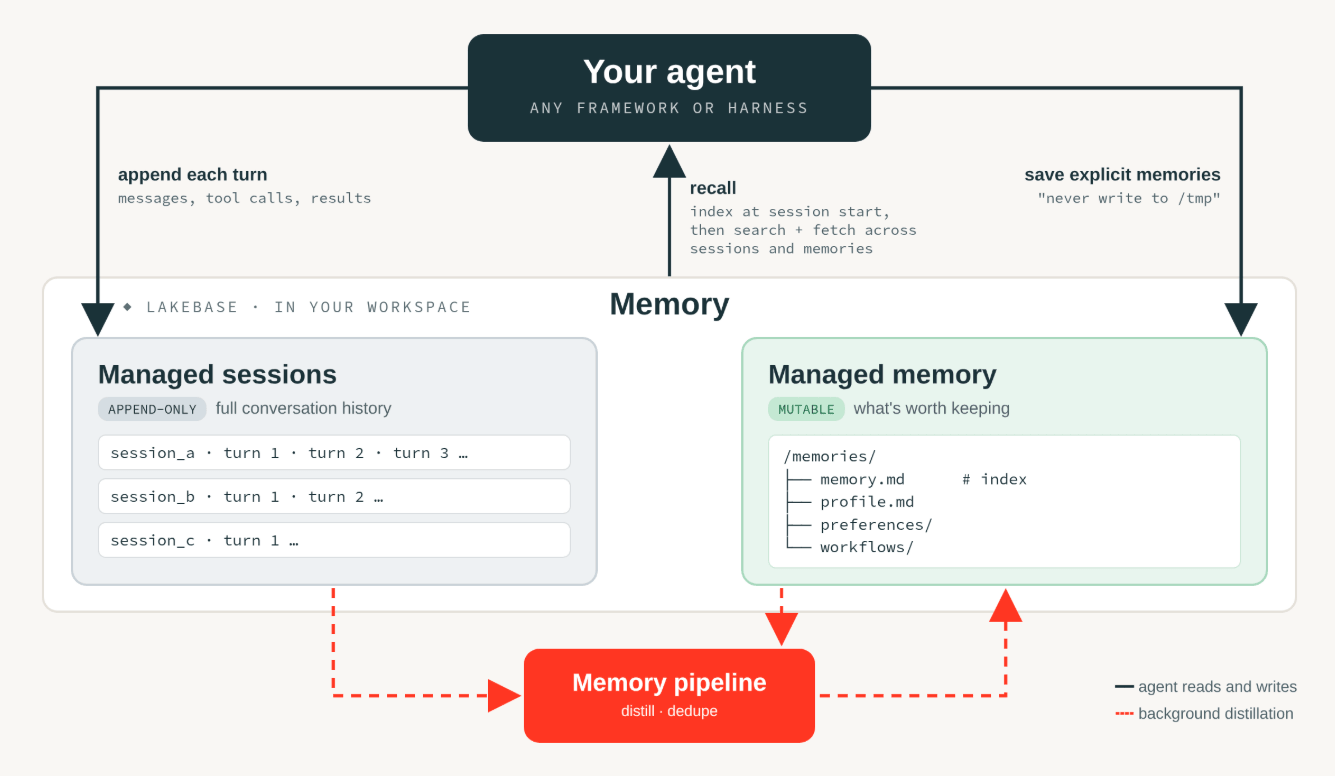
Figura 1. Agent Memory en Agent Bricks. El agente añade cada turno a las sesiones gestionadas, recupera y guarda memorias directamente, y un pipeline de memoria destila las sesiones en memoria a largo plazo en segundo plano.
Agent Memory consta de tres partes:
- Sesiones gestionadas: registran cada conversación como un historial ordenado de mensajes, llamadas a herramientas y resultados, en el formato nativo de su entorno de trabajo.
- Memoria gestionada: conserva lo que vale la pena recordar: perfil, preferencias, conocimiento del dominio y flujos de trabajo. Al principio de una sesión, el agente carga un índice de lo que se conoce en la memoria. Durante la sesión, encuentra detalles con búsqueda híbrida por palabras clave y semántica.
- Pipelines de memoria: sintetizan las sesiones en memoria en segundo plano, a petición o de forma periódica. Extraen hechos duraderos y preferencias, eliminan duplicados y reemplazan hechos que las conversaciones más recientes contradicen.
Todo se ejecuta en Lakebase, el Postgres serverless de Databricks, aprovisionado en su espacio de trabajo y operado por Databricks. Esto garantiza que almacenar y recuperar memorias sea ultrarrápido y que sus almacenes puedan escalarse junto con el tráfico de sus agentes.
Construido sobre nuestra investigación de memoria
Agent Memory es una implementación para producción de MemCurrent, el sistema de memoria descrito en MemCurrent: Designing Memory for Enterprise Agents. El hallazgo central de nuestros investigadores es que la memoria funciona mejor en dos capas: un registro bruto de lo que sucedió y un registro sintetizado de lo que vale la pena recordar, mantenido actualizado mediante un proceso en segundo plano en lugar de ser escrito ad hoc por el agente a mitad de la tarea.
Construida de esa manera, la memoria mejoró la calidad y la eficiencia al mismo tiempo. Los agentes superaron aproximadamente tres veces más tareas que los agentes sin memoria, finalizaron más rápido y utilizaron menos tokens. La misma infraestructura ya impulsa la memoria en Genie, la experiencia en lenguaje natural de Databricks para usuarios de negocios.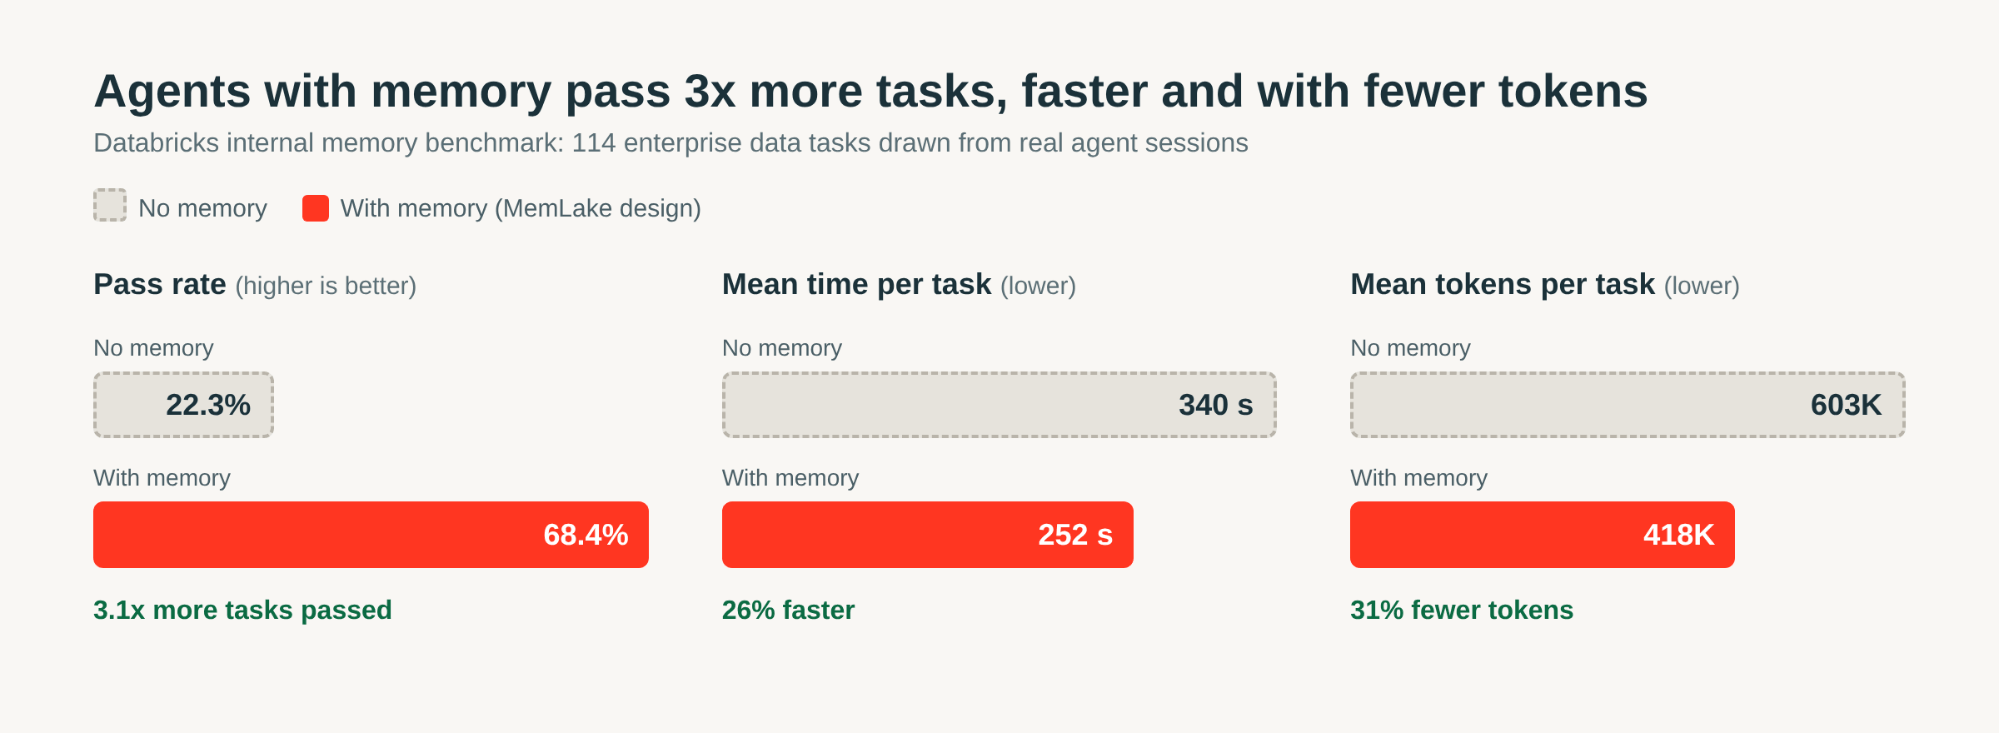
Figura 2. Agentes con y sin memoria en la prueba de rendimiento interna de memoria de Databricks sobre tareas de datos empresariales. Fuente: investigación de MemCurrent.
Qué cambia para sus agentes
- Menor coste por tarea. Los agentes se saltan el trabajo que ya han realizado. En el ejemplo anterior, una vez que el flujo de trabajo se guardó en la memoria, el agente respondió a una pregunta de seguimiento relacionada en 2 llamadas a herramientas y 41 segundos, en comparación con las 11 llamadas a herramientas y casi seis minutos anteriores.
- Personalización persistente. Las preferencias, correcciones y definiciones específicas del equipo se mantienen a lo largo de las sesiones, delimitadas a cada usuario, para que las personas no tengan que repetirse.
- Errores que permanecen corregidos. Los agentes recuerdan sus errores y pueden evitar cometer el mismo error dos veces, lo que ahorra tiempo y tokens valiosos.
- Memoria de su propiedad y bajo su control. Las sesiones y las memorias residen en su proyecto de Lakebase, de forma independiente a cualquier entorno de trabajo de agentes individual. Los desarrolladores pueden leer, exportar y eliminar las entradas que un agente conserva sobre cada usuario, y darle instrucciones a un pipeline de memoria para orientar lo que retiene, como "conservar preferencias duraderas del cliente; ignorar notas puntuales de depuración".
- Una plataforma para todo el ciclo. El mismo agente utiliza modelos a través de Unity Gateway, se despliega con la CLI de Agent Bricks y se rastrea y evalúa con el rastreo de Agent Bricks, con la memoria incluida.
Comenzar
Nada de esto requiere nueva infraestructura por su parte. La CLI de Agent Bricks puede ayudarle a desplegar un agente con memoria y sesiones en cuestión de minutos.
A partir de ese momento, la siguiente conversación de tu agente con cada usuario comienza con lo que aprendió de las anteriores. Para obtener más información, consulta la guía de inicio rápido para crear un agente nuevo con memoria, o nuestro tutorial para agregar memoria a un agente existente.
Agent Memory es una parte de Agent Bricks, la plataforma de desarrollo de agentes de Databricks para crear, ejecutar y mejorar agentes personalizados a escala, con cualquier modelo, marco de trabajo o entorno. Explora Agent Bricks para ver el resto de la plataforma.
Más recursos
- Crea un agente con estado en menos de 10 minutos con la documentación de la CLI de Agent Bricks.
- Agrega memoria y sesiones a un agente existente con la documentación de memoria y sesiones para agentes.
- Lee la investigación detrás de esto en MemCurrent: Diseñando memoria para agentes empresariales.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.