Restauraciones basadas en ramas de Lakebase Postgres para una recuperación rápida a escala
Cómo Lakebase Postgres reemplaza las lentas restauraciones de bases de datos con restauraciones basadas en ramas casi instantáneas para recuperar 100 TB en segundos.
por Cassie Murray y Carlota Soto
- La recuperación tradicional de bases de datos es extremadamente lenta y escala mal con el tamaño, lo que a menudo causa horas de inactividad mientras se aprovisiona nuevo cómputo, se descargan instantáneas grandes y se reproducen archivos de registro.
- Lakebase Postgres introduce las restauraciones basadas en ramas, una operación de metadatos que recupera instantáneamente una base de datos al apuntar a un historial inmutable en un almacenamiento desacoplado en lugar de copiar datos.
- Restaurar una base de datos de 100 TB toma segundos, lo que hace que la recuperación sea prácticamente instantánea y permite a los agentes de AI gestionar sin problemas los flujos de trabajo de ramificación y deshacer.
En los sistemas OLTP administrados, las restauraciones siempre han sido dolorosamente lentas y se vuelven aún más lentas a gran escala. Esto a menudo significa que las bases de datos de producción de gran tamaño, donde el tiempo de inactividad es más costoso, son las que más tardan en recuperarse.
Las soluciones alternativas habituales son difíciles, costosas y riesgosas. Implican réplicas adicionales, entornos adicionales e incluso la intervención de un DBA en la restauración, lo que no garantiza por completo que esté protegido. La conmutación por error (failover) a una réplica en buen estado ayuda cuando una máquina falla, pero no sirve de nada cuando la escritura incorrecta ya se encuentra en la réplica pasiva (standby). Eso de todos modos implica una restauración, y una restauración puede significar horas de tiempo de inactividad.
Este problema se debe a la arquitectura de los sistemas OLTP administrados tradicionales. El cómputo y el almacenamiento se envían como una sola máquina, y la restauración comienza con el aprovisionamiento de una nueva instancia (y la espera ya ha comenzado); las instantáneas residen en el almacenamiento de objetos mientras Postgres se ejecuta en ese volumen, por lo que la instantánea aún debe transferirse al disco (más espera); luego, la reproducción de WAL debe cerrar la brecha desde el momento de la instantánea hasta la marca de tiempo exacta de recuperación (aún más espera). A medida que la base de datos crece, este proceso se vuelve más lento y costoso.
La arquitectura de Lakebase Postgres rompe el monolito y cambia la mecánica de restauración. En Lakebase, el cómputo y el almacenamiento están desacoplados, y el historial de la base de datos ya se conserva en el almacenamiento de objetos de una manera que se puede consultar de forma instantánea. En esta arquitectura, una restauración no copia datos en un disco nuevo. En su lugar, simplemente crea una rama (branch) en una marca de tiempo, lo cual es una operación de metadatos sencilla y no una tarea de copia y reproducción de varias horas.
En términos prácticos, el tiempo de restauración se reduce a segundos, incluso si la base de datos es de 100 TB. Y es tan simple que un agente puede hacerlo.
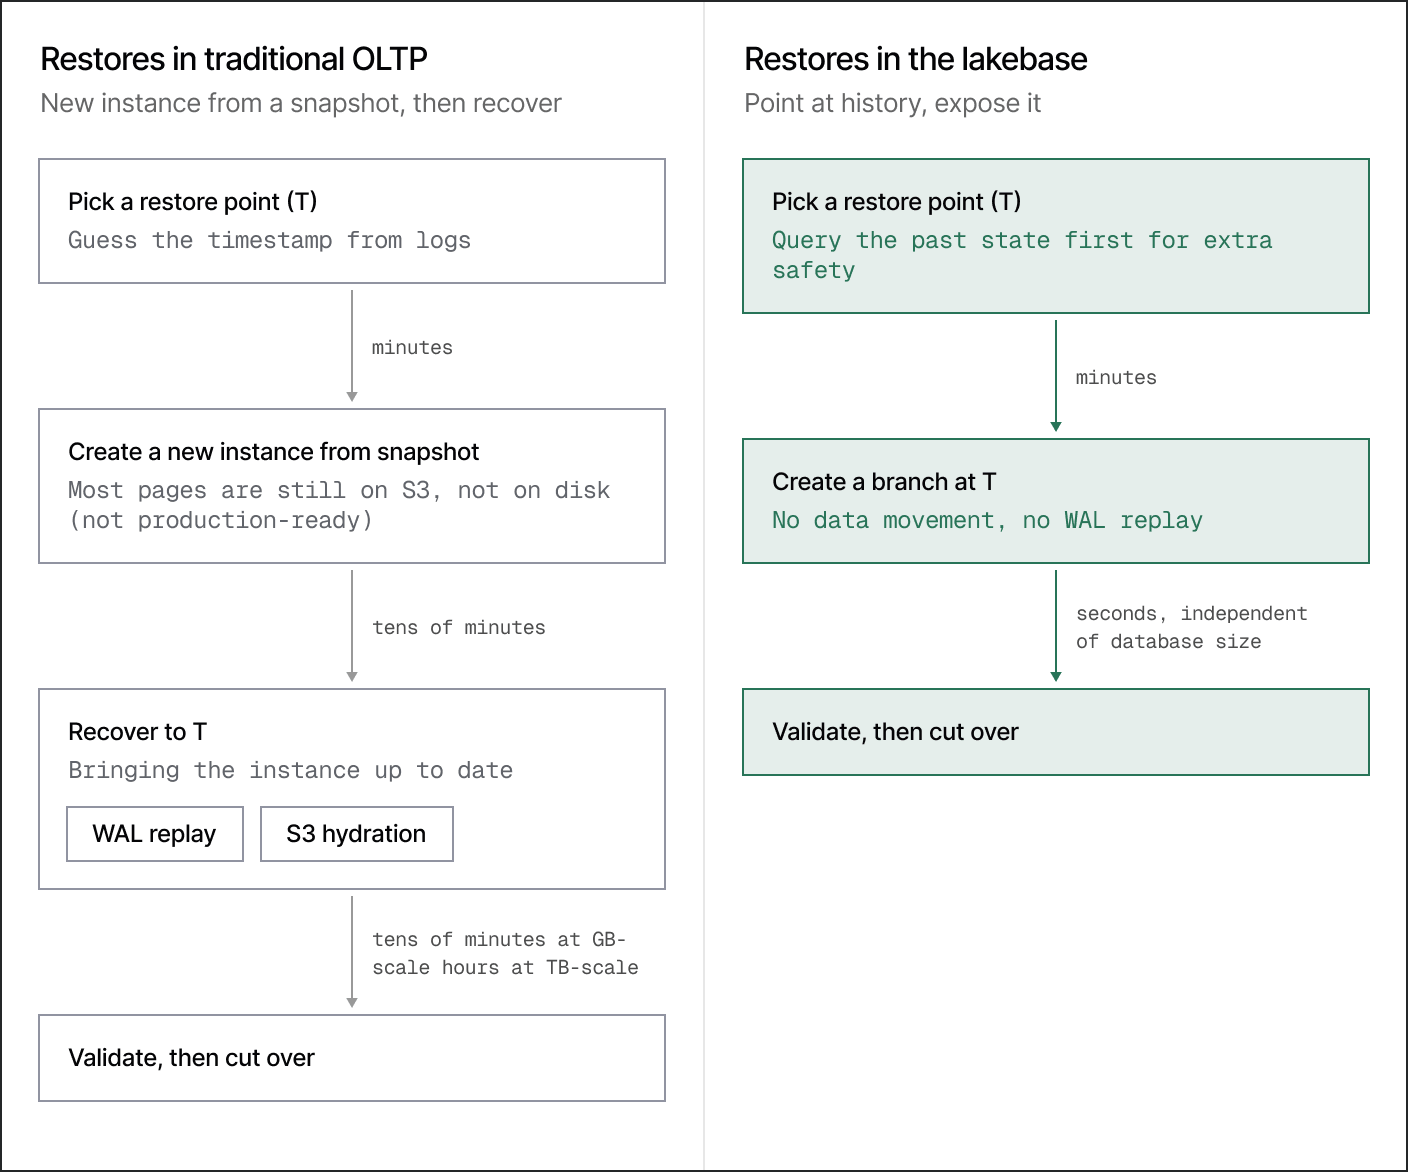
La ruta de restauración tradicional de OLTP (y dónde falla)
La recuperación en el punto en el tiempo (PITR) tradicional de Postgres se basa en dos ingredientes: una copia de seguridad base de los archivos y el WAL archivado para todo lo que ocurra después de esa copia de seguridad. En un entorno de Postgres administrado, como Amazon RDS, esa copia de seguridad suele ser una instantánea que se encuentra en el almacenamiento de objetos.
“Restaurar desde una copia de seguridad” a un momento particular en el tiempo T es en realidad un proceso que consta de tres partes:
- Implementar una nueva instancia
- Restaurar la última instantánea utilizable antes de T
- Reproducir el WAL desde esa instantánea hasta T
1. Implementar una nueva instancia
Esto implica aprovisionar volúmenes de cómputo y almacenamiento (acoplados) de al menos el mismo tamaño que el primario. Una instancia pequeña puede activarse en minutos, pero una instancia grande con volúmenes EBS grandes suele tardar más, lo que hace que tenga que esperar incluso antes de comenzar el proceso de restauración.
2. Restaurar desde la instantánea
Las instantáneas de RDS residen en S3, por lo que “restaurar” significa extraer esa instantánea del almacenamiento de objetos y colocarla en el disco de Postgres.
Este proceso es lento cuando el tamaño es grande, por lo que RDS no espera a que se complete antes de hacer que la instancia restaurada esté available. En el caso de volúmenes grandes, esto ocurre mientras la mayoría de las páginas de tablas e índices aún están en S3. Pero que esté disponible no significa que el conjunto de trabajo esté en el volumen de Postgres. Si una consulta toca un bloque que aún no es local, el volumen lo recupera de S3 en el acto mientras el resto se sigue hidratando en segundo plano.
Este tipo de consultas presentan una latencia que es aceptable para una verificación interna, pero no para producción. La restauración solo se completa cuando los datos que realmente necesita residen en el volumen, y eso no es rápido para una base de datos grande. Cuanto mayor sea la base de datos, más tiempo (en horas) tomará esto.
3. Reproducir WAL hasta T
La instantánea solo es consistente con respecto al momento en que se tomó. Para llegar a T, Postgres aún tiene que reproducir los registros de transacciones archivados después de esa instantánea. El tiempo que toma la reproducción depende de cuánto haya sucedido entre la instantánea y T. Una instantánea de hace una hora será mucho más rápida que una de la noche anterior. Además, si tuvo un día con un alto volumen de escritura, habrá mucho WAL que reproducir. Una vez más, esto significa una larga espera (además de que la instancia aún se está hidratando desde S3).
Ventanas de tiempo de inactividad significativas
A menos que la base de datos sea pequeña, la PITR casi siempre es una operación de varias horas. Debe aprovisionar el monolito, extraer una instantánea de S3, reproducir el WAL y esperar hasta que una parte suficiente del volumen sea local para recibir tráfico.
Durante toda esa ventana, es posible que sufra un tiempo de inactividad. Una réplica en buen estado y de alta disponibilidad (HA) puede salvarlo si la primaria falló y la réplica aún tiene datos correctos. Sin embargo, es posible que no lo salve de una PITR, por lo que las tablas eliminadas y las escrituras incorrectas ya podrían estar en la réplica pasiva (standby).
Las restauraciones lentas de bases de datos son un dolor de cabeza
En una encuesta, se preguntó a 50 desarrolladores que ejecutan Postgres de producción de más de 1 TB sobre su experiencia con las restauraciones:
- El 59 % tuvo una falla crítica de producción en los últimos 12 meses
- El 30 % estuvo inactivo durante más de 3 horas, y algunos superaron el medio día
- solo el 21 % se recuperó en menos de 60 minutos
Esto generó un posible impacto comercial adverso:
- El 40 % informó una interrupción comercial significativa
- El 52 % recibió comentarios negativos de los clientes a raíz del incidente
- El 72 % se sintió solo “algo seguro” de poder recuperarse rápidamente si volviera a ocurrir una falla
Las restauraciones basadas en ramas introducen una nueva ruta
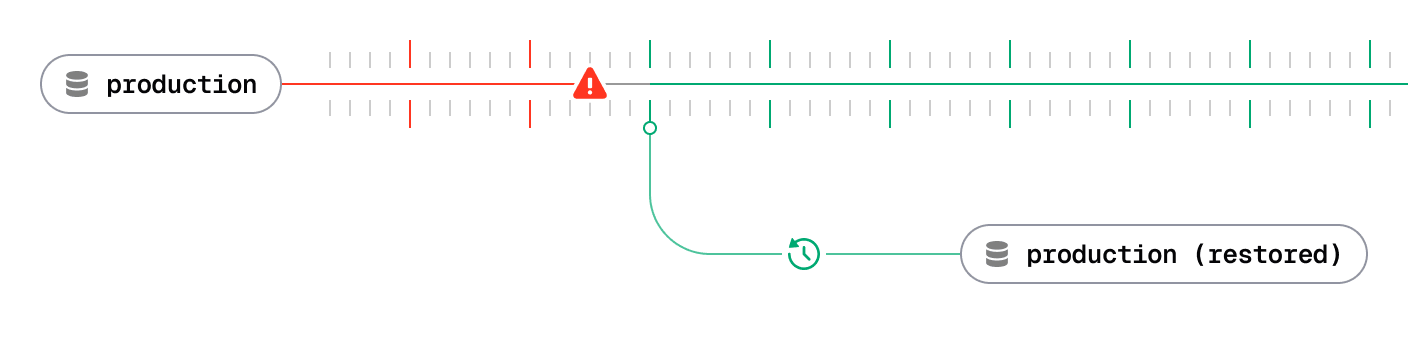
En Lakebase Postgres, una arquitectura moderna permite una ruta diferente para las restauraciones.
El cómputo y el almacenamiento están separados
El cómputo y el almacenamiento duradero están separados y conectados por el WAL. El cómputo ejecuta Postgres, lo que significa que ejecuta SQL, planifica consultas, aplica MVCC, administra bloqueos y genera WAL (todas las tareas habituales de Postgres). Lo que no hace es poseer la copia duradera de sus datos.
El almacenamiento es el que posee la durabilidad y el historial, y el trabajo se divide en tres partes ejecutadas por tres componentes distintos:
- Los safekeepers reciben el WAL del cómputo. Una transacción es duradera una vez que un cuórum de safekeepers ha reconocido su registro de WAL
- El pageserver convierte el WAL en las páginas que lee Postgres. Puede reconstruir cualquier página para una clave determinada en un LSN determinado.
- El almacenamiento de objetos conserva el historial inmutable a largo plazo. El cómputo nunca lo lee directamente; el pageserver se encuentra en el medio.
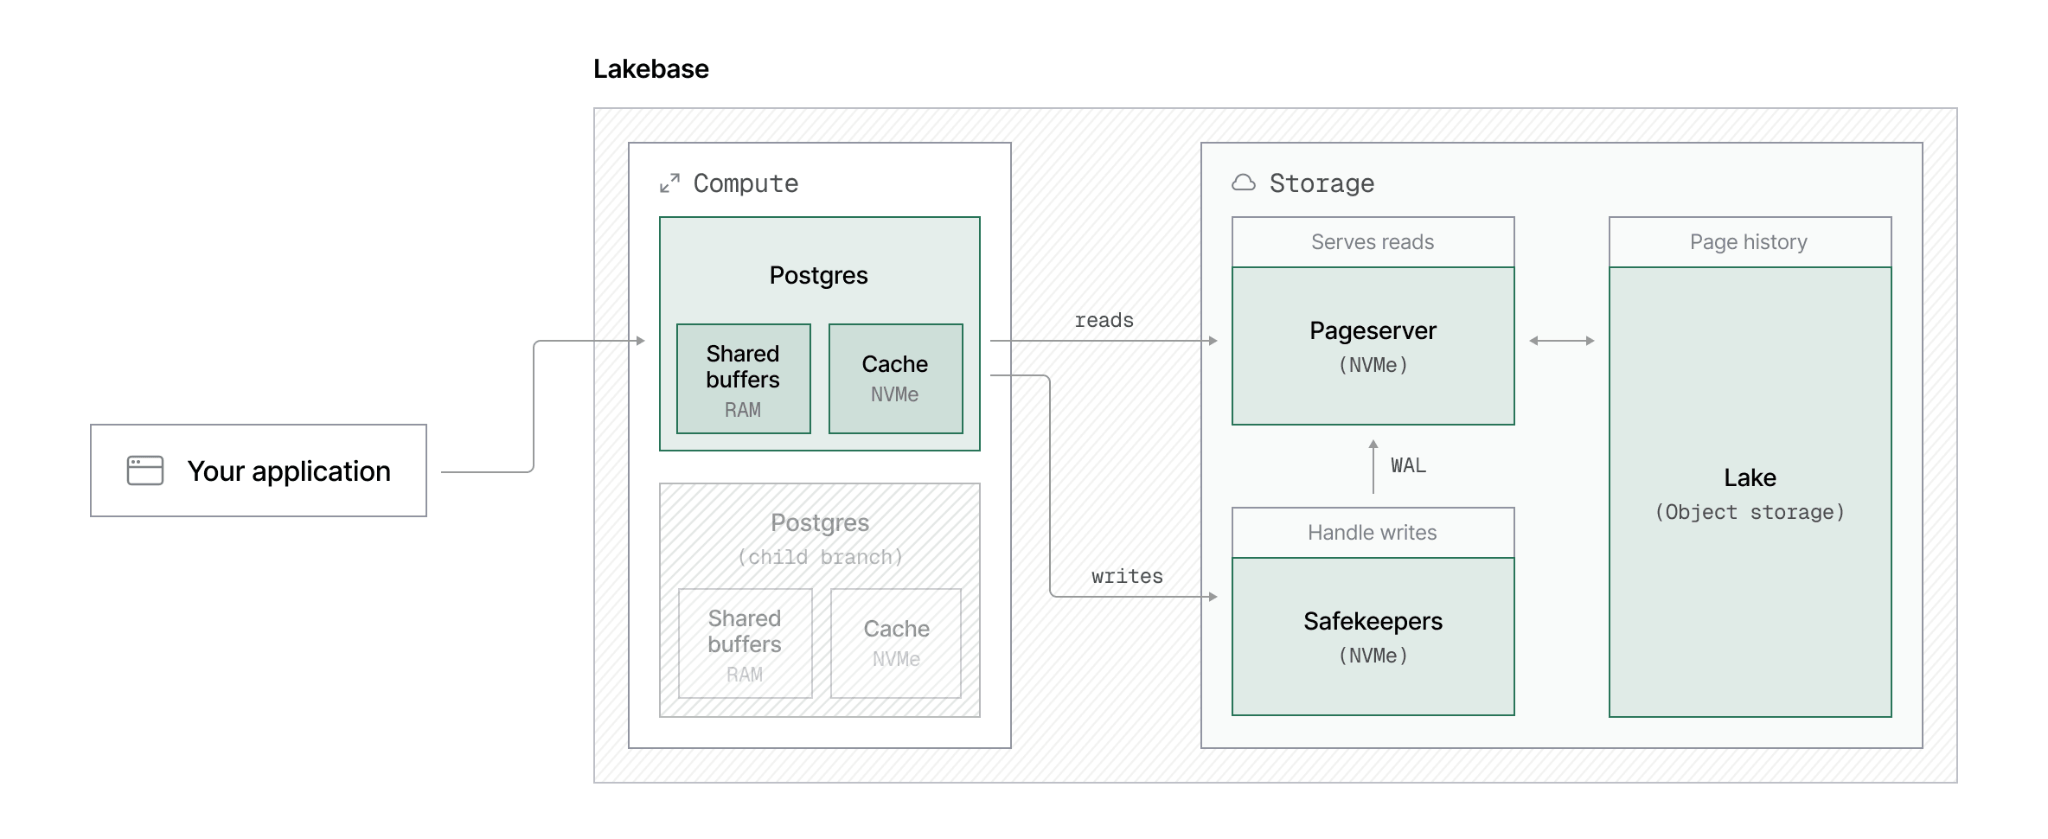
Cuando ingresa una escritura:
- Postgres cambia las filas en la memoria y genera WAL
- El cómputo transmite ese WAL a los safekeepers
- Un cuórum lo reconoce y la transacción ahora es duradera
- Posteriormente, el pageserver convierte ese WAL en versiones de página
- Esas versiones se guardan en el almacenamiento de objetos como historial inmutable
El historial se almacena como una línea de tiempo direccionable
En este diseño, la ruta de escritura toma una forma interesante. La arquitectura anterior separa la confirmación (commit) de una transacción de la materialización de las páginas, lo que en términos más sencillos significa: las versiones de página antiguas nunca se sobrescriben. El historial de su base de datos se acumula como una línea de tiempo a la que puede apuntar, no como una única copia que usted modifica.
Una restauración en Lakebase es una rama en un punto en el tiempo
En la ruta tradicional, una restauración significa principalmente reconstruir ese estado pasado en una instancia separada. Pero con Lakebase, hay un historial de almacenamiento inmutable al que hacer referencia, por lo que ese paso es innecesario y se reemplaza por una primitiva diferente: una rama (branch).
Mientras que las restauraciones tradicionales aprovisionan una nueva instancia y copian datos en ella, una restauración en Lakebase es una rama en un punto del historial. Esta nueva rama tiene su propio cómputo independiente, su propia cadena de conexión y se puede consultar de forma completamente independiente de la producción. No es una réplica de la instancia original, pero se siente exactamente como tal.
A continuación, se explica cómo utilizar esta primitiva para una restauración:
- Cuando algo falla en la rama principal, usted elige una marca de tiempo en el pasado (de hecho, puede inspeccionar esa marca de tiempo antes de comprometerse con una restauración, por ejemplo, ejecutando consultas)
- Una vez que la haya validado, el plano de control asigna esa marca de tiempo al punto exacto en el historial del almacenamiento (el LSN correcto), crea esa rama y asocia el cómputo
- La "base de datos restaurada" es esa nueva rama, que está disponible prácticamente tan pronto como presionas "desplegar", independientemente de la cantidad de datos almacenados en la base de datos subyacente
Dado que este es el concepto clave, reiteremos:
La rama no copia la base de datos
Este método de restauración elimina por completo las copias de datos. La rama restaurada no necesita copiar datos; simplemente apunta a las capas de imagen y delta que ya existen hasta ese momento en el tiempo.
- En un sistema de copia y reproducción, una restauración es una tarea de movimiento de datos. La base de datos no está "ahí" hasta que se completan la copia y la reproducción de WAL
- En Lakebase, la "base de datos" ya está ahí. Una restauración son metadatos: un puntero a un punto en el historial. Lo único que queda es exponer ese punto como una rama, con su propio cómputo
El resultado: restaurar 100 TB es tan rápido como restaurar 10 GB
La ventaja es que el escalado ya no resulta aterrador desde el punto de vista operativo. Si una restauración es un trabajo de metadatos, el tiempo que tarda no aumenta con el tamaño de tus datos, y el mecanismo sigue siendo el mismo.
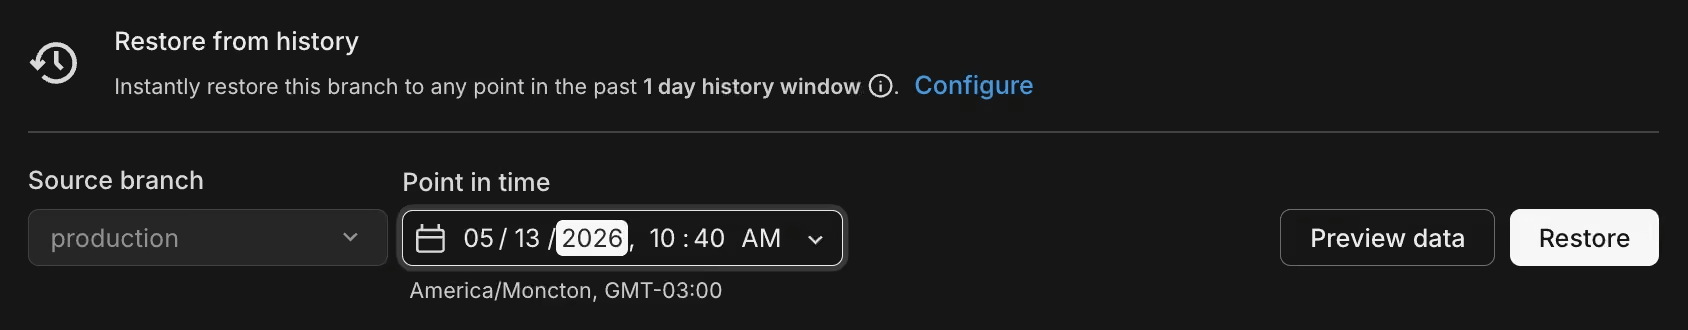
Independientemente de lo grande que sea tu base de datos:
- Acceder a un estado pasado direccionable es casi instantáneo
- Validar ese estado solo toma el tiempo que requieran las comprobaciones y los datos que elijas leer
Un humano o un agente siempre puede acceder a un estado pasado consultable de inmediato después de un incidente, incluso en una base de datos Postgres enorme.
Los agentes pueden construir sobre las restauraciones
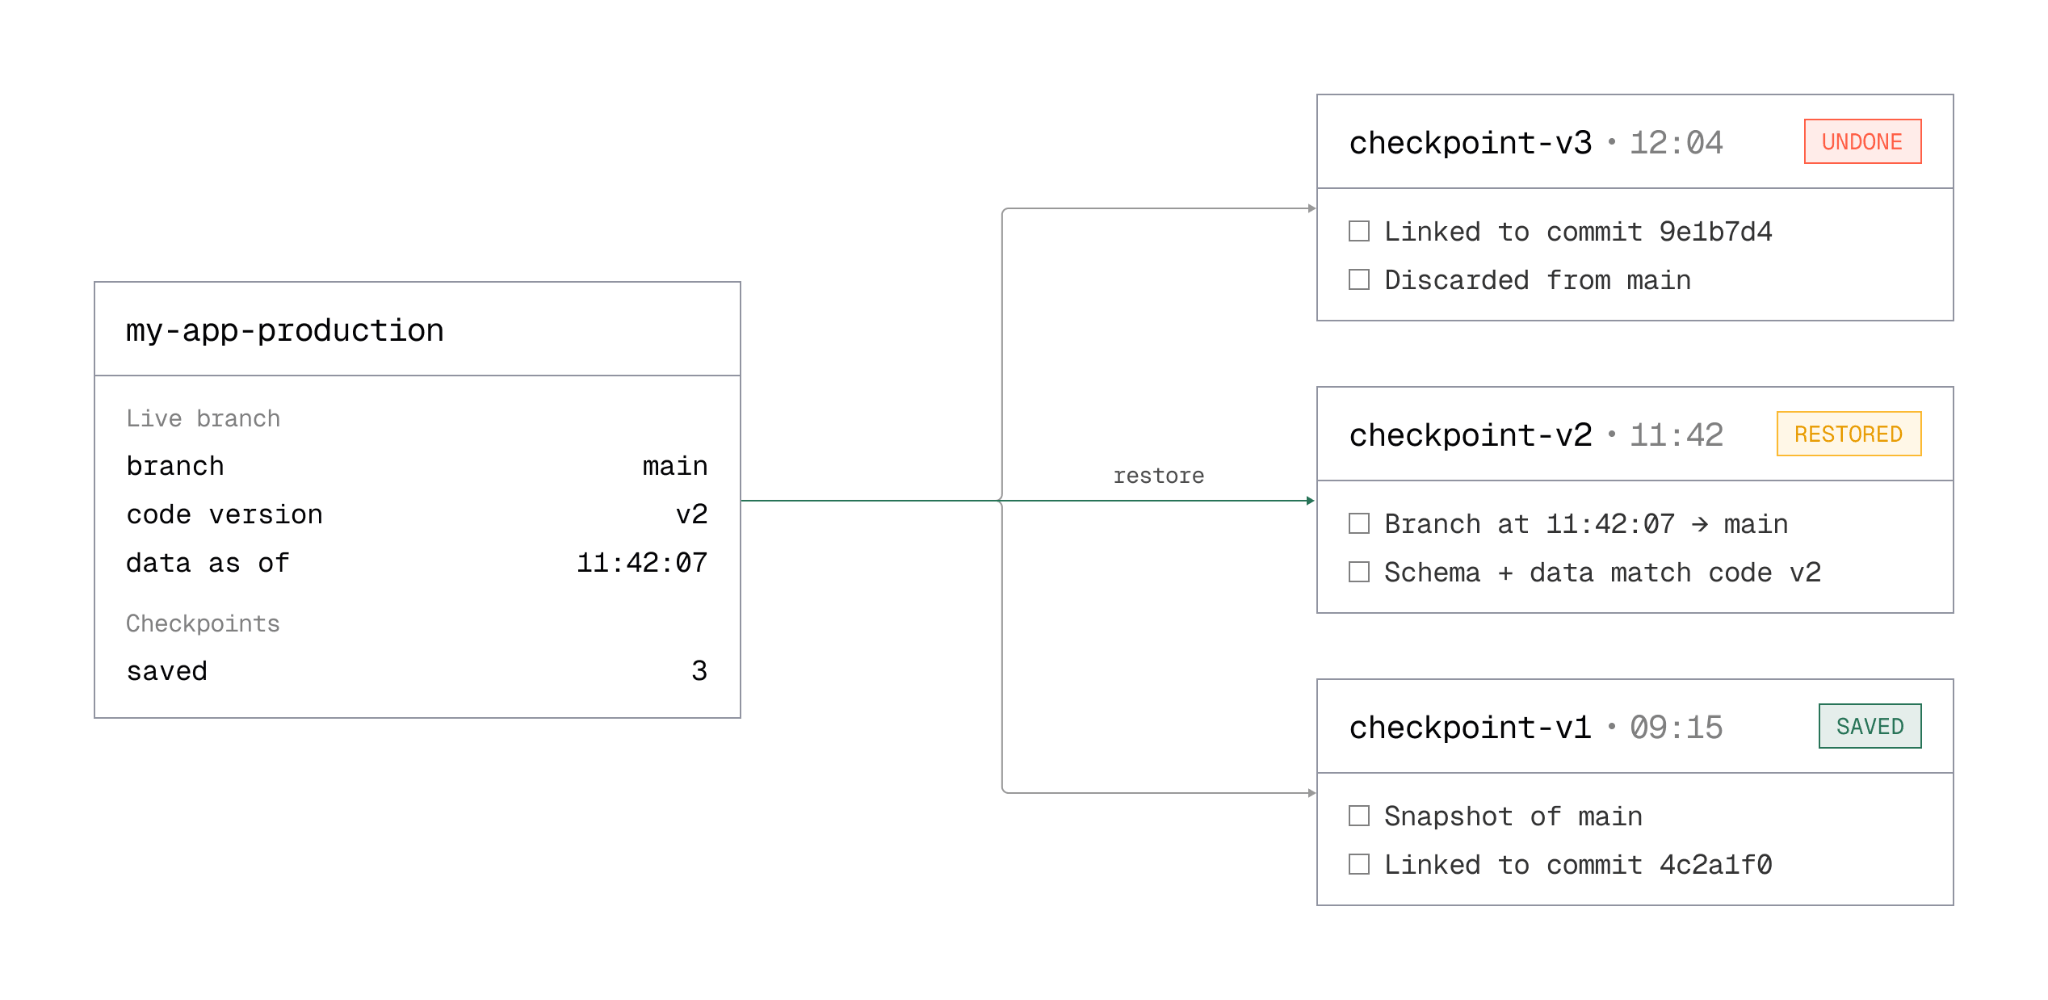
Las restauraciones en Lakebase son una operación sencilla: crear una rama en una marca de tiempo. El bucle es lo suficientemente corto como para que los agentes puedan tratarlo como una llamada de herramienta común, no solo para resolver incidentes.
Esa es la pieza que las plataformas de agentes como Replit o v0 realmente convierten en producto para crear funciones de control de versiones o de deshacer. Un bucle típico se ve así:
- El agente cambia la aplicación, lo que a su vez cambia la base de datos
- La plataforma guarda un punto de control como una instantánea de main. Almacena el ID del punto de control junto a la versión del código
- El usuario presiona deshacer o elige una versión anterior en la UI
- La plataforma busca ese punto de control y lo restaura en la rama activa
- El esquema y los datos vuelven instantáneamente a la versión de la base de datos que coincide con el "código antiguo"
La PITR tradicional es demasiado lenta y pesada para admitir flujos de trabajo en tiempo real, pero una rama en una marca de tiempo es lo suficientemente rápida y económica como para formar parte del producto.
La arquitectura de Lakebase cambia la forma en que se ve la recuperación
Las restauraciones tradicionales se vuelven más lentas y pesadas a medida que la base de datos crece. Las restauraciones basadas en ramas no. El historial ya reside fuera del cómputo, por lo que un punto pasado es algo que puedes abrir como una rama, no algo que debas reconstruir. Independientemente de si tienes 10 GB o 100 TB, las restauraciones se ven iguales. Elige una marca de tiempo, crea la rama y asocia el cómputo. Los fallos a gran escala ya no son tan aterradores.
Compruébalo por ti mismo: crea una base de datos Postgres en Lakebase, carga una buena cantidad de datos, ejecuta una restauración y pregúntate cómo has podido vivir sin esto durante tanto tiempo.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.