Lakebase Search: Búsqueda vectorial y de texto completo de última generación para Postgres
Búsqueda rápida, escalable y serverless en Postgres, ahora disponible de forma general (GA)
por Zhou Sun, Jinjing Zhou, Keming Yang, Usamoi Cui, Pranav Aurora y Junyu Chen
- Lakebase Postgres ahora incluye un motor de búsqueda integrado (GA en AWS/Azure). Dos extensiones, lakebase_vector (búsqueda ANN) y lakebase_text (BM25), le permiten ejecutar búsquedas semánticas, por palabras clave e híbridas directamente en Postgres junto con los datos operativos, lo que elimina la necesidad de un sistema de búsqueda independiente y un pipeline ETL.
- Supera a pgvector y a los motores de búsqueda dedicados a escala. En un benchmark de 100M de vectores, Lakebase ofrece el doble de throughput que el siguiente mejor sistema, un costo 4 veces menor que cloud Postgres con pgvector y un 97% de recall con una latencia P99 de 71 ms. Esto lo logra desacoplando el almacenamiento del procesamiento y utilizando clustering IVF jerárquico + cuantización binaria (RaBitQ) para que las consultas solo afecten a los datos que necesitan.
- La arquitectura es serverless y escala a cero. Paga por el uso de las consultas, no por el volumen de datos. Las compilaciones de índices se descargan de la base de datos primaria, los arranques en frío tardan aproximadamente 1 segundo y se pueden servir 100M de vectores en una sola unidad de procesamiento, lo que lo hace diseñado específicamente para los patrones de recuperación en ráfagas de los agentes de AI.
Los sistemas OLTP tradicionales no se diseñaron para las exigencias de búsqueda de los agentes de IA. Requieren una recuperación de baja latencia y alta precisión en todos tus datos y, a menudo, ejecutan búsquedas paralelas masivas. Hasta ahora, resolver esto significaba conectar de forma improvisada un motor de búsqueda independiente a tu base de datos principal mediante una canalización ETL.
¿Pero qué pasaría si tu base de datos OLTP pudiera simplemente ejecutar la carga de trabajo de búsqueda de manera eficiente?
Hoy, traemos un motor de búsqueda rápido y escalable a Lakebase Postgres a través de dos extensiones: lakebase_vector (búsqueda escalable de vecinos aproximados) y lakebase_text (búsqueda de texto completo bm25). Ambas extensiones están disponibles de forma general en AWS y Azure.
Con lakebase_vector, Postgres está ahora en la vanguardia de la búsqueda vectorial. Supera la eficiencia y escalabilidad de un motor de búsqueda dedicado. En la prueba de rendimiento VectorDBBench de 100 millones de vectores (100M), ofrece el doble de rendimiento que el siguiente mejor sistema y es 4 veces más económico que un proveedor de Postgres en la nube que utiliza pgvector, y eso sin tener en cuenta el ahorro adicional por el escalado automático.
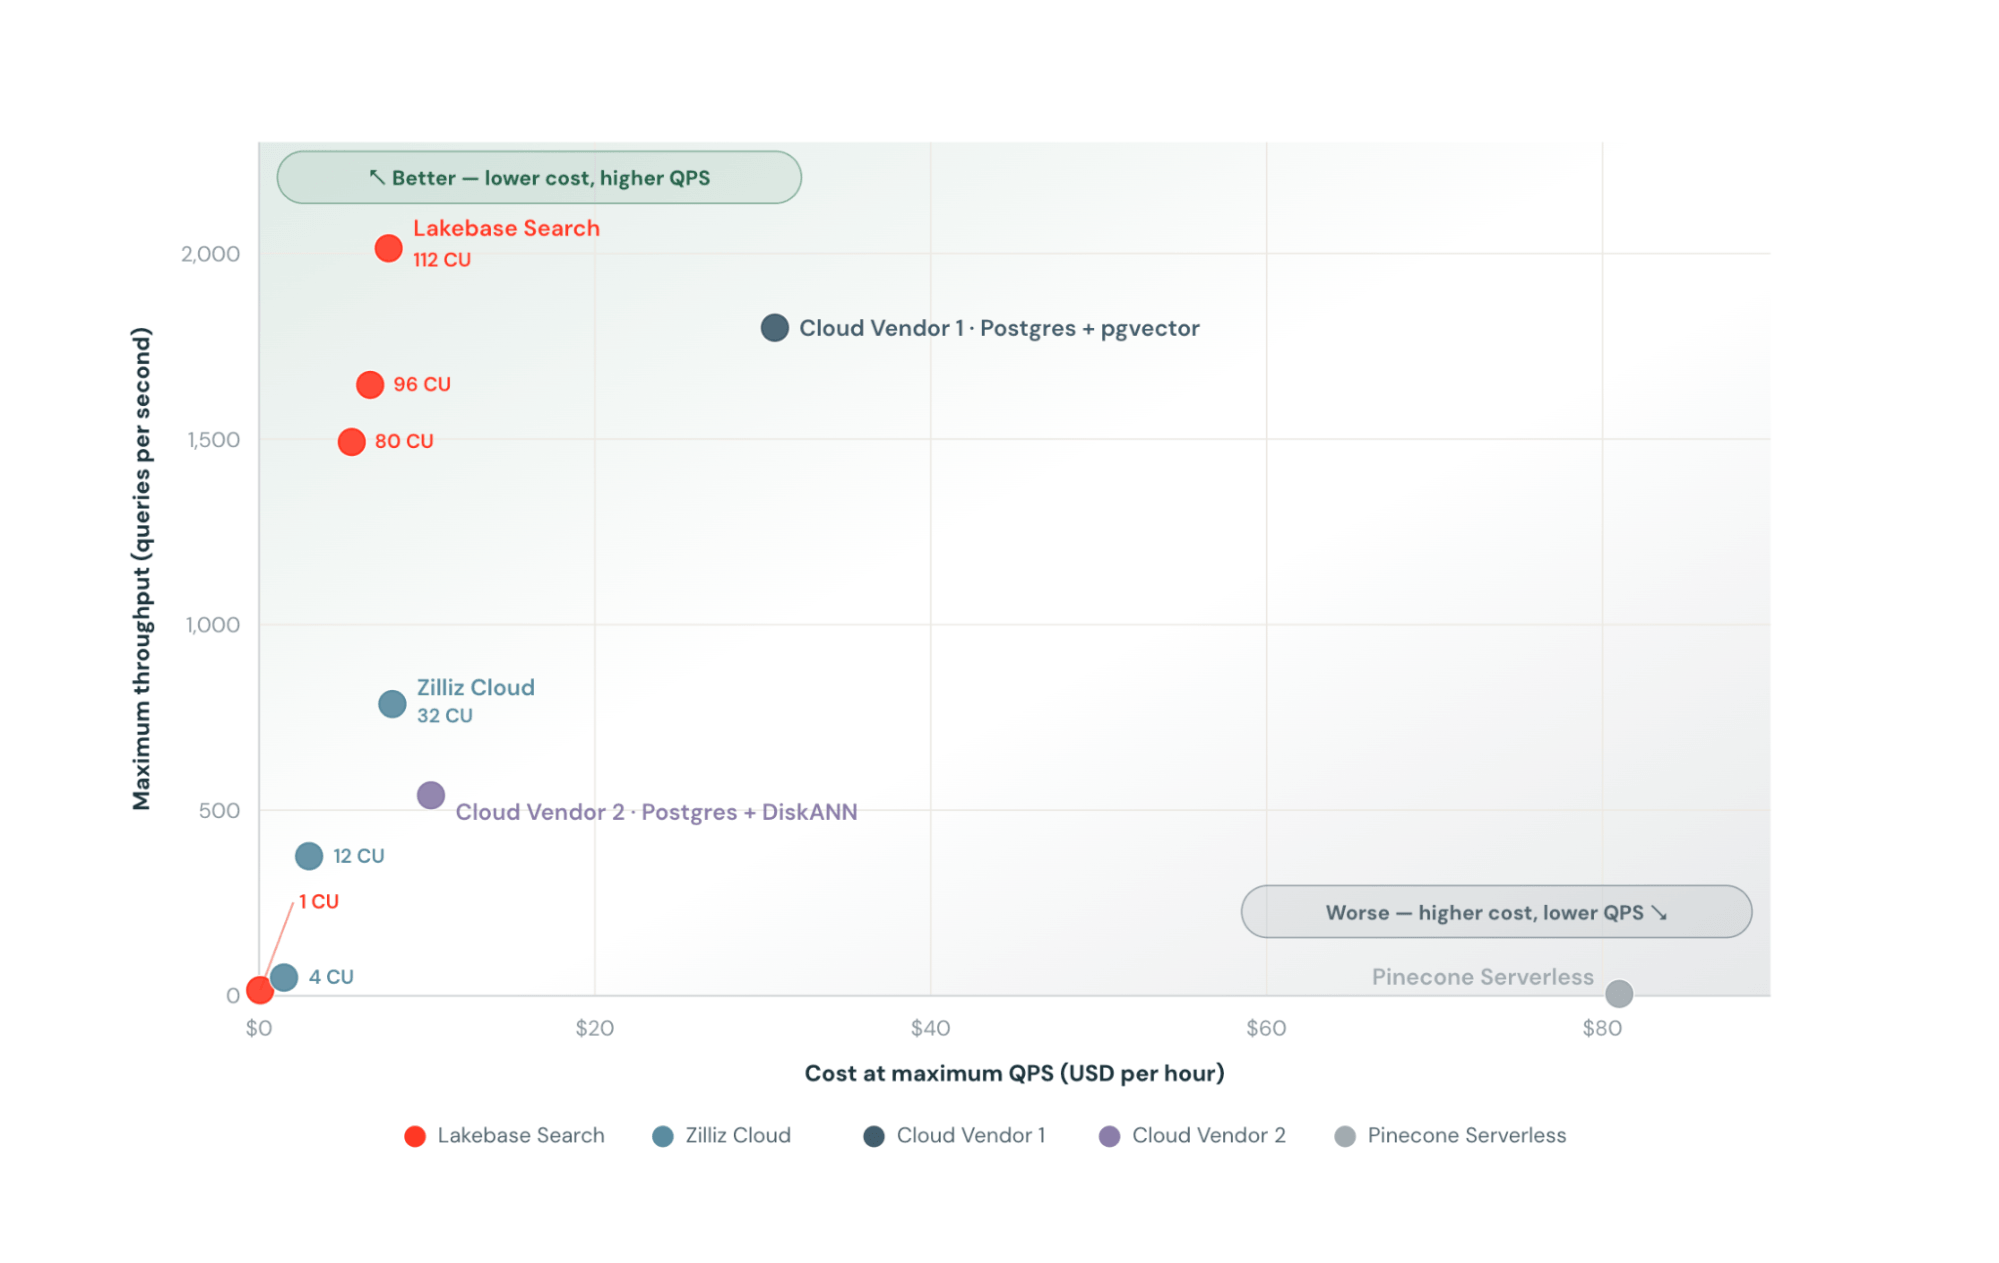
Mantiene este rendimiento sin sacrificar la precisión. En nuestras pruebas, lakebase_vector ofreció una latencia P99 de 71 milisegundos con un 97% de recall (recuperando con éxito los vecinos más cercanos reales el 97% de las veces).

Lakebase Postgres ahora cuenta con capacidades de búsqueda de última generación, y hemos visto a clientes como Conexiom ejecutar búsquedas híbridas con BM25 en más de 100 millones de filas con la mitad de la huella de cómputo de su configuración anterior de pgvector. Ahora tienen una base de datos para todas las cargas de trabajo de OLTP y búsqueda que es completamente serverless y se escala según sus necesidades.
Lakebase Search nos brinda un nivel completamente nuevo de escalabilidad sobre pgvector, y habilita BM25 en la misma base de datos serverless. Usamos Lakebase para conectar datos a nuestros agentes a escala. —Jordan Voves, Arquitecto de IA/ML en Conexiom
Por qué pgvector encuentra un límite a gran escala
Para la mayoría de los usuarios de Postgres, la búsqueda comienza con pgvector. Permite la búsqueda de similitud de vectores a través de algoritmos de indexación como HNSW e IVFFlat sobre datos de forma nativa en Postgres, evitando la complejidad de un almacén de vectores independiente. De hecho, pgvector es la extensión más instalada en Lakebase Postgres. Observamos 3 puntos de dolor comunes en los clientes que ejecutan pgvector a escala.
Primero, los costos se escalan con el volumen de datos, no con el uso.
pgvector mantiene su índice en la memoria de tu base de datos para ser rápido. Debido a que la búsqueda HNSW se basa en el recorrido de grafos de acceso aleatorio, las consultas se ejecutan en milisegundos solo si todo cabe perfectamente en la memoria RAM. En el momento en que el índice se desborda al disco, las consultas se convierten en cadenas de lecturas aleatorias y el rendimiento se desploma de 10 a 50 veces.
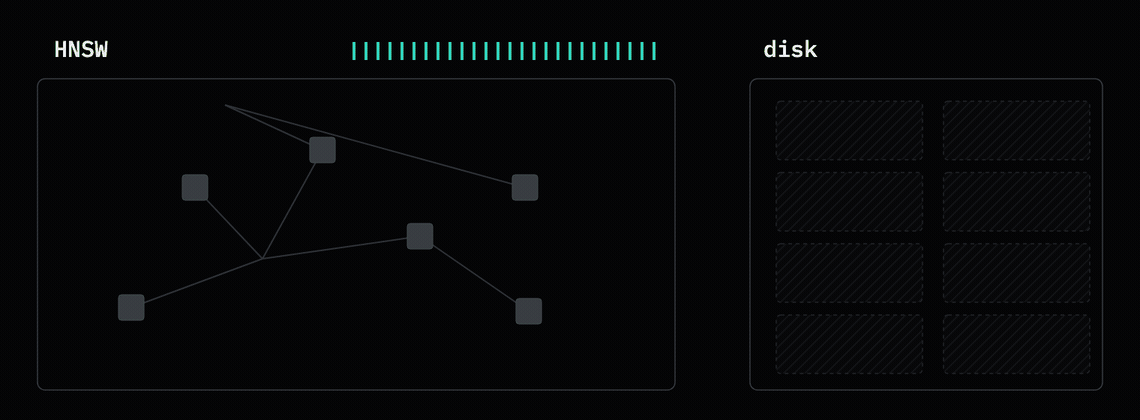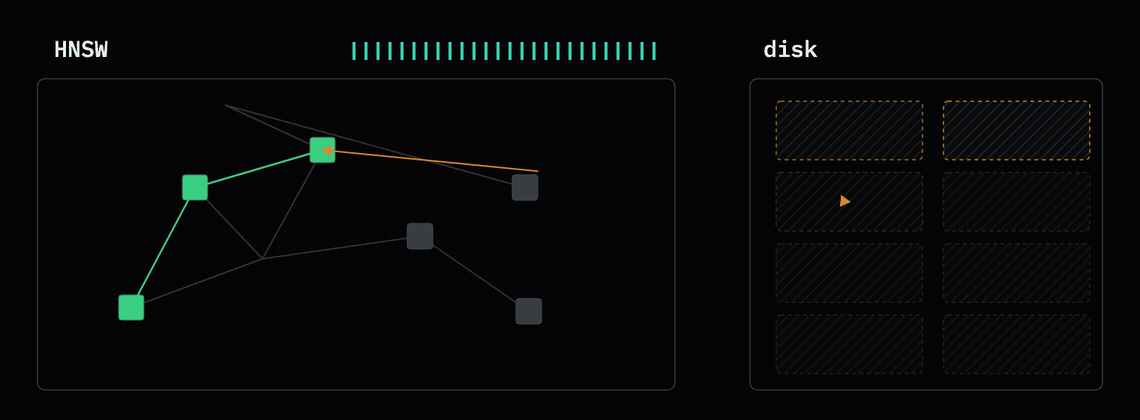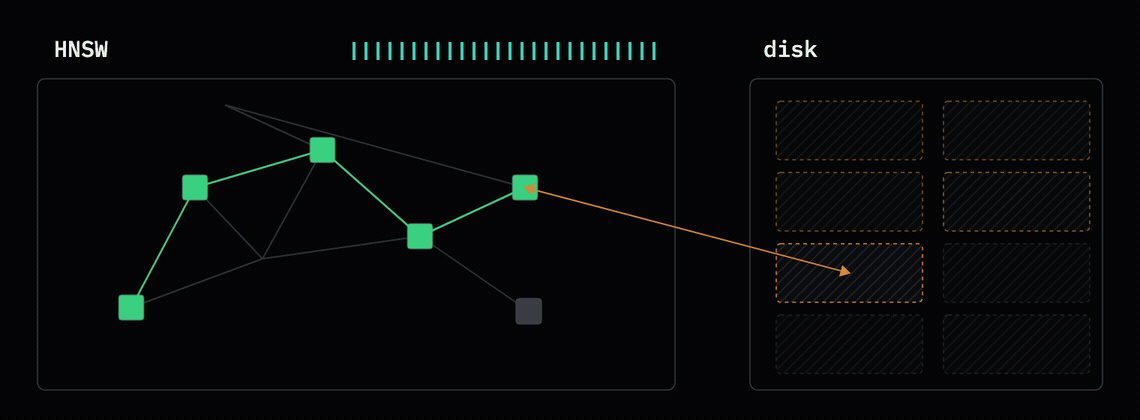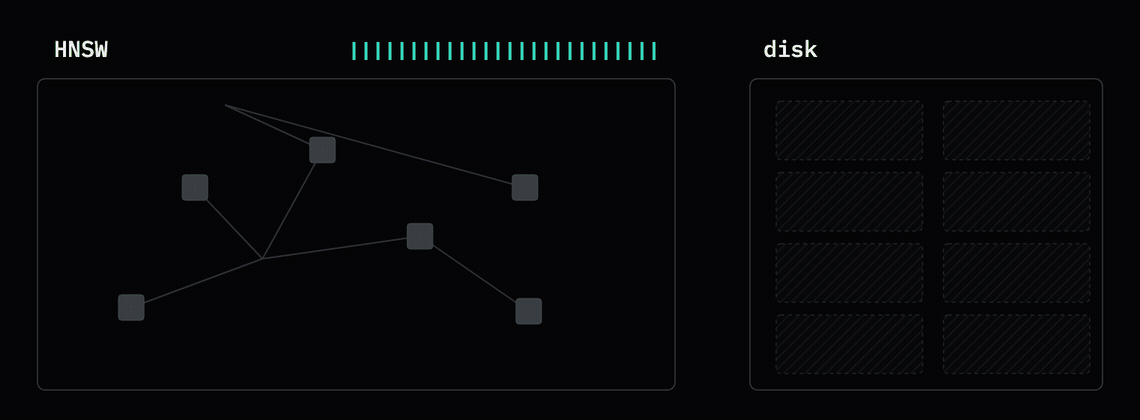
Un vector float32 de 768 dimensiones requiere aproximadamente 3.3 KB de memoria después de contabilizar los enlaces de grafos y la sobrecarga de Postgres. Con 100 millones de filas, necesitas ~330 GB de RAM para mantener el índice residente para consultas de milisegundos. No existe la noción de un "conjunto de trabajo" (working set). Realizas el aprovisionamiento para todo el índice, ya sea que consultes todo o nada.
Segundo, el mantenimiento del índice es costoso y bloquea tu base de datos.
Los índices de pgvector están limitados por la memoria porque el grafo HNSW depende del acceso aleatorio continuo. Cuando la construcción se desborda al disco, millones de operaciones de E/S aleatorias estancan el rendimiento, lo que requiere casi 50 horas para construir un índice pgvector en una instancia de nube estándar.
La ingesta sufre el mismo cuello de botella. Insertar nuevos vectores es lento y costoso porque cada escritura obliga a pgvector a navegar y modificar múltiples capas del grafo utilizando búsquedas de acceso aleatorio.
Segundo, la ingesta se vuelve lenta y costosa, HNSW depende de la navegación continua de grafos de acceso aleatorio. También necesita modificar cada capa del grafo. Así que el índice hnsw
El mantenimiento continuo agrava el problema. Debido a que HNSW carece de reequilibrio global, restaurar la calidad de la búsqueda requiere un REINDEX completo, lo que bloquea la tabla y las escrituras de producción.
Tercero, sacrificas la calidad de la búsqueda a cambio de rendimiento
Cada consulta de pgvector se ejecuta en un único proceso de backend de Postgres, lo que significa que el escaneo del índice HNSW nunca se paraleliza.
Para obtener un mayor recall, el motor debe visitar más nodos del grafo, lo que activa más lecturas de memoria aleatorias y comparaciones de distancia. Esto infla la latencia y reduce tus QPS. Debido a que una sola búsqueda no se puede paralelizar entre núcleos, tu única opción para obtener un mayor rendimiento es agregar más conexiones o réplicas de lectura.
lakebase_vector lleva la búsqueda vectorial escalable a Postgres
El principal cuello de botella con pgvector es que todo el índice tiene que caber en la memoria RAM de una sola máquina para ser rápido. ¿Qué pasaría si no fuera así?
Lakebase Postgres nos brinda un excelente punto de partida, porque separa el almacenamiento del cómputo. Los datos duraderos residen en un almacenamiento de objetos en la nube económico, mientras que la RAM y el NVMe local actúan como cachés efímeras frente a él para lecturas rápidas del conjunto de datos de trabajo. Con esta arquitectura, una caché HNSW se traduce en una serie de lecturas aleatorias del almacenamiento de objetos.
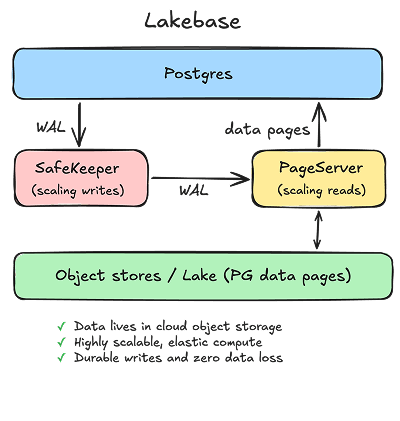
Necesitamos un índice que sea rápido tanto cuando está en caché en la RAM como cuando está frío en el almacenamiento de objetos. Aprovechamos dos ideas:
- Agrupamiento (clustering) IVF jerárquico. Los vectores se agrupan en clústeres almacenados como bloques contiguos. Una consulta califica los centroides de los clústeres en memoria y luego lee solo los pocos bloques prometedores, lo que convierte cientos de saltos aleatorios en un puñado de lecturas secuenciales de gran tamaño.
- Cuantización binaria (RaBitQ). Cada vector se comprime a ~1 bit por dimensión, aproximadamente 32 veces más pequeño que float32. Las consultas escanean los códigos compactos para preseleccionar candidatos, luego vuelven a clasificar (rerank) esa lista restringida de candidatos frente a los vectores de precisión completa.
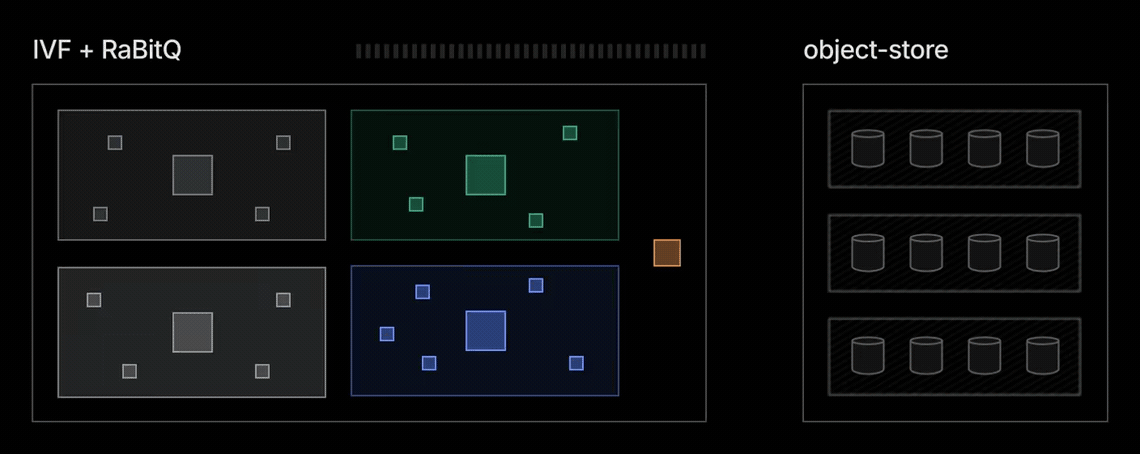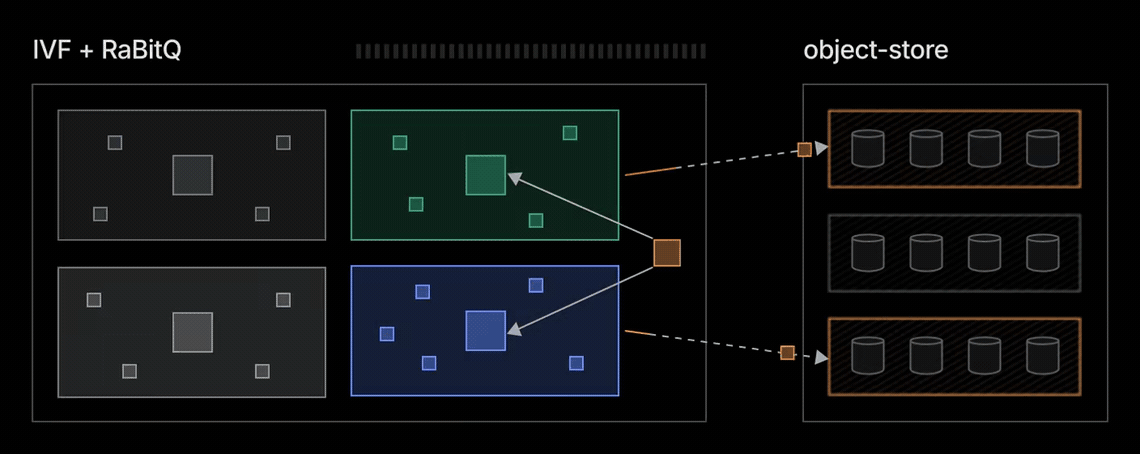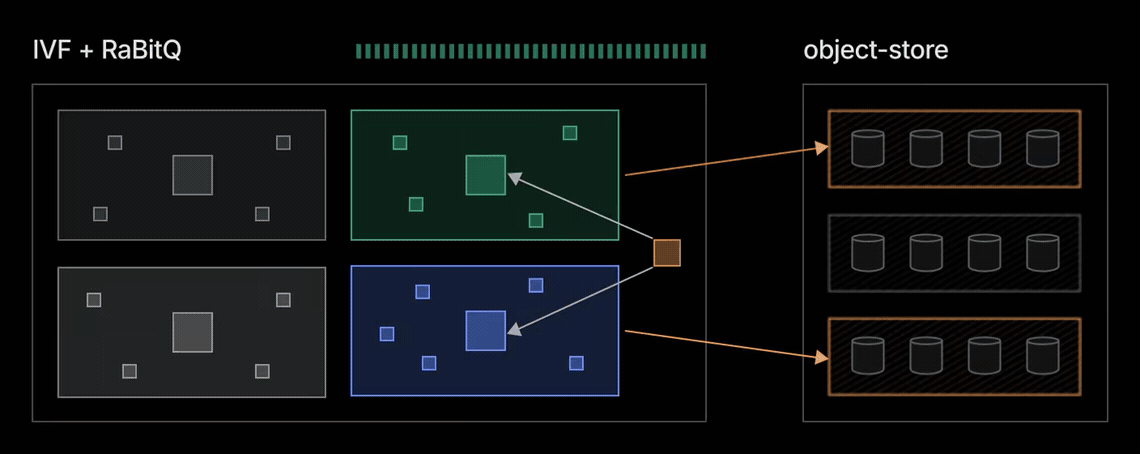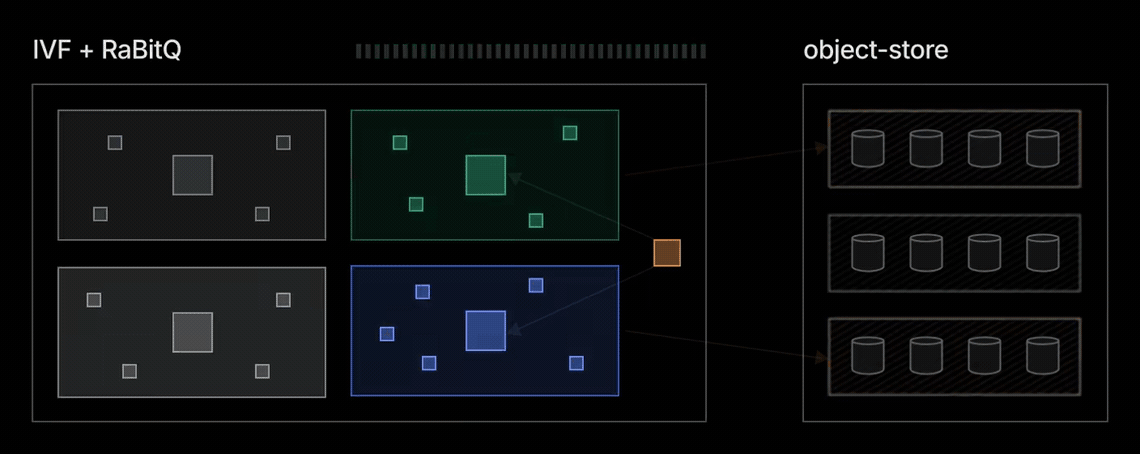
Cuando está en caché, la búsqueda opera sobre una huella mínima utilizando vectores cuantizados. Cuando está frío, las consultas recuperan solo los bloques que necesitan y no tienen que recorrer todo el índice. Lakebase_vector ofrece:
Paga solo por lo que usas y escala a cero
El desacoplamiento del almacenamiento y el cómputo hace que lakebase_vector sea completamente sin estado (stateless): un nodo almacena en caché datos calientes bajo demanda, se suspende a cero cuando está inactivo y se reanuda en la siguiente consulta.
- En reposo, solo pagas por el almacenamiento, lo que te brinda un costo base bajo para mantener los vectores indexados en Lakebase.
- Los arranques en frío son económicos porque solo se cargan los códigos cuantizados y los bloques específicos que toca una consulta. Nuestro P90 medido para la primera consulta después de escalar a cero es de solo 1.13 segundos (100M × 768 dimensiones).
- Incluso es posible servir 100 millones de vectores con solo 1 Unidad de Cómputo (CU) de Lakebase. Solo el conjunto de datos de trabajo activo necesita almacenarse en caché en los nodos de cómputo, lo que te brinda un modelo de precios que realmente refleja el uso real y la actividad de las consultas.

Construcción de índices rápida y delegada
lakebase_vector construye índices de forma más paralela. Entrenamos los centroides una sola vez con una pequeña muestra aleatoria. Este es el único paso que analiza todo el conjunto de datos. Después de eso, cada vector se asigna de forma independiente a su centroide más cercano, se cuantifica y se escribe en el bloque de su clúster. Este proceso se puede distribuir entre tantos núcleos como tengas, escalando con el cómputo.

Llevamos esto un paso más allá al descargar por completo la creación de índices de tu base de datos primaria. Almacenar los datos en formatos abiertos permite que nuestra arquitectura LTAP delegue la indexación y el mantenimiento en motores distribuidos como Spark, reduciendo los tiempos de creación a solo minutos con cómputo en paralelo. Sigue atento.
Búsqueda rápida y precisa
lakebase_vector amplía la búsqueda de candidatos de forma económica utilizando códigos compactos de 1 bit, volviendo a clasificar solo una lista corta y ajustada con total precisión. Dado que los bloques de índices son independientes, una sola consulta se paraleliza entre los núcleos de la CPU, lo que ofrece una alta recuperación y baja latencia de forma simultánea.
El filtrado se realiza directamente a medida que lakebase_vector escanea los bloques del clúster. La aplicación de predicados en línea evita la obtención excesiva de candidatos y mantiene una alta recuperación en las consultas filtradas.
lakebase_text: búsqueda nativa BM25 en Postgres
La búsqueda de texto estándar de Postgres (tsvector) carece de contexto de relevancia en todo el corpus. lakebase_text lleva BM25 nativo a Postgres al puntuar los términos con la frecuencia inversa de documento (IDF) global: ponderando fuertemente los términos raros y de alta intención, mientras penaliza las palabras de relleno comunes.
También es más rápido que los índices tradicionales tsvector + GIN. Al evaluar los límites superiores de puntuación durante el recorrido, el motor omite bloques de publicación enteros que no pueden alcanzar los mejores resultados (top-K).
La combinación de lakebase_text con lakebase_vector habilita la búsqueda híbrida nativa dentro de Postgres. En una sola consulta, puedes fusionar la búsqueda semántica de vectores con la relevancia de palabras clave de BM25, aplicar predicados de filtro SQL estándar y combinar directamente con tablas operativas activas.
Lakebase Postgres está diseñado para la era de los agentes
Los agentes han llevado a los motores de búsqueda tradicionales más allá de sus límites. Convirtieron la búsqueda de vectores en un requisito fundamental de la pila de datos e introdujeron una ráfaga extrema de actividad, donde un solo flujo de trabajo puede activar miles de solicitudes de recuperación simultáneas en segundos.
Diseñamos Lakebase Search específicamente para esta nueva realidad. Lakebase Postgres ahora puede manejar todas tus cargas de trabajo operativas y de búsqueda, respaldado por una arquitectura serverless que escala sin problemas desde 1 fila hasta 1000 millones de vectores, y desde 1 QPS hasta miles, sin necesidad de reaprovisionamiento manual ni gestión de infraestructura.
Creamos Lakebase Search basándonos en los comentarios de cientos de clientes beta, y los resultados hablan por sí solos:
- Gasto en base de datos 3 veces menor: Conexiom redujo los costos de infraestructura en 3 veces y, al mismo tiempo, logró un rendimiento 5 veces mayor en comparación con pgvector.
- Una sola llamada de herramienta SQL para agentes: los desarrolladores reemplazan los complejos pipelines de recuperación multisistema con una sola llamada SQL para la búsqueda híbrida nativa, regulada por las reglas estándar de la base de datos.
- OLTP y búsqueda unificados: los equipos consolidan las tablas operativas activas y los clústeres de búsqueda dedicados en un único backend de pago por uso.
Lakebase Search ya está disponible de forma general hoy en AWS y Azure. Si ya estás creando una aplicación o un agente en Lakebase, simplemente habilita las extensiones. Si aún no has probado Lakebase, comienza hoy mismo.
▎ 📝 Nota: Databricks AI Search es un motor de búsqueda administrado para una recuperación de alta calidad lista para usar; puede ser la mejor opción cuando deseas excelentes resultados sin necesidad de realizar ajustes manuales. Lakebase Search es la mejor opción cuando deseas tener todos tus datos operativos y de búsqueda en una sola base de datos.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.