NEAREST BY Join: escalado de la búsqueda vectorial en Databricks Runtime
Cómo integramos la búsqueda de vectores en Databricks como un join SQL de primer nivel, con optimizaciones profundas de kernel en Photon y un índice de vectores en un formato de almacenamiento abierto.
por Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu y Sergei Tsarev
- NEAREST BY es un nuevo join SQL para la búsqueda de vectores por lotes: para cada fila de consulta, encuentra las k filas más cercanas por similitud o distancia vectorial, ya sea exacta o aproximada.
- Un operador de Photon fusionado con un kernel GEMM bloqueado personalizado lleva la puntuación de distancia hacia el rendimiento aritmético máximo que ofrece el hardware.
- Su Lakehouse también es su almacén de vectores, sin un sistema independiente que sincronizar u operar: el índice de vectores IVF es una tabla Delta común con clustering líquido que descarta la mayoría de las particiones al leer.
La búsqueda vectorial surgió originalmente como un problema de servicio. El caso de uso clásico es un chatbot o una barra de búsqueda: llega un embedding de consulta y el sistema se optimiza para devolver los top-k documentos más cercanos en cuestión de milisegundos.
Sin embargo, una gran parte de las cargas de trabajo de búsqueda vectorial en nuestra plataforma están inherentemente orientadas a lotes (batch): precalculan los vecinos más cercanos exactos o aproximados de forma offline en lugar de buscarlos en el momento de la solicitud. Una empresa de pagos compara más de 100 millones de transacciones diarias con 140 millones de embeddings de comercios para la resolución de entidades; una firma de datos enriquece decenas de millones de registros históricos cada noche; un fondo cuantitativo ejecuta lotes de millones de consultas contra un corpus de 50 millones de vectores para el etiquetado de taxonomías.
La resolución de entidades, la deduplicación, el etiquetado semántico, la clasificación, el enriquecimiento de registros y las recomendaciones por lotes son, fundamentalmente, cargas de trabajo por lotes: millones de consultas contra millones o miles de millones de vectores de forma programada, donde el éxito se mide por si el trabajo se completa dentro de su SLA a un costo razonable, en lugar de por la latencia de una sola búsqueda. Estas cargas de trabajo merecen una arquitectura muy diferente para ofrecer un mejor rendimiento, confiabilidad y eficiencia de costos, por lo que volvimos a los principios fundamentales.
Requisitos
- Rendimiento (throughput) agregado por encima de la latencia por solicitud. La unidad de éxito es que todo el trabajo por lotes se complete dentro de su SLA a un costo razonable, por lo que el diseño debe priorizar el rendimiento sobre la latencia por solicitud en cada oportunidad.
- Escalar en ambos lados del join. Hasta cientos de millones de vectores de consulta contra miles de millones de vectores base. El sistema debe manejar todas las formas de cardinalidad de consulta y base.
- Paralelismo elástico. El rendimiento por lotes proviene del escalado horizontal. El trabajo debe particionarse de forma limpia entre cientos o miles de núcleos, y el cómputo debe adaptarse al tamaño del trabajo: escalar horizontalmente (scale out) para la ejecución y reducirse a cero (scale down) al finalizar.
- Pico aritmético por núcleo. El cálculo de puntuación de distancia es costoso computacionalmente. El escalado horizontal solo multiplica lo que logra un solo núcleo, por lo que los bucles internos deben ejecutarse cerca del máximo teórico establecido por el ancho de banda aritmético (FLOPs/s) y el ancho de banda de memoria (bytes/s) del hardware subyacente.
- Tolerancia a fallos. Un trabajo que se ejecuta durante horas debe sobrevivir a la pérdida de nodos de trabajo (workers), fallos temporales de tareas y presión de memoria mediante el volcado a disco (spilling). Estas son propiedades de un motor de ejecución, no características que podamos añadir a un endpoint de servicio en tiempo real.
El Databricks Runtime se adapta perfectamente a estos requisitos: un motor de ejecución distribuido, elástico y tolerante a fallos creado sobre Spark y Photon, un motor de consultas nativo de C++ vectorizado. Esta es exactamente la razón por la que decidimos crear la búsqueda vectorial directamente como una característica nativa del motor en lugar de depender de una infraestructura independiente.
Arquitectura
Nuestra primera versión de la función SQL VECTOR_SEARCH fue diseñada para federar solicitudes a un endpoint externo de búsqueda vectorial en tiempo real. Se implementó como un nodo Generate que transmitía una fila de consulta a la vez: cada fila implicaba una solicitud de red, una respuesta para deserializar y, posiblemente, reintentos. Funcionó, pero expuso un límite de rendimiento: el rendimiento estaba limitado por el tamaño del endpoint en tiempo real en lugar del tamaño del clúster de ejecución, con el motor de ejecución reducido a un despachador. También pasó por alto la verdadera forma de la consulta. Una búsqueda vectorial por lotes no es un millón de búsquedas pequeñas. Es una sola consulta grande: para cada fila de la izquierda, encontrar las k filas más cercanas de la derecha, es decir, un join de clasificación top-k. Ejecutar joins enormes es exactamente en lo que destaca el motor de ejecución.
Implementar la búsqueda vectorial de forma nativa en el motor de ejecución ofrece ventajas desde dos ángulos.
- Una sola copia de los datos. Los embeddings permanecen en tablas Delta en el Lakehouse: sin un almacén de vectores independiente, sin canalizaciones de sincronización que mantener consistentes y sin un segundo sistema que operar y pagar.
- Un único motor de ejecución. La búsqueda se ejecuta en un solo motor que escala de forma elástica con la carga de trabajo, con kernels diseñados específicamente para formas de consulta por lotes, lo que lleva a cada núcleo hacia su pico de FLOPs y permite que el escalado horizontal multiplique el resto. El motor ya se encarga de la tolerancia a fallos: las tareas se reintentan automáticamente y la presión de memoria se vuelca a disco. Sin control de concurrencia en el lado del cliente, limitación de velocidad (rate limiting) ni bucles de reintento.
Esto dio como resultado una pila deliberadamente pequeña pero profunda: una nueva sintaxis de join, NEAREST BY, que convierte al join de clasificación top-k en una operación relacional de primer nivel; una reescritura que la reduce a tres primitivas: funciones de distancia aceleradas por SIMD y un agregado top-k acotado; un operador Photon fusionado que reemplaza toda la parte media del plan con un kernel GEMM personalizado; y un índice IVF opcional creado como una tabla Delta ordinaria con agrupamiento líquido (liquid-clustered), lo que permite que las consultas APPROX califiquen una fracción de los vectores base con los mismos kernels.
La sintaxis: un join de clasificación top-k
Los motores existentes convergieron en dos formas de interfaz. Postgres con pgvector y Snowflake componen operadores de distancia con ORDER BY … LIMIT; el procesamiento por lotes requiere entonces una subconsulta LATERAL por cada fila conductora, y el optimizador carece de un patrón que reconocer para diferenciar las consultas KNN y ANN. Ese reconocimiento también es frágil: cualquier desviación de la forma esperada de la consulta hace que la ruta rápida desaparezca silenciosamente. BigQuery expone una función con valor de tabla: el procesamiento por lotes es de primer nivel, pero las referencias a las columnas son cadenas que el analizador (parser) no puede validar.
Estructuralmente, la búsqueda vectorial por lotes es una operación relacional binaria: dos entradas de tabla, una salida que combina ambas y un top-k por cada fila de la izquierda que las conecta. La sintaxis codifica esa estructura como un join de clasificación top-k nativo:
El join es asimétrico, similar a LATERAL: el lado izquierdo conduce, el lado derecho es buscado. La dirección de clasificación es explícita: BY SIMILARITY descendente, BY DISTANCE ascendente. LEFT OUTER conserva las filas de consulta sin candidatos, y la expresión BY es conectable (pluggable): cualquier escalar ordenable en ambos lados funciona, por lo que otras expresiones de puntuación pueden reutilizar la misma cláusula más adelante.
APPROX y EXACT codifican un contrato semántico. EXACT garantiza el top-k real mediante una evaluación exhaustiva; APPROX permite que el optimizador sustituya una estrategia aproximada, como un índice ANN, donde corresponda. Por lo tanto, crear o eliminar un índice nunca puede cambiar silenciosamente los resultados de la consulta: solo las consultas que especifican APPROX consienten la aproximación.
La reescritura de consultas
NEAREST BY se analiza en un nodo de join lógico, que el optimizador reduce a operadores relacionales estándar: la reescritura etiqueta cada fila de consulta con un id generado, califica cada par (consulta, base), conserva los mejores k por id con un agregado top-k agrupado e inserta en línea (inline) las filas conservadas:
Semánticamente, esto encapsula toda la característica: un cross join, una expresión de puntuación escalar y un agregado top-k agrupado. Debido a que cada operador es uno relacional ordinario, el plan se distribuye, se vuelca a disco (spill) y se reintenta como cualquier otro; la corrección y la tolerancia a fallos se obtienen de forma gratuita. Lo que la reescritura realmente aísla son las dos primitivas por las que fluye todo el tiempo de ejecución: la función de distancia que califica un par y el agregado que conserva los mejores k de cada grupo.
Implementamos cada operador de este plan de forma nativa en Photon, además de un operador fusionado adicional, creado específicamente para la búsqueda vectorial, que colapsa por completo la sección media del plan con un kernel más eficiente y optimizado para lotes.
Los kernels de Photon
Las funciones vectoriales
Los bloques de construcción principales son una familia de funciones SQL vectoriales sobre columnas ARRAY<FLOAT>. Tres de ellas son responsables del cálculo de similitud y distancia:
| Función SQL | Calcula | Más cercano significa |
|---|---|---|
| vector_inner_product(a, b) | 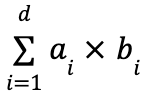 | Mayor (BY SIMILARITY) |
| vector_cosine_similarity(a, b) | 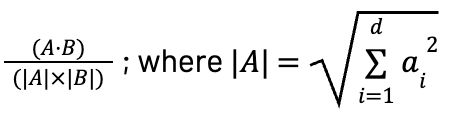 | Mayor (POR SIMILITUD) |
| vector_l2_distance(a, b) | 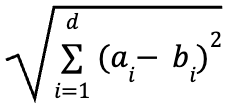 | Menor (POR DISTANCIA) |
Junto con las funciones de similitud y distancia, lanzamos dos funciones auxiliares de norma (vector_norm y vector_normalize) y dos agregados (vector_sum y vector_avg). Juntos cubren tanto la construcción de consultas como de índices: las funciones de distancia evalúan las consultas y asignan filas a su centroide más cercano, mientras que los agregados y normalizadores recalculan esos centroides durante k-means.
Photon ejecuta toda la familia como kernels SIMD nativos. En esencia, cada métrica consiste en operaciones de multiplicación y suma, y una única instrucción de multiplicación y suma fusionada (FMA) calcula 𝑎 · 𝑏 + 𝑐 en todo un registro vectorial por emisión. Los kernels se implementan en función de cuatro decisiones de diseño deliberadas.
- Portables por diseño. Los mismos kernels deben ejecutarse en cada nube (AWS, Azure, GCP) y en cada arquitectura de CPU (x86, ARM) que admitimos. Dado que el ancho de SIMD y el conjunto de instrucciones difieren entre ellas, cada kernel se compila en varios clones específicos de la ISA, y el mejor que admita la CPU se selecciona en tiempo de ejecución (AVX-512 en un núcleo Intel moderno, SVE2 en Graviton).
- Entrada sin copia (zero-copy). Un ARRAY<FLOAT> es contiguo dentro de una fila, por lo que cada vector se lee como un puntero directo al búfer de respaldo de la columna sin realizar copias ni indexación por elemento dentro del bucle crítico (hot loop).
- Semántica de flotantes relajada. Prescindir del orden estricto de IEEE permite al compilador fusionar multiplicaciones y sumas en instrucciones FMA y dividir la reducción en cadenas de acumuladores en paralelo, de modo que el bucle no se serializa en una sola suma acumulada.
- Nada escalar en el bucle. Los bucles críticos son reducciones vectorizadas puras de multiplicación y suma; el trabajo escalar, como sqrt y la división, se realiza una sola vez, fuera del bucle.
El agregado top-k
En SQL estándar, el top-k agrupado es una función de ventana: ROW_NUMBER() OVER (PARTITION BY query ORDER BY score). Esto ordena cada partición por completo y luego descarta todo excepto los k rangos superiores. En su lugar, ampliamos los agregados max_by / min_by existentes con una sobrecarga de un tercer parámetro K. La implementación se basa en cuatro propiedades clave.
- Selección de una sola comparación. El estado de agregación por grupo es un montículo (heap) acotado cuya raíz es el candidato de desalojo y el umbral de admisión. Una vez lleno, cada candidato se acepta o rechaza con una sola comparación. Nunca se ejecuta una ordenación sobre el flujo de candidatos.
- Estado O(k). La memoria por grupo es independiente del tamaño de la entrada. Una consulta evaluada frente a mil millones de filas solo contiene k filas de estado, y k puede llegar hasta 100,000.
- Materialización tardía. El montículo almacena índices, no copias completamente materializadas. Un candidato sigue siendo un puntero al lote columnar activo y se copia al estado agregado solo si sobrevive cuando se recicla el lote.
- Distribuible. Los agregados tienen un contrato de fusión/parcial. Cada partición emite su top-k local, el shuffle mueve esos arreglos de k elementos en lugar de pares sin procesar, y la fusión los vuelve a insertar. El resultado es exacto porque el top-k global siempre es un subconjunto de la unión de los parciales.
El modelo roofline
Con todos los kernels nativos anteriores, el plan de consulta está completamente optimizado para Photon (Photonized), pero aún está lejos de ser óptimo a escala de lotes. La razón es teórica, no de implementación, y el modelo roofline es una forma sencilla y eficaz de visualizarlo.
𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 = 𝑚𝑖𝑛(𝑃𝑝𝑒𝑎𝑘, 𝐴𝐼 × 𝐵𝑊)
𝑃𝑝𝑒𝑎𝑘 es el rendimiento de cómputo máximo del hardware (FLOPs/s), BW es el ancho de banda de la memoria (bytes/s), y 𝐴𝐼 es la intensidad aritmética del kernel (FLOPs realizados por byte movido). Al graficar 𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 frente a 𝐴𝐼, obtenemos el límite roofline: un techo de memoria diagonal que se encuentra con un techo de cómputo horizontal en el punto de cresta, es decir, la 𝐴𝐼 mínima en la que un kernel puede estar limitado por el cómputo (compute-bound). A la izquierda de la cresta, solo ayuda mover menos bytes por FLOP; a la derecha, el kernel está limitado por el cómputo y las propias unidades aritméticas son el límite. Concretamente, en una máquina m6i.2xlarge de referencia (a modo ilustrativo, las constantes varían según el hardware):
| Por núcleo | |
|---|---|
| Techo de rendimiento de cómputo | 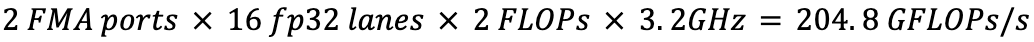 |
| Techo de ancho de banda de DRAM | 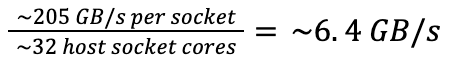 |
| Punto de cresta | 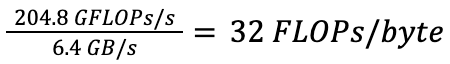 |
*Los techos de caché L1/L2 se sitúan entre 30 y 60 veces por encima de la cuota equitativa de DRAM, pero la tabla base es mucho más grande que cualquier caché, por lo que cada byte base cruza el límite de la DRAM al menos una vez.
*El techo de rendimiento de cómputo escala linealmente con los núcleos. Un clúster de 64 ejecutores m6i.2xlarge (4 núcleos físicos cada uno) alcanza un máximo de 64 x 4 x 204.8 GFLOP/s ≈ 52.5 TFLOP/s de FMA de fp32.
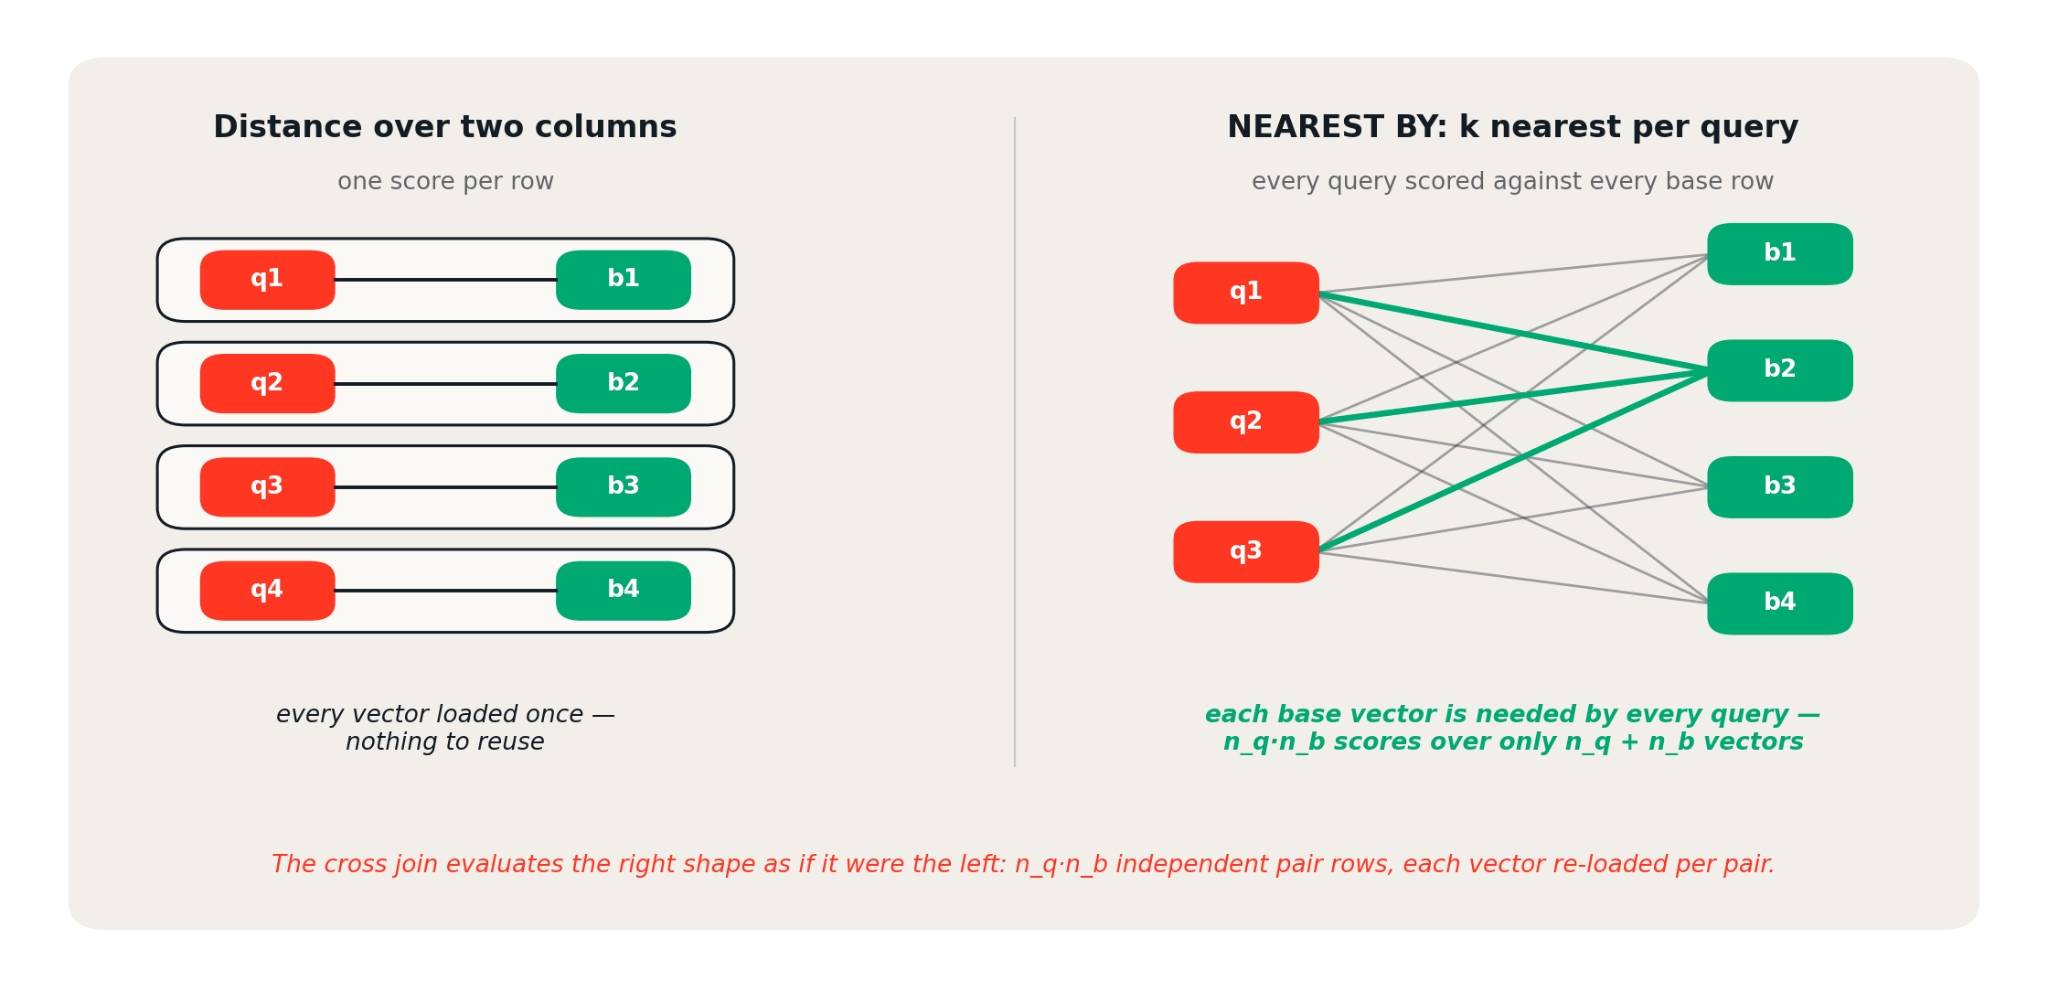
Evaluar dos columnas alineadas produce una puntuación por fila: cada vector se usa una vez y no existe reutilización. La forma NEAREST BY produce 𝑛𝑞 × 𝑛𝑏 puntuaciones a partir de solo 𝑛𝑞 + 𝑛𝑏 vectores distintos, ya que cada vector base es requerido por cada consulta.
Ahora compare lo que mueve la búsqueda de vectores bajo el plan ingenuo (naive) frente a uno consciente de la reutilización. Los FLOPs son idénticos en ambos: 2 × 𝑑 × 𝑛𝑞 × 𝑛𝑏, donde 𝑛𝑞 y 𝑛𝑏 son la cardinalidad del lado de la consulta y de la base, y d es la dimensión de incrustación.
| Plan | Bytes movidos | Intensidad aritmética (AI) | Escalado |
|---|---|---|---|
| Combinación cruzada por pares (pairwise cross join) — cada operando se carga de nuevo y se usa una sola vez | 2 × 4 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 | 1/4 | 0(1) |
| GEMM fusionado — almacenamiento en búfer, transmisión única | 4 × 𝑑 × 𝑛𝑏 | 𝑛𝑞/2 | 0(𝑛𝑞) |
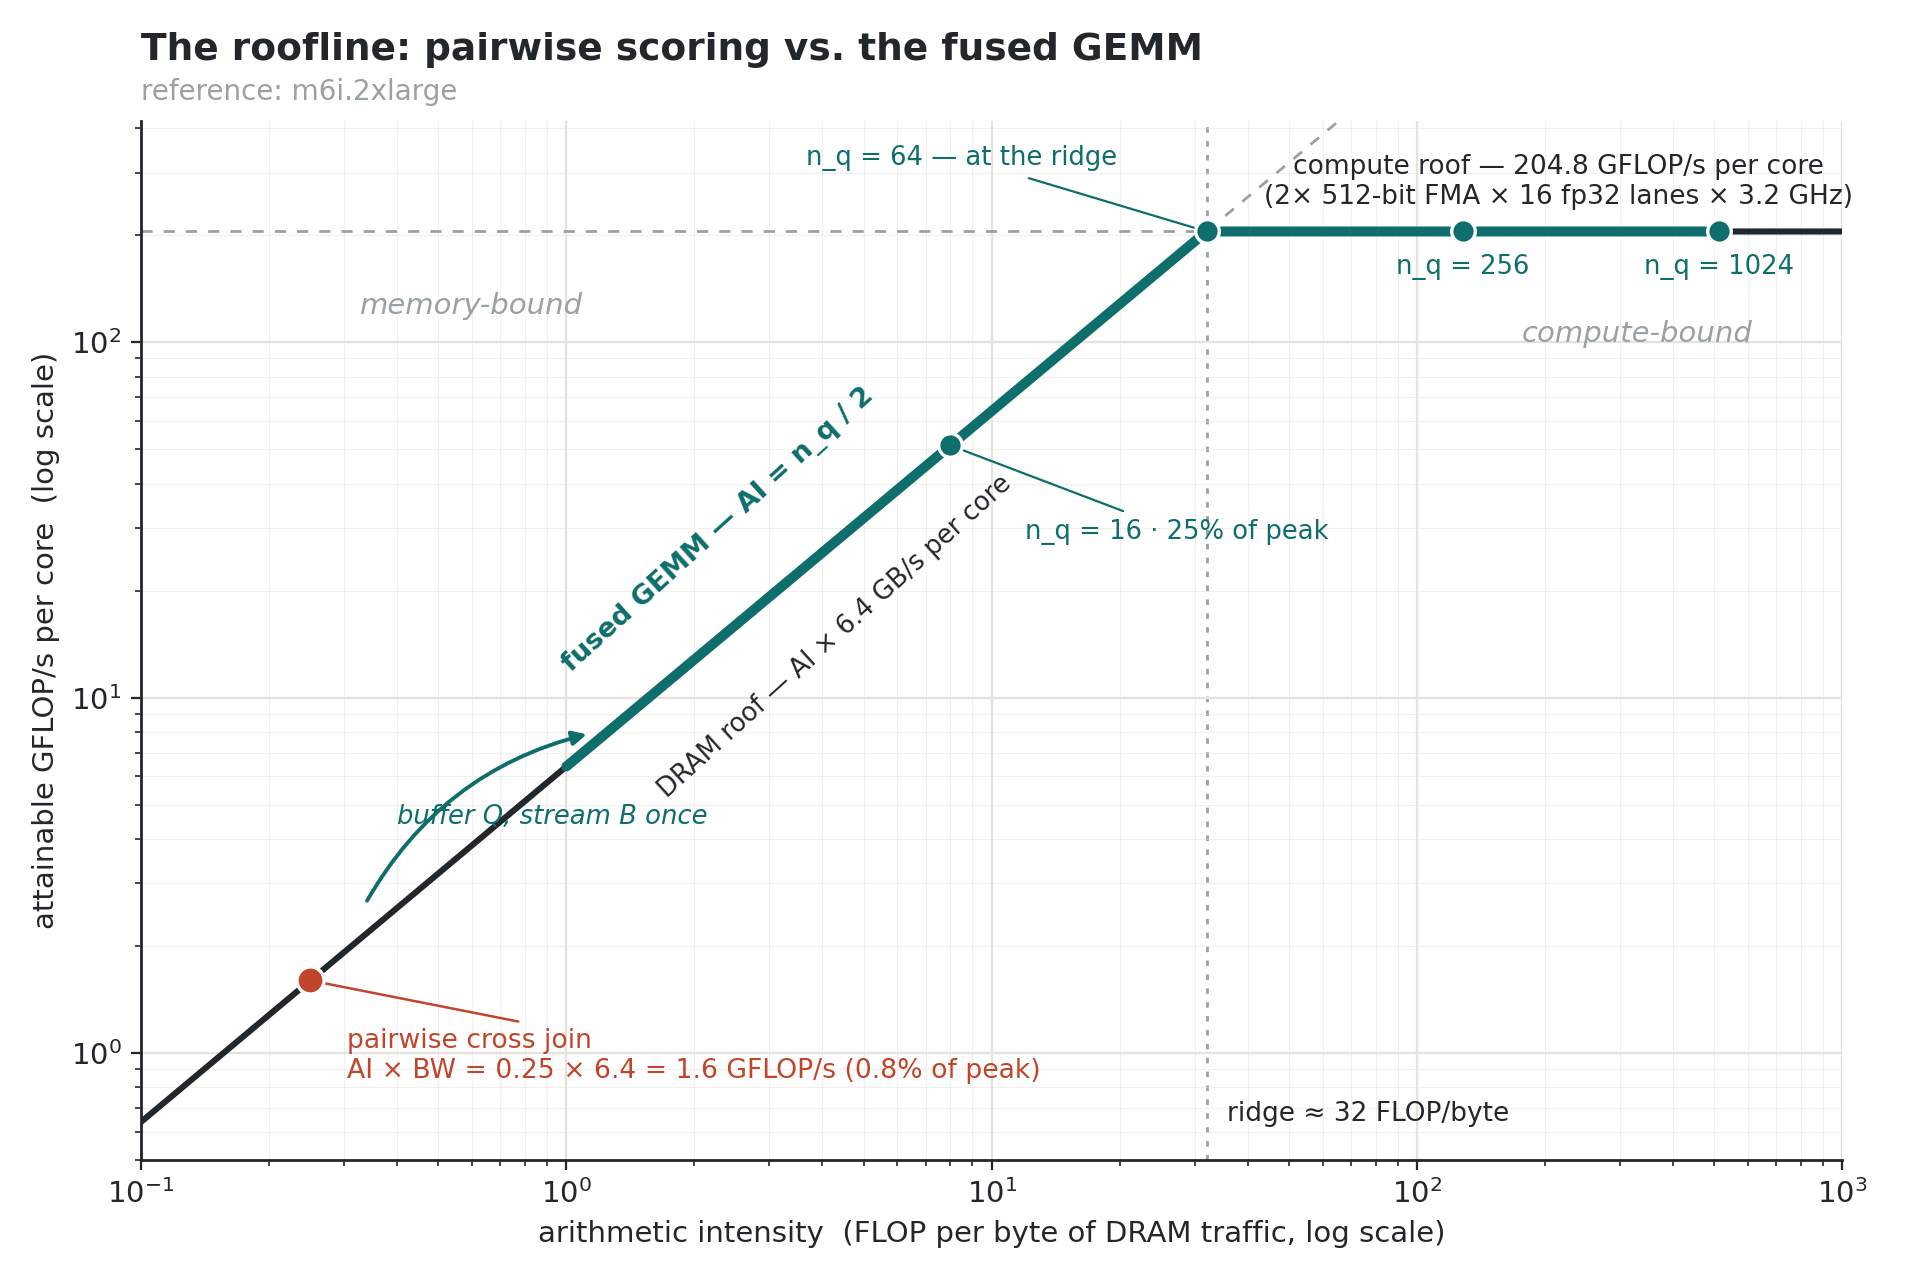
La evaluación por pares queda fijada a la pendiente de la DRAM al 0.8% del máximo, mientras que la intensidad aritmética del kernel GEMM fusionado crece con el tamaño del lote: 𝐴𝐼 = 𝑛𝑞/2, lo que le permite cruzar la cresta en 𝑛𝑞 = 64 y mantenerse en el techo de cómputo con lotes más grandes. Los kernels de distancia y similitud de vectores son casi óptimos para su forma de entrada, pero la forma del plan ingenuo no tiene reutilización de datos que aprovechar, y el procesamiento por lotes no puede ayudar: la explosión de pares multiplica los FLOPs y los bytes por igual. La solución es un plan de operador fusionado, permitir que el kernel aproveche la reutilización de datos y la intensidad aritmética aumentará en consecuencia.
El operador fusionado y el kernel GEMM
El operador fusionado es un único nodo de ejecución de Photon que reemplaza el cross join, la proyección de distancia/similitud y, opcionalmente, el top-k parcial. Almacena en búfer la entrada más pequeña, transmite la otra en lotes, evalúa las teselas de consulta por base con un kernel GEMM personalizado y mantiene el estado top-k por consulta a través de las teselas cuando k es lo suficientemente pequeño. Con el top-k fusionado, su salida es de como máximo 𝑛𝑞 × 𝑘 filas candidatas en lugar de pares 𝑛𝑞 × 𝑛𝑏 , consumidas por el kernel de fusión descendente max_by / min_by. El pico de memoria por tarea es el lado almacenado en búfer + un lote en tránsito + el estado de selección 0(𝑛𝑞 × 𝑘). La distribución sigue las estrategias de combinación estándar: transmitir (broadcast) el lado más pequeño cuando quepa; de lo contrario, particionar ambos lados y ejecutar un producto cartesiano por bloques (block-cartesian).
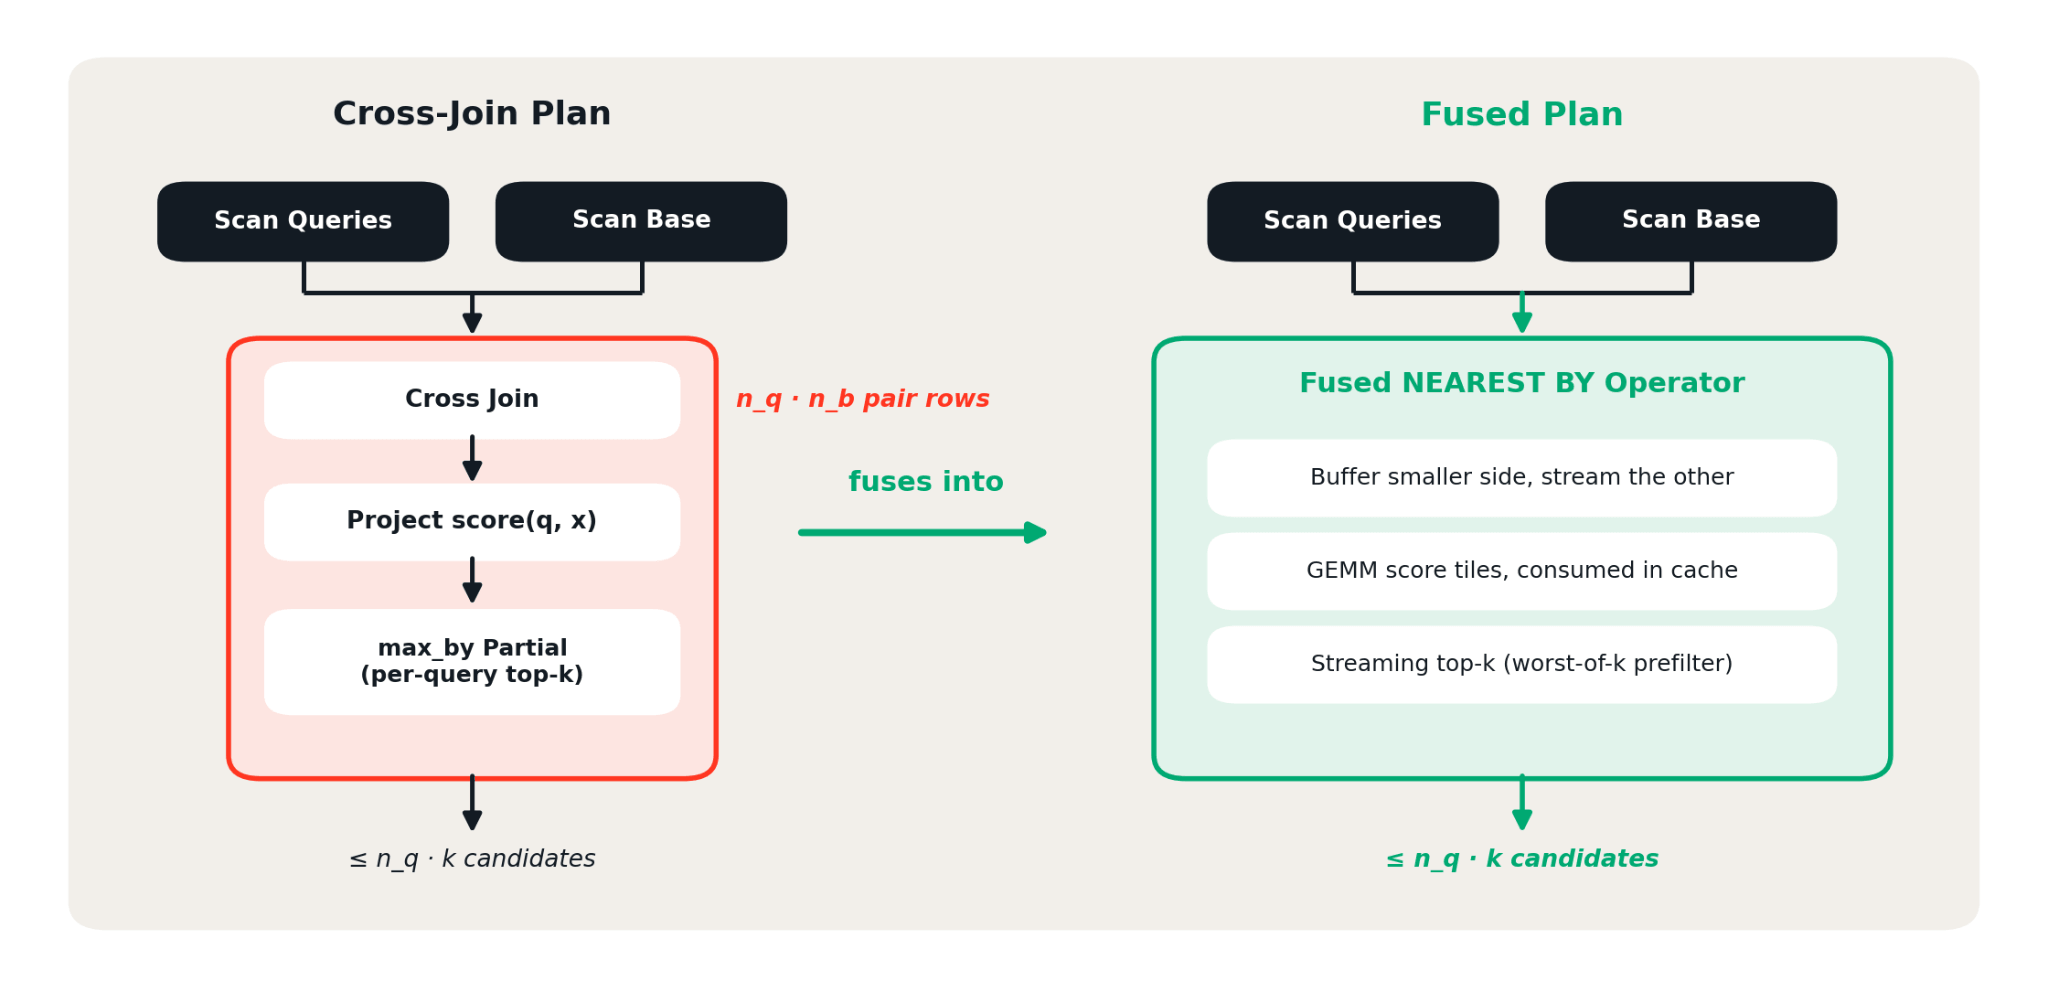
Como se muestra en el modelo roofline, la fusión cambia los bytes que movemos en la memoria, no las FLOPs que realizamos. Cada vector base se evalúa con respecto a todas las consultas almacenadas en búfer una vez cargado, por lo que la intensidad aritmética crece linealmente con el lote y cruza el punto de cresta (ridge point) de referencia en 𝑛𝑞 = 64, muy por debajo de los tamaños de lote de las cargas de trabajo de producción típicas. Lo mismo ocurre cuando el lado de la base es más pequeño: la intensidad aritmética se escala con el lado que permanezca residente.
Cruzar la cresta es necesario, pero no suficiente. El recuento de bytes de 𝑛𝑞/2 es el resultado directo del kernel GEMM bloqueado que se muestra a continuación. Superar el límite de DRAM solo desplaza el cuello de botella hacia abajo, a la velocidad de banda de la caché y luego a la latencia de FMA.
Concretamente, el kernel es un GEMM bloqueado clásico sobre la matriz de puntuación 𝐷 = 𝑄 · 𝐵𝑇. El bucle externo avanza sobre la base un panel de vectores a la vez y empaqueta cada panel priorizando la dimensión (dimension-major) para su reutilización en las teselas de consulta. Dado que la dimensión de incrustación (embedding) está bloqueada en paneles, el bucle intermedio barre cada tesela de consulta almacenada en búfer contra el panel empaquetado antes de recuperar el siguiente. El bucle más interno acumula una pequeña tesela de salida en registros a lo largo de un panel de dimensiones; para incrustaciones más anchas que un solo panel, los parciales en ejecución se almacenan en el búfer de puntuación y se vuelven a leer para continuar con el siguiente panel. Cada tesela terminada se escribe en un búfer de puntuación reciclado y acotado que el top-k de transmisión consume in situ, por lo que la matriz de puntuación completa de 𝑛𝑞 × 𝑛𝑏 nunca se escribe en la DRAM.
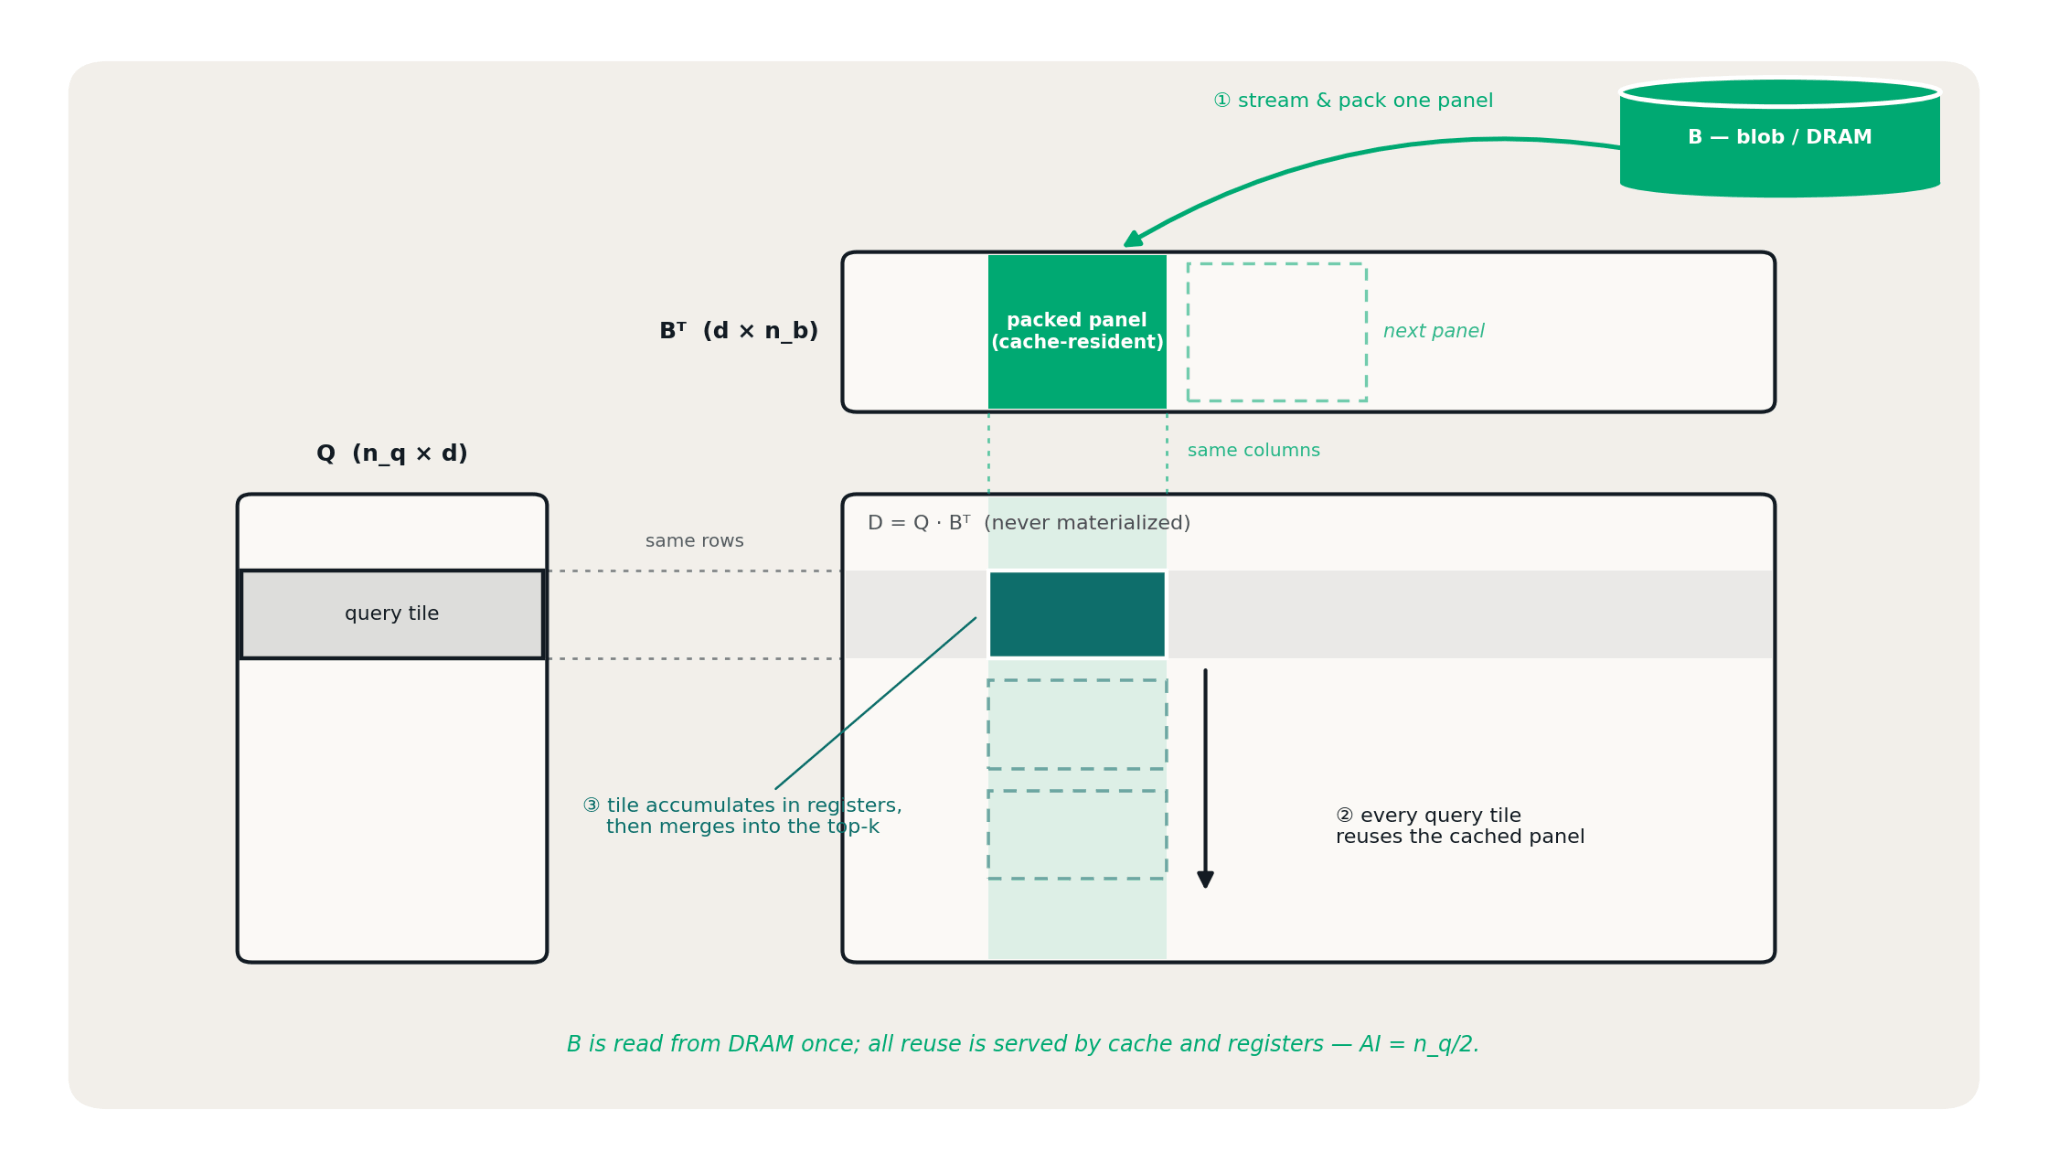
Hay dos niveles de bloqueo para mejorar la reutilización de datos. Los paneles base empaquetados se reutilizan en las teselas de consulta para fomentar los aciertos de caché de la CPU, mientras que el bloqueo de registros permite que cada valor cargado contribuya a múltiples FMA. Cada tamaño de tesela equilibra dos consideraciones contrapuestas:
- Tamaño del panel empaquetado: el panel debe ser lo suficientemente pequeño como para caber cómodamente en la caché, pero lo suficientemente grande como para limitar la sobrecarga de guardar y volver a cargar los resultados parciales. Cada límite a lo largo de la dimensión de incrustación requiere un viaje de ida y vuelta a través del búfer de puntuación. Los paneles más grandes reducen ese tráfico, pero pueden aumentar los fallos de caché.
- Tamaño de la tesela de registro: los acumuladores y operandos deben caber dentro de los registros vectoriales disponibles, al tiempo que proporcionan suficientes acumulaciones independientes para solapar la latencia de FMA. Las teselas más grandes aumentan la reutilización de datos y exponen más trabajo independiente, pero también aumentan la presión de los registros y el riesgo de desbordamiento a la memoria (spilling).
La mayoría de las cargas de trabajo de producción se ejecutan con una k relativamente pequeña, por lo que optimizamos el top-k de transmisión para ese caso. El estado de selección por consulta permanece dentro del operador fusionado, cada tesela de puntuación se fusiona en las selecciones mientras aún está en la caché, y la matriz completa de 𝑛𝑞 × 𝑛𝑏 nunca llega a la DRAM. Una vez que una consulta contiene k entradas, su peor puntuación se convierte en el umbral de admisión, lo que permite que la fusión rechace múltiples puntuaciones por comparación vectorizada. Solo las filas supervivientes se recopilan para la salida. Cuando k es lo suficientemente grande como para que este estado genere presión de memoria, el operador ejecuta solo el GEMM bloqueado y entrega las teselas puntuadas al parcial max_by / min_by existente. Bajo esta alternativa (fallback), emitir una puntuación 𝑓𝑝32 por par cuesta 4 𝑏𝑦𝑡𝑒𝑠 frente a 2𝑑 𝐹𝐿𝑂𝑃𝑠, por lo que 𝐴𝐼 = 𝑑/2, lo que sigue estando muy por encima de la cresta para cualquier dimensión realista.
El índice de vectores
Todo lo visto hasta ahora acelera la búsqueda exhaustiva KNN (k-nearest-neighbor); nada de esto cambia el hecho de que la búsqueda exhaustiva es 0(𝑛𝑞 × 𝑛𝑏): un millón de consultas contra mil millones de filas equivale a 1015 productos escalares, y ninguna tesela de registro amortiza un exponente. Para eso sirven APPROX y el índice de vectores.
El índice es un diseño clásico de IVF (archivo invertido). La indexación entrena k-means sobre una muestra del corpus para producir un conjunto de centroides. Cada fila base se asigna a su centroide más cercano y, en el momento de la consulta, cada consulta evalúa solo los vectores de sus clústeres más cercanos. La poda se compone con 𝑛𝑏: a escala de miles de millones, una consulta analiza ≤ 0.1% del corpus, lo que representa órdenes de magnitud menos trabajo de distancia que la fuerza bruta. Elegimos IVF en lugar de índices de grafos porque los escaneos de clústeres independientes se paralelizan entre los ejecutores y el diseño se encuentra de forma natural en el almacenamiento en columnas, mientras que el recorrido de grafos es una cadena de búsquedas secuenciales.
Físicamente, el índice es una tabla Delta ordinaria. Las filas de asignación llevan el vector junto a su id de centroide, y la tabla está agrupada mediante liquid clustering por id de centroide. Los candidatos de cada clúster se encuentran contiguos en el almacenamiento de blobs, y los archivos cuyos clústeres no tienen ninguna consulta analizada se podan antes de leerse. La actualización es transaccional e incremental.
Una consulta APPROX se reescribe sobre las mismas primitivas: sondear los centroides con la misma combinación top-k NEAREST BY, equi-join por id de centroide para restringir cada consulta a sus clústeres sondeados, puntuar y top-k, y luego fusionar. Los archivos agregados desde la última actualización se procesan por fuerza bruta en una rama de compensación y se unen en la misma fusión, por lo que un índice desactualizado poda menos, pero nunca degrada la calidad de la búsqueda.
La ejecución de consultas está determinada por las cardinalidades de la consulta y de la base.
| Escenario | Estrategia de combinación | Características clave |
|---|---|---|
| Tabla de índice pequeña, tabla de consulta pequeña | BNLJ, transmisión del índice | Todo en memoria |
| Tabla de índice pequeña, tabla de consulta grande | BNLJ, transmisión del índice | Las consultas permanecen particionadas y se transmiten, se transmite el índice a todas |
| Tabla de índice grande, tabla de consulta pequeña | BNLJ, transmisión de consultas | Las particiones del índice se transmiten, se transmiten las consultas sondeadas |
| Tabla de índice grande, tabla de consulta grande | Equi-join por ID de centroide, con barajado (shuffle) in situ para el índice | Barajar las consultas sondeadas por ID de centroide; aprovechar el liquid clustering del índice para evitar un barajado completo del índice |
El caso grande-grande es donde el liquid clustering ofrece el mayor rendimiento: solo se mueve el lado de la consulta; cada consulta sondeada se baraja a las particiones de sus clústeres, mientras que el lado del índice escanea directamente los archivos para buscar los ID de centroide coincidentes. Cada partición sondea exactamente los candidatos de sus propios clústeres.
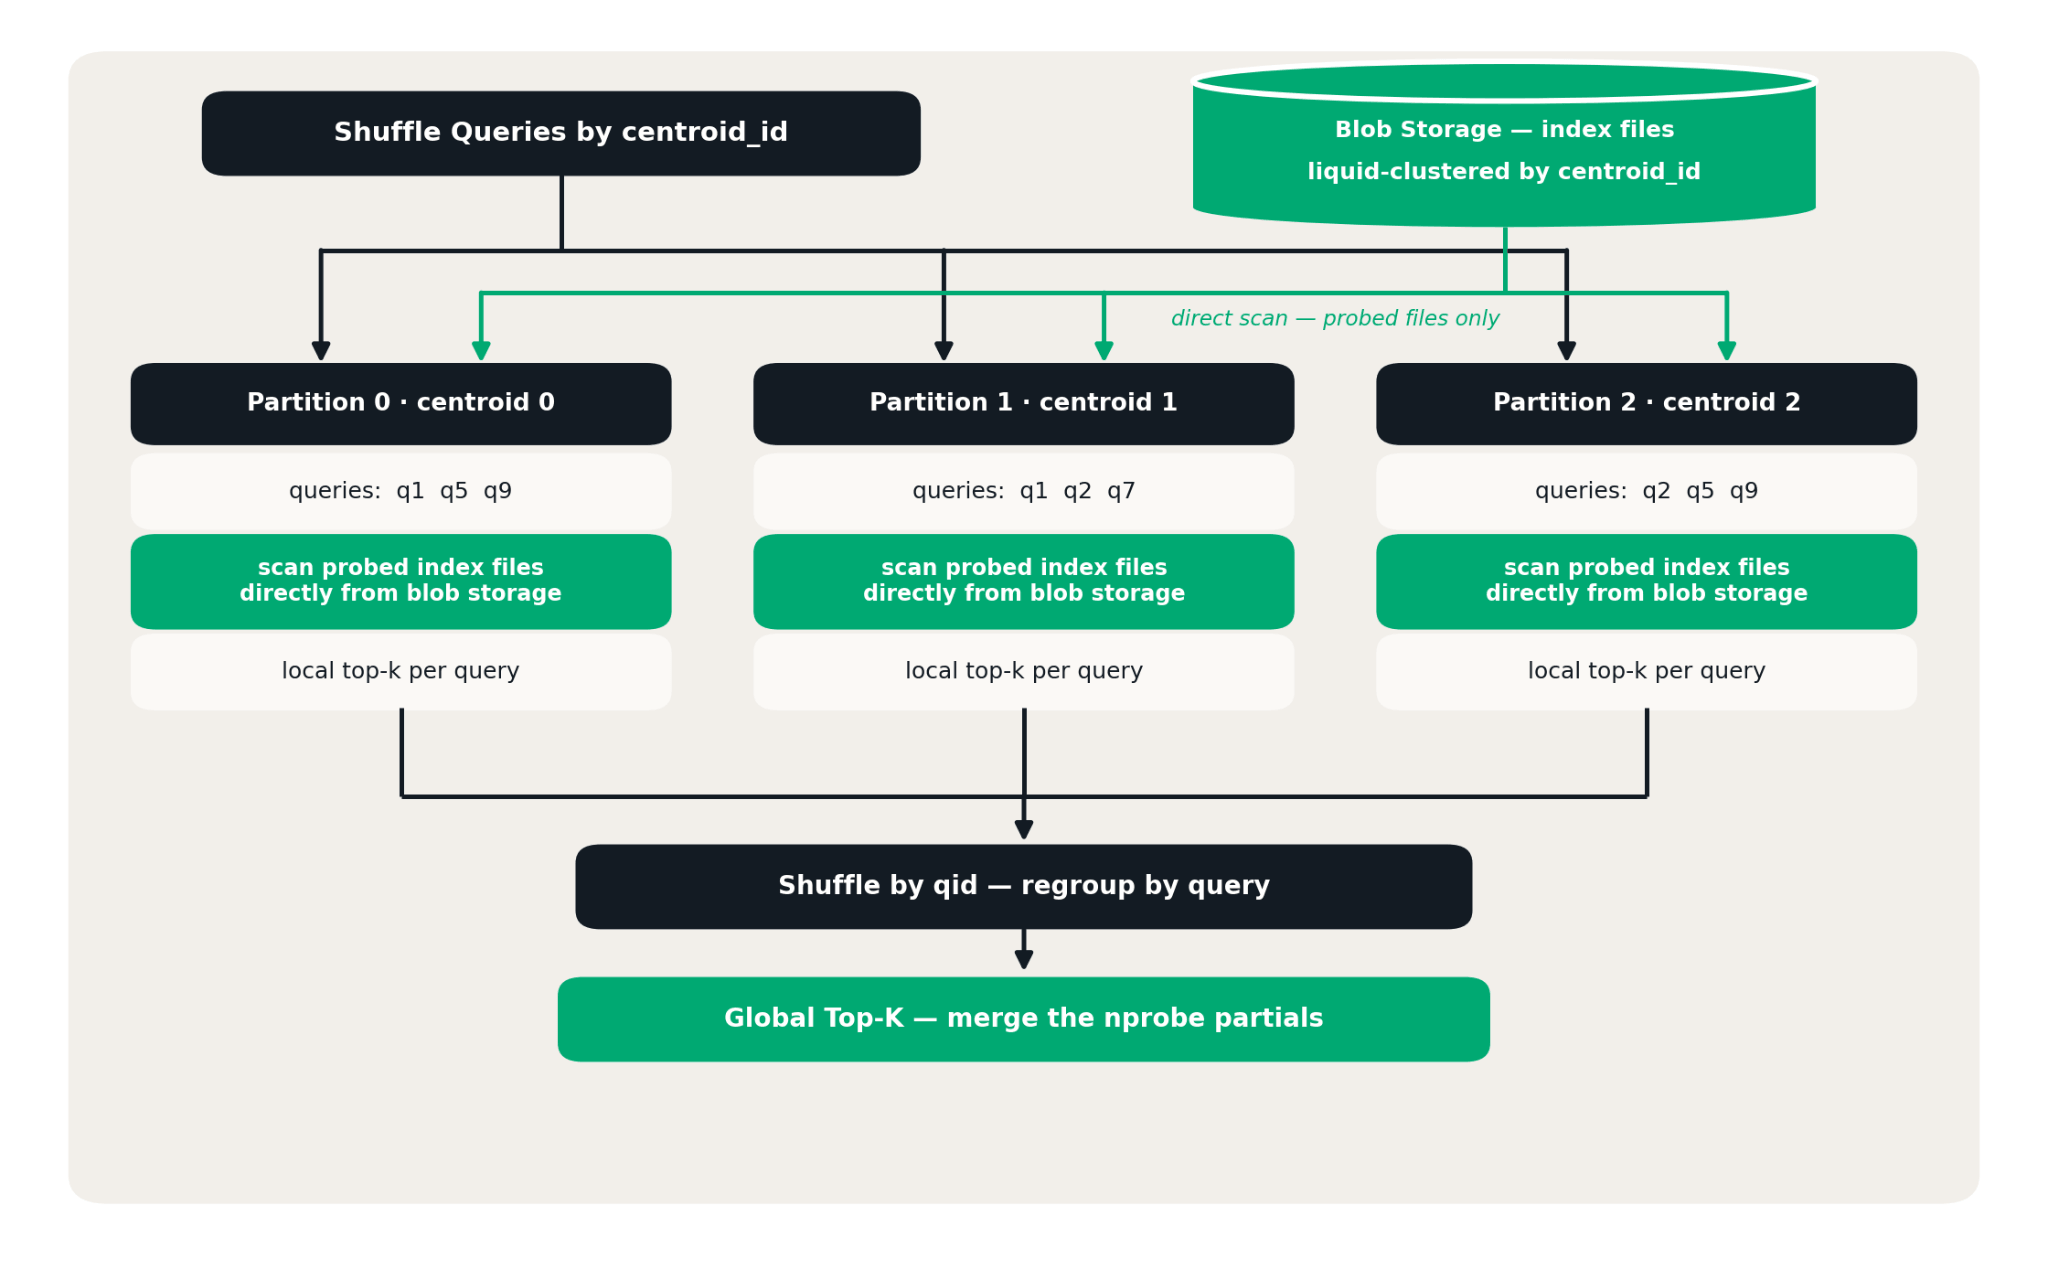
Dentro de una partición, los candidatos de cada clúster llegan como un bloque contiguo denso, por lo que se aplica el mismo kernel GEMM. La ruta exacta lo ejecuta una vez de forma global; la ruta aproximada lo ejecuta una vez por clúster. Top-k local por consulta, reagrupar, fusionar los parciales: el contrato de parcial/fusión del agregado hace exactamente aquello para lo que fue diseñado.
El resultado
Evaluamos NEAREST BY en cargas de trabajo canónicas observadas de clientes, con tablas base que van desde 100.000 hasta 5.000 millones de vectores y lotes de consultas de hasta 10 millones de vectores, con el objetivo de alcanzar al menos un 96% de recall@K. Usando ANN indexado:
- Deduplicación semántica: una autocombinación de una tabla de 10 millones de registros se completó en minutos, recuperando coincidencias candidatas para la detección de duplicados.
- Clasificación y etiquetado: la búsqueda de 10 millones de consultas frente a 100.000 vectores de referencia tardó menos de un minuto, lo que permite la clasificación a través de ejemplos etiquetados similares.
- Actualizaciones de recomendaciones: un lote de 1 millón de consultas contra 10 millones de vectores de catálogo generó candidatos de recomendación en minutos.
- Resolución y enriquecimiento de entidades: la búsqueda de 1 millón de consultas contra 1.000 millones de vectores de referencia se completó en minutos, proporcionando coincidencias candidatas para vincular registros y recuperar contexto adicional.
Conclusión
La búsqueda de vectores por lotes no necesitaba un nuevo sistema; necesitaba convertirse en un ciudadano de primera clase del que ya contiene los datos. NEAREST BY expresa la carga de trabajo como lo que es estructuralmente: un join de clasificación top-k. El modelo roofline explica por qué el plan básico está limitado por la memoria y qué debe hacer al respecto cualquier kernel más rápido. El operador fusionado y su GEMM bloqueado convierten ese análisis en intensidad aritmética, y el índice de vectores lo escala aún más mientras sigue siendo una tabla Delta con clustering líquido común. Los nuevos mecanismos están diseñados deliberadamente para ser sencillos, acotados, pero profundos y eficaces: una cláusula de join, siete funciones vectoriales, una sobrecarga de agregación, un operador fusionado y una decisión de diseño de almacenamiento. Todo lo demás, desde las operaciones de shuffle y spill hasta la gobernanza y el escalado automático, ya venía con el motor de ejecución, desarrollado y perfeccionado durante más de una década.
Si te interesa desarrollar sistemas informáticos complejos para cargas de trabajo de IA/ML a gran escala en Databricks, ven a construir con nosotros!
Descargar ahora Prueba NEAREST BY: lee la documentación
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.