PostgreSQL 19 ya está disponible en Lakebase
Prueba las nuevas funciones: REPACK, recomendaciones de planes de consulta, WAIT FOR LSN y más
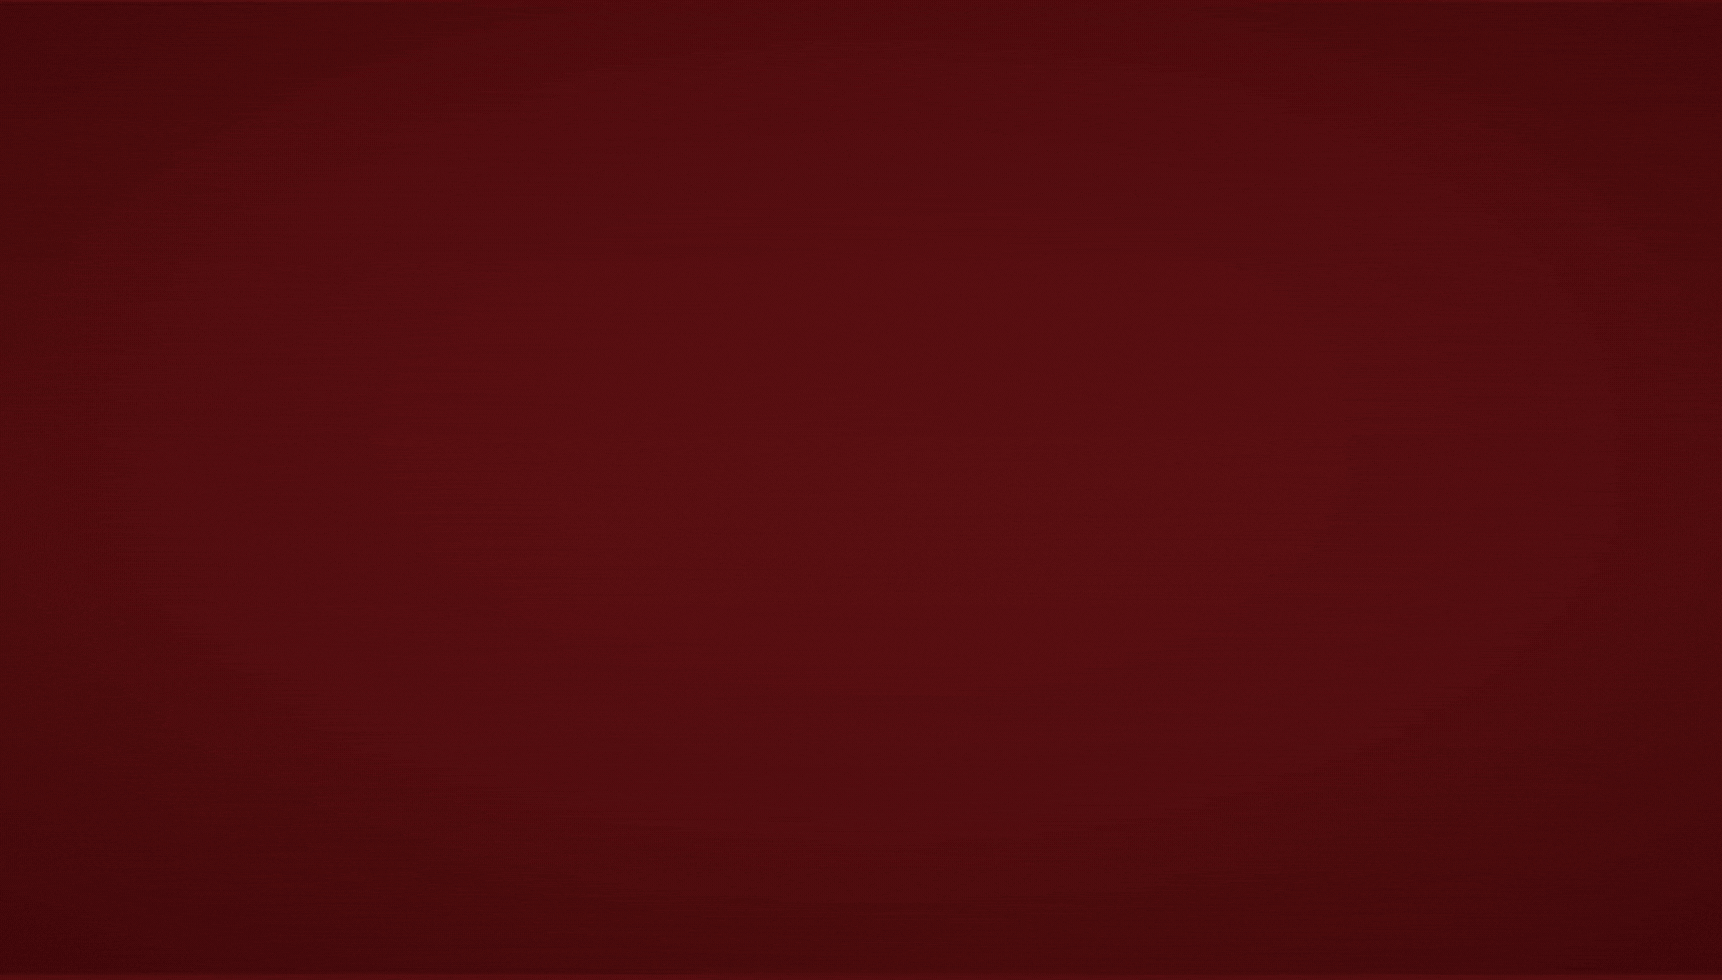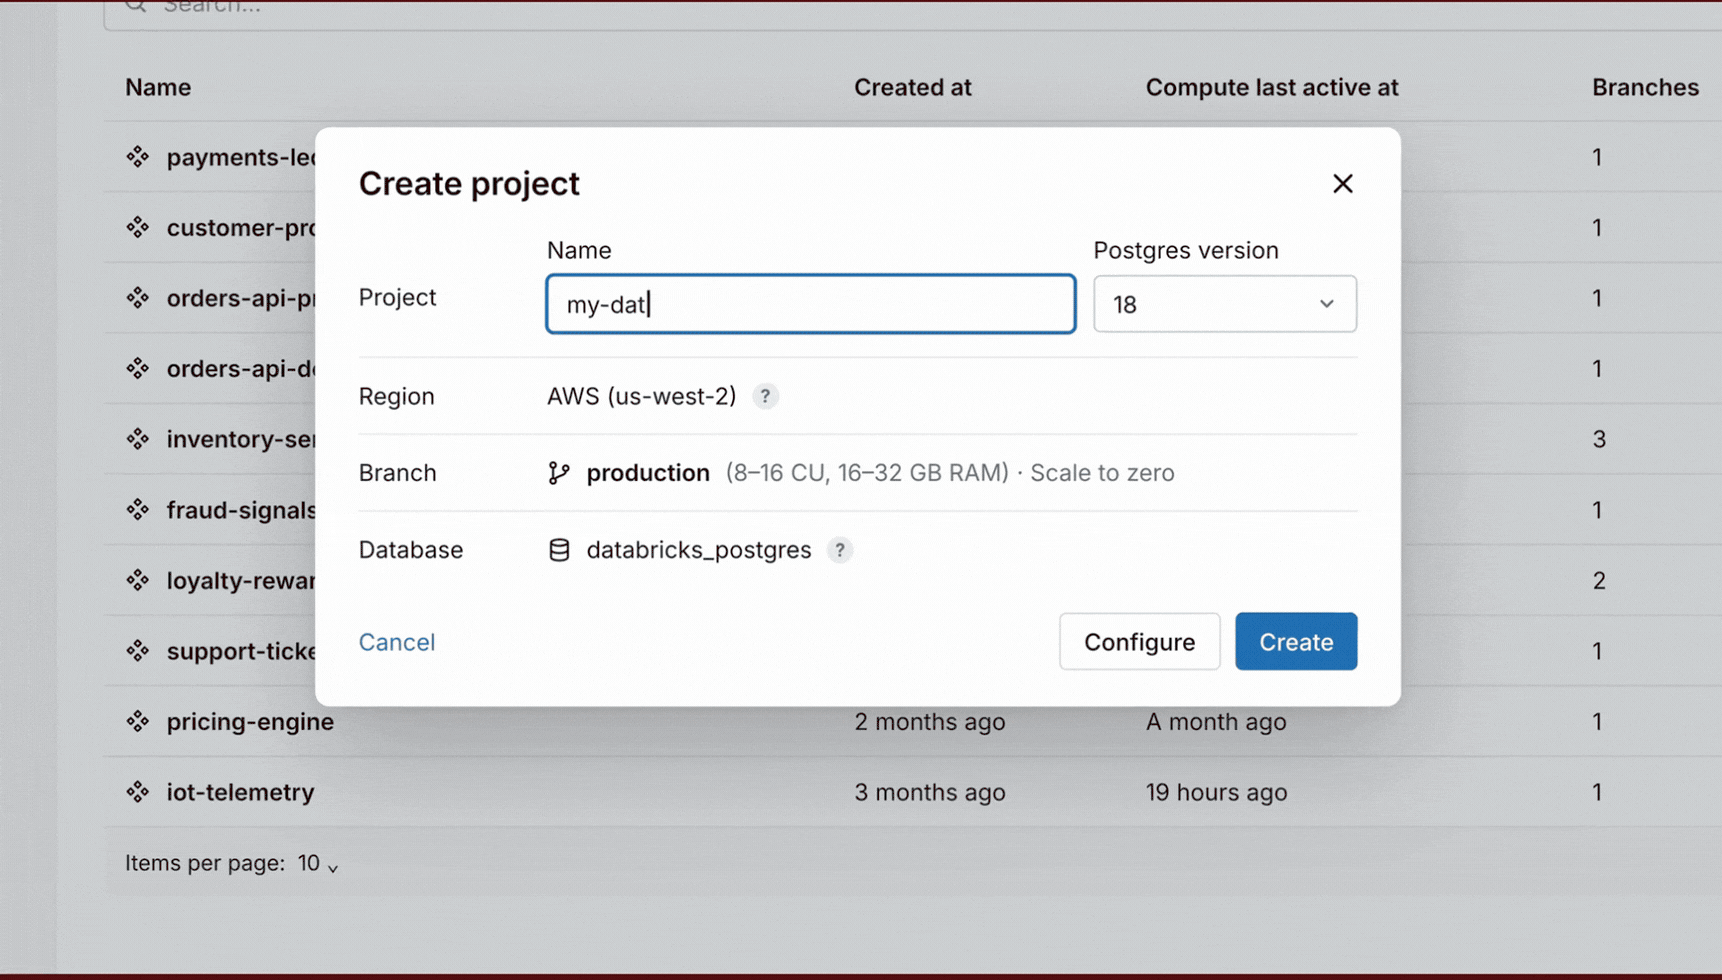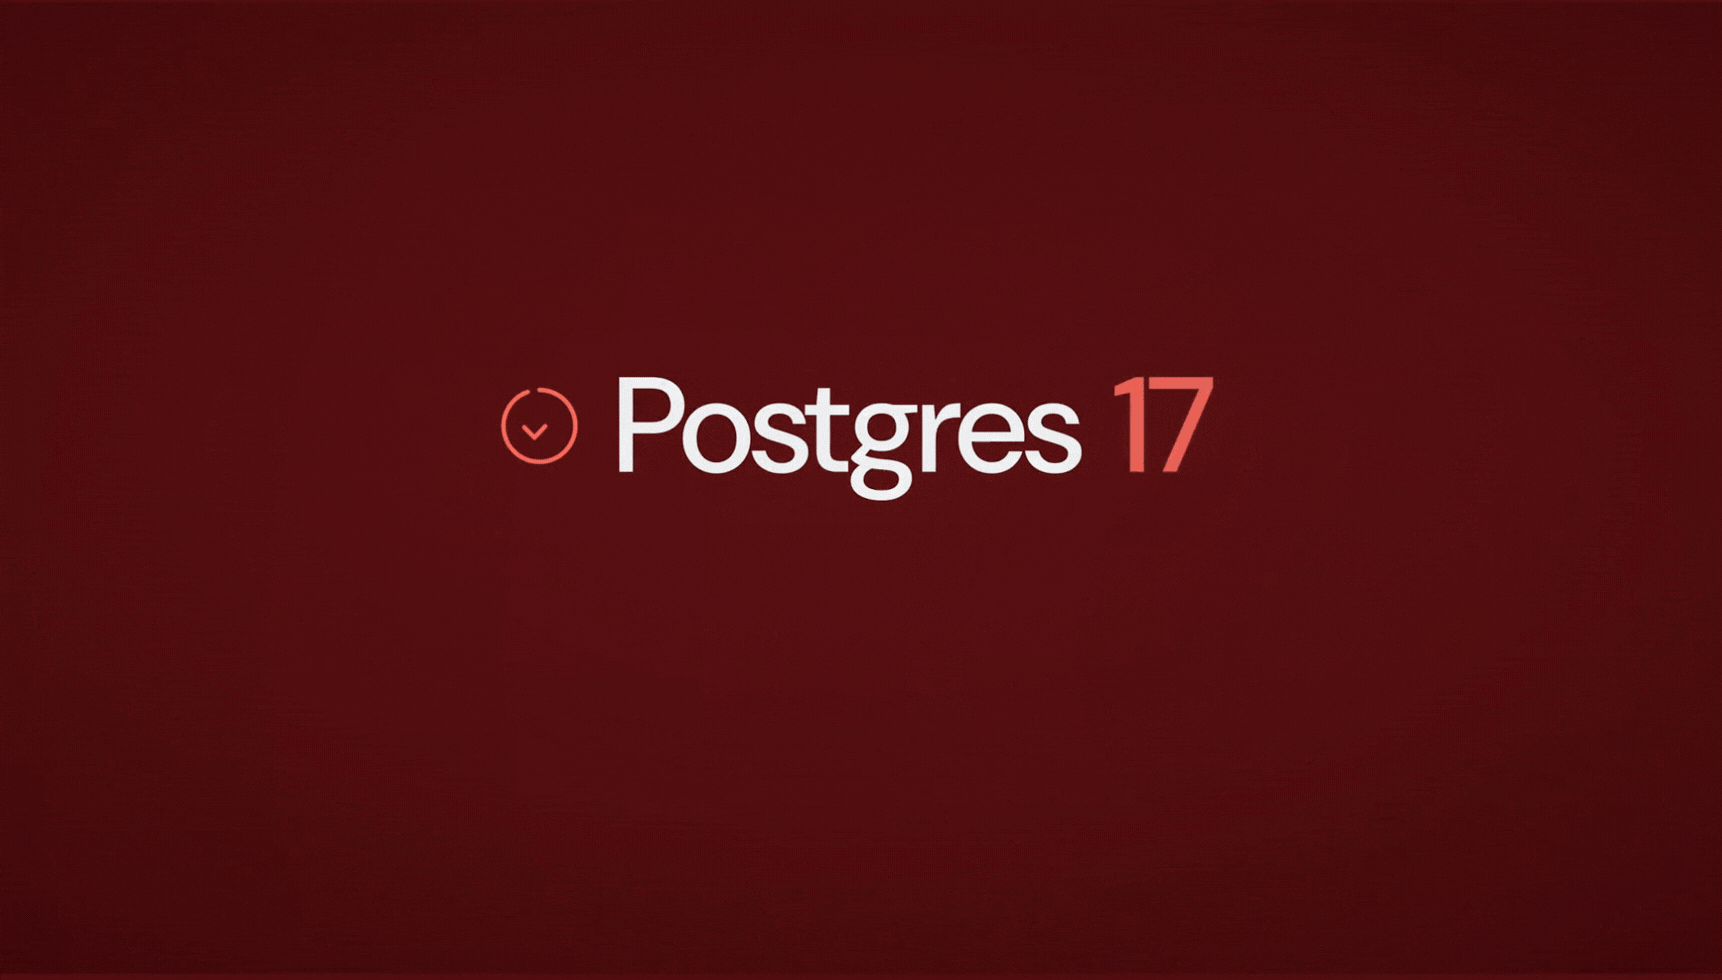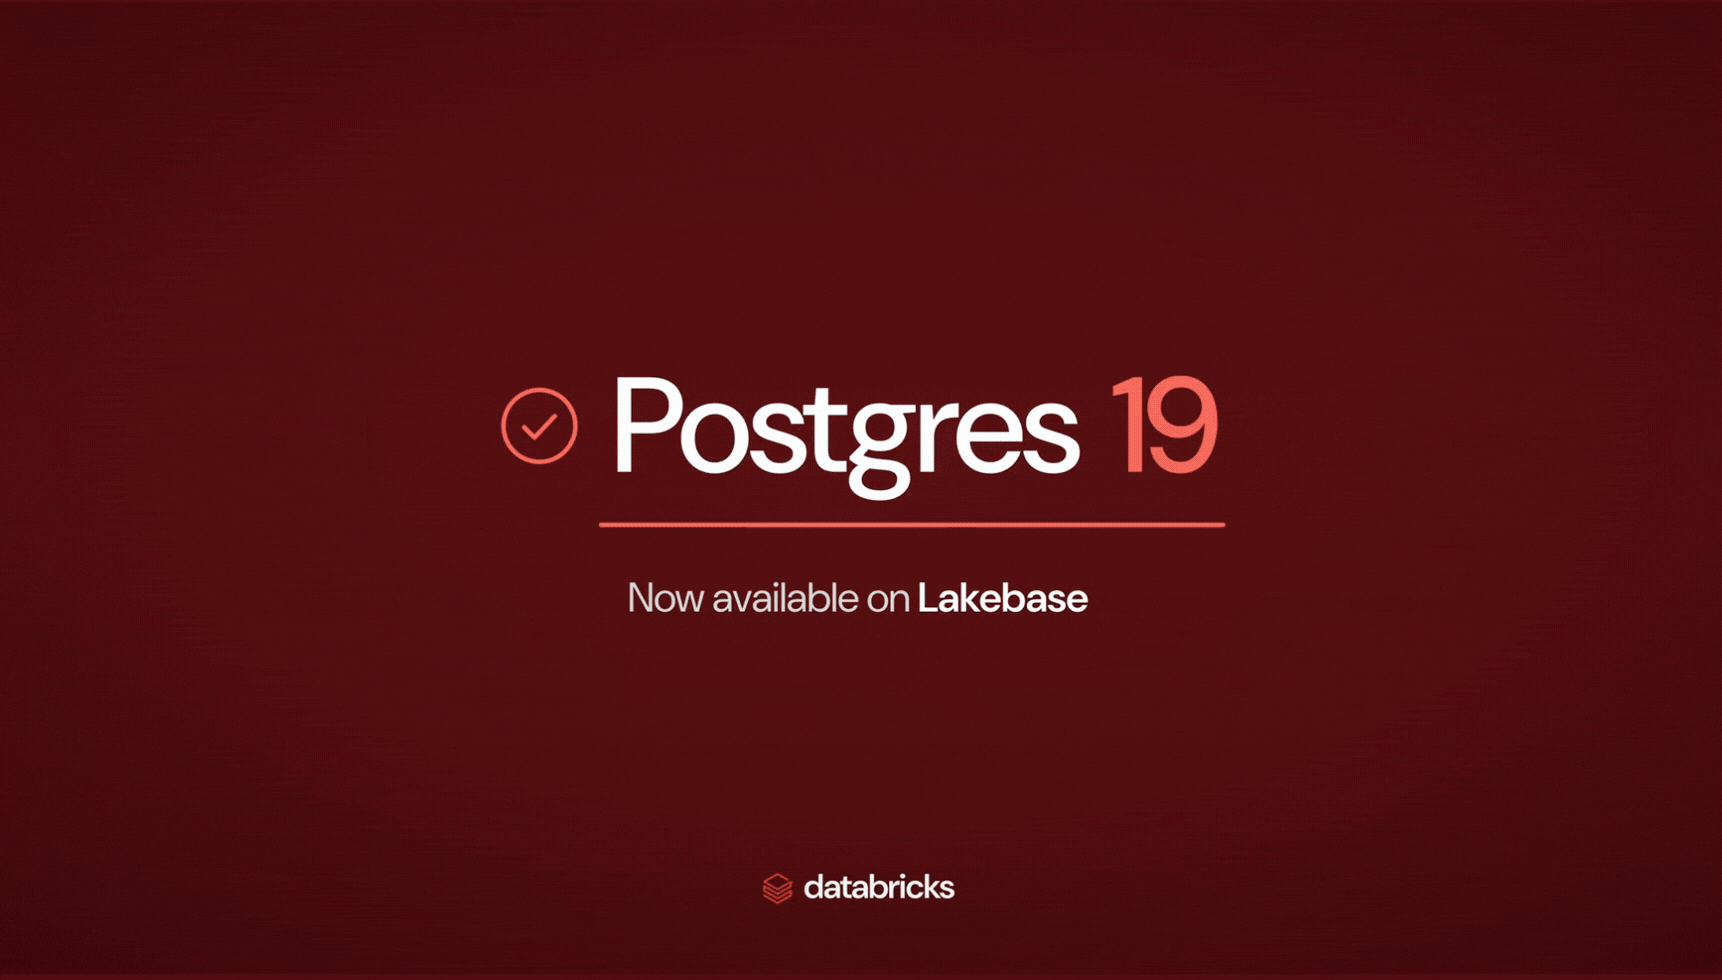
- PostgreSQL 19 está disponible en Lakebase el mismo día de su lanzamiento por parte de la comunidad. Para probarlo, crea un nuevo proyecto de Lakebase y selecciona PostgreSQL 19.
- Esta versión de PostgreSQL se centra en el control operativo. REPACK recupera espacio mientras continúan las lecturas y escrituras, las recomendaciones de planes de consulta te permiten estabilizar planes que fallan, y WAIT FOR LSN te ofrece lectura de tus propias escrituras en las réplicas. La replicación lógica también recibe varias mejoras.
- Varios ingenieros de Lakebase son colaboradores y contribuidores de PostgreSQL que trabajaron en esta versión, desde las recomendaciones de planes de consulta hasta la memoria compartida y la gestión de versiones.
PostgreSQL 19 ya está disponible oficialmente (GA) y se puede usar en Lakebase. A menudo, las nuevas versiones principales tardan semanas en llegar a otros servicios administrados de PostgreSQL. En su lugar, quisimos dar acceso a nuestros clientes el mismo día.
Varios ingenieros del equipo de Lakebase son committers y colaboradores de PostgreSQL, y trabajaron directamente en esta versión, desde la asesoría en el plan de consultas hasta la memoria compartida, el manejo de la configuración regional y la gestión de versiones. Para probarlo, crea un nuevo proyecto de Lakebase y selecciona PostgreSQL 19 como la versión.
Qué hay de nuevo en PostgreSQL 19
PostgreSQL 19 es una versión práctica. No hay una única característica principal que cambie la esencia de PostgreSQL. En su lugar, la versión 19 aborda problemas operacionales que los equipos de bases de datos conocen muy bien: tablas con sobrecarga, planes de consulta inestables, retraso en las réplicas, estadísticas incompletas y tareas de mantenimiento que son difíciles de ejecutar de forma segura en producción.
El hilo conductor es el control. PostgreSQL 19 te ofrece más formas de intervenir cuando los valores predeterminados no son suficientes, sin renunciar a la tendencia del proyecto hacia la fiabilidad y el comportamiento predecible.
La lista completa de cambios se encuentra en las notas de la versión de PostgreSQL 19.
REPACK
PostgreSQL utiliza el control de concurrencia multiversión, por lo que una UPDATE crea una nueva versión de fila y una DELETE deja una tupla inactiva atrás. La limpieza rutinaria hace que ese espacio se pueda reutilizar, pero no necesariamente devuelve el espacio al sistema operativo ni restaura un orden físico útil de las filas. Con el tiempo, las tablas con muchas actualizaciones pueden volverse pesadas y estar mal agrupadas.
Las soluciones habituales han sido VACUUM FULL, CLUSTER, o herramientas externas como pg_repack. Los comandos integrados funcionan, pero toman un bloqueo ACCESS EXCLUSIVE para toda la operación, bloqueando el acceso normal a la tabla.
PostgreSQL 19 añade REPACK, que recupera espacio mientras continúan las lecturas y escrituras normales durante la mayor parte de la operación. Por ejemplo, una aplicación de chat puede reconstruir su tabla de messages mientras agrupa las filas por conversación y hora de envío utilizando un índice existente:
REPACK recupera espacio como VACUUM FULL; con USING INDEX, también ordena físicamente las filas como CLUSTER. Con CONCURRENTLY, PostgreSQL reconstruye la tabla mientras continúan las lecturas y escrituras normales, capturando los cambios en curso mediante la decodificación lógica. Luego toma un bloqueo ACCESS EXCLUSIVE para aplicar los cambios capturados restantes e intercambiar los archivos nuevos de la tabla y del índice. Esta fase suele ser breve, pero puede tardar más en una tabla ocupada.
Existen limitaciones operativas. La reestructuración concurrente crea una ranura de replicación adicional mientras dura la operación, por lo que necesita capacidad libre en max_repack_replication_slots y una tabla con una clave principal no deferible o una identidad de réplica basada en índices adecuada. También necesita espacio temporal en disco para una copia de la tabla y todos sus índices, posiblemente además de un archivo de ordenamiento del tamaño de la tabla. Las tablas con gran tráfico de actualizaciones y eliminaciones se enfrentan a un límite adicional: la implementación actual de la versión preliminar de PostgreSQL 19 falla si se actualizan o eliminan más de unos 104 millones de tuplas en la tabla de destino mientras se ejecuta REPACK (CONCURRENTLY). Esto cuenta los cambios realizados durante la reestructuración, no las filas que ya están en la tabla.
No todos los tipos de relaciones son aptos. Las transacciones de larga duración pueden retrasar el bloqueo final. La reestructuración concurrente tampoco es segura para el control de versiones multiversión (MVCC): después de confirmarse, las transacciones que utilicen instantáneas tomadas antes de que comenzara la reestructuración pueden ver la tabla como vacía. El agrupamiento físico también se degrada a medida que llegan escrituras posteriores.
REPACK CONCURRENTLY aún necesita planificación, pero incorpora al núcleo una tarea que antes requería más tiempo de inactividad o una extensión.
Asesoría de planes de consulta
El optimizador basado en costos de PostgreSQL utiliza estadísticas de las tablas y estimaciones de costos para elegir un plan de ejecución. La mayor parte del tiempo, eso funciona bien.
Las estadísticas describen bien las tablas individuales, pero los conjuntos de datos reales suelen contener relaciones que son más difíciles de capturar. Imagina que los clientes empresariales representan el 0.1 % de los clientes, pero generan el 30 % de los pedidos. Las estadísticas por tabla no pueden capturar esa correlación entre tablas.
Con un índice en orders.customer_id,, el planificador puede estimar que cada cliente empresarial tiene solo unos pocos pedidos y elegir un bucle anidado que sonde repetidamente el índice. Si esos clientes realmente representan el 30 % de los pedidos, cada búsqueda devuelve muchas más filas de las esperadas, y una combinación hash puede ser más adecuada.
PostgreSQL 19 añade pg_plan_advice y pg_stash_advice para estas situaciones:
pg_plan_advicedescribe las decisiones del planificador como sugerencias, aplica las sugerencias proporcionadas e informa si se siguieron.pg_stash_advicealmacena sugerencias por ID de consulta y las aplica automáticamente cuando se planifica una consulta coincidente.
Estos componentes no añaden estadísticas entre tablas ni reemplazan al planificador. En su lugar, te permiten intervenir cuando una estimación imprecisa produce un plan deficiente.
Considera una consulta que cuenta los pedidos de clientes empresariales:
Aquí, c es el alias de la tabla de clientes filtrados. La siguiente sugerencia le pide a PostgreSQL que coloque a esos clientes en el lado interior de una combinación hash:
Cuando PostgreSQL puede aplicar la sugerencia, EXPLAIN informa comentarios similares a:
matched significa que el plan resultante cumple con la sugerencia. No significa que el nuevo plan sea necesariamente mejor; aún debes evaluarlo con la carga de trabajo real.
A diferencia de las pistas del optimizador en línea, la asesoría de planes se encuentra fuera del texto de la consulta de la aplicación. Puedes inspeccionar el plan actual, probar sugerencias específicas y luego guardarlas por ID de consulta.
pg_stash_advice es el componente que aplica automáticamente la asesoría guardada. Crea la extensión en cada base de datos antes de utilizar sus funciones de gestión de almacenamiento:
Crea un almacenamiento y asocia la asesoría probada con el ID de consulta informado por EXPLAIN (VERBOSE). Reemplaza <query_id> con el identificador de tu plan:
Configura la base de datos para utilizar el almacenamiento en las nuevas conexiones:
Reemplaza appdb con el nombre de tu base de datos.
Trata la asesoría de planes como un estabilizador una vez que hayas diagnosticado el problema. Las distribuciones de datos cambian, las declaraciones preparadas en caché pueden seguir usando un plan anterior durante un tiempo, y el optimizador sigue acertando más veces de las que se equivoca.
Cuando el optimizador cambia inesperadamente una consulta crítica a un plan peor, PostgreSQL 19 te ofrece una forma compatible para estabilizarla.
Autovacuum en paralelo y nuevas vistas de estadísticas
Autovacuum ahora puede usar procesos en paralelo al limpiar índices, controlado por autovacuum_max_parallel_workers. Un nuevo sistema de puntuación prioriza las tablas aptas según la urgencia con la que necesitan limpieza o análisis.
Las nuevas vistas de estadísticas muestran más información sobre lo que hace el servidor:
pg_stat_lockinforma estadísticas por tipo de bloqueo.pg_stat_recoverymuestra el estado de recuperación.pg_stat_autovacuum_scoresmuestra cómo autovacuum prioriza las tablas.
Los diagnósticos a nivel de consulta también mejoran. EXPLAIN (ANALYZE, IO) informa sobre la actividad de E/S asíncrona, y auto_explain.log_io puede incluir la misma información en los planes registrados.
PostgreSQL 19 también informa los bytes escritos para imágenes de página completa en pg_stat_wal, EXPLAIN (ANALYZE, WAL), y en los registros de limpieza y análisis.
En conjunto, esto hace que las investigaciones de rendimiento dependan menos de la inferencia. Puedes ver por qué se priorizó el trabajo de mantenimiento, dónde ocurrió la E/S asíncrona y cuántos bytes de WAL provinieron de imágenes de página completa.
Replicación lógica
La replicación lógica se ha convertido en infraestructura clave para la captura de datos modificados, migraciones, servicio en tiempo real y pipelines de ETL. PostgreSQL 19 cierra varias brechas de larga data:
- La decodificación lógica se puede activar sin reiniciar cuando
wal_levelesreplica. Crear el primer espacio de replicación lógica válido elevaeffective_wal_levelalogical, mostrando el nivel de WAL vigente actualmente. - Los valores de secuencia se pueden sincronizar desde los publicadores hacia los suscriptores.
- Las publicaciones pueden incluir todas las secuencias con
FOR ALL SEQUENCES. CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...)publica todas las tablas excepto un conjunto nombrado.- Las suscripciones pueden reutilizar los detalles de conexión de un servidor
postgres_fdwconCREATE SUBSCRIPTION ... SERVER. - La opción de suscripción
retain_dead_tuplesconserva suficiente información paradetect update_deletedconflictos, donde una actualización replicada apunta a una fila eliminada por otro origen. La detección también requieretrack_commit_timestampen el suscriptor, ypg_stat_subscription_statscuenta estos conflictos.
La sincronización de secuencias elimina un caso límite de migración incómodo, especialmente durante las actualizaciones de versión principal que usan replicación lógica. Copiar filas de tablas sin avanzar sus secuencias puede hacer que un suscriptor promovido genere valores que ya existen, provocando errores de clave duplicada.
PostgreSQL copia los valores de secuencia iniciales cuando la suscripción se crea con copy_data = true, que es el valor predeterminado. Los cambios de secuencia posteriores no se transmiten de forma continua, así que actualízalos inmediatamente antes del cambio de sistema:
Esto actualiza las secuencias que ya conoce la suscripción a sus valores actuales en el publicador. Si la publicación ha ganado nuevas secuencias, usa ALTER SUBSCRIPTION ... REFRESH PUBLICATION para agregarlas y sincronizar sus valores antes del cambio de sistema.
WAIT FOR LSN
Las réplicas de lectura asíncronas añaden capacidad de lectura sin hacer que las confirmaciones principales esperen por ellas. El compromiso es el retraso de replicación. Una aplicación puede confirmar una escritura en la base de datos principal, leer inmediatamente de una réplica y no encontrar la fila porque la réplica aún no ha reproducido el WAL correspondiente.
PostgreSQL 19 añade una forma directa de coordinar esa transferencia. Un LSN identifica una posición en el WAL de PostgreSQL, y WAIT FOR LSN bloquea la instancia de reserva hasta que la reproducción alcanza al menos la posición solicitada:
De forma predeterminada, WAIT FOR LSN espera indefinidamente a que la instancia de reserva reproduzca el LSN solicitado. Otros modos pueden esperar a que el WAL se escriba o se vuelque en el disco, y puedes configurar un tiempo de espera límite.
El cliente o administrador de conexiones todavía tiene que llevar el LSN desde la base de datos principal hasta la réplica. Ahora la base de datos proporciona el paso de sincronización faltante, por lo que el comportamiento de leer tus propias escrituras ya no necesita sondeos ni pausas arbitrarias.
ON CONFLICT DO SELECT
INSERT ... ON CONFLICT DO SELECT te ofrece un patrón claro de obtención o creación que devuelve tanto las filas existentes como las recién insertadas:
Reemplaza la solución alternativa de DO UPDATE SET col = EXCLUDED.col, que realiza una actualización aunque ningún valor cambie. Eso crea una nueva versión de fila y deja una tupla muerta en cada conflicto.
Salida JSON para COPY TO
COPY TO ahora puede emitir JSON directamente. De forma predeterminada, escribe un objeto por línea, mientras que FORCE_ARRAY envuelve la salida en un solo arreglo JSON:
El nuevo formato JSON es solo para exportación, por lo que COPY FROM no lo acepta.
SQL más pequeño y cambios de rendimiento
Por último, algunos cambios compactos que mejoran la experiencia de uso:
- Las expresiones de ruta JSON adquieren métodos de cadena familiares como
btrim(),lower(),replace()ysplit_part(). - La familia
random(min, max)ahora es compatible condate,timestampytimestamptz, lo que ayuda con las pruebas y los conjuntos de datos sintéticos. - Cinco funciones de ventana aceptan
IGNORE NULLSyRESPECT NULLS. - Cuando
io_method = worker, los procesos de E/S se escalan automáticamente entreio_min_workersyio_max_workers. Las comprobaciones de claves ajenas son más rápidas, y el optimizador y el ejecutor reciben otra ronda de optimizaciones dirigidas.
También perdimos algunas características
Varias características importantes llegaron durante el desarrollo de PostgreSQL 19, pero se eliminaron antes del lanzamiento. Los revisores encontraron problemas de corrección o diseño que eran demasiado riesgosos de resolver tarde en el ciclo, por lo que la comunidad reservó las características para un lanzamiento posterior.
Algunas de las características que finalmente no se incluirán en la versión 19:
SQL/PGQconsultas de grafos de propiedades.CREATE PROPERTY GRAPHyGRAPH_TABLEincorporaron la coincidencia de patrones de grafos sobre tablas regulares en SQL. Revertido el 7 de septiembre de 2026.UPDATE and DELETE ... FOR PORTION OF.Actualizaciones y eliminaciones temporales que dividen filas para preservar el historial fuera del rango de tiempo objetivo. Revertido el 15 de septiembre de 2026.ALTER TABLE ... MERGE PARTITIONSySPLIT PARTITION. Comandos integrados para combinar o dividir particiones. Revertido el 27 de agosto de 2026.GROUP BY ALL. Abreviatura para agrupar por cada expresión que no sea de agregación en la lista de selección. Revertido el 17 de julio de 2026.- Formatos de salida que no son de texto para
pg_dumpall. Revertido el 18 de junio de 2026. - Funciones de extracción de DDL.
pg_get_role_ddl(),pg_get_tablespace_ddl()ypg_get_database_ddl()fueron Revertidas el 13 de septiembre de 2026.
Gracias a los colaboradores de PostgreSQL
PostgreSQL es posible gracias a sus colaboradores: gracias a los cientos de colaboradores de la comunidad mencionados en las notas de la versión. Un agradecimiento especial a los ingenieros del equipo de Lakebase que trabajaron en esta versión de PostgreSQL:
- Robert Haas escribió pg_plan_advice y pg_stash_advice (este último junto con Lukas Fittl)
- Heikki Linnakangas trabajó en un nuevo mecanismo para registrar memoria compartida, una reestructuración de cómo los subsistemas la asignan, correcciones de multixact y el nuevo valor predeterminado de 128 para max_locks_per_transaction
- Jeff Davis escribió el cambio que permite que CREATE SUBSCRIPTION reutilice los detalles de conexión de un servidor postgres_fdw, y realizó una gran cantidad de trabajo de configuración regional y manejo de caracteres
- Jonathan Katz trabajó en el comunicado de prensa de PostgreSQL 19 y se encargó de la coordinación de la versión
- Matthias van de Meent trabajó en múltiples confirmaciones (commits), incluido el cambio a las rutinas estáticas de métodos de acceso a índices
- Alexander Lakhin encontró y reportó múltiples errores
Actualización a PostgreSQL 19
Como ocurre con cualquier versión principal nueva de PostgreSQL, recomendamos un enfoque medido para adoptarla. Antes de migrar cargas de trabajo de producción a 19.0, sugerimos que:
- Pruebe primero sus propias cargas de trabajo, consultas y extensiones en PostgreSQL 19 en un entorno de desarrollo o pruebas (staging)
- Compare el rendimiento y el comportamiento con su versión actual, ya que las versiones principales pueden cambiar los planes de consulta y los valores predeterminados
- Verifique que las extensiones en las que confía estén disponibles en PostgreSQL 19 (consulte más abajo).
- Mantenga la producción en su versión actual hasta que se sienta cómodo con los resultados
PostgreSQL 19 también cambia varios valores predeterminados y comportamientos de compatibilidad. Verifique estos aspectos antes de actualizar:
- La compilación JIT está desactivada de forma predeterminada
- La compresión TOAST utiliza LZ4 de forma predeterminada en lugar de pglz
- La autenticación de contraseñas por MD5 emite advertencias de depreciación más fuertes
- Se elimina la compatibilidad con la autenticación RADIUS
- standard_conforming_strings siempre está activado
- pg_upgrade rechaza clústeres con índices btree_gist afectados en inet o cidr
- Los nombres de bases de datos, roles y espacios de tablas ya no pueden contener retornos de carro ni saltos de línea
Una nota sobre las extensiones
Hemos cubierto la mayoría de las extensiones compatibles en nuestra versión de PostgreSQL 18, pero no todas están disponibles todavía en PostgreSQL 19. Iremos agregando más a medida que los proveedores de extensiones las pongan a disposición. Si su carga de trabajo depende de una extensión específica, confirme que esté disponible en PostgreSQL 19 antes de planificar una migración.
Por lo general, la comunidad lanza su primera versión menor unos meses después de una versión principal, a medida que el uso en el mundo real revela correcciones y mejoras. Se espera PostgreSQL 19.1 para febrero, y muchos equipos planean sus actualizaciones de producción alrededor de ese lanzamiento. Este es un patrón común y sensato para cualquier versión .0, y también aplica en este caso.
Sea cual sea su cronograma, estamos aquí para ayudarle. Si desea conversar sobre la planificación de la actualización o las pruebas, comuníquese con su equipo de cuenta o con el soporte de Databricks.
Pruébelo
PostgreSQL 19 ya está disponible en Lakebase. Cree un proyecto de PostgreSQL 19 en su espacio de trabajo para probarlo, o comience a usar Lakebase si es nuevo en la plataforma.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.