RADAR: Detecta fallas grises con detección de anomalías
Cómo la detección de anomalías en tiempo real detecta interrupciones parciales y silenciosas en minutos, y cómo crear el mismo sistema en Databricks.
- Los fallos grises pasan desapercibidos en los dashboards en verde, lo que le cuesta clientes e ingresos de forma silenciosa antes de que alguien se dé cuenta.
- RADAR es un patrón de cuatro etapas agnóstico de métricas (métricas de confiabilidad, detección de anomalías, alertas y análisis de causa raíz) que Databricks ejecuta en sí mismo para detectar estos fallos en minutos, con más del 90% de precisión y un descubrimiento un 95% más rápido.
- Puede crear el mismo sistema en Databricks para cualquier métrica (facturación, conversión o rendimiento del modelo) utilizando componentes nativos y una estructura de agentes de AI.
Algunas de las interrupciones más dañinas son aquellas que tu monitoreo nunca detecta: una parte de tus clientes experimenta fallas de manera silenciosa mientras que cada verificación de estado sigue mostrándose normal. Estas "fallas grises" provocan la pérdida de usuarios e ingresos durante horas antes de que alguien conecte los puntos. Esta publicación trata sobre cómo detectarlas a tiempo mediante la detección de anomalías: cómo lo hacemos en Databricks con un sistema llamado RADAR y cómo puedes crear lo mismo para cualquier métrica que sea más importante para tu negocio. Está escrito para las personas responsables de la confiabilidad del servicio: SRE, ingenieros de plataformas y datos, personal de guardia y los líderes de ingeniería a quienes reportan.
Cuando todo está en verde pero nada está bien
Imagina un miércoles cualquiera. Tu trabajo es mantener la confiabilidad de un servicio de cara al cliente, y cada panel de control en tu pared está en verde: CPU saludable, latencia correcta, servidores activos, base de datos conectada. Según cada señal que observa tu equipo, el sistema parece perfecto.
No lo está.
- 9:30 — Un despliegue de rutina introduce un error sutil en tu flujo de pago.
- 9:35 — Uno de cada veinte clientes que paga con tarjeta de crédito falla silenciosamente. Después de un par de intentos, se rinden y se van.
- 12:40 — Llega el primer ticket de soporte. Parece simplemente otro número de tarjeta mal escrito, así que nadie le presta atención.
- 14:20 — Llegan dos tickets más sobre el mismo problema.
- 14:25 — Tu líder de soporte detecta el patrón y lo escala.
- 16:00 — Los ingenieros localizan el error y lanzan una solución.
Durante casi siete horas, tu monitoreo insistió en que todo estaba bien mientras los clientes se iban y los ingresos se perdían.
¿Qué es una falla gris?
Ese miércoles es un ejemplo de manual de una falla gris. En la superficie todo parece saludable; por debajo, una pieza específica ha dejado de funcionar silenciosamente, y afecta a los clientes sin llegar a activar ninguna alerta.
Dos cosas hacen que las fallas grises sean tan engañosas:
- Son parciales. No afecta a todos, solo a una parte, como un único tipo de tarjeta de crédito. No hay una caída del servidor que detectarías al instante, sino un punto intermedio confuso donde la mayoría de los usuarios están bien y un grupo falla todo el tiempo.
- Crecen. Lo que comienza con un puñado de clientes afectados se propaga. Si no se atiende, cada vez más personas se topan con la misma pared.
Piensa en ello como humo detrás de la pared. Desde fuera, la casa parece estar bien, pero por dentro el daño se está extendiendo; y cuanto más esperes, mayor será el radio de impacto. Los investigadores también tienen un nombre para el problema subyacente: el artículo de Microsoft Gray Failure: The Achilles’ Heel of Cloud-Scale Systems lo llama observabilidad diferencial: tus detectores de fallas no notan un problema incluso cuando tus usuarios claramente sí lo hacen.
Por qué esperar a los reportes de los clientes no funciona
La mayoría de los equipos manejan las fallas grises exactamente de la misma manera que ocurrió ese miércoles: esperan a que los clientes se lo digan. Los reportes de los clientes importan (son problemas reales de personas reales), pero tus clientes no deberían ser tu sistema de monitoreo. Depender únicamente de los reportes tiene tres problemas:
- Es manual. Alguien tiene que notar la misma queja en un montón de tickets. Eso es fácil de pasar por alto.
- Es tardío. Para cuando se queja la suficiente cantidad de personas como para que alguien conecte los puntos, ya han pasado horas o días.
- Es silencioso. La mayoría de los clientes afectados nunca abren un ticket. Simplemente se van.
La solución no es dejar de leer los tickets; sigue haciéndolo. Consiste en agregar una detección automática que se ejecute todo el tiempo y capte lo que las personas pasan por alto. Concretamente, quieres algo que se active en el momento en que muchos más clientes de lo habitual comiencen a experimentar el mismo problema al mismo tiempo.
| Solo reportes de clientes | Agregar detección automática |
|---|---|
| Manual: fácil de pasar por alto | Detecta lo que las personas pasan por alto |
| Tardío: se nota en días | Rápido: se nota en tiempo real |
| Los clientes sufren en silencio | Identifica el pico: muchos usuarios a la vez |
Presentamos RADAR
Esa es la idea detrás de RADAR (Reliability Anomaly Detection, Alerting, and Root-cause analysis). Lo creamos en Databricks para detectar fallas grises en minutos en lugar de horas. El nombre es muy adecuado: cuando la visibilidad es baja, no esperas a que algo te golpee, sino que buscas señales débiles de forma anticipada.
Así es como lo orientamos hacia una señal especialmente útil: los errores de usuario.
Una falla gris a menudo se manifiesta como un pico repentino de errores que parecen ser culpa del usuario. Imagina a un grupo de usuarios en una región que de repente no pueden iniciar un determinado tipo de clúster. Cada solicitud falla con INVALID_ARGUMENT, un error que dice cortésmente: "esto es problema tuyo".
Pero cuando muchos usuarios se topan con el mismo error de "tu culpa" al mismo tiempo, deja de ser su culpa. Es nuestra. Ese pico es exactamente el patrón que RADAR está diseñado para detectar.
Las cuatro etapas de RADAR
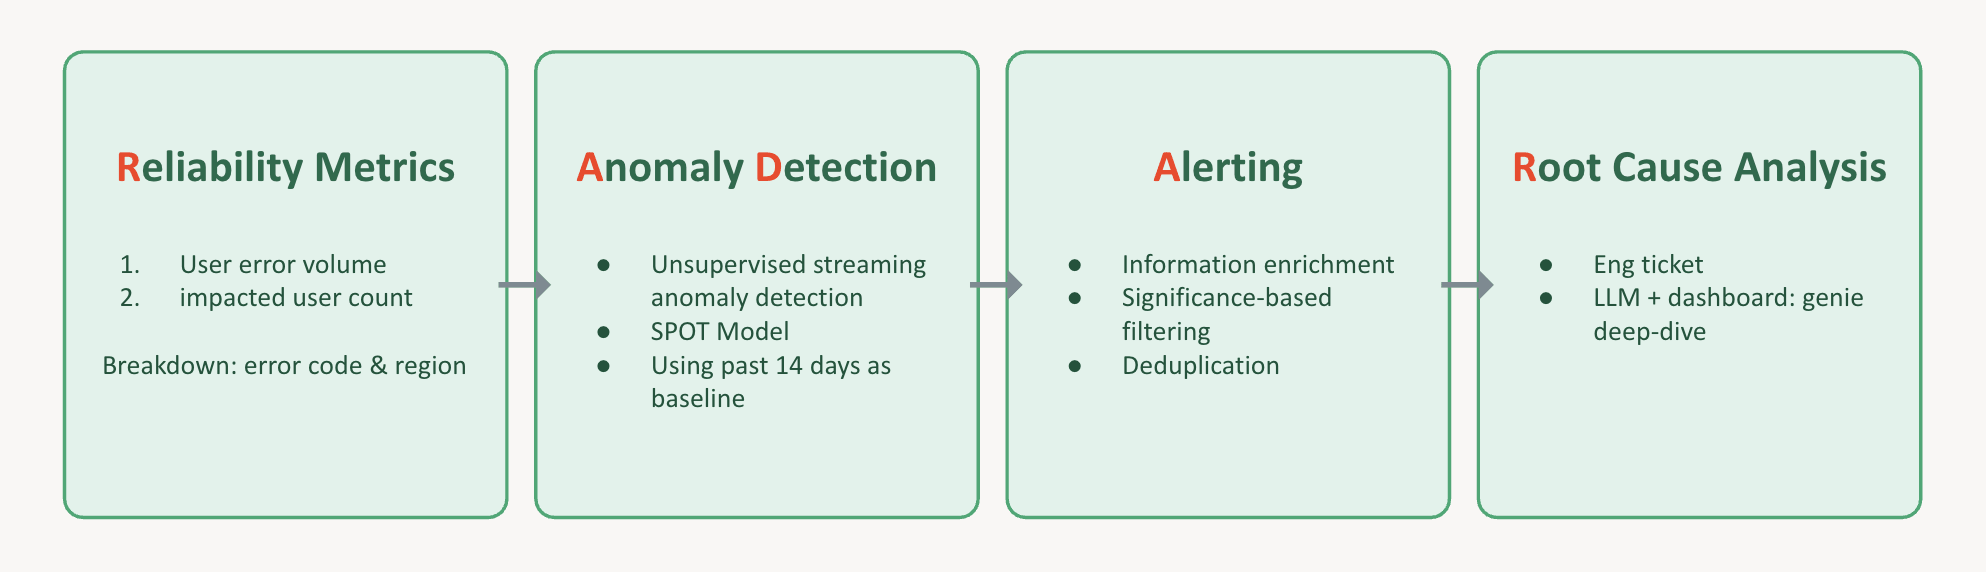
RADAR convierte ese instinto en un pipeline con cuatro etapas:
- Métricas de confiabilidad. En cada momento, registra dos cosas: cuántos errores están ocurriendo y cuántos usuarios individuales experimentan cada uno. Desglósalo por código de error y región. Ahora tienes un conjunto enriquecido de series temporales que describen el estado de salud de tu servicio.
- Detección de anomalías. Ejecuta la detección de anomalías en cada una de esas series para que el sistema marque cualquier cosa que parezca fuera de lo común, sin que tengas que ajustar manualmente un montón de umbrales. Usamos un modelo de streaming no supervisado llamado SPOT, que aprende cómo se ve lo "normal" a partir de los últimos 14 días y solo necesita un único parámetro de riesgo en lugar de límites manuales. (SPOT proviene de Anomaly Detection in Streams with Extreme Value Theory de Siffer et al., KDD 2017).
- Alertas. Cuando algo se activa, la capa de alertas toma el control. Esta enriquece la alerta con contexto, filtra lo que no es significativo y elimina duplicados para que el personal de guardia no quede sepultado bajo copias de lo mismo. Luego, genera un ticket dirigido al equipo de ingeniería adecuado para ese error.
- Análisis de causa raíz. Cada ticket llega con detalles detallados de la anomalía y un enlace a un panel de control respaldado por un asistente de AI, AI/BI Genie. Quien esté de guardia puede ir directamente a averiguar qué falló realmente, en el menor tiempo posible.
Qué logramos
Ejecutar RADAR internamente cambió la forma de estos incidentes. Antes, esperábamos los tickets de los clientes para descubrir tales incidentes, lo que provocaba días de retraso. Con RADAR, logramos una reducción del 95 % en el tiempo de descubrimiento de incidentes, con una precisión superior al 90 %, sin necesidad de que un humano detecte el patrón. Como resultado, podemos mantener controlado el radio de impacto de las fallas grises.
Apunta RADAR a cualquier métrica
Aquí está la parte que más te importa: a RADAR no le importa cuál sea la métrica. Da la casualidad de que lo apuntamos a los errores de los usuarios, pero el mismo patrón funciona en cualquier lugar donde un número pueda salir mal silenciosamente:
- Servicios financieros: fallas en pagos y transacciones, anomalías de facturación, señales de fraude
- Venta minorista y comercio electrónico: conversión de pago, errores en el carrito, tiempos de entrega
- Atención médica y ciencias de la vida: flujo de pacientes, procesamiento de reclamaciones
- Cualquier producto de AI: rendimiento del modelo y desviación de la distribución de datos que aparece antes de que un modelo falle visiblemente
Es el mismo patrón bajo diferentes configuraciones. En cualquier lugar donde tengas algo que pueda salir mal silenciosamente, se aplica RADAR.
Constrúyelo tú mismo en Databricks
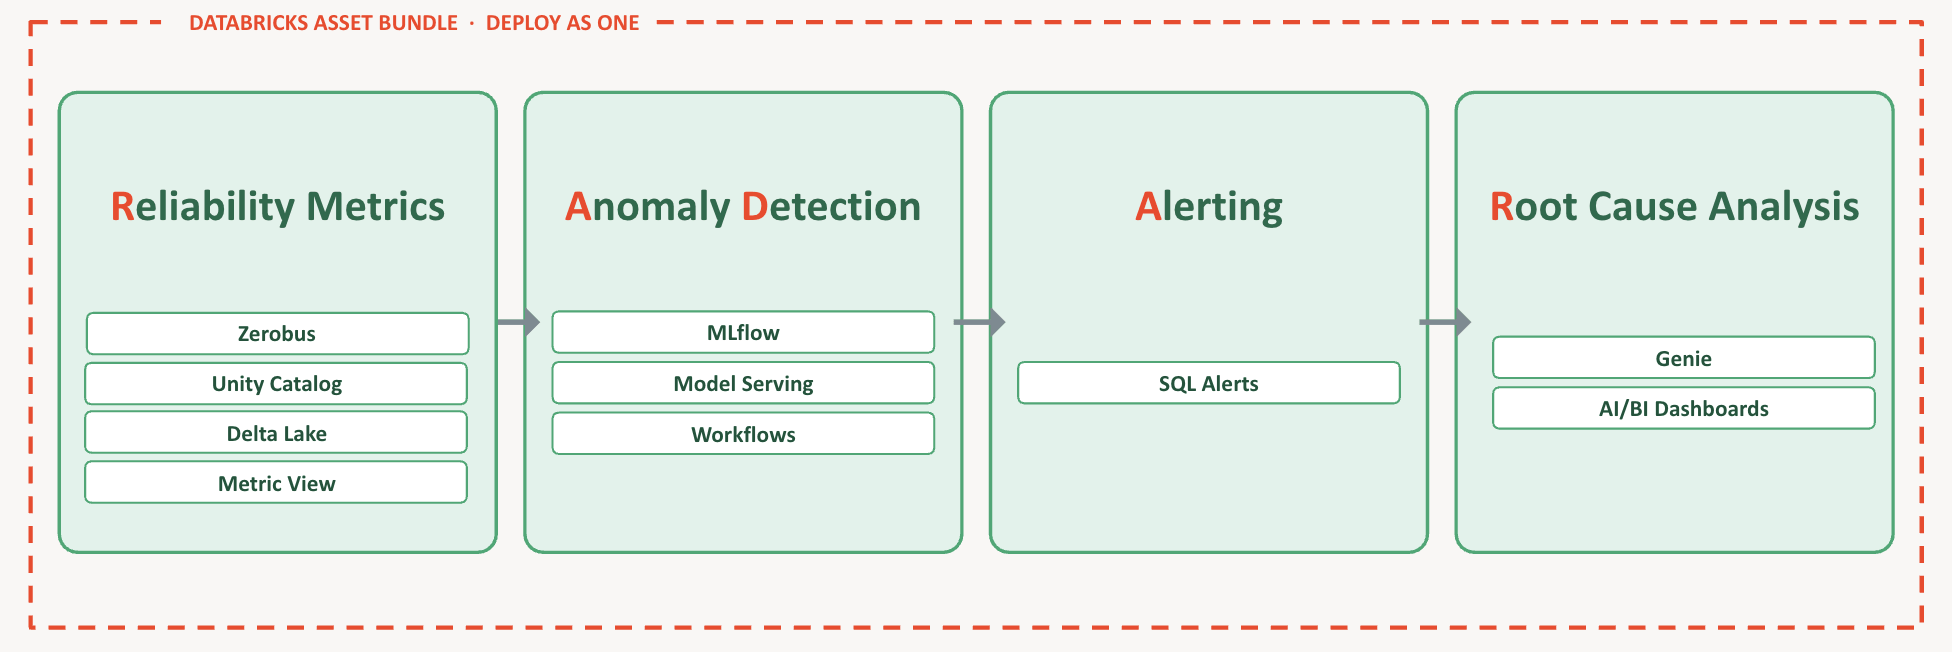
La mejor noticia: cada pieza que necesitas ya está en Databricks. Mapea las cuatro etapas en la plataforma y se verá así:
- Métricas de confiabilidad — Zerobus para ingesta de baja latencia, Unity Catalog y Metric View para gobernanza, Delta Lake para almacenamiento
- Detección de anomalías — MLflow para el entrenamiento de modelos, Model Serving para entregar el endpoint del modelo y Workflows para orquestar las tareas recurrentes
- Alertas — Databricks SQL Alerts para activar alertas
- Análisis de causa raíz — AI/BI Genie y AI/BI Dashboards
Y todo se despliega como una sola unidad a través de un Declarative Asset Bundle (DAB).
Conectar todas esas partes a mano es la parte molesta, así que la eliminamos. Sintetizamos todo el sistema interno RADAR en una sola plantilla: un archivo markdown que funciona como una receta, mapeando cada parte de RADAR a un componente específico de Databricks (recopilar y almacenar → una tabla Delta; detectar la anomalía → una tarea; alertar y eliminar duplicados → un ticket; visualizar → un dashboard).
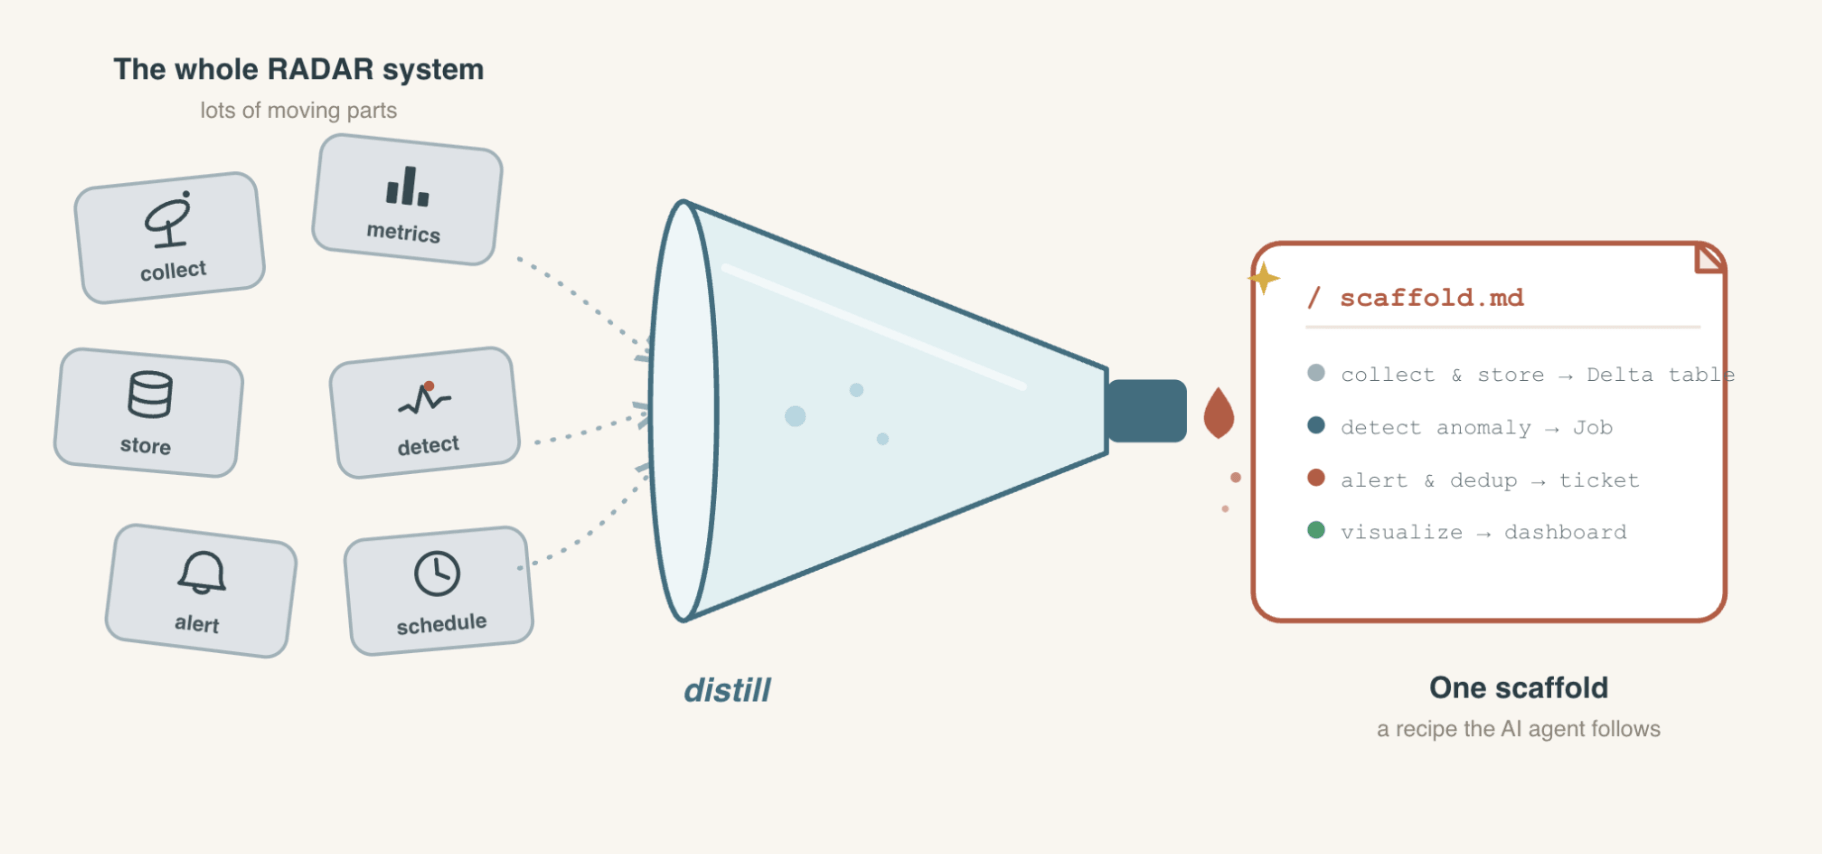
Y aquí viene la recompensa. Tú aportas tu propia métrica (dondequiera que esté tu señal) y le entregas la métrica, la plantilla y un prompt corto a un agente de AI. Este construye todo el sistema RADAR por ti, en vivo en Databricks. Puedes seguir las instrucciones de GitHub sobre cómo construir uno a partir de un solo prompt.
Conclusiones clave
Dos ideas para recordar:
- Detecta los fallos grises antes de que se agraven. Los dashboards en verde no son prueba de que los clientes estén bien. Añade detección de anomalías en tiempo real para que un fallo parcial y silencioso salga a la luz en minutos, no en días.
- Construye RADAR en Databricks para cualquier métrica que te interese. La plantilla, la demo y el prompt son públicos; utilízalos como punto de partida.
Obtén la plantilla de RADAR en GitHub
Porque el mejor resultado no es responder más rápido a los clientes enojados, sino que tus clientes nunca tengan que descubrir los incidentes por ti.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.