Inteligencia de retail en tiempo real: cómo crear recomendaciones de e-commerce con Lakebase y AI Search en Databricks
Cómo una plataforma líder de e-commerce de moda ofrece recomendaciones de productos personalizadas de baja latencia a millones de usuarios, impulsada en su totalidad por Databricks Data Intelligence Platform.
por Sunny Singh
- Una arquitectura de referencia completa para crear un motor de recomendación y clasificación multietapa en Databricks, desde la ingesta de clickstream hasta el servicio personalizado en tiempo real, reemplazando la infraestructura de ML fragmentada por una única plataforma unificada.
- El sistema ofrece recomendaciones de productos personalizadas de baja latencia al combinar recomendaciones por lotes precalculadas con una ruta de puntuación en tiempo real, utilizando Databricks AI Search para la recuperación de candidatos, Lakebase para el servicio de características en línea y Model Serving para la inferencia de baja latencia.
- Al unificar la ingeniería de datos, la gestión de características, el entrenamiento de modelos y el servicio en tiempo real en una sola plataforma gobernada, los equipos de e-commerce eliminan el código de acoplamiento, aceleran los ciclos de iteración y obtienen un linaje de extremo a extremo, desde el clickstream sin procesar hasta las predicciones en producción.
La oportunidad: la personalización como motor de ingresos
Cada segundo que un comprador pasa en una aplicación de comercio electrónico de moda genera un flujo de señales de intención: búsquedas, visualizaciones de productos, adiciones a la lista de deseos e interacciones con el carrito. Las plataformas que convierten esas señales en recomendaciones de productos relevantes en tiempo real son las que ganan. Los análisis comparativos del sector demuestran que una personalización eficaz puede aumentar las tasas de conversión entre un 10 y un 30 % e incrementar significativamente el valor medio de los pedidos.
Sin embargo, crear un sistema de recomendación apto para producción sigue siendo uno de los desafíos de ingeniería de ML más difíciles. Exige ingesta de datos en tiempo real, ingeniería de características compleja, múltiples modelos de ML trabajando en conjunto e infraestructura de servicio que responda en milisegundos, todo ello mientras se mantienen sincronizados el inventario, la ubicación y las reglas de negocio.
Este blog presenta una arquitectura de referencia completa para crear un sistema de este tipo en Databricks, basada en una implementación real para una plataforma líder de comercio electrónico de moda en Asia que atiende a más de 1 millón de usuarios activos mensuales en un catálogo de más de 100 000 SKU.
Resumen del sistema: la arquitectura de un vistazo
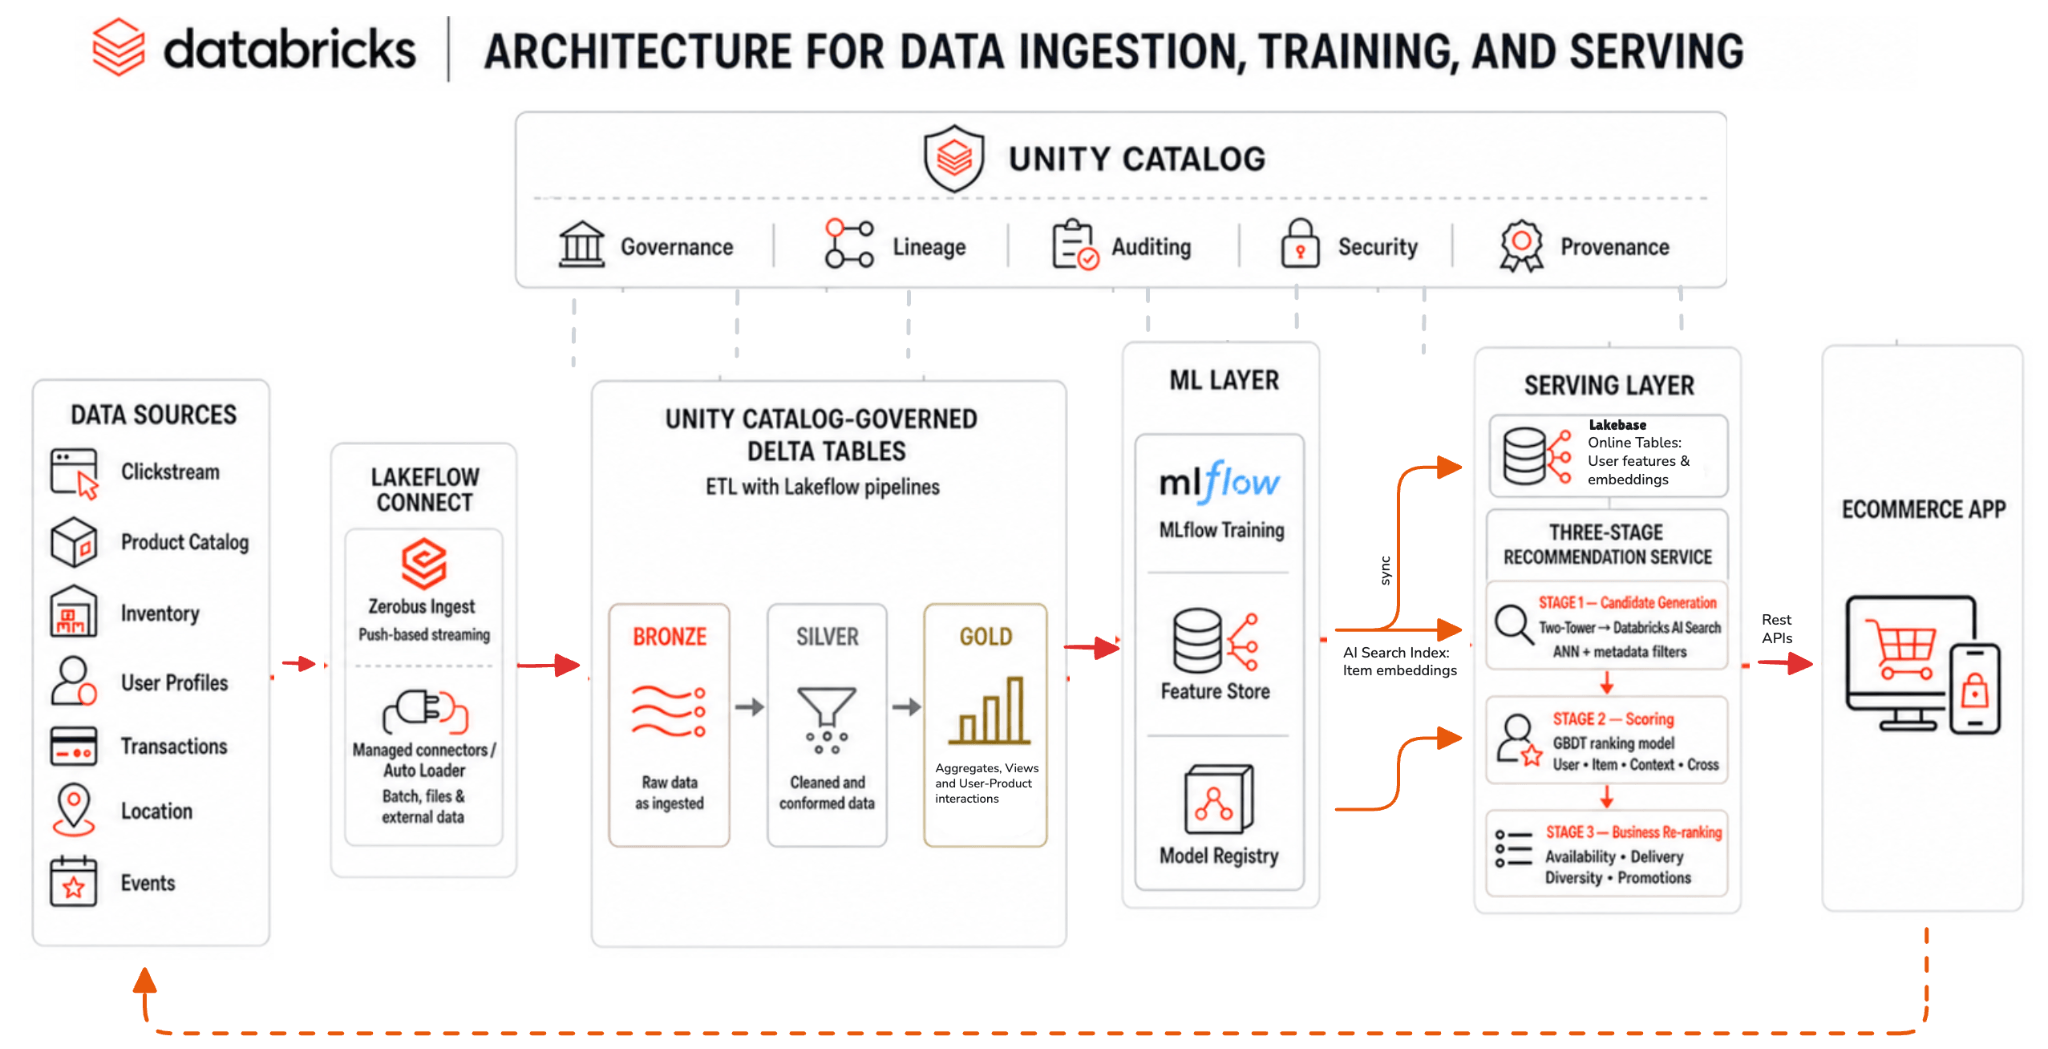
La arquitectura sigue un enfoque de plataforma unificada donde cada componente, desde la ingesta hasta el servicio, se ejecuta en Databricks, bajo el gobierno de Unity Catalog.
Arquitectura general del sistema:
Ingesta de datos: de clickstream a lakehouse en segundos
La plataforma ingesta aproximadamente 1000 eventos por segundo: visualizaciones de productos, búsquedas, acciones de añadir al carrito, compras y metadatos de sesión. El Zerobus Ingest de Lakeflow Connect proporciona la base de la ingesta, depositando los eventos directamente en las tablas Delta de Unity Catalog sin necesidad de un agente de mensajes autogestionado.
Una distinción arquitectónica importante: los datos de clickstream fluyen a través de Zerobus hacia el lakehouse para el cálculo de características fuera de línea y el entrenamiento de modelos, pero durante la inferencia en tiempo real (Ruta B), las señales de usuario en la sesión (lo que el comprador está buscando en este preciso momento) se envían directamente como parte de la carga útil de la solicitud de la API al endpoint de Model Serving. Esto evita por completo el almacenamiento en el lakehouse durante la ruta de inferencia, lo que garantiza que el contexto en tiempo real esté disponible sin incurrir en latencia de ingesta.
Zerobus acepta datos de cualquier cliente productor de Kafka estándar (Java, Python, Go) mediante un simple cambio de configuración: apunte el servidor bootstrap al endpoint de Zerobus y los registros se depositarán en la tabla Delta de destino. Para los equipos que ya ejecutan una infraestructura de Kafka, Structured Streaming con Declarative Pipelines ofrece una ruta alternativa con la misma arquitectura descendente.
Los datos fluyen hacia una arquitectura de medallón:
Capa Bronce: flujos de eventos sin procesar de solo anexar, además de datos de referencia:
- Señales del usuario:
- De comportamiento: secuencias de navegación, consultas de búsqueda, patrones de tiempo de permanencia, historial de clics
- Transaccionales: frecuencia de compra, valor medio del pedido, tasa de devolución, distribución del gasto por categoría
- De preferencia: artículos en la lista de deseos, búsquedas guardadas, afinidad de marca, preferencias de talla
- Demográficas: cohorte de edad, grupo de ubicación, tipo de dispositivo, nivel de interacción con la aplicación
- Señales del artículo:
- Catálogo: jerarquía de categorías, marca, nivel de precio, material, color, estacionalidad
- Rendimiento: tasa de conversión, relación entre visualizaciones y carritos, tasa de devolución, calificación promedio
- Visuales: embeddings de imágenes (que capturan la similitud de estilo más allá de los atributos de texto)
- Novedad: días transcurridos desde la publicación, velocidad de tendencia, trayectoria del stock
- Señales contextuales:
- Temporales: hora del día, día de la semana, proximidad al día de pago, períodos de festivales o rebajas
- Geográficas: ciudad del usuario, centro de distribución más cercano, preferencias de estilo regionales
- Ambientales: clima (influye en las preferencias de categoría), eventos locales
- De sesión: intención de navegación actual (inferida a partir del comportamiento en la sesión)
Capa Plata: limpia, organizada por sesiones y enriquecida:
- Comportamiento del usuario organizado por sesiones (secuencias de navegación, tiempos de permanencia, patrones de interacción)
- Características de productos limpias (atributos normalizados, jerarquías de categorías)
- Señales de interacción agregadas (recuentos de visualizaciones de 7 días, puntuaciones de tendencias, índices de popularidad)
- Matrices de interacción usuario-producto (señales de retroalimentación implícita)
Capa Oro: tablas de características listas para el modelo y conjuntos de datos de entrenamiento:
- Vectores de características de usuario (embeddings de comportamiento, perfiles de preferencia, grupos demográficos)
- Vectores de características de artículos (embeddings de productos, codificaciones de atributos)
- Conjuntos de datos de entrenamiento (pares de interacción etiquetados para el entrenamiento de modelos)
- Listas de recomendaciones precalculadas (generadas por lotes, almacenadas para una búsqueda rápida)
Las características se actualizan con diferentes frecuencias: los agregados de comportamiento se actualizan diariamente a través de Databricks Workflows programados, mientras que el catálogo completo de productos se sincroniza semanalmente. Los embeddings tanto de usuarios como de artículos se vuelven a calcular diariamente para capturar la evolución de las preferencias y el nuevo inventario. El Feature Store de Databricks gestiona tanto las características offline (para el entrenamiento) como las características online (para el servicio), lo que garantiza la coherencia entre el entrenamiento y el servicio: las mismas definiciones de características utilizadas durante el entrenamiento del modelo están disponibles automáticamente en el momento de la inferencia a través de las tablas online de Lakebase.
Unity Catalog gobierna cada capa, proporcionando linaje desde el evento de clickstream sin procesar hasta la predicción final entregada a la aplicación, con un control de acceso detallado que garantiza que la PII permanezca protegida mientras las características agregadas fluyen libremente hacia el entrenamiento del modelo.
Servicio en tiempo real: dos caminos para obtener respuestas de baja latencia
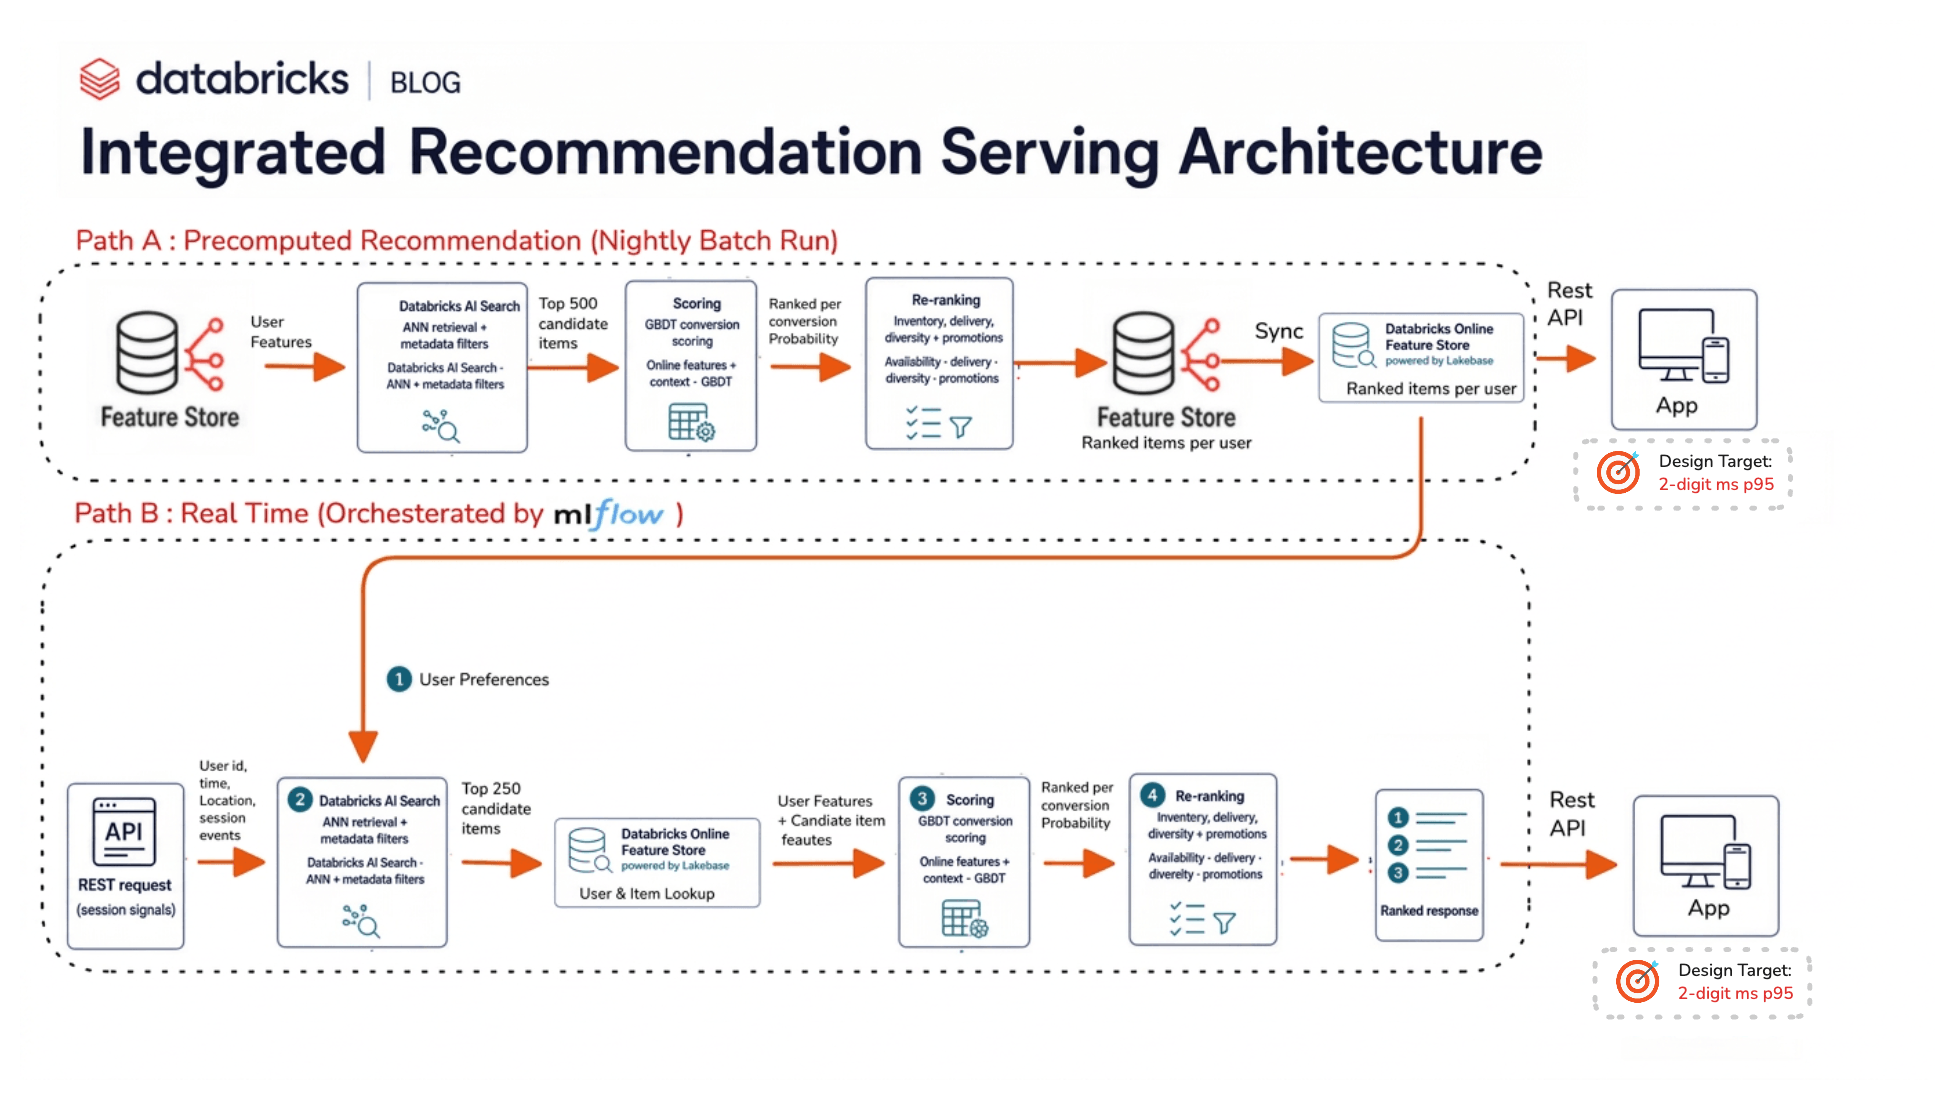
La arquitectura de servicio proporciona dos rutas complementarias, cada una optimizada para diferentes patrones de interacción. La Ruta A maneja las superficies predecibles y de gran volumen donde el cálculo previo es tanto viable como óptimo. La Ruta B maneja las superficies dinámicas y conscientes de la sesión donde la intención inmediata del usuario debe dar forma a la respuesta en tiempo real.
Ruta A: recomendaciones por lotes precalculadas (< de 2 dígitos de ms)
La Ruta A sirve a la mayoría de las superficies de recomendación: carruseles de la página de inicio, clasificaciones de páginas de categorías, campañas de correo electrónico y notificaciones push. Estas superficies comparten una característica común: la identidad del usuario y el tipo de superficie se conocen de antemano, por lo que los resultados se pueden calcular con anticipación.
Un trabajo por lotes nocturno, coordinado por Databricks Workflows, ejecuta el embudo completo de 3 etapas offline para cada usuario activo. Recupera los embeddings de usuario más recientes, ejecuta consultas ANN por lotes en el índice de artículos de AI Search para generar candidatos, los califica con el modelo LightGBM utilizando características de la capa Oro y aplica reglas de negocio (puntuación de inventario, proximidad de entrega, diversidad, impulso promocional). El resultado (una lista de productos clasificados top-N por usuario, normalmente de 50 a 100 artículos por superficie) se escribe en las tablas online de Lakebase, indexadas por ID de usuario y tipo de superficie.
En el momento del servicio, la aplicación realiza una búsqueda simple de clave-valor: user_id + surface → lista de productos clasificados. Sin inferencia de modelos, sin búsqueda de vectores, sin ensamblaje de características: solo una lectura directa desde Lakebase.
Dado que el trabajo por lotes se ejecuta por la noche, la Ruta A refleja las señales y el estado del inventario del día anterior. Para la mayoría de las superficies, esta frescura es más que suficiente (las preferencias a largo plazo y las afinidades de marca evolucionan a lo largo de los días, no de los minutos) y los nuevos productos que recibieron sus embeddings iniciales aparecerán en las recomendaciones en un plazo de 24 horas.
Ruta B: puntuación en tiempo real con reconocimiento de sesión (< ms de 2 dígitos)
La Ruta B se activa cuando el contexto de recomendación solo existe en el momento de la solicitud: "Artículos similares" en una página de detalles del producto, sugerencias de "Completa el look" o resultados de búsqueda reordenados dinámicamente que se adaptan a medida que el usuario navega.
La aplicación de comercio electrónico envía las señales de la sesión actual (artículos vistos en los últimos minutos, consultas de búsqueda activas, contenido del carrito y patrones de tiempo de permanencia) directamente como carga útil de la solicitud al endpoint de Model Serving a través de la REST API. El endpoint ejecuta el embudo completo de 3 etapas de forma síncrona dentro de un único ciclo de solicitud-respuesta:
- Etapa 1: recuperación de candidatos en tiempo real El endpoint transforma las señales de la sesión en un embedding de consulta, ya sea el embedding del artículo del producto que se está visualizando o un embedding de usuario combinado que fusiona el perfil de preferencias a largo plazo (de Lakebase) con el comportamiento dentro de la sesión, ponderando más las señales recientes. Este embedding se envía a Databricks AI Search, que realiza una recuperación híbrida: búsqueda de similitud ANN combinada con filtros de metadatos estrictos (elegibilidad de categoría, inventario regional, umbrales mínimos de stock). Los artículos que están agotados o no son elegibles nunca entran en el conjunto de candidatos. AI Search devuelve entre 200 y 500 candidatos en un solo viaje de ida y vuelta de red. Para superficies con reconocimiento de sesión, el endpoint calcula un embedding de consulta combinado, que une el embedding de preferencias a largo plazo precalculado del usuario (recuperado de Lakebase) con un embedding de sesión derivado de los artículos vistos recientemente, ponderado hacia las señales recientes para capturar la intención inmediata. Esta combinación es un cálculo ligero que se realiza dentro del endpoint, no una llamada de modelo independiente.
- Etapa 2: ensamblaje de características y puntuación Los ID de los artículos candidatos activan búsquedas puntuales en las tablas online de Lakebase, recuperando características de usuario precalculadas (agregados de comportamiento, segmento demográfico, sensibilidad al precio) y características de artículos (tasa de conversión, puntuación de tendencias, días desde la publicación). Las características de contexto en tiempo real (hora del día, dispositivo, ubicación, promociones activas) se derivan directamente de la carga útil de la solicitud. El endpoint construye vectores de características para cada par de usuario-candidato, incluidas las características cruzadas como la afinidad usuario-categoría y la superposición de preferencias de marca, y los pasa al modelo de puntuación LightGBM, que predice la probabilidad de conversión en una sola llamada de inferencia por lotes sin recursos de GPU.
- Etapa 3: reglas de negocio y reordenación La lista puntuada pasa por una capa de reordenación determinista: la puntuación con reconocimiento de inventario resta prioridad al stock en disminución, la puntuación por proximidad de entrega favorece a los almacenes más cercanos para un cumplimiento más rápido, la inyección de diversidad evita el dominio de marcas o categorías en la lista final y el impulso promocional destaca los artículos alineados con las campañas activas. La lista reordenada se trunca al tamaño solicitado (normalmente de 10 a 20 artículos) y se devuelve como respuesta de la API.
Las reglas de negocio se basan en la configuración: los pesos promocionales, los umbrales de diversidad y los límites de inventario se leen de una tabla de configuración administrada en el momento del servicio, lo que permite a los equipos comerciales ajustar las reglas sin tener que volver a implementar el modelo.
El endpoint está implementado como un MLflow PyFunc model personalizado que orquesta la canalización de varias etapas internamente: consulta a AI Search, realiza búsquedas en Lakebase, ejecuta la inferencia de LightGBM y aplica las reglas de negocio dentro de una sola llamada predict().
Una estrategia de respaldo garantiza la resiliencia: si la ruta en tiempo real supera su presupuesto de latencia, el sistema se degrada de forma controlada para ofrecer artículos populares almacenados en caché o las recomendaciones precalculadas del usuario de la Ruta A.
Cómo abordar el problema del arranque en frío
Todo sistema de recomendación debe abordar dos escenarios de arranque en frío:
Nuevos usuarios (sin historial de navegación): cuando un usuario llega por primera vez, el sistema construye un embedding de usuario predeterminado a partir de las señales demográficas disponibles: ubicación, tipo de dispositivo, contexto de registro y cualquier preferencia declarada. Este embedding se utiliza para la búsqueda ANN en el índice de artículos, lo que coloca de manera efectiva al nuevo usuario dentro de un grupo de comportamiento con datos demográficos similares. A medida que el usuario interactúa, su embedding converge rápidamente hacia sus preferencias reales.
Nuevos productos (sin datos de interacción): cuando un nuevo SKU entra en el catálogo, el sistema genera un embedding de artículo a partir de sus atributos: título, categoría, marca, punto de precio y características visuales extraídas de las imágenes del producto. Este embedding se utiliza para encontrar artículos existentes similares en el espacio vectorial, y el nuevo producto hereda las puntuaciones de recomendación iniciales de sus vecinos más cercanos. Los nuevos productos aparecen en las recomendaciones en el siguiente ciclo por lotes diario.
Ciclo de vida del modelo y mejora continua
Los modelos se vuelven a entrenar semanalmente mediante Databricks Workflows, con el seguimiento de experimentos y el control de versiones gestionados a través de MLflow. La plataforma admite la implementación champion/challenger: las nuevas versiones del modelo se implementan junto con el modelo de producción, y el tráfico se desplaza gradualmente en función de las métricas de rendimiento online.
Las métricas clave de ML supervisadas incluyen:
- AUC-ROC: mide la capacidad del modelo de puntuación para distinguir entre los artículos con los que un usuario interactuará y con los que no
- NDCG@K (ganancia acumulada descontada normalizada): evalúa si los artículos más relevantes aparecen en la parte superior de la lista clasificada
- Recall@K : mide qué fracción de artículos relevantes recupera con éxito la etapa de generación de candidatos
- Log Loss : realiza un seguimiento de la calibración de las predicciones, lo que garantiza que las puntuaciones de probabilidad de conversión sigan estando bien calibradas a lo largo del tiempo
Estas métricas del modelo se complementan con los KPI de negocio (tasa de clics, tasa de conversión e ingresos por sesión), que sirven como validación definitiva de que las mejoras del modelo se traducen en un impacto en el mundo real.
La detección automática de desviaciones (drift) alerta cuando las distribuciones de características o las distribuciones de puntuación de predicción se desvían de las líneas de base, lo que activa una investigación o un entrenamiento acelerado. Los registros de servicio se correlacionan con las canalizaciones de entrenamiento a través de identificadores a nivel de solicitud, lo que garantiza que el bucle de retroalimentación produzca datos de entrenamiento limpios y sin filtraciones (leakage) para la siguiente iteración del modelo. Las técnicas de entrenamiento con reconocimiento de posición garantizan que el modelo aprenda las preferencias reales del usuario en lugar de artefactos de la posición de visualización.
Resultados esperados
Esta arquitectura permite:
- respuestas personalizadas de bajo milisegundo de 2 dígitos a escala, que cumplen con las expectativas de rendimiento de los compradores modernos que priorizan los dispositivos móviles
- Recomendaciones actualizadas diariamente que reflejan el inventario más reciente, los productos en tendencia y las preferencias cambiantes de los usuarios
- Gobernanza unificada desde el flujo de clics (clickstream) sin procesar hasta las predicciones de producción, con linaje completo y control de acceso a través de Unity Catalog
- Experimentación rápida: las nuevas variantes del modelo se pueden entrenar, evaluar e implementar en días en lugar de meses
- Simplicidad operativa: una única plataforma reemplaza el mosaico de sistemas separados para la ingesta, la ingeniería de características, el entrenamiento y el servicio
- Escalabilidad fluida: de miles a millones de usuarios sin tener que rediseñar la arquitectura, aprovechando la computación serverless y la infraestructura administrada
Conclusión
Crear un motor de recomendación y clasificación de nivel de producción ya no requiere unir una docena de sistemas especializados. Al unificar la ingesta en tiempo real (Zerobus), la gestión de características (Feature Store + Lakebase), el entrenamiento de modelos (MLflow + Workflows), la recuperación de vectores (AI Search) y el servicio de baja latencia (Model Serving) en una única plataforma gobernada, los equipos de comercio electrónico pueden centrarse en lo que importa: comprender a sus clientes y ofrecer el producto adecuado en el momento adecuado.
El resultado no es solo un motor de recomendación: es una plataforma de personalización completa y lista para producción que puede servir como la columna vertebral inteligente de cualquier experiencia de comercio electrónico.
¿Listo para crear el suyo propio? Explore los aceleradores de soluciones de motores de recomendación de Databricks, sumérjase en la documentación de AI Search o póngase en contacto con el equipo de cuentas de Databricks para organizar un taller de arquitectura.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.