"Regex para filas": simplificando la detección de patrones en SQL con MATCH_RECOGNIZE
Use MATCH_RECOGNIZE siempre que una secuencia sea importante, desde tendencias del mercado de valores hasta fallas de sensores y más.
por Kent Marten y Sergei Fedorov
- MATCH_RECOGNIZE es un nuevo operador de SQL, disponible en vista previa pública, que permite detectar patrones y secuencias a partir de datos de eventos.
- MATCH_RECOGNIZE utiliza coincidencia de patrones tipo regex.
- MATCH_RECOGNIZE es muy útil en diversos sectores, como servicios financieros, ciberseguridad, comercio electrónico y fabricación/IoT
Imagine que trabaja en ciberseguridad y tiene una tabla que registra los intentos de inicio de sesión. Esta tabla incluye cada intento de inicio de sesión como un éxito o un fallo y el momento en que se produjo el intento. Quiere encontrar patrones de inicio de sesión extraños, por lo que podría hacerse la pregunta: "¿qué usuarios tuvieron fallos de inicio de sesión consecutivos, seguidos de un éxito?". Encontrar este tipo de actividad sospechosa con SQL estándar es un reto. SQL trata las filas como conjuntos de hechos no ordenados sin una línea de tiempo y no existe un concepto inherente de secuencia de eventos.
Podría contar los inicios de sesión fallidos por usuario, pero los recuentos no le ayudarán a entender si estos intentos de inicio de sesión se produjeron en un intervalo de tiempo estrecho o se distribuyeron a lo largo de un mes; y no pueden decirle si se produjo un inicio de sesión correcto justo después de los fallos. Para hacer eso en SQL, acabará con una consulta compleja que encadena múltiples expresiones de tabla comunes, anclando la ventana de tiempo al primer fallo y luego comprobando cada fila posterior.
MATCH_RECOGNIZE simplifica esto. Ahora disponible en el cómputo de Databricks (incluido Lakehouse Real-Time), MATCH_RECOGNIZE le permite describir directamente la secuencia que le interesa, como una expresión regular para filas. Una sola cláusula SQL ahora se encarga de la coincidencia de patrones y usted ha eliminado el SQL excesivamente complicado que dependía de la lógica de "gaps and islands".
Veamos ejemplos específicos de la industria sobre cómo MATCH_RECOGNIZE simplifica la detección de secuencias en diferentes sectores.
Ciberseguridad: Identificación de anomalías sospechosas en el inicio de sesión

Si está buscando credential stuffing en los registros de autorización, el simple hecho de contar los intentos de inicio de sesión puede dar lugar a falsos positivos. Específicamente, necesita detectar picos de alta frecuencia, como 5 o más intentos de inicio de sesión fallidos dentro de una ventana de tiempo estrecha específica, seguidos inmediatamente por un inicio de sesión correcto.
Las funciones de ventana estándar COUNT() OVER (PARTITION BY user_id ORDER BY event_time) pueden decirle cuántos fallos ocurrieron en un período de tiempo, pero no pueden anclar fácilmente una ventana de tiempo deslizante al primer fallo de una secuencia específica, ni pueden aislar limpiamente la secuencia una vez que se produce un éxito.
Con MATCH_RECOGNIZE, puede usar FIRST(FAIL.event_time) directamente dentro del bloque DEFINE para anclar la marca de tiempo del intento fallido inicial. Cada evento FAIL posterior se comprueba dinámicamente para garantizar que se produce dentro de la hora posterior a ese primer intento antes de pasar al estado SUCCESS.
Análisis financiero: Detección de tendencias de acciones en forma de V
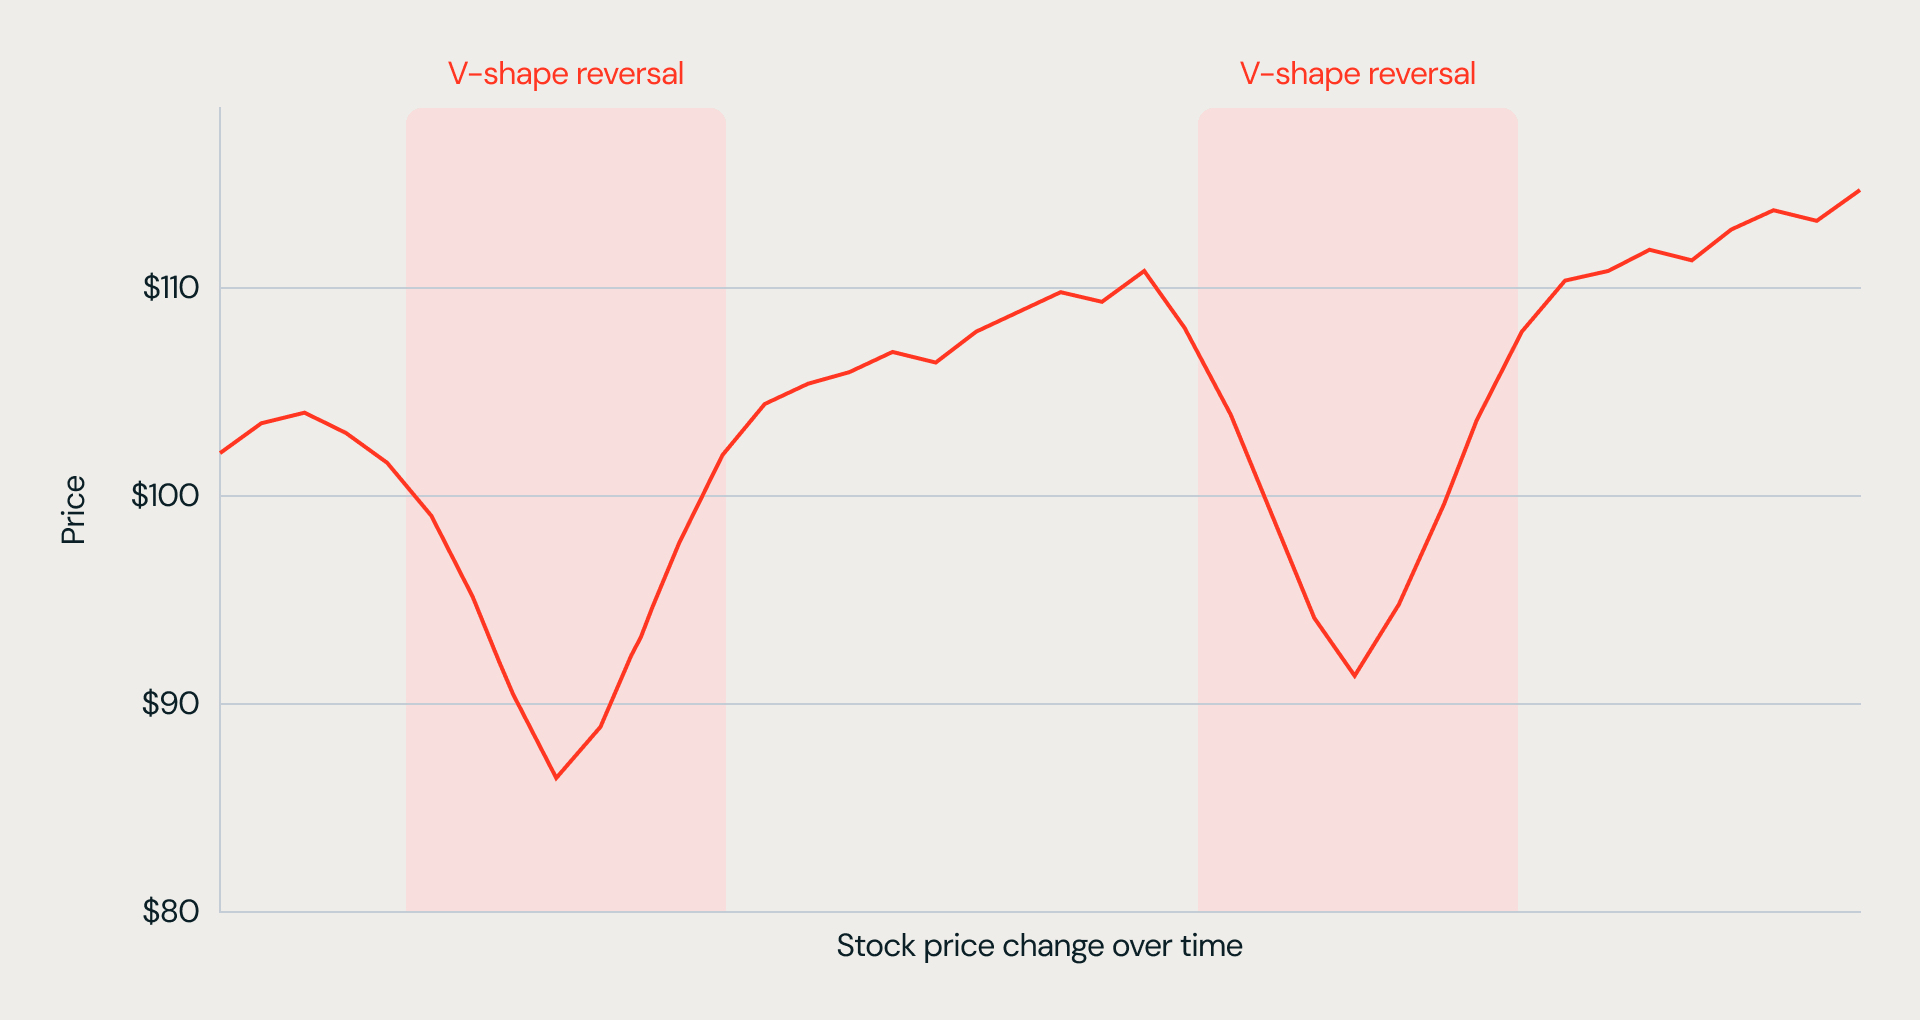
A todo analista de datos de mercado le interesan las reversiones de precios, momentos en los que una acción pierde valor y luego, de repente, empieza a recuperarlo. Esta forma se conoce como "forma de V", y encontrarla en SQL estándar significa recurrir a una técnica llamada "gaps and islands": dado que SQL no tiene una noción nativa de tendencia, primero tiene que dividir manualmente sus filas en "islas" (tramos consecutivos en los que el precio se mueve en la misma dirección) antes de poder siquiera preguntar dónde empieza y termina una forma de V.
En la práctica, eso significa usar LAG y LEAD para comparar cada fila con sus vecinas, construyendo un contador acumulativo que se incrementa cada vez que la dirección cambia (de modo que tiene un ID de grupo para cada isla), y luego escribir filtros HAVING para confirmar la forma y los límites de cada isla. Es un montón de andamiaje solo para responder a una pregunta sencilla: "¿dónde cayó el precio y se recuperó?".
La cláusula MATCH_RECOGNIZE elimina la necesidad de este andamiaje. Simplemente particiona los datos por símbolo, los ordena por tiempo y define la forma de la tendencia en V como una secuencia de estados similares a expresiones regulares.
Comercio electrónico: Detección de abandono del proceso de pago

Los gerentes de producto quieren encontrar usuarios con alta intención de compra, pero que nunca la completan. Los usuarios que demuestran una intención de compra real, pero luego se quedan en silencio, son una señal valiosa. Identificar a este conjunto de usuarios puede ayudar a: determinar a qué usuarios enviar un recordatorio, medir fácilmente la oportunidad y qué porcentaje es recuperable con acciones de seguimiento, y como punto de comparación con otros usuarios de esta cohorte, descubrir una nueva perspectiva (como que un determinado producto tiene un precio demasiado alto). Un embudo de conversión fallido de alto valor realiza el seguimiento de los usuarios que:
- Visitaron una página de producto dos o más veces (VIEW 2 o más veces, lo que indica un alto interés)
- Añadieron el artículo a su carrito (ADD_TO_CART)
- Finalmente abandonaron la sesión (usando un filtro de tiempo)
El último paso no se basa en un valor, sino en un intervalo de tiempo basado en la actividad del usuario. No hay ninguna fila de "abandono" con la que coincidir ni un "error de pago", el usuario simplemente se detiene. En SQL tradicional, se demuestra una negación con subconsultas NOT EXISTS, autouniones y funciones de ventana para mostrar que no ocurrió nada después de añadir los artículos al carrito, y que había transcurrido suficiente tiempo de inactividad para considerar el carrito abandonado.
MATCH_RECOGNIZE expresa "no pasó nada después de esto" directamente con el anclaje de fin de partición $, que obliga a que la adición al carrito sea el último evento registrado en la sesión. Añada un filtro de tiempo para la ventana de inactividad y tendrá una regla de abandono basada en el tiempo de espera sin autouniones.
Fabricación / IoT: Predicción de fallos de equipos a partir de datos de sensores

El mantenimiento predictivo depende de la detección de tendencias y patrones. En cualquier máquina en uso, su temperatura interna tiende a aumentar, pero una secuencia de aumento constante de la temperatura, seguida de un pico de vibración, podría indicar un fallo inminente.
El SQL tradicional requiere comparaciones continuas fila por fila para intentar detectar de forma constante una tendencia peligrosa. MATCH_RECOGNIZE gestiona la lógica fila por fila de forma nativa. Dentro de la cláusula DEFINE, puede utilizar las funciones PREV y NEXT (que actúan de forma similar a LAG y LEAD). Esto significa que configurar una regla de aumento de temperatura es tan sencillo como escribir temperature > PREV(temperature).
Pruebe Match Recognize en Lakehouse hoy mismo
Ahora es más fácil que nunca descubrir patrones de datos y simplificar el análisis de secuencias de eventos. MATCH_RECOGNIZE le permite escribir menos código para la coincidencia de patrones de forma lógica. Esta cláusula es más fácil de validar, más fácil de mantener y sencilla de actualizar.
- Explore la documentación: Sumérjase en la documentación de referencia oficial de SQL para obtener más información sobre la sintaxis de patrones avanzada, los cuantificadores y las agregaciones de medidas.
- Pruébelo en su espacio de trabajo: Pruebe los ejemplos anteriores en sus propios flujos de registro, sesiones de clickstream o telemetría de series temporales en Databricks SQL o Lakehouse//RT.
- Migre canalizaciones heredadas: Identifique sus CTE de autounión y funciones de ventana más complejas y deje que Genie Code le ayude a reescribirlas con consultas MATCH_RECOGNIZE más sencillas.
El mejor almacén de datos es un Lakehouse. Nuestras capacidades nativas siguen expandiéndose y le permiten realizar análisis más potentes en una única plataforma unificada.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.