Ejecuta, depura y escala cargas de trabajo de Databricks desde tu IDE local
Conecta tu editor local o CLI al cómputo de Databricks, al espacio de trabajo y a Unity Catalog para un desarrollo fluido de ingeniería de datos y ML.
por Tanishq Maheshwari y Matt Jones
- Ejecuta y depura de forma interactiva cargas de trabajo de Databricks desde tu IDE: conéctate a Serverless, AI Runtime y clústeres dedicados.
- Minimiza los cambios al espacio de trabajo: navega por Unity Catalog y edita los archivos de tu espacio de trabajo directamente desde el IDE.
- Administra un único entorno entre el IDE y el espacio de trabajo: tus archivos y las dependencias del proyecto siempre estarán sincronizados.
El espacio de trabajo de Databricks está diseñado específicamente para el análisis y la ingeniería de datos. Sin embargo, es posible que prefieras usar IDE locales y la CLI para aprovechar tus propias herramientas y asistentes de codificación como Cursor, Copilot y Claude Code. Esto es especialmente útil al desarrollar canalizaciones complejas a gran escala o modelos de ML.
Hasta ahora, la extensión de Databricks para Visual Studio y Cursor y Databricks Connect permitían el desarrollo local de Spark utilizando el cómputo de Databricks. Pero ejecutar de forma remota cargas de trabajo que no son de Spark y mantener las dependencias sincronizadas con Databricks Runtime seguían siendo puntos críticos comunes.
Ahora estamos cerrando estas brechas. Con nuestras últimas actualizaciones en la experiencia de IDE, ahora puedes conectar VS Code, Cursor o tu terminal directamente al cómputo de Databricks. Ejecuta, depura y escala cargas de trabajo de Python y SQL en infraestructura de clúster real mientras mantienes toda la ergonomía de tu IDE.
Ejecución remota sin limitaciones
Con nuestro nuevo túnel SSH (consulta la documentación), puedes conectar tu editor local o CLI a Serverless, AI Runtime y clústeres dedicados:
Ejecuta y depura de forma interactiva archivos y notebooks del espacio de trabajo desde VS Code, Cursor o la CLI.
Usa el mismo entorno en el IDE y en el espacio de trabajo; tus dependencias y archivos siempre estarán sincronizados con Databricks Runtime y el espacio de trabajo.
Aprovecha los agentes de codificación en el túnel SSH para que tengan todo el contexto del espacio de trabajo y colaboren con Databricks de manera más eficaz. Cursor y Copilot funcionan de inmediato, mientras que otros agentes como Claude Code se pueden instalar cuando el túnel SSH esté en ejecución.
Comenzar es sencillo. Puedes conectarte al túnel SSH con un solo comando usando la CLI de Databricks:
databricks ssh connectpara conectarte a serverless.databricks ssh connect --accelerator <GPU_type>para conectarte a AI Runtime, donde el tipo de GPU puede ser (GPU_1xA10 o GPU_8xH100).databricks ssh connect --cluster <cluster_id>para conectarte a un clúster dedicado.
También puedes iniciar el túnel SSH en un IDE incluyendo --ide vscode o --ide cursor como un parámetro adicional.
Como alternativa, puedes iniciar el túnel SSH directamente desde la versión más reciente de la extensión de IDE.
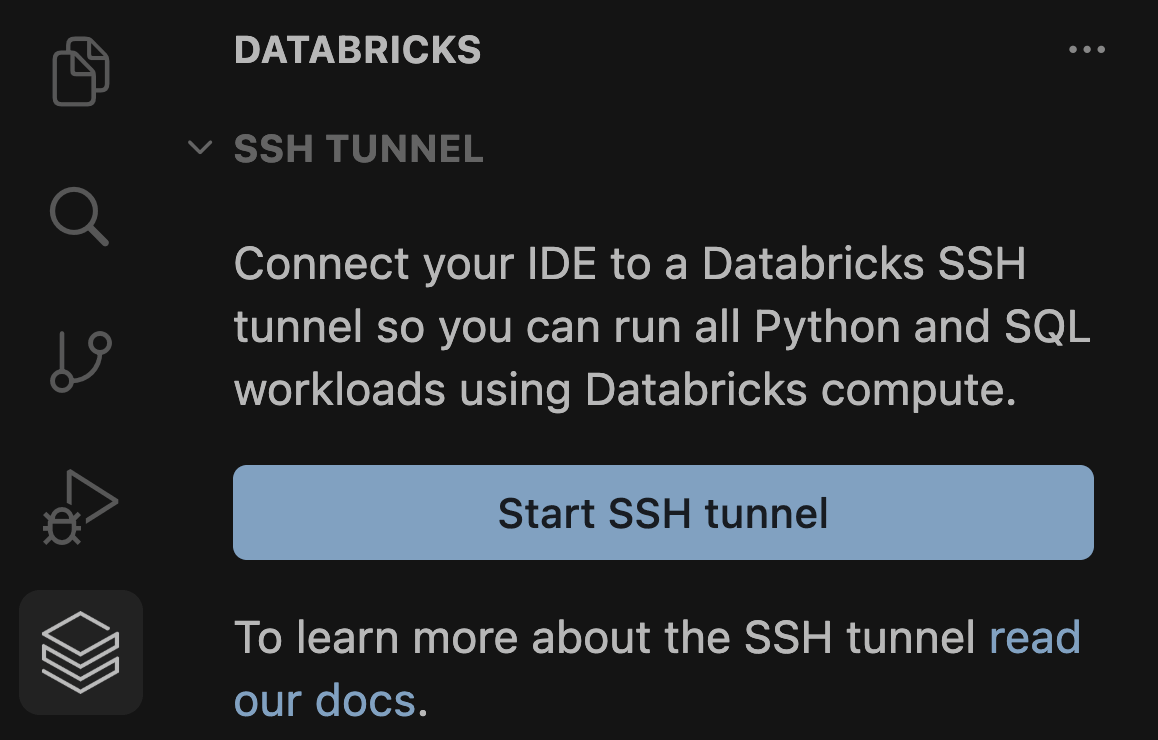
También hemos incluido otras funciones que facilitan el uso de la CLI y el IDE como tu espacio de trabajo principal:
- Administra las dependencias del proyecto (documentación): especifica un entorno base del espacio de trabajo con el parámetro
--base-environmentpara iniciar tu túnel SSH con las dependencias de Python preinstaladas. Consulta - Monitorea el uso y los costos (documentación): asocia una política de uso de serverless con el parámetro
--usage-policy-idpara realizar un seguimiento de los costos del túnel SSH por usuario, equipo o proyecto. - Explora tus activos de datos usando Unity Catalog desde el IDE (documentación): navega por catálogos, esquemas y todos tus activos de datos sin tener que cambiar al espacio de trabajo en medio de tu flujo de desarrollo.
Para conocer todos los detalles sobre cómo conectarse al túnel SSH, consulta la documentación aquí.
Próximos pasos
- Unity AI Gateway se configurará automáticamente para los usuarios del túnel SSH, de modo que puedas gobernar el acceso y el gasto en cada agente, herramienta, modelo y MCP.
- La extensión de IDE existente se integrará en el túnel SSH, para que puedas implementar y administrar paquetes de automatización declarativos desde una interfaz de usuario en el IDE.
- Las dependencias que no sean de Python y las imágenes personalizadas de Docker se podrán configurar al iniciar el túnel SSH, lo que te permitirá tener un control total de tu entorno.
Conclusión
Con estas funciones, puedes desarrollar desde el entorno que prefieras mientras trabajas a la vanguardia de la ingeniería de datos y ML. Dirige tu IDE y tus agentes a Databricks, ejecuta y depura con cómputo real y mantén un ciclo de desarrollo rápido.
Más información y próximos pasos
Para comenzar con las herramientas de desarrollo presentadas en el blog, consulta la siguiente documentación:
- “Túnel SSH” (AWS | Azure | GCP)
Conéctate al cómputo de Databricks para ejecutar de forma interactiva cargas de trabajo de Python y SQL desde el IDE o la CLI, manteniendo todo el código y los datos seguros dentro de tu espacio de trabajo de Databricks. - “Extensión de IDE” (AWS | Azure | GCP)
Trabaja con archivos locales y define, implementa y ejecuta paquetes de automatización declarativos utilizando una interfaz de usuario en el IDE. - “Databricks Connect” (AWS | Azure | GCP)
Conecta tu entorno de desarrollo local al cómputo de Databricks para ejecutar de forma remota cargas de trabajo de Spark. - “Unity AI Gateway” (AWS | Azure | GCP)
Controla qué servicios de AI pueden usar los equipos, enruta y administra el tráfico de AI, establece medidas de seguridad y monitorea el uso desde un único plano de control.
Para comprender qué herramientas se adaptan mejor a tus necesidades, consulta Conectarse desde tu IDE.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.