Escalado y operación de un gran proyecto dbt en Databricks: el equipo de datos de IFCO sobre rendimiento, visibilidad y depuración
- Optimice los modelos incrementales de dbt para que cada ejecución escriba solo las filas que cambiaron, utilizando liquid clustering, una estrategia de fusión deliberada y poda dinámica de archivos. Esto redujo el tiempo de ejecución del trabajo principal de IFCO en más de un 60 % y eliminó la actualización completa nocturna.
- Diagnostique los modelos lentos a partir del plan de consulta ejecutado real, no del SQL compilado, ya que ahí es donde aparecen las causas reales. IFCO empaquetó ese diagnóstico en una habilidad repetible que se ejecuta en cada modelo.
- Ejecute el proyecto dbt como una tarea por modelo en Databricks Jobs con la herramienta de código abierto databricks-dbt-factory, en lugar de como un trabajo opaco. Esto proporciona visibilidad por modelo, reejecuciones dirigidas y pruebas obligatorias.
Resumen
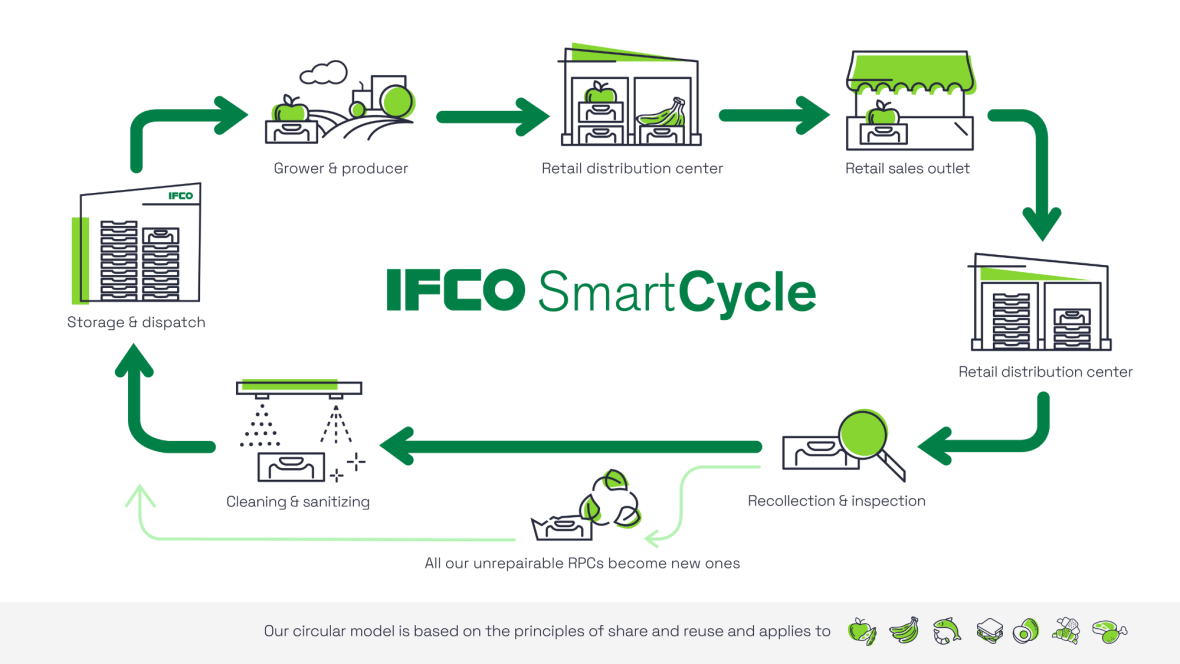
IFCO gestiona uno de los pools de embalaje reutilizable más grandes del mundo, con cientos de millones de cajas y palés. Con más de 2000 empleados en todo el mundo, IFCO cuenta con más de 350 personas en Alemania, la mayoría de las cuales trabaja en su sede global en Pullach, cerca de Múnich. El negocio consiste en un servicio de pooling circular: los contenedores de plástico reutilizables (RPC) transportan productos frescos desde los productores y empacadores hasta los centros de distribución y minoristas, y luego regresan a los Centros de Servicio de IFCO para ser lavados, clasificados y enviados de nuevo a más de 50 países.
Cada caja y palé se rastrea a lo largo de su ciclo de vida, alimentando los KPI con los que opera el negocio: tiempo de ciclo, pérdida, rotura, costo de lavado y tamaño del pool. Convertir miles de millones de eventos de seguimiento sin procesar en KPI confiables es difícil por tres razones: hay una gran cantidad de datos, algunos llegan tarde de formas difíciles de predecir y, cuando lo hacen, obligan al pipeline a corregir el historial que ya ha reportado.
Esta publicación muestra cómo el equipo de la plataforma de datos de IFCO, en colaboración con el equipo de Forward Deployed Engineering de Databricks, logró que ese pipeline fuera más rápido y económico. La lógica de transformación se mantiene en dbt. Se ejecuta en Databricks, donde cada configuración incremental se asigna a un comportamiento de escritura concreto de Delta Lake: qué columnas agrupan los datos, qué parte de la tabla de destino debe tocar una escritura y si las filas se fusionan o se reemplazan. Definir correctamente esas configuraciones, con la granularidad de datos adecuada, redujo el tiempo de ejecución diario del trabajo de la capa semántica principal en más de un 60 por ciento y permitió a IFCO retirar una costosa actualización completa nocturna.
IFCO y la naturaleza del problema de los datos
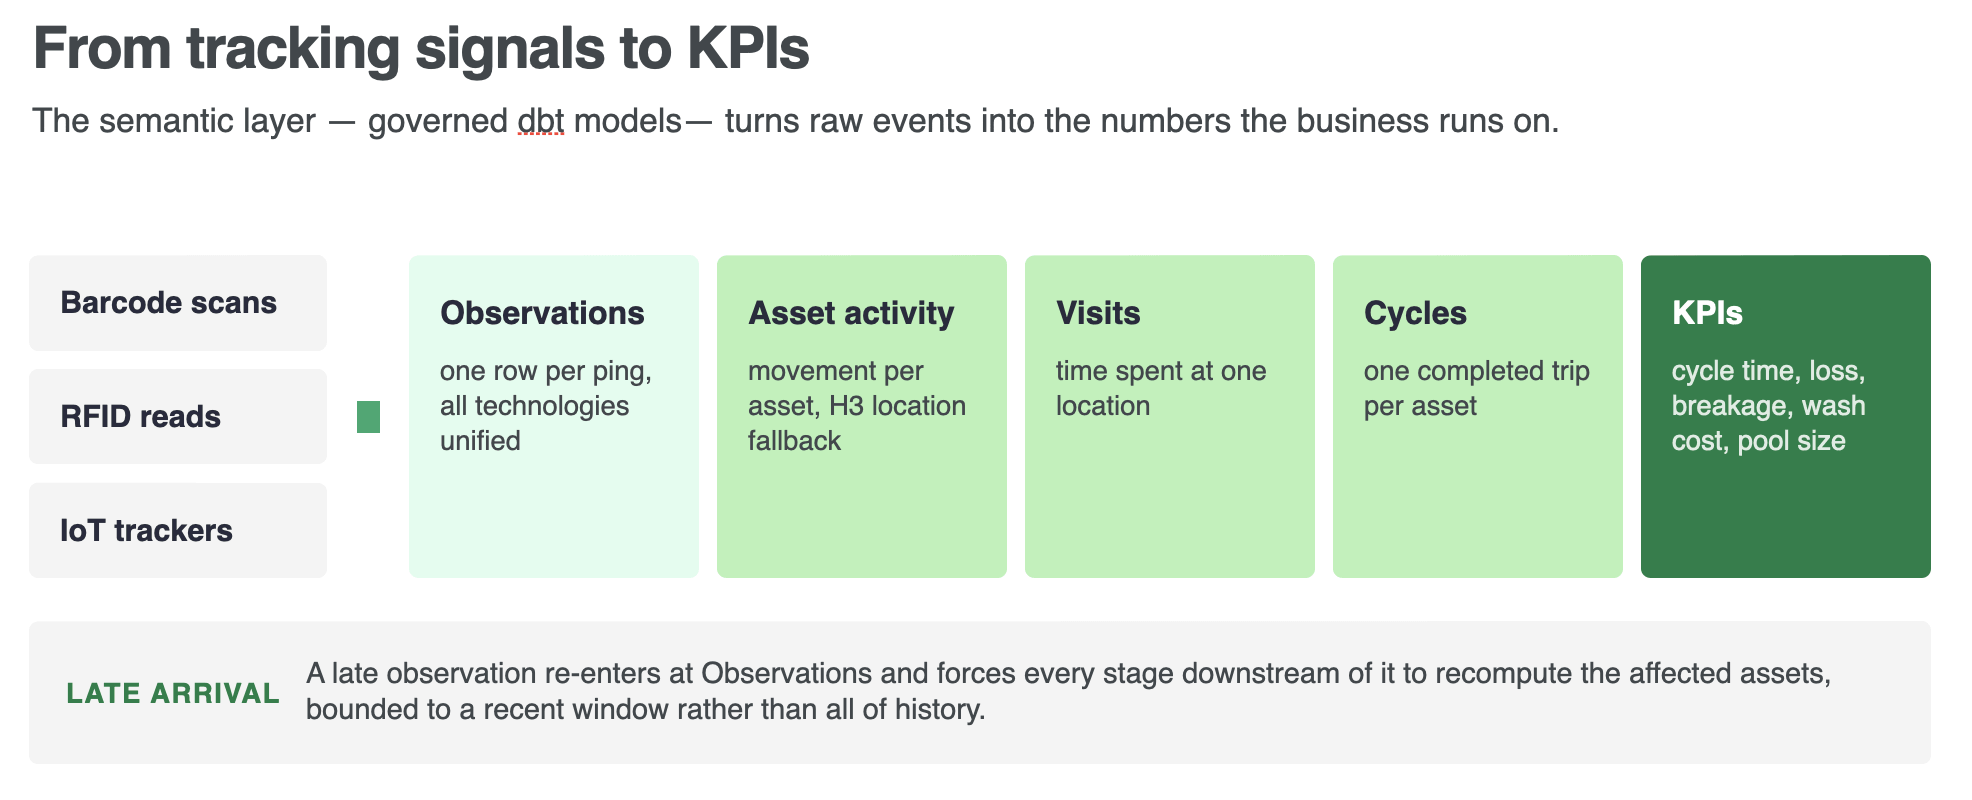
Una caja se recoge, se llena, se envía, se devuelve, se lava y se reutiliza muchas veces al año, por lo que IFCO necesita saber dónde está cada activo y qué ha sucedido con él. IFCO introdujo una capa semántica que reúne muchas señales de seguimiento diferentes en una sola vista gobernada de la actividad de los activos: escaneos de códigos de barras a medida que las cajas pasan por la línea de lavado, lecturas de RFID en las puertas de los muelles y rastreadores alimentados por batería que informan la posición GPS, las balizas Bluetooth cercanas y la temperatura. (A lo largo de esta publicación, \"capa semántica\" se refiere a estos modelos gobernados de dbt que convierten los eventos de seguimiento sin procesar en KPI comerciales). Tres propiedades hacen que esto sea difícil.
- Escala. Cada día ingresan miles de millones de eventos de seguimiento. La consolidación reduce los pings repetidos de cada activo a muchas menos filas de actividad, pero las tablas que leen los KPI siguen siendo lo suficientemente grandes como para que reconstruirlas desde cero sea costoso.
- Llegadas tardías impredecibles. La mayoría de las observaciones llegan dentro de un intervalo esperado, pero algunas fuentes se retrasan semanas, y unas pocas meses, sin un horario fijo. Un pipeline que asume que los datos que tiene hoy son la imagen completa de lo que sucedió ayer reportará silenciosamente un historial incorrecto.
- Reconciliación histórica. La actividad de los activos es una secuencia, por lo que una observación tardía no solo llena un vacío. Si se introduce un escaneo en medio de la línea de tiempo de un activo, cambia lo que el pipeline ya había concluido sobre todo lo posterior: a dónde fue el activo después, cuándo comenzó su ciclo, en qué categoría de KPI cayó. Por lo tanto, una llegada tardía obliga al pipeline a recalcular el estado que ya ha publicado, en lugar de simplemente agregar una nueva fila. El objetivo es emitir una buena estimación rápidamente y hacerla converger hacia la realidad a medida que llegan los datos tardíos, sin tener que volver a procesar todo cada noche.
Procesamiento incremental a escala
Un modelo incremental de dbt es, en el fondo, un conjunto de comportamientos de lectura y escritura de Delta, y la mayor parte del éxito provino de un principio: hacer que cada ejecución toque la menor cantidad de filas posible y descartarlas lo antes posible. La primera y más importante palanca es la lectura en sí, escaneando solo los archivos y los activos modificados que una ejecución realmente necesita, ya que cada fila que se evita leer es una fila que nunca llega a las costosas operaciones de ordenamiento, shuffles y escrituras por activo en las etapas posteriores. Cada técnica a continuación es una configuración común de dbt que se convierte en un comportamiento específico de Delta.
Agrupe por las columnas por las que filtra y realiza uniones. El Liquid clustering, asociado a la granularidad por la que se consulta cada modelo (para la actividad de los activos, el activo y la fecha del evento), permite que el motor omita archivos en lugar de escanearlos. Esto es lo que hace que las siguientes dos técnicas funcionen.
Elija la estrategia incremental de manera deliberada. La estrategia decide cómo escribe cada ejecución, y la elección surge de dos preguntas: ¿tiene cada fila una clave estable? y ¿está actualizando filas en el lugar o reemplazando un grupo de ellas a la vez? Para upserts con clave y alta eliminación de duplicados, merge es la opción predeterminada. Con clave en la granularidad real (para la actividad de los activos, asset_id y event_date_time), realiza dos acciones que una eliminación y reinserción masiva no puede hacer:
El predicado de equi-join activa el recorte dinámico de archivos: los valores clave en el lote entrante omiten los archivos de destino que no pueden contener una coincidencia, por lo que la escritura solo toca la sección que cambia. (DBT_INTERNAL_DEST and DBT_INTERNAL_SOURCE son los alias de dbt para la tabla de destino y el lote entrante en la instrucción que genera). Agrupar por las mismas claves con las que coincide el merge mantiene ese recorte ajustado. Una protección de hash de fila, un matched_condition que compara un hash sustituto de cada fila, luego omite la reescritura de las filas que realmente no cambiaron, lo que ahorra escrituras y mantiene limpio el feed de cambios posterior.
delete+insert es la alternativa: elimina un grupo completo de filas por clave y lo vuelve a insertar. Esto es más sencillo cuando una ejecución vuelve a derivar un grupo como una unidad y las filas no tienen una identidad estable con la que coincidir, a costa de reescribir el grupo incluso cuando nada cambió. Con volúmenes muy grandes, vale la pena realizar un benchmark de ambos en lugar de hacer suposiciones.
Limite la escritura a una ventana reciente. El mismo mecanismo de predicado tiene un segundo uso. En lugar de un equi-join para el recorte de archivos, un límite de tiempo restringe la escritura a datos recientes, por lo que en los modelos ascendentes (upstream) de mayor volumen, MERGE coincide con una sección reciente del destino en lugar de con toda la tabla:
Debido a que el predicado se basa en cuándo se ingirió una fila, no en cuándo ocurrió el evento, un evento que tiene meses de antigüedad se sigue capturando siempre que haya llegado recientemente. La ventana solo tiene que ser lo suficientemente amplia como para cubrir el lapso entre la llegada de los datos y el procesamiento de este trabajo. Si se define demasiado estrecha, los datos tardíos se omitirán silenciosamente: no se producirá un error, simplemente nunca se procesarán.
Vuelva a calcular solo lo que cambió. Los modelos limitan su alcance a los activos afectados por datos nuevos o tardíos, identificados a partir de una marca de agua (watermark) de ingesta, y leen una ventana más amplia de la que escriben, de modo que los eventos tardíos se capturan sin una actualización completa.
Mantenga Delta ordenado. Las tablas incrementales pesadas activan las escrituras optimizadas y la autocompactación, o delegan el mantenimiento de las tablas a Predictive Optimization, de modo que las fusiones frecuentes no dejen un costo de lectura por archivos pequeños.
La disciplina consiste en aplicar esto en la granularidad correcta y luego confirmar, a partir del plan de consulta real, que el motor realmente realiza el recorte en lugar de escanear silenciosamente.
Un ejemplo práctico: consolidación de observaciones en la actividad de los activos
El modelo con mayor actividad en la capa semántica es el que consolida las observaciones de cada tecnología de seguimiento en un único flujo con reconocimiento de ubicación por activo. Determina cuándo se movió realmente un activo mediante funciones de ventana particionadas por activo y ordenadas por hora del evento. Cuando una observación no incluye una ubicación explícita, recurre a las funciones H3 integradas de Databricks SQL, que asignan cada latitud/longitud a una celda de cuadrícula hexagonal para que el \"mismo lugar\" se convierta en una comparación económica de los ID de celda y su distancia de cuadrícula, en lugar de realizar repetidos cálculos matemáticos de distancia geográfica. Fue, por un amplio margen, el mayor consumidor de tiempo de ejecución.
El primer paso no fue optimizar, sino ver qué se estaba ejecutando realmente, y esa distinción es importante. dbt compile representa el SELECT de un modelo con sus referencias resueltas, pero para un modelo incremental esa no es la instrucción que ejecuta Databricks. Detrás de ese SELECT compilado, dbt genera y ejecuta una operación más grande: vistas temporales, escaneos de la tabla de destino y la escritura final de regreso a la tabla. La única forma de descubrir a dónde van el tiempo y la memoria es leer el plan de consulta ejecutado real, etapa por etapa, desde el historial de consultas, no el SQL compilado.
Leído de esa manera, el plan era revelador. El modelo estaba escaneando miles de millones de filas, volcando cientos de gigabytes al disco y pasando aproximadamente el 85 por ciento de su tiempo en un único ordenamiento de ventana y shuffle por activo. En efecto, estaba reconstruyendo toda la tabla en cada ejecución. Tres factores causaron esto:
- El conjunto de activos "modificados" nunca se redujo. Se regeneraba una marca de tiempo upstream en cada ejecución en lugar de transmitirse desde el origen, por lo que casi todos los activos parecían nuevos. Cuando todo parece modificado, una ejecución incremental se convierte silenciosamente en una actualización completa.
- El recálculo por activo no tenía límites. Las funciones de ventana revisaban todo el historial de cada activo, por lo que incluso un conjunto de cambios realmente pequeño arrastraba años de historial a través de la ordenación.
- La etapa de ventana calculaba columnas que la consulta final nunca utilizaba, incluyendo una segunda ventana prospectiva cuyo resultado completo se descartaba.
Cada solución se deriva directamente de su causa: transmitir la marca de tiempo de ingesta real a través de los modelos upstream para que el conjunto modificado refleje datos genuinamente nuevos, limitar el recálculo a una ventana reciente, eliminar las columnas no utilizadas y la ventana prospectiva, realizar el clustering según la granularidad por la que se consulta el modelo y, finalmente, ejecutar todo el grafo como tareas paralelas por modelo en computación serverless (la siguiente sección). En conjunto, esto redujo el tiempo de ejecución del trabajo principal en más del 60 por ciento (casi dos tercios) y eliminó la actualización completa nocturna que se requería para mantener los KPIs correctos.
De una sesión de depuración a una habilidad repetible
El diagnóstico anterior (leer el plan de ejecución real en lugar del SQL compilado, revisar el lado de lectura y el lado de escritura, y rastrear cada síntoma hasta una causa raíz) no es específico del modelo de consolidación. Es una secuencia que cualquier ingeniero ejecutaría en cualquier modelo incremental lento en Databricks. Esa secuencia es lo que se empaqueta como una habilidad: un playbook que un agente de IA ejecuta bajo demanda, de modo que el diagnóstico escala con el número de modelos en lugar de con el número de ingenieros que recuerdan cómo hacerlo.
La habilidad imita el ejemplo práctico paso a paso. Extrae la familia de instrucciones real del historial de consultas, no de la salida de dbt compile, porque para un modelo incremental se trata de instrucciones diferentes. Lee ambos lados de la ejecución: métricas del lado de escaneo (archivos descartados, filas leídas, spill) y métricas del lado de escritura (filas escritas frente a filas eliminadas), ya que la amplificación solo aparece en el lado de escritura. Luego, busca las mismas tres clases de fallos encontradas en el modelo de consolidación: un conjunto modificado que nunca se reduce (una marca de tiempo upstream que se regenera en lugar de transmitirse), un recálculo por activo sin límites (una ventana sin límite de retrospectiva) y trabajo desperdiciado (columnas o pasadas de ventana calculadas pero que nunca se leen downstream). Cada comprobación se basa en una métrica o en una señal del plan, no en una corazonada.
El resultado es un informe, no una solución silenciosa: cada hallazgo se presenta con su evidencia (filas escaneadas, bytes de spill, nodo del plan), junto con un cambio propuesto, y no se aplica nada al modelo hasta que se aprueba. Una vez aprobado, las mismas métricas de antes/después utilizadas para justificar la solución se vuelven a medir en la siguiente ejecución, por lo que la habilidad cierra el ciclo en lugar de asumir que la solución funcionó.
La ganancia es la consistencia, no la novedad. Las tres causas detrás del tiempo de ejecución del modelo de consolidación eran comunes y fáciles de pasar por alto bajo carga (una marca de tiempo regenerada, una ventana sin límites, columnas muertas). Ejecutar una habilidad para detectarlas no cuesta nada de repetir, y encuentra el mismo tipo de problema en el siguiente modelo antes de que se convierta en un problema de tiempo de ejecución del 60 por ciento que alguien tenga que escalar.
Ejecución de un proyecto dbt grande en Databricks Jobs
Databricks Workflows (Lakeflow Jobs) trata a dbt como un tipo de tarea de primer nivel: un proyecto dbt se puede programar, ejecutar y monitorear junto con la ingesta y los pasos downstream en un único flujo de trabajo gobernado, con reintentos y alertas compartidos. La versión más simple ejecuta todo el proyecto como una sola tarea dbt. Funciona, pero es una caja negra: si un modelo falla, todo el trabajo falla, sin forma de ver, volver a ejecutar o monitorear modelos individuales. A esta escala, eso representa un riesgo operativo.
La solución es ejecutar el grafo de dbt como tareas individuales de Databricks, una por modelo, prueba, semilla y snapshot. IFCO genera ese grafo con databricks-dbt-factory, una biblioteca de código abierto independiente (con licencia MIT, en GitHub y PyPI). Lee el manifiesto de dbt y una plantilla de trabajo, y produce un trabajo de Databricks Asset Bundle con una tarea por nodo. La granularidad por tarea solo vale la pena si cada tarea es económica de iniciar, lo que se reduce a tres mecanismos:
- Tipo de tarea de notebook. Un pequeño notebook ejecutor compartido activa dbt a través de su API de Python. dbt procesa el SQL y lo envía al SQL warehouse, por lo que el cómputo del notebook no procesa ningún dato.
- Entornos base. Un entorno base es una instantánea de entorno de Python serverless preconstruida. Este ya contiene
dbt-databricks, por lo que cada tarea comienza desde allí y omite el pip install que de otro modo tendría que realizar una tarea nueva. - Inyección de manifiesto. Se entrega un manifiesto preconstruido directamente a dbt para omitir el análisis, y cada tarea escribe artefactos en un directorio local privado. En un proyecto grande ejecutado por muchas tareas a la vez, esa es la diferencia entre pasar minutos releyendo el proyecto y realizar trabajo útil.
Al mantener la sobrecarga al mínimo, la distribución (fan-out) ofrece a operaciones lo que necesita: visibilidad a nivel de tarea, ejecuciones repetidas dirigidas solo del modelo fallido y sus dependientes, registro, alertas y pruebas por modelo, y un ejecutor que se puede extender (cargar secretos, etiquetar una ejecución con un SHA de git o publicar en Slack en unas pocas líneas). Todo se despliega como Databricks Asset Bundles a través de una matriz de GitHub Actions sensible a la ruta, y el tiempo de ejecución y el costo por modelo se rastrean desde las etiquetas de consulta y las tablas del sistema en un panel con alertas, de modo que una regresión aparece en un día y no en una factura mensual.
Pruebas y calidad a escala
La eficiencia no sirve de nada si altera silenciosamente los números, por lo que la calidad se impone, no se espera. Cada modelo cuenta con un propietario y una prueba de unicidad. Las claves primarias se prueban como únicas y no nulas con nivel de gravedad de error. Los modelos con lógica real (funciones de ventana, uniones múltiples, macros no triviales) requieren pruebas unitarias. dbt-bouncer bloquea los commits que violan esto, junto con sqlfluff en el dialecto de Databricks, y los contratos se aplican en las capas que leen los consumidores externos.
La misma disciplina se aplica al costo de las pruebas en sí. Las comprobaciones en las vistas se materializan o se agrupan en menos pasadas, porque una comprobación basada en vistas vuelve a calcular la vista en cada ejecución; las comprobaciones básicas se convierten en restricciones de columna y las pruebas se limitan a los datos incrementales. A nivel local, los desarrolladores recurren a un manifiesto de producción, por lo que solo se compilan los modelos modificados mientras que los upstream leen de prod. En CI, las pruebas unitarias y de datos muestreados se ejecutan en los modelos modificados antes de la fusión (merge).
Benchmarking
| Métrica | Antes | Después |
|---|---|---|
| Tiempo de ejecución diario, trabajo principal | ≈ 7 horas | 2 h 20 min, reducción de ~66 % |
| Actualización completa nocturna | requerida para mantener los KPIs correctos | retirada |
| Filas escaneadas por ejecución, modelo de consolidación | ≈ 25 mil millones (y creciendo diariamente) | -75 % de filas escaneadas |
| Costo de cómputo diario | Reducido en un 58 % | |
| Activos recalculados por ejecución | casi la totalidad del grupo | ≈ 3 - 5 % del grupo |
Próximos pasos
El pipeline actual es por lotes (batch): la ingesta se realiza una vez al día y la capa semántica se ejecuta sobre ella, emitiendo una estimación temprana y convergiendo a medida que llegan los datos tardíos. Tres trabajos recomendados durante la colaboración llevarían esto más allá y abrirían la puerta a KPIs casi en tiempo real.
- Consumir solo lo que cambió, con Change Data Feed. Change Data Feed de Delta permite que un modelo downstream lea solo las filas que cambiaron upstream, en lugar de volver a escanear sus entradas. Aplicado al modelo de consolidación y sus dependientes, reduce el trabajo de conciliación de "escanear una ventana reciente" a "procesar las filas exactas que se movieron", el siguiente paso natural después de limitar el recálculo.
- Ingesta de menor latencia. La carga una vez al día puede pasar a una ruta de ingesta de streaming, Auto Loader o un conector Lakeflow Connect de baja latencia, sin tener que volver a diseñar nada downstream. Eso por sí solo reduce el tiempo de actualización de un día a minutos.
- Transformaciones de streaming declarativas. La misma lógica de transformación se puede ejecutar de forma continua como un Lakeflow Declarative Pipeline que lee un stream, en lugar de como un lote nocturno, con un procesamiento con estado que gestiona la conciliación por activo a medida que llegan los eventos.
La pregunta decisiva es la necesidad del negocio, no la tecnología. Cuando una métrica realmente debe actualizarse en cuestión de minutos en lugar de a la mañana siguiente, esta ruta la ofrece en las mismas tablas gobernadas, con la misma lógica definida por dbt. Cuando una actualización diaria es suficiente, el pipeline por lotes ya es la respuesta más económica.
Conclusión
La estructura de la solución consiste en una división clara del trabajo. La lógica de transformación permanece en dbt, de forma modular y probada, mientras que los datos se mantienen en el formato abierto Delta Lake bajo un único modelo de gobernanza de Unity Catalog, de modo que el linaje y los controles de acceso sobreviven a cada reconstrucción de tablas y nada queda vinculado a un único motor de consultas. Esa lógica de dbt se compila en las características de Databricks creadas para escalar: liquid clustering, escrituras incrementales de Delta, poda dinámica de archivos y funciones geoespaciales H3. Realice diagnósticos a partir del plan de consulta real en lugar del SQL compilado, reduzca el número de filas que llegan a los costosos ordenamientos y shuffles, y ejecute el proyecto como un gráfico de tareas por modelo para que operaciones obtenga visibilidad y ejecuciones repetidas seguras con un bajo costo de procesamiento. Los mayores logros no provinieron de clusters más grandes, sino de realizar menos trabajo: procesar menos filas, recalcular menos activos y reconstruir la tabla con mucha menos frecuencia.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.