Unificación de la gobernanza en todos los motores y catálogos en el Lakehouse abierto
Cómo dos nuevas especificaciones de Apache Iceberg™ hacen que la gobernanza sea tan portable como tus datos
- Las restricciones de lectura y las etiquetas de catálogo son dos nuevas especificaciones de Apache Iceberg™ que ayudan a estandarizar cómo se aplican las políticas en diferentes motores y catálogos.
- Ambas adiciones eliminan la aplicación fragmentada. Las restricciones de lectura delegan las decisiones en motores de confianza; las etiquetas de catálogo hacen que los metadatos de gobernanza sean portables entre catálogos federados.
- Ahora existe un modelo claro para cada patrón de acceso: aplicación centralizada para motores no confiables, restricciones de lectura para los de confianza y etiquetas de catálogo para la federación de catálogo a catálogo.
En nuestras publicaciones anteriores, mostramos cómo los formatos de tabla abiertos, las API abiertas y la gobernanza unificada se están uniendo para completar la visión de Open Lakehouse. También presentamos el control de acceso basado en atributos entre motores, lo que permite que las políticas definidas en Unity Catalog se apliquen de manera coherente cuando los motores externos acceden a los datos gobernados.
Ahora, esa visión está comenzando a materializarse en el entorno de código abierto. La comunidad de Apache Iceberg™ presentó recientemente dos incorporaciones importantes a Iceberg REST Catalog: restricciones de lectura y etiquetas de catálogo. Juntas, abordan dos desafíos distintos: delegar la aplicación de políticas a un motor externo y hacer que el contexto de gobernanza sea portátil entre catálogos.
En esta publicación, analizaremos más de cerca ambas incorporaciones a la especificación: cómo funcionan, los desafíos clave que abordan, las oportunidades futuras de innovación y cuándo utilizarlas.
Restricciones de lectura: estandarización de la aplicación delegada
Las restricciones de lectura abordan un escenario común de motor a catálogo: una organización gobierna los datos en un catálogo y desea consultarlos desde varios motores o herramientas.
Para cualquier consulta gobernada, deben ocurrir tres cosas:
- El catálogo recibe la identidad del solicitante y el contexto relevante, como sujetos, grupos, roles o incluso atributos de identidad como 'región'
- Evalúa la política para decidir si el usuario puede leer la tabla y qué filtros de fila o máscaras de columna se aplican.
- Una capa de computación de confianza aplica esa decisión cuando se leen los datos.
Cuando se accede a los datos desde un motor, estas responsabilidades se pueden dividir de dos maneras.
Con la aplicación centralizada, los tres pasos permanecen dentro del entorno del catálogo. Por ejemplo, Databricks implementa un control de acceso detallado en computación dedicada mediante el enrutamiento transparente de consultas a través de un grupo de filtrado seguro. Y la función de ABAC entre motores de Unity Catalog extiende esta gobernanza a otros motores al colocar el grupo de filtrado detrás de las API de escaneo/planificación de Iceberg REST Catalog para depurar los datos antes de que un motor externo como Spark1 o DuckDB procese el resultado.
Con la aplicación delegada, el catálogo recibe la identidad del solicitante y evalúa la política, luego devuelve las restricciones de fila y columna resultantes a un motor en el que confía para aplicarlas. Aquí, la confianza significa que el catálogo puede confiar en que el motor aplicará las restricciones y evitará que los usuarios las evadan. Los motores como Spark y DuckDB no son de confianza cuando los usuarios controlan el entorno de ejecución porque esos usuarios pueden ejecutar código arbitrario o acceder directamente a los datos subyacentes. Una implementación de Trino configurada de forma segura es un ejemplo de un motor de confianza porque proporciona una aplicación nativa para filtros de fila y máscaras de columna.
La aplicación delegada requiere un contrato común entre el catálogo y el motor. La comunidad de Iceberg adoptó restricciones de lectura para proporcionar ese contrato.
Cómo funcionan las restricciones de lectura
Cuando un lector carga una tabla a través de Iceberg REST Catalog, el catálogo evalúa las políticas aplicables para el usuario principal solicitante y el contexto de la solicitud. Puede devolver las acciones de proyección de columnas y las expresiones de filtro de filas requeridas, y el motor de confianza debe aplicar esas restricciones a medida que lee la tabla.
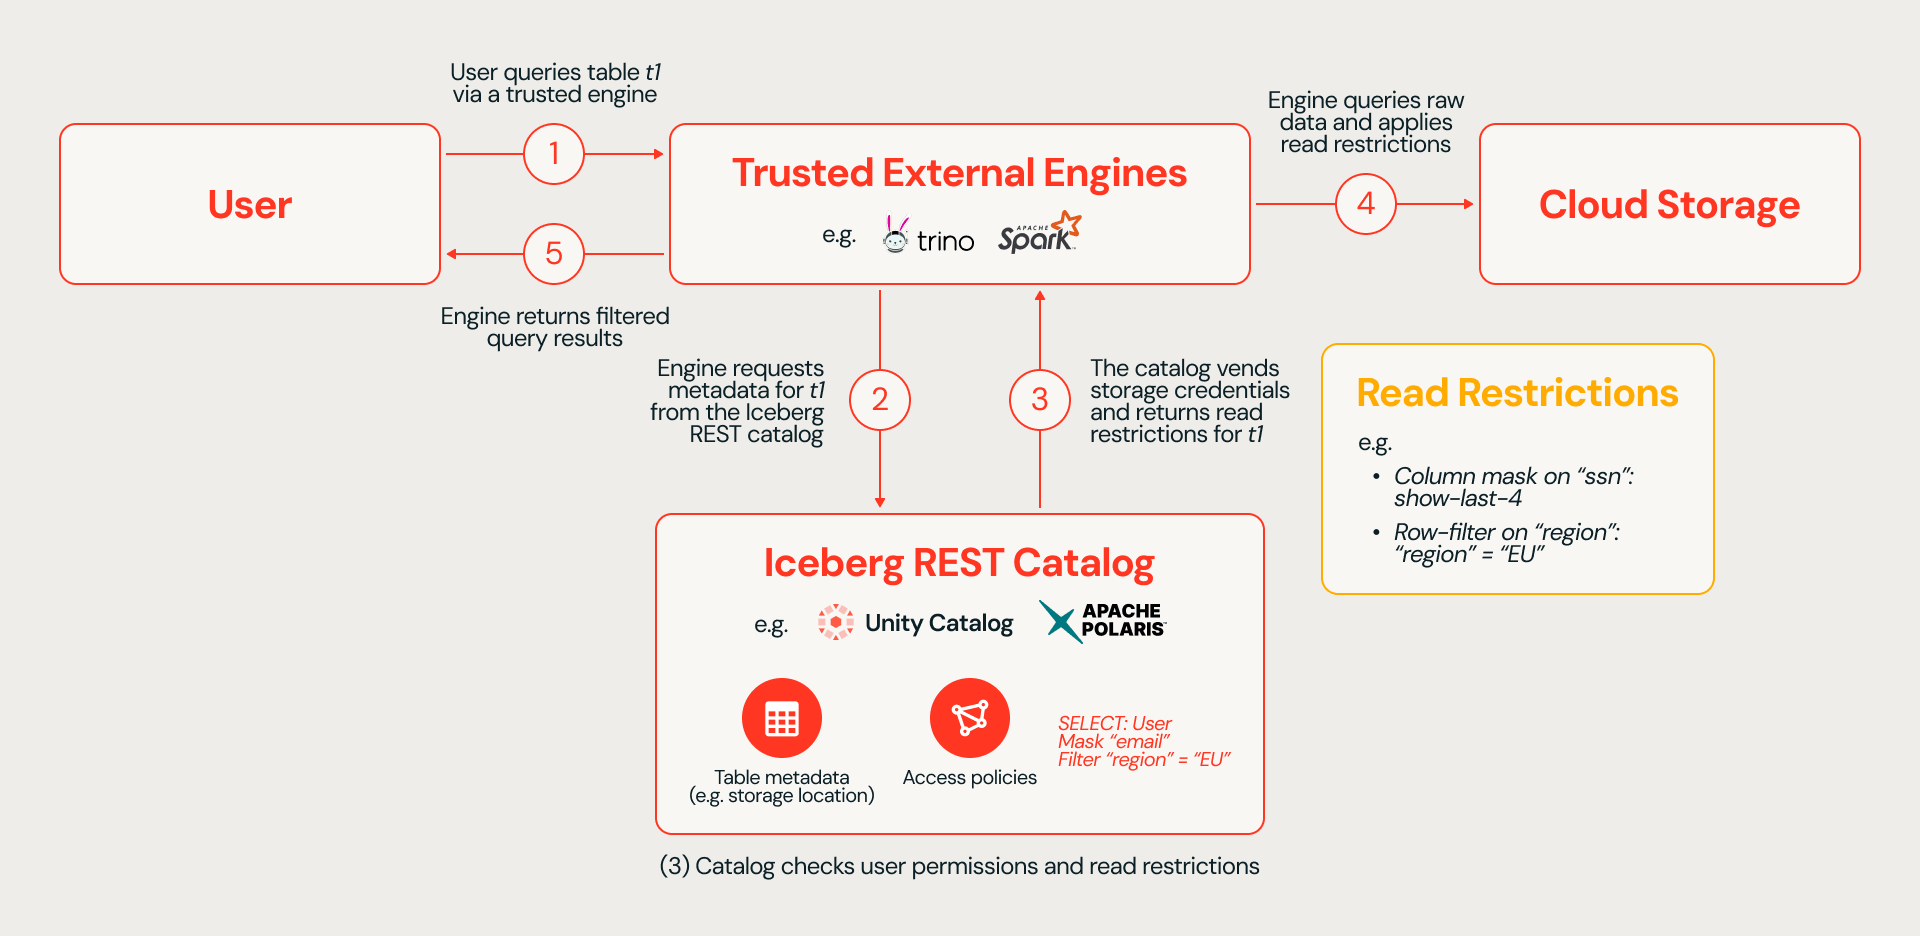
Dos decisiones de diseño son importantes para comprender el alcance actual de la propuesta.
Primero, el motor no recibe la política tal como la definió el administrador. En su lugar, recibe el resultado para un usuario principal en particular, expresado como instrucciones de filtrado o enmascaramiento que debe aplicar. Esto crea un contrato de aplicación común entre el motor y el catálogo. La especificación inicial define un vocabulario limitado: nueve acciones de proyección de columnas predefinidas y expresiones estandarizadas de filtro de filas como comparaciones o pertenencia a conjuntos. Muchas políticas empresariales del mundo real dependen de subconsultas, tablas de búsqueda o UDF personalizadas, que no se pueden expresar dentro del vocabulario de restricciones de lectura. Esto tiene una implicación importante: las políticas solo se pueden representar cuando el catálogo puede reducir su resultado al vocabulario definido por el estándar; de lo contrario, se pierde la semántica de la política.
Segundo, la especificación define lo que debe aplicar un motor de confianza, pero no cómo el catálogo establece esa confianza. Una reclamación del cliente no es suficiente, por lo que los administradores de sistemas y las implementaciones deben utilizar mecanismos de seguridad adecuados para su entorno. Las discusiones de la comunidad de Iceberg han considerado mecanismos como mTLS y OAuth, pero la confianza, en última instancia, permanece fuera del protocolo (discusión de la comunidad de Iceberg).
Las restricciones de lectura son más adecuadas para escenarios de acceso directo de motor a catálogo donde las políticas del catálogo de origen son simples y un motor de confianza puede aplicar la decisión resultante. Quedan muchas preguntas sobre la implementación, como por ejemplo cómo un motor propaga de forma segura la identidad y los atributos del usuario final, cómo un catálogo distingue al usuario del motor que actúa en su nombre y cómo se vinculan las credenciales a su destinatario previsto. A medida que surjan las implementaciones, nos entusiasma colaborar con la comunidad de Iceberg para superar estos desafíos y evolucionar el estándar.
Etiquetas de catálogo: hacer que el contexto de gobernanza sea portátil
Las etiquetas de catálogo abordan un escenario diferente: la gobernanza en catálogos federados.
Muchas empresas ahora conectan múltiples catálogos, como Unity Catalog, Snowflake, AWS Lake Formation y Google Cloud Knowledge Catalog, a través de la federación y las API abiertas. Esto es más complejo que una integración de motor a catálogo porque cada catálogo sirve a sus propios usuarios, aplicaciones y motores a través de distintos modelos de identidad, lenguajes de políticas y semánticas.
Cualquier solución de gobernanza unificada que funcione a escala empresarial debe:
- Preservar la expresividad de las políticas. Los clientes deben poder definir reglas sofisticadas, incluidas políticas basadas en atributos y subconsultas complejas, y aplicarlas de manera uniforme en sistemas heterogéneos.
- Proporcionar una auditabilidad y rendición de cuentas claras. Cada catálogo debe poder demostrar el cumplimiento de forma independiente sin necesidad de que los administradores concilien las trazas de auditoría en múltiples sistemas.
- Escalar sin colocar otro servicio de catálogo en la ruta crítica. El descubrimiento con reconocimiento de permisos en el Catálogo A no debería requerir una llamada al Catálogo B para cada usuario y recurso. Por ejemplo, la mayoría de las experiencias de usuario en Unity Catalog reconocen los permisos, y cargar el explorador de catálogos o proporcionar la búsqueda predictiva podría, de lo contrario, requerir miles de decisiones por usuario que son difíciles de almacenar en caché, lo que ralentiza la experiencia del usuario y vincula el rendimiento y la disponibilidad a otro servicio.
Las etiquetas de catálogo, adoptadas recientemente por la comunidad de Iceberg, son el primer paso hacia esta visión. Las etiquetas permiten que los catálogos intercambien metadatos ligeros de clave-valor a nivel de tabla y columna a través de APIs abiertas. Las etiquetas pueden indicar que un campo contiene PII, asociar un conjunto de datos con un dominio empresarial o proporcionar sugerencias semánticas para modelos de AI. Dado que la propuesta es general, las etiquetas pueden admitir muchos casos de uso más allá del control de acceso, incluidos el descubrimiento, la propiedad, la atribución de costos, el contexto de AI y la calidad de los datos.
Cómo funcionan las etiquetas de catálogo
Cuando un catálogo consumidor carga una tabla de un catálogo productor a través de la federación de catálogos, el catálogo productor devuelve etiquetas a nivel de tabla y columna.
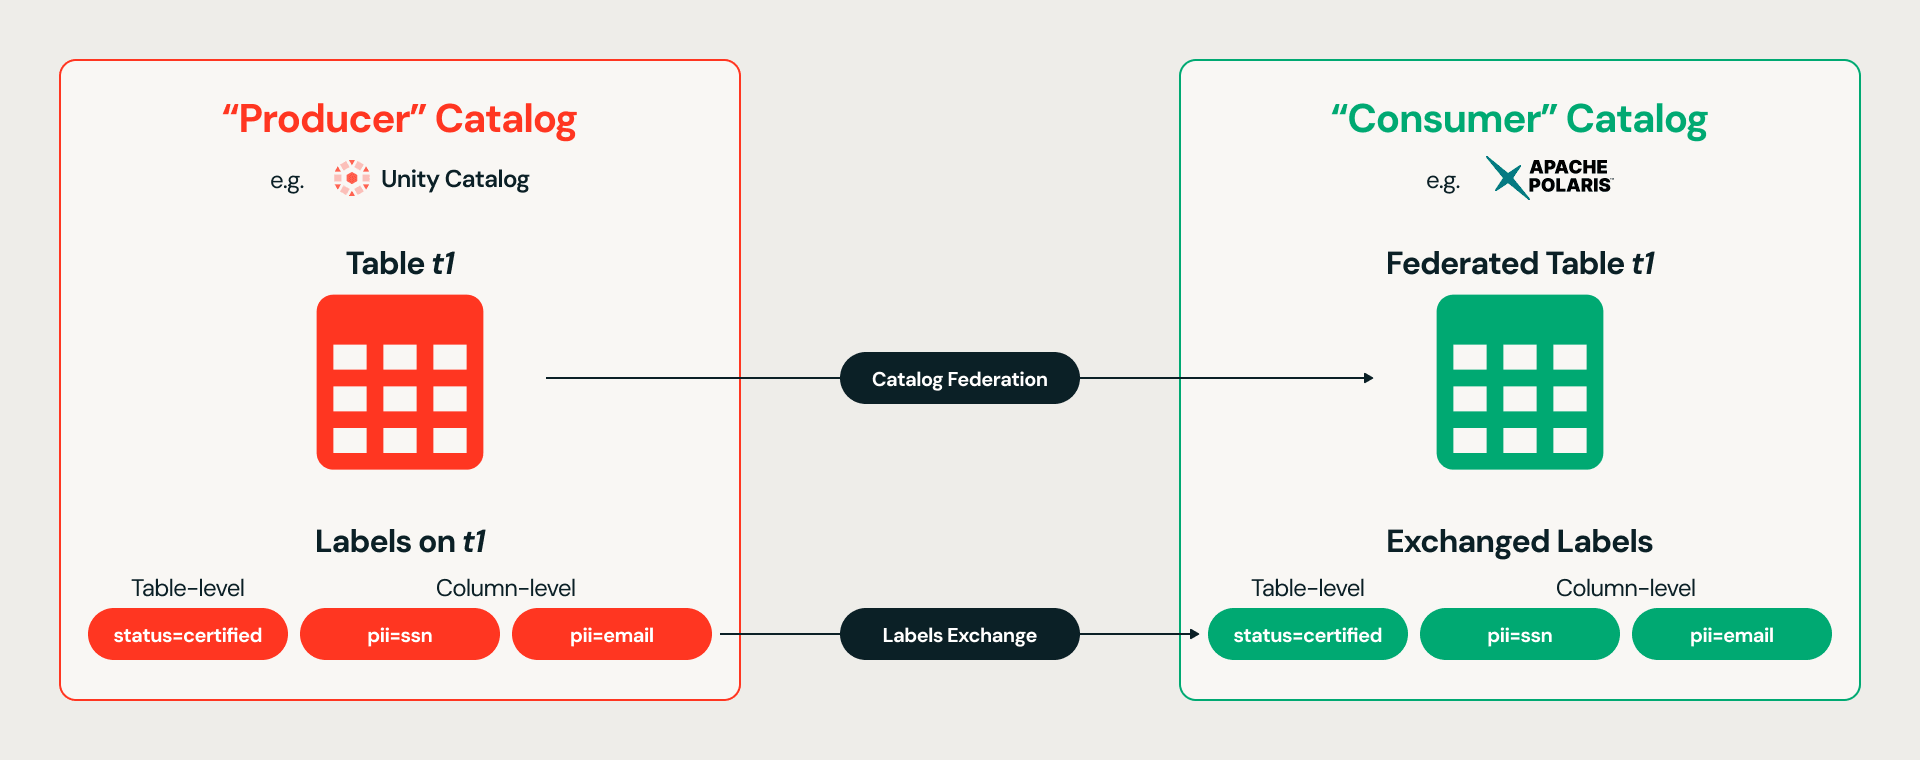
A continuación, el catálogo consumidor asigna las etiquetas a sus propias clasificaciones, atributos o modelo de etiquetas nativo. Luego, evalúa el acceso utilizando sus identidades y políticas nativas y aplica los controles dentro de su propio entorno de ejecución. Por ejemplo, si un catálogo productor etiqueta una columna ssn como pii=ssn, el catálogo consumidor puede aplicar una política basada en etiquetas que enmascare las columnas que llevan esa etiqueta.
Dado que la aplicación de las políticas sigue siendo local, el catálogo consumidor preserva la expresividad de sus políticas nativas y evita llamar al catálogo productor para cada decisión de acceso. Cada catálogo también mantiene de forma independiente sus registros de aplicación y su traza de auditoría.
Vale la pena tener en cuenta que las etiquetas son pares clave-valor opacos. El estándar no define una semántica compartida ni identificadores estables, y el linaje de las etiquetas no se extiende más allá del catálogo de origen. El catálogo consumidor solo recibe la clave y el valor resueltos, no si la etiqueta estaba destinada al descubrimiento, al control de acceso, a la atribución de costos o a otro propósito. Por lo tanto, las etiquetas hacen que los metadatos sean portables, pero no su significado; las empresas aún necesitan convenciones compartidas o asignaciones explícitas para interpretar las etiquetas de manera uniforme.
Las etiquetas de catálogo son más adecuadas para escenarios de catálogo a catálogo con federación entre sistemas heterogéneos, donde el catálogo consumidor tiene su propio sistema de gobernanza y necesita un contexto reutilizable en lugar de una decisión de acceso independiente para cada usuario y solicitud. La idea central es que la gobernanza y el contexto empresarial, al igual que los metadatos de las tablas, deben ser abiertos y portables a través de las APIs de Iceberg REST Catalog.
Elegir el modelo adecuado
El modelo adecuado depende del destino: aplicación centralizada para un motor no confiable, restricciones de lectura para un motor confiable y etiquetas de catálogo para el intercambio abierto de metadatos cuando el destino es otro catálogo con su propio sistema de gobernanza.
Aplicación centralizada mediante planificación de escaneo | Restricciones de lectura | Etiquetas de catálogo | |
Cómo funciona | El catálogo de origen evalúa y aplica la política a través de un servicio de filtrado seguro, devolviendo solo los datos autorizados | En el momento de la consulta, el catálogo le indica al motor qué restricciones aplicar para este usuario y recurso en particular; por ejemplo, "aplicar mask_alphanum en la columna 12" | Los catálogos comparten información comercial o de gobernanza adicional sobre una tabla determinada; por ejemplo, "la columna 12 tiene la clasificación pii=ssn" |
Ideal para | Acceso directo desde un motor no confiable, como un entorno de ejecución de Spark o DuckDB controlado por el usuario | Acceso directo de motor a catálogo donde el origen evalúa la política y un motor confiable aplica el resultado | Federación entre sistemas heterogéneos con su propia identidad, política y entorno de ejecución de aplicación |
Identidad y seguridad | El cliente debe traducir y pasar los conceptos de identidad (roles, grupos, etc.) al catálogo. La aplicación permanece dentro del límite de confianza del catálogo, por lo que los datos no autorizados nunca llegan al motor. | El cliente debe traducir los conceptos de identidad (principales, roles, grupos, atributos de usuario) a algo que el catálogo entienda y pasar estos atributos como parte del contexto de la solicitud | El destino utiliza las identidades y los atributos que ya entiende, lo que reduce el contexto confidencial que se intercambia entre los sistemas |
Escala, rendimiento y disponibilidad | La planificación de escaneo en el lado del servidor puede optimizar el acceso a los datos, pero enrutar las consultas gobernadas a través de una flota de filtros agrega latencia y una dependencia operativa en comparación con la aplicación en el motor consumidor. | El catálogo de destino ya no puede reutilizar una tabla almacenada en caché entre sus usuarios porque las respuestas de las tablas se vuelven específicas de cada usuario. Esto hace que experiencias como la navegación, la búsqueda y el autocompletado requieran una caché por usuario o requieran una llamada independiente al catálogo de origen para cada acción del usuario. | El contexto de gobernanza se puede almacenar en caché y actualizar para que la búsqueda, la navegación y otras experiencias de usuario funcionen de forma nativa |
Gobernanza y auditabilidad | El catálogo de origen conserva toda la expresividad de sus políticas nativas y registra la evaluación y aplicación de las políticas dentro del mismo entorno de confianza | Las decisiones se limitan al vocabulario compartido del estándar. Los registros de auditoría se dividen entre los sistemas de origen y de destino. | El destino utiliza su motor de políticas nativo y mantiene un registro de extremo a extremo de la evaluación y aplicación |
En resumen | Úselo cuando el catálogo de origen deba garantizar que los datos no autorizados nunca lleguen a un motor no confiable | Úselo cuando el destino sea un motor confiable y las políticas de origen se puedan expresar por completo con restricciones de lectura | Úselo cuando el destino sea otro catálogo que necesite una gobernanza escalable a velocidad nativa entre sus usuarios y motores |
Qué viene a continuación
Las restricciones de lectura y las etiquetas de catálogo resuelven dos problemas distintos e importantes para la gobernanza multiplataforma. Las restricciones de lectura ofrecen a los catálogos una forma estándar de delegar la aplicación a motores confiables. Las etiquetas de catálogo hacen que la gobernanza y el contexto empresarial sean portables entre catálogos, al igual que sus datos. Junto con la aplicación centralizada a través de Cross-Engine ABAC, estas ofrecen a las empresas un conjunto práctico de opciones para gobernar los datos de manera uniforme en todos los motores y catálogos.
Felicitaciones a la comunidad de Apache Iceberg por adoptar ambas propuestas. Aunque queda mucho trabajo por delante, este es un gran hito. Nos entusiasma ver que más partes del ecosistema adopten estos componentes fundamentales y seguir trabajando con la comunidad para hacer realidad la gobernanza unificada en el lakehouse abierto.
1La propia guía de seguridad de Apache Spark establece que el código enviado por el usuario se ejecuta sin restricciones en su comportamiento y les da a los usuarios el control sobre los recursos asignados a su aplicación. Una extensión de Spark puede implementar restricciones de lectura, pero la implementación se considera confiable solo cuando los administradores controlan el entorno de ejecución y eliminan cualquier vía alternativa para evadir la aplicación de políticas, ya que carece de una API de control de acceso a nivel de tabla, y mucho menos de una para el control de acceso detallado (discusión de la comunidad de Iceberg).
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.