O verdadeiro gargalo do imageamento biomédico são os dados, não o modelo
Dos silos de PACS à multiômica: por que a IA de imageamento estagna nos dados e como construir a base para desbloqueá-la.
por Parastou Eslami e Douglas Moore
- O que é: Uma perspectiva prática sobre por que a IA de imagens médicas fica aquém do esperado em hospitais, na academia, em medtechs e na indústria farmacêutica; e como é uma base de dados mais sólida em R&D.
- O desafio: As imagens são os dados mais ricos da medicina, mas os menos utilizáveis: isoladas em PACS, CROs e laboratórios centrais, difíceis de desidentificar e raramente vinculadas a outras modalidades de dados que impulsionam biomarcadores e a estratificação de pacientes. A parte difícil são os dados, não o modelo.
- A principal lição: A fronteira não é ter um modelo melhor, é a base de dados por trás dele. Governe exames de imagem em um só lugar, torne-os consultáveis, desidentifique em escala e conecte-os a dados de EHR, ômica e ensaios clínicos (por meio de padrões de lakehouse governados). Acerte nos dados, e o modelo se torna a parte fácil.
Parte I — O problema
Quatro setores, um gargalo
Hospitais e sistemas de saúde geram a matéria-prima. A radiologia é o setor da IA médica mais fortemente regulamentado no mundo: dos cerca de 950 dispositivos com suporte a IA/ML autorizados pela FDA até meados de 2024, cerca de 723 (aproximadamente 76%) eram ferramentas de radiologia. Quase todas são específicas e supervisionadas por humanos, realizando triagem, medição, reconstrução ou priorização de listas de trabalho. A verdadeira dificuldade em um hospital raramente é o modelo. É que os dados ficam bloqueados em PACS e arquivos neutros de fornecedores criados para exibir imagens em um visualizador, não para responder a perguntas de pesquisa. Extrair uma coorte significa extrair imagens dos sistemas clínicos, desidentificá-las (PHI se esconde nos cabeçalhos DICOM e fica gravado nos pixels) e encontrar o poder de computação para usá-las. O modelo é os 10% fáceis.
Centros médicos acadêmicos são onde a maior parte da ciência aberta acontece. O campo deve grande parte do seu progresso a conjuntos de dados compartilhados como MIMIC-CXR (377.110 radiografias de tórax), The Cancer Imaging Archive, fastMRI e a divisão de imagens do UK Biobank, além de ferramentas abertas como MONAI, nnU-Net e 3D Slicer. A academia também expõe o problema de credibilidade da área. Uma revisão conhecida do BMJ (Nagendran et al., 2020) sobre estudos de imagens comparando deep learning com clínicos descobriu que, de 81 estudos, apenas alguns eram prospectivos ou testados em um ambiente clínico real, e o código e os dados não estavam disponíveis em 93% e 95% deles. Essa dívida de reprodutibilidade deriva diretamente da dificuldade de compartilhar e reexecutar dados de imagem.
Empresas de medtech e dispositivos (GE HealthCare, Siemens Healthineers, Philips, Canon) incorporam IA diretamente no scanner: reconstrução com deep learning que encurta os exames, redução de dose, triagem no próprio dispositivo. Seu problema mais difícil é a generalização. Um algoritmo treinado em um scanner, intensidade de campo e protocolo de um fabricante pode degradar silenciosamente no de outro. Curar dados de treinamento multisite que representem o mundo real e, em seguida, comprovar isso aos órgãos reguladores por meio dos processos 510(k) e PMA, é tanto o diferencial competitivo quanto o custo.
Empresas farmacêuticas e de biotecnologia tratam a imagem como um instrumento de medição. Ensaios oncológicos dependem de critérios de resposta padronizados, como RECIST, iRECIST e RANO, analisados de forma centralizada e cega para eliminar o viés de local, e biomarcadores de imagem quantitativos podem identificar a resposta a medicamentos antes de medidas baseadas no tamanho. Nada disso funciona a menos que uma medição signifique a mesma coisa em diferentes locais, scanners e momentos, e é por isso que a QIBA da RSNA cria perfis que definem a aquisição e a análise com uma precisão determinada. A variabilidade é a inimiga dos endpoints de um ensaio clínico.
Quatro tarefas diferentes, um gargalo compartilhado. Os pixels estão em toda parte e não podem ser consultados em lugar nenhum.

Por que a colaboração é tudo e por que ela é tão difícil
Nenhuma instituição sozinha possui dados diversificados o suficiente para construir um modelo que generalize. O estudo colaborativo mais robusto até o momento comprova isso. No estudo EXAM (Nature Medicine, 2021), 20 instituições treinaram um modelo compartilhado para prever as necessidades de oxigênio para COVID-19 a partir de radiografias de tórax e dados de EMR, sem mover nenhum dado de paciente entre elas. Apenas os pesos do modelo trafegaram, e o modelo federado obteve, em média, um ganho de 16% em AUC e 38% em generalização em relação aos modelos de local único. A mecânica é menos exótica do que parece: cada local treina localmente, um coordenador faz a média dos pesos do modelo em vez dos dados (a receita clássica de média federada) e a agregação segura e a privacidade diferencial evitam que os registros de qualquer local sejam reconstruídos a partir desses pesos.
Essa é a promessa. A realidade é que a colaboração é realmente difícil, por razões mais estruturais do que técnicas:
- Heterogeneidade dos dados. Diferentes scanners, protocolos e convenções de rotulagem significam que "o mesmo" exame muitas vezes não é o mesmo. Os modelos federados degradam com esses dados não IID e distorcidos pela aquisição, a menos que sejam propositalmente ajustados com técnicas como média de normalização de lote ou harmonização consciente do local.
- Privacidade e governança. Todo estudo interinstitucional exige aprovações do IRB por local, acordos de uso de dados e uma desidentificação que precisa ser defensável.
- Nenhum substrato comum. Consórcios como o MIDRC (co-liderado pelo ACR, RSNA e AAPM) existem justamente porque a ingestão, curadoria, desidentificação, rotulagem e compartilhamento são tão difíceis que exigem um esforço nacional dedicado.
A colaboração em exames de imagem não é um mero diferencial. É o único caminho para modelos que funcionem fora do edifício onde foram treinados, e é quase inteiramente limitada pelo encanamento de dados e governança.
A complexidade que a maioria das pessoas fora da área nunca vê
Quando as pessoas dizem "imagens médicas", elas geralmente imaginam uma radiografia de tórax. A realidade é uma infinidade de formatos e escalas que faz as ferramentas de dados de uso geral falharem.
| Tipo de imagem | Formatos | Dimensões e escala | Por que as ferramentas de uso geral falham |
|---|---|---|---|
| Radiologia — raio X, TC, RM | DICOM, codificável em cerca de uma dúzia de sintaxes de transferência (não compactado → JPEG 2000 → HTJ2K) | Raio X 2D → volumes 3D de TC/RM → cardíaco dinâmico 4D | Criado para mover estudos entre máquinas, não para analisar em massa; decodificadores (pydicom, GDCM, pylibjpeg) executam em thread única — alguns estudos são triviais, alguns milhões tornam-se um problema de sistemas distribuídos |
| Patologia digital — imagens de lâminas inteiras | Formatos de fornecedores: Aperio .svs, Hamamatsu .ndpi, Philips iSyntax (via OpenSlide); quase nenhum DICOM | Gigapixel — múltiplos GB, dezenas de milhares de blocos, lidos como uma pirâmide em várias ampliações | Muito grande para abrir na memória; a coloração e as cores do scanner variam de laboratório para laboratório, tornando-se uma fonte própria de erro no modelo |
| Oftalmologia, dermatologia e outros | Volumes de OCT, fotografia clínica, cada um com suas próprias convenções | 2D e 3D, específicos por modalidade | Mais um conjunto de formatos que uma ferramenta feita para pastas de JPEGs nunca foi projetada para manipular |
"Imagens médicas" não é uma coisa só — é uma infinidade de formatos e escalas. Os arquivos de pesquisa chegam a petabytes, o suficiente para que sua desidentificação em escala seja uma linha de pesquisa publicada por si só.
Existe um segundo tipo de complexidade que prejudica silenciosamente os estudos: os próprios números não são comparáveis entre locais. Um valor de captação padronizado ou um volume tumoral medido em dois scanners com dois protocolos não são a mesma medição. É por isso que a imagem quantitativa se apoia em padrões como os perfis da QIBA e as definições da IBSI para recursos de radiômica, e por que a reprodutibilidade, e não a precisão bruta, costuma ser o ponto de falha.
Uma ferramenta que lida com uma pasta de JPEGs não consegue lidar com nada disso, o que explica em grande parte por que a área de imagens ficou atrás da genômica e dos dados de EHR para se tornar pronta para análise.
A imagem é o aspecto mais crítico de um problema maior
O que é fácil passar despercebido quando o foco permanece apenas nas imagens: tudo o que foi dito aqui também se aplica ao restante de P&D. A imagem é apenas onde a dor aparece primeiro, porque os dados são os maiores e os mais incomuns.
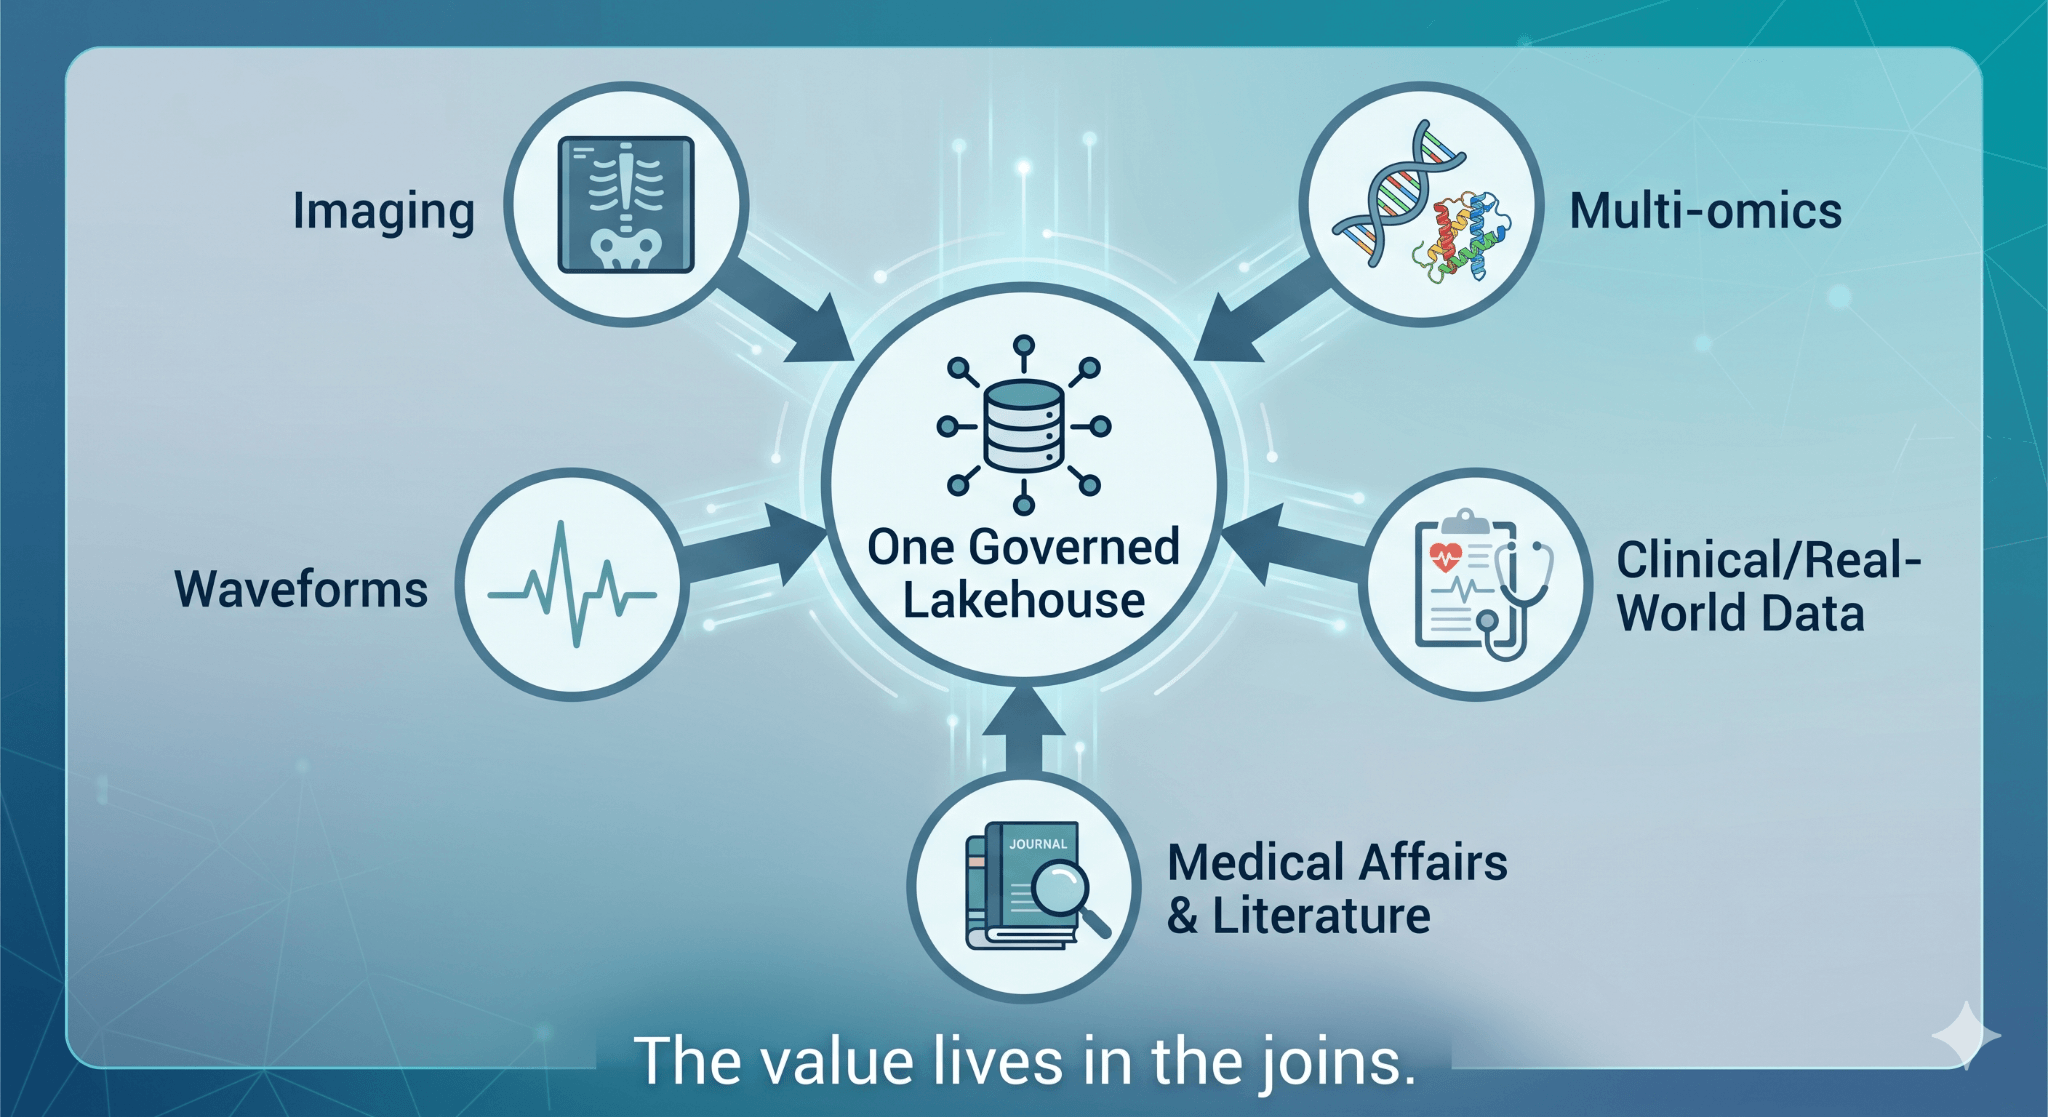
Entre em uma organização de P&D de ciências da vida hoje e a verdadeira fronteira não será um único tipo de dado. É a multiômica: a genômica, a transcriptômica, a proteômica e a metabolômica, que chegam cada uma com seus próprios formatos e silos. São dados do mundo real e de ensaios clínicos, EHRs, registros e formas de onda. São os assuntos médicos e a literatura. As perguntas que realmente impulsionam um programa — quais pacientes respondem e por quê, o que a imagem somada à assinatura molecular e ao resultado dizem juntas — estão na junção desses domínios, não dentro de apenas um deles.
Cada um desses tipos de dados carrega a mesma complicação das imagens. É rico, de alta dimensão, em grande parte não estruturado, preso em sistemas específicos de um domínio, difícil de governar e ainda mais difícil de vincular. Uma imagem de lâmina inteira, uma chamada de variante genômica e um endpoint de ensaio clínico já são bastante difíceis por si só. O valor vem de colocá-los na mesma frase. Esse é um problema de base de dados antes de ser um problema de IA, e é o que as equipes mais subestimam.
Esta não é apenas uma história da área da saúde. Uma análise recente da Bain sobre o motivo pelo qual os orçamentos de IA continuam subindo enquanto os retornos não acompanham, revelou que o acesso e a integração de dados é a maior barreira isolada para a IA, citada por 41% das empresas e mencionada ainda mais vezes pelos líderes do que pelos retardatários. A versão direta deles: a maioria das organizações ainda não consegue acessar com confiabilidade seus próprios dados. A medicina apenas torna mais difícil ignorar essa realidade.
Parte II — A base
É aqui que as coisas ficam mais concretas e técnicas. Para os leitores que não estão construindo a plataforma, a versão resumida é simples: governe tudo em um só lugar, torne os pixels consultáveis, desidentifique em escala e vincule as imagens ao restante dos dados do paciente. O restante desta seção explica como.
O que a base de dados realmente precisa fazer
Eliminando as especificidades de cada setor, os requisitos são os mesmos. A plataforma precisa:
- Governar arquivos de imagem não estruturados e seus metadados extraídos em um só lugar, com controle de acesso, linhagem e auditabilidade capazes de responder às exigências dos órgãos reguladores.
- Processar dados em escala de petabytes, de gigapixels e multidimensionais (raios X 2D, volumes de TC/RM 3D, estudos dinâmicos 4D, lâminas de patologia em gigapixels) sem falhas de desempenho.
- Desidentificar em escala, tanto nos cabeçalhos quanto nos pixels.
- Vincular imagens a prontuários eletrônicos (EHR), genômica, formas de onda e texto, para que uma única pergunta de pesquisa possa abranger todos eles.
- Tornar o compartilhamento interinstitucional uma etapa de configuração, e não uma negociação de seis meses.
Esse é o formato de um lakehouse. Veja como isso se mapeia na prática, usando padrões que funcionam no Databricks.
Uma arquitetura medalhão para Pixels
O modelo mental que torna o processamento de imagens viável é o mesmo padrão medalhão que as equipes já usam para dados tabulares, adaptado para arquivos binários.
- Bronze: os estudos brutos chegam primeiro a um armazenamento de objetos na nuvem com acesso restrito ou Volume, onde um trabalho de desidentificação é executado nos cabeçalhos e pixels antes de qualquer outra coisa; os arquivos desidentificados formam então a camada bronze governada nos Volumes do Unity Catalog, com uma linha de catálogo por arquivo, e o Auto Loader gerenciando a chegada incremental para que novos estudos fluam continuamente, em vez de em lotes noturnos frágeis.
- Silver: as tags DICOM com valores de texto são extraídas para tabelas Delta (blobs binários, como os dados de pixels, permanecem no arquivo), tornando os metadados que estavam presos nos arquivos consultáveis com SQL simples. Esta é a etapa que transforma "um visualizador pode abrir" em "um analista pode consultar". O acelerador de código aberto Pixels faz exatamente isso, catalogando arquivos em paralelo e extraindo tags em escala.
- Gold: coortes curadas e prontas para análise, unidas a tabelas clínicas e ômicas, prontas para treinamento, BI ou estudos regulatórios.
A razão pela qual isso não é trivial é o throughput. As bibliotecas de parsing de DICOM usam um único núcleo; o truque é distribuí-las. Na prática, isso significa UDFs do pandas e mapInPandas para distribuir o parsing em um cluster ou uma fonte de dados personalizada do Spark. Em um trabalho publicado pela equipe do Pixels, uma fonte de dados zipdcm lê os metadados DICOM diretamente de arquivos zip na memória, mantendo os arquivos originais compactados no local: ela catalogou mais de 107.000 DICOMs em cerca de 3,5 minutos em dois workers de 8 núcleos, aproximadamente 7 vezes mais rápido do que as abordagens anteriores. O gargalo deixa de ser a E/S de disco e rede para ser o parsing puro de CPU, exatamente o tipo de coisa em que um cluster se destaca.

Governança que resiste a uma auditoria
A análise de imagens é o maior problema de governança de dados não estruturados, e é o requisito em que a maioria das plataformas falha silenciosamente. Os Volumes do Unity Catalog governam os arquivos brutos no S3, ADLS ou GCS em um namespace de três níveis, enquanto os metadados extraídos são salvos no Delta. Ambos estão sob um único modelo de controle de acesso e linhagem que se estende até os modelos treinados com os dados, permitindo responder meses depois a perguntas como "quem acessou esta coorte e o que foi criado a partir dela". A segurança em nível de linha e coluna e as regras baseadas em atributos permitem que uma organização exponha metadados desidentificados de forma ampla, mantendo os pixels subjacentes protegidos.
A desidentificação é onde isso se torna crítico. As PHI do cabeçalho são tratadas com criptografia com preservação de formato (FPE), para que o mesmo identificador de paciente sempre corresponda ao mesmo pseudônimo. Esse detalhe importa mais do que parece: significa que a TC de um paciente ainda pode ser vinculada à sua patologia e exames laboratoriais em vários conjuntos de dados sem nunca expor o identificador real. Os perfis de confidencialidade do padrão DICOM definem o que remover e o que manter. O problema mais difícil são as PHI gravadas nos pixels, como o nome do paciente impresso em um ultrassom ou formulário digitalizado. Ferramentas clássicas como o Presidio lidam bem com texto livre, mas ignoram imagens. Remover essas PHI gravadas é um problema de pesquisa ativo: trabalhos recentes mostram que os modelos de linguagem e visão (VLMs) agora superam os pipelines exclusivos de OCR na detecção e ocultamento dessas informações (Lee et al., Radiology 2025), e métodos de desidentificação em produção que combinam a sanitização de metadados DICOM com OCR direcionado em texto gravado foram validados em centenas de milhares de imagens em dez modalidades (Macdonald et al., 2024). Para os pixels, a equipe do Pixels publicou um pipeline de modelo de linguagem e visão que combina OCR com um VLM e executa de forma distribuída com UDFs do pandas. Em uma amostra balanceada do benchmark MIDI-B, o GPT-4o e o Claude 3.7 Sonnet atingiram aproximadamente 100% de recall e precisão, o Llama 4 Maverick aberto alcançou 100% de recall a uma fração do custo, e o Spark reduziu a desidentificação de 1.000 quadros de 105 minutos para 6. A equipe também está explorando uma abordagem mais enxuta, apenas com VLM, para ir ainda mais longe.
Treinamento e servimento, sobre os mesmos dados governados
Assim que os pixels se tornam consultáveis e governados, a camada de ML deixa de ser a parte difícil. Os modelos de segmentação e classificação se registram no mesmo catálogo como modelos do MLflow, mantendo sua linhagem até a coorte exata em que foram treinados. Para imagens especificamente, o NVIDIA MONAI e o VISTA-3D (um modelo de segmentação base que abrange 127 classes anatômicas) se conectam para autosegmentação e ajuste fino, com um visualizador OHIF incorporado em um Databricks App para que um radiologista ou patologista possa revisar, corrigir e rotular novamente sob o modelo de segurança da plataforma.
O loop de aprendizado ativo do MONAI Label significa que cada correção melhora o lote seguinte, permitindo que as equipes evitem a armadilha de precisar de um conjunto de dados totalmente anotado antes de começar. A inferência é executada como servimento de modelo em GPU em tempo real (com redução a zero quando inativo para que um modelo raramente usado não consuma GPU) ou como inferência em lote distribuída em milhões de estudos. E como os trabalhos mais recentes do Pixels incluem um serviço DICOMweb (QIDO-RS, WADO-RS, STOW-RS), o lakehouse pode se integrar diretamente a um fluxo de trabalho clínico ou PACS/VNA, em vez de ficar isolado.
Provando a segurança: validação, drift e o caminho regulatório
Treinar um modelo é o começo, não o fim. Um modelo com ótimo desempenho no scanner de um local pode degradar silenciosamente no de outro; portanto, o trabalho real é a validação externa em diferentes locais, fornecedores e protocolos, além do monitoramento de drift à medida que os scanners são atualizados e os protocolos mudam em produção. O MLflow lida com a avaliação e o rastreamento; a disciplina mais difícil é tratar cada modelo como um ativo versionado, acompanhado de sua coorte, métricas e aprovações. Para qualquer solução voltada ao uso clínico, os órgãos reguladores começaram a se adaptar à IA adaptativa. O Plano de Controle Pré-determinado de Mudanças (PCCP) da FDA permite que as equipes pré-especifiquem como um modelo pode ser retreinado e atualizado sem a necessidade de uma nova submissão a cada mudança, enquanto as Boas Práticas de Aprendizado de Máquina (GMLP) estabelecem expectativas para dados, validação e monitoramento. Construir essas proteções na base de dados, em vez de adicioná-las posteriormente, é o que separa uma demonstração de uma solução pronta para implantação hospitalar.
Colaboração sem mover os dados
Existem duas maneiras complementares de obter a diversidade interinstitucional que o EXAM demonstrou ser necessária, e elas resolvem problemas diferentes.
O aprendizado federado mantém os dados fisicamente no local e move apenas os pesos do modelo, usando a média federada para combiná-los e agregação segura com privacidade diferencial para evitar que os dados de qualquer local vazem. É a ferramenta certa quando os dados legalmente não podem ser movidos.
O lakehouse adiciona uma segunda opção que costuma ser mais simples na prática: o Delta Sharing e os Clean Rooms permitem que as instituições compartilhem tabelas e arquivos governados (ou executem análises conjuntas em coortes desidentificadas) sem copiar nada, usando a emissão de credenciais (credential vending) em vez da exportação de dados. Para muitas pesquisas multilocal, "compartilhar uma visualização governada da coorte" é uma tarefa muito mais leve do que estruturar um anel de treinamento federado, e as duas abordagens podem ser combinadas.
Tornando a imagem multimodal
Este é o requisito que transforma o exame de imagem de uma modalidade isolada em parte do histórico do paciente. Como os metadados estão no Delta, as imagens podem ser unidas a feeds FHIR e HL7 do EHR, a tabelas de variantes genômicas, a formas de onda e a textos clínicos, com a identidade do paciente resolvida por meio da camada de pseudonimização. Modelos de dados comuns como o OMOP fornecem um esquema compartilhado para armazenar dados observacionais. Além disso, o Vector Search indexa embeddings para recuperação semântica (o Pixels inclui até uma função que mapeia um termo em linguagem natural para a tag DICOM correta), e ferramentas de linguagem natural como o Genie permitem que um cientista crie uma coorte apenas fazendo uma pergunta, sem precisar escrever SQL.
Formas de onda fisiológicas são um tipo próprio de dado. Um ECG, um traçado de pressão arterial ou um pullback de IVUS ou OCT é uma série temporal de alta frequência amostrada centenas ou milhares de vezes por segundo, geralmente armazenada em formatos como WFDB em vez de DICOM. O desafio técnico é o alinhamento: um frame de pullback ou um batimento de ECG só faz sentido quando está sincronizado no tempo com a imagem e com o evento clínico a que pertence. Fazer isso corretamente, reamostrar, reconciliar carimbos de data/hora (timestamps) e armazenar a série junto ao estudo é exatamente o tipo de junção que traz resultados quando a pergunta é por que um paciente respondeu, e não apenas se respondeu.
Embeddings também desbloqueiam algo mais poderoso do que a busca. Modelos de imagem e texto treinados em exames e laudos pareados (a linha de trabalho do BiomedCLIP e CheXzero) colocam imagens e linguagem em um espaço vetorial compartilhado, para que os sistemas possam recuperar casos semelhantes, sinalizar achados sem um rótulo explícito ou embasar um modelo gerativo nas imagens e laudos anteriores reais de um paciente, em vez de apenas em seus dados de treinamento. Esse último padrão, a geração aumentada por recuperação sobre imagens e laudos, é o que torna o rascunho de laudos e a sumarização de casos confiáveis o suficiente para serem mostrados a um médico: o modelo pode apontar para o que viu. Isso só funciona quando as imagens, os laudos e seus embeddings estão juntos sob um único teto governado, o que é este artigo inteiro em miniatura.
Isso também é o que a nova onda de modelos de fundação precisa. O Prov-GigaPath (Nature, 2024), pré-treinado com auto-supervisão em 1,3 bilhão de tiles de 171.189 imagens de lâmina inteira, só funciona com dados grandes, diversos, governados e multimodais. Os silos não conseguem alimentá-lo. Um lakehouse consegue.
O retorno: um co-cientista para o pesquisador, um parceiro para o clínico
A versão tangível de tudo isso não é um sistema autônomo que substitui alguém. É um parceiro, um co-cientista de IA para o pesquisador e um copiloto para o clínico, embasado nos próprios dados governados da instituição, em vez da internet aberta.
Para um pesquisador, um agente co-cientista transforma uma pergunta em trabalho. Peça a ele para "encontrar pacientes com CPNPC virgens de tratamento com TC inicial, patologia correspondente e status de EGFR, e depois resumir como as lesões mudaram no acompanhamento", e ele planeja as etapas, consulta as tabelas clínicas e de imagem por meio de um espaço Genie, recupera casos semelhantes com o Vector Search, chama um endpoint de segmentação para medir as lesões e embasa seu resumo na literatura relevante, com cada afirmação rastreável até os dados utilizados.
A classe emergente de sistemas de "co-cientistas de IA" visa exatamente isso: ajudar a gerar e triar hipóteses, não apenas responder a consultas. O que separa um brinquedo de um colaborador de confiança é se ele é construído sobre dados governados e multimodais.
Para um clínico, a mesma estrutura se torna um parceiro que faz o trabalho pesado que um radiologista ou oncologista faria manualmente: buscar os exames anteriores do paciente, medir e comparar lesões, apresentar os critérios de diretrizes aplicáveis e rascunhar o laudo para revisão. Ele nunca assina o laudo; o ser humano assina. Isso não é uma limitação, é o design. Quase todas as IAs de imagem aprovadas hoje são supervisionadas por humanos, e um parceiro que mostra seu trabalho e cita suas fontes é o que torna essa supervisão real, em vez de um mero carimbo de aprovação.
O que torna qualquer um deles seguro é a base por trás. Cada ferramenta que o agente chama é um objeto governado, uma função do Unity Catalog, um endpoint de modelo em execução, um índice do Vector Search, um espaço Genie; portanto, os mesmos controles de acesso, linhagem e identidade de representação que protegem os pixels também delimitam o que o agente pode ver e fazer. Componha especialistas — um agente de radiologia, um agente de genômica, um agente de assuntos médicos — sob um supervisor, e a equipe de agentes espelhará as junções multimodais que a base de dados já possibilita. O parceiro é a parte fácil, uma vez que a base esteja correta.
Além da imagem: a mesma base sustenta o restante de P&D
A razão pela qual isso importa além da radiologia é que exatamente a mesma arquitetura absorve o restante do ecossistema de dados de P&D. A multiômica (genômica, transcriptômica, proteômica, metabolômica) chega ao mesmo Unity Catalog ao lado de dados clínicos e de imagem. Ela traz seus próprios formatos e padrões pesados — VCF para variantes, BAM e CRAM para leituras de sequenciamento alinhadas, as especificações da GA4GH que os mantêm interoperáveis e mecanismos como Glow e Hail para análise em escala populacional —, mas o padrão de lakehouse é idêntico: governar os arquivos, extrair a camada consultável e juntá-la a todo o resto.
É também aqui que a stack da NVIDIA, como BioNeMo e NIMs, se conecta para modelos de sequência e estrutura. Dados do mundo real, dados de ensaios clínicos, registros e formas de onda se juntam a coortes de imagem sem a necessidade de exportação. Assuntos médicos e a literatura se tornam textos consultáveis sob a mesma governança e a mesma interface de AI/BI e Genie. Os programas que avançam — aqueles que respondem quais pacientes respondem e por quê — vivem nas junções entre esses domínios, e um lakehouse é a rara arquitetura que mantém uma lâmina gigapixel, uma chamada de variante e um endpoint de ensaio clínico sob um único modelo de governança e permite que sejam consultados juntos.
O resultado final

As equipes que constroem IA e GenAI sobre esse tipo de dado continuam aprendendo a mesma lição. Um modelo pode parecer ótimo em uma demonstração em uma semana. O que leva meses depois é deixar os dados limpos, vinculados, desidentificados e governados o suficiente para confiar neles diante de um cientista ou órgão regulador. O problema dos dados não é a parte sem brilho do projeto. Ele é o projeto.
Analisando dados de imagem, ômica, clínicos e de assuntos médicos dentro das mesmas organizações, a conclusão é simples. A fronteira na imagem médica não é uma arquitetura melhor. É uma base melhor. Os algoritmos existem. Os dados existem, em algum lugar. O que estava faltando era uma maneira de tornar as imagens governadas, consultáveis, vinculáveis e compartilháveis, e unidas a tudo o mais que uma pergunta de pesquisa toca, sem abrir mão da privacidade e do rigor que a medicina exige.
As equipes que vencerem em P&D não serão as que buscarem o modelo primeiro. Serão aquelas que ajustarem os dados primeiro e deixarem a IA vir em seguida. Resolva isso e o modelo se tornará a parte fácil, como sempre foi.
Por onde começar
A maneira mais rápida de testar isso é em seus próprios dados.
- Comece com o acelerador de código aberto Pixels (databricks-industry-solutions/pixels) para transformar uma pasta de DICOM em tabelas Delta governadas e consultáveis, e veja o padrão medalhão em ação.
- Execute no Databricks. Crie um workspace, aponte os Volumes do Unity Catalog para um conjunto de dados público como TCIA ou MIMIC-CXR e configure a ingestão, a desidentificação e um visualizador OHIF de ponta a ponta antes de trazer dados protegidos.
- Aprofunde-se na engenharia por trás dos números apresentados aqui: os artigos sobre ingestão 7x mais rápida, desidentificação com VLM e MONAI/VISTA-3D vinculados acima.
- Escale de uma coorte para todo o acervo. Uma vez que um único tipo de estudo é ingerido, desidentificado e unido a uma tabela clínica, o mesmo padrão se estende para multiômica, dados do mundo real e a camada de agentes por cima.
Se a sua equipe está desenvolvendo soluções para imagem médica ou P&D multimodal no Databricks, os autores adorariam saber como vocês estão abordando isso. Entre em contato ou deixe um comentário e, quando estiver pronto para passar de um piloto para a produção, a equipe de Saúde e Ciências da Vida do Databricks poderá ajudar você a chegar lá.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Soluções, Código aberto, Saúde e ciências da vida, Práticas recomendadas, Genie, Unity Catalog, AI Search e Lakehouse Architecture
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.