Ramificação de banco de dados: um guia do desenvolvedor para fluxos de trabalho no estilo Git
Aprenda como o branching de banco de dados traz fluxos de trabalho no estilo Git para bancos de dados, usando copy-on-write para criar ambientes isolados e descartáveis para desenvolvedores, CI e agentes de AI.
- O branching de banco de dados cria ambientes isolados via copy-on-write, compartilhando dados não alterados e armazenando apenas as diferenças — sem necessidade de cópias completas.
- Ele suporta testes semelhantes aos de produção, isolamento de CI por PR e recuperação fácil, tendo as migrações (e não os merges) como fonte da verdade.
- É essencial para agentes de AI que executam muitas ramificações de curta duração; o uso seguro exige ramificações pai protegidas, dados fictícios, TTLs e controles de acesso.
O Git tornou o desenvolvimento isolado um padrão para equipes de software. Cada desenvolvedor pode criar uma branch, trabalhar de forma independente e mesclar as alterações quando estiver pronto.
A ramificação de banco de dados traz esse mesmo isolamento para o banco de dados. Ela permite que desenvolvedores, jobs de integração contínua (CI) e agentes de AI criem ambientes de banco de dados isolados a partir de um estado de banco de dados compartilhado e façam alterações sem afetar o banco de dados pai ou uns aos outros.
Isso significa menos tempo de espera por ambientes compartilhados, menos falhas de teste causadas por alterações de outras pessoas e feedback mais rápido sobre migrações de esquema. Quando algo dá errado, você pode descartar a branch em vez de reparar ou restaurar um banco de dados compartilhado.
TL;DR
- A ramificação de banco de dados cria ambientes isolados sem a necessidade de cópias completas do banco de dados. O copy-on-write torna isso possível ao compartilhar dados não alterados e armazenar apenas o que muda.
- A ramificação de banco de dados é cada vez mais importante para agentes de AI. Ela oferece aos agentes ambientes isolados para testar alterações e fazer experimentos sem colocar o banco de dados pai em risco.
- Operar branches de banco de dados com segurança exige controles claros. Proteja as branches pai, restrinja o acesso a dados confidenciais, automatize a limpeza e mantenha os ambientes descartáveis reproduzíveis.
O que é ramificação de banco de dados?
A ramificação de banco de dados oferece um ambiente de banco de dados isolado com base no estado de outro banco de dados em um momento específico. A branch começa com o esquema do banco de dados pai e seus dados, mas as alterações feitas na branch não afetam o pai ou qualquer outra branch irmã.
Se você já tem familiaridade com o Git, a ideia básica deve parecer familiar. Uma branch de código oferece uma linha privada de desenvolvimento a partir de um commit conhecido. Uma branch de banco de dados oferece um ambiente de banco de dados isolado a partir de um estado de banco de dados conhecido.
Uma diferença importante é que você geralmente não mescla as alterações de uma branch de banco de dados de volta para o banco de dados pai. Em vez disso, os arquivos de migração continuam sendo a fonte única de verdade durável. Você pode testar uma migração na sua branch, garantir que ela funcione com dados realistas e, em seguida, permitir que seu pipeline de implantação aplique essa mesma migração ao banco de dados de destino. Dessa forma, a ramificação de banco de dados torna práticas antigas, como design evolutivo de banco de dados, ambientes de banco de dados por desenvolvedor e migrações controladas por versão, viáveis mesmo quando você está trabalhando com dados em escala de produção.
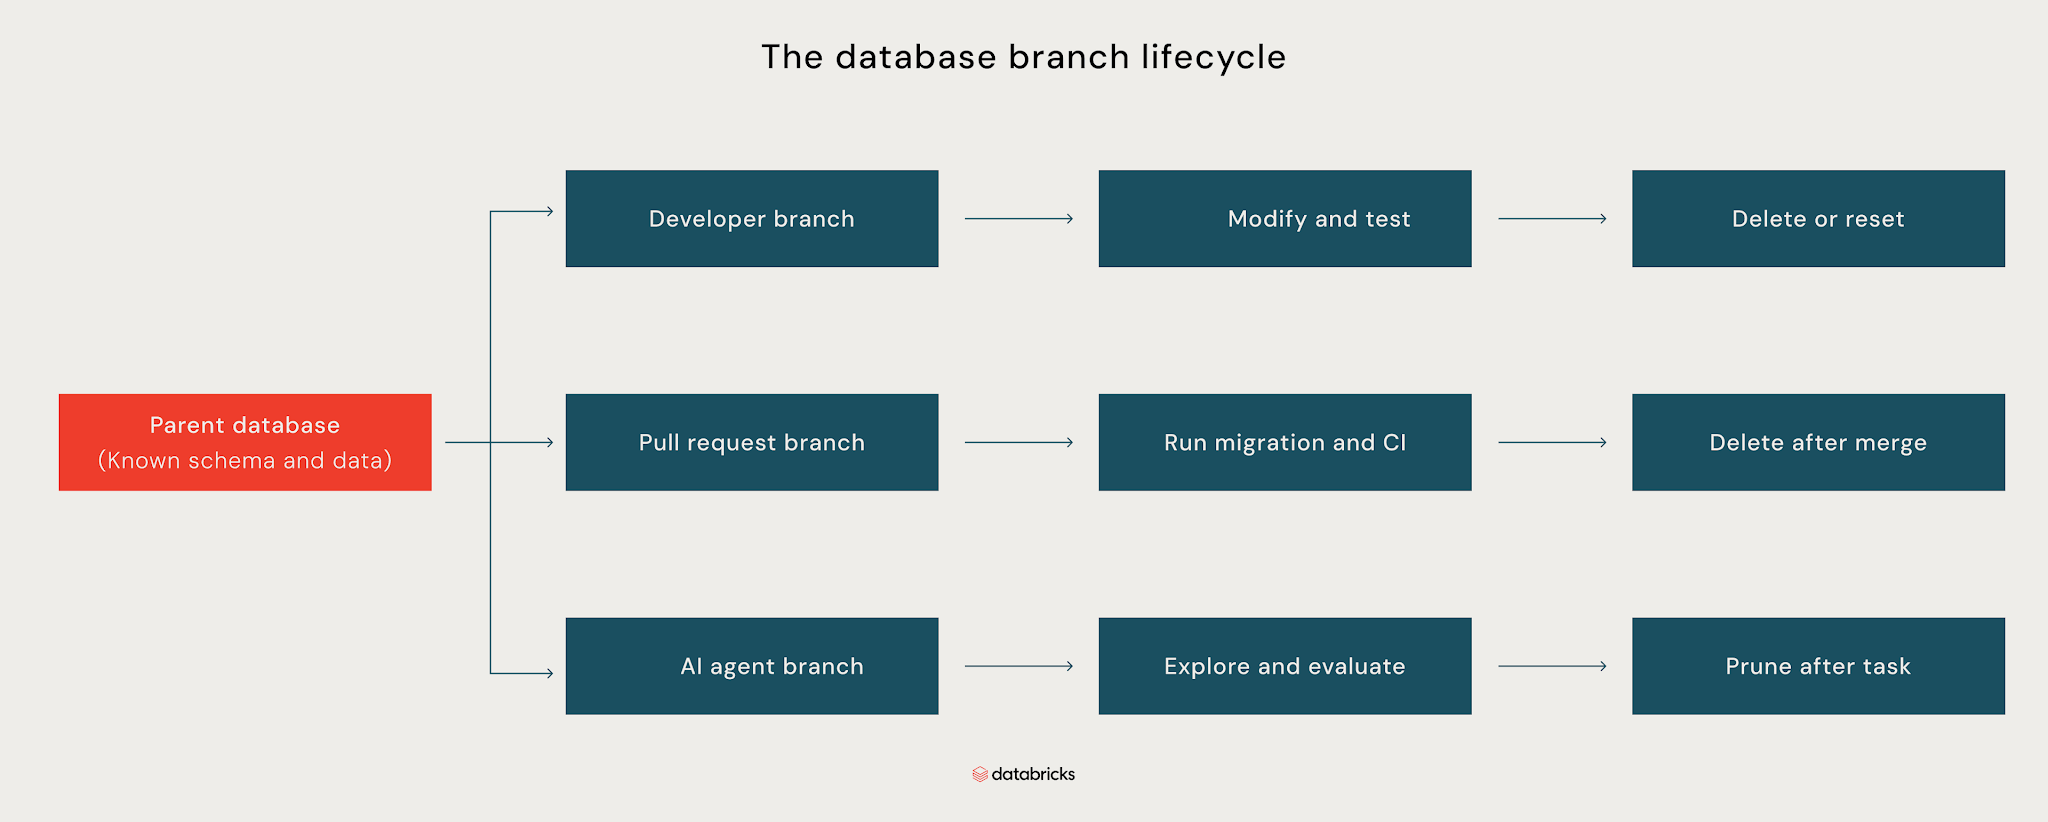
Como mostrado acima, um banco de dados pai fornece o esquema e os dados conhecidos para várias branches isoladas. Você pode usar uma branch de desenvolvedor para modificar e testar alterações, uma branch de pull request para executar migrações e CI, ou uma branch de agente para explorar e avaliar alterações. Quando o trabalho é concluído, cada branch pode ser redefinida, excluída ou podada sem afetar o banco de dados pai ou as outras branches. A ramificação de banco de dados torna esse nível de isolamento possível por meio do copy-on-write.
Como funciona a ramificação de banco de dados com Copy-on-Write
O copy-on-write (CoW) torna a ramificação de banco de dados prática ao evitar uma cópia completa inicial do banco de dados. Quando você cria uma branch, ela inicialmente compartilha os dados existentes do pai em vez de duplicá-los. Ambos podem ler os mesmos dados subjacentes, enquanto as alterações feitas em um permanecem isoladas do outro. Mas quando a branch modifica os dados, a camada de armazenamento cria uma nova versão dos dados afetados para essa branch, enquanto os dados não alterados continuam compartilhados com o pai.
O Lakebase usa essa abordagem de copy-on-write para criar branches de banco de dados sem duplicar todo o banco de dados pai. Como resultado, cada branch requer armazenamento adicional apenas para os dados que divergem de seu pai.
Considere um banco de dados de 40 GB. Com uma cópia completa tradicional, a criação de uma branch de desenvolvedor e de uma branch de pull request exigiria 80 GB adicionais de armazenamento. No entanto, com o copy-on-write, ambas as branches compartilham inicialmente os dados do pai e consomem armazenamento adicional apenas quando divergem.
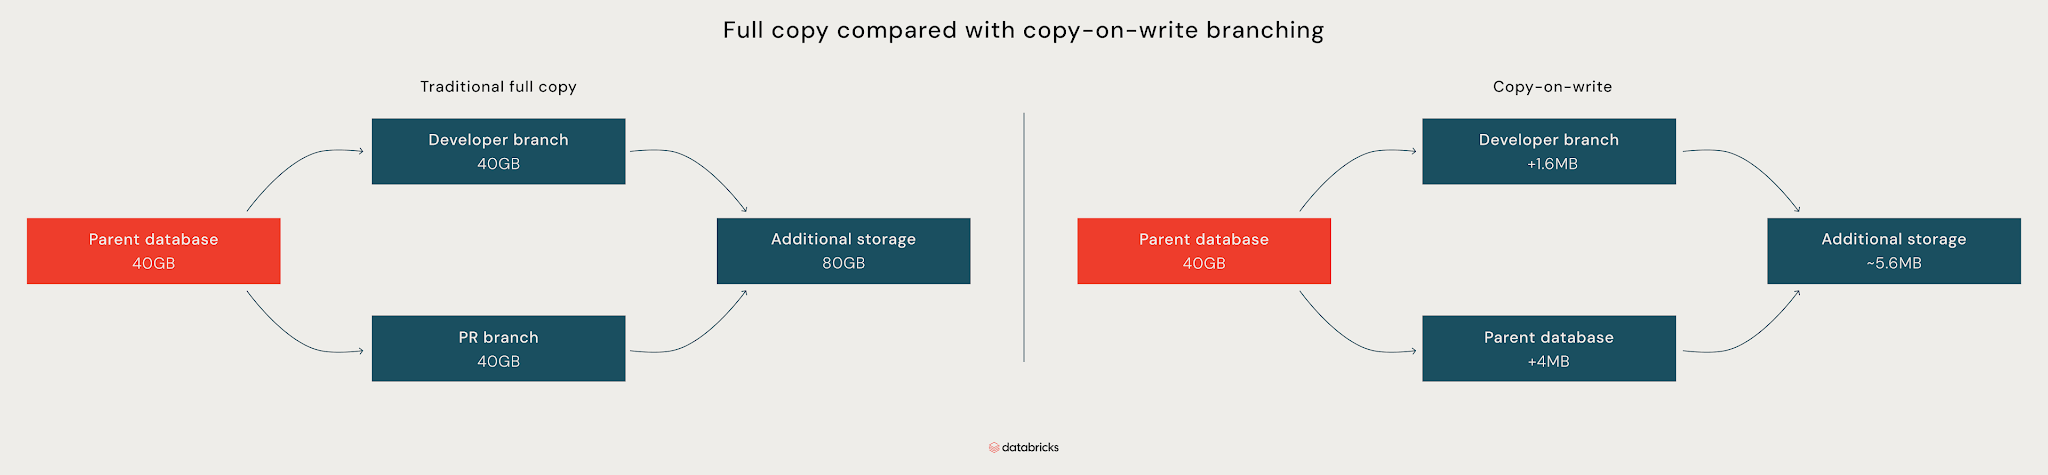
Como mostrado no diagrama acima, se as alterações na branch do desenvolvedor forem de apenas 1,6 MB e as alterações na branch de PR forem de apenas 4 MB, as duas branches adicionarão apenas cerca de 5,6 MB de armazenamento. As cópias tradicionais duplicam todo o banco de dados para cada branch, enquanto as branches com copy-on-write compartilham dados não alterados e armazenam apenas suas alterações.
O mesmo princípio se aplica quando o pai é alterado após a criação de uma branch. A branch continua a referenciar a versão original dos dados não alterados, enquanto o pai grava novas versões das páginas que modifica. Isso permite que as duas branches sejam alteradas de forma independente, sem duplicar dados não alterados.
O que a ramificação de banco de dados torna possível
Baselines semelhantes à produção
Você pode criar branches de banco de dados a partir de um snapshot de produção protegido para que cada desenvolvedor e job de CI comece a partir do mesmo estado conhecido. Isso permite testar migrações em relação a dados realistas, restrições existentes e tabelas em escala de produção, em vez de usar um banco de dados local vazio ou um ambiente de staging desatualizado.
Por exemplo, uma migração como ALTER TABLE orders ADD COLUMN customer_id UUID NOT NULL pode funcionar em um banco de dados vazio, mas falhar em milhões de pedidos existentes. Testá-la em uma branch semelhante à produção expõe esse problema antes que a migração chegue ao staging ou à produção. Quando a branch ficar desatualizada, você poderá excluí-la e criar uma nova a partir da mesma baseline.
Isolamento por PR
Você pode dar a cada pull request seu próprio ambiente de banco de dados. O CI cria a branch quando o PR é aberto, aplica as migrações propostas e executa testes de integração nela. Quando o PR é fechado, o pipeline exclui a branch.
Isso significa que dois desenvolvedores podem fazer alterações conflitantes de esquema sem afetar os testes um do outro. Um PR que adiciona uma coluna, altera uma restrição ou modifica um índice obtém seu próprio estado de banco de dados, de modo que o CI testa a alteração de forma isolada, em vez de testar contra o que quer que outro desenvolvedor esteja fazendo no staging.
Recuperação de falhas mais fácil
As branches também facilitam o isolamento de migrações e experimentos que falharam. Se um backfill produzir resultados inesperados, um teste corromper dados ou uma migração deixar uma branch em um estado ruim, você poderá descartar a branch afetada e criar uma nova a partir do pai, em vez de continuar trabalhando com um ambiente de desenvolvimento contaminado.
Por exemplo, você pode testar com segurança uma operação destrutiva como DELETE FROM orders WHERE created_at < ... em uma branch, inspecionar os resultados e descartar a branch quando terminar. O banco de dados pai permanece intocado durante todo o processo.
Para desenvolvedores e equipes de DevOps, esses benefícios já são atraentes. No entanto, se você estiver criando ou executando agentes de AI, a ramificação de banco de dados se torna importante em uma escala totalmente diferente.
Principais conclusões sobre sistemas multiagentes, casos de uso de IA, avaliações e muito mais

Por que os agentes de AI tornam a ramificação essencial para a infraestrutura
Os agentes de AI podem precisar de seus próprios ambientes de banco de dados para testar diferentes abordagens para uma tarefa. Eles podem criar uma branch para cada abordagem, comparar os resultados e descartar as que não precisam. Em uma frota de agentes, isso pode significar centenas ou milhares de ambientes de curta duração em execução ao mesmo tempo.
Nessa escala, as cópias completas de banco de dados tornam-se caras e lentas para provisionar. A ramificação de banco de dados evita essa sobrecarga, tornando prático para os agentes criarem e descartarem ambientes enquanto trabalham.
A ramificação também pode reduzir o raio de impacto de erros dos agentes, fornecendo a eles um ambiente isolado para testar alterações. Em vez de conceder a um agente acesso de gravação a um banco de dados de produção, você pode dar a ele acesso a uma branch onde ele possa testar operações destrutivas sem afetar o pai.
Como operar branches de banco de dados com segurança
As branches de banco de dados são mais fáceis de gerenciar quando você as trata como ambientes descartáveis e automatiza seu ciclo de vida. Algumas práticas mantêm esse fluxo de trabalho seguro e previsível:
- Proteja as branches de produção e pai: Restrinja quem pode gravar, redefinir ou excluir branches de produção e outras branches pai importantes. Em vez disso, agentes e desenvolvedores devem trabalhar em branches filhas.
- Use dados seguros para branches efêmeras: Evite copiar dados de produção confidenciais para branches de desenvolvimento ou de agentes de curta duração, a menos que seja necessário e devidamente protegido. Sempre que possível, use dados fictícios para que os ambientes descartáveis não se tornem um caminho para expor informações de produção.
- Defina um tempo de vida (TTL) para as branches: Defina um tempo de expiração para branches de curta duração, de modo que PRs abandonados, execuções de CI com falha e tarefas de agente encerradas não deixem ambientes em execução indefinidamente.
- Mantenha as migrações como a fonte da verdade: Trate os arquivos de migração como a fonte da verdade. Teste as migrações em uma branch, revise-as no controle de versão e aplique a migração aprovada ao banco de dados de destino, em vez de promover alterações feitas diretamente em uma branch.
- Torne os ambientes reproduzíveis: Trate as branches como descartáveis, em vez de ambientes de longa duração que exigem reparo manual. Mantenha a configuração necessária para recriar um ambiente no controle de versão, para que uma branch desatualizada ou corrompida possa ser excluída e recriada a partir de sua branch pai.
- Controle o acesso e o uso de recursos: Dê aos desenvolvedores e agentes apenas as permissões de que precisam e monitore a idade da branch, computação, armazenamento e o número de ambientes ativos. Use ferramentas como o Unity Catalog para governar o acesso aos dados disponíveis nesses ambientes.
Com essas proteções implementadas, as equipes podem usar branches de banco de dados como ambientes descartáveis em fluxos de trabalho de desenvolvimento, integração contínua e entrega contínua (CI/CD) e agentes. Cada branch fornece um ambiente isolado para testar alterações e pode ser removida automaticamente quando o trabalho for concluído.
Conclusão
O branching de banco de dados oferece uma maneira prática de criar ambientes de banco de dados isolados sem o custo e a complexidade de cópias completas. Você pode usar branches para testar migrações com dados realistas, dar a cada pull request seu próprio banco de dados, recuperar-se de experimentos com falha e executar várias cargas de trabalho baseadas em banco de dados em paralelo.
Comece com um fluxo de trabalho simples, como uma branch por pull request, e automatize a criação e a limpeza. A partir daí, você pode estender o branching para ambientes de desenvolvedores e cargas de trabalho de agentes à medida que suas necessidades crescerem. Pronto para testar? Explore o branching de banco de dados com o Databricks Lakebase ou siga um tutorial prático para implementar o branching de banco de dados no Postgres.
Perguntas frequentes
O que é branching de banco de dados?
O branching de banco de dados cria um ambiente de banco de dados isolado a partir de um banco de dados pai em um momento específico. A branch começa com o esquema e os dados do pai, mas as alterações feitas na branch permanecem isoladas. Com o copy-on-write, as branches compartilham dados não alterados com o pai, o que as torna rápidas de criar e baratas de descartar.
Qual é a diferença entre branching de banco de dados e branching do Git?
A ideia é semelhante: ambos permitem criar um ambiente isolado a partir de um estado conhecido e fazer alterações sem afetar o original. As branches do Git isolam o código-fonte, enquanto as branches de banco de dados isolam o esquema e os dados do banco de dados.
Os fluxos de trabalho diferem depois disso. As branches do Git geralmente são mescladas de volta na branch principal, enquanto as branches de banco de dados geralmente não são. Em vez disso, você testa sua migração na branch de banco de dados e, em seguida, aplica a migração revisada ao banco de dados de destino por meio do seu processo de implantação.
Qual é o objetivo do branching de banco de dados?
O branching de banco de dados oferece a desenvolvedores, tarefas de CI e agentes de IA ambientes isolados para testar alterações sem afetar a produção ou outras cargas de trabalho. Você pode usar branches para testar migrações com dados realistas, criar ambientes por PR, recuperar-se de experimentos com falha e executar várias cargas de trabalho baseadas em banco de dados em paralelo.
Quais são os dois tipos de branching de banco de dados?
As duas abordagens comuns são o branching de cópia completa (full-copy) e o branching copy-on-write. O branching de cópia completa duplica o banco de dados para cada branch, portanto, o tempo de criação e os requisitos de armazenamento aumentam com o tamanho do banco de dados. O branching copy-on-write compartilha dados não alterados com o pai e armazena apenas as alterações feitas em cada branch.
Que tipos de bancos de dados suportam branching?
O branching depende mais da arquitetura de armazenamento do banco de dados do que do seu modelo de dados. Bancos de dados relacionais, de documentos, chave-valor e de grafos podem, teoricamente, suportar branching, mas a implementação e os recursos variam de acordo com a plataforma.
Como faço para implementar o branching de banco de dados?
A implementação depende da sua plataforma de banco de dados e da arquitetura de armazenamento. Em geral, você precisa de um banco de dados pai e de uma maneira de criar branches isoladas a partir de um estado conhecido do banco de dados. O Databricks Lakebase oferece branching de banco de dados para fluxos de trabalho de desenvolvimento, CI e agentes, com branches que podem ser criadas e removidas conforme necessário. Para uma implementação prática, consulte o tutorial de desenvolvimento baseado em branches do Databricks.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.