Banco de dados para agentes de AI: 5 critérios de avaliação
Conheça os 5 critérios para avaliar um banco de dados para agentes de IA — isolamento de branch, escala serverless, busca híbrida, garantias ACID e acesso unificado.
- Agentes de IA precisam de um banco de dados que suporte leituras e gravações contínuas e concorrentes em múltiplos tipos de memória — e não o padrão de uma requisição por vez que os aplicativos tradicionais usam.
- Cinco critérios definem um banco de dados de agentes pronto para produção: isolamento de branch por agente, computação scale-to-zero, busca híbrida em uma única consulta, garantias ACID sob concorrência e uma plataforma unificada sem atraso de ETL.
- O Lakebase da Databricks atende a cada critério, com validação no mundo real da Superhuman e da easyJet.
Os cinco critérios para avaliar um banco de dados para agentes de IA são isolamento de branches, escalabilidade serverless, busca híbrida, garantias ACID e acesso unificado à plataforma. Juntos, esses critérios ajudam desenvolvedores e equipes de dados a determinar se um banco de dados pode dar suporte a agentes à medida que eles passam de protótipos para a produção e começam a lidar com tarefas simultâneas, dados operacionais em tempo real e estado persistente.
Um banco de dados para agentes de IA é um sistema projetado para armazenar o estado, a memória, os resultados de ferramentas e os dados operacionais que um agente precisa para concluir tarefas em várias etapas e sessões. Ao contrário de um banco de dados que atende a uma aplicação convencional, ele precisa suportar leituras e gravações repetidas, atividade simultânea de agentes, recuperação em diferentes tipos de memória e acesso a dados operacionais atualizados.
O surgimento dos agentes de IA torna esses requisitos ainda mais importantes. Quando os desenvolvedores executam agentes de codificação, agentes de suporte ao cliente ou plataformas multi-tenant, os agentes fazem mais do que apenas recuperar informações. Eles gravam estados, retomam tarefas, coordenam chamadas de ferramentas e agem com base em dados operacionais em constante mudança. À medida que as equipes de dados levam os agentes para a produção, as limitações do banco de dados podem gerar memória desatualizada, conflitos de gravação, latência e custos desnecessários de computação.
Por que um banco de dados para agentes de IA não é o mesmo problema
Um agente pronto para produção precisa se lembrar do que já fez, retomar uma tarefa de onde parou e obter o contexto correto antes de agir. Combine-o com o banco de dados errado e essa memória pode se tornar desatualizada, incompleta ou inconsistente.
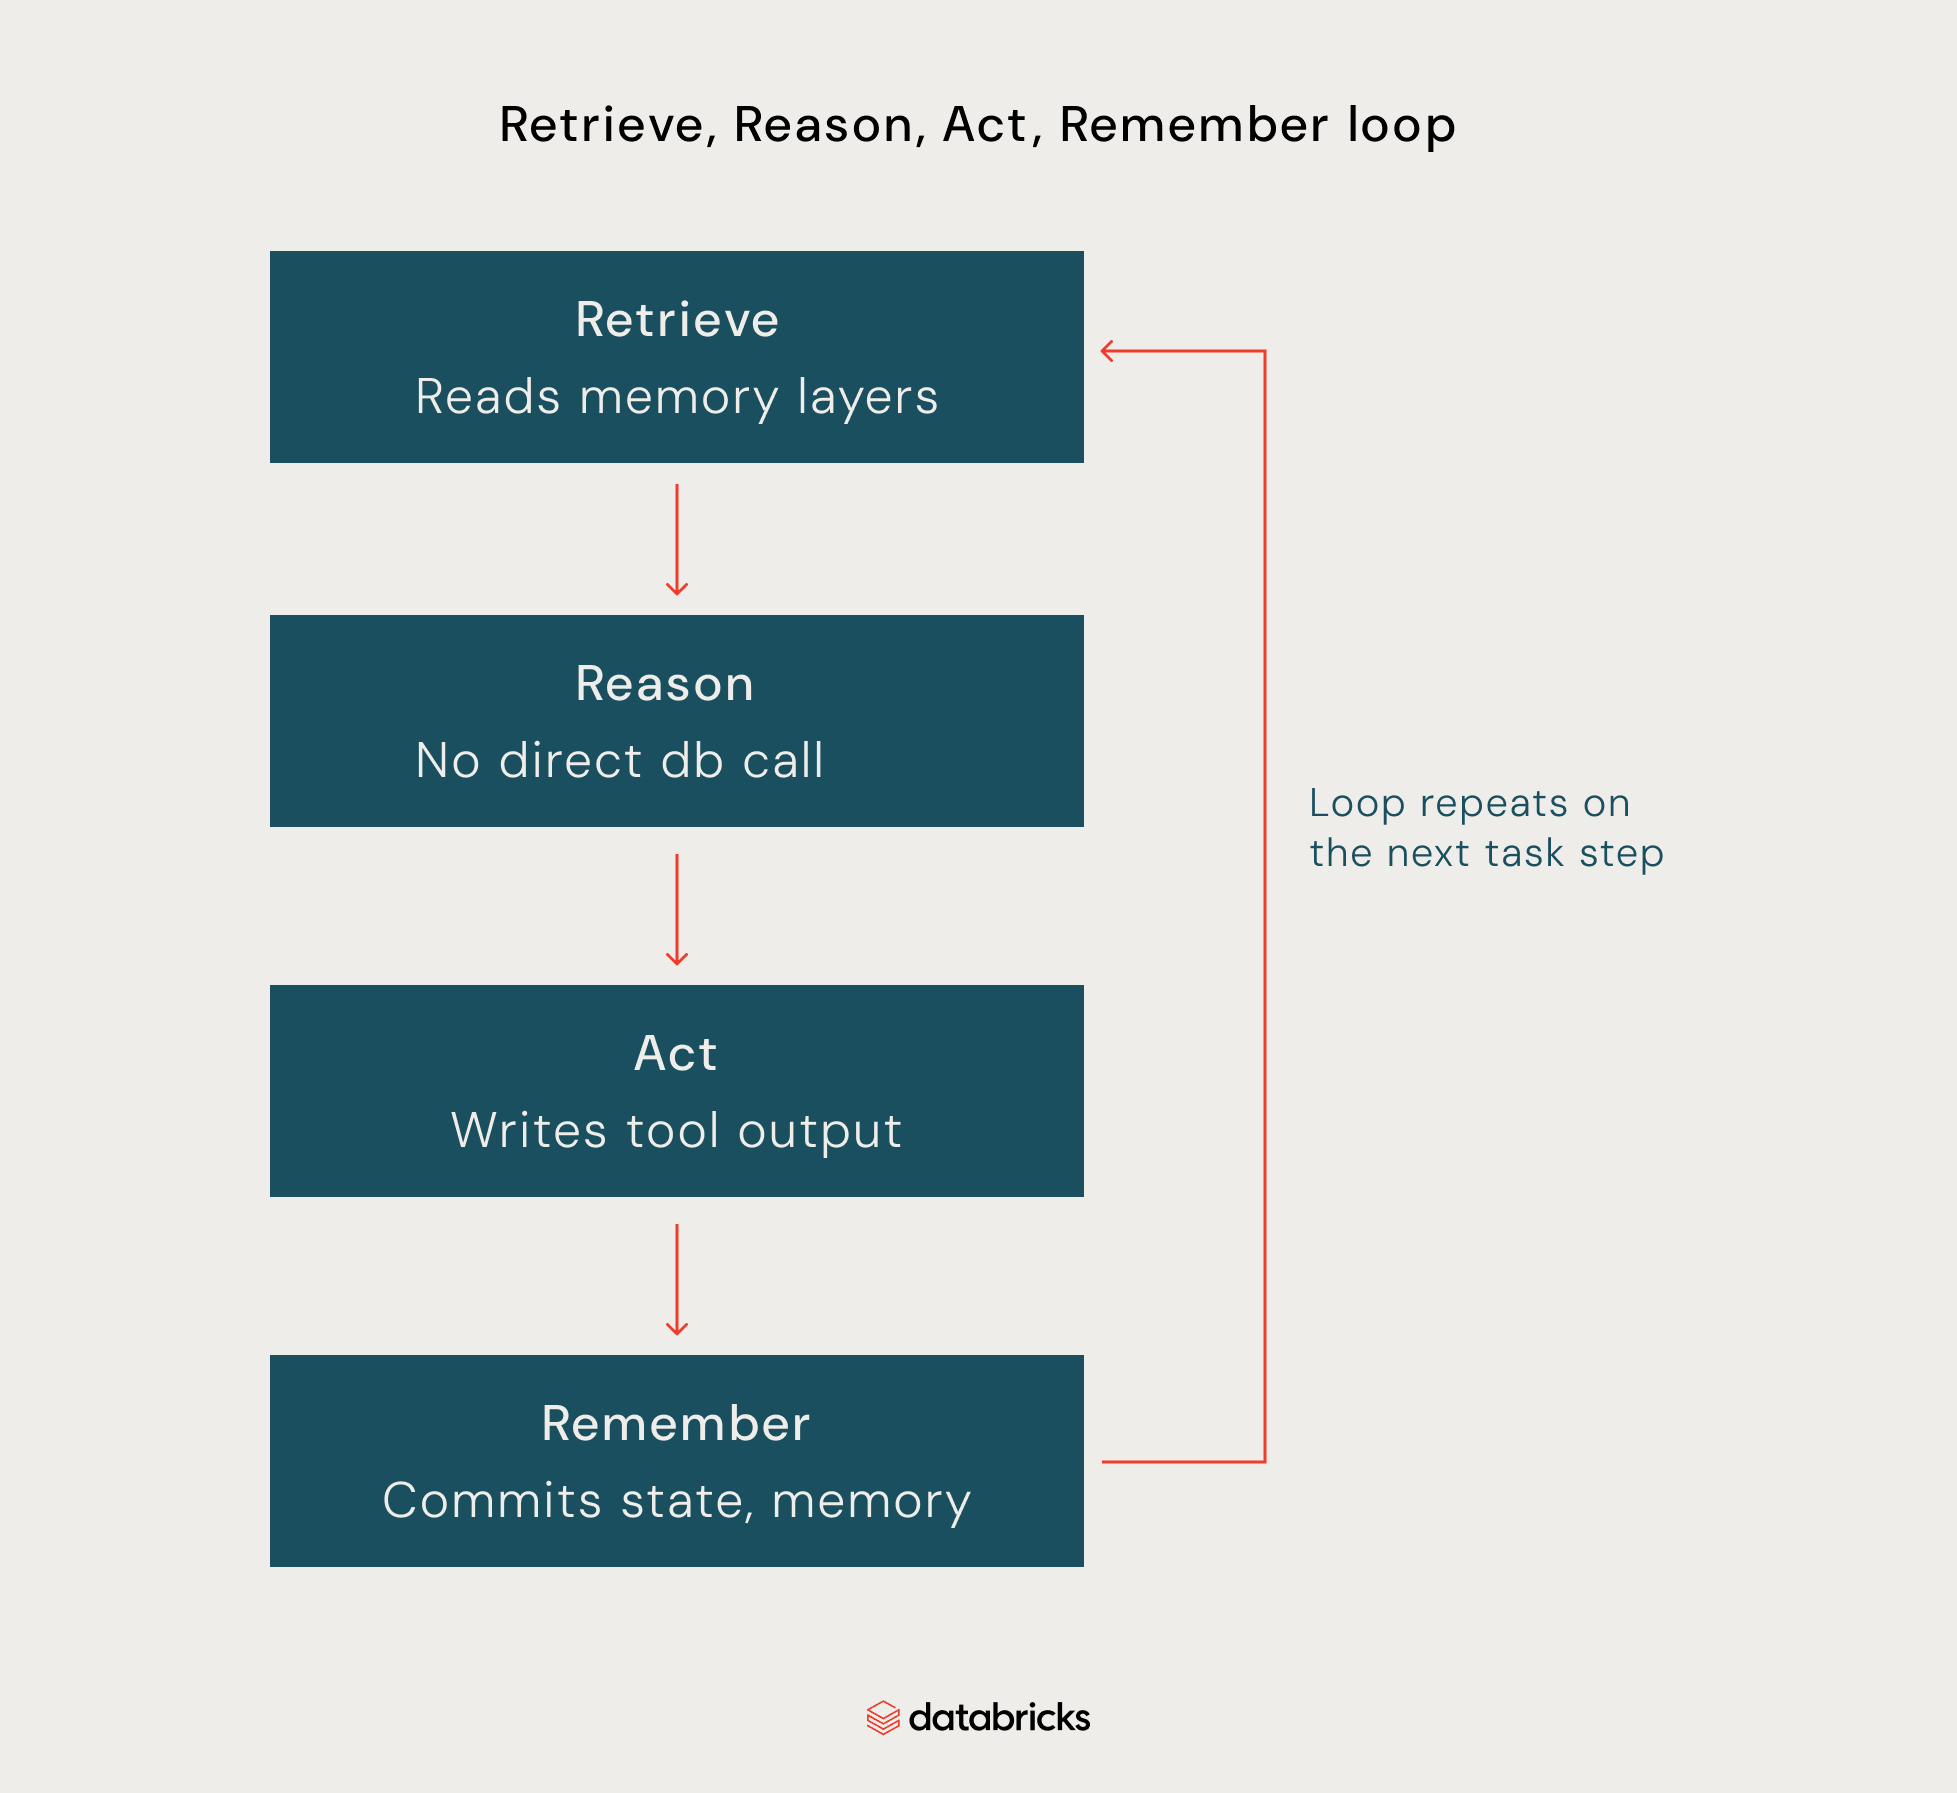
Os agentes em produção dependem de quatro camadas de memória para realizar isso:
- Memória de curto prazo: a memória de trabalho em contexto disponível durante a interação atual, incluindo mensagens recentes, informações recuperadas e resultados de ferramentas.
- Memória episódica: interações passadas que permitem ao agente lembrar de conversas anteriores, preferências do usuário e tarefas concluídas.
- Memória procedimental: os fluxos de trabalho, definições de ferramentas e instruções que orientam como as tarefas são realizadas, sejam eles armazenados externamente ou integrados ao modelo.
- Estado operacional: o status em tempo real da tarefa, incluindo etapas concluídas e pendentes, saídas de ferramentas e checkpoints para retomar o trabalho mais tarde.
Essa é uma carga de trabalho mais complexa do que a de uma aplicação típica, que envia uma consulta ao banco de dados e segue em frente. A maioria dos bancos de dados de produção são bancos de dados operacionais, também chamados de sistemas de processamento de transações online (OLTP), construídos em torno desse mesmo padrão de uma solicitação por vez. Um agente não funciona dessa forma. Ele realiza leitura após leitura e gravação após gravação em uma única tarefa, sem pausas humanas entre elas, enquanto centenas de outros agentes fazem a mesma coisa.
Os 5 critérios para avaliar qualquer banco de dados para cargas de trabalho de agentes de IA
Ao selecionar um banco de dados para agentes de IA, vários critérios são importantes, mas estes cinco são os que realmente vale a pena avaliar, independentemente do fornecedor considerado, seja gerenciado ou auto-hospedado.
Branch por agente: testes seguros com dados reais
Testar um agente apenas com dados sintéticos é como testar um sistema de suporte com um punhado de contas de clientes perfeitamente formatadas. Ele pode se comportar exatamente como esperado, mas as contas reais são sempre mais complexas. As equipes de dados acabam se deparando com campos ausentes, registros inconsistentes, dados antigos e casos extremos que nunca chegaram aos seus cenários de teste.
É por isso que recomendamos tratar os testes isolados com dados reais como um critério de avaliação do banco de dados. O objetivo é que o agente trabalhe com um estado semelhante ao de produção, sem permitir que ele modifique a produção. Uma maneira de obter esse isolamento é o branching de cópia zero (zero-copy branching), que permite aos desenvolvedores criar um ambiente separado sem manter uma segunda cópia completa do banco de dados.
Lakebase Projects foi projetado para lidar com esse tipo de desenvolvimento e teste isolados, permitindo que os desenvolvedores criem branches a partir de dados de produção sem copiar os dados subjacentes. Criar um branch de um banco de dados de produção em escala de terabytes leva cerca de um segundo, sem custo adicional de armazenamento até que o branch divirja de seu pai.
Escalar para zero: como a precificação serverless muda a economia dos agentes
27% dos gastos com nuvem são desperdiçados todos os anos, e a computação ociosa e subutilizada é consistentemente o maior fator para isso. Os bancos de dados de agentes são um exemplo claro do porquê. A maioria dos agentes não funciona continuamente. Eles são ativados, realizam uma tarefa, gravam os resultados e depois ficam inativos até que a próxima solicitação chegue. Pagar por computação dedicada 24 horas por dia significa pagar pelo mesmo problema de computação ociosa em cada banco de dados de agente que uma equipe está executando.
Um modelo serverless de escala para zero resolve isso suspendendo a computação após um período sem conexões ativas e retomando-a quando o trabalho recomeça. Isso faz com que os custos acompanhem o uso real em vez do tempo ocioso. No entanto, a velocidade de inicialização importa tanto quanto a economia. Um agente esperar 20 ou 30 segundos para que seu banco de dados seja ativado não é prático, especialmente quando ele está respondendo a um usuário ou aguardando a próxima chamada de ferramenta.
Lakebase usa esse modelo para Postgres, com a computação sendo retomada em poucas centenas de milissegundos após uma nova consulta. Isso mantém o atraso de inicialização pequeno o suficiente para que a escala para zero funcione com cargas de trabalho interativas de agentes.
Busca híbrida: recuperação em todas as quatro camadas de memória em uma única consulta
A busca vetorial por si só é como um bibliotecário que só consegue navegar por "o que parece semelhante", nunca por um número de chamada exato. Peça para ele encontrar documentos sobre arquitetura de banco de dados e ele se sairá bem. Peça o registro com o ID de conta 48291 e ele não terá uma maneira confiável de encontrá-lo. A semelhança semântica não foi feita para correspondências exatas.
Essa é a lacuna que muitos pipelines de geração aumentada de recuperação (RAG) enfrentam quando dependem apenas da busca vetorial. A busca híbrida fecha essa lacuna combinando similaridade vetorial, correspondência de palavras-chave e filtragem de metadados em uma única consulta, em vez de juntar resultados de sistemas separados. Divida isso entre um índice vetorial e um armazenamento relacional, e o agente fará duas chamadas em vez de uma. Os sistemas podem ficar dessincronizados, e cada salto extra adiciona uma latência que o loop de um agente nem sempre consegue absorver. A recuperação precisa ocorrer bem abaixo de 100 milissegundos para continuar utilizável dentro de um ciclo de raciocínio rápido.
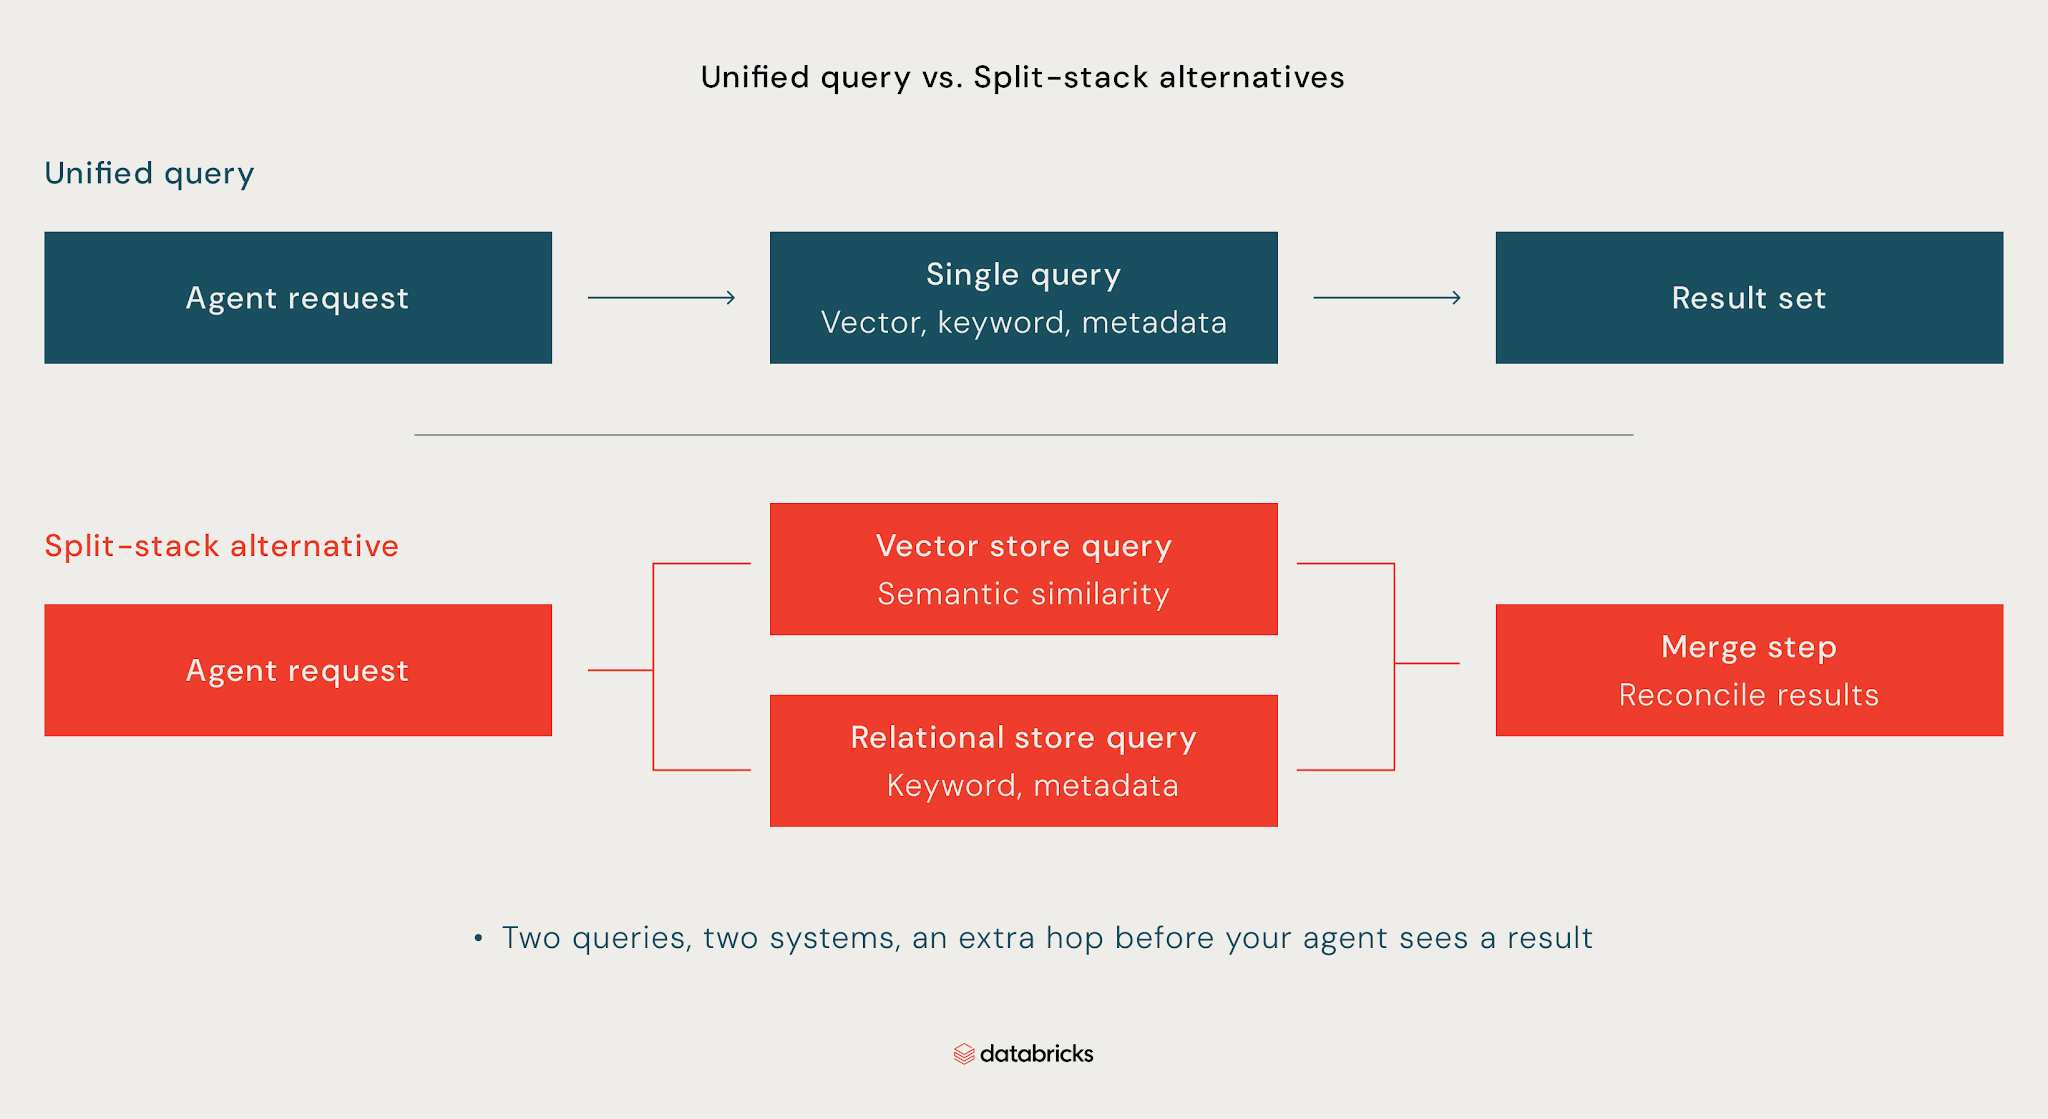
O Lakebase Search executa consultas vetoriais, de palavras-chave e de metadados nas mesmas tabelas Postgres onde os dados operacionais já residem, de modo que não há um segundo sistema para ficar dessincronizado. Sua arquitetura LTAP é o que mantém esses dados atualizados, com desempenho de gravação até 5 vezes mais rápido do que o Postgres padrão. Isso significa que o que um agente acabou de gravar pode estar disponível para recuperação quase imediatamente.
Garantias ACID para sistemas multiagentes
Imagine dois agentes de suporte atualizando o mesmo registro de cliente ao mesmo tempo. Um está resolvendo um problema de faturamento e ajustando o nível de assinatura, enquanto o outro está registrando um reembolso. Sem o isolamento adequado, uma atualização pode substituir a outra, deixando o registro em um estado que nenhum dos agentes pretendia.
É por isso que as garantias transacionais devem ser um critério rigoroso ao avaliar um banco de dados para cargas de trabalho multiagentes. O ACID oferece aos desenvolvedores quatro propriedades para verificar:
- Atomicidade: uma transação é concluída totalmente ou não é concluída de forma alguma.
- Consistência: o banco de dados permanece válido antes e depois de cada transação.
- Isolamento: transações simultâneas não interferem no trabalho umas das outras de maneiras inesperadas.
- Durabilidade: uma gravação confirmada (committed) sobrevive a uma falha ou reinicialização.
Para sistemas multiagentes, as questões práticas importam mais do que a sigla. A confirmação (commit) da saída de uma ferramenta pode ocorrer de forma atômica, para que uma ação concluída pela metade nunca seja tratada como concluída? O que acontece quando dois agentes de suporte atualizam o mesmo registro? Quais níveis de isolamento o banco de dados suporta? Um agente pode retomar após uma reinicialização sem perder o estado confirmado?
Ao comparar bancos de dados, recomendamos verificar os níveis de isolamento e a semântica de confirmação (commit) que eles realmente suportam, e não apenas se afirmam "suportar transações". Uma vez que múltiplos agentes compartilham dados operacionais, esses detalhes determinam se o trabalho simultâneo permanece previsível.
Plataforma unificada: dados operacionais na stack de IA sem ETL
Um agente esperando que um pipeline se atualize está tomando decisões com base em dados desatualizados. No momento em que esse pipeline é executado, o registro sobre o qual ele está agindo já pode ter mudado novamente. Ao avaliar um banco de dados, observe o quão de perto ele conecta os dados operacionais com os sistemas de análise e IA que dependem deles.
Uma plataforma unificada mantém as gravações operacionais e as leituras analíticas nos mesmos dados, sem a necessidade de um pipeline separado de extração, transformação e carregamento (ETL) entre elas. Seus agentes podem trabalhar com dados atuais, enquanto seus modelos podem usar resultados em tempo real em vez de esperar por um processamento em lote. As equipes de dados também mantêm a governança e as trilhas de auditoria na mesma plataforma, em vez de enviar as cargas de trabalho dos agentes para um sistema separado que é mais difícil de rastrear. Unity Catalog é o que aplica essa camada de governança em dados operacionais e analíticos no Databricks. A experiência da Superhuman mostra como isso funciona na prática: substituir pipelines de sincronização personalizados em uma camada de cache e um armazenamento NoSQL gerenciado por uma plataforma unificada reduziu o cronograma de integração de dados de quase três meses para cerca de duas semanas.
A easyJet adotou uma abordagem semelhante em sua pilha de gerenciamento de receita. Desde que migrou para o Lakebase, a companhia aérea tem capturado atividades de reserva e precificação em tempo real junto com análises nos mesmos dados do lakehouse, consolidou mais de 100 repositórios Git em dois e reduziu os ciclos de desenvolvimento de aplicativos de seis a nove meses para cerca de quatro.
Lakebase mantém os dados operacionais no lakehouse do Databricks, para que os mesmos dados possam dar suporte a cargas de trabalho transacionais e análises downstream sem um pipeline ETL separado.
Seu guia compacto para analítica moderna
Placar de avaliação de banco de dados de agentes de AI
Submeta qualquer candidato a estas cinco verificações e você saberá em poucos minutos onde ele se sustenta e onde falha, independentemente do fornecedor que estiver comparando.
| Critério | O que testar | Requisito mínimo | Sinais de alerta | Comportamento do Lakebase |
|---|---|---|---|---|
| Branch por agente | É possível criar um branch isolado com dados de produção reais sem fazer uma cópia completa? | A criação do branch é concluída em segundos, não em minutos | Exige uma cópia completa do banco de dados ou demora mais do que o seu ciclo de teste | Cria branches de um banco de dados em escala de terabytes em cerca de um segundo, sem custo de armazenamento até que haja divergência |
| Escalar para zero | A computação é suspensa após um período de inatividade e retomada rapidamente para continuar utilizável? | A computação é retomada em menos de um segundo, sem etapa de ativação manual | A inicialização a frio leva mais de 10 segundos, ou os bancos de dados ociosos ainda são cobrados pela taxa total | Reativa em algumas centenas de milissegundos e não cobra nada enquanto estiver suspenso |
| Busca híbrida | Uma única consulta pode combinar similaridade de vetor, correspondência de palavras-chave e um filtro estruturado? | Consulta única, em menos de 100 ms | Exige chamadas separadas para um armazenamento de vetores e um armazenamento relacional, seguidas de uma mesclagem manual | Executa consultas de vetor, palavra-chave e metadados nas mesmas tabelas do Postgres |
| Garantias ACID | Dois agentes podem gravar no mesmo registro ao mesmo tempo sem perder nenhuma das gravações? | Nenhuma gravação é perdida; o isolamento se mantém sob carga concorrente | Substituições silenciosas ou isolamento que se degrada sob concorrência | Garantias transacionais padrão do Postgres, não afetadas pela carga concorrente de agentes |
| Plataforma unificada | Quanto tempo leva para uma nova gravação ficar disponível para análise? | Sem etapa de ETL, ou latência medida em segundos, não em horas | Exige um pipeline agendado antes que os dados possam ser consultados em outro lugar | Cada gravação torna-se consultável no lakehouse do Databricks sem a necessidade de um pipeline separado |
Um banco de dados que falha em mais de um desses requisitos mínimos representa um risco de produção quando você estiver executando agentes em escala, e não apenas uma pequena concessão que você possa contornar mais tarde.
Conclusão
Escolher um banco de dados para agentes de AI se resume à adequação à carga de trabalho, não a listas de recursos. Os cinco critérios deste guia oferecem aos desenvolvedores e equipes de dados uma estrutura prática para avaliar qualquer banco de dados antes de adotá-lo em produção. Se um candidato não puder atender a esses requisitos hoje, os agentes em produção acabarão expondo as lacunas à medida que assumirem mais usuários, mais tarefas e mais trabalho concorrente.
Se você estiver avaliando um banco de dados para agentes de AI, explore o Lakebase para ver como o Databricks oferece suporte a cargas de trabalho transacionais, branching, dimensionamento serverless, busca híbrida e acesso unificado a dados operacionais.
Perguntas frequentes
Os agentes de AI precisam de um banco de dados?
Sim. A maioria das implementações de agentes não retém o contexto de curto prazo, o histórico episódico, o conhecimento de procedimentos ou o estado das tarefas em tempo real entre as chamadas, a menos que você os persista e recarregue explicitamente. Sem um banco de dados por trás, seu agente normalmente perde esse contexto no momento em que a sessão termina e não consegue retomar uma tarefa de onde parou.
Um banco de dados vetorial é suficiente para agentes de AI?
Não por si só. Um banco de dados vetorial lida bem com a recuperação semântica, mas seu agente também precisa gravar e atualizar o estado operacional, garantir a integridade transacional em gravações concorrentes e filtrar campos estruturados que uma busca por similaridade não consegue capturar com confiabilidade. A busca semântica cobre apenas uma parte do que um agente precisa, não toda a carga de trabalho.
Qual é o melhor banco de dados para RAG em agentes de AI?
Não existe uma resposta única. Para RAG em agentes de AI, o melhor banco de dados é aquele que pode executar busca híbrida em uma única consulta, manter a recuperação rápida o suficiente para o loop do agente e permanecer atualizado o suficiente para evitar memória obsoleta.
Como os sistemas multiagentes alteram os requisitos do banco de dados?
Quando vários agentes gravam em dados compartilhados ao mesmo tempo, a integridade transacional deixa de ser opcional. Seu banco de dados precisa isolar as gravações concorrentes para que a atualização de um agente não substitua silenciosamente a de outro, e precisa confirmar as saídas das ferramentas de forma atômica para que uma ação inacabada nunca seja tratada como concluída.
Qual é a diferença entre OLTP e OLAP para agentes de AI?
As ações em tempo real do seu agente, a gravação de saídas de ferramentas, a atualização de estado e a geração de checkpoints são cargas de trabalho OLTP. Relatórios e treinamento de modelos com base nesses dados são cargas de trabalho OLAP. Os agentes normalmente precisam de ambos para trabalhar com os mesmos dados sem um pipeline entre eles. É por isso que os critérios deste guia se concentram em bancos de dados que podem atender tanto ao trabalho de agentes com uso intenso de transações quanto a análises downstream a partir dos mesmos dados.
O Postgres é bom para agentes de AI?
O Postgres padrão oferece garantias ACID sólidas e um ecossistema maduro, cobrindo parte do que seu agente precisa. Ele não oferece branching com cópia zero, computação com escala para zero ou acesso operacional e analítico unificado por si só; isso depende da plataforma criada em torno dele.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Lakebase, Serverless, Operational Databases (OLTP) e ETL/ELT
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.