Databricks for Good e Virtue Foundation: Parceria para conectar voluntários da área médica a serviços de saúde essenciais em 72 países
por Priyanka Mehta e Shaunak Sen
- A Virtue Foundation fez uma parceria com o Databricks for Good para aproveitar a AI e aprimorar os resultados de saúde global.
- O resultado permitiu que a Virtue Foundation combinasse melhor as habilidades dos profissionais de saúde com oportunidades de voluntariado em países em desenvolvimento onde essas habilidades são mais necessárias.
- Juntas, as equipes do Databricks e da Virtue Foundation estão fornecendo datasets principais atualizados em um formato facilmente acessível e prático.
Introdução
A Virtue Foundation é uma organização sem fins lucrativos focada na prestação de serviços de saúde globais e na criação de um mercado eficiente para a saúde filantrópica global. Até o momento, eles prestaram atendimento a mais de 50.000 pacientes, com foco especial em Gana e na Mongólia. A base desse mercado é a curadoria de dados de instalações de saúde globais por meio do VF Match, uma plataforma que conecta profissionais médicos a oportunidades de voluntariado em 72 países de baixa e média-baixa renda. O Databricks for Good tem trabalhado em estreita colaboração com a Virtue Foundation desde 2024 para aproveitar a AI para agregar dados nesses países e torná-los acionáveis.
Uma prova de conceito inicial demonstrou que os LLMs podiam extrair informações estruturadas de fontes de dados da web díspares para criar um mapa da infraestrutura de saúde e, mais importante, das lacunas nos serviços em áreas com poucos recursos. No entanto, dimensionar essa funcionalidade e levá-la para a produção apresentou muitos desafios. Desde essa primeira iteração, criamos uma plataforma baseada em Databricks que transformou a POC em um sistema de nível de produção que agrega dados de milhares de instalações de saúde e organizações sem fins lucrativos em todo o mundo.
Neste artigo, mostramos como aprimoramos nosso trabalho anterior para capacitar ainda mais a Virtue Foundation a conectar sua comunidade de voluntários médicos com necessidades críticas nesses países.
Construindo a base: dados de saúde de 72 países
O núcleo do VF Match é o Foundational Data Refresh (FDR): um conjunto de dados abrangente de instalações de saúde e organizações sem fins lucrativos construído do zero a partir de várias fontes baseadas na web. Ingerimos e atualizamos sistematicamente dados de 72 países de baixa e média-baixa renda em todo o mundo.
Duas fontes de dados complementares alimentam essa atualização:
- Overture Maps: um conjunto de dados geoespaciais de código aberto da Meta e da Microsoft, que fornece localizações confiáveis de instalações de saúde.
- Bright Data: infraestrutura de web scraping industrial que captura informações em tempo real de toda a internet.
O coração do FDR é um pipeline de extração de informações alimentado pelos modelos GPT da OpenAI. Processar mais de 25 milhões de páginas da web por meio de LLMs com garantias de produção exigiu repensar os pipelines tradicionais de inferência de LLM. Em vez de tentar uma extração direta (one-shot), nosso pipeline divide a tarefa em etapas direcionadas: classificar a relevância médica, identificar o tipo de organização (uma instalação médica ou NGO) e extrair especialidades, equipamentos e procedimentos.
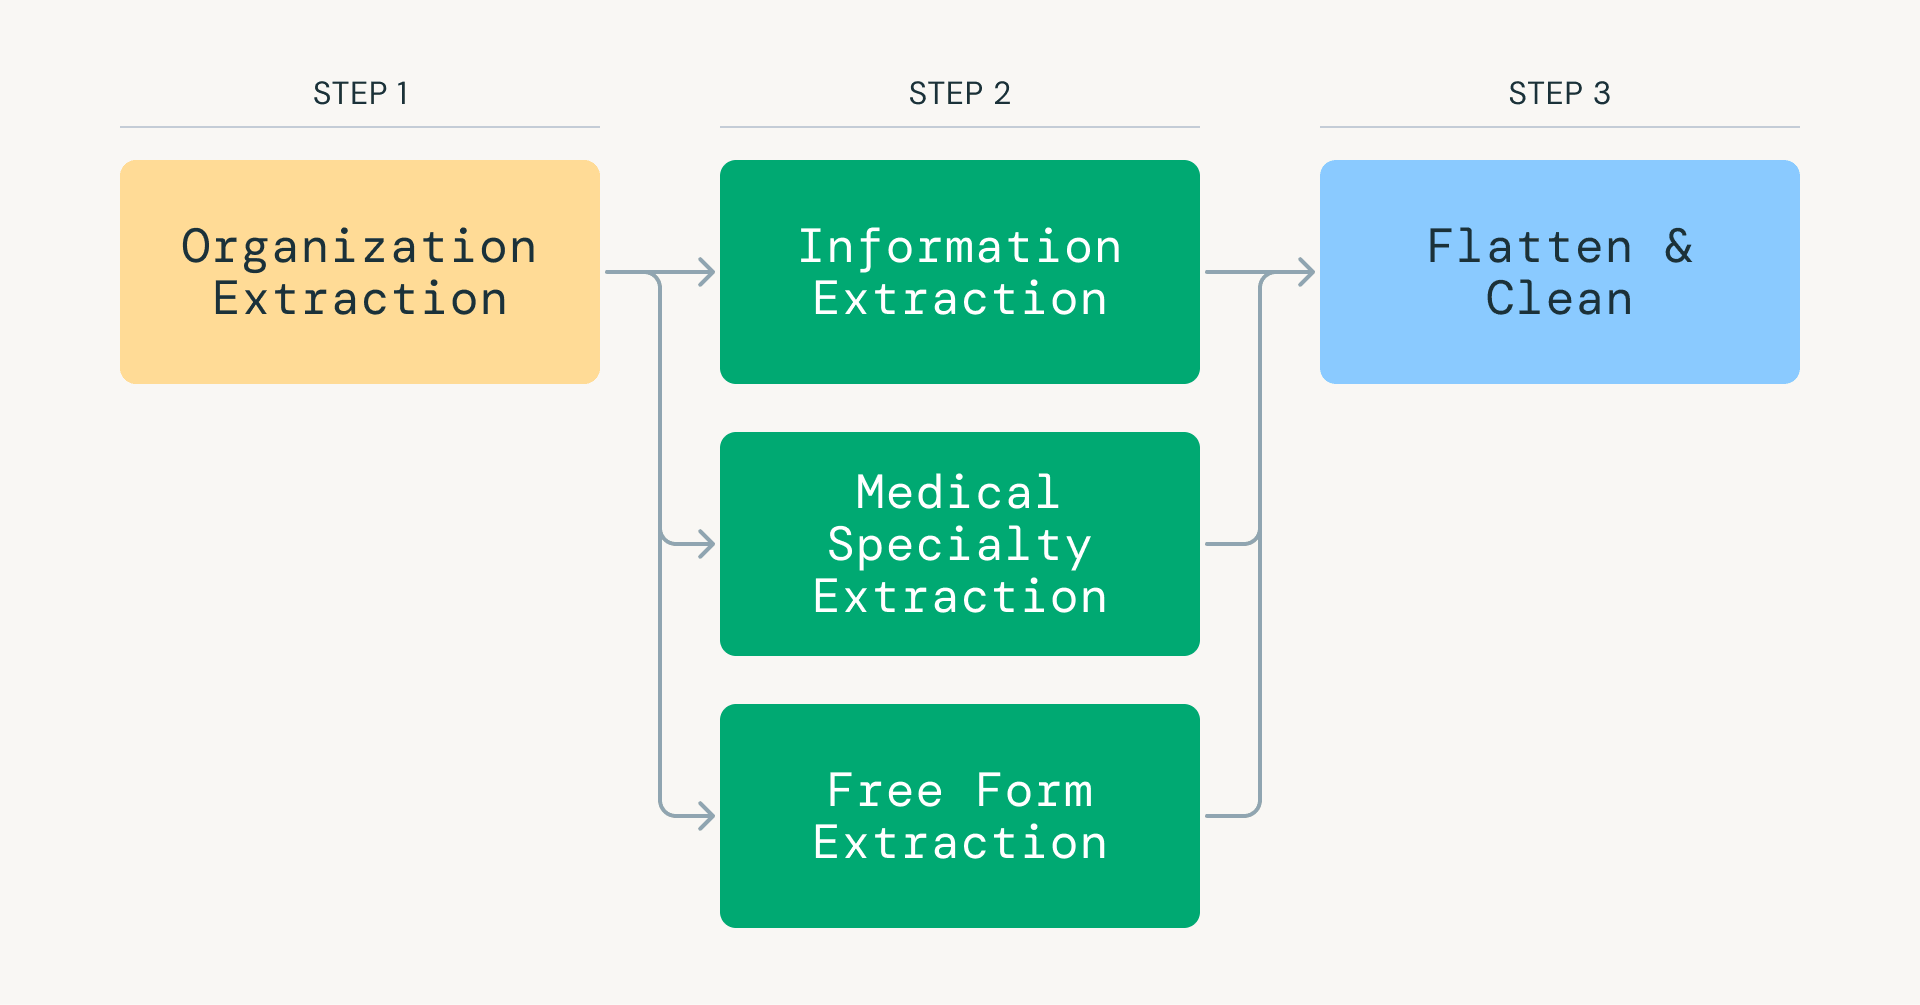
Essa abordagem reduz drasticamente o consumo de tokens, ao mesmo tempo em que foca cada invocação do modelo em uma tarefa específica e de alta precisão. O Databricks e o Apache Spark são usados para orquestrar e paralelizar com eficiência os dados coletados, distribuindo cargas de trabalho entre milhares de executores e permitindo inferência de LLM de alto rendimento (high-throughput).
Vários recursos críticos tornam esse pipeline escalável e pronto para produção:
- Modelagem de dados extensível: os dados em cada etapa são armazenados em um esquema em estrela (star schema), simplificando as análises downstream e melhorando o desempenho das consultas.
- Ponto de controle (checkpointing) baseado em status: cada registro rastreia seu estado de processamento, permitindo que os pipelines sejam retomados de qualquer ponto sem reprocessar linhas com chamadas de LLM caras.
- Registro de extração configurável: cada método de extração é controlado por um objeto estruturado que especifica o prompt do sistema, tornando a lógica de extração modular, reproduzível e extensível.
- Processamento distribuído escalável: o sistema processa cargas de trabalho distorcidas (skewed) de vários terabytes usando Spark para paralelismo, Photon para desempenho em escala e orquestração de nível de produção.
Essas garantias são aplicadas por meio do Lakeflow Jobs, que orquestra mais de 15 tarefas interdependentes com ramificação condicional, execução paralela e políticas de repetição inteligentes. O resultado é um sistema que processa dados de instalações de saúde em escala com a precisão de especialistas médicos.
Resolução de entidades em escala
Depois que os dados das instalações e das organizações sem fins lucrativos são coletados e extraídos usando um LLM, surge um desafio clássico: a resolução de entidades. A mesma instalação pode aparecer em várias fontes de dados com variações de nome, endereços inconsistentes ou detalhes de contato ausentes. A desduplicação tradicional falha nesses cenários devido a dados desorganizados, por isso usamos o Splink, um framework de vinculação probabilística de registros de código aberto. Usando as informações obtidas em nossa etapa de IE, o Splink avalia pares de correspondência por meio de comparações ponderadas em campos como número de telefone, endereço residencial e muito mais. O resultado é uma chave unificada por instalação, garantindo que os usuários finais vejam um registro confiável para cada instalação médica e NGO.
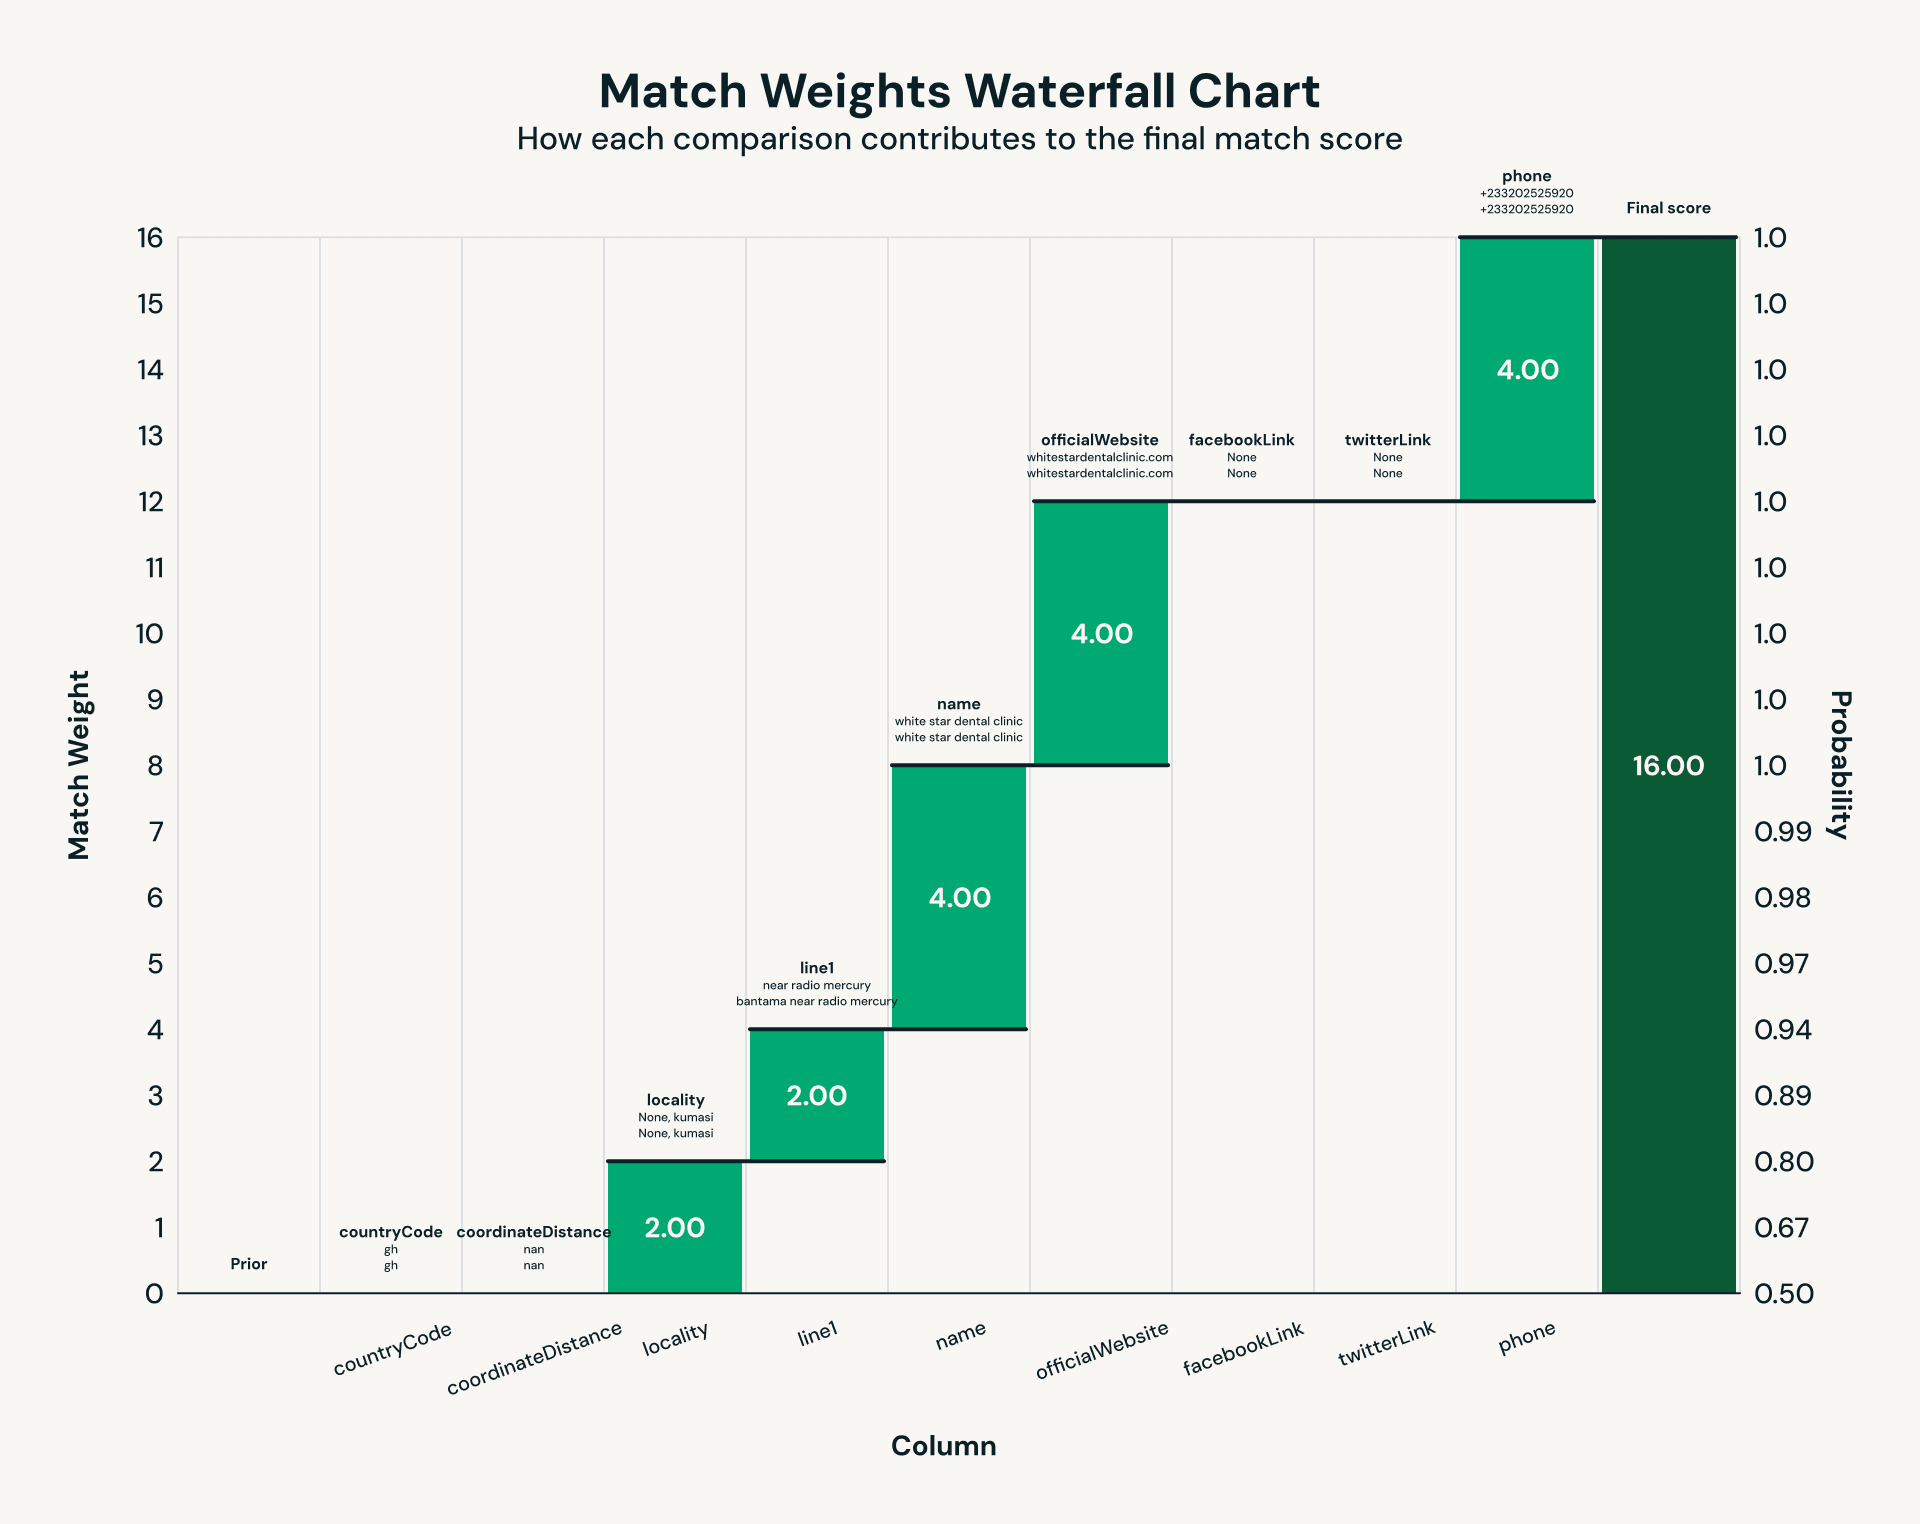
A execução de correspondência probabilística em milhares de instalações de saúde e organizações sem fins lucrativos revelou gargalos clássicos de desempenho que surgem na escala de terabytes. O núcleo da vinculação de registros é a comparação em pares, o que cria cargas de trabalho inerentemente distorcidas: comparações comuns produzem partições massivas, enquanto a maioria das outras permanece muito menor. As primeiras execuções deixaram isso dolorosamente claro, com uma partição do Spark rodando por 30 minutos enquanto a mediana era concluída em 52 segundos – um caso clássico de retardatários (a "maldição do último redutor") degradando o desempenho do trabalho. A ativação do Photon, o mecanismo de consulta vetorizado do Databricks, reduziu as partições de dados no pior caso de 30 minutos para aproximadamente 2 minutos: uma melhoria de 15 vezes.
VF Agent: a linguagem natural encontra os dados de saúde
Olhando para o futuro, desenvolvemos um protótipo de um agente que permite aos especialistas analisar dados usando linguagem natural. Usamos uma arquitetura multiagente integrada ao LangGraph e aproveitamos o Databricks Model Serving, o AI Search e o Genie.
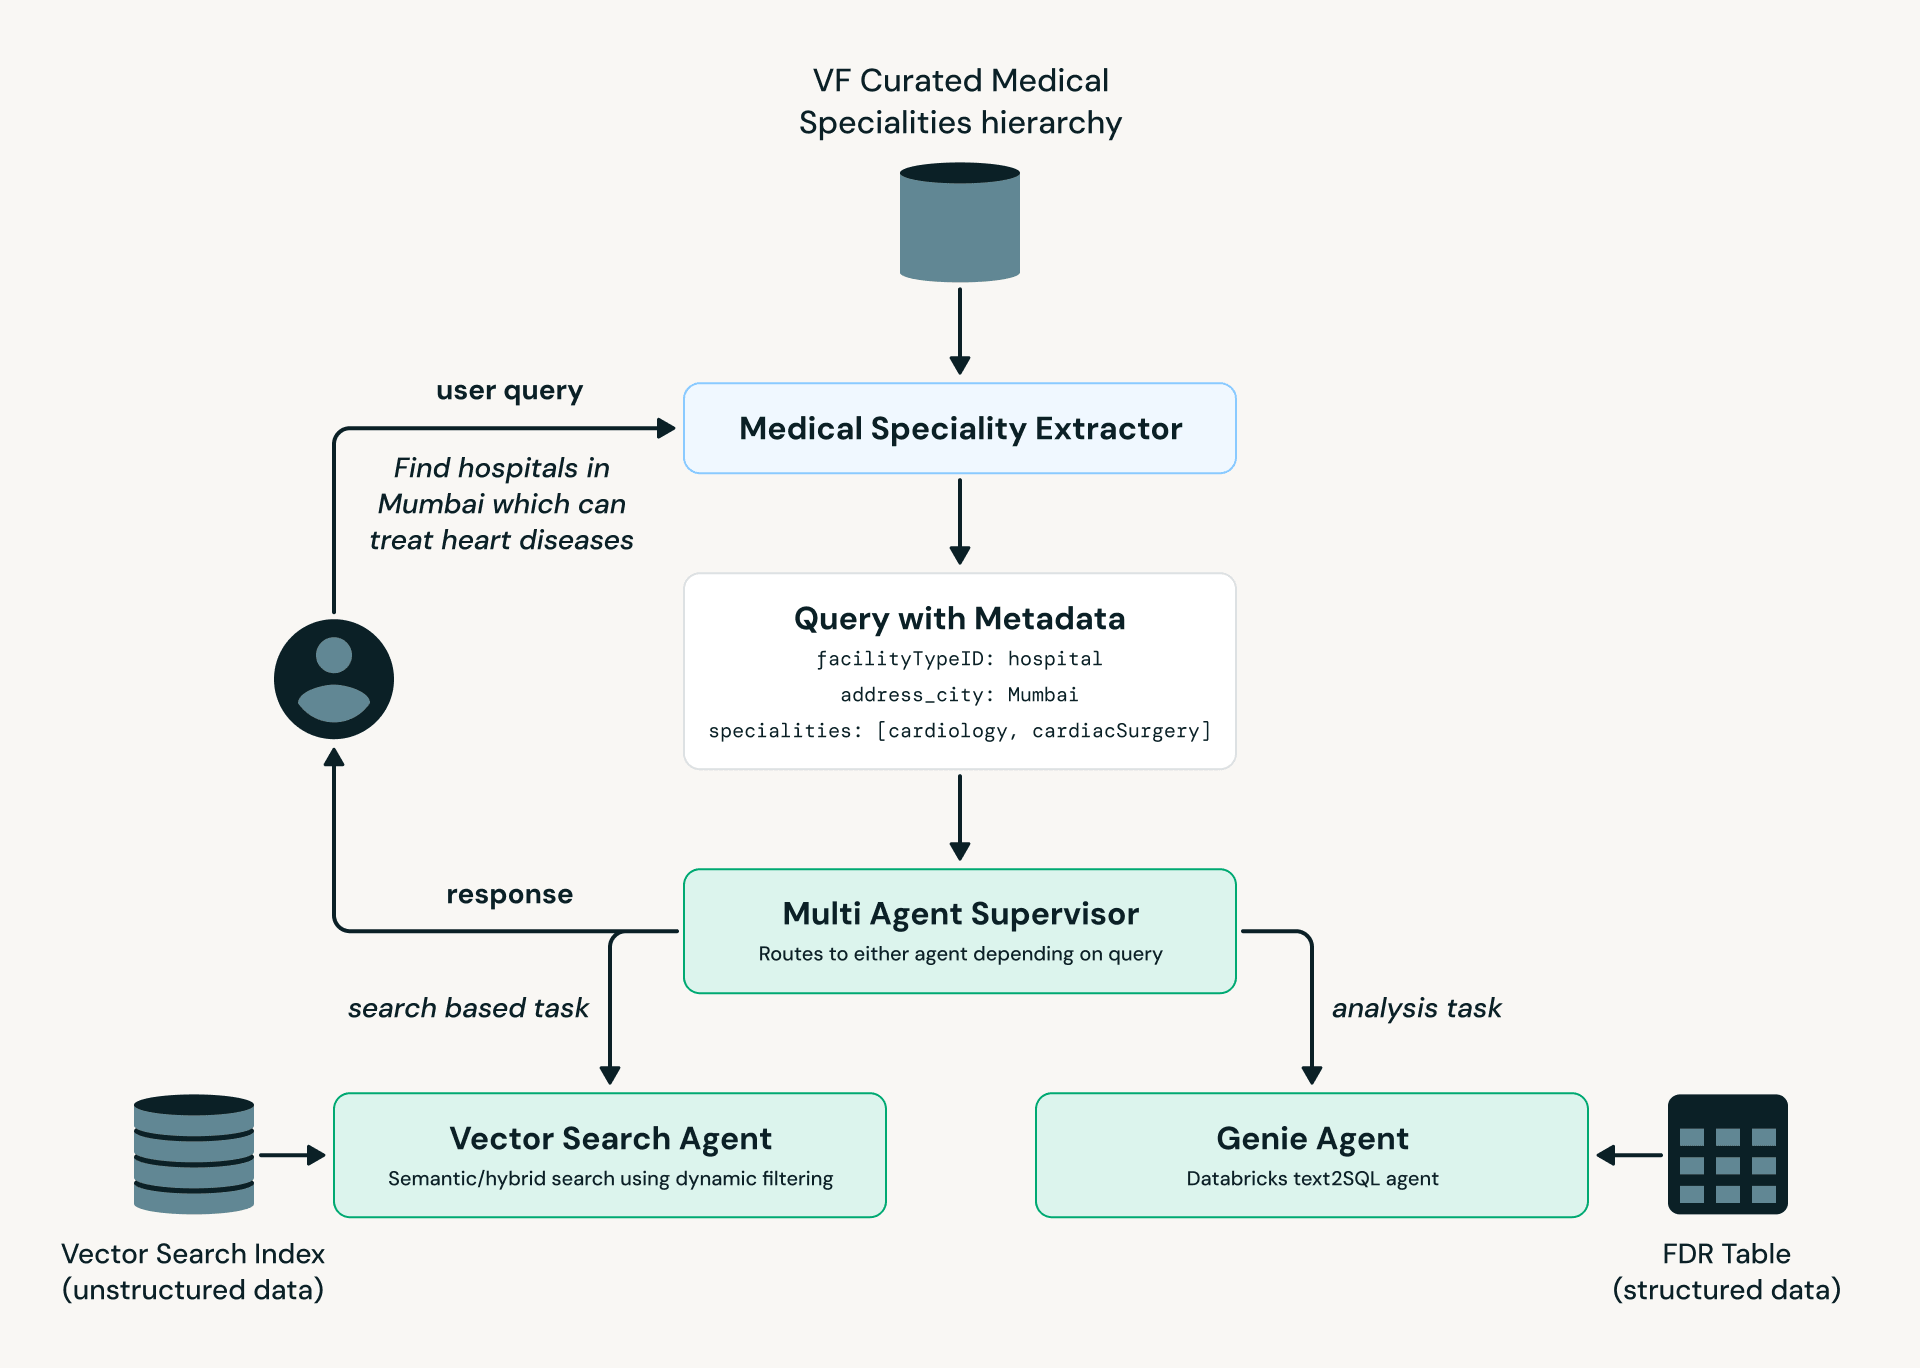
Como ilustrado no diagrama acima, o Medical Specialty Extractor converte a linguagem do usuário em terminologia médica padronizada, que é então passada para o Multi-Agent Supervisor. Com base na intenção e complexidade da consulta, ela é roteada para o AI Search Agent (descoberta e pesquisa de instalações) ou para o Genie Agent (consultas analíticas em dados estruturados).
Resumo
Os profissionais de saúde agora podem descobrir oportunidades atualizadas mais rapidamente, encontrar correspondências para suas especialidades médicas e acessar dados globais sobre milhares de instalações em todo o mundo. A jornada da Virtue Foundation, da prova de conceito à produção, demonstra o que é possível quando sistemas avançados de AI são combinados com uma plataforma de dados unificada.
O resultado final é uma visão global da infraestrutura de saúde – revelando onde os voluntários médicos são mais necessários.
Se você quiser saber mais sobre este projeto, consulte:
- Visão geral do projeto Databricks x Virtue Foundation - YouTube
- Entrevista da UN Bloomberg (YouTube) - por volta do minuto 38:00
- Depoimento em vídeo: Bright Initiative x Virtue Foundation x Databricks
Leia mais sobre alguns de nossos outros projetos do Databricks for Good abaixo:
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.