Como tirar o máximo proveito da execução do dbt no Databricks
Torne os pipelines do dbt no Databricks mais baratos, rápidos e simples de operar.
- Evite conectar ferramentas separadas e mantenha todo o pipeline em um único projeto dbt no Databricks, desde a ingestão por streaming até definições de métricas governadas
- Orquestre o dbt nativamente no Lakeflow Jobs sem a necessidade de um orquestrador externo.
- Defina a governança no próprio projeto dbt, para que as regras de acesso sejam aplicadas pelo Unity Catalog diretamente das configurações do seu projeto.
Dezenas de milhares de organizações confiam no dbt para transformação de dados. Onde você o executa molda tudo: quanto custa executar seus pipelines do dbt, quão rápido eles entram em produção e quanta carga de trabalho operacional eles demandam. Executar o dbt no Databricks oferece às suas cargas de trabalho do dbt uma plataforma aberta e um pipeline unificado.
Mais de 3.000 organizações executam o dbt no Databricks, e a maioria das equipes poderia aproveitar muito mais isso. Este blog destaca as práticas que tornam os pipelines do dbt mais baratos, rápidos e simples de operar no Databricks.
Torne seus pipelines do dbt mais baratos e rápidos
Os custos do dbt aumentam com trabalhos que você não precisa repetir. Recriações completas recalculam dados que não mudaram, manter as consultas rápidas exige ajustes manuais e, quando a conta dispara, não há uma atribuição clara aos modelos do dbt que causaram isso. Adote as práticas desta seção e seus pipelines vão:
- Recriar apenas os dados que realmente mudaram
- Manter a rapidez sem a necessidade de escolher ou reformular chaves de partição
- Executar a manutenção de tabelas automaticamente sem post-hooks
- Rastrear cada dólar gasto até um modelo específico
1. Construa apenas o que mudou com estratégias incrementais
Recriações completas de tabelas são o maior custo evitável na maioria dos projetos dbt. Quando apenas uma pequena fração dos dados muda entre as execuções, recalcular toda a tabela desperdiça sua computação e aumenta sua conta. As estratégias incrementais do dbt, todas suportadas no dbt-databricks, permitem que cada modelo processe apenas dados novos, e a escolha certa depende de como seus dados realmente chegam.
Estratégia | Use quando |
|---|---|
append | As linhas são apenas inseridas, nunca atualizadas |
merge | A mesma chave pode chegar mais de uma vez e precisa de upsert (dimensões de alteração lenta, deduplicação, atualizações com atraso) |
replace_where | O modelo recalculado gera uma janela de tempo estreita a cada execução, como os últimos dias de atividade |
insert_overwrite | Sua consulta retorna partições inteiras |
delete+insert | Você deseja que os registros sejam substituídos por chave, sem lógica de atualização no nível da coluna |
microbatch | Dados de séries temporais com uma coluna event_time e necessidades estruturadas de backfill |
A maioria dos projetos usa por padrão merge quando uma estratégia mais específica resolveria. Se você puder descrever os dados alterados com um predicado, replace_where realiza menos trabalho do que um merge que precisa verificar o destino para encontrar correspondências. Se não puder, incremental_predicates no merge reduz essa verificação consideravelmente.
Cada estratégia acima é uma decisão que você toma e precisa manter. A próxima prática deixa que a plataforma cuide disso para você.
2. Deixe as exibições materializadas cuidarem da incrementalização por você
As exibições materializadas automatizam a incrementalização. Você pode definir o modelo como SQL simples, e o Databricks rastreia quais dados subjacentes mudaram e atualiza apenas os resultados afetados. No dbt-databricks, uma exibição materializada é uma materialização nativa, portanto essa é uma alteração de configuração de apenas uma linha:
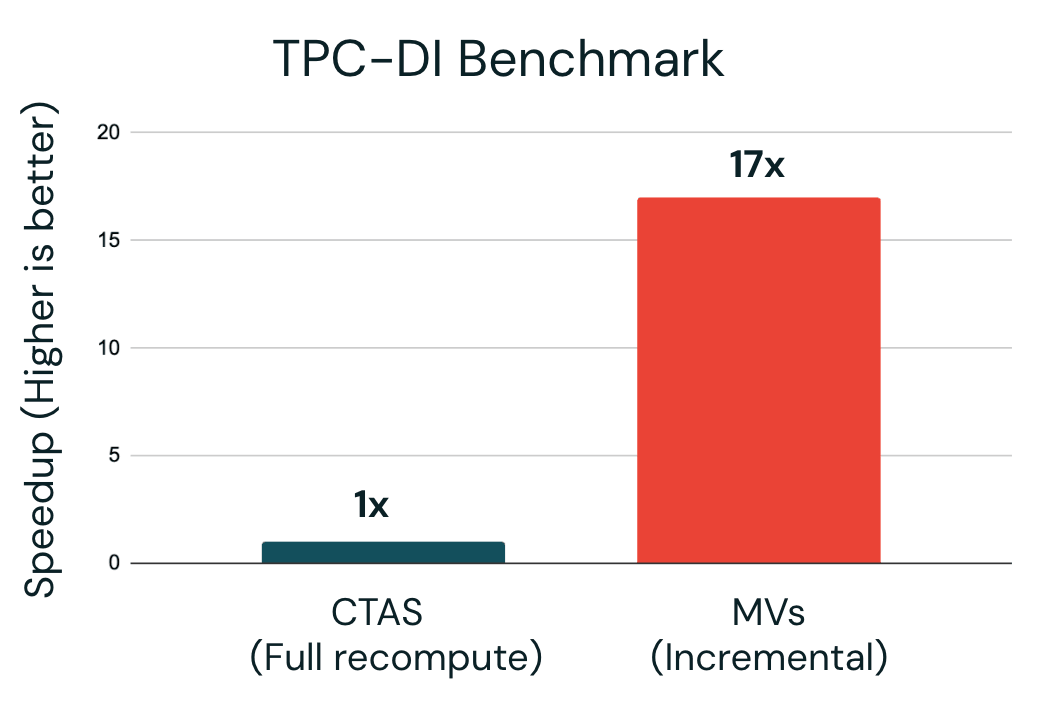
As exibições materializadas se encaixam melhor na camada de serviço: agregações sobre fontes que mudam com frequência, especialmente aquelas dispendiosas que alimentam painéis e precisam se manter atualizadas. Em nosso benchmark TPC-DI, trocar recalculamentos completos por exibições materializadas na camada de serviço ofereceu um ganho de velocidade de 17x.
3. Automatize o layout de dados para ajuste de desempenho
Escolher chaves de partição, reformulá-las quando os padrões de consulta mudam e agendar OPTIMIZE, VACUUM e ANALYZE em post-hooks consomem tempo de engenharia.
O Predictive Optimization executa OPTIMIZE, VACUUM e a coleta de estatísticas em tabelas gerenciadas automaticamente, escolhendo o que executar e quando com base em como cada tabela é consultada. Habilite-o uma vez no nível do catálogo ou do esquema, e os post-hooks que os projetos dbt costumam acumular para manutenção de tabelas podem ser desativados.
Para o layout de dados, o Liquid Clustering substitui o design de partição por um layout autoajustável. Ele organiza os dados com base em como a tabela é realmente consultada, evita a explosão de arquivos pequenos enfrentada por tabelas com excesso de partições e se adapta à medida que os padrões de consulta mudam. Ou deixe o Databricks escolhê-los e ajustá-los a partir do histórico de consultas com o Liquid Clustering automático (CLUSTER BY AUTO), alimentado pelo Predictive Optimization. Uma única configuração em nível de projeto agrupa cada nova tabela criada pelo projeto.
Ambos os recursos foram projetados como decisões únicas. Com Upgrades automáticos, as tabelas gerenciadas do Unity Catalog continuam recebendo novas otimizações conforme o Databricks as lança.
4. Atribua cada dólar com tags de consulta
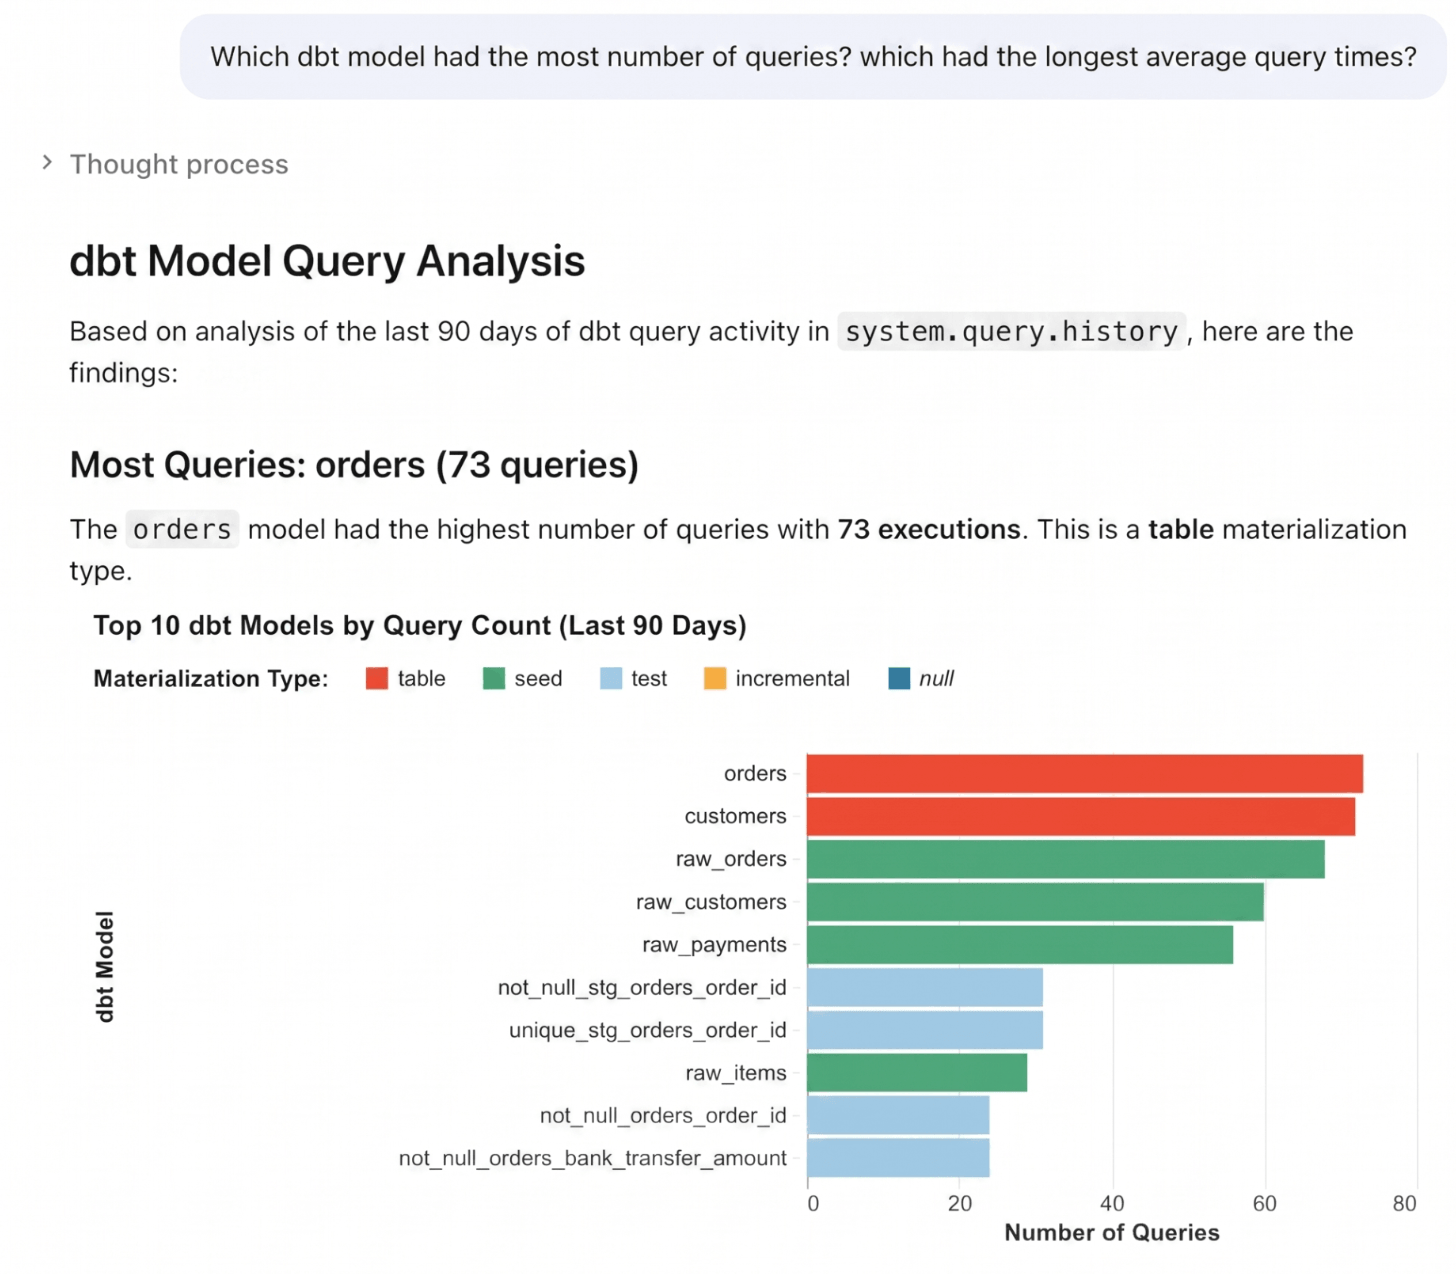
No final do trimestre, o setor financeiro pergunta por que a conta do warehouse aumentou. Na maioria das configurações, ninguém sabe responder, porque uma consulta nos dados de uso não tem nenhuma conexão com o modelo dbt que a executou.
As tags de consulta tornam essa conexão automática. Toda consulta que o dbt executa no Databricks é marcada automaticamente com o nome do modelo, a versão do dbt e o tipo de materialização. Adicione suas próprias tags personalizadas para as dimensões de orçamento da sua organização:
As tags aparecem em system.query.history, e o cruzamento com system.billing.usage atribui os gastos com warehouse serverless a qualquer agrupamento suportado pelas tags: custo por modelo, por equipe, por domínio, por materialização. Você pode ver exatamente quais modelos custam mais.
Simplifique seus pipelines dbt
Uma configuração típica do dbt depende de uma pilha de outras ferramentas: um sistema separado para ingerir os dados, um orquestrador externo para executar o projeto, ferramentas de BI onde cada uma redefine as mesmas métricas e uma governança que fica fora do seu projeto dbt. Cada item é mais uma coisa para manter e mais um lugar para divergências. Adote as práticas desta seção e um único projeto dbt irá:
- Ingerir dados diretamente no projeto
- Executar e implantar a partir do Databricks, sem um orquestrador de terceiros para manter
- Servir uma única definição de métrica governada para todas as ferramentas
- Carregar suas próprias regras de governança, versionadas junto com seus modelos dbt
1. Traga a ingestão para o projeto dbt com Streaming Tables
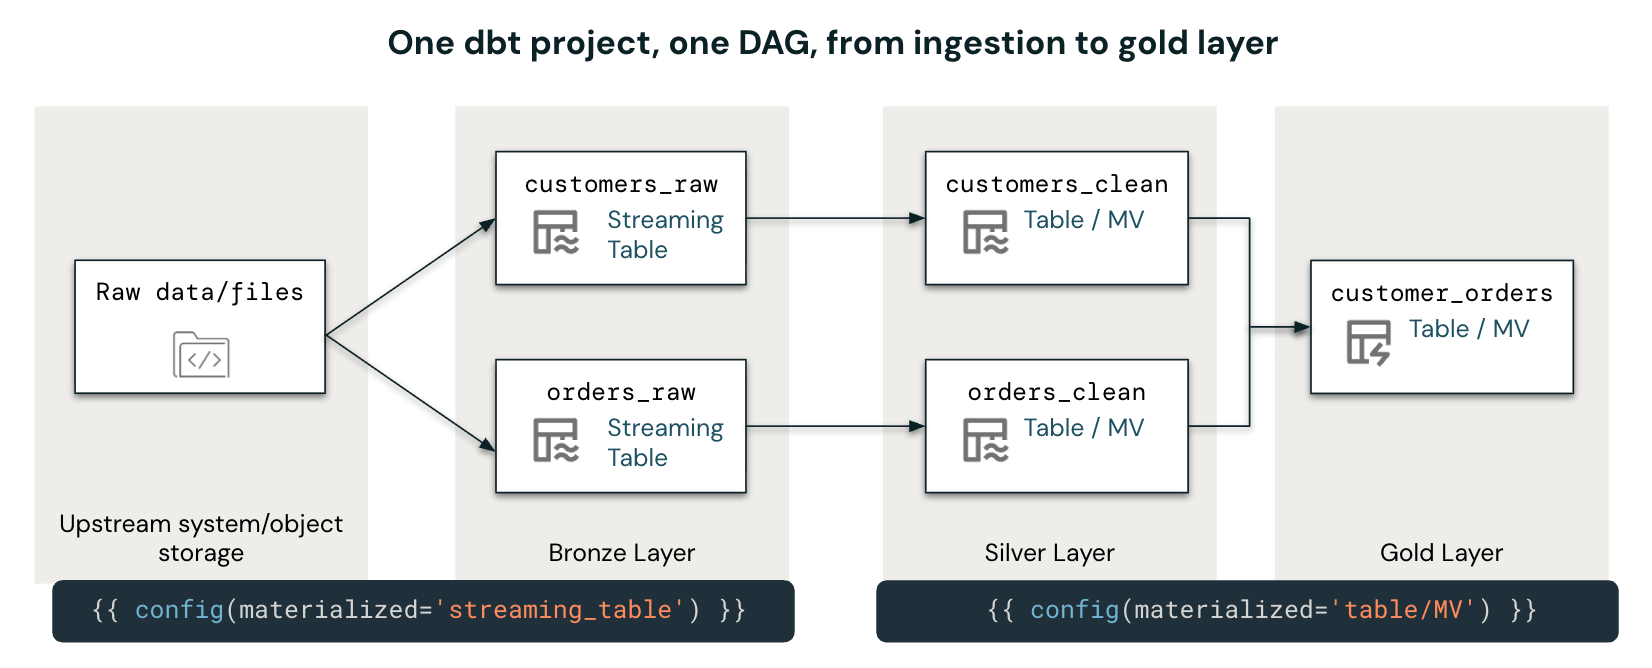
A ingestão é a parte do pipeline que tradicionalmente ficava fora do dbt, resultando em uma arquitetura dividida sem uma visão única da linhagem. A materialização streaming_table elimina essa divisão. Um modelo dbt materializado como uma streaming table coleta incrementalmente novos arquivos ou eventos conforme eles chegam, de modo que a ingestão se torna apenas mais um modelo no DAG.
A partir daí, o restante do pipeline (modelos silver e gold) pode referenciar a streaming table com ref(), testes e documentação se aplicam a todas as camadas, e a linhagem cobre todo o caminho desde os arquivos brutos até o mart final.
2. Padronize métricas com Unity Catalog Semantics
Toda ferramenta de BI, agente ou outro consumidor de dados cria suas próprias definições de métricas, o que gera confusão e divergências entre as partes interessadas. Uma metric view move a definição para um único local governado: você declara as medidas e dimensões uma única vez e todos os consumidores consultam a mesma lógica.
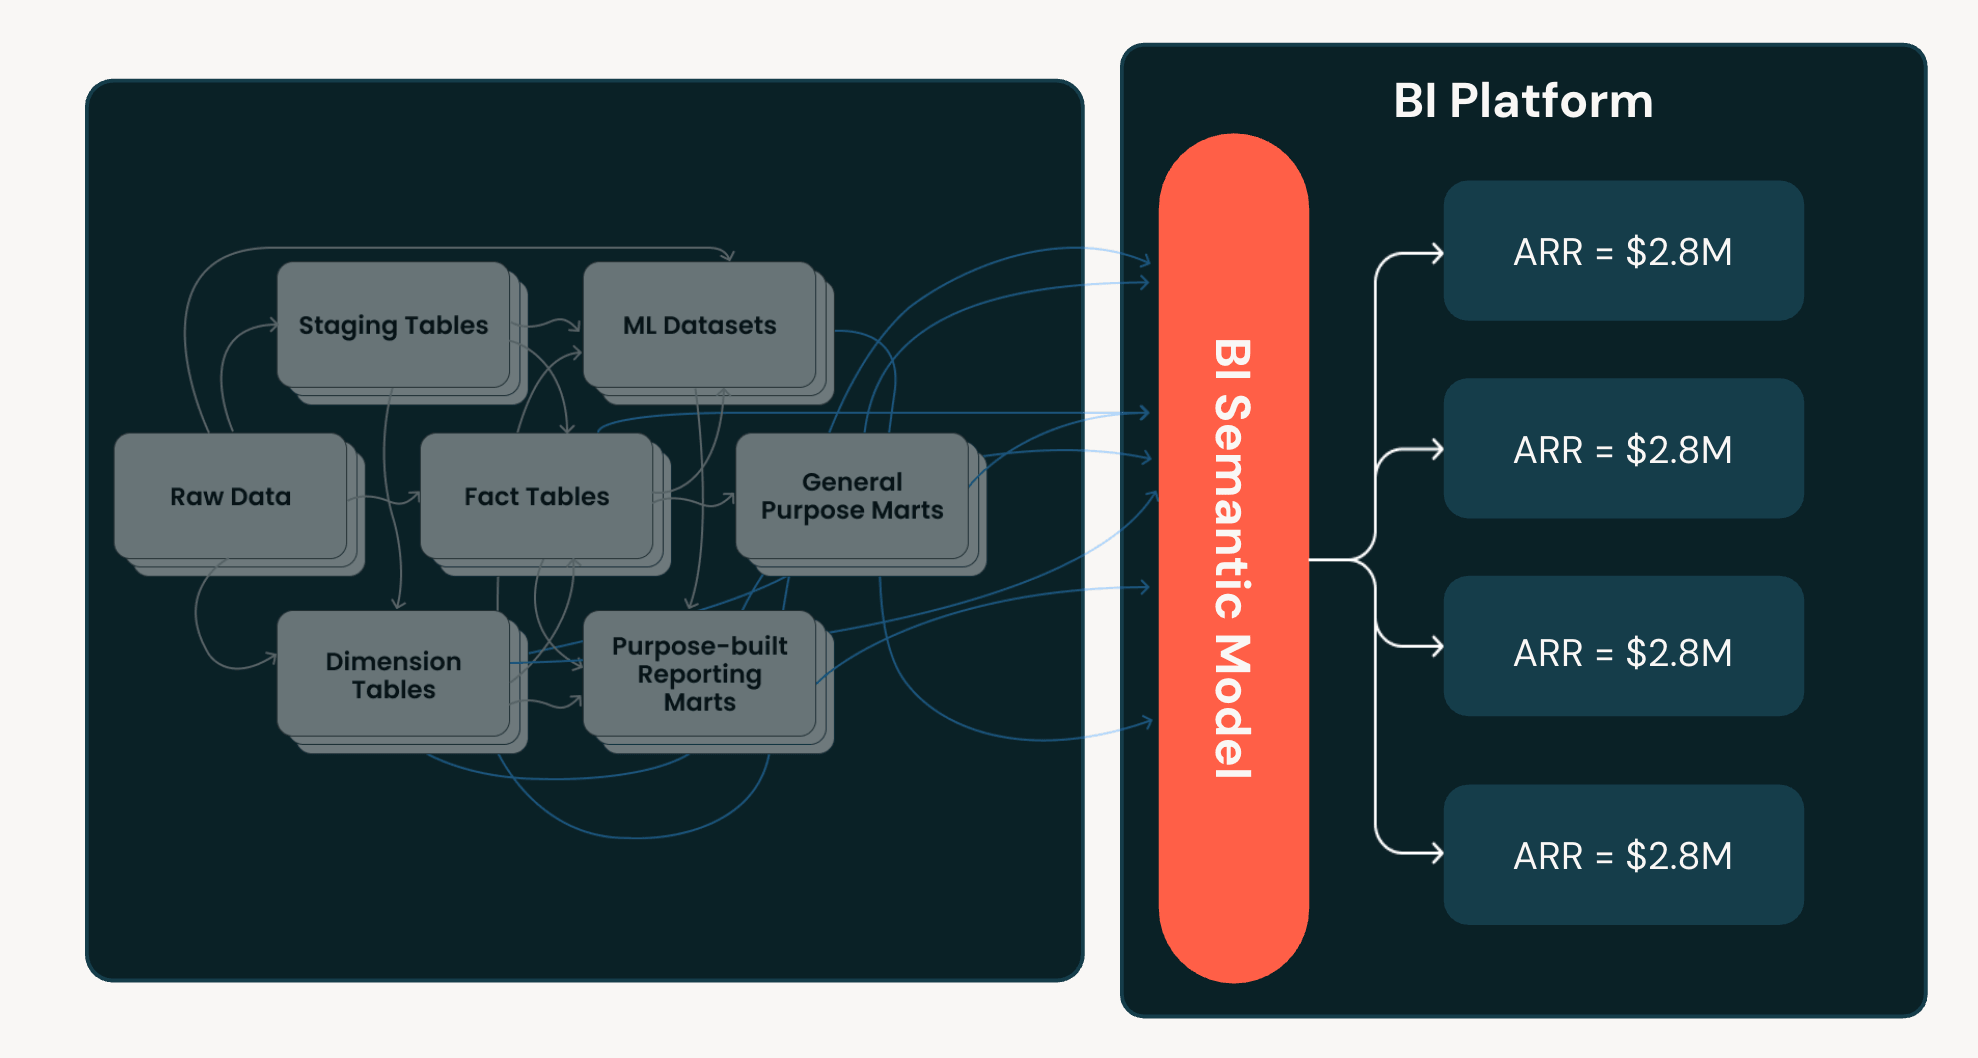
O dbt-databricks expõe metric views como um tipo de materialização nativo, para que a definição fique no seu projeto dbt, versionada e revisada como qualquer outro modelo.
Os usuários podem escolher seus próprios agrupamentos no momento da consulta com a função MEASURE(), para que a mesma definição sirva ao editor SQL, painéis de BI, notebooks e Genie.
3. Orquestre o dbt nativamente via Lakeflow Jobs
Uma execução do dbt raramente é todo o pipeline. Quando as etapas upstream e downstream estão em ferramentas diferentes, a complexidade se acumula: ferramentas adicionais para gerenciar, pagar e proteger, com uma linhagem dispersa.
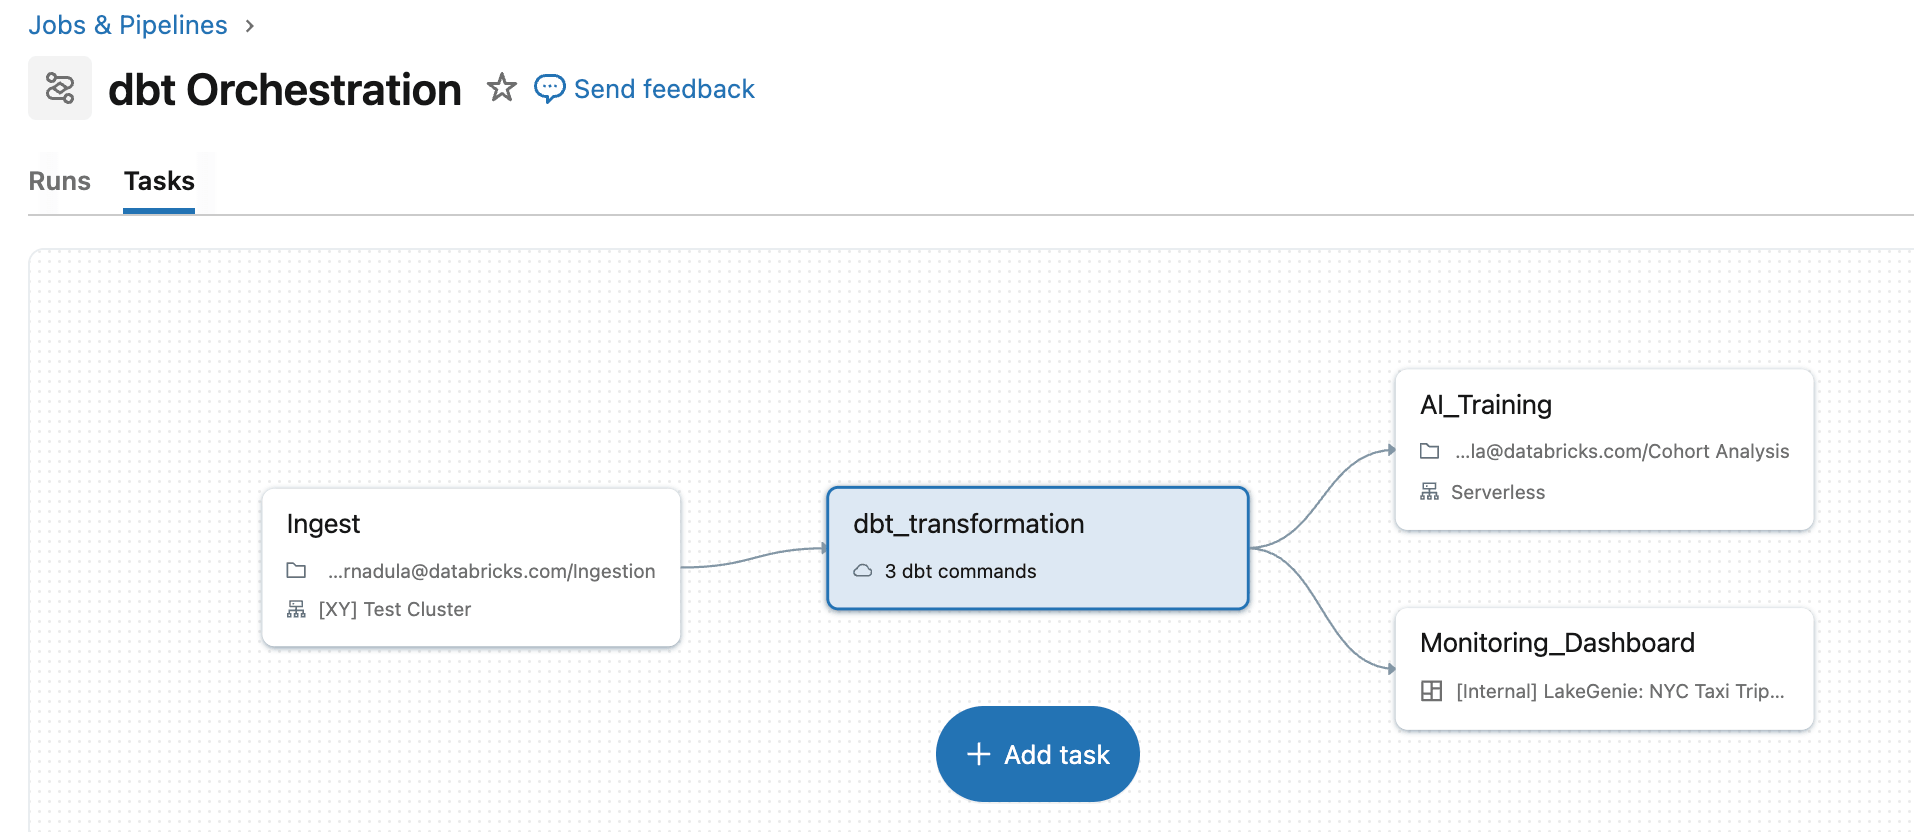
O Lakeflow Jobs unifica tudo isso em um único Gráfico Acíclico Dirigido (DAG) com o dbt como uma tarefa nativa. Uma tarefa de ingestão alimenta a tarefa dbt e as tarefas downstream são acionadas após a conclusão, com dependências impostas pela plataforma. A camada operacional já vem integrada com agendamento, tentativas automáticas, histórico de execuções e alertas, sem infraestrutura adicional para manter. O Jobs suporta dbt Core e dbt Platform, e o suporte para o dbt Core v2.0 está a caminho.
4. Implante como código com Declarative Automation Bundles
Um job montado manualmente na interface do usuário é difícil de versionar, revisar ou reproduzir. Os Declarative Automation Bundles (DABs) resolvem isso tornando a definição do job parte do repositório de código. O Lakeflow Job, seu agendamento, configurações de computação e o projeto dbt, todos declarados em YAML e implantados como um único pacote.
A implantação com --target dev cria uma cópia isolada de todo o pipeline; --target prod a promove.
Nem todo modelo dentro de um projeto precisa ser executado em todos os agendamentos. Adicione tags aos modelos por frequência no YAML do dbt e atribua a cada frequência seu próprio job, que constrói apenas os modelos que contêm sua tag. Mudar um modelo de diário para de hora em hora torna-se uma alteração de apenas uma linha:
5. Defina a governança no projeto
A governança geralmente é configurada após a execução dos modelos, separadamente do projeto dbt que constrói os dados. Como a governança fica fora do seu projeto dbt, ela pode ficar desalinhada com suas execuções do dbt.
Defina a governança no projeto dbt onde os modelos já residem. Como configuração de projeto, ela é enviada com o código, é revisada como o código e o Unity Catalog a aplica a cada consulta.
Tags, concessões (grants) e proteção em nível de linha e coluna podem ser definidas na configuração de todo o projeto em dbt_project.yml. databricks_tags orienta a classificação e as políticas, grants controla quem pode ler a tabela, e row_filters e column_masks controlam o que cada usuário vê:
Em escala, o controle de acesso baseado em atributos (ABAC) elimina a repetição. Defina uma política em uma tag governada e ela aplicará os filtros de linha e máscaras de coluna corretos a cada tabela com essa tag, para que um novo modelo com a tag pii esteja coberto no momento em que for construído. Use filtros e máscaras por modelo apenas quando a lógica for realmente específica do modelo, como no caso do isolamento multilocatário.
O elemento comum entre essas práticas é transferir o trabalho operacional para a plataforma: processamento incremental, layout de dados, manutenção de tabelas, aplicação de governança e orquestração. O que permanece no seu projeto dbt é sua lógica de transformação testada e com controle de versão. Escolha a prática que resolve o problema atual do seu projeto e comece por aí.
Junte-se a mais de 3.000 organizações que já usam o dbt no Databricks. Comece a usar o adaptador dbt-databricks.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.