Postgres Gerenciado: O que o Lakebase realmente resolve por você
Veja o que o Lakebase realmente automatiza no Postgres gerenciado — aplicação de patches, escalonamento, failover e backups — e onde a responsabilidade ainda é sua.
- O Postgres gerenciado deve poupar a equipe de banco de dados de operações rotineiras, como aplicação de patches, escalonamento, failover e backups.
- O Lakebase executa o PostgreSQL em infraestrutura serverless com escalonamento automático, redução a zero (scale-to-zero), recuperação em um ponto no tempo (point-in-time recovery), branching, pgvector e PostGIS.
- O Lakebase lida com a maioria das operações do Postgres gerenciado dentro de uma região, enquanto a recuperação de desastres entre regiões ainda exige procedimentos de recuperação gerenciados pelo cliente.
Cada provedor de Postgres se autodenomina "gerenciado". Poucos concordam sobre o que essa palavra abrange. Alguns querem dizer que aplicam patches no sistema operacional (OS) e deixam o resto para a equipe de banco de dados. Outros querem dizer que o banco de dados escala, lida com falhas e faz backup de si mesmo sem que ninguém da equipe precise tocar em um arquivo de configuração.
O Postgres gerenciado é um serviço de banco de dados no qual o provedor opera a infraestrutura subjacente e lida com as principais operações do banco de dados, como aplicação de patches, escalonamento, failover e backups, para que a equipe de banco de dados gaste menos tempo com manutenção e mais tempo criando a aplicação que roda sobre ele. Quanto mais dessas operações o provedor assumir, menos administração de banco de dados restará para o cliente.
Essa distinção se torna ainda mais importante à medida que o Postgres avança para aplicações de AI. O banco de dados agora pode conter o estado da aplicação, histórico de conversas, embeddings e dados de agentes, além das cargas de trabalho transacionais tradicionais, de modo que a superfície operacional se estende além de apenas manter o banco de dados em execução.
O Lakebase Postgres leva essa abordagem gerenciada para o Postgres serverless, combinando escalonamento automático, compatibilidade com PostgreSQL, recuperação e integrações com a Databricks. A questão é quanto trabalho operacional ele realmente elimina.
TL;DR
- O Postgres gerenciado deve tirar da responsabilidade da equipe de banco de dados as operações rotineiras, como aplicação de patches, escalonamento, failover e backups.
- O Lakebase executa o PostgreSQL em infraestrutura serverless com escalonamento automático, scale-to-zero, snapshots automáticos, recuperação point-in-time, branching e suporte para extensões populares como pgvector e PostGIS.
- O Lakebase lida com a maioria das operações de Postgres gerenciado dentro de uma região.
O que realmente significa Postgres gerenciado
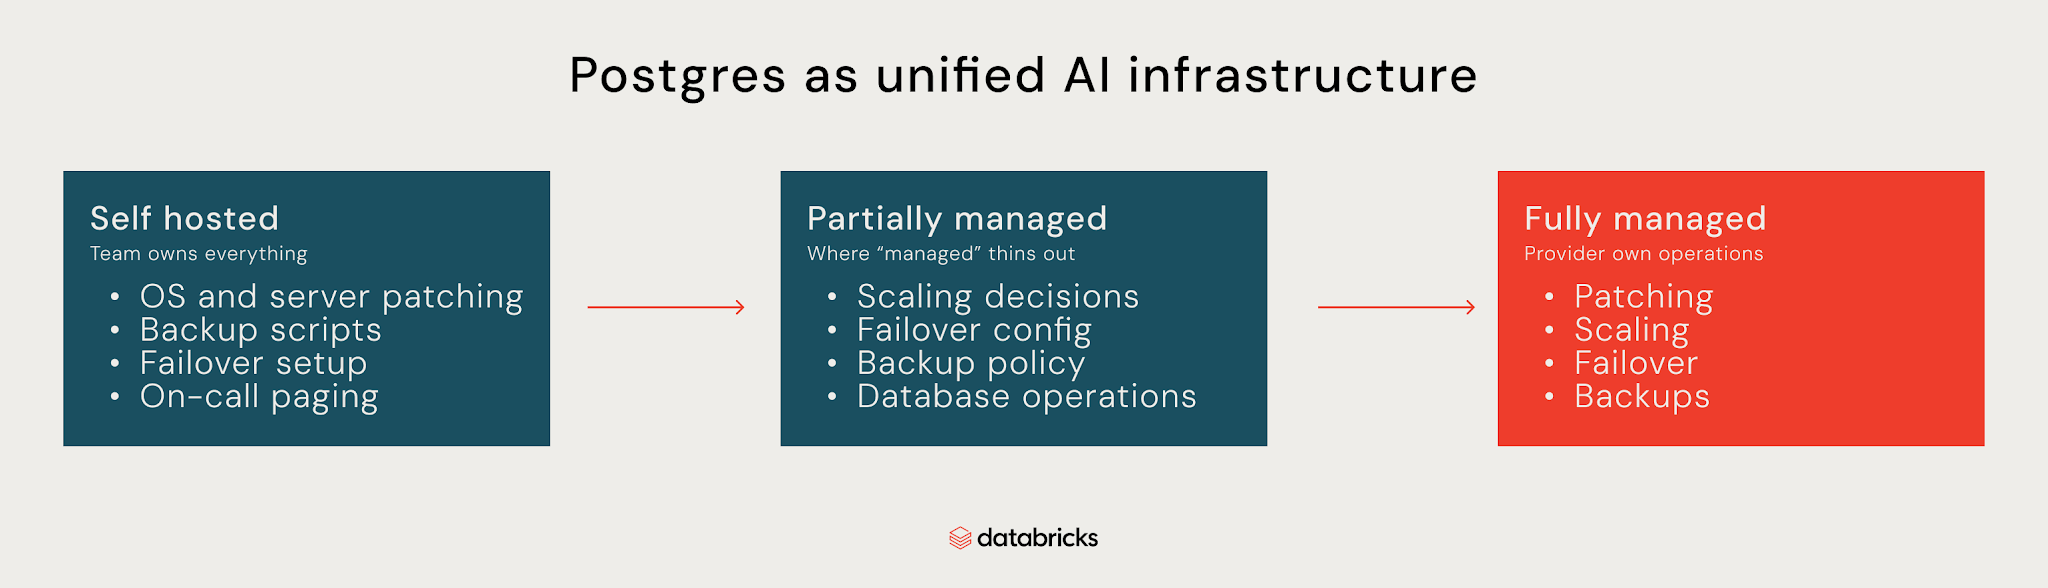
Pense no Postgres gerenciado como entregar as chaves de um banco de dados. O quanto uma equipe entrega depende do provedor. Em um extremo, a equipe de banco de dados ainda lida com o servidor, backups, failover e escalonamento. No outro, um serviço totalmente gerenciado cuida do trabalho operacional para a equipe, não apenas da infraestrutura subjacente. A maioria dos provedores fica em algum lugar no meio, gerenciando a VM e a rede, enquanto deixa algumas operações de banco de dados, decisões de escalonamento, configuração de failover e políticas de backup para a equipe.
Um provedor pode aplicar patches no OS e chamar o banco de dados de gerenciado, enquanto a equipe ainda é responsável pelo trabalho que o mantém disponível e recuperável.
Aplicação de patches, escalonamento, failover e backups são um bom ponto para traçar essa linha. Um serviço gerenciado também determina quanto da segurança, recuperação, migração, cargas de trabalho de AI e ferramentas de desenvolvimento em torno do Postgres sua equipe ainda precisa gerenciar.
O Postgres gerenciado é um serviço no qual o provedor opera a infraestrutura do banco de dados e lida com as principais tarefas operacionais, como aplicação de patches, escalonamento, failover e backups. Um serviço totalmente gerenciado assume a responsabilidade por essas operações, para que sua equipe possa se concentrar em criar soluções com o Postgres em vez de executá-lo.
O que o Postgres gerenciado deve gerenciar
O teste mais claro de onde um serviço se enquadra nesse espectro é se ele tira estas quatro tarefas operacionais da responsabilidade da equipe:
Manutenção e aplicação de patches
Um provedor gerenciado deve aplicar patches de OS, versões secundárias do PostgreSQL e manutenções rotineiras, como ajuste de vacuum, sem que a equipe de banco de dados precise agendar ou executar nada manualmente — o oposto do Postgres auto-hospedado, onde tudo isso fica sob responsabilidade deles. Atualizações de versões principais ainda exigem planejamento, já que as extensões e o comportamento da aplicação podem mudar, mas um bom provedor reduz essa necessidade ao mínimo e torna o caminho de atualização claro.
Escalonamento
A capacidade deve se ajustar à carga de trabalho sem que os engenheiros de plataforma precisem redimensionar a infraestrutura manualmente: escalonamento vertical para mais computação ou memória, réplicas de leitura para o tráfego de leitura e, idealmente, escalonamento serverless que elimina totalmente essa decisão. O escalonamento automático do Lakebase é um exemplo em produção, permitindo gravações no Postgres 5 vezes mais rápidas do que no Postgres padrão. O teste real é um pico de tráfego: se a equipe de banco de dados estiver monitorando a utilização e esperando por um redimensionamento, o escalonamento ainda é trabalho deles.
Alta disponibilidade e failover
O banco de dados deve permanecer ativo quando a infraestrutura falhar, sem que um engenheiro de plantão precise promover manualmente uma réplica às 2h da manhã. Alguns provedores lidam com isso usando instâncias em standby que assumem o controle automaticamente; outros, como o Lakebase, substituem a computação com falha imediatamente, já que ela não mantém um estado local durável. Ainda assim, nem todo provedor realiza o failover na mesma velocidade ou com a mesma perda de dados. Alguns perdem segundos de gravações no processo; outros não perdem nada. Esse é o detalhe que vale a pena verificar antes de confiar no rótulo, incluindo se o failover existe e o que acontece com as gravações em andamento quando ele é acionado.
Backups e recuperação
Backups automáticos e um processo de restauração que as equipes possam executar sem precisar de um ticket de suporte são o básico. A recuperação point-in-time (PITR) restaura os dados para um momento específico em vez de apenas para o último snapshot, o que é fundamental quando uma migração malsucedida corrompe os dados no meio da tarde. A queda de uma região inteira é um problema maior, medido pelo Recovery Time Objective (RTO) — quanto tempo você fica fora do ar — e pelo Recovery Point Objective (RPO) — quanta perda de dados você pode tolerar. Um provedor sem números definidos para ambos não tem um plano de recuperação de desastres, apenas um palpite.
Como o Postgres gerenciado protege seus dados
Um banco de dados gerenciado deve criptografar os dados em repouso e em trânsito, controlar quem pode acessá-los e dar às equipes de dados visibilidade sobre as atividades do banco de dados. Isso significa:
- Criptografia: Os dados precisam de proteção em repouso e em trânsito, no disco e na movimentação entre sua aplicação e o banco de dados. O detalhe que vale a pena verificar é quem controla as chaves, já que alguns provedores gerenciam a criptografia inteiramente do lado deles, o que se torna um problema no momento em que um requisito de conformidade ou política interna exige que a organização as possua. As chaves gerenciadas pelo cliente oferecem esse controle, mantendo as operações subjacentes do banco de dados com o provedor.
- Controle de acesso: O controle de acesso baseado em funções lida com o básico, concedendo privilégios diferentes a usuários e serviços distintos, mas os sistemas de produção geralmente exigem mais, e os setores que lidam com dados de pagamento precisam atender a padrões como o Payment Card Industry Data Security Standard (PCI DSS) além disso. O controle de acesso baseado em atributos por meio do Unity Catalog estende essas políticas ainda mais, considerando propriedades do usuário, do recurso ou da solicitação, em vez de depender apenas de funções.
- Logs de auditoria: Sem visibilidade sobre quem fez o quê e quando, investigar um incidente fica mais difícil, assim como comprovar a conformidade. Os logs de auditoria devem dar às equipes de dados visibilidade sobre as atividades administrativas e do banco de dados por padrão, e não ser algo que elas precisem configurar, operar e manter como um pipeline separado sobre o banco de dados.
O que considerar ao migrar um banco de dados PostgreSQL existente
Uma migração pode parecer simples até que o novo banco de dados não ofereça suporte a uma extensão, configuração ou recurso do PostgreSQL do qual uma aplicação dependa. Verifique do que a aplicação depende antes de mover qualquer coisa. Aqui estão os principais pontos a considerar ao migrar um banco de dados PostgreSQL existente:
- Compatibilidade: Verifique se a configuração atual se comporta da mesma maneira na nova plataforma: suporte à versão do PostgreSQL, configurações personalizadas e premissas no nível da aplicação que podem não se sustentar após a mudança de infraestrutura. A compatibilidade padrão com o protocolo de conexão do Postgres significa que as strings de conexão existentes, mapeadores objeto-relacionais (ORMs), drivers e ferramentas têm uma chance real de funcionar sem alterações no código.
- Extensões: A migração é o momento em que as equipes descobrem se todas as extensões das quais o banco de dados depende foram migradas com sucesso. Por isso, verifique a lista de suporte do provedor em relação ao que está realmente em uso antes de se comprometer. Vale a pena verificar o pgvector para cargas de trabalho de AI ou embeddings, o PostGIS é importante para dados geoespaciais, e qualquer outra extensão da qual uma aplicação dependa deve ser verificada individualmente, em vez de presumir que uma opção popular estará disponível.
- Métodos de migração: A migração baseada em dump, que exporta e restaura na nova plataforma, é simples e funciona para bancos de dados menores ou janelas de manutenção planejadas. A replicação lógica mantém a origem ativa enquanto transmite as alterações para o destino, permitindo que as equipes façam a transição com uma interrupção muito menor assim que ambos estiverem sincronizados. A escolha certa depende do tamanho do banco de dados, do volume de gravação e de quanto tempo de inatividade a empresa pode tolerar.
- Validação e transição: Uma migração não está concluída apenas porque os dados foram movidos. Execute a carga de trabalho de consulta real no novo banco de dados e compare os resultados e o desempenho com a origem, já que a correspondência na contagem de linhas não é suficiente; os planos de consulta, os tempos de resposta e o comportamento do aplicativo precisam se manter consistentes. Planeje a transição pensando em um caminho de rollback, para que a equipe saiba como direcionar o tráfego de volta se algo der errado, em vez de ter que descobrir isso no meio de um incidente.
Seu guia compacto para analítica moderna
O Postgres é bom para aplicações de AI?
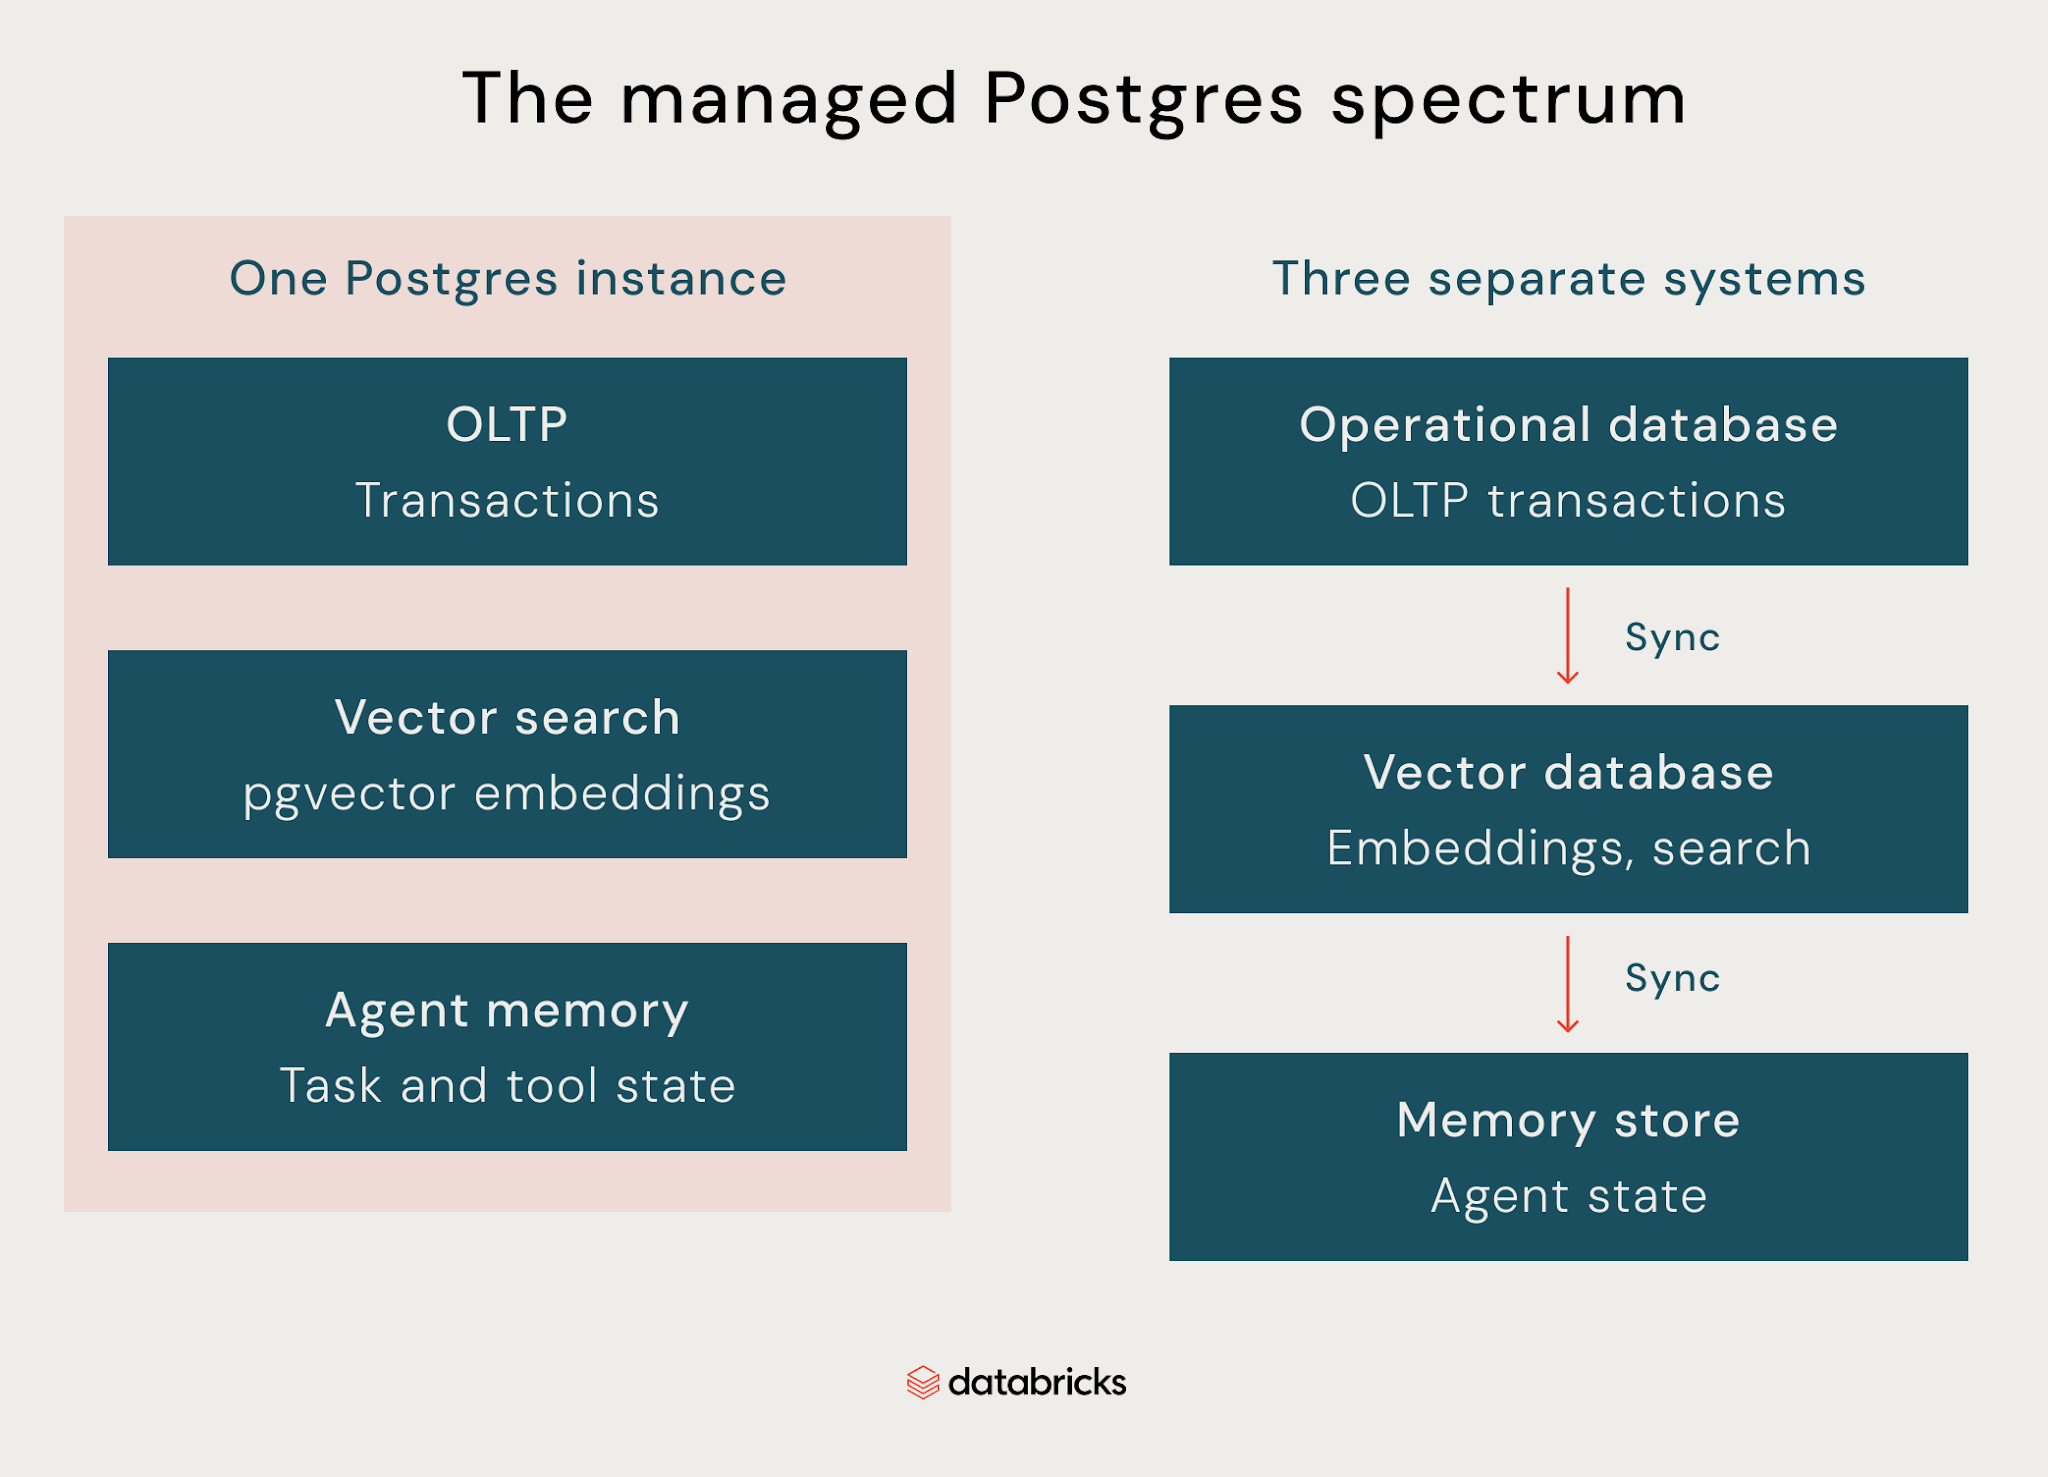
O Postgres pode ser uma excelente opção para aplicações de AI quando uma aplicação precisa de estado transacional e busca vetorial no mesmo sistema. Isso se resume a quatro coisas: o pgvector como a extensão que torna isso possível, a busca vetorial para recuperação, a memória de grandes modelos de linguagem (LLM) para persistir o estado entre as requisições e as cargas de trabalho de agentes que precisam de ambos ao mesmo tempo.
pgvector
pgvector adiciona um tipo de dados vetorial e indexação de busca por similaridade diretamente no Postgres, para que os embeddings fiquem junto com o restante dos dados da sua aplicação, em vez de em um sistema próprio. A desvantagem é que um banco de dados vetorial separado significa que manter os embeddings e os dados operacionais sincronizados se torna um problema de engenharia à parte, algo que o pgvector elimina para cargas de trabalho que não precisam de um repositório vetorial dedicado.
Busca vetorial e busca semântica
O pgvector permite armazenar embeddings e usar índices de vizinho mais próximo aproximado (ANN) para encontrar vetores semelhantes de forma eficiente à medida que o conjunto de dados cresce, o que viabiliza a busca semântica, a geração aumentada de recuperação e a correspondência baseada em significado dentro do Postgres. A estratégia de indexação correta ainda depende do tamanho do conjunto de dados e dos padrões de consulta, portanto, o pgvector não elimina a necessidade de avaliar o desempenho para sua carga de trabalho específica.
Memória de LLM
As aplicações de LLM precisam de um lugar para manter o estado entre as requisições, incluindo o histórico de conversas, preferências do usuário, documentos recuperados e resultados de ferramentas. O Postgres pode armazenar esse estado como dados relacionais comuns, enquanto o pgvector lida com os embeddings no mesmo banco de dados. Para cargas de trabalho que exigem recuperação vetorial especializada em escala muito grande, um banco de dados vetorial dedicado ainda pode fazer sentido, mas muitas aplicações de AI podem manter o estado operacional e a recuperação juntos.
Cargas de trabalho de agentes
Os agentes leem e atualizam o estado continuamente enquanto são executados. Eles acompanham conversas, armazenam resultados intermediários e registram chamadas de ferramentas, o que torna o banco de dados parte da camada de execução do agente, e não apenas um lugar para recuperar contexto. Um banco de dados desenvolvido para cargas de trabalho de agentes de AI precisa suportar tanto esse estado transacional em constante mudança quanto a recuperação que o agente usa para encontrar o contexto relevante, em um único sistema.
Postgres para desenvolvimento de aplicações
Além de executar cargas de trabalho de produção, o Postgres precisa apoiar a maneira como sua equipe realmente desenvolve. Isso significa garantir que as conexões não se tornem um gargalo à medida que você escala, e que testar alterações de esquema não signifique colocar em risco os dados de produção.
Gerenciamento de conexões
O Postgres tem um limite finito de conexões que pode manter simultaneamente, e instâncias de aplicação que escalam horizontalmente podem atingir esse limite antes que a computação ou o armazenamento se tornem o gargalo. O pool de conexões reutiliza conexões de banco de dados estabelecidas entre as requisições, em vez de abrir uma nova conexão para cada uma. Em um serviço gerenciado, o que importa é se o pool de conexões já vem integrado ou se é algo que sua equipe precisa operar separadamente.
Ramificação de banco de dados
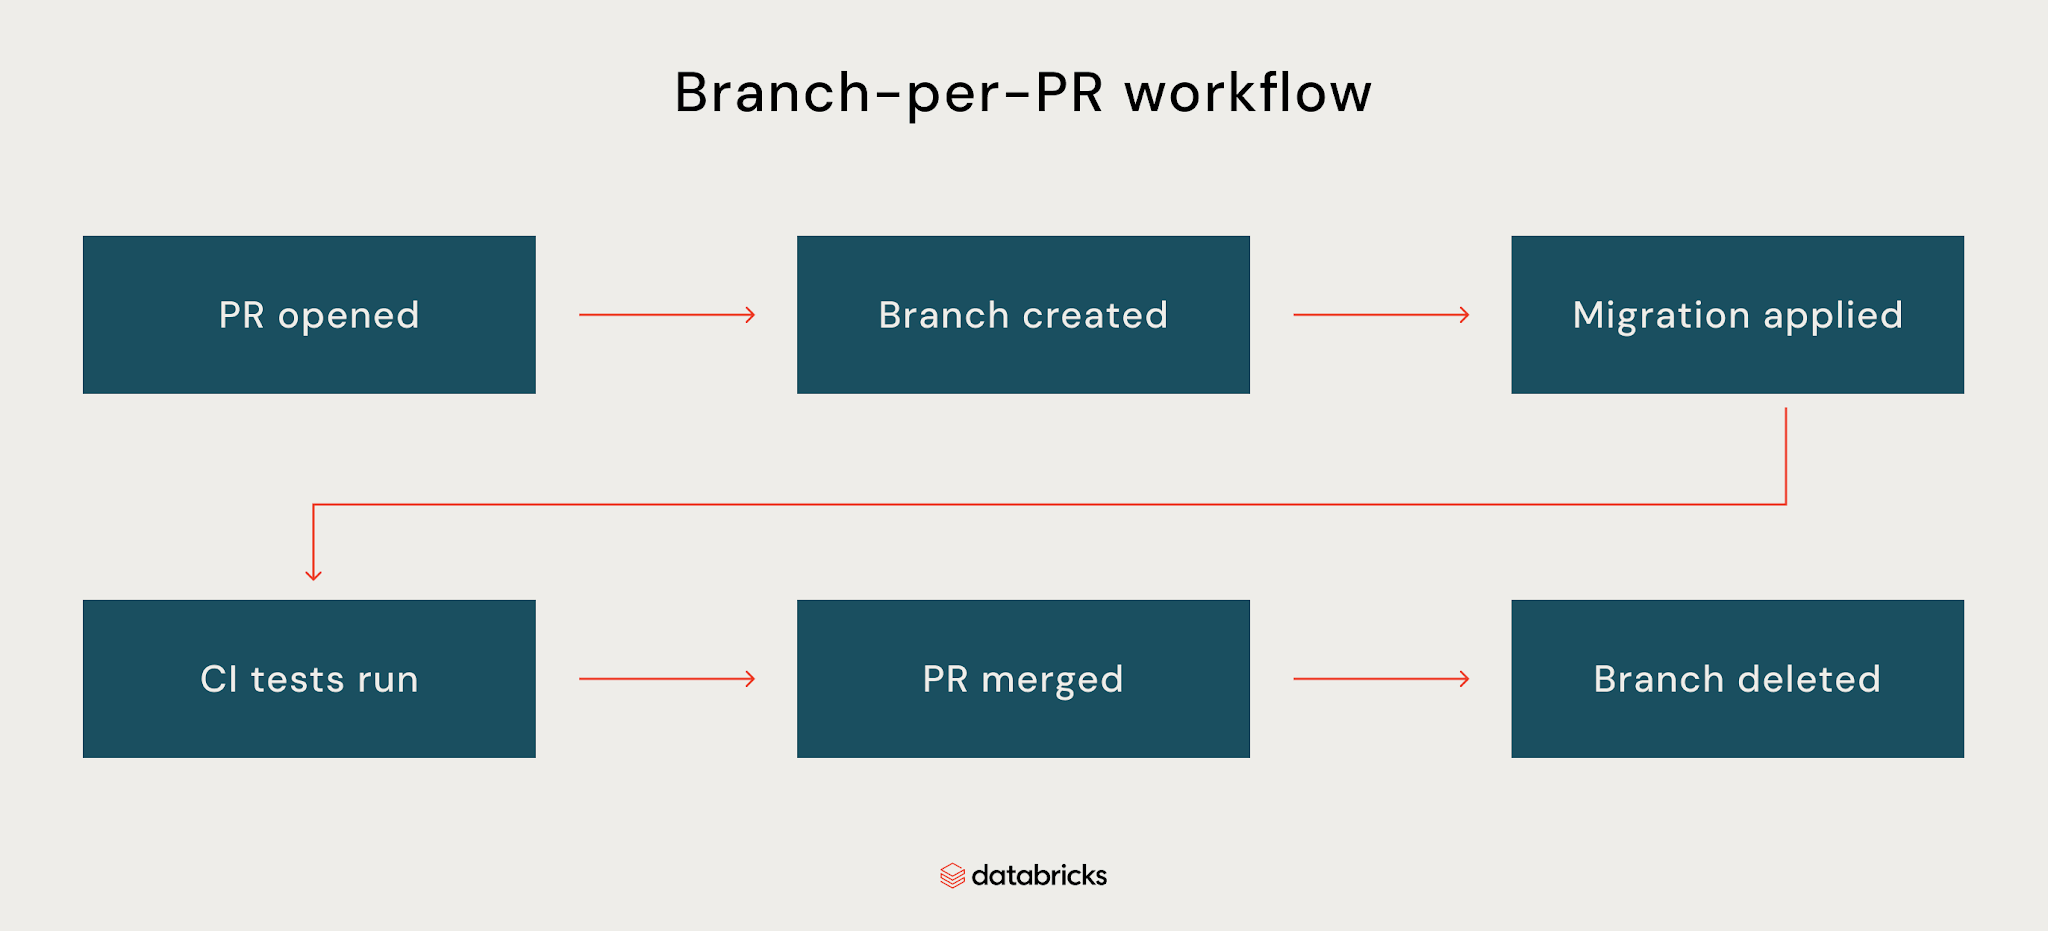
Testar alterações de esquema com dados de produção significa arriscar o ambiente de produção ou manter um banco de dados de staging que fica desatualizado com o tempo. A ramificação de banco de dados cria um ambiente isolado a partir de um estado de banco de dados de origem ou de um snapshot de um ponto no tempo, para que os desenvolvedores possam testar migrações com dados realistas, trabalhar de forma semelhante ao desenvolvimento evolutivo de banco de dados e excluir o branch quando ele não for mais necessário.
Por que usar o Lakebase no Postgres gerenciado
A abordagem do Lakebase fica mais clara quando você a compara com as principais tarefas que o Postgres gerenciado deve realizar:
- Serverless: O Lakebase executa o PostgreSQL em computação serverless que escala automaticamente com a demanda, inclusive reduzindo a zero quando ocioso, eliminando a necessidade de dimensionar uma instância com antecedência ou pagar por capacidade não utilizada. A Databricks relata uma taxa de transferência de gravação no Postgres até 5 vezes maior com o Lakebase em seus testes, embora o resultado dependa da carga de trabalho e da configuração.
- Compatibilidade com PostgreSQL: O Lakebase usa conectividade padrão do PostgreSQL, de modo que os drivers, ORMs e ferramentas existentes, como psql, pgAdmin e DBeaver, se conectam da mesma forma que fariam com qualquer outra instância do Postgres, sem nenhum protocolo proprietário entre a aplicação e o banco de dados.
- Confiabilidade: O Lakebase executa computação secundária em zonas de disponibilidade separadas e a promove automaticamente caso a primária falhe, mantendo o endpoint de conexão inalterado. A equipe de banco de dados não precisa promover uma réplica manualmente ou reconfigurar a aplicação durante o incidente.
- Preços: A computação escala de acordo com a carga de trabalho, em vez de uma instância provisionada permanentemente, e as cobranças param assim que o banco de dados é suspenso. O armazenamento é cobrado separadamente.
- Integração com o Lakehouse: O Lakebase se conecta ao restante da plataforma Databricks em vez de operar como um serviço Postgres isolado. Tabelas sincronizadas disponibilizam os dados do Unity Catalog para aplicações Postgres sem a necessidade de um pipeline de sincronização personalizado, e o Change Data Feed, atualmente em Public Preview, expõe as alterações do banco de dados para processamento downstream no lakehouse.
O que sai da responsabilidade da equipe
A tabela abaixo mostra quais operações de banco de dados o Lakebase gerencia e quais ainda ficam sob a responsabilidade da equipe de banco de dados:
| Dimensão | O que o Lakebase gerencia |
|---|---|
| Aplicação de patches | Atualizações automáticas do PostgreSQL, de segurança, do OS e de computação |
| Escalonamento | Escalonamento automático, incluindo redução a zero (scale-to-zero) quando ocioso |
| Failover | Failover automático para computação secundária dentro de uma região |
| Backups e recuperação | Restauração de ponto no tempo (point-in-time restore) com histórico configurável de 2 a 30 dias, além de snapshots agendados para proteção adicional de backup |
| Recuperação de desastres | Private Preview, apenas na AWS. Replicação periódica com failover manual e procedimentos de recuperação gerenciados pelo cliente. |
| Criptografia | Em repouso e em trânsito, com chaves gerenciadas pelo cliente disponíveis |
| Controle de acesso | Funções e permissões do PostgreSQL, com integrações do Unity Catalog para uma governança mais ampla. |
| Extensões | pgvector, PostGIS e outras extensões do PostgreSQL suportadas |
| Pool de conexões | PgBouncer integrado |
| Ramificação | Copy-on-write, sem armazenamento duplicado |
| Integração com o Lakehouse | Tabelas sincronizadas e Change Data Feed |
| Preços | Serverless, escala com a carga de trabalho, suspenso quando ocioso. Armazenamento cobrado separadamente. |
A aplicação de patches, o escalonamento, o failover e os backups são executados automaticamente, conforme a tabela acima. A recuperação de desastres é a exceção: ainda em Private Preview, apenas na AWS, com failover manual e procedimentos de recuperação gerenciados pelo cliente. Esse é o detalhe que vale a pena verificar antes de contar com o Lakebase para qualquer recurso que abranja várias regiões. Saiba mais sobre o Databricks Lakebase.
Conclusão
"Gerenciado" significa algo diferente dependendo de quem está vendendo, desde apenas aplicar patches no OS e considerar o trabalho feito até assumir toda a responsabilidade de executar um banco de dados de produção: escalonamento, failover, backups, segurança, migração, cargas de trabalho de AI e toda a experiência do desenvolvedor em torno disso.
O Lakebase atende a esses critérios na maior parte deles. A aplicação de patches, o escalonamento e o failover são executados sem a intervenção da sua equipe; a recuperação de ponto no tempo (point-in-time recovery) é integrada, e a segurança, as extensões, o pool de conexões e a ramificação já vêm com o serviço. A recuperação de desastres entre regiões é a única exceção, ainda em Private Preview com failover manual, não oferecendo a mesma proteção automática que o Lakebase fornece dentro de uma região.
Para as equipes que estão avaliando o Postgres gerenciado, a questão crucial é quanto do trabalho operacional realmente sai de suas responsabilidades. O Lakebase lida com a maior parte desse trabalho dentro de uma região, enquanto a recuperação de desastres entre regiões continua sendo uma área onde as equipes ainda têm responsabilidades.
Perguntas frequentes
Qual é a diferença entre o Postgres gerenciado e o auto-hospedado (self-hosted)?
O Postgres auto-hospedado coloca todas as tarefas operacionais sob a responsabilidade da equipe de banco de dados: aplicação de patches, escalonamento, failover, política de backup e recuperação de desastres. O Postgres gerenciado transfere parte ou a totalidade disso para o provedor, mas o nível dessa transferência varia bastante. Serviços parcialmente gerenciados cuidam da infraestrutura e deixam o restante para o cliente. Alguns serviços totalmente gerenciados também incluem ferramentas de segurança, assistência de migração e fluxos de trabalho de desenvolvedores, como a ramificação de banco de dados.
O que é Postgres serverless?
O Postgres serverless é um modelo de banco de dados gerenciado no qual os recursos de computação escalam automaticamente conforme a demanda, eliminando a necessidade de provisionar um tamanho de instância fixo. Alguns provedores reduzem a computação a zero quando o banco de dados está ocioso, enquanto outros mantêm uma capacidade mínima. A cobrança geralmente se baseia na computação utilizada, em vez de uma instância provisionada permanentemente.
Como funciona a ramificação de banco de dados no Postgres?
A ramificação de banco de dados cria uma ramificação (branch) isolada e do tipo copy-on-write de um banco de dados, sem duplicar o armazenamento subjacente. Cada ramificação pode ter seus próprios recursos de computação e alterações de dados, sem afetar a produção. As equipes utilizam esse recurso para testar migrações de esquema com dados reais, criar uma ramificação por pull request ou restaurar uma ramificação a partir de um ponto específico no tempo e, em seguida, excluí-la assim que o trabalho for concluído.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.