MemCurrent: Projetando memória persistente para agentes em produção
As ferramentas de IA facilitaram a criação de agentes no estilo "vibe coding". No entanto, construir e manter um agente corporativo em produção continua sendo um desafio significativamente maior. Em especial, os desenvolvedores geralmente precisam equilibrar qualidade (obter boas respostas, principalmente em tarefas de cauda longa) e eficiência (manter custos e latência sob controle em escala). Muitas vezes, as técnicas trazem ganhos em uma dimensão ao custo de outra.
A memória é uma forma promissora de melhorar ambos ao mesmo tempo. Ela pode ajudar os agentes a carregar contexto útil entre as tarefas, como preferências do usuário, correções anteriores, definições de métricas e fluxos de trabalho bem-sucedidos. Em tese, isso pode aumentar a precisão, reduzir erros repetidos e evitar a redescoberta desnecessária. Mas ter mais histórico não significa necessariamente ter uma memória melhor. Fornecer todas as interações passadas é dispendioso e pode introduzir contexto desatualizado, conflitante ou irrelevante. O principal desafio é decidir o que reter, como manter essas informações e como medir sua utilidade.
Neste post, apresentamos o MemCurrent, uma arquitetura de memória persistente para agentes em produção, que agora alimenta o novo Agent Bricks Memory e o Genie. Os agentes leem e escrevem na memória enquanto trabalham, e um pipeline off-line de "dreaming" consolida a memória para mantê-la consistente e atualizada. Em nosso benchmark interno, construído a partir de tarefas corporativas reais, o MemCurrent triplica a taxa de sucesso do agente em comparação com a ausência de memória, além de utilizar 31% menos tokens e executar 26% mais rápido. O restante deste post aborda como o projetamos e avaliamos, e o que aprendemos ao longo do caminho.
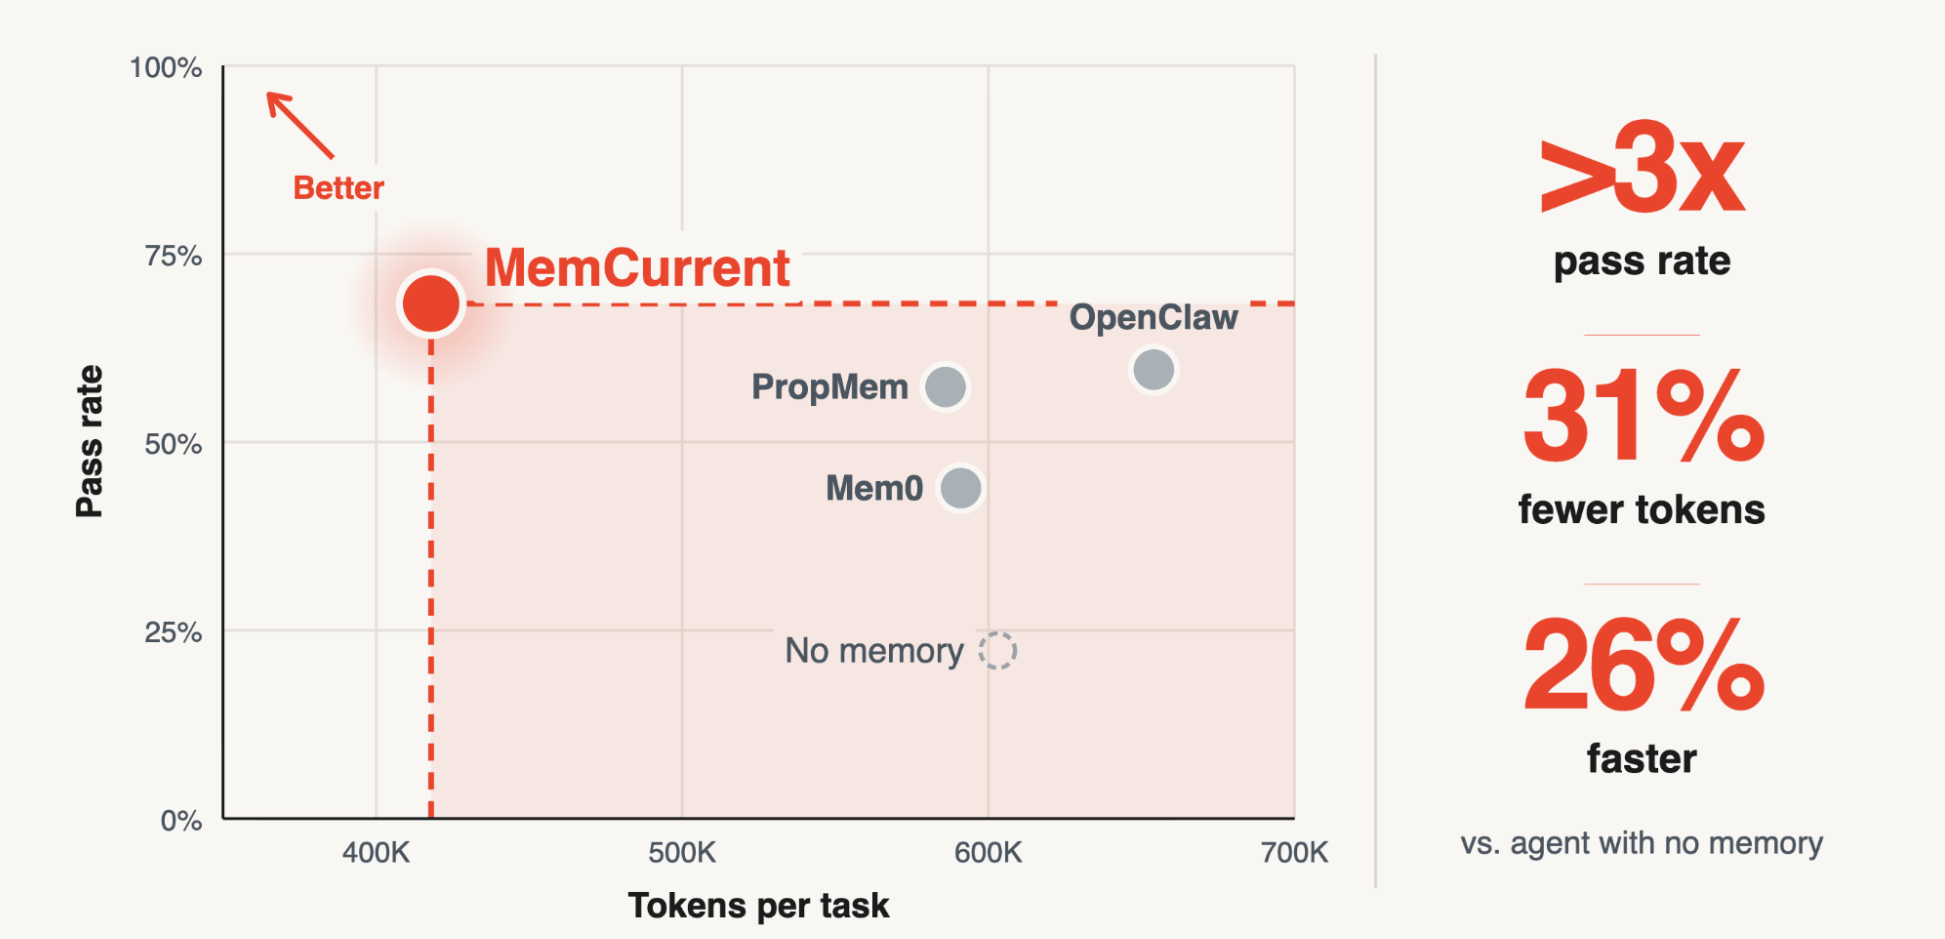
Figura 1. Taxa de sucesso vs. tokens por tarefa em nosso Benchmark de Memória Interno. O MemCurrent está na fronteira de Pareto, superando a memória do Mem0, PropMem e OpenClaw em ambas as dimensões.
Como projetamos a memória
Existem três maneiras de integrar memória a um agente. Como um plugin (como em nosso trabalho anterior no MemAlign e Memory Scaling), a memória é lida e gravada automaticamente em pontos fixos de uma sessão. Como ferramentas, o agente decide o que e quando ler e gravar. Como um pipeline off-line, a memória é atualizada em segundo plano com base em um agendamento ou gatilho, e usada em sessões posteriores. Cada abordagem possui seus prós e contras:
Memória como... | Disparado por | Momento da computação | Prós | Contras |
Plugin | Automático | On-line |
|
|
Ferramenta | Agente | On-line |
|
|
| Pipeline | Agendamento ou gatilho | Off-line |
|
|
Tabela 1. Três padrões de acesso à memória: plugin, ferramenta ou pipeline off-line.
O MemCurrent utiliza as três abordagens, cada uma onde melhor se adapta.
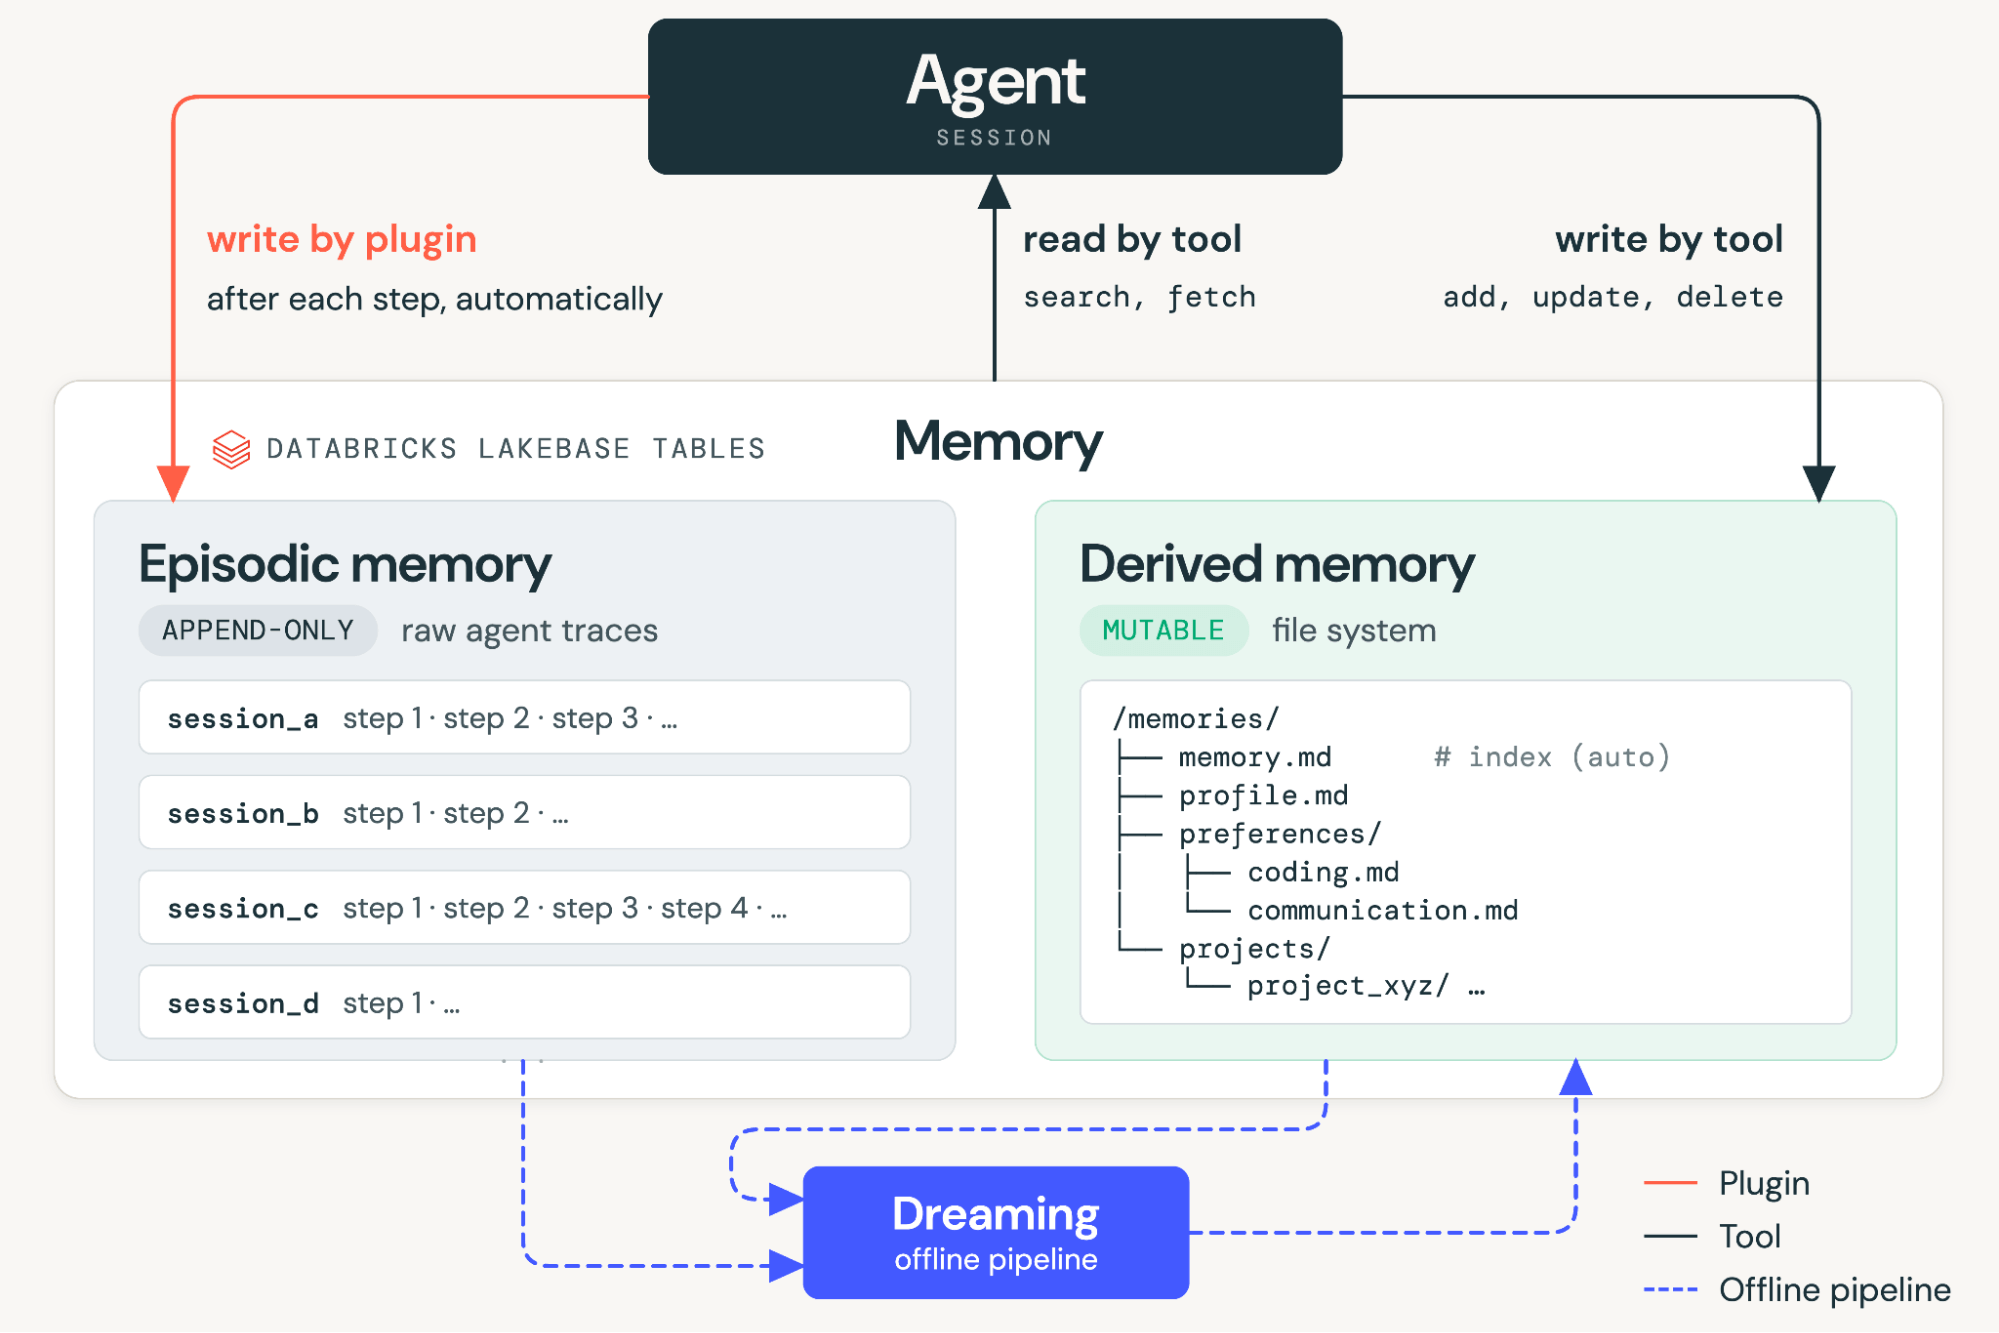
Figura 2. Visão geral do MemCurrent.
O MemCurrent possui dois tipos de memória: memória episódica, que armazena rastros brutos da sessão; e memória derivada, que contém os aprendizados destilados desses rastros, armazenados como arquivos em uma base de conhecimento estruturada. Um índice gerado automaticamente memory.md fica no topo, descrevendo a estrutura de arquivos e o conteúdo de cada um.
Tanto a memória episódica quanto a derivada residem em um banco de dados de nível de produção que pode ser dimensionado para muitos usuários, mantendo respostas de baixa latência. A memória episódica é do tipo "append-only" (apenas adição), na qual um plugin registra cada etapa durante a execução da sessão. A memória derivada é uma tabela mutável que simula um sistema de arquivos hierárquico, na qual a gravação ocorre de duas formas. As ferramentas do agente (add_memory, update_memory, delete_memory) lidam com solicitações explícitas, como “Nunca grave scripts no diretório /tmp”. Um pipeline off-line de "dreaming" captura o restante, destilando aprendizados implícitos de cada nova sessão nos arquivos relevantes. Ele também limpa todo o repositório, dividindo arquivos muito grandes, mesclando duplicatas e resolvendo conflitos.
A leitura funciona em camadas. No início da sessão, um plugin injeta o índice de memória, para que o agente saiba o que conhece antes de começar. Durante a sessão, o agente dispõe de duas ferramentas que funcionam em ambos os tipos de memória: search_memory retorna as principais correspondências para uma consulta (uma etapa em um rastro passado ou uma linha em um arquivo de memória) e fetch_memory retorna a entrada completa por identificador (ID da sessão ou caminho do arquivo).
Como avaliamos a memória
Benchmarks
Começamos com três benchmarks de código aberto populares: LoCoMo, LongMemEval e ConvoMem. Todos os três testam se um agente consegue lembrar fatos mencionados anteriormente em conversas sintéticas abertas.
Além disso, construímos um Benchmark de Memória Interno a partir de conversas reais do Genie, onde os usuários fazem todo tipo de pergunta sobre seus dados. Como mostrado na Figura 3, começamos com mais de 12 mil sessões, minamos 3 mil candidatas contendo sinais relevantes para a memória e elaboramos uma pergunta de acompanhamento com rubricas de pontuação. As outras sessões do mesmo usuário servem como preenchimento (fillers) para o caso de teste. Um juiz adversarial verificou cada caso de teste em relação a 7 critérios, como se o conhecimento está realmente presente, se é específico do usuário, necessário para responder, natural e verificável. Após uma revisão manual final, o benchmark conta com um total de 114 casos de teste, com 29 usuários e 2.233 sessões de histórico.
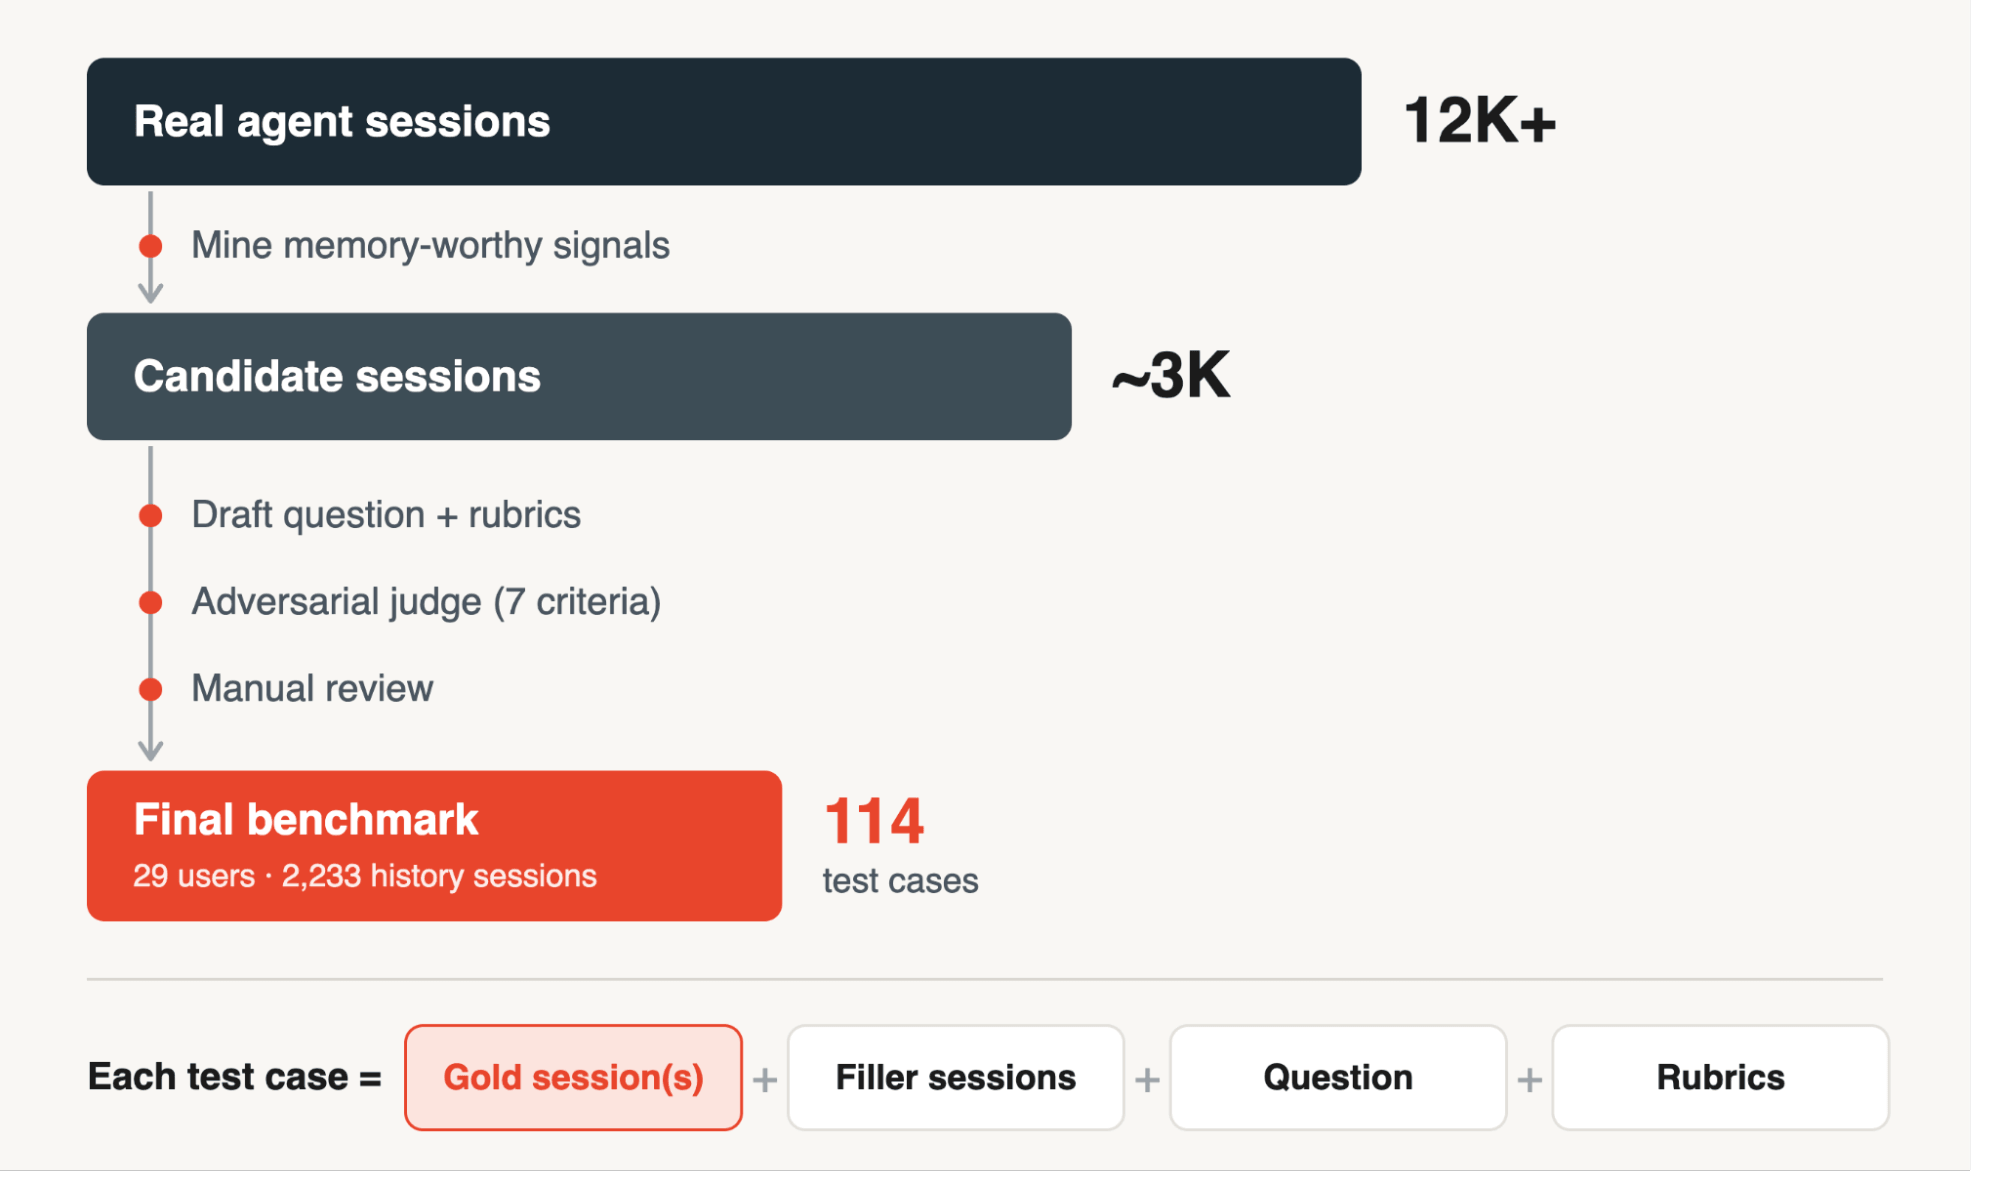
Figura 3. Como construímos nosso Benchmark de Memória Interno.
Aqui está um exemplo:
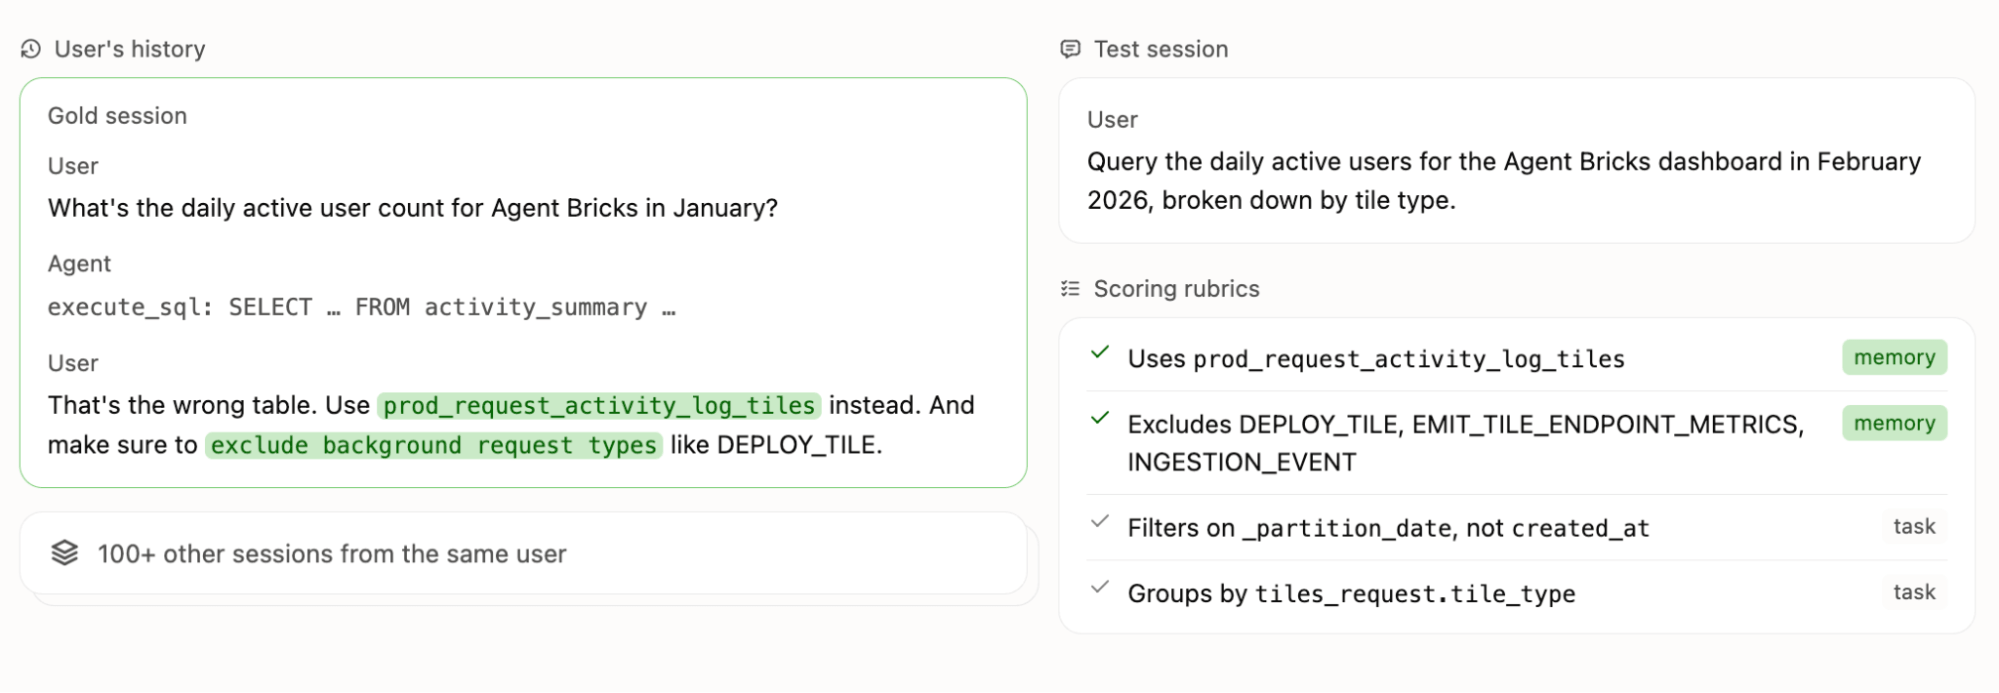
Figura 4. Um exemplo de caso de teste do nosso Benchmark de Memória Interno. Em uma sessão anterior, o usuário corrige a escolha de tabela do agente e instrui a excluir solicitações em segundo plano. Mais tarde, o agente se depara com uma pergunta diferente, mas relacionada, e precisa encontrar essa sessão entre mais de 100 outras para aplicar o que aprendeu. O resultado é avaliado por um juiz LLM com base em uma lista de rubricas (algumas dependentes da memória, outras intrínsecas à tarefa).
Nosso benchmark difere dos existentes de três maneiras:
Domínio corporativo. Os benchmarks existentes são chats em aberto sobre as vidas de personas simuladas. O nosso vem do trabalho real em um workspace de dados, envolvendo um amplo conhecimento corporativo, como semântica de tabelas, definições de métricas e fluxos de trabalho.
A memória alimenta ações, não respostas. Encontrar a string certa em conversas passadas não é suficiente; os agentes devem aplicar o conhecimento recuperado para concluir tarefas em várias etapas.
Diversidade. Os casos de teste abrangem 5 tipos de memória (perfil, preferências, conhecimento do domínio, projetos, fluxos de trabalho) cruzados com 11 cenários (instrução direta, fatos alterados ou desatualizados, agregação multissessão, perguntas independentes de memória e mais).
Resultados
Comparamos o MemCurrent com três backends de memória de código aberto, Mem0, PropMem, OpenClaw memory, usando o mesmo LLM subjacente.
Benchmarks de código aberto. Emparelhamos cada backend de memória com um agente simples de perguntas e respostas, construído com duas estruturas de agente (LangGraph e OpenAI Agents SDK). Também executamos dois baselines: um limite inferior sem nenhuma memória e um limite superior com contexto completo, onde todas as sessões anteriores vão para o contexto do agente. Em todos os três benchmarks, o MemCurrent obtém a pontuação mais alta entre todos os backends de memória e permanece na fronteira de Pareto de custo-precisão. Em média, o MemCurrent (88,1%) tem um desempenho no mesmo nível do contexto completo (87,8%) com cerca de 12 vezes menos tokens de entrada por pergunta (8,4K vs. 103K). Nos dois benchmarks com os históricos mais longos, ele até supera o contexto completo, no qual jogar tudo dentro do prompt acaba confundindo o agente.
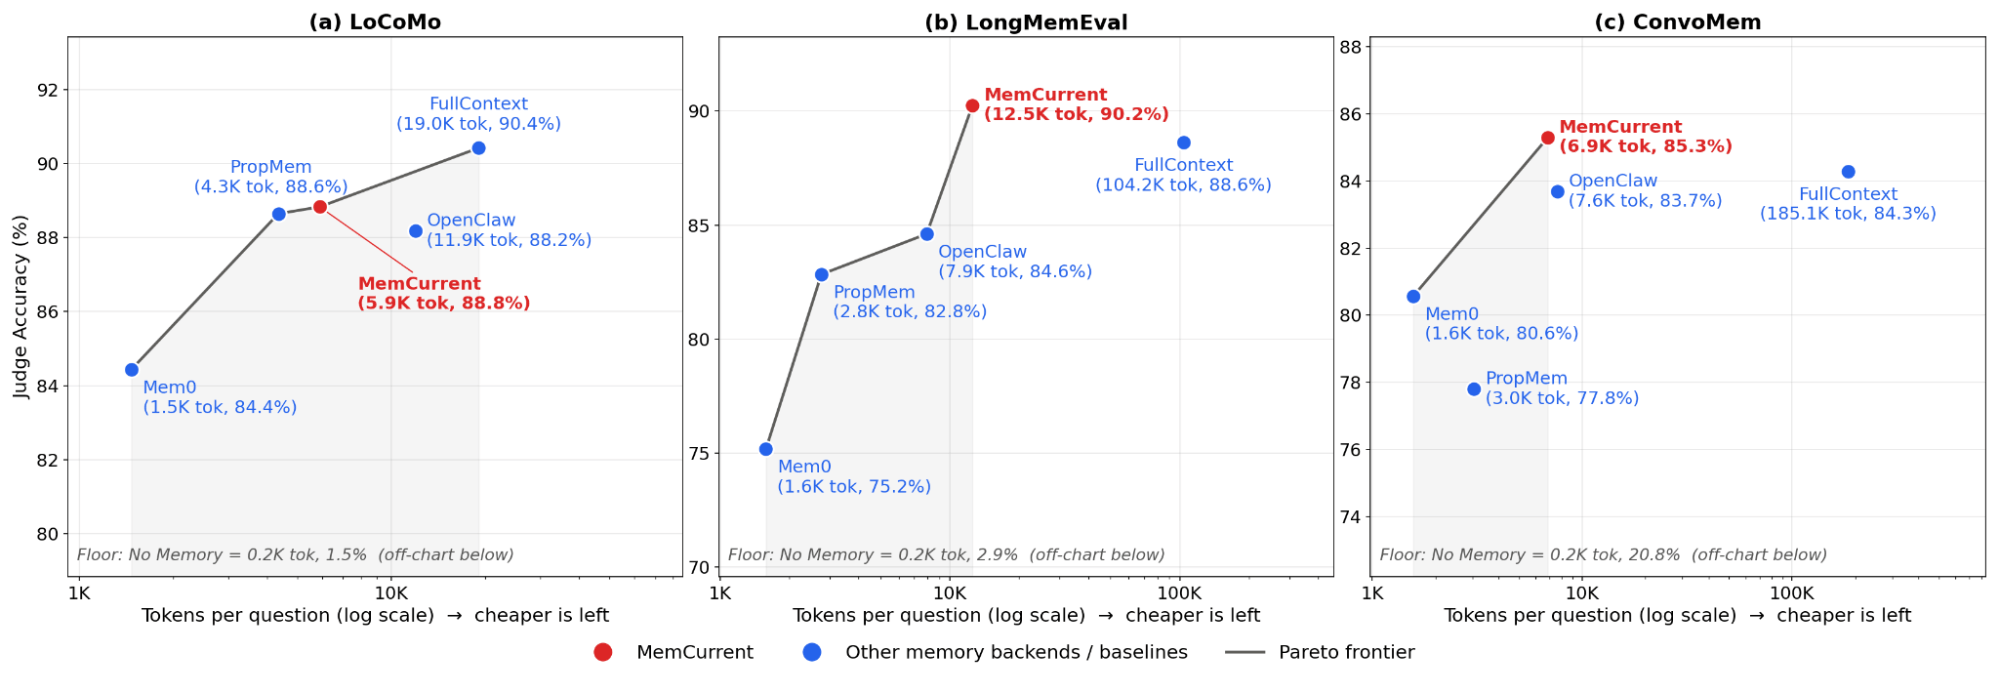
Figura 5. Trade-off entre custo e precisão1 de backends de memória em (a) LoCoMo (19–32 sessões/amostra), (b) LongMemEval (divisão s) (38–62 sessões/amostra) e (c) ConvoMem (subconjunto estratificado de 500 amostras, 100 sessões/amostra). Usamos o GPT 5.6 luna como o modelo de agente e memória. Todos os backends de memória são executados como um plugin, que busca automaticamente memórias relacionadas à pergunta e as injeta no contexto do agente no início da sessão.2 A precisão é a média entre as estruturas LangGraph e OpenAI Agents SDK e 3 repetições. O custo é a média de tokens de entrada por pergunta (escala logarítmica).
Benchmark de memória interna. No nosso benchmark, a diferença aumenta. Aqui, cada backend de memória é executado dentro do nosso Genie interno, o mesmo agente de onde vieram as sessões de benchmark. Os históricos são longos demais para caber no contexto, portanto nosso limite superior é a injeção gold: injetar apenas as memórias gold no contexto do agente. Entre todos os backends de memória, o MemCurrent tem a maior taxa de aprovação (68,4%) e a menor latência (252s) e uso de tokens (418K), reduzindo em mais de 80% a diferença entre nenhuma memória (22,3%) e a injeção gold (78,6%). Notavelmente, embora o Mem0 também estivesse na fronteira em benchmarks anteriores, ele fica para trás com 43,9% aqui, com maior latência e custo. Em comparação com nenhuma memória, o MemCurrent triplica a taxa de aprovação do agente (22,3% → 68,4%) ao mesmo tempo em que o torna 1,35x mais rápido e 1,44x mais barato.
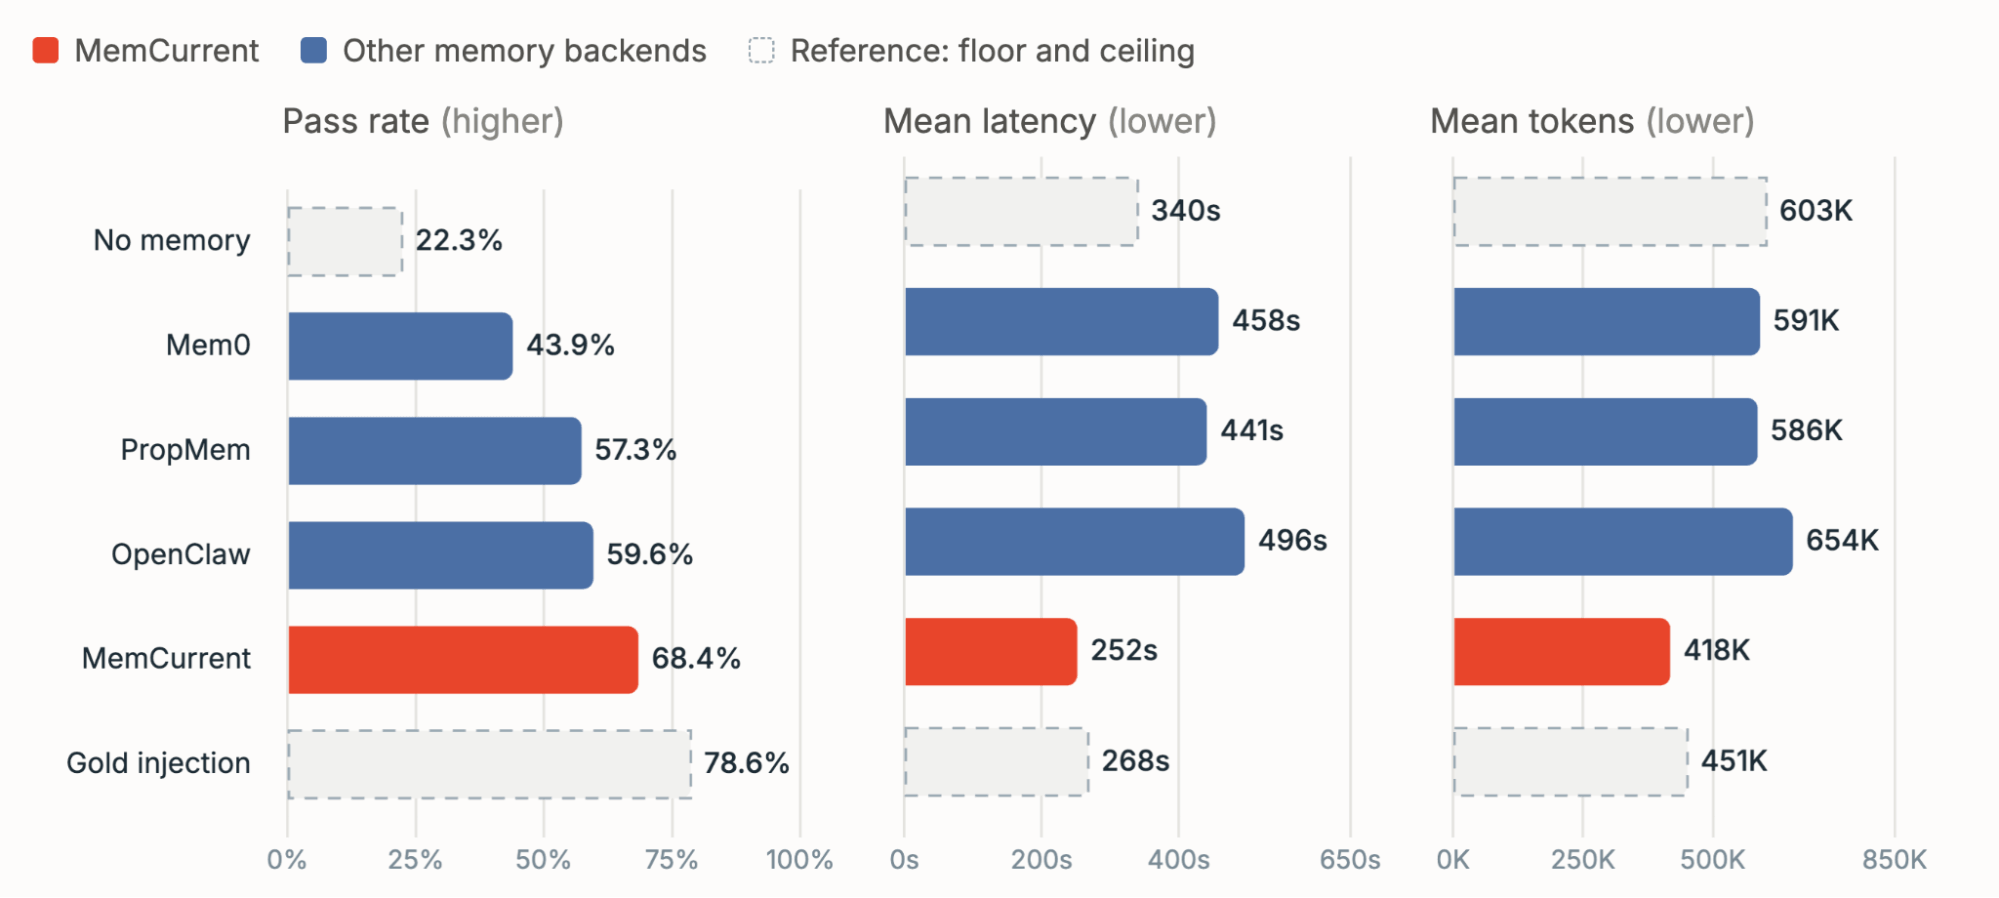
Figura 6. Taxa de aprovação, latência média e uso médio de tokens por tarefa no nosso Benchmark de Memória Interna ao longo de 3 repetições. Usamos o Claude Opus 4.6 como o modelo de agente e o GPT 5.6 sol como o modelo de memória. Todos os backends de memória são fornecidos como ferramentas de agente e um plugin de início de sessão.
MemCurrent em Ação
Além dos números de benchmark, vamos examinar dois exemplos de como o MemCurrent ajuda na prática, a partir de sessões internas do Genie.
Exemplo 1: a memória evita um erro ocasional de alucinação. Na Figura 7, um usuário solicitou ao agente os 20 principais usuários do Produto X nos últimos dois meses. O agente escreveu uma consulta SQL correta, mas nunca leu os resultados reais da execução salvos em um arquivo. Mesmo assim, produziu com confiança uma tabela com conteúdo alucinado. Após o feedback do usuário, o agente salvou a lição na memória. Da próxima vez, assim que a consulta foi executada, o agente leu os resultados primeiro e retornou a tabela correta. Uma única correção de memória impediu que um deslize pontual se tornasse um hábito.
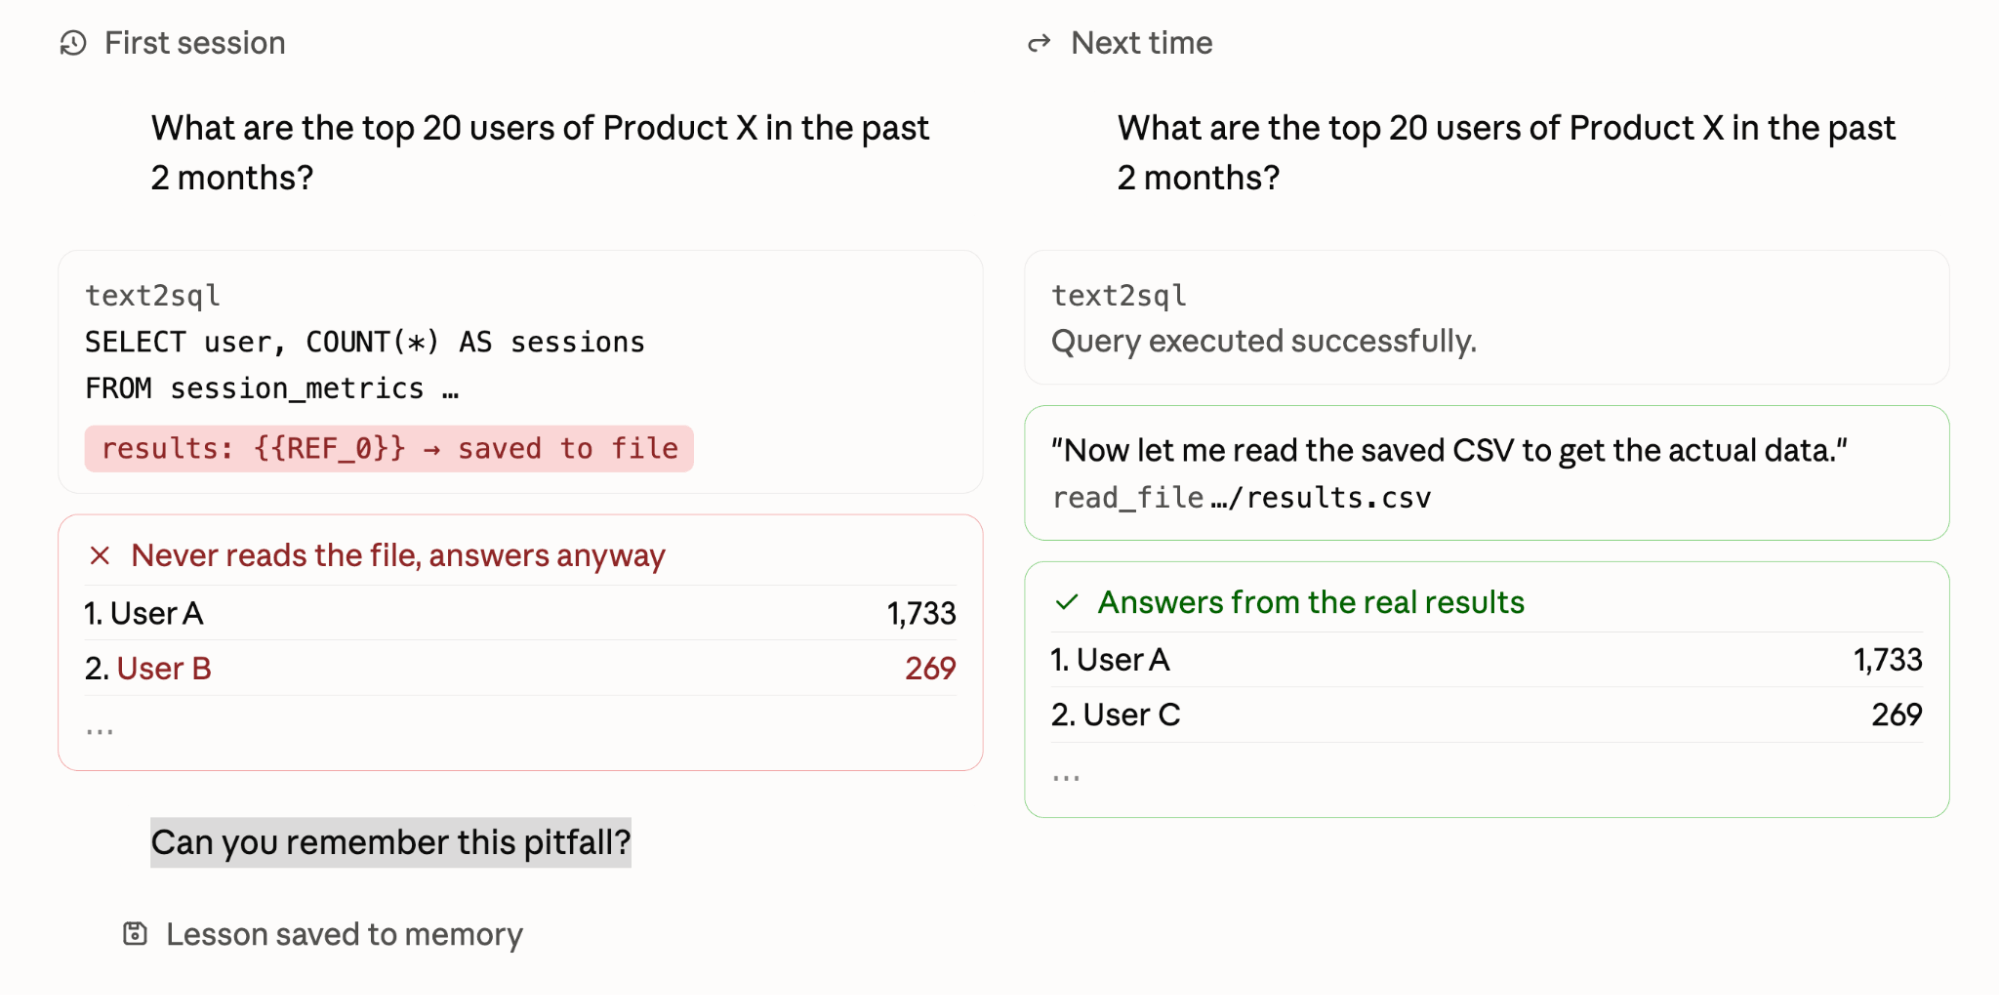
Figura 7. Um exemplo anonimizado de como a memória ajuda o agente a evitar um erro repetido de alucinação.
Exemplo 2: a memória economiza computação em tarefas relacionadas. Na Figura 8, um usuário pediu “os 5 principais clientes de SDP”. O agente teve que descobrir tudo do zero: o que significa “SDP”, quais tabelas continham dados de uso e como fazer o join e filtrá-las. Foram necessárias 11 chamadas de ferramentas, 8 subagentes e quase seis minutos. O agente salvou essas etapas como um arquivo de fluxo de trabalho na memória, que ele pôde reutilizar em tarefas relacionadas. Mais tarde, o usuário fez uma pergunta diferente: quantos clientes de SDP tiveram mais de 5 mil execuções de pipeline no mês passado. Usando o fluxo de trabalho, o agente respondeu com 2 chamadas de ferramentas e 1 subagente em 41 segundos. A pergunta era nova, mas o caminho para a resposta não era, e a memória permitiu que o agente pulasse explorações desnecessárias.
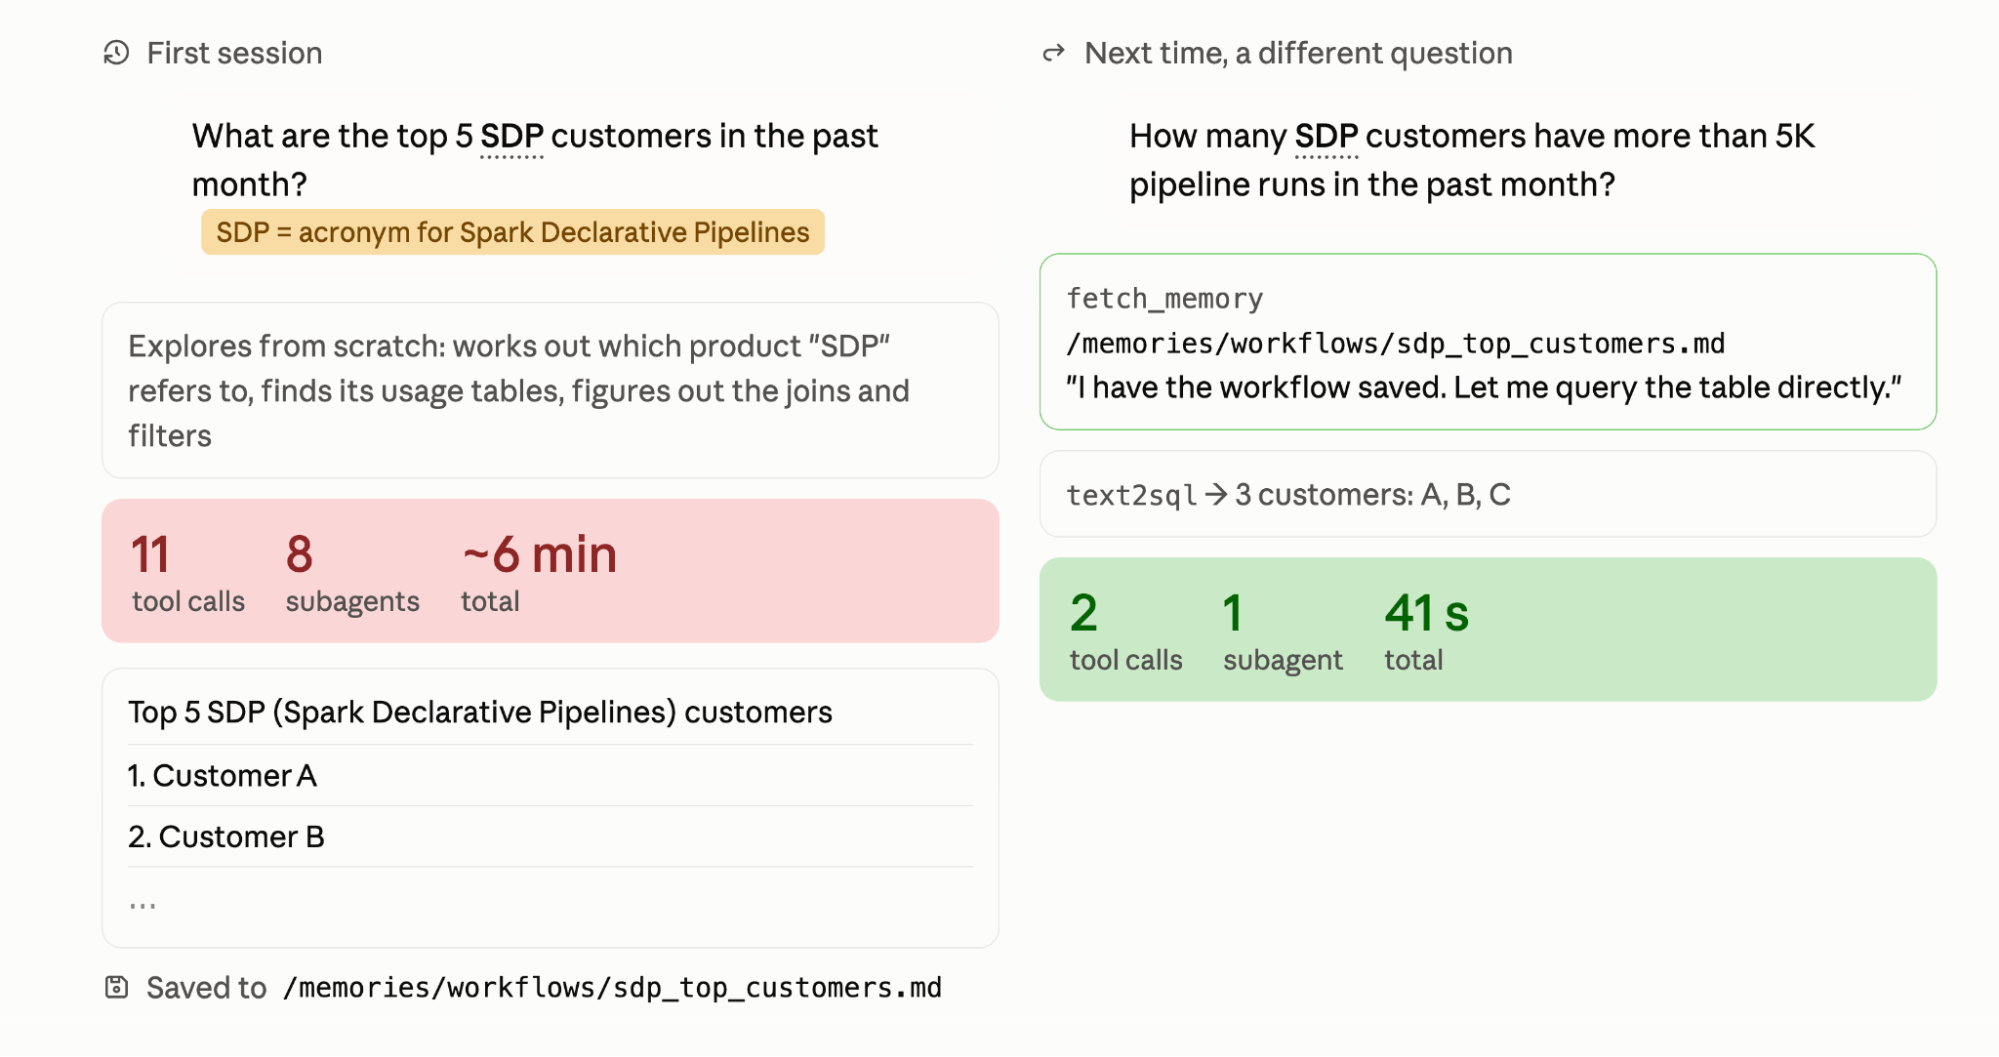
Figura 8. Um exemplo anonimizado de como a memória transforma uma tarefa de 6 minutos em 41 segundos.
O que faz o MemCurrent funcionar
Para entender o que explica o desempenho superior do MemCurrent, executamos ablações no nosso Benchmark de Memória Interna para duas escolhas de design: tipos de memória e estratégia de extração.
Precisamos de ambos os tipos de memória? A memória episódica por si só ajuda de forma moderada: 35,8%, acima dos 22,3% sem memória. O histórico bruto é útil, mas o agente só o pesquisa em cerca de um terço dos casos de teste, embora passe em 60% desses casos quando o faz. A memória derivada evita esse problema, pois o índice de memória injetado no início da sessão fornece ao agente informações sobre o que está disponível na memória e quando buscar, elevando a taxa de aprovação para 66,1%. Adicionar a memória episódica por cima oferece o melhor resultado, em 68,4%. O ganho é pequeno, mas sugere que os traços brutos podem recuperar detalhes que a destilação descarta.
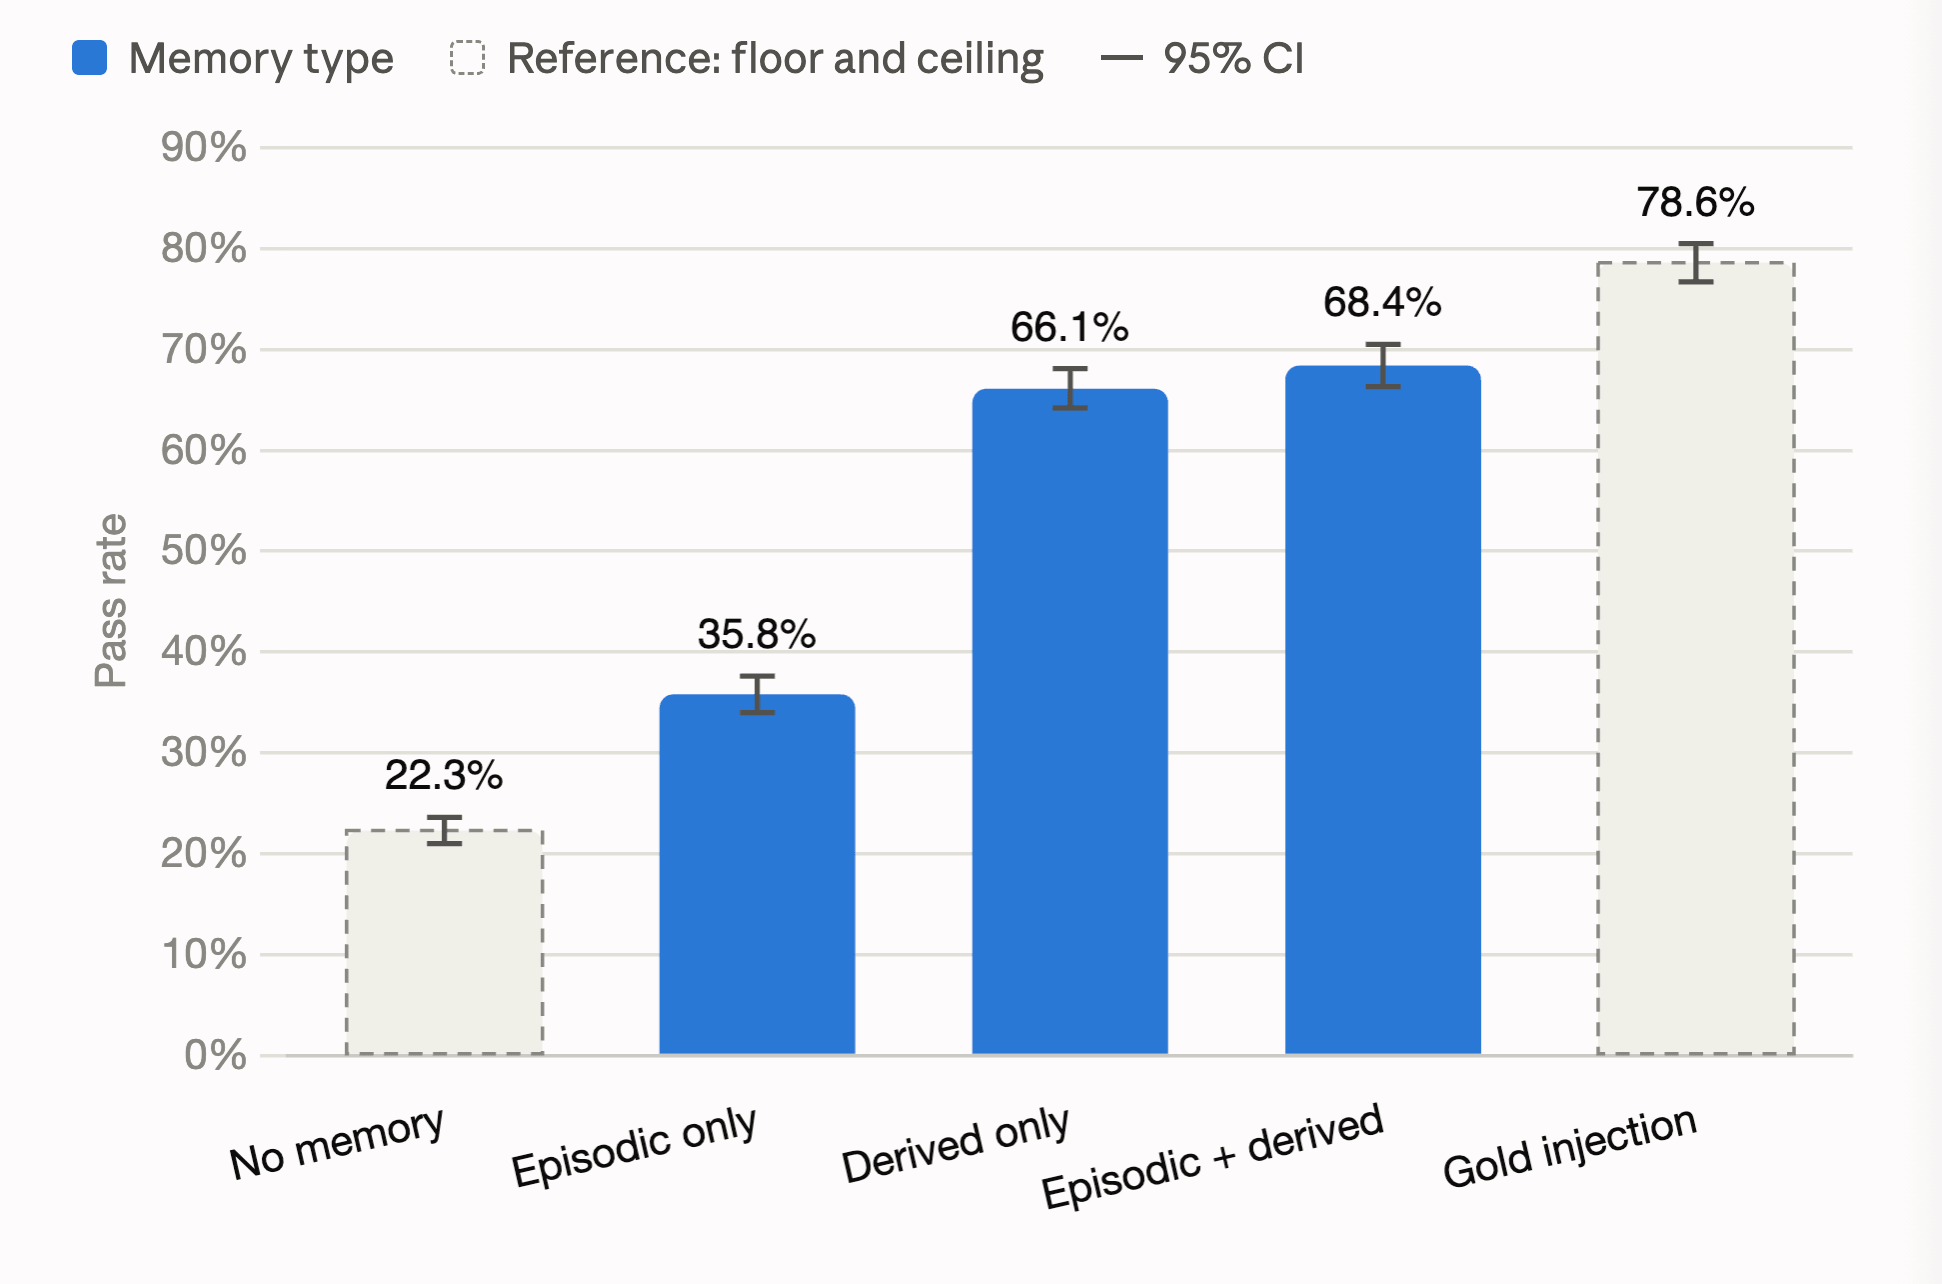
Figura 9. Taxa de aprovação por tipo de memória.
Qual é uma boa estratégia de extração de memória? Como mostrado na Figura 2, dois canais extraem a memória derivada: ferramentas online e dreaming offline. Quando isolado, o dreaming offline (63,5%) supera as ferramentas online (53,9%) em quase 10 pontos. A combinação deles produz a maior taxa de aprovação, de 66,1%. Isso dá suporte à divisão de tarefas: o dreaming cuida da extração e consolidação em segundo plano, enquanto as ferramentas online fazem com que solicitações explícitas tenham efeito imediato.
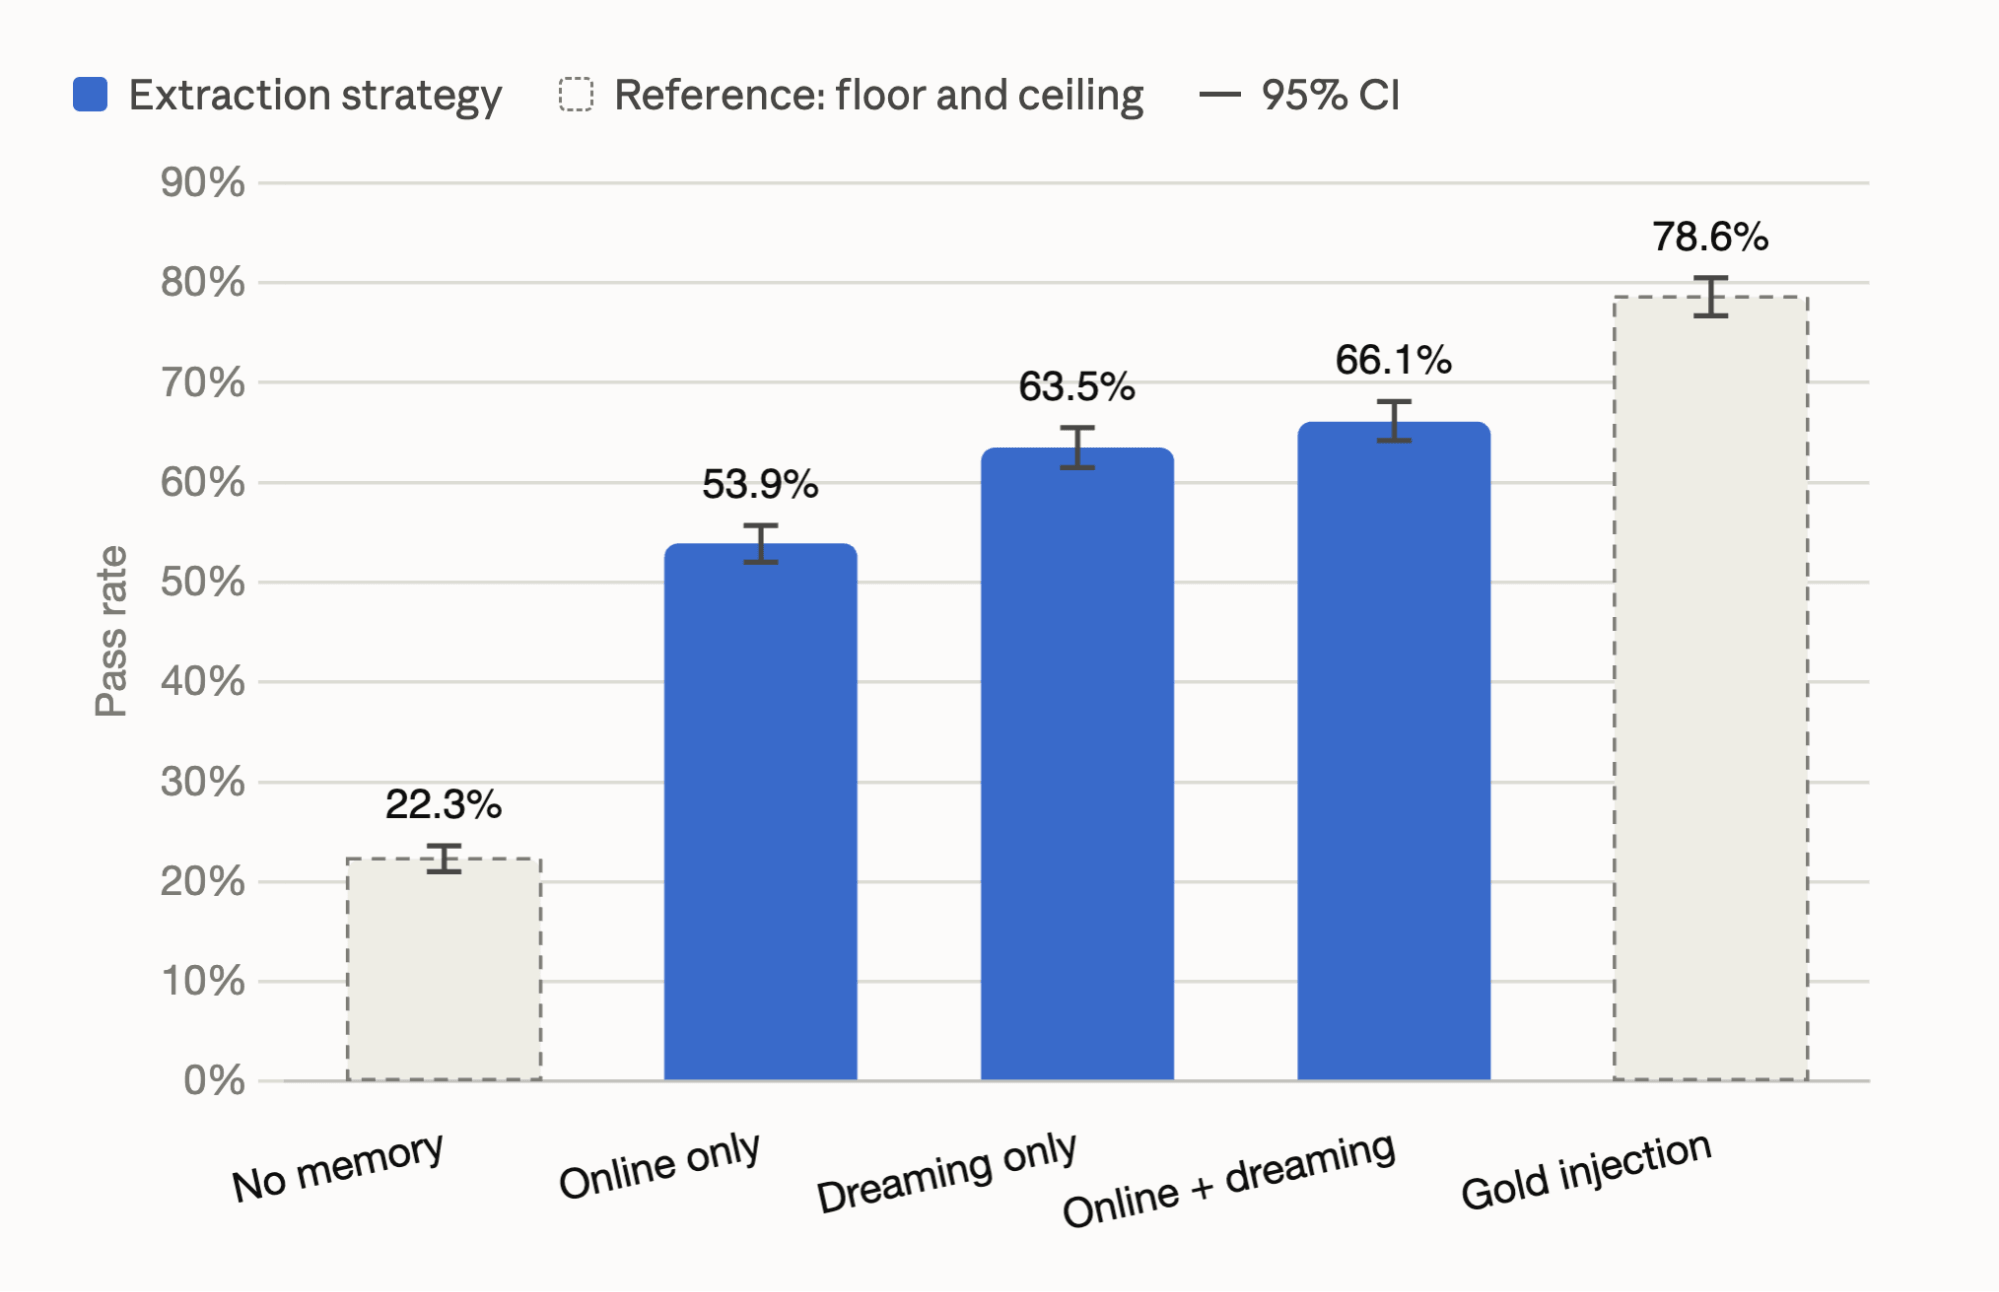
Figura 10. Taxa de aprovação por estratégia de extração.
Conclusão
A memória é a forma como um agente deixa de começar do zero. Neste post, apresentamos o MemCurrent, uma arquitetura de memória para agentes em produção que combina memória episódica e memória derivada, com três padrões de acesso: plugins para registrar e carregar contexto automaticamente, ferramentas que o agente chama sob demanda e um pipeline de dreaming offline que consolida a memória em segundo plano.
Em todos os benchmarks que executamos, o MemCurrent melhora a qualidade e a eficiência ao mesmo tempo, superando o trade-off que nos propusemos a quebrar. Em benchmarks de código aberto, ele iguala o desempenho de contexto completo com cerca de 12 vezes menos tokens de entrada. No nosso Benchmark de Memória Interna, construído a partir do trabalho real com dados, ele triplica a taxa de aprovação do agente em relação à ausência de memória, além de torná-lo mais rápido e mais barato.
As ablações apontam de onde vem o valor. A memória derivada faz a maior parte do trabalho, e a memória episódica adiciona um ganho menor ao recuperar detalhes que a destilação descarta. Combinar ferramentas online com dreaming offline cria a melhor estratégia de extração: solicitações explícitas entram em vigor imediatamente, enquanto o dreaming destila aprendizados implícitos e consolida o armazenamento em segundo plano.
Além dos números, a memória fornece uma base de conhecimento que não está vinculada a um único agente ou LLM. Ela pode se mover com os usuários para novos agentes ou LLMs e pode semear o conhecimento compartilhado em toda a organização, uma direção que exploraremos a seguir.
Primeiros passos
Estamos trazendo essas descobertas para impulsionar melhorias nos produtos da Databricks:
Para desenvolvedores de agentes. O Agent Bricks é a plataforma de desenvolvimento da Databricks para criar agentes personalizados. O MemCurrent é integrado à oferta de memória do Agent Bricks, alimentado pelo Lakebase. A oferta inclui:
- Armazenamento de sessão para memória episódica
- Armazenamento de memória para memória derivada
- Um pipeline automático de dreaming
- Rastreamento e avaliação da qualidade do agente, incluindo o impacto da memória
- Uma CLI que ajuda você a começar rapidamente com um agente de exemplo ponta a ponta com tudo isso em <10 minutos
Comece a criar seu agente personalizado hoje mesmo.
Para usuários do Databricks Genie. O Genie é uma interface na qual os usuários do Databricks podem conversar com seus dados em linguagem natural. O MemCurrent já está em ação nos bastidores, ajudando a melhorar a qualidade das respostas e reduzindo a latência e o custo.
Comece a usar o Genie.
Autores: Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen
Agradecemos a Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu e aos participantes do nosso estudo interno de usuários pelo feedback e suporte durante todo este projeto.
1 A latência é semelhante (4-7s/pergunta) em todos os back-ends de memória, pois a maioria das perguntas pode ser respondida em um único salto.
2 Consideramos a memória baseada em plug-ins suficiente para os benchmarks existentes. Os resultados da adição de ferramentas são estritamente dominados e, portanto, omitidos.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.