Usando o Structured Streaming com o Delta Sharing no Unity Catalog
por Will Girten, Josh Seidel, Lin Zhou e Sachin Thakur
Temos o prazer de anunciar que o suporte para uso do Structured Streaming com o Delta Sharing já está disponível para o público em geral (GA) no Azure, AWS e GCP! Esse novo recurso permitirá que os destinatários de dados na Databricks Lakehouse Platform façam streaming de alterações de uma tabela Delta compartilhada por meio do Unity Catalog.
Os provedores de dados podem aproveitar esse recurso para dimensionar com facilidade seu data-as-a-service, reduzir o custo operacional do compartilhamento de grandes conjuntos de dados, melhorar a qualidade dos dados com validações e verificações imediatas à medida que novos dados chegam e aprimorar o atendimento ao cliente com o fornecimento de dados em tempo real. Da mesma forma, os destinatários de dados podem fazer streaming das alterações mais recentes de um conjunto de dados compartilhado, reduzindo o custo de infraestrutura do processamento de grandes lotes de dados e estabelecendo a base para aplicações de dados em tempo real de ponta. Os destinatários de dados em vários setores da indústria podem se beneficiar desse novo recurso, por exemplo:
- Varejo: analistas de dados podem fazer streaming dos números de vendas mais recentes de uma linha de moda sazonal e apresentar insights de negócios em um relatório de BI.
- Saúde e ciências da vida: profissionais de saúde podem fazer streaming de leituras de eletrocardiograma para um modelo de ML para identificar anormalidades.
- Manufatura: equipes de gestão predial podem fazer streaming de leituras de termostatos inteligentes e identificar em qual horário do dia ou da noite as unidades de aquecimento e resfriamento devem ser ligadas ou desligadas com eficiência.
Muitas vezes, as equipes de dados usam pipelines de dados executados em lote para processar seus dados pelo fato de a execução em lote ser robusta e fácil de implementar. No entanto, hoje as organizações precisam dos dados mais recentes para tomar decisões de negócios em tempo real. O Structured Streaming não apenas simplifica o processamento em tempo real, mas também simplifica o processamento em lote, reduzindo o número de jobs em lote para apenas alguns jobs de streaming. Converter pipelines de dados em lote para streaming é simples, pois o Structured Streaming suporta a mesma API de DataFrame.
Neste artigo do blog, vamos explorar como as empresas podem aproveitar o Structured Streaming com o Delta Sharing para maximizar o valor de negócios dos seus dados em tempo quase real usando um exemplo do setor financeiro. Também examinaremos como outros recursos complementares, como o Databricks Workflows, podem ser usados em conjunto com o Delta Sharing e o Unity Catalog para criar uma aplicação de dados em tempo real.
Suporte para Structured Streaming
Talvez o recurso do Delta Sharing mais aguardado nos últimos meses seja o suporte adicionado para o uso de uma tabela Delta compartilhada como origem no Structured Streaming. Esse novo recurso permitirá que os destinatários de dados criem aplicações em tempo real usando tabelas Delta compartilhadas por meio do Unity Catalog na Databricks Lakehouse Platform.
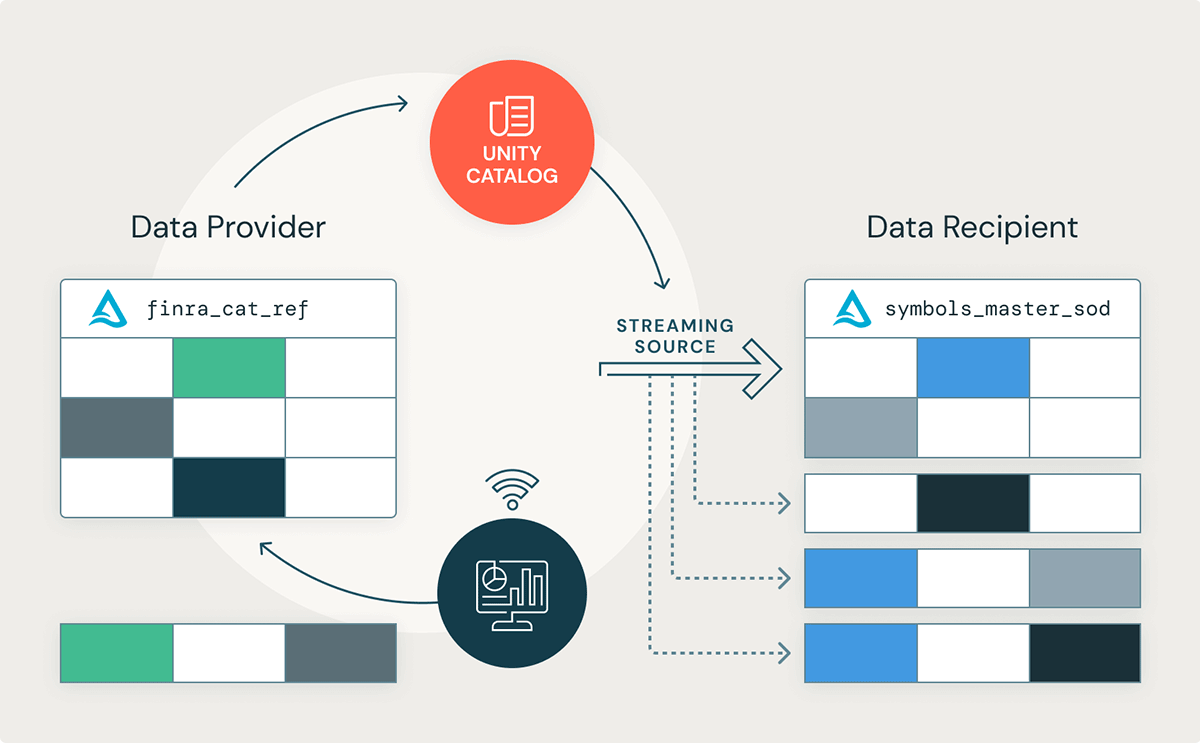

Como usar o Delta Sharing com o Structured Streaming
Vamos analisar mais de perto como um destinatário de dados pode fazer streaming de informações sobre símbolos de ações negociadas publicamente para obter insights de negociação em tempo real. Este artigo usará o conjunto de dados FINRA CAT Reportable Equity Securities Symbol Master, que lista todas as ações e títulos negociados no National Market System (NMS) dos EUA. O Structured Streaming pode ser usado para criar aplicações em tempo real, mas também pode ser útil em cenários nos quais os dados chegam com menos frequência. Para uma demonstração simples em notebook, usaremos um conjunto de dados atualizado três vezes ao longo do dia: uma no início da data de transação (SOD), uma segunda vez durante o dia para refletir eventuais alterações intradiárias e uma terceira vez no final da data de transação (EOD). Não há atualizações publicadas nos finais de semana nem em feriados dos EUA.
| Arquivo publicado | Horário |
|---|---|
| CAT Reportable Equity Securities Symbol Master – SOD | 6:00 EST |
| CAT Reportable Options Securities Symbol Master – SOD | 6:00 EST |
| Member ID (IMID) List | 6:00 EST |
| Member ID (IMID) Conflicts List | 6:00 EST |
| CAT Reportable Equity Securities Symbol Master – Intraday | 10:30 EST, e aproximadamente a cada 2 horas até que o arquivo EOD seja publicado |
| CAT Reportable Options Securities Symbol Master – Intraday | 10:30 EST, e aproximadamente a cada 2 horas até que o arquivo EOD seja publicado |
| CAT Reportable Equity Securities Symbol Master – EOD | 20:00 EST |
| CAT Reportable Options Securities Symbol Master – EOD | 20:00 EST |
Tabela 1.1 - Os dados de referência de membros e símbolos FINRA CAT são publicados ao longo do dia útil. Não há atualizações publicadas nos finais de semana nem em feriados dos EUA.
Da perspectiva do provedor de dados: ingestão de dados do CAT usando o Databricks Workflows
Um dos principais benefícios da Databricks Lakehouse Platform é que ela facilita extremamente o streaming contínuo de alterações para uma tabela Delta. Começaremos definindo uma tarefa simples em Python que baixa o arquivo de símbolos de títulos de ações FINRA CAT no início da data de transação (SOD). Depois disso, salvaremos o arquivo publicado em um diretório temporário no sistema de arquivos do Databricks.
Código 1.1. - Uma tarefa simples em Python pode baixar o arquivo de símbolos de ações do FINRA CAT no início do dia de negociação.
Para demonstrar, também definiremos uma função que fará a ingestão do arquivo bruto e atualizará continuamente uma tabela bronze no nosso Delta Lake cada vez que um arquivo atualizado for publicado.
Código 1.2 - Os dados de símbolos de ações do FINRA CAT são ingeridos em uma tabela Delta no início de cada dia de negociação.
Depois de iniciado, o Databricks Workflow começará a popular o conjunto de dados de símbolos de ações do CAT cada vez que o arquivo for publicado no início do dia de negociação.
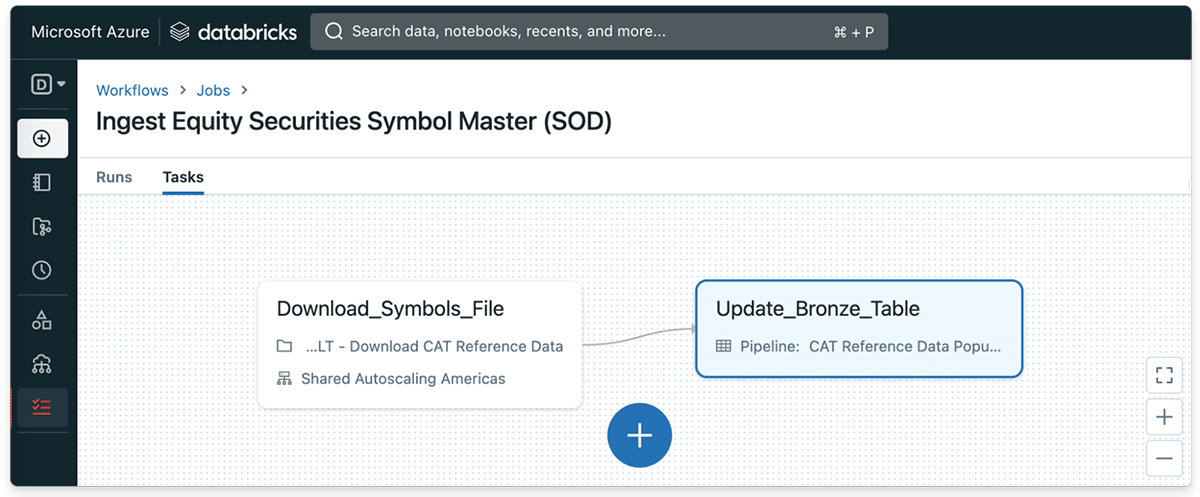

Da perspectiva do provedor de dados: compartilhamento de uma tabela Delta como origem de streaming
Agora que criamos um pipeline de streaming para ingerir atualizações no arquivo de símbolos a cada dia útil, podemos aproveitar o Delta Sharing para compartilhar a Delta Table com os destinatários dos dados. Criar um Delta Share na Databricks Lakehouse Platform pode ser feito com apenas alguns cliques ou com uma única instrução SQL, caso prefira a sintaxe SQL.
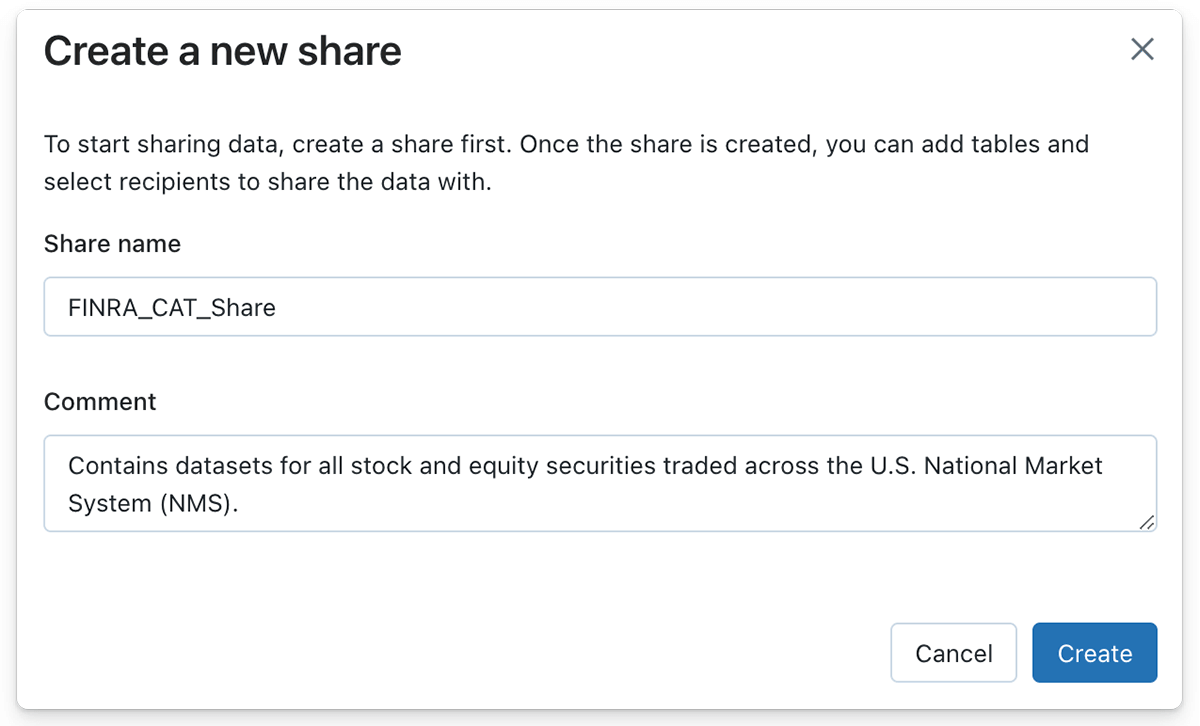

Da mesma forma, um provedor de dados pode preencher um Delta Share com uma ou mais tabelas clicando no botão 'Gerenciar ativos' e, em seguida, no botão 'Editar tabelas'. Neste caso, a Delta Table bronze que contém os dados de símbolos de ações é adicionada ao objeto Share.
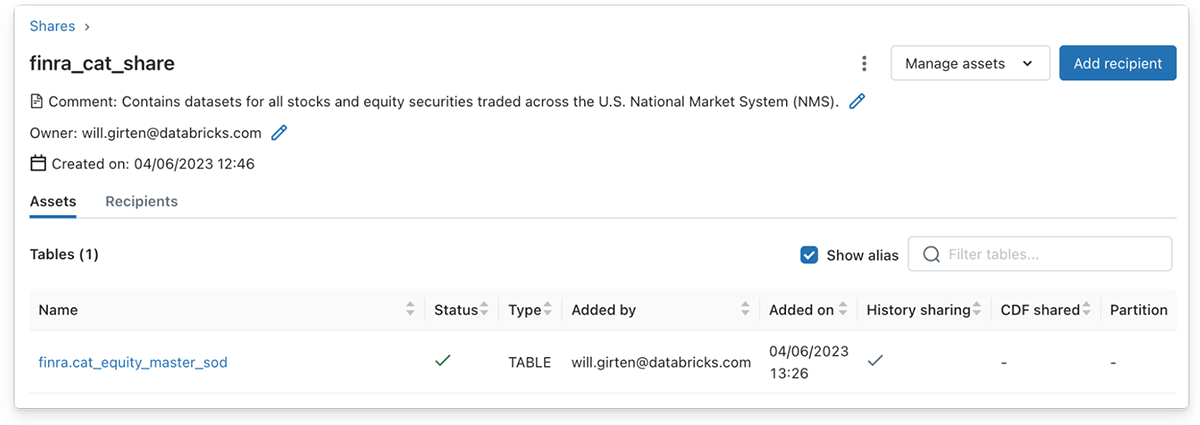

Observe que o histórico completo de uma tabela Delta deve ser compartilhado para dar suporte a leituras usando o Structured Streaming. O compartilhamento do histórico é ativado por padrão ao usar a UI do Databricks para adicionar uma tabela Delta a um Share. No entanto, o compartilhamento do histórico deve ser especificado explicitamente ao usar a sintaxe SQL.
Código 1.4 - O histórico de uma tabela Delta deve ser compartilhado explicitamente para dar suporte a leituras do Structured Streaming ao usar a sintaxe SQL.
Da perspectiva do destinatário dos dados: fazendo streaming de uma tabela Delta compartilhada
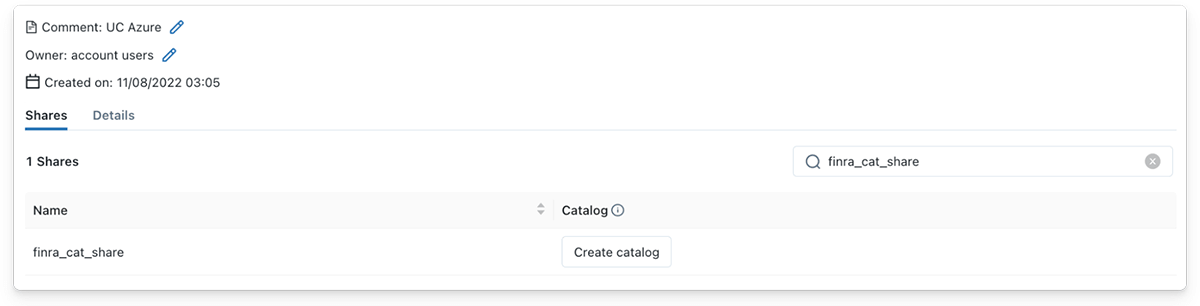

Como destinatário de dados, fazer streaming a partir de uma tabela Delta compartilhada é igualmente simples! Depois que o Delta Share for compartilhado com um destinatário de dados, ele verá imediatamente o Share aparecer sob os detalhes do provedor no Unity Catalog. Posteriormente, o destinatário dos dados pode criar um novo catálogo no Unity Catalog clicando no botão 'Criar catálogo', fornecendo um nome significativo e adicionando um comentário opcional para descrever o conteúdo do Share.
Os destinatários dos dados podem fazer streaming de uma Delta Table compartilhada por meio do Unity Catalog usando o Databricks Runtime 12.1 ou superior. Neste exemplo, usamos um cluster Databricks com o Databricks 12.2 LTS Runtime instalado. Um destinatário de dados pode ler a tabela Delta compartilhada como um Spark Structured Stream usando a fonte de dados deltaSharing e fornecendo o nome da tabela compartilhada.
Código 1.4 - Um destinatário de dados pode fazer streaming de uma Delta Table compartilhada usando a fonte de dados deltaSharing.
Como um exemplo adicional, vamos combinar o conjunto de dados principal de símbolos de ações CAT compartilhado com um conjunto de dados de histórico de preços de ações, local no Unity Catalog do destinatário dos dados. Começaremos definindo uma função utilitária para obter os históricos semanais de preços de ações de um determinado símbolo de ação.
A seguir, uniremos o stream de dados mestre de ações com os históricos locais de preços de ações de 3 grandes empresas de tecnologia — Apple Inc. (AAPL), Microsoft Corporation (MSFT) e Invidia Corporation (NVDA).
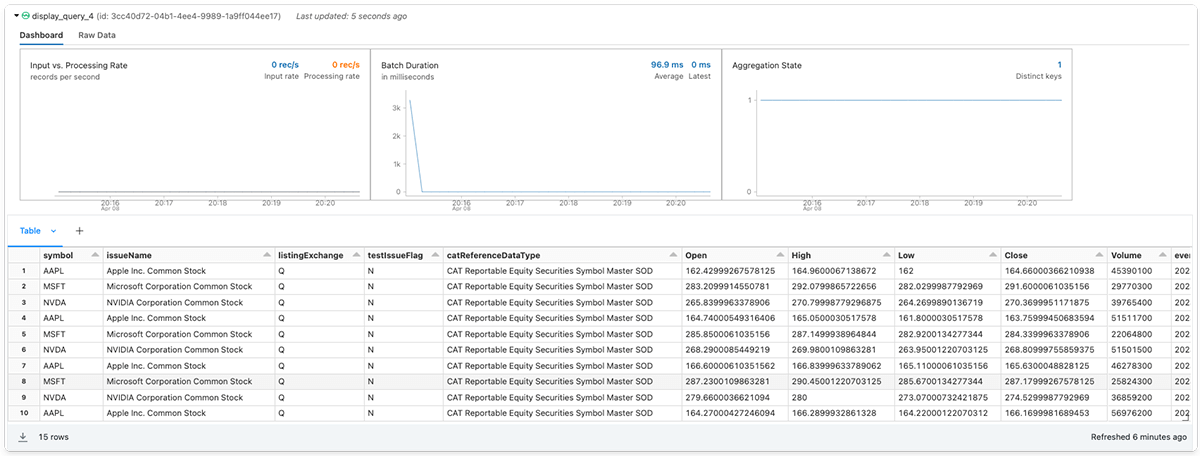
Por fim, o destinatário dos dados pode adicionar um sink de destino opcional e iniciar a consulta de streaming.

Primeiros passos com o Delta Sharing no Databricks
Espero que você tenha gostado deste exemplo de como as organizações podem aproveitar o Delta Sharing para maximizar o valor de negócios de seus dados em tempo quase real.
Quer começar a usar o Delta Sharing, mas não sabe por onde começar? Se você já é cliente do Databricks, siga o guia para começar a usar o Delta Sharing (AWS | Azure | GCP). Leia a documentação para saber mais sobre as opções de configuração incluídas neste recurso. Se você ainda não é cliente do Databricks, inscreva-se para um teste gratuito com um workspace Premium ou Enterprise.
Créditos
Gostaríamos de agradecer especialmente por todas as contribuições para este lançamento, incluindo Abhijit Chakankar, Lin Zhou e Shixiong Zhu.
Recursos
- Notebooks complementares:
- [eBook] Saiba mais sobre o compartilhamento de dados e colaboração com a Databricks Lakehouse
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.