O que é AIOps?
O AIOps combina AI e machine learning com observabilidade para automatizar as operações de IT. Explore seus principais componentes, benefícios, casos de uso e desafios.
- O AIOps (Artificial Intelligence for IT Operations) aplica AI, machine learning e dados operacionais para detectar anomalias, correlacionar eventos, identificar causas raiz e automatizar a resposta a incidentes.
- Ele ajuda as equipes de IT e engenharia de plataforma a reduzir o risco de inatividade, diminuir a fadiga de alertas, acelerar a tomada de decisões e reduzir o tempo médio de resolução (MTTR).
- O AIOps complementa as práticas de observabilidade e DevOps ao converter sinais brutos do sistema em inteligência operacional acionável, mantendo a supervisão humana (human-in-the-loop) para ações de maior risco.
A Inteligência Artificial para Operações de TI (AIOps) aplica AI e machine learning às operações de TI para detectar anomalias, correlacionar eventos, identificar causas raiz e acionar respostas mais rapidamente do que qualquer processo manual.
O Gartner cunhou o termo em 2017. Então, por que você está lendo sobre isso agora?
Porque a infraestrutura que executa suas aplicações em 2026 não se parece em nada com aquilo para o qual o monitoramento tradicional foi criado. Você está gerenciando centenas de microsserviços, dependências multicloud, cargas de trabalho de AI e sistemas baseados em agentes que geram mais sinais operacionais em uma hora do que um engenheiro de plantão consegue ler em uma semana.
É essa lacuna que o AIOps está posicionado para preencher agora. Este guia explica como ele funciona, onde se encaixa e o que avaliar antes de escolher uma plataforma.
- O AIOps aplica AI e machine learning às operações de TI para detectar anomalias, correlacionar eventos, identificar prováveis causas raiz e permitir uma resposta mais rápida a incidentes.
- O AIOps ajuda as equipes a reduzir o risco de inatividade, diminuir a fadiga de alertas, melhorar a velocidade de tomada de decisão e acelerar a resposta a incidentes, transformando dados operacionais em insights acionáveis.
- O AIOps complementa a observabilidade e o DevOps em vez de substituí-los, aumentando a capacidade dos engenheiros de AI e de plataforma com inteligência operacional, ao mesmo tempo que mantém a supervisão humana para ações de maior risco.
O que o AIOps faz e o que não faz
O AIOps analisa dados de logs, traces, eventos e topologia de rede para detectar problemas e prever falhas antes que se tornem incidentes.
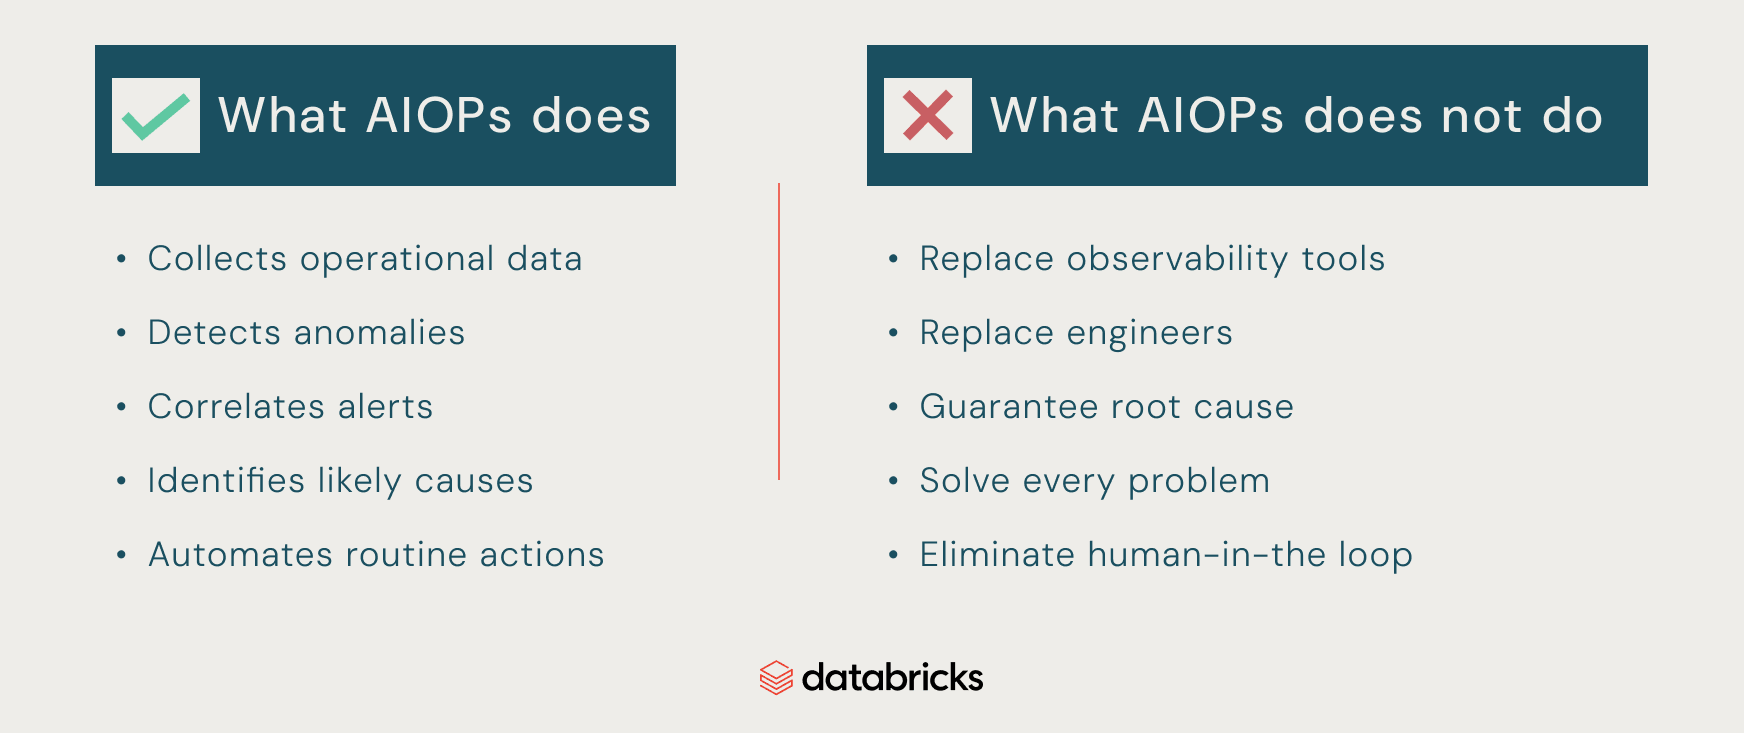
Ele fica entre a observabilidade e a ação. A observabilidade mostra o que está acontecendo nos sistemas. O AIOps pega esse sinal, reduz o ruído, conecta eventos relacionados e ajuda os engenheiros de plataforma a decidir o que fazer a seguir. Ele não substitui a observabilidade, o DevOps ou o julgamento humano. Ele torna os três mais rápidos.
Por que agora?
À medida que a infraestrutura se torna mais distribuída, o volume de dados operacionais, la complexidade das dependências e a velocidade das mudanças aumentam. As ferramentas tradicionais de monitoramento não atendem às crescentes demandas e costumam gerar ruído excessivo, carecendo de um contexto claro para priorizar as ameaças. Como resultado, as equipes de dados enfrentam dificuldades para identificar os sinais que importam antes que os incidentes afetem os usuários.
Quando as equipes aproveitam a AI e o machine learning nas operações de TI, elas se otimizam para:
- Reduzir o risco de inatividade: O AIOps pode detectar anomalias e correlacionar eventos relacionados para identificar possíveis falhas mais cedo, ajudando a resolver problemas antes que eles interrompam serviços importantes e causem inatividade.
- Diminuir a fadiga de alertas: O machine learning pode filtrar alertas repetitivos ou de baixo valor e destacar eventos com maior probabilidade de exigir atenção humana.
- Melhorar a velocidade de decisão: Ao adicionar contexto aos eventos operacionais e identificar as prováveis causas raiz, o AIOps ajuda os engenheiros a determinar o que está acontecendo e o que investigar a seguir.
- Acelerar a resposta a incidentes: Quando a correção apropriada é conhecida, o AIOps pode recomendar ou automatizar ações como reiniciar serviços, dimensionar recursos ou acionar fluxos de trabalho predefinidos.
Esses fatores se inclinam especificamente para a detecção precoce de ameaças e uma recuperação mais rápida. Eles não pretendem concluir que o AIOps resolve todos os gargalos de automação ou elimina a necessidade de engenheiros.
Quais são os principais componentes do AIOps?
Ao avaliar uma plataforma de AIOps, é importante entender os principais blocos de construção e como eles funcionam em seus domínios:
- Ingestão de dados: Aqui, as plataformas de AIOps coletam e consolidam dados de métricas, logs, traces, eventos e alertas de infraestrutura, aplicações e dispositivos de rede em um data lake, data warehouse ou lakehouse. Uma ingestão de dados ampla e confiável dá ao AIOps a visibilidade necessária para detectar problemas em ambientes de TI.
- Normalização e enriquecimento de dados: Depois que o AIOps coleta dados de várias fontes, a análise processa os dados brutos para destacar tendências, prever as necessidades de capacidade dos ambientes e detectar comportamentos incomuns do sistema antes que causem interrupções. Isso dá às análises downstream uma visão consistente do que está acontecendo e onde isso importa.
- Detecção de anomalias. Para detectar atividades incomuns nos sistemas, os métodos tradicionais dependem de limites estáticos, limites de CPU e medidas semelhantes para acionar alertas. Sem nenhum contexto. O AIOps aprende como é o comportamento normal para cada métrica, por hora, dia e estação. Depois, ele só alerta quando esse comportamento se desvia da linha de base. Isso dá aos engenheiros de AI mais tempo para investigar possíveis problemas antes que eles afetem os usuários.
- Correlação de eventos. Quando 10 servidores diferentes mostram alto uso de CPU, o AIOps conecta os alertas relacionados em vez de tratar cada alerta como um incidente isolado. Isso reduz a fadiga de alertas e ajuda a focar no problema subjacente, em vez de centenas de eventos individuais.
- Análise de causa raiz. O método antigo, no qual 70 alertas disparam e você acompanha cada um deles, é insustentável. O AIOps entende a topologia do sistema, examina os serviços dependentes durante os alertas e traz à tona a causa raiz do problema. A partir dos alertas, o AIOps determina que o serviço C está degradado, enquanto os serviços A e B estão apenas downstream. Isso acelera a solução de problemas, minimiza o tempo de inatividade dos negócios e economiza tempo ao evitar investigações por incidente.
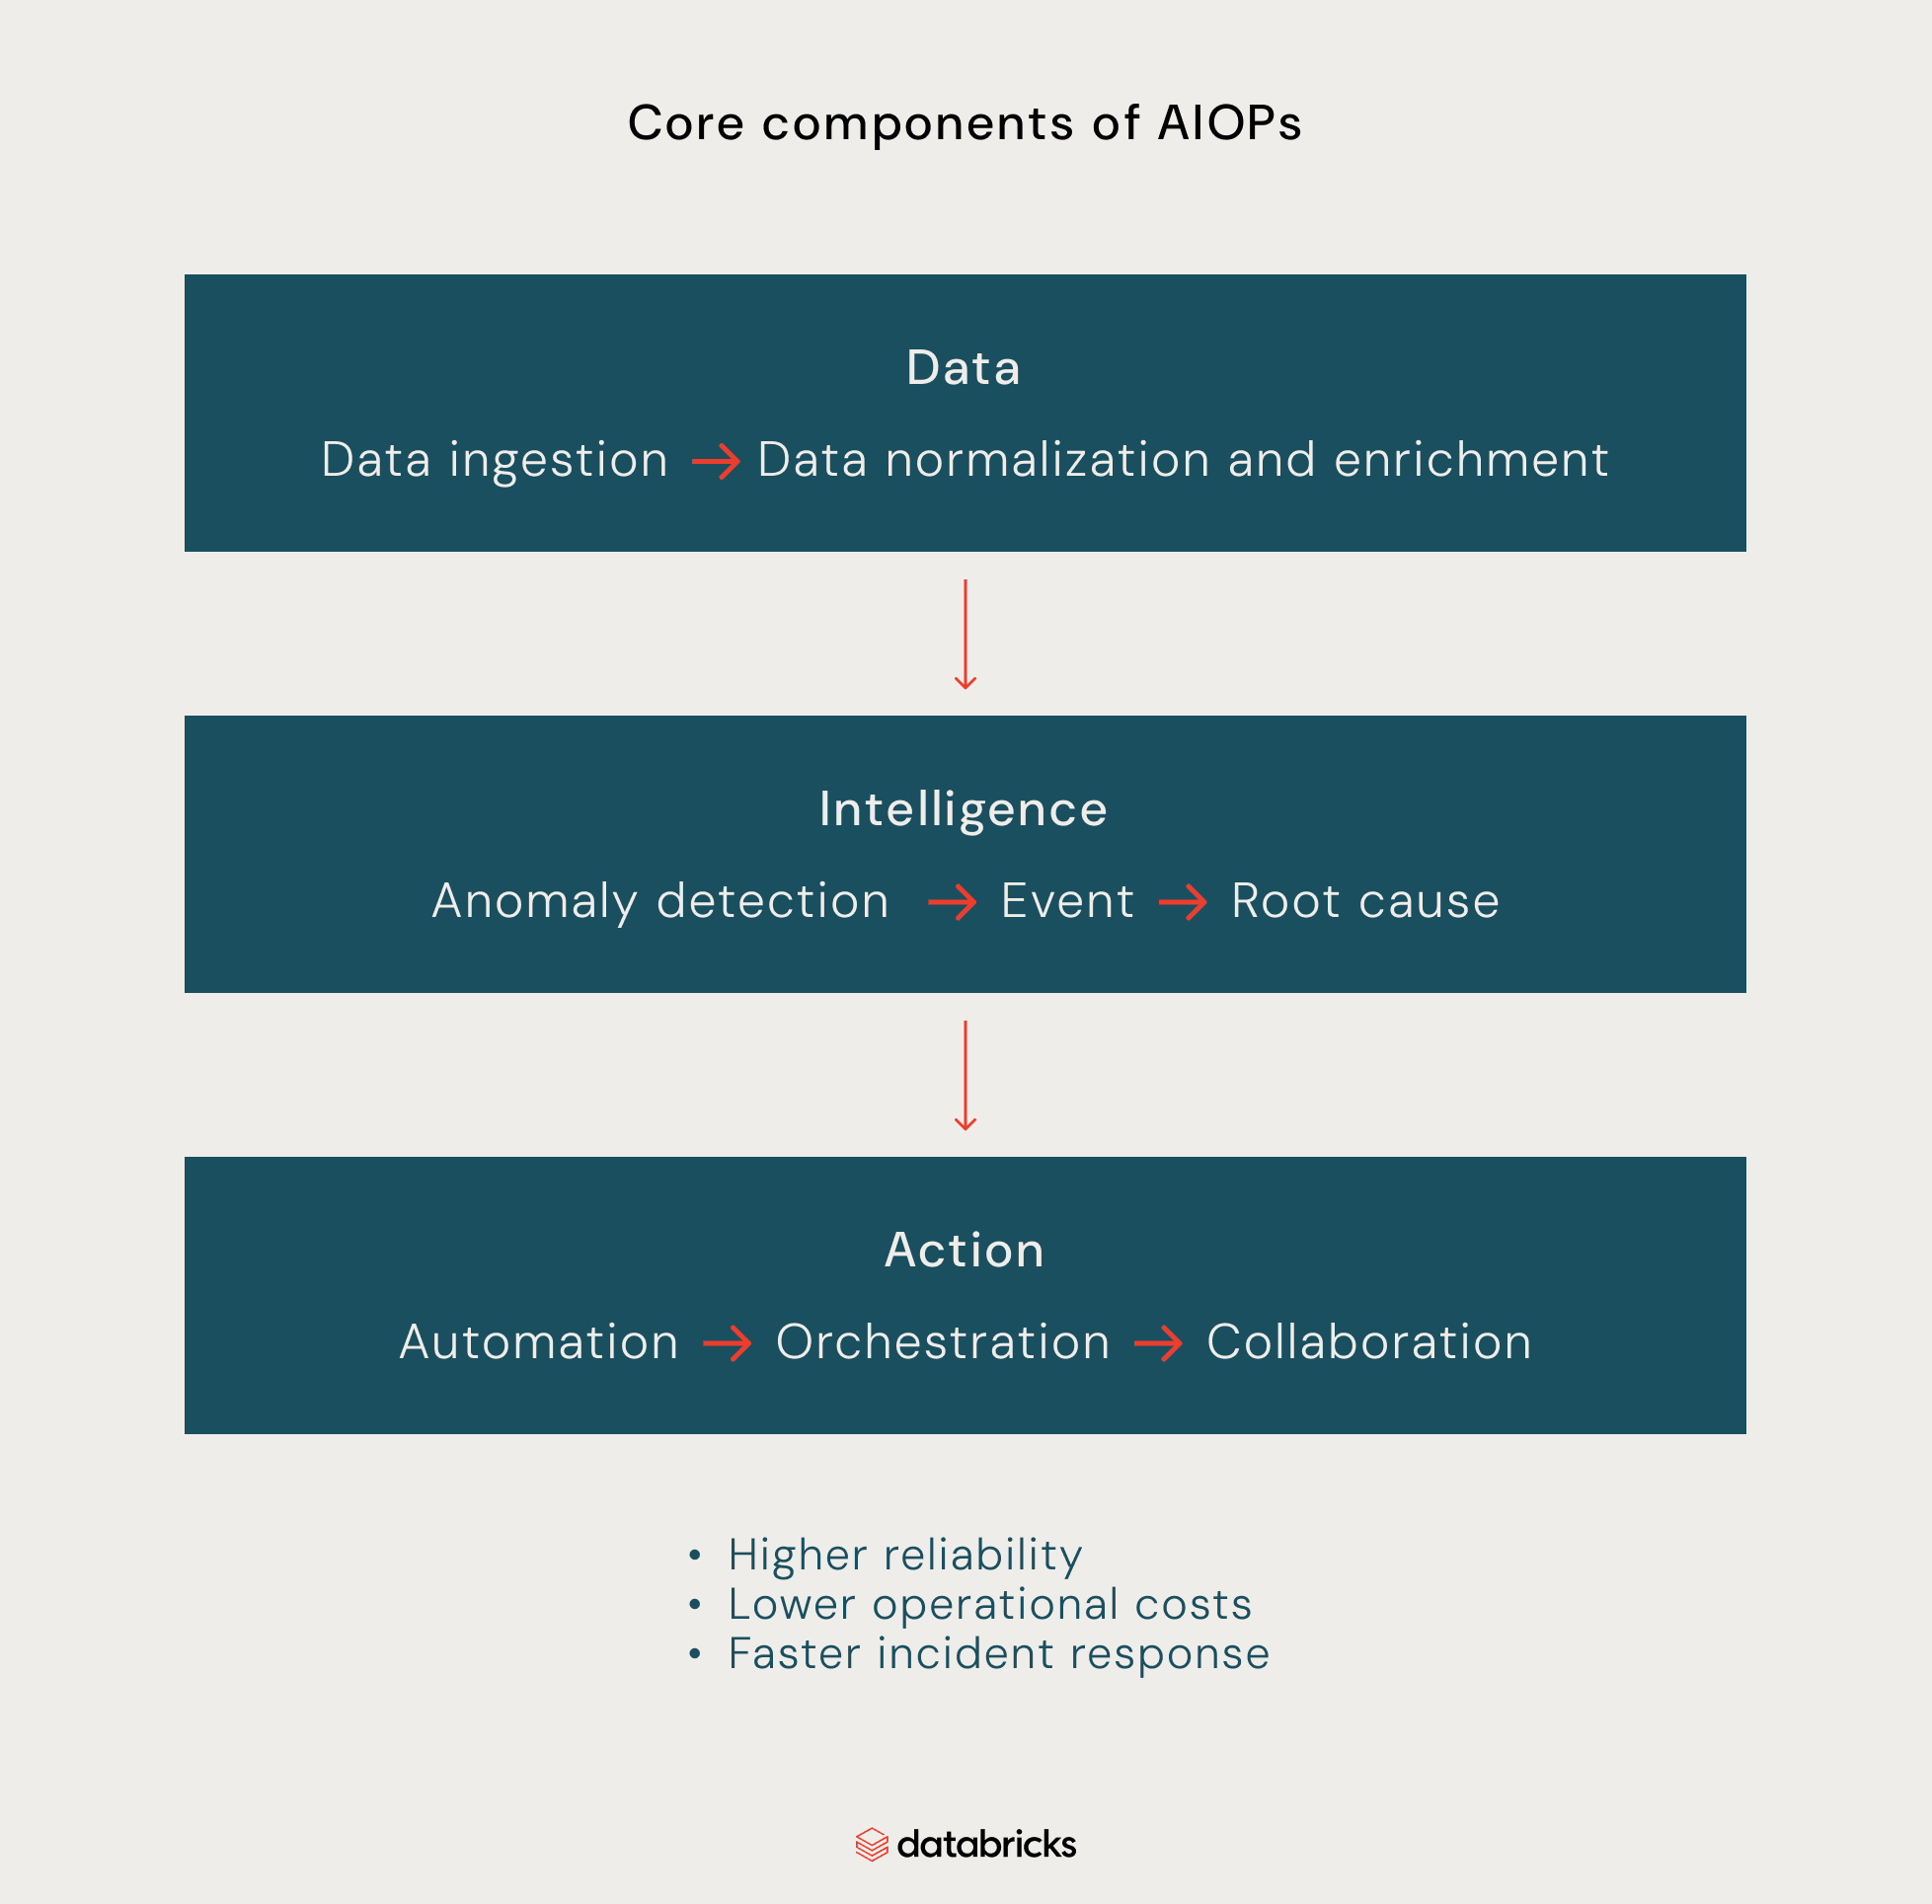
- Automação e orquestração. Uma vez identificada a causa raiz, o AIOps transforma esses insights em ação, recomendando ou executando respostas predefinidas, como reiniciar um serviço, dimensionar a infraestrutura, reverter uma implantação ou abrir um ticket. Esse componente reduz a intervenção manual, acelera a resolução de incidentes e ajuda a controlar os custos operacionais. Para fluxos de trabalho operacionais mais avançados, o Agent Bricks pode ajudar as equipes a criar e implantar agentes de AI que usam dados e ferramentas corporativas para realizar tarefas de várias etapas.
- Fluxos de trabalho de colaboração. Conecta os insights do AIOps às pessoas e processos responsáveis por resolver incidentes. Isso pode incluir o roteamento de alertas, atribuição de responsabilidades, escalonamento de incidentes e fornecimento aos engenheiros do contexto necessário para responder.
Com esses componentes principais, vejamos como eles se unem na seção a seguir.
Como o AIOps funciona?
O processo de AIOps começa com a coleta de sinais de aplicações, infraestrutura, redes e serviços em nuvem. Em seguida, os dados passam por uma limpeza, na qual sinais duplicados, incompletos ou inconsistentes são organizados em um formato que o AIOps possa analisar.
Por exemplo, seu sistema detecta que sua aplicação de repente começa a retornar um alto número de erros de Interface de Programação de Aplicações (API). O AIOps compara o comportamento atual da sua aplicação com padrões anteriores e sinaliza o aumento de erros como incomum.
Com a correlação de eventos, a plataforma de AIOps conecta os erros de API a outros sinais, como um aumento repentino na carga do banco de dados ou uma implantação recente. A análise de causa provável examina esses sinais conectados para determinar as causas prováveis. Em vez de tratar os erros de API, a carga do banco de dados e a implantação como eventos separados, o AIOps identifica a implantação recente como a fonte provável do incidente.
A etapa final é a resposta guiada ou automatizada. Dependendo do fluxo de trabalho, o AIOps pode recomendar uma ação de correção, abrir um ticket, notificar a equipe apropriada ou executar automaticamente uma resposta predefinida, como reverter a implantação.
Ações de maior risco devem exigir intervenção humana (human-in-the-loop) para permitir que os engenheiros revisem e aprovem a resposta antes que ela afete a produção.
Quais são os principais tipos de AIOps?
Os tipos de AIOps dependem do que melhor se adapta à organização, do escopo de suas operações, dos sistemas a serem gerenciados e do nível de interconexão na infraestrutura.
As abordagens centradas em domínio (domain-centric) e agnósticas de domínio (domain-agnostic) são os dois principais tipos de AIOps. Nenhuma delas substitui diretamente a outra; ambas têm seus pontos fortes e desvantagens:
O AIOps centrado em domínio foca em uma área específica, como gerenciamento de nuvem, desempenho de rede ou monitoramento de aplicativos. Uma abordagem centrada em domínio é a escolha ideal para solucionar problemas em um domínio específico; ela fornece um contexto mais profundo e uma análise mais especializada dentro desse ambiente.
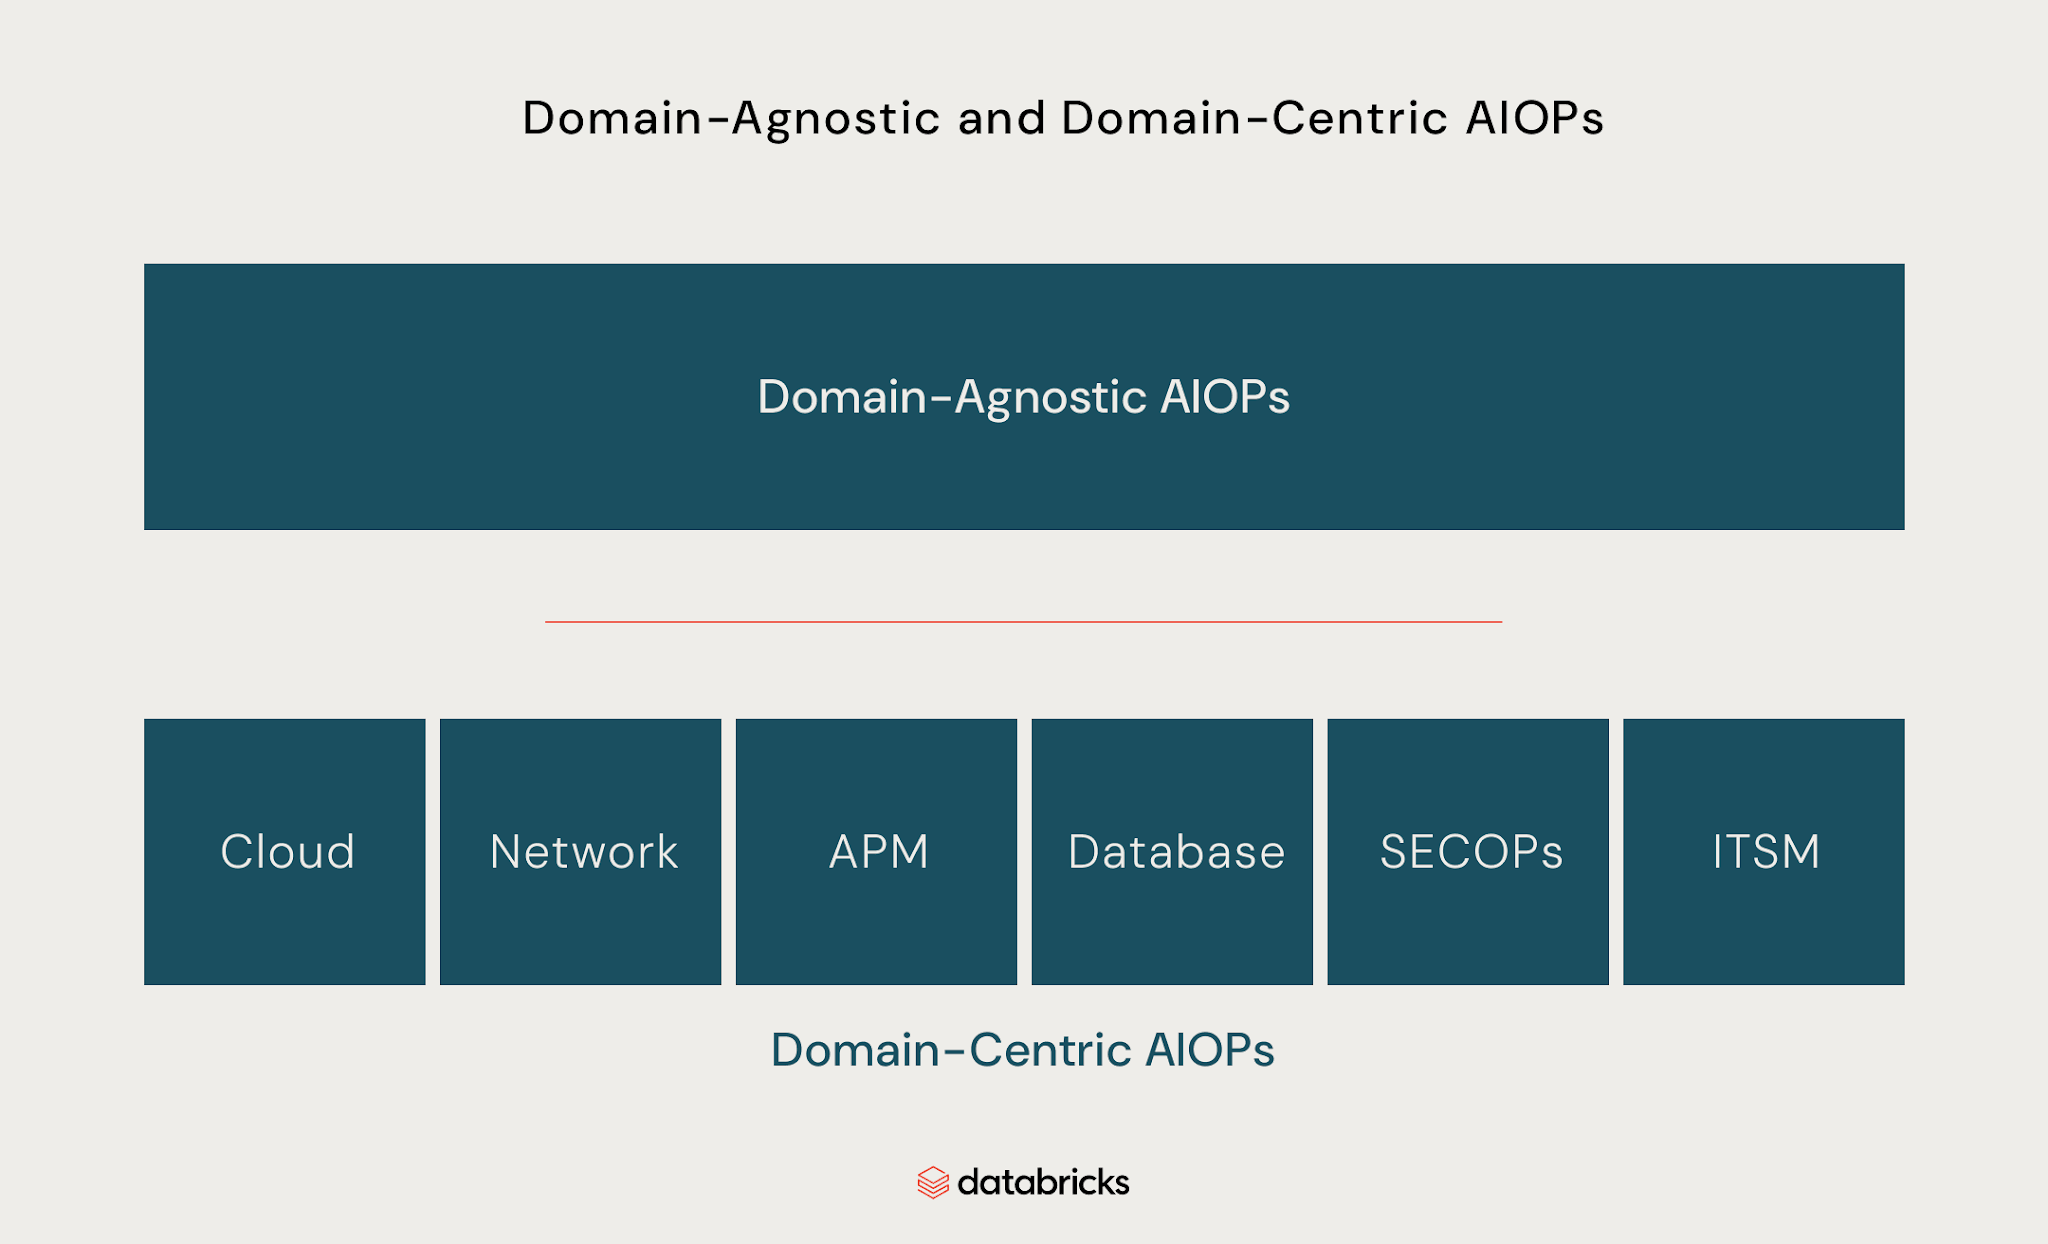
O AIOps agnóstico de domínio opera em vários ambientes de IT, coletando e analisando dados de sistemas como aplicativos, redes, infraestrutura de nuvem e armazenamento. Em contraste com a abordagem centrada em domínio, as plataformas de AIOps agnósticas de domínio são mais adequadas para resolver problemas mais amplos. Isso as torna mais adequadas para organizações que gerenciam infraestruturas complexas e interconectadas, onde os incidentes frequentemente ultrapassam os limites operacionais.
O AIOps centrado em domínio pode fornecer maior profundidade e inteligência mais especializada dentro de um único domínio, enquanto o AIOps agnóstico de domínio oferece maior amplitude e visibilidade mais ampla em sistemas e ferramentas.
Casos de uso comuns de AIOps
Os casos de uso de AIOps abrangem muitas áreas das operações de IT; algumas das aplicações mais comuns incluem:
Análise de causa raiz
O AIOps ajuda a identificar a causa provável de uma interrupção, erro ou problema de desempenho. Em vez de tratar um pico de erros de API como um incidente isolado, o AIOps pode correlacioná-lo com uma implantação recente, uma falha de banco de dados ou uma alteração de configuração de rede.
Detecção de anomalias
O AIOps varre continuamente os dados do sistema para estabelecer uma linha de base e detectar desvios que possam levar a incidentes e falhas.
Monitoramento de desempenho
O AIOps pode monitorar ambientes de IT em ambientes de nuvem, on-premises e híbridos com serviços e dependências interconectados. Isso ajuda a identificar tendências e priorizar problemas por meio de monitoramento constante e correlação de desempenho.
Adoção e migração para a nuvem
As migrações para a nuvem introduzem novas dependências em cargas de trabalho, APIs, serviços e infraestrutura. O AIOps mapeia essas relações, monitora mudanças no comportamento do sistema e identifica possíveis gargalos antes que eles interrompam serviços críticos. O AIOps fornece uma visibilidade mais clara em ambientes híbridos e multicloud durante a migração.
Adoção de DevOps
O DevOps aumenta a velocidade de desenvolvimento e implantação, mas também introduz riscos operacionais e problemas que podem passar despercebidos por humanos. O AIOps monitora a atividade de implantação, analisa seu impacto na produção e pode acionar respostas predefinidas quando ocorrem problemas.
O AIOps e o DevOps abordam partes diferentes do ciclo de vida de entrega e operações de software e são mais eficazes quando integrados.
Principais conclusões sobre sistemas multiagentes, casos de uso de IA, avaliações e muito mais

AIOps vs. DevOps: qual é a diferença?
Não se trata de uma escolha entre AIOps ou DevOps, mas sim de AIOps e DevOps. As duas abordagens se complementam em vez de competir. O DevOps fornece o modelo operacional para criar, testar e implantar software, enquanto o AIOps aplica inteligência operacional aos sistemas que o executam.
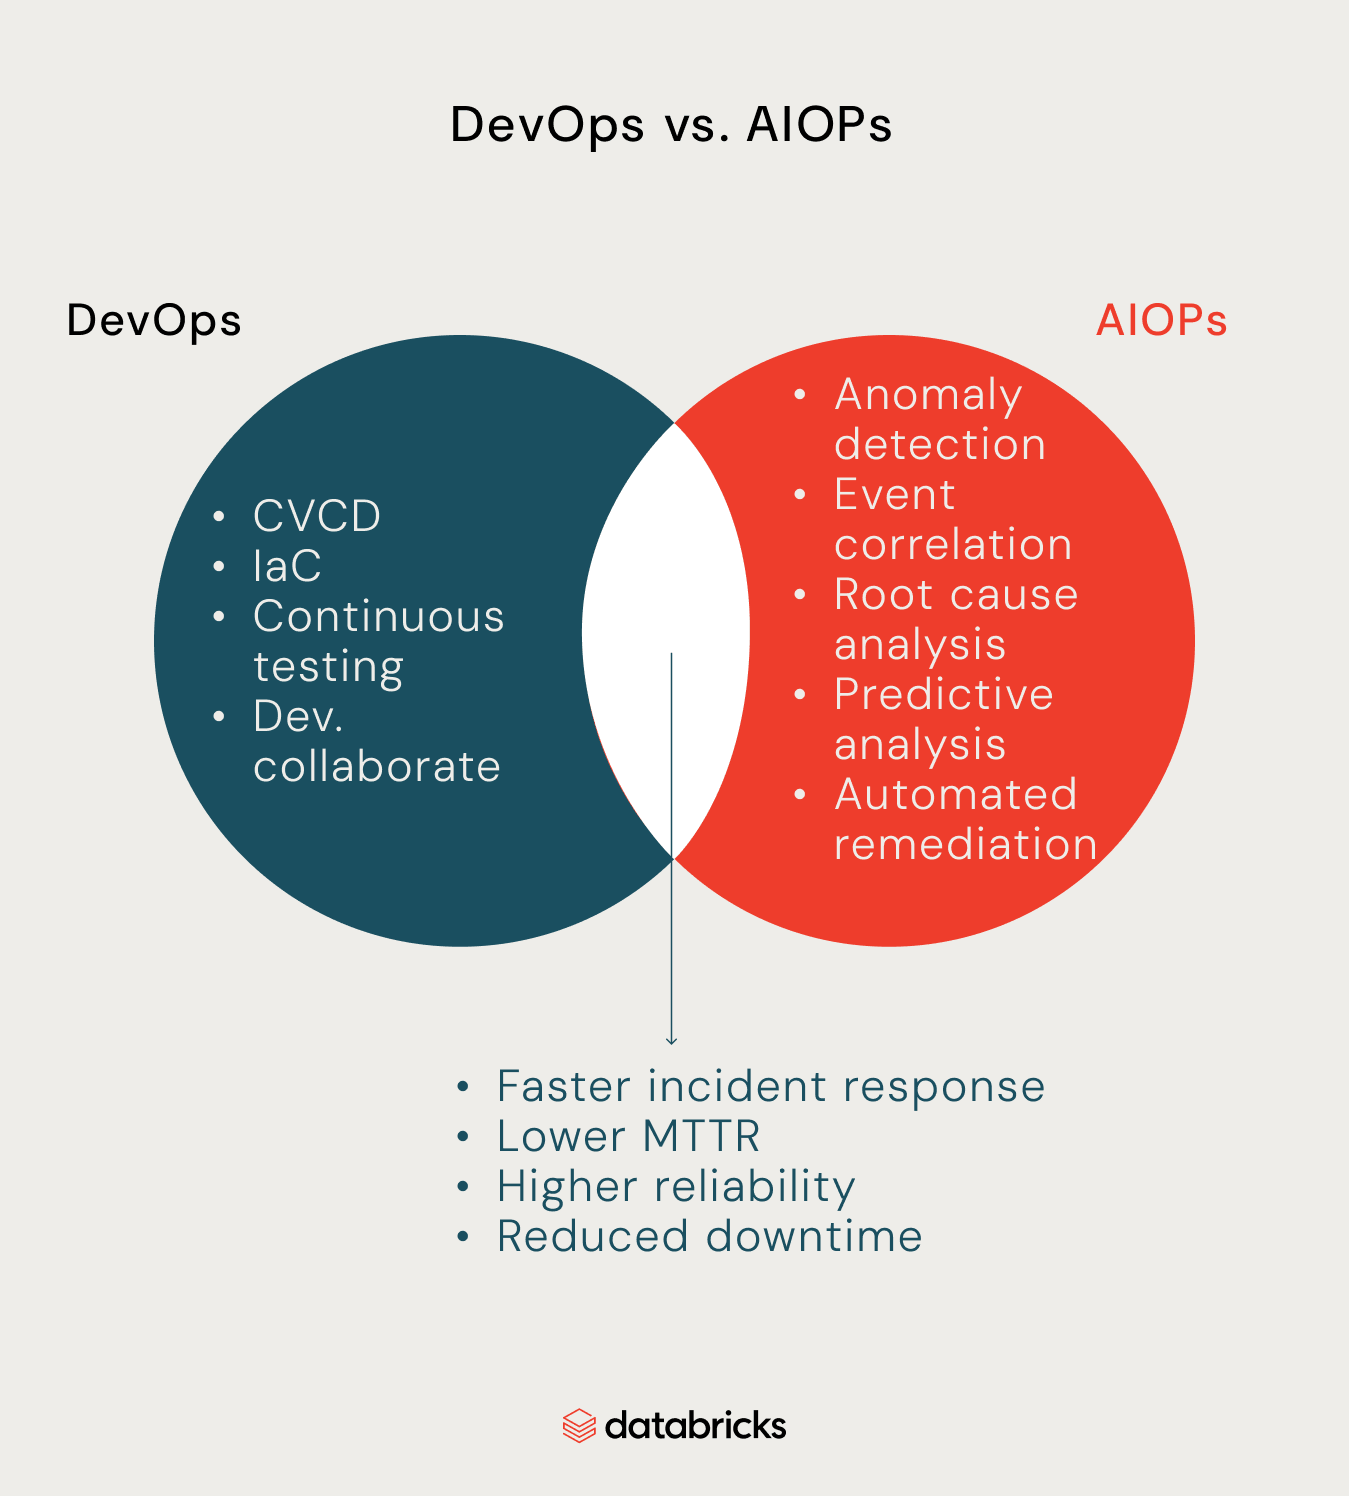
O DevOps conecta o desenvolvimento e as operações automatizando a entrega de software, permitindo que os desenvolvedores lancem alterações mais rapidamente. O AIOps estende esse modelo operacional analisando dados de infraestrutura, aplicativos e outros sistemas para detectar anomalias, correlacionar eventos, identificar causas prováveis e apoiar uma remediação mais rápida.
| DevOps | AIOps | |
|---|---|---|
| Foco principal | Entrega de software e colaboração | Operações de IT e inteligência operacional |
| Função | Modelo operacional e práticas de engenharia | Análise e automação orientadas por AI |
| O que analisa | Código, builds, testes, implantações | Métricas, logs, traces, eventos e alertas |
| Principais resultados | Lançamentos mais rápidos e confiáveis | Detecção, resposta e recuperação mais rápidas |
| Como trabalham juntos | Entrega alterações em produção | Monitora e responde ao seu impacto operacional |
O DevOps pode implantar uma nova versão do aplicativo enquanto o AIOps monitora seu impacto na produção. Se a implantação apresentar um comportamento incomum, o AIOps poderá correlacionar sinais, identificar a causa provável e acionar uma resposta predefinida ou alertar o engenheiro apropriado. Em conjunto, eles ajudam a avançar mais rápido com visibilidade clara.
Quais são os benefícios do AIOps?
Os principais benefícios do AIOps são um MTTR mais rápido, custos operacionais mais baixos, melhor observabilidade e colaboração, e um gerenciamento de ITOps mais preditivo. Cada benefício se conecta diretamente a como os engenheiros de plataforma detectam, compreendem e resolvem incidentes.
- MTTR mais rápido: O AIOps pode correlacionar eventos, identificar causas raiz prováveis e recomendar as próximas ações mais rapidamente do que uma investigação manual. Isso reduz o tempo que os engenheiros passam rastreando incidentes e ajuda a restaurar os serviços afetados mais cedo.
- Custos operacionais mais baixos: O AIOps automatiza tarefas repetitivas de detecção, investigação e remediação, reduzindo o esforço manual necessário para gerenciar ambientes de IT em crescimento. Ele também pode ajudar a evitar tempos de inatividade dispendiosos, identificando problemas antes que eles aumentem de proporção.
- Melhor observabilidade e colaboração: O AIOps traz sinais de infraestrutura, aplicativos e outros sistemas operacionais para uma visão compartilhada da integridade do sistema. Isso oferece às equipes de desenvolvimento, segurança e operações de IT um melhor contexto ao investigar incidentes e coordenar respostas.
- Gerenciamento preditivo de ITOps: O AIOps usa dados operacionais históricos e em tempo real para identificar padrões que possam indicar falhas futuras ou problemas de capacidade. As equipes de dados podem priorizar esses riscos e agir antes que se tornem incidentes graves.
Esses resultados dependem da qualidade dos sinais que a plataforma de AIOps recebe, da definição clara de propriedade dos processos operacionais e da integração com os fluxos de trabalho existentes. Sem isso, o AIOps pode adicionar mais ruído e automação sem melhorar a resposta a incidentes.
Apesar desses motivos para integrar o AIOps nas organizações, ainda existem algumas restrições a serem consideradas.
Quais são as limitações do AIOps?
O AIOps apresenta limitações em vários aspectos; sua eficácia depende da qualidade dos dados, do contexto disponível para seus modelos e de como os engenheiros de AI integram suas recomendações aos fluxos de trabalho existentes.
- Lacunas na qualidade dos dados: Dados incompletos, inconsistentes ou ruidosos de logs, métricas, traces, eventos e outras fontes podem produzir correlações imprecisas, anomalias não detectadas ou alertas desnecessários.
- Falta de contexto: Sinais operacionais, sem informações prévias sobre dependências, implantações recentes, configurações ou impacto nos negócios, podem levar o AIOps a identificar uma anomalia sem compreender corretamente sua causa ou gravidade.
- Desvio de modelo (model drift): Modelos treinados em padrões históricos podem se tornar menos precisos à medida que os sistemas, as cargas de trabalho e as linhas de base operacionais mudam, exigindo monitoramento e ajuste contínuos.
- Risco de superautomação: As equipes não podem automatizar totalmente uma etapa complexa de remediação sem as salvaguardas apropriadas. Fazer isso pode transformar um pequeno incidente em um problema maior. Ações de maior risco devem manter a supervisão humana.
- Proliferação de ferramentas: Adicionar outra plataforma de AIOps a uma pilha de monitoramento e observabilidade fragmentada pode criar mais complexidade.
- Baixa confiança ou adoção: É menos provável que os engenheiros confiem em recomendações que não conseguem entender ou verificar. As equipes de dados precisam de uma definição clara de propriedade, recomendações explicáveis e resultados mensuráveis antes de expandir o AIOps para operações críticas.
As equipes de dados e os engenheiros de AI precisam conhecer essas limitações porque elas definem expectativas e os ajudam a se preparar de maneira mais eficaz para suas estratégias de governança e gerenciamento de riscos.
Unity Catalog fornece essas estratégias de governança e acesso a ativos de dados e AI em um único catálogo, ajudando as equipes a controlar o acesso a dados confidenciais e regulamentados.
Como as organizações podem implementar o AIOps?
Para que as organizações implementem o AIOps em suas operações de IT, é importante notar que se trata de um processo gradual, e não de uma transformação big-bang. Isso significa focar no sequenciamento, introduzindo-o em etapas, validando seu valor e expandindo para criar confiança no sistema.
Comece com um problema operacional de alto impacto onde o AIOps possa trazer benefícios mensuráveis, como reduzir a fadiga de alertas ou melhorar a resposta a incidentes.
Unifique os sinais operacionais relevantes, adicione contexto sobre dependências e comportamento do sistema e comece com recomendações antes de permitir que o AIOps automatize ações de maior risco. As equipes que criam fluxos de trabalho operacionais de agentes no Databricks podem usar o Agent Bricks para criar e implantar agentes, o MLflow para rastreamento e avaliação, o Unity Catalog para acesso governado e o Unity Gateway para controles de tráfego de modelos e ferramentas.
As equipes começam a confiar nas recomendações, a operacionalizar os fluxos de trabalho e a definir métricas como MTTR, volume de alertas e frequência de incidentes para medir o impacto. A partir daí, as organizações podem expandir o AIOps para outros sistemas, gerenciando as mudanças nas ferramentas, processos e responsabilidades existentes.
Veja como o Mosaic AI ajuda as organizações a gerenciar e governar a AI em suas operações.
Quais são as diferentes abordagens para o AIOps?
Para determinar se uma abordagem de AIOps centrada no domínio ou agnóstica de domínio é melhor para a infraestrutura e os processos da sua organização, considere a cobertura, a profundidade, as integrações, o esforço de configuração e a adequação.
- Cobertura: você precisa de AIOps para um único domínio operacional ou para várias equipes, sistemas e ambientes?
- Profundidade: sua equipe precisa de inteligência especializada para um domínio específico ou de uma análise mais ampla em sistemas interconectados?
- Integrações: essa abordagem pode se conectar às suas ferramentas existentes de monitoramento, observabilidade, nuvem e operações de IT?
- Esforço de configuração: quanto tempo e esforço operacional serão necessários para implantar, configurar e manter?
- Adequação organizacional: ela se alinha às habilidades da sua equipe, aos fluxos de trabalho existentes, ao modelo de responsabilidade e aos objetivos operacionais?
Analisar e responder a essas perguntas com atenção oferece às equipes um modelo de decisão melhor sobre qual abordagem adotar. A escolha certa é aquela que se adapta aos seus requisitos operacionais.
Próximos passos
O AIOps aplica AI e machine learning a dados operacionais para detectar problemas mais cedo, entender seu impacto e responder mais rápido. Ele funciona melhor como uma camada de inteligência que auxilia os engenheiros e os processos existentes de observabilidade e operações de IT, em vez de substituí-los.
Comece identificando onde o AIOps pode agregar mais valor, seja na detecção de anomalias, análise de causa raiz, resposta a incidentes ou monitoramento de desempenho. Em seguida, avalie os dados e integrações disponíveis, apresente recomendações antes de implementar automações de maior risco e meça o impacto em métricas-chave, como o volume de alertas e os custos operacionais.
Para criar e gerenciar aplicações de agentes e de Modelos de Linguagem de Grande Porte (LLM), explore o MLflow para ver como ele pode apoiar o ciclo de vida de suas aplicações e seus fluxos de trabalho operacionais.
Perguntas frequentes
O que significa AIOps?
AIOps significa Inteligência Artificial para Operações de IT. Ele usa AI, machine learning e dados operacionais para detectar, investigar e responder a problemas de IT.
Quais dados o AIOps usa?
O AIOps pode analisar dados operacionais, incluindo logs, métricas, traces, eventos, alertas, dados de configuração e outros sinais de sistemas de IT.
Qual é a diferença entre AIOps e observabilidade?
A observabilidade coleta e compreende o que está acontecendo nos sistemas. O AIOps se baseia nesses sinais operacionais aplicando AI e machine learning para correlacionar eventos, detectar anomalias, identificar causas prováveis e apoiar ou automatizar respostas.
Qual é a diferença entre AIOps e MLOps?
O AIOps aplica AI e machine learning a operações de IT, enquanto o MLOps se concentra no desenvolvimento, implantação, monitoramento e gerenciamento de modelos de machine learning e seu ciclo de vida. Eles resolvem problemas operacionais diferentes, embora possam se sobrepor em organizações que operam sistemas de ML em escala.
O AIOps é uma ferramenta ou uma prática?
O AIOps é tanto uma prática quanto uma categoria de ferramentas. A prática envolve a aplicação de AI e machine learning a operações de IT, enquanto as plataformas de AIOps fornecem os recursos de processamento de dados, análise, correlação e automação necessários para apoiar essa prática.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.