A estrutura de pipeline aberta para agentes e equipes de dados
Crie pipelines com segurança para escala agêntica com qualidade, validação e governança de dados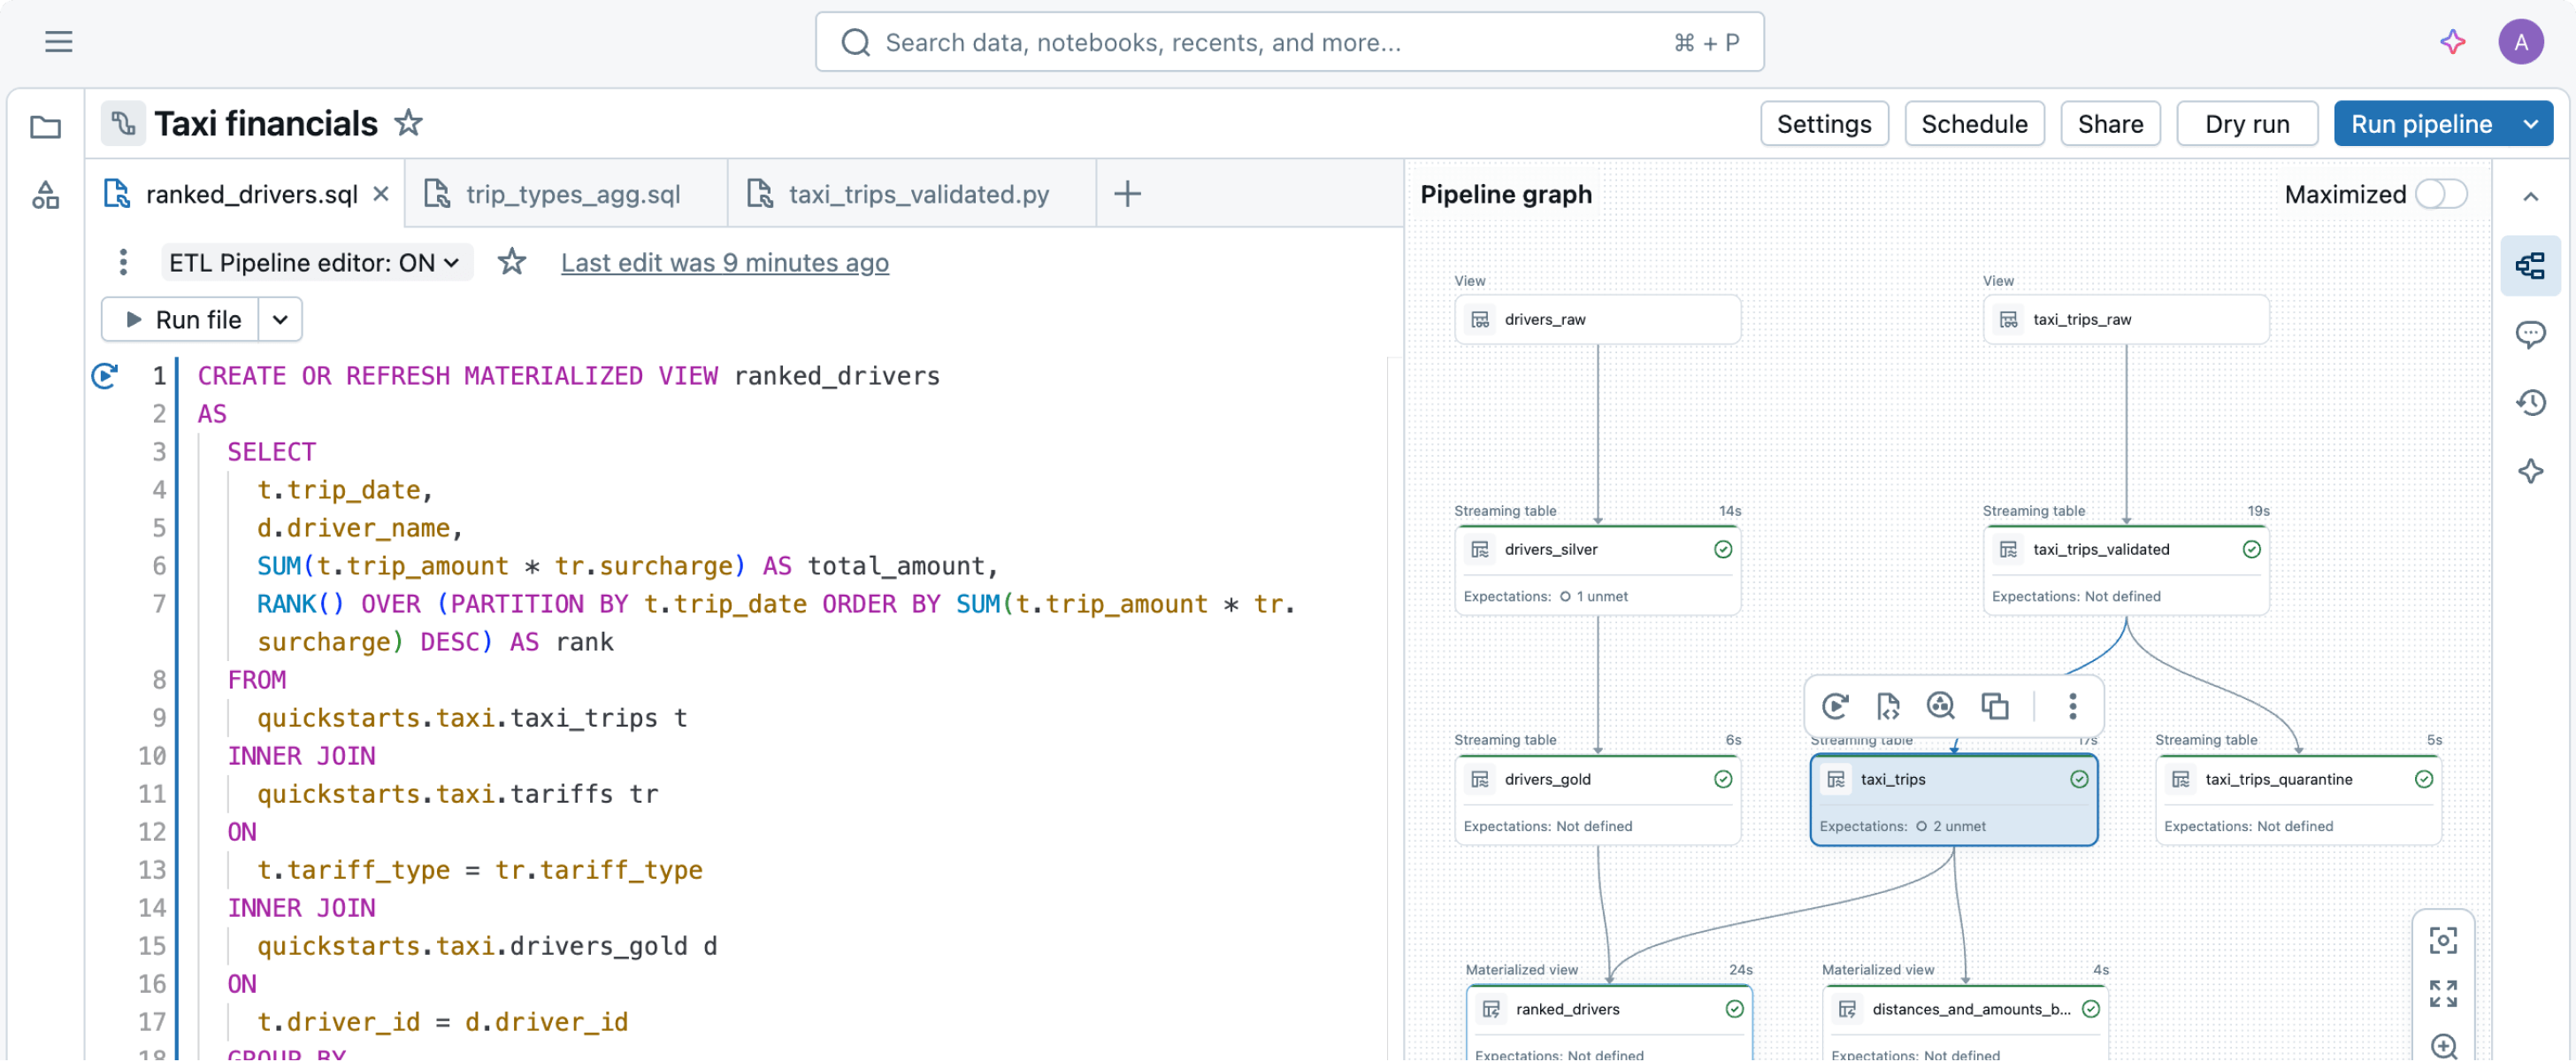
TOP TEAMS SUCCEED WITH INTELLIGENT DATA PIPELINES
Crie e execute pipelines em escala agêntica com confiança
Capacite equipes de dados e agentes de IA com padrões abertos, verificações de qualidade automatizadas e governança de nível empresarial.
Padrões abertos
O padrão aberto universal para pipelines de dados. Unifique lote e streaming, bem como SQL e Python, no Apache Spark™ — fornecendo uma base portátil para equipes de dados e agentes de IA gerarem código de produção robusto.

Criado para agentes
A estrutura nativa para agentes de codificação. Os agentes declaram resultados de dados alvo. O Apache Spark™ Declarative Pipelines (SDP) resolve automaticamente gráficos de dependência, executa simulações de compilador e aplica regras de qualidade antes da execução dos pipelines.

Execução governada
Execução de pipeline segura e autônoma. O Unity Catalog impõe limites e segurança rigorosos de catálogo, enquanto o SDP lida com o gerenciamento de estado, a recuperação de erros e o processamento incremental nos bastidores.
Criado para padronizar o desenvolvimento de pipelines para agentes e humanos
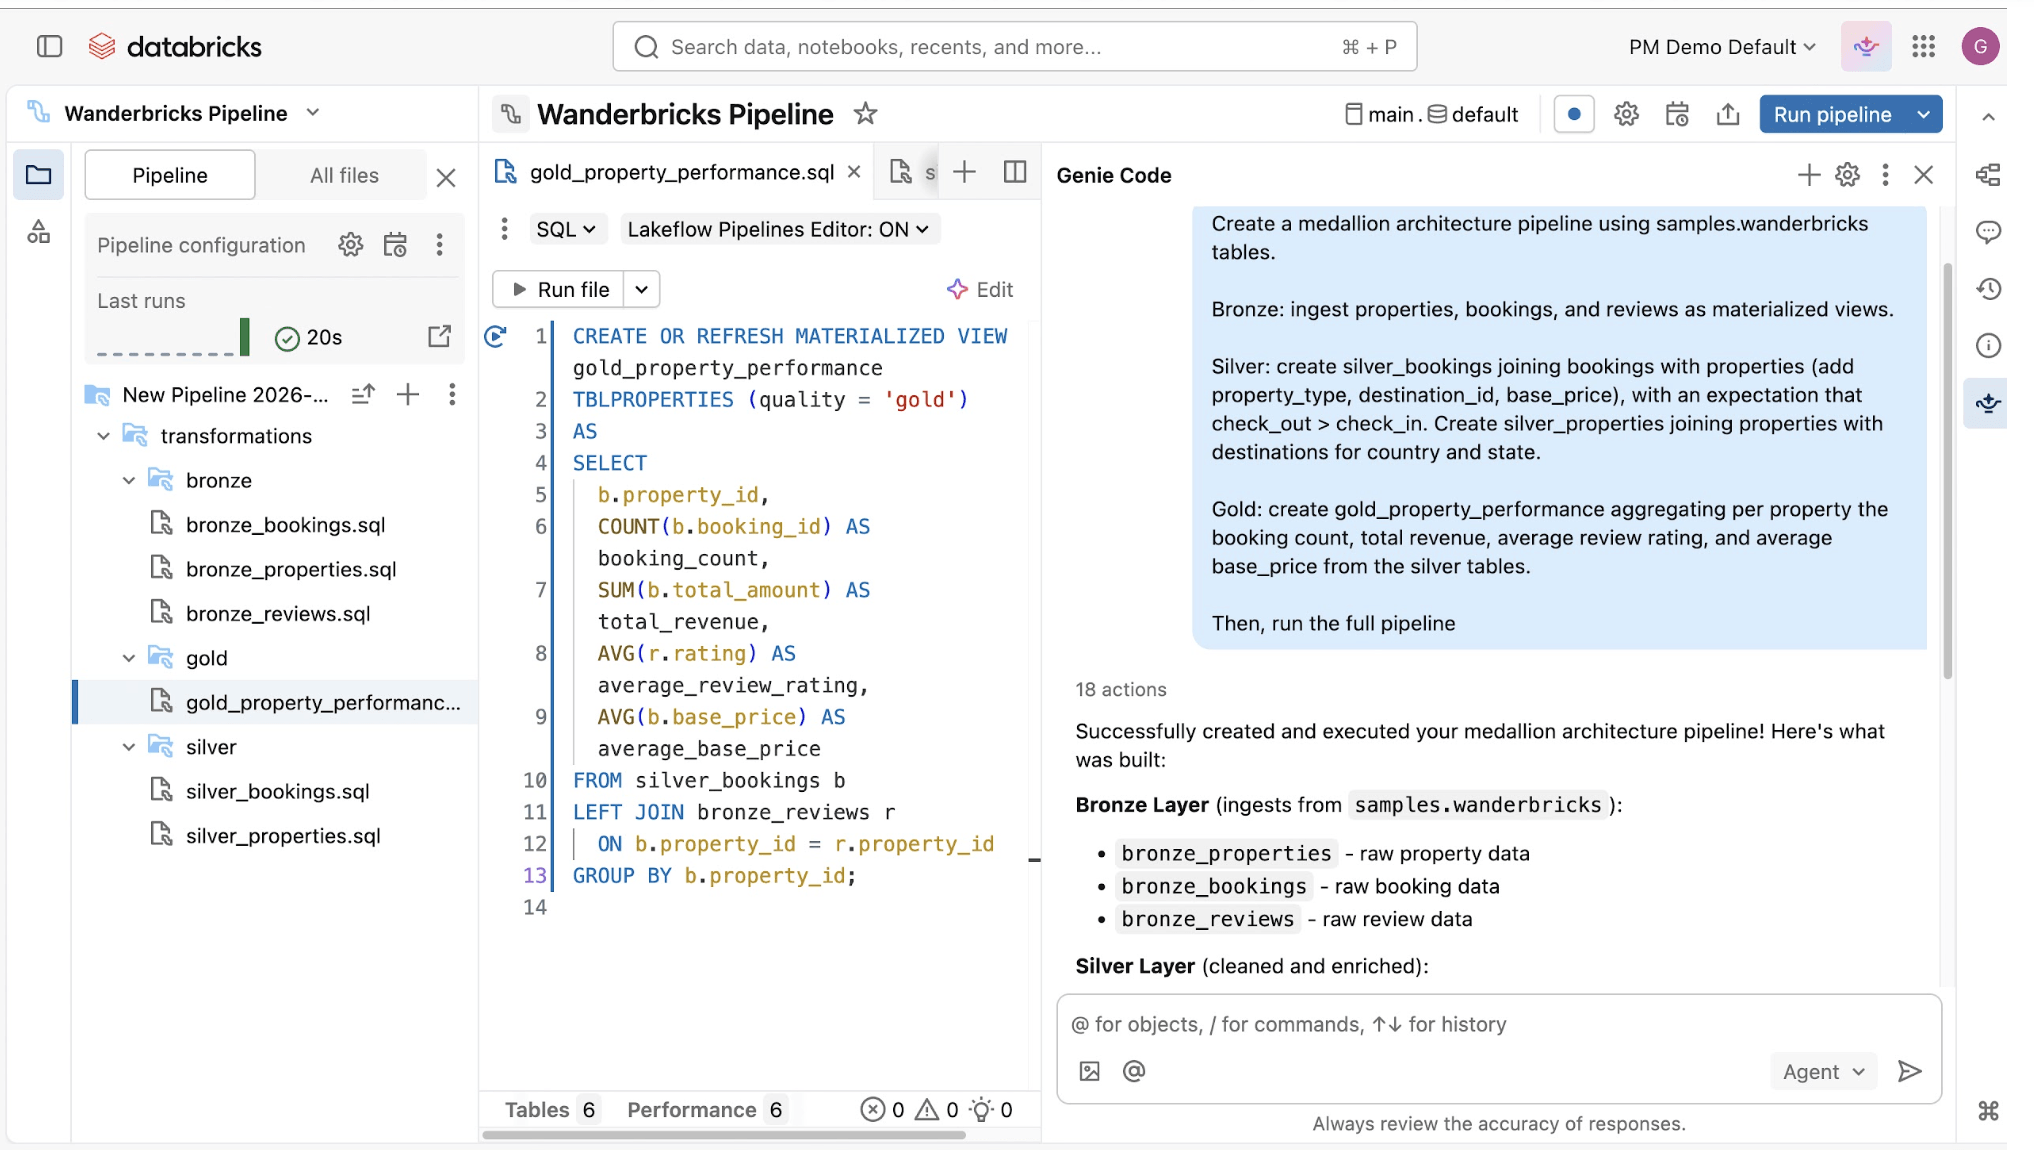
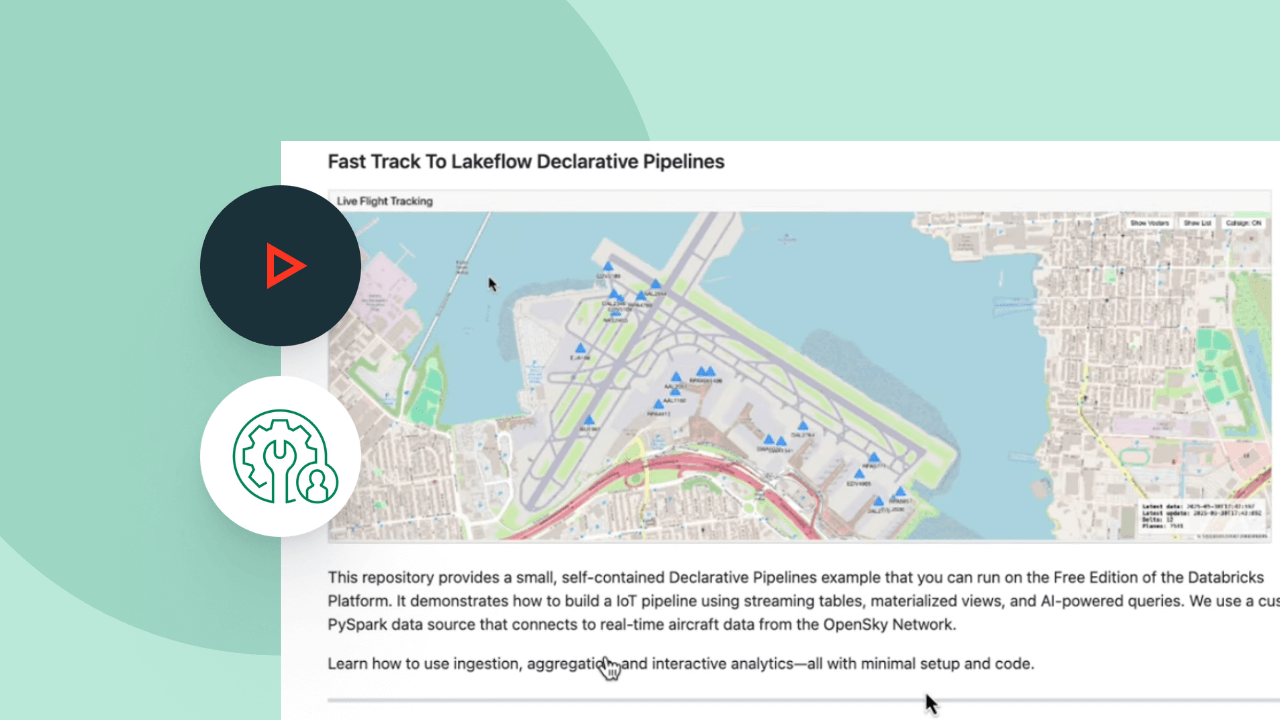
Padronize o desenvolvimento de pipelines com criação pronta para agentes, manuseio automatizado de padrões e um framework para todas as equipes.Crie, valide e itere declarativamente usando linguagem natural via Genie Code — ou através do seu agente de codificação de escolha.
Aproveitando a API unificada do Spark para processamento em lote e stream, o SDP permite alternar facilmente entre os modos de processamento.

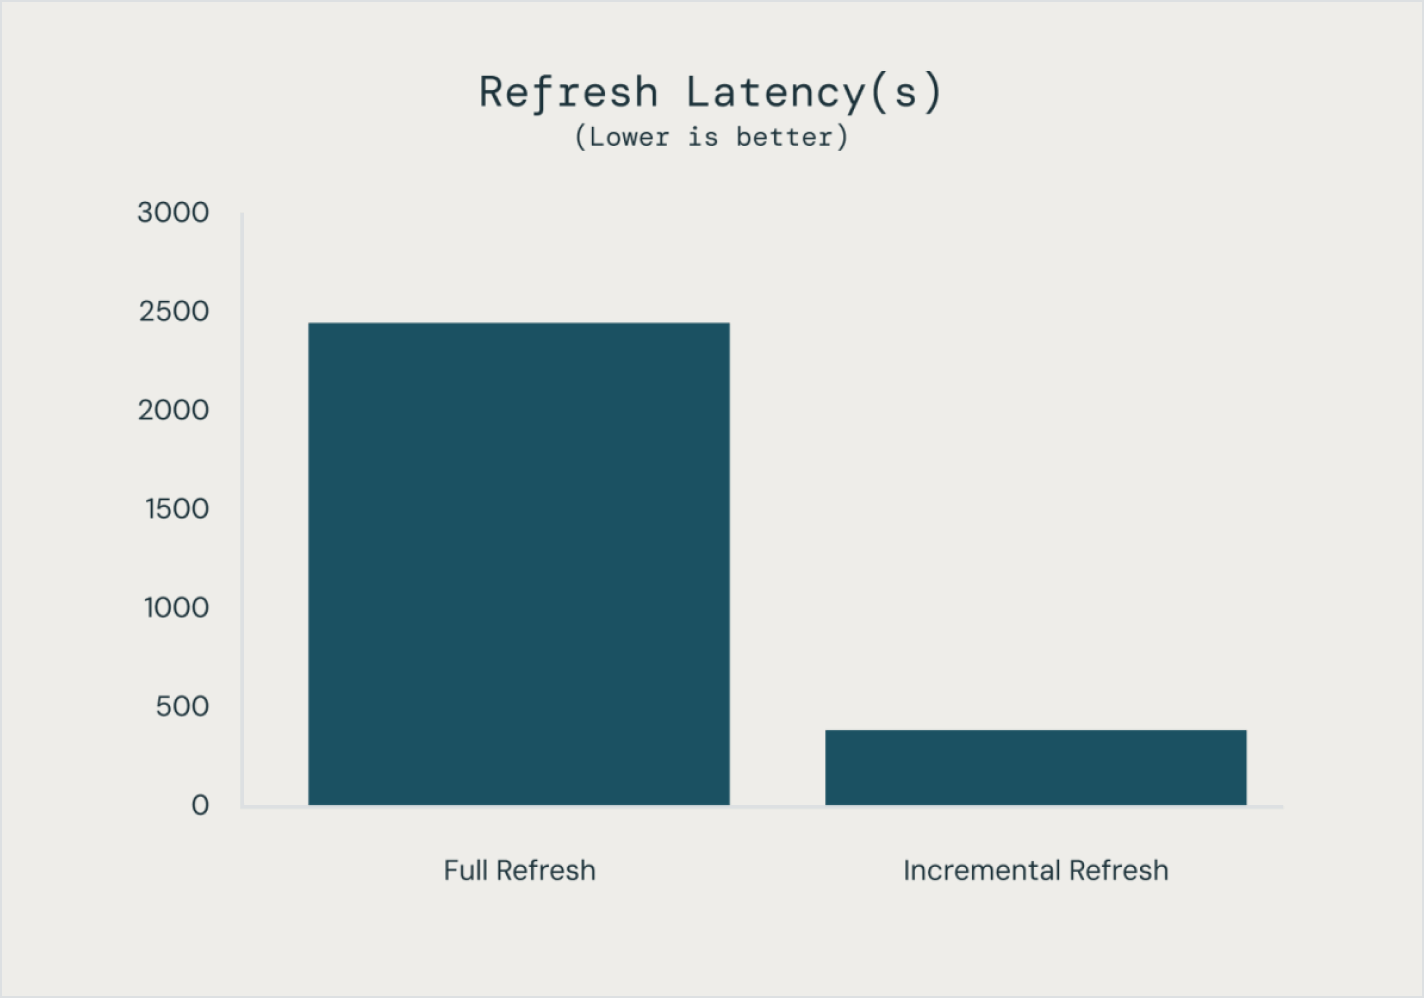
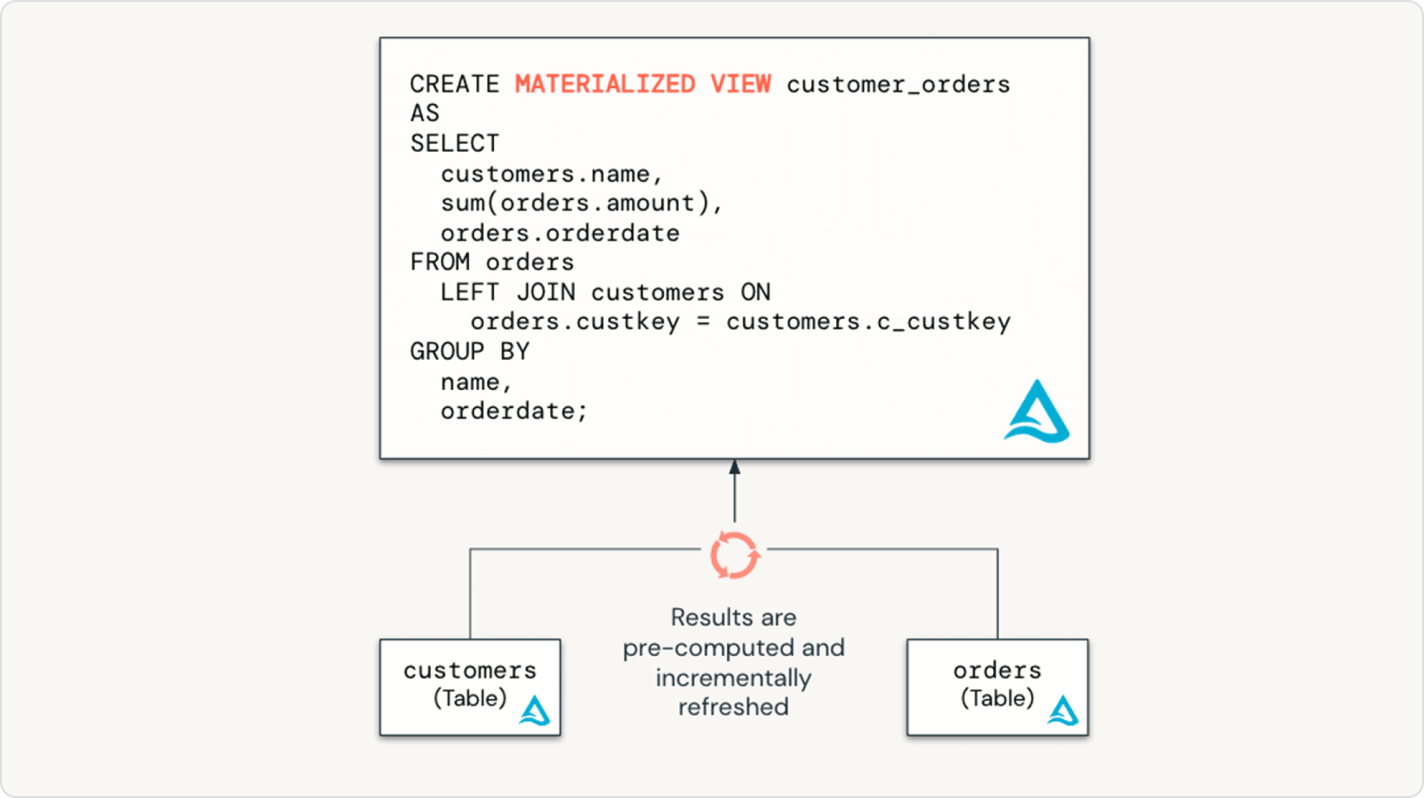
O SDP facilita a otimização do desempenho do pipeline ao declarar um pipeline de dados incremental inteiro com tabelas e views materializadas.
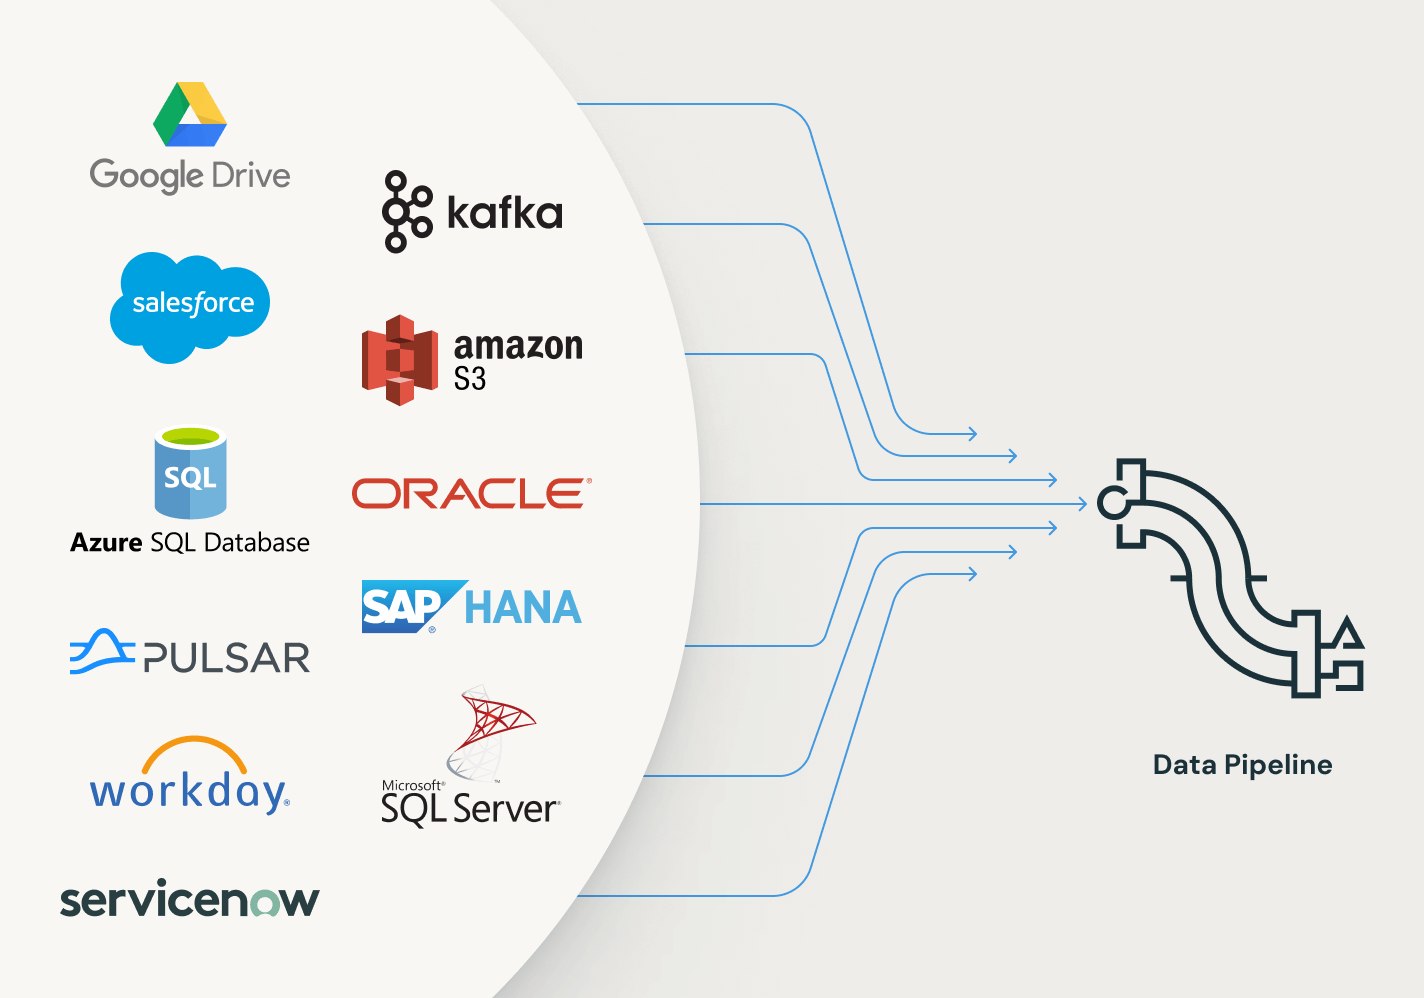
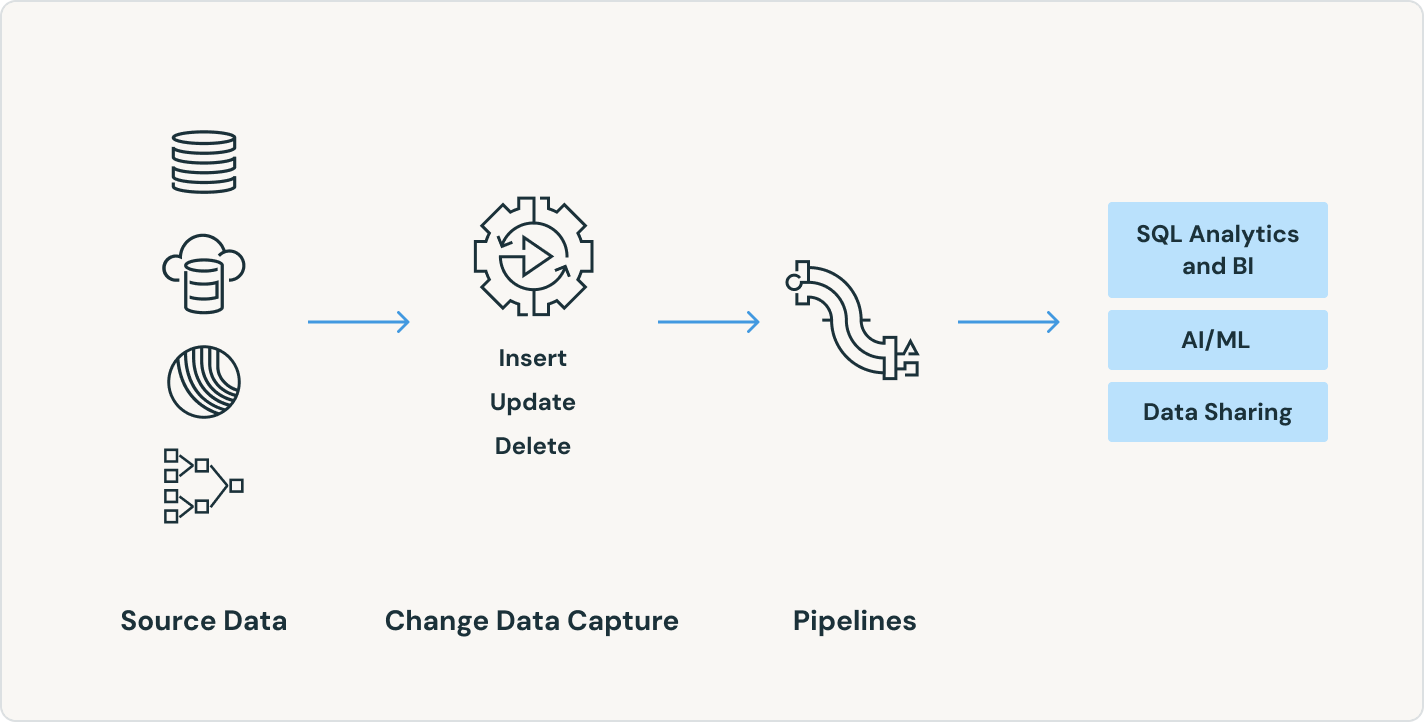
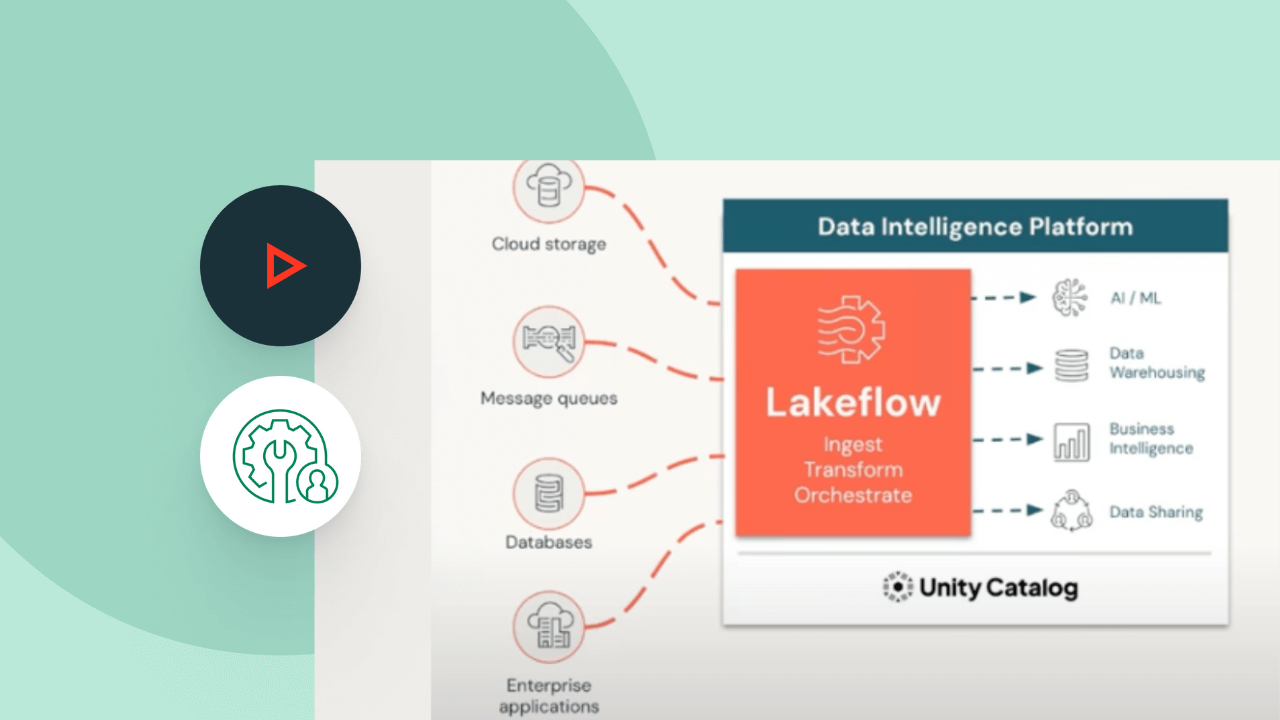
O SDP oferece suporte a um amplo ecossistema de fontes e destinos. Carregue dados de qualquer fonte — incluindo armazenamento em nuvem, barramentos de mensagens, feeds de dados de alteração, bancos de dados e aplicativos empresariais.
As expectativas permitem garantir que os dados que chegam às tabelas atendam aos requisitos de qualidade de dados e forneçam insights sobre a qualidade dos dados com cada atualização do pipeline.
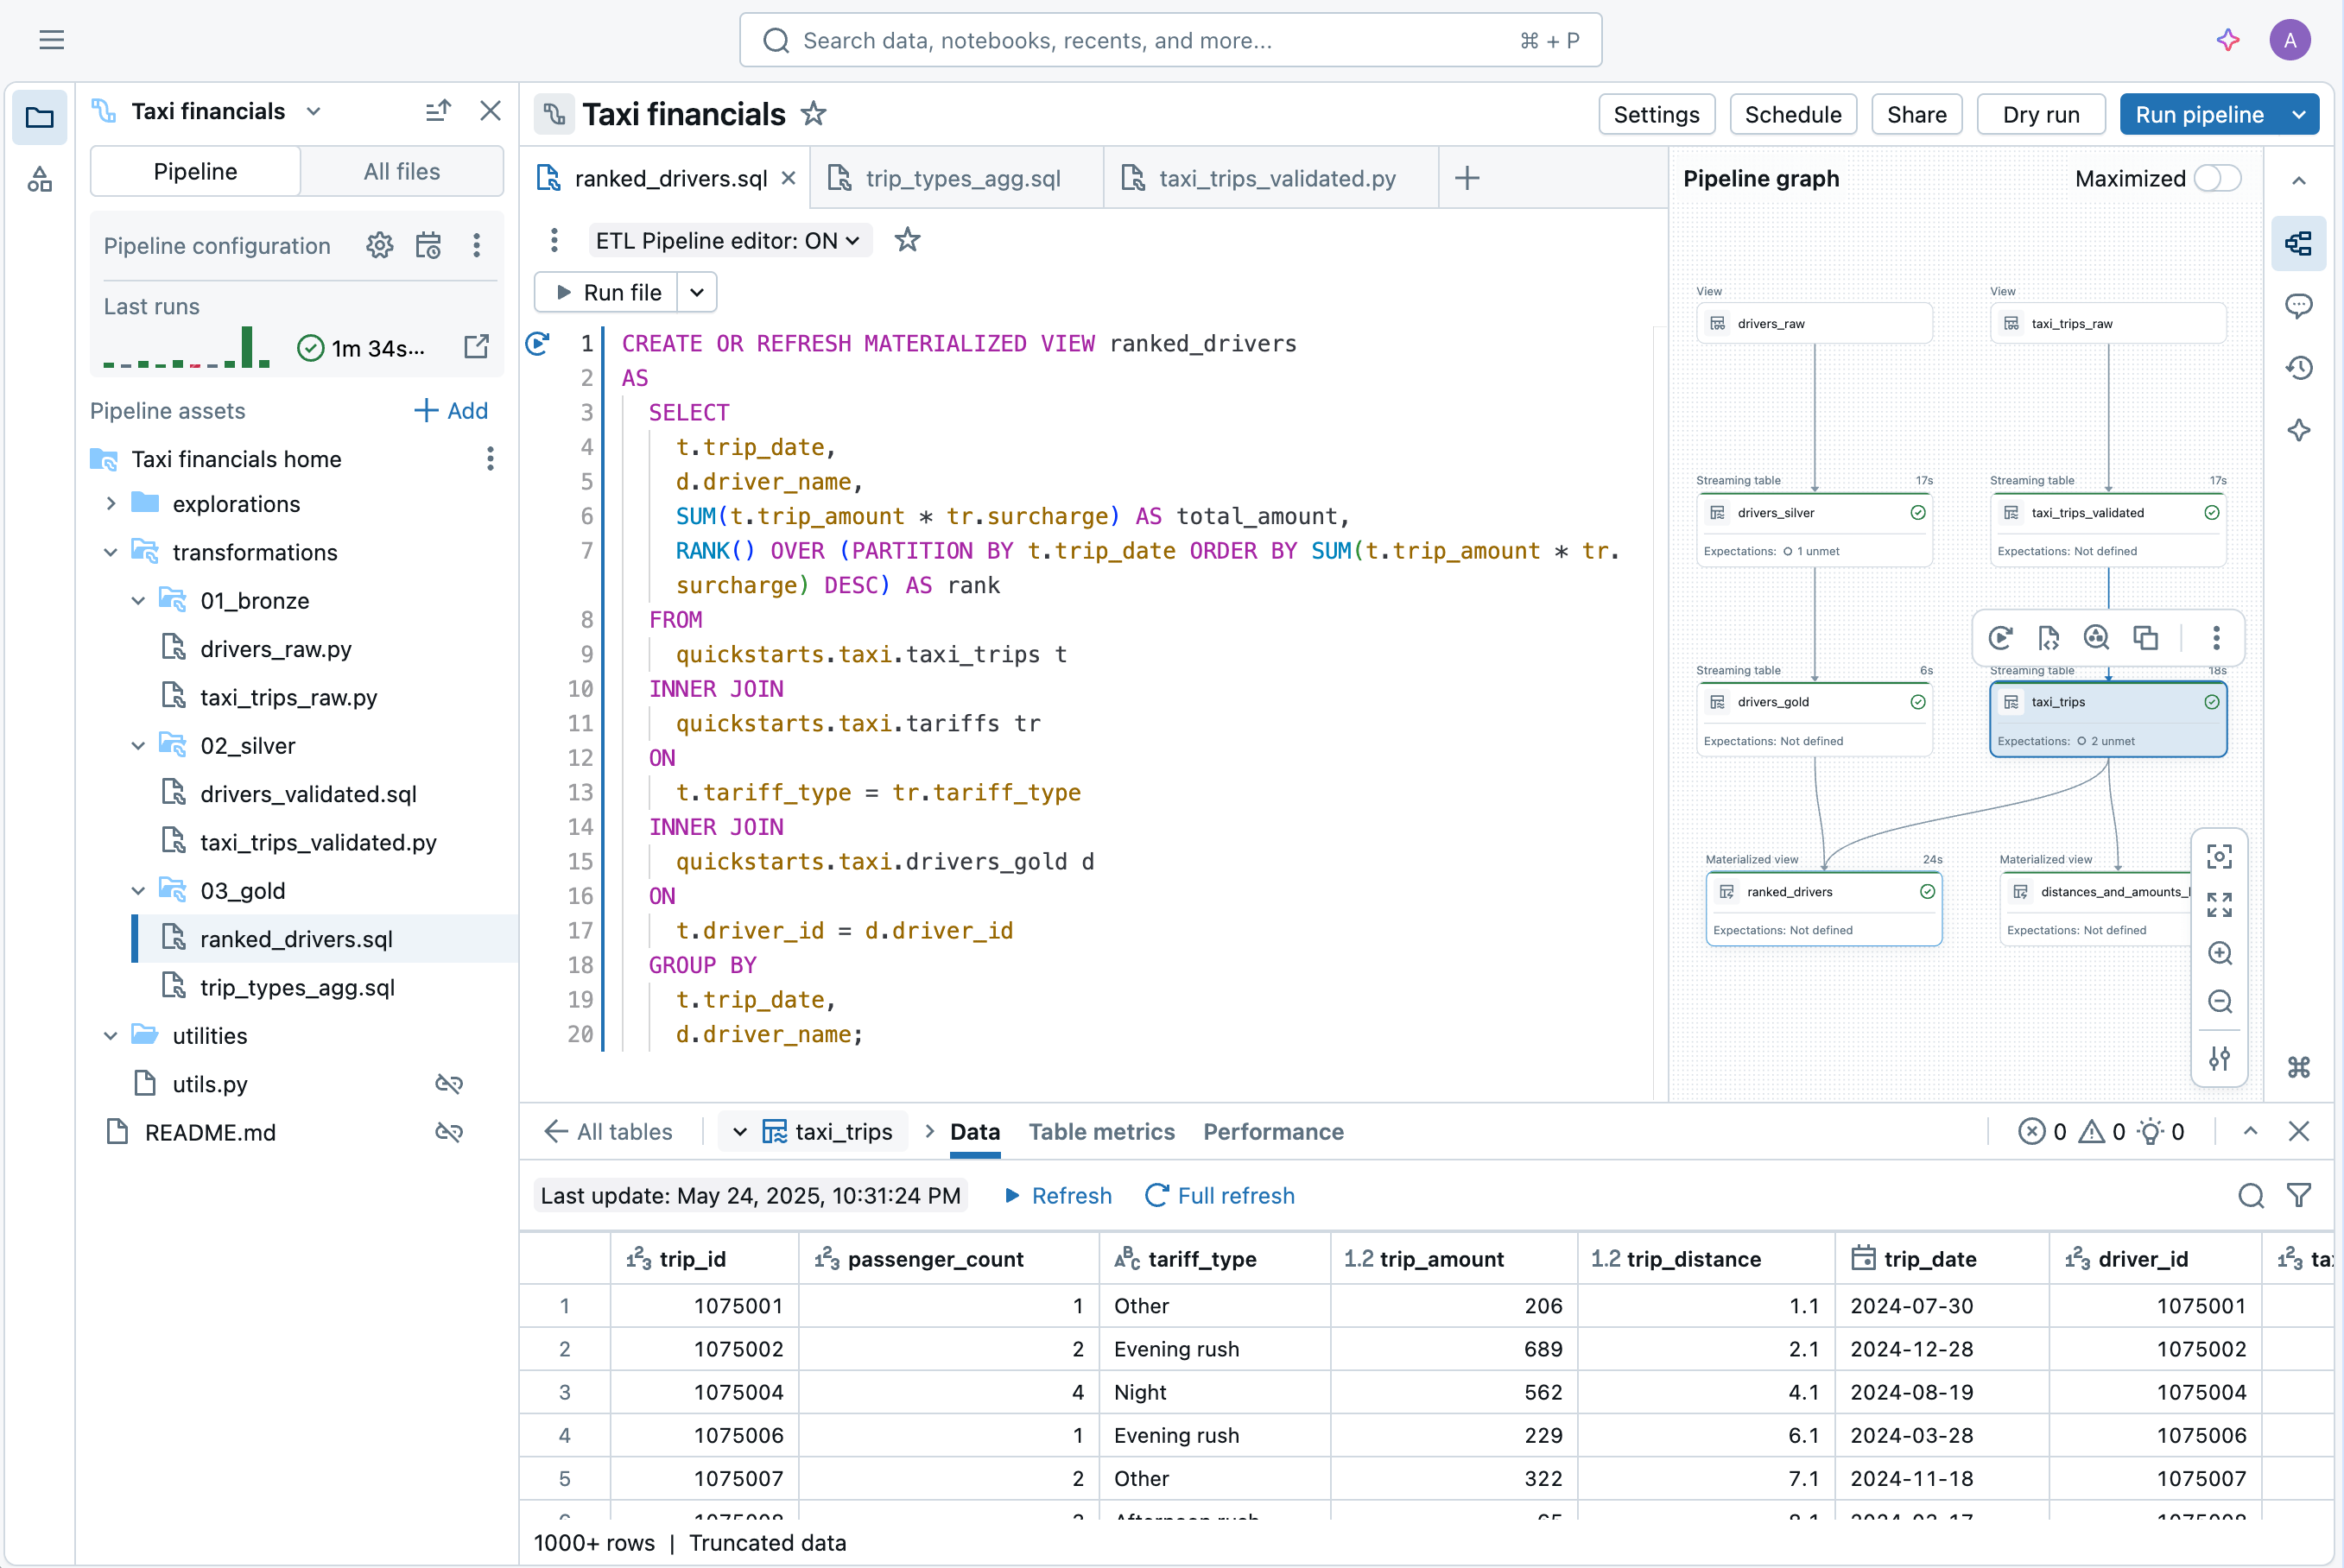
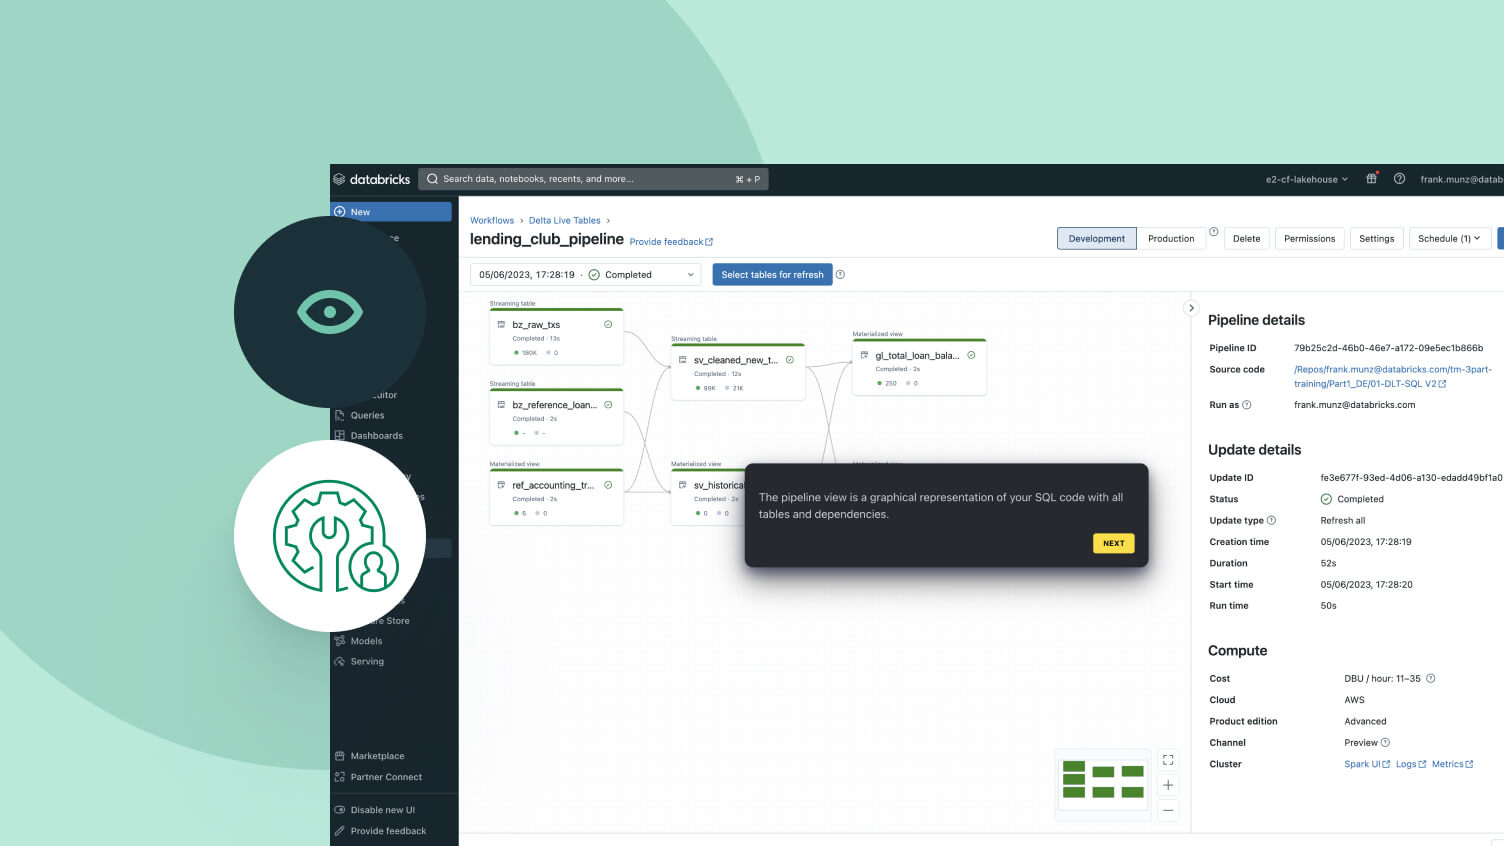
Desenvolva pipelines no editor de pipelines de Lakeflow — um IDE nativo para engenharia de dados — sem qualquer troca de contexto. Visualize o DAG, a pré-visualização de dados e as percepções de execução em uma única interface de usuário. Desenvolva código facilmente com preenchimento automático, erros em linha e diagnósticos.
Mais recursos
Simplifique seus pipelines de dados

Simplifique as fontes, transformações e destinos
A programação declarativa significa que você pode aproveitar o poder do ETL na lataforma da Databricks com apenas algumas linhas de intenção.
O preço baseado no uso ajuda a controlar despesas
Pague apenas pelos produtos que usar, por segundo.Descubra mais
Explore outras ofertas integradas e inteligentes na Plataforma de Dados + IA da Databricks.
Genie Code
Seu parceiro autônomo de AI para trabalho com dados.
Genie Code
Seu parceiro autônomo de AI para trabalho com dados.

LakeFlow Connect
Conectores de ingestão de dados eficientes de qualquer fonte e integração nativa com a Plataforma de Dados + IA da Databricks desbloqueiam o acesso fácil a analises e IA, com governança unificada.

Lakeflow Jobs
O Workflows permite definir, gerenciar e monitorar facilmente fluxos de trabalho multitarefa para ETL, análises e pipelines de machine learning. Com uma ampla variedade de tipos de tarefas compatíveis, recursos de observabilidade detalhada e alta confiabilidade, suas equipes de dados podem automatizar e orquestrar melhor qualquer pipeline e aumentar a produtividade.

Armazenamento do Lakehouse
Unifique os dados em seu lakehouse, em todos os formatos e tipos, para todas as suas cargas de trabalho de análises e IA.

Unity Catalog
Governe sem esforço todos os seus ativos de dados com a única solução de governança unificada e aberta do setor para dados e IA, integrada à Plataforma de Dados + IA da Databricks.

Inteligência de Documentos
Analise, extraia e classifique documentos empresariais em escala com governança integrada para IA agêntica.

Plataforma de Dados + IA da Databricks
Descubra como a Plataforma de Dados + IA da Databricks viabiliza seus dados e workloads de IA.
Dê um passo adiante
Explore a documentação dos Spark Declarative Pipelines
Tudo o que você precisa para começar a usar o Spark Declarative Pipelines nos ambientes AWS, Microsoft Azure ou Google Cloud Platform.
Experimente o Databricks gratuitamente
Comece uma avaliação gratuita ou simplesmente inscreva-se na Free Edition.
Perguntas frequentes sobre o Spark Declarative Pipelines
O Spark Declarative Pipelines (SDP) é uma estrutura aberta que simplifica a engenharia de dados em lote e streaming no Apache Spark. Ao permitir que as equipes de dados e agentes de codificação declarem estados de dados de destino em vez de escrever código procedimental, o SDP resolve automaticamente dependências, aplica as expectativas de qualidade de dados e lida com o gerenciamento de estados incrementais.
Pronto para se tornar uma empresa de dados + IA?
Dê os primeiros passos em sua transformação